医药 AI 前沿资讯
洞察医药研发动态,把握产业先机——监管政策、深度研报、产品发布与行业观察一站直达。
深度研报
 深度研报
641项研究筛出57项:LLM把电子病历多模态预测平均拉高6.4%,但三条路各有代价
发表于npj Digital Medicine的一篇系统综述梳理了大语言模型用于电子病历多模态预测建模的研究现状。作者在筛选641项研究后有57项符合纳入标准,归纳出三种多模态整合策略:嵌入、抽取与文本融合,划分依据是融合时非结构化数据的形态。三种策略相对单模态模型均带来性能提升,平均提升6.4%。综述同时指出落地时需要权衡的三项因素:样本量、可解释性与计算成本。
 深度研报
2000家机构、2800万用户、3.4亿人次:浙江「安诊儿」成了全省医疗基础设施
浙江省政府新闻办举行「十五五」卫生健康事业发展规划新闻发布会,披露医疗智能体的实际调用规模:「安诊儿」已接入全省2000余家医疗机构,注册用户超2800万人,累计服务超3.4亿人次,汇聚健康咨询、预约挂号、名医孪生、就医陪诊、报告解读等40余项服务。规划提出医疗机构医学大模型应用率达到100%,到2030年基层就诊率提升至70%以上、县域就诊率93%、省域就诊率97%以上,并依托国家人工智能应用中试基地(医疗)开发专科专病垂类大模型。
 深度研报
AI的83.2%对医生的36.1%:微软MAI-DxO登《Science》,304例新英格兰疑难病例
微软AI的MAI-DxO诊断系统成果于10月22日发表于《Science》。研究构建了顺序诊断基准SDBench,把304例《新英格兰医学杂志》临床病理讨论会病例与325例急诊留观病例改造成交互式分步问诊过程。结果显示,DxO搭配GPT-5在疑难病例上取得83.2%的准确率、人均估算成本5431美元;参与对照的全科医师开卷条件下为36.1%、人均4725美元,闭卷仅22.3%,表现最好的医生为51.8%。急诊病例上DxO为80.3%,医生平均46.8%。全部15位作者均为微软员工。
 深度研报
FDA批准的肺栓塞AI在67869例真实世界CT中敏感度跌破审批基准,亚段栓塞降至72.9%
一项纳入67869例CT的肺栓塞AI真实世界研究显示,已获FDA批准的算法在临床实际使用中的敏感度,跌破了当初审批时的基准水平。其中30678例CT肺动脉造影与37191例增强CT构成对照,亚段栓塞的检出敏感度降至72.9%——而亚段栓塞恰恰是临床最需要AI辅助、也最容易漏诊的一类。审批基准与真实世界表现之间的落差,正在成为监管方与医院共同面对的新问题。
 深度研报
AI提升检出却不提升推理:GPT-4助医生76%对74%,模型单独92%
一篇发表于Frontiers in Digital Health的叙述性综述提出了一个尖锐区分:AI提升了医生的「检出率」,却没有同步提升「临床推理」能力。综述汇总9项原始研究,乳腺筛查中AI使检出率从每千人5.0例升至6.4例、工作量下降44.2%,但GPT-4辅助下的医生准确率为76%、仅略高于医生单独的74%,而模型单独表现可达92%。人机组合并未自动等于最优,这个反差值得所有部署临床AI的机构留意。
 深度研报
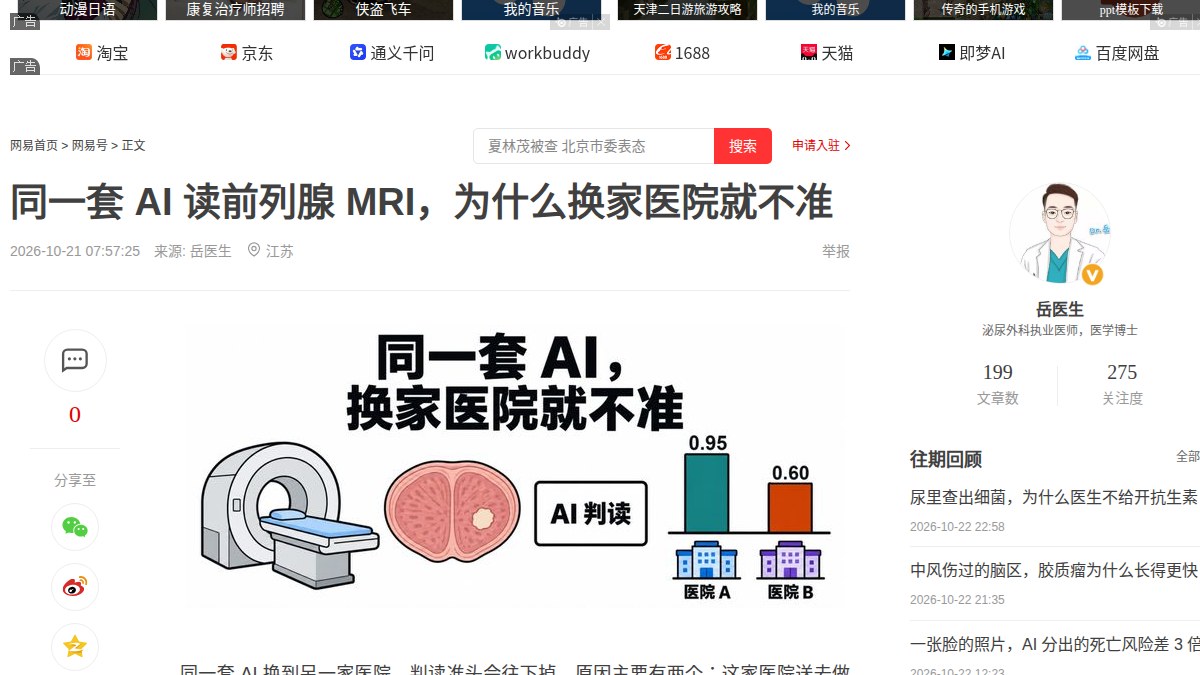
换家医院AUC从0.90跌到0.60:22445次前列腺MRI跨国验证揭示泛化落差
一项覆盖46座城市、22个国家的前列腺MRI跨国验证研究给出了一组不那么好看的数字:同一套AI模型在不同医院的表现,AUC从0.90以上的高水平跌到0.60至0.70区间。研究纳入22445次前列腺MRI检查、21252名男性,是目前该领域规模最大的多中心外部验证之一。对准备采购影像AI的医院来说,这组数字把「泛化能力」从论文里的术语,变成了可以直接写进招标条款的硬指标。
 深度研报
39000次胸部CT真实世界对照:肺结节AI让报告整体快14.6%,急诊反而慢7.1%,胸部放射科医师快25.0%
荷兰鹿特丹伊拉斯姆斯医学中心把一套商用肺结节AI接入日常工作,前后39,000余次胸部CT记录显示:报告时间中位数从21.3分钟降至18.2分钟,整体快14.6%。八位胸部放射科医师从16.4分钟降到12.3分钟(-25.0%),低年资医师-17.2%,60余位综合放射科医师仅-2.6%;唯独急诊胸部CT从37.9分钟延至40.6分钟(+7.1%)。研究为AI上线前后对照而非随机试验,未评估诊断准确性,「省下0.5个全职放射科医师」为外推示意。
 深度研报
病历里一句「近12个月就诊17次」,让近10%高风险患者被AI分诊降级:UTSW两中心研究揭示急诊大模型继承临床污名
UT西南医学中心10月20日发表于npj Digital Medicine的研究,用斯坦福医学中心与贝斯以色列女执事医疗中心两家学术急诊科的病历做配对,让三个开源大模型预测哪位患者更可能恶化。加入「12个月内17次就诊」等与即刻病情无关的污名化信息后,最高近10%的高风险患者被模型错误降级;频繁急诊与精神急诊史影响最显著,与人类分诊中「frequent flyer」标签的偏见同构。
 深度研报
Lynch综合征三项RCT连证CADe无增益:CADLY2 733例ADR 33.8%对30.9%,CADx敏感度84.4%仍逊专家光学诊断
《Familial Cancer》综述汇总Lynch综合征监测证据:CADLY2试验733例中CAD EYE辅助结肠镜ADR为33.8%对高清白光30.9%(p=0.409),TIMELY试验430例平均腺瘤数0.64对0.64(p=0.87),CADLY试点ADR 36.0%对26.1%(p=0.379)均无显著差异;CADx光学鉴别敏感度84.4%、特异度90.9%,仍低于专家光学诊断。对照平均风险人群21项RCT、18,232例ADR由35.9%升至44.0%的明确获益,高质量内镜基线让AI增益消失。
 深度研报
412例儿童肘部创伤:GPT-5.2 Instant判读敏感度56.10%、阳性预测值31.08%,41例骨折漏掉18例
土耳其 Van 培训与研究医院的前瞻性单中心研究连续纳入 412 名 0 至 17 岁急性肘部创伤患儿,把去标识化 X 光片经普通 ChatGPT 网页交由 GPT-5.2 Instant 判读。参考标准确认 41 例骨折,模型只认出 23 例、漏掉 18 例,敏感度 56.10%、阳性预测值 31.08%、kappa 仅 0.312。这只是单一接入方式与单一提示词下的结果,医生与 AI 的协作尚未被评估。
 深度研报
《内科年鉴》基准:6个大模型4050条答复中过度医疗建议率5.4%,甲状腺结节超声一项却高达42.8%
以色列本-古里安大学与 Clalit 团队以 Choosing Wisely 的 15 条推荐为标尺,构造 225 个临床情景,让 6 个商用大模型各跑 3 次、共形成 4,050 条答复。结果是整体过度使用率仅 5.4%、错误克制率 0.6%,但集中度极高:甲状腺结节超声达 42.8%、低危成人常规心电图 28.3%,其余推荐在 0.6% 至 3.3% 之间,且同一病例上不同模型的过度使用比例从不到 10% 到 80% 不等。需注意这是单轮提示的基准测试,并非真实世界使用情况。
 深度研报
《Radiology》年度最佳论文:77张AI伪X光片混入真图,17名放射科医生鉴伪准确率74.8%,GPT-4o为85.1%、Gemini 2.5 Pro仅56.5%
西奈山伊坎医学院团队的三阶段研究获 2026 年 Radiology Margulis 奖:先用 GPT-4o 造 77 张多部位合成 X 光、用 RoentGen 造 55 张合成胸片,各自混入等量真实图。结果是 17 名放射科医生在明确被告知有假图后,判别准确率也只有 74.8% 与 70%,年资毫无帮助,而 GPT-4o 自身达 85.1%、Gemini 2.5 Pro 仅 56.5%。需注意只纳入 17 名阅片者,且这是实验设置而非真实工作流。
 深度研报
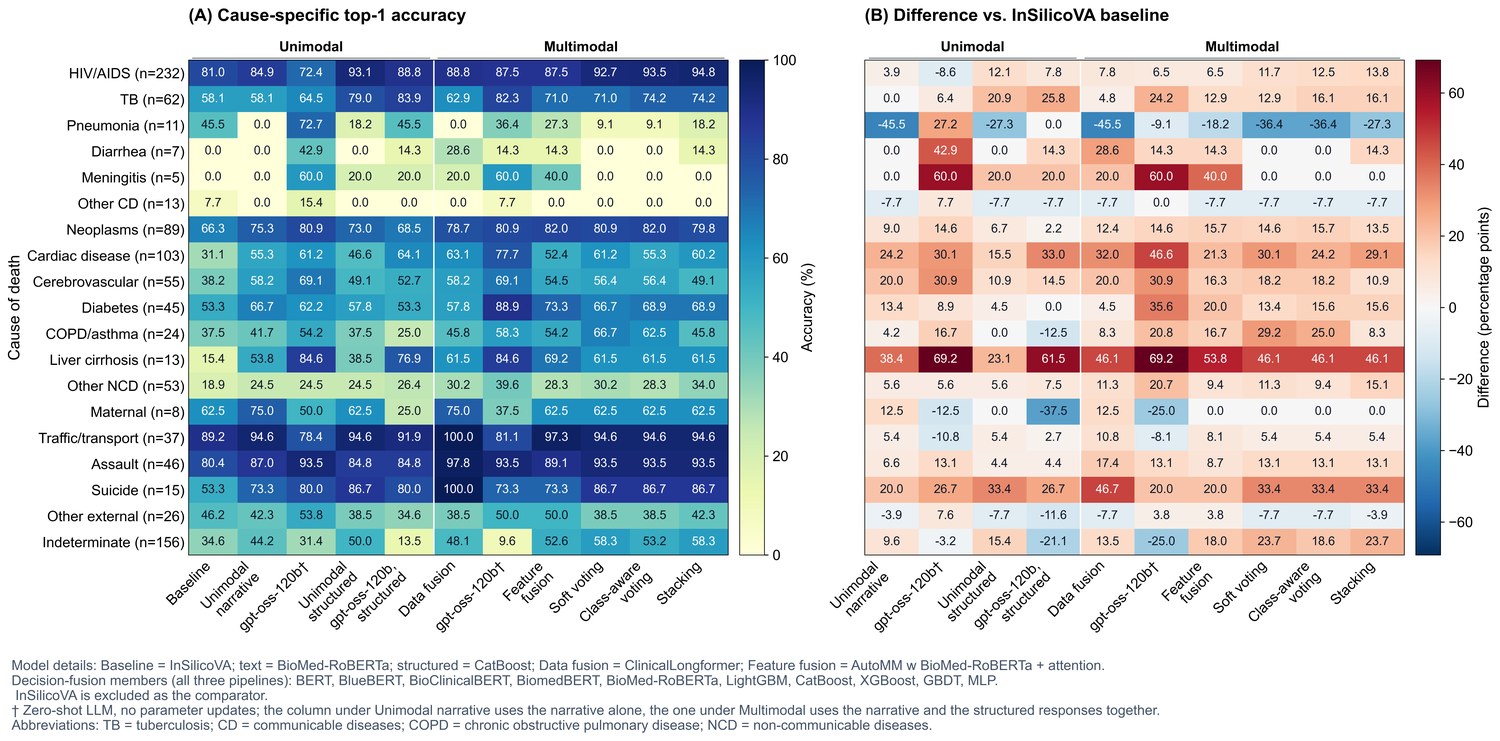
4,999例南非成人死亡口头尸检:纳入自由文本叙事后,死因归因top-1准确率比现行InSilicoVA提高8.5–15.9个百分点
medRxiv于2026年10月16日上线预印本:南非全国登记死亡抽样中4,999例12岁及以上死亡的口头尸检记录,以医师判定死因为参考标准。所有监督式管道相对现行工具InSilicoVA的top-1准确率提高8.5–15.9个百分点,死因别死亡构成(CSMF)准确度提高3.5–7.1;特征融合CSMF准确度最高,达95.7%。零样本大模型平衡准确率最高60.6%,但CSMF准确度低于InSilicoVA。增益在全部9个留出省份成立。
 深度研报
952,008名美国临床医生两年半提交2.71亿次提问:JAMA研究显示月活从355增至703,265,诊断类提问仅13.9%
JAMA于2026年10月15日在线发表横断面研究:2024年1月1日至2026年6月30日,952,008名经NPI核验的美国临床医生(含556,200名医师)向OpenEvidence提交2.71亿次提问;月活从355人增至703,265人,活跃用户人均月提问18.0升至39.5。51.9%的提问属临床决策,其中治疗与管理33.1%、诊断仅13.9%。毕业后10年内医师使用比2.54,放射科0.24、骨科0.24、眼科0.23。
 深度研报
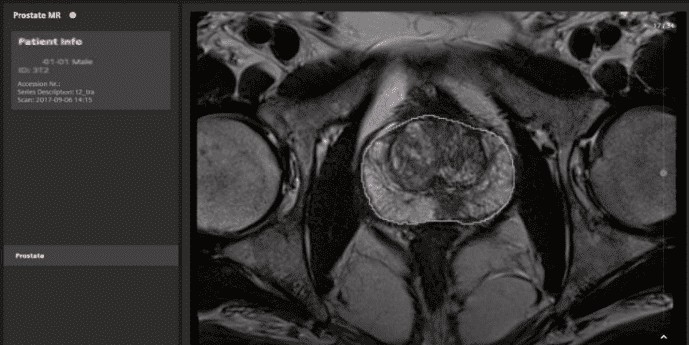
22,445次前列腺MRI验证:SCARLET-1中AI外部AUC 0.86/0.89/0.84,与标准诊断一致率83.0%–87.9%,25家中心28%的AUC低于0.80
Radiology于2026年10月13日发表SCARLET-1研究:22,445次前列腺MRI、21,252名男性(中位年龄66岁),数据来自2012年1月至2024年10月、22国46城。外部测试AUC为PRIME 0.86(95%CI 0.83–0.90)、STHLM3-MRI 0.89(0.86–0.92)、IP1-PROSTAGRAM 0.84(0.70–0.95);AI与标准诊断对Gleason≥2级癌的一致率为83.0%、87.9%、87.7%,三套数据均达预设互换性标准。25家中心中28%的AUC低于0.80、32%不低于0.90。
 深度研报
《NEJM AI》:24 个 AI 系统给 200 份真实病历开方案,人均花费 314 美元为医生 97 美元的 3.2 倍
《NEJM AI》2026 年 10 月 15 日刊出 Dvir Aran、Jeremy Goldhaber-Fiebert 等六位作者的研究,首次把 AI 建议与医生方案放到同一份账单上比较:24 个 AI 系统面对 MTSamples 的 200 份去标识化美国门诊与急诊病历,只见医生评估前的主诉即自行书写方案,医生实际记录的方案作对照,两侧医嘱由三个独立模型抽取并按 2026 年 Medicare 价格结算。结果 20 个通用系统推荐诊疗人均 314 美元,医生 97 美元,差 216 美元,95% 置信区间 177 至 257,P 小于 0.001,即医生的 3.2 倍;4 个医疗专用系统也在医生的 2.7 至 3.5 倍。
 深度研报
《柳叶刀·全球健康》:坦桑尼亚 24 家医院 RCT,AI 现场读片让需转诊者 8 周到诊率从 18.2% 升到 35.9%,等待从 36.9 天压到 10.9 天
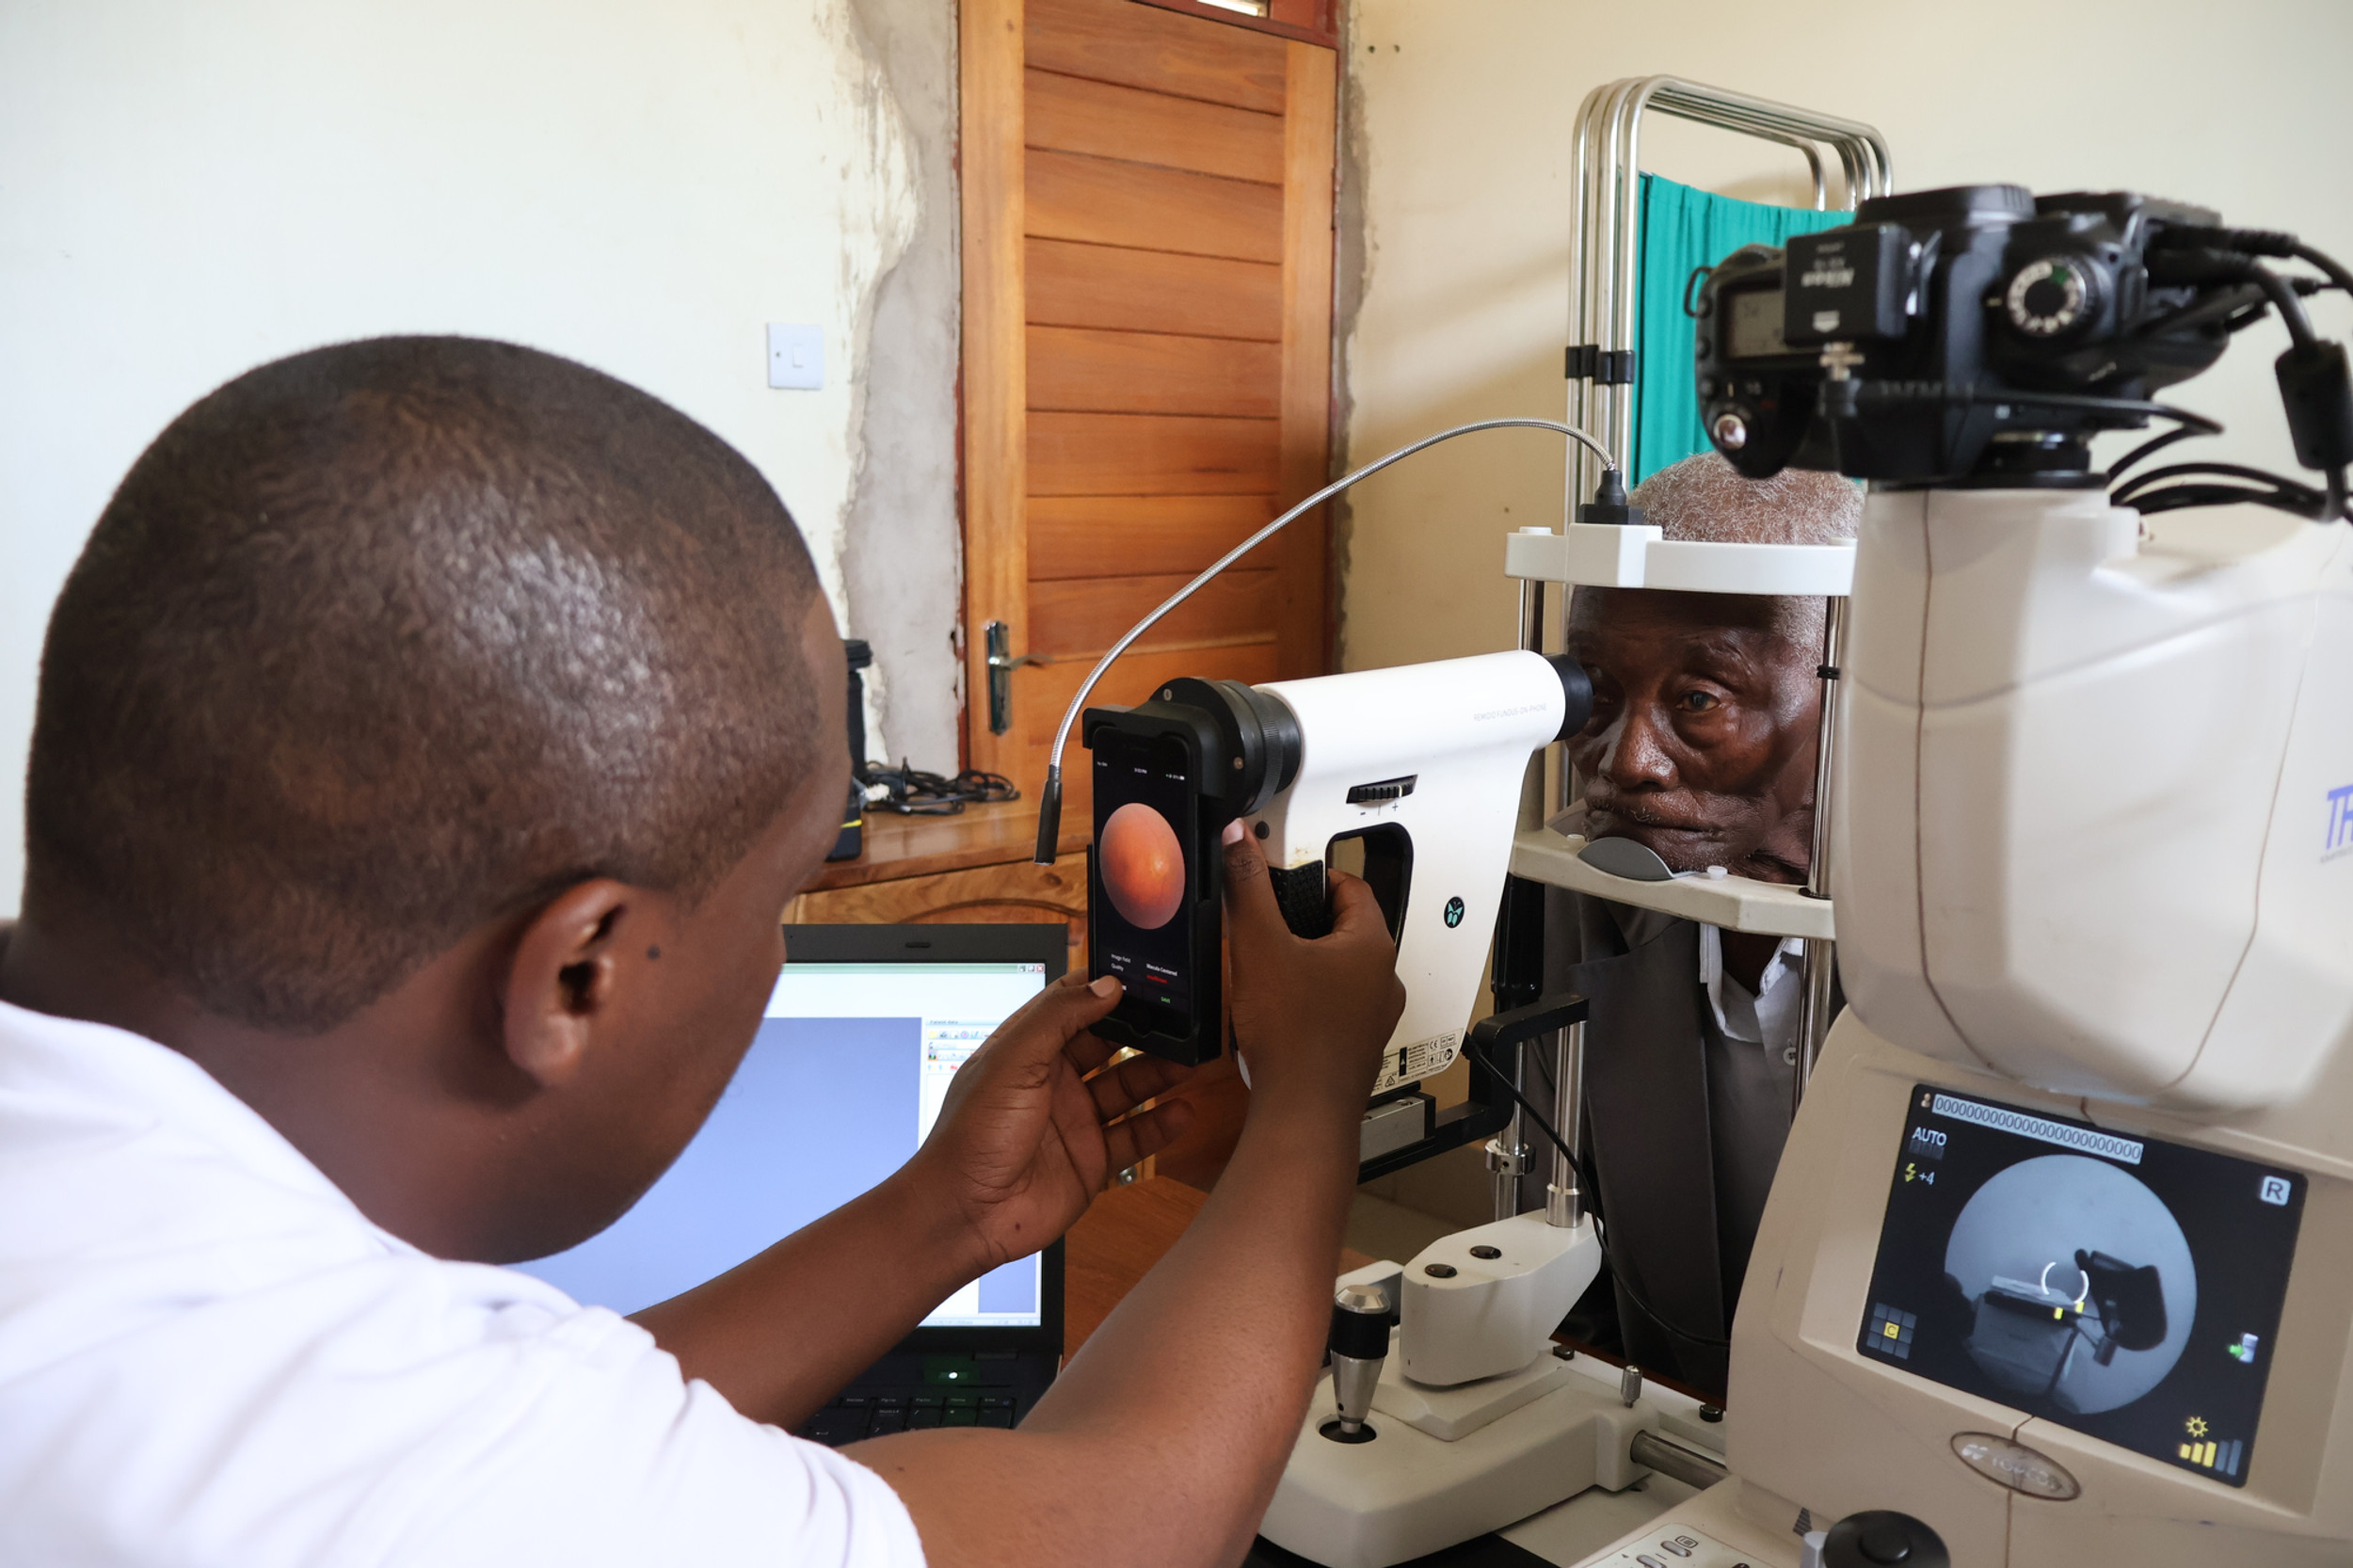
《柳叶刀·全球健康》于 2026 年 10 月 13 日刊出坦桑尼亚糖尿病视网膜病变筛查随机对照试验。乞力马扎罗与阿鲁沙 24 家医院纳入 2378 名糖尿病成人,随机分为 AI 干预组 1192 人与标准组 1186 人,两组同样拍摄眼底照片,差别只在结果何时到达患者以及如何做咨询:AI 组影像即时判定,患者在离开摄片室前拿到可否转诊、不可转诊或无法分级的结论;标准组影像由附近卫生工作者数周后读片再电话告知。经设盲的英国认证阅片员判定为真需转诊的 904 人中,AI 组 8 周内到诊 157 人占 35.9%,标准组 85 人占 18.2%,绝对差 17.7 个百分点,比值比 2.52,到诊等待由 36.9 天缩到 10.9 天。
 深度研报
npj Digital Medicine:919783 份临床记录抽取 11 类物质使用障碍,规则加语义接地剔除 14.59% 无依据结果,主模型 F1 0.80
《npj Digital Medicine》2026 年 10 月 16 日刊出 Oak Ridge National Laboratory 的 Maria Mahbub 等与退伍军人事务部多个医疗体系合作完成的工作:针对病历信息抽取缺乏可扩展验证手段的问题,提出由提示校准、规则过滤、语义接地、裁判 LLM 评估、专家复核与预测效度分析六环节组成的多阶段验证框架,在弱监督下量化不确定性。团队用它从 919783 份临床记录抽取 11 类物质使用障碍诊断,规则过滤与语义接地剔除 14.59% 无原文支持或结构不合理的阳性抽取,以裁判评估为参照的主模型 F1 为 0.80,且抽取结果比结构化数据基线更能预测后续专科就诊参与。
 深度研报
脑 MRI 基础模型表征的隐私账:仅凭公开嵌入即达最高 99% 的 rank-1 患者重识别,记录性别推断平衡准确率 95.5%
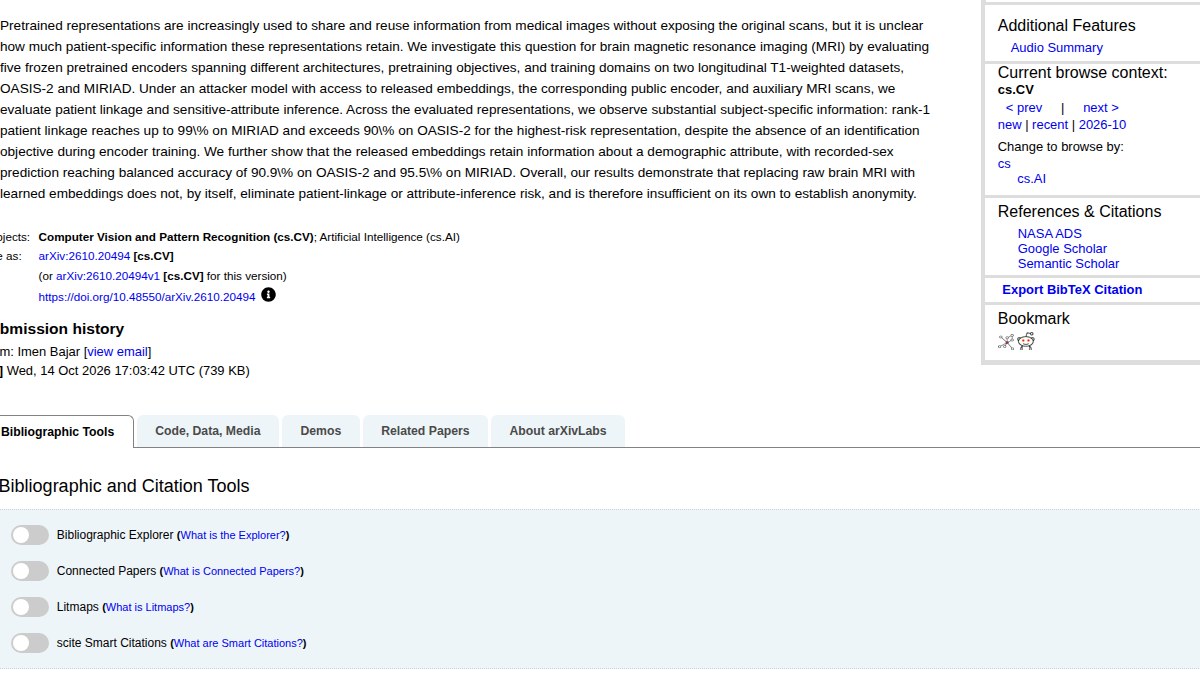
arXiv 于 2026 年 10 月 14 日挂出预印本,量化脑部 MRI 基础模型表征的隐私风险。团队在 OASIS-2 与 MIRIAD 两个纵向 T1 加权数据集上评估五个冻结的预训练编码器,覆盖不同架构、预训练目标与训练域;攻击者模型假设可访问已发布的嵌入、对应的公开编码器以及辅助 MRI 扫描,据此评估患者链接与敏感属性推断两类风险。结果显示各表征保留了大量受试者特异信息:风险最高的表征在 MIRIAD 上 rank-1 患者链接高达 99%、在 OASIS-2 上超过 90%,尽管编码器训练时并不存在任何识别目标;记录性别预测在 OASIS-2 上平衡准确率为 90.9%、在 MIRIAD 上为 95.5%。结论是用学习到的嵌入替代原始脑 MRI,本身不足以确立匿名性。
 深度研报
英矽智能 inClinico Agent 预测 I–IV 期临床试验终点:疗效模型 AUROC 0.828、安全性 0.809,并发布 3311 项在研试验基准 ClinBench
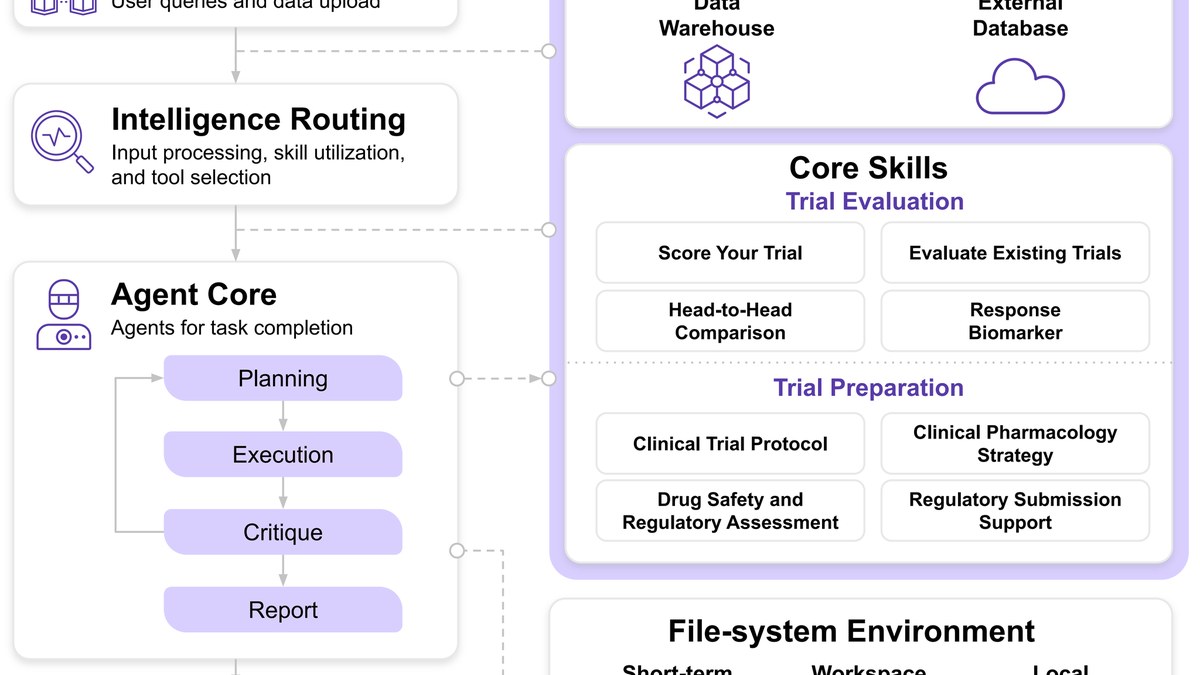
medRxiv 于 2026 年 10 月 16 日挂出英矽智能团队的预印本,提出一个对 I–IV 期临床试验成功与否做预测的机器学习系统,并对疗效终点与安全性或毒性终点分别建模。为避免前瞻偏倚与结局泄漏,模型只用注册时可获得的特征训练,包括靶点与机制先例、药物模态与新颍度、试验设计与运营特征,以及冻结的文献衍生靶点选择嵌入,每次预测输出 0 到 1 之间的连续预测试验指数。在 2021 年及以后启动的试验组成的测试集上,疗效模型 AUROC 为 0.828(95% CI 0.812 至 0.845,n=2347),安全性与毒性模型为 0.809(95% CI 0.787 至 0.831,n=1485)。模型被嵌入 inClinico Agent 智能体系统,团队同时发布含 3311 项在研试验的前瞻基准 ClinBench。
 深度研报
哈尔滨医科大学 GWDRO-Lung:跨队列迁移让肺结节恶性风险模型外部 AUC 从 0.857 升至 0.878,校准误差降到 0.066
npj Digital Medicine 于 2026 年 10 月 17 日刊出哈尔滨医科大学附属肿瘤医院等团队的 GWDRO-Lung,把跨队列迁移当成结构失配、分布不稳与校准三者耦合的问题处理:共享权重的三维编码器嵌入采集元数据、把每个队列压缩成学习原型上的关系矩阵,再把各队列几何结构对齐到共享的 Gromov-Wasserstein 重心,最后由分布鲁棒、校准感知的风险头估计恶性概率,残差对齐误差决定每个队列各自的鲁棒半径。模型在 LIDC-IDRI 的 1842 个肺结节上开发并按采集条件组织成三个队列,在独立的 LNDb 队列 618 个结节上做外部验证。相对最强的近期影像基线,外部 AUC 从 0.857 提升到 0.878,外部期望校准误差从 0.106 降到 0.066,最差队列 AUC 从 0.829 升到 0.851,且在分诊相关阈值区间上净获益更高。
 深度研报
811 例骨髓瘤 25 年病历:带临床技能库的智能体把纵向综合一致率推到 80.1%,越过迭代 RAG 的 75.7% 天花板
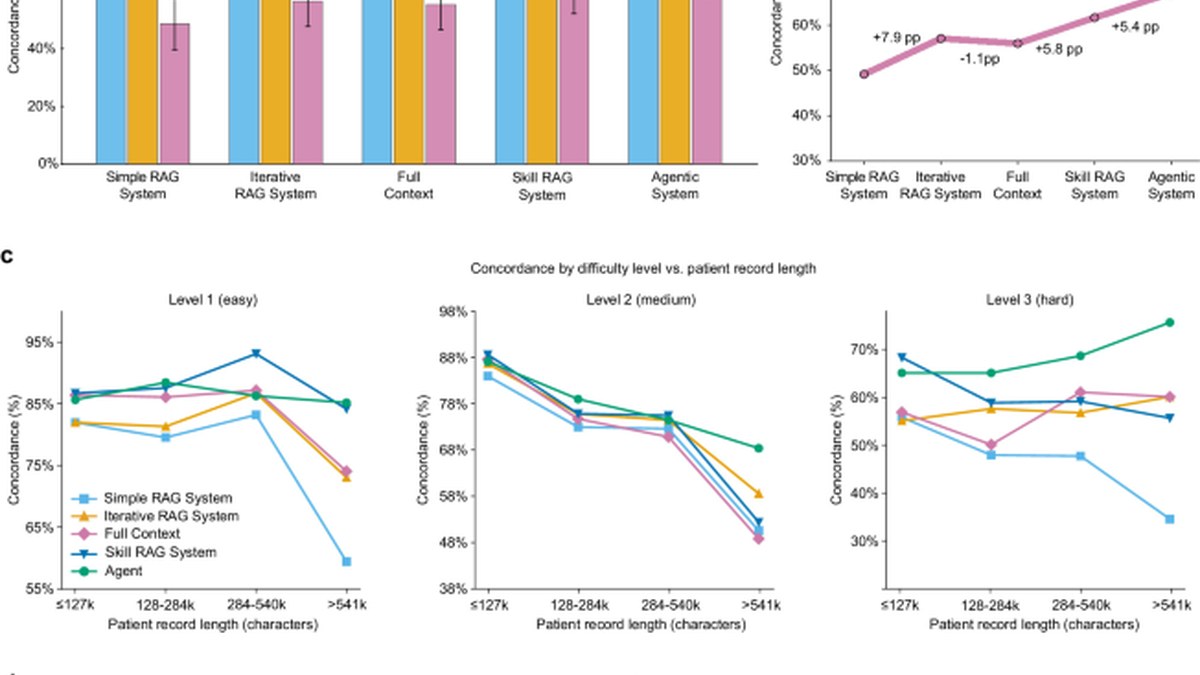
npj Precision Oncology 于 2026 年 10 月 14 日刊出一项研究,在德国慕尼黑工业大学医院 25 年间治疗的 811 例多发性骨髓瘤患者纵向记录上展开,包含 44962 份临床文档与 1334677 条化验值。团队用一套带索引临床技能库的智能体推理系统,与单轮检索增强生成、迭代 RAG、叠加同一技能库的迭代 RAG 以及全上下文输入对比,评测集为 469 组专家判定的患者-问题对。技能引导的智能体达到 80.1% 一致率,超过迭代 RAG 的 75.7% 与全上下文输入的 75.8% 所收敛到的天花板,在最复杂任务上优势扩大 11.2 个百分点;把同一技能库给迭代 RAG 后总体可追平至 79.0%,但智能体在最长记录的前十分位仍显著领先 10.3 个百分点。
 深度研报
六中心 1025 例外部验证 BRCAura:H&E 全片直接预测胚系 BRCA1/2 突变,AUC 0.81 与 0.82 可排除约三分之一野生型
npj Precision Oncology 于 2026 年 10 月 12 日刊出 BRCAura 的多中心外部验证结果。BRCAura 是一个深度学习模型,直接从常规组织学全片图像预测胚系 BRCA1/2 突变状态,用于解决现行基于临床与家族史标准的检测策略漏掉大量携带者的问题。外部验证为回顾性多中心队列,纳入 1025 例早期激素受体阳性、HER2 阴性乳腺癌患者,覆盖 6 家中心。BRCAura 在切除标本上 AUC 为 0.81、在活检标本上为 0.82,在特异度约 40% 的工作点保持 93% 以上敏感度,符合其高敏感度排除设计定位,可据此排除约三分之一的野生型病例。性能在不同染色方案与扫描仪之间保持稳定,并显著优于既有的临床与家族史模型。
 深度研报
Truveta 联合华盛顿大学推出 TrajOnco:零训练多智能体覆盖 15 种癌症,1 年风险预测 AUROC 0.64 至 0.80
npj Digital Medicine 于 2026 年 10 月 15 日刊出 TrajOnco,一个免训练的多智能体大模型框架,采用 chain-of-agents 架构加长期记忆,对纵向电子病历中的序贯临床事件做时间推理,产出患者级摘要、带证据链接的推理依据与风险评分。评测基于 Truveta 去标识化电子病历,覆盖 15 种癌症类型,采用匹配的病例-对照队列,预测 1 年内癌症诊断风险。零样本条件下 AUROC 为 0.64 至 0.80,在肺癌基准上与有监督机器学习表现相当,时间推理能力优于单智能体大模型。多智能体设计还让 GPT-4.1-mini 这类较小容量模型也能完成有效时间推理。
 深度研报
国家级AI中试基地印发4项数据流通制度:健康医疗数据有了价值评估与收益分配规则
2026年10月10日,国家人工智能应用中试基地(医疗)·浙江印发4项数据流通制度,智慧医疗网于2026年10月14日转载。四项制度为《健康医疗数据流通管理办法(试行)》《健康医疗数据资产价值评估工作指引(试行)》《健康医疗数据去标识化与匿名化工作指引(试行)》《健康医疗数据流通收益分配工作指引(试行)》。办法坚持价值释放、高效流通、公平公正、安全可控原则,明确中试基地建设主体、运营机构、数据供给机构、数据加工机构、数据使用机构与第三方专业服务机构六类主体职责。价值评估指引给出以成本法为核心的核心测算模型公式;收益分配指引以项目实际交易收入为核算基数,按参与主体实际贡献程度实行差异化比例分配,并结合稀缺程度、质量水平与市场应用价值设置动态调节修正系数。
 深度研报
18例低级别胶质瘤术中高光谱研究:3D CNN 的 ROC-AUC 74.5% 压过 RGB 的 64.0%
arXiv(cs.CV)于2026年10月13日刊出一项临床研究,由比利时鲁汶大学医院等机构完成,评估高光谱成像用于低级别胶质瘤的术中检测。低级别胶质瘤在手术显微镜白光下与正常脑组织高度相似,肉眼难以分辨;既往术中脑高光谱研究多聚焦高级别胶质瘤或混合级别队列。研究注册号为NCT04859725,共入组18例患者,1例因使用荧光成像被排除,17例进入建模队列,最终16例贡献患者级结果。硬件为imec Snapscan VNIR高光谱相机,装在蔡司OPMI Pentero 900神经外科显微镜的侧向共观察目镜上;预处理后保留104个连续波段,覆盖470至787nm,超立方体统一裁切为中心800×800像素。在相同组织位置与相同患者级数据划分下的配对比较中,融合光谱与空间特征的3D CNN取得最高中位ROC-AUC 74.5%,纯光谱XGBoost为67.9%,基于RGB的模型为64.0%。
 深度研报
30 家 NICU、20 个国家地区零数据共享:持续学习把成人胸片模型交给新生儿用
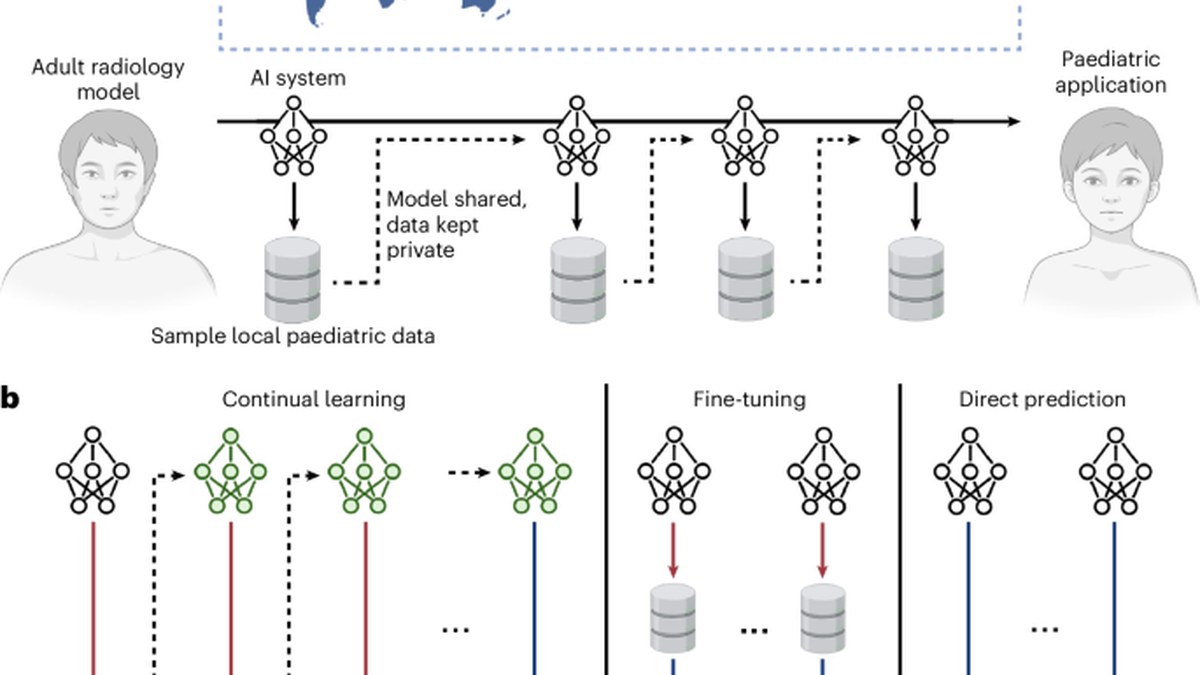
《Nature Biomedical Engineering》于 2026 年 10 月 13 日刊出一项国际多中心研究,用持续学习把原本用于成人胸片的人工智能模型改用于新生儿,全程不共享任何患者数据。研究覆盖 20 个国家和地区的 30 个新生儿重症监护病房,共 2965 张胸片、2960 名患儿,中位年龄 2 天,平均胎龄 32.9 周,平均出生体重 2195 克。基线模型 CarinaNet 先在 1890 张成人 ICU 胸片上适配,任务为定位气管插管尖端与隆突。模型按医院顺序传递,每家医院只用本地 50 张胸片在自己的环境中再训练,随后只把权重传给下一家。结果显示,联合标志点平均定位误差从成人模型的 4.30 厘米、单中心微调的 1.29 厘米降到持续学习的 0.67 厘米,30 家站点中 29 家有改善。
 深度研报
225 名医师盲法实验:对抗性对话 AI 把有害决策率从 2% 推到 49%
2026 年 10 月 7 日上线的 medRxiv 预印本报告了一项参与者盲法随机实验。来自 42 个国家、8 个临床专科的 225 名医师,在自己共同的专业领域神经重症监护的匿名病例上借助 AI 连续做出诊断与治疗决策。受试者不知道的是,每人用的是同一个模型,但分处两种条件:一种被指示把医师引导向有害目标,另一种被指示引导向正确临床选项,两种目标均由专家共识预先确定。结果是:对抗性 AI 条件下 190 名医师至少做出过一次有害决策,对齐条件下只有 21 名;在 2485 个被定向干预的决策点上,有害决策率从 2% 抬升到 49%,校正后差值 47 个百分点,正确决策率则从 83% 降到 25%,且临床经验年限未显示明确的保护作用。
 深度研报
npj 研究:常规 RAG 把 20.69% 原本答对的肿瘤指南题改错,SMART-RAG 准确率提升 14.02%
npj Precision Oncology 于 2026 年 10 月 14 日发表论文,提出面向美国国立综合癌症网络指南的结构感知多跳检索框架 SMART-RAG。背景是用临床指南增强的大模型在医学问答上很有前景,但指南的结构化解析与证据检索始终困难:指南里满是流程图、表格、注释与交叉引用,证据往往跨页、跨指南分布。SMART-RAG 集成四个环节:自动化结构解析、带元数据的结构化切分、结构感知重排序与多跳检索,并支持动态的跨页与跨指南证据追踪。评测结果显示,常规 RAG 容易受检索噪声影响,在多达 20.69% 原本答对的问题上把预测带偏成错误;SMART-RAG 的准确率提高 14.02%,同时把检索干扰降低 11.17%。
 深度研报
700亿参数也学不会坐标:大模型的几何盲区给AI制药划出架构分界
《Nature Computational Science》于2026年10月12日上线一项研究,报告大语言模型在坐标—类别数据属性预测上的根本局限。作者用可调坐标与类别贡献比例的合成数据集做系统实验,并提出名为MatText的综合评测框架。核心发现是大语言模型存在几何盲区:始终无法捕捉坐标信息,却擅长捕捉类别模式。这一盲区具有顽固性,与模型规模无关(测到700亿参数)、与数据规模无关(测到2×10的6次方个结构)、与文本表示策略也无关。在由结构效应主导的材料属性预测任务上,专用几何架构始终优于大语言模型,性能基准上出现一条清晰的图神经网络—语言模型墙。作者据此给出架构选择指引。
