4,999例南非成人死亡口头尸检:纳入自由文本叙事后,死因归因top-1准确率比现行InSilicoVA提高8.5–15.9个百分点
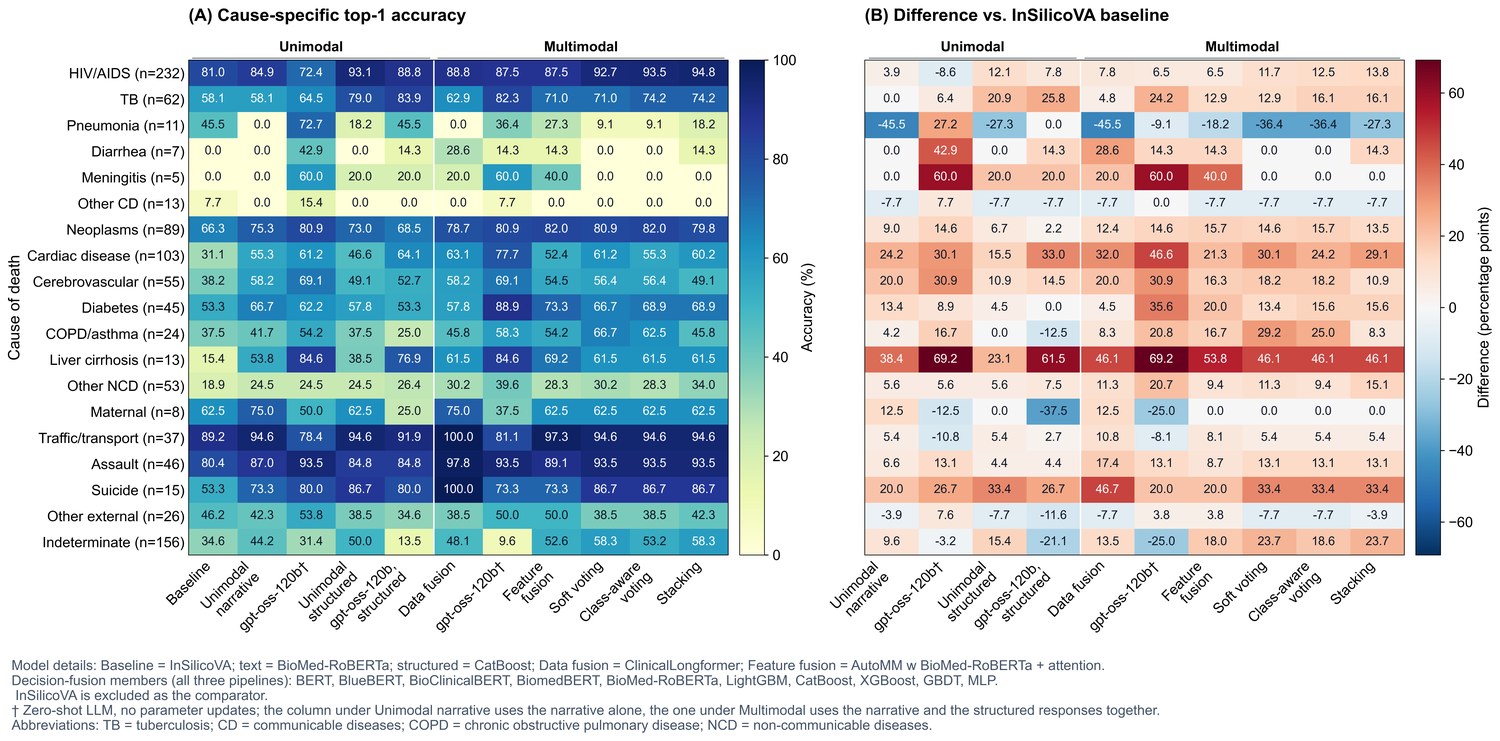
medRxiv于2026年10月16日上线预印本:南非全国登记死亡抽样中4,999例12岁及以上死亡的口头尸检记录,以医师判定死因为参考标准。所有监督式管道相对现行工具InSilicoVA的top-1准确率提高8.5–15.9个百分点,死因别死亡构成(CSMF)准确度提高3.5–7.1;特征融合CSMF准确度最高,达95.7%。零样本大模型平衡准确率最高60.6%,但CSMF准确度低于InSilicoVA。增益在全部9个留出省份成立。
影响分析 × 监管与合规专家 | 数据视角 × AI技术供应商/创业者 | 深度研报
全球每年约5500万例死亡中,非洲不足10%拥有医学证明的死因,口头尸检是中低收入国家判定人群死因的主力工具。2026年10月16日上线medRxiv的一项预印本用南非全国登记死亡抽样中的4,999例成人死亡验证了一件事:长期被算法丢弃的自由文本叙事可以用起来。所有监督式管道相对现行工具InSilicoVA的top-1准确率提高8.5至15.9个百分点,死因别死亡构成准确度提高3.5至7.1。
开场:4,999例南非成人死亡口头尸检,把自由文本叙事正式纳入死因归因
口头尸检天生就是多模态的。受过训练的访员向照护者或近亲询问死者临终前的情况,产出的既是一份由离散症状答案构成的结构化问卷,也是一段记述病史、病情演变、就医经过与死亡情境的自由文本叙事。医师判定死因时会同时读这两部分,但大规模生成死亡统计的算法,例如InSilicoVA与InterVA,是为结构化答案设计的,出现在它们之前的自然语言处理技术尚未成熟。结果是,只要一个地区采集了叙事文本,这些信息就只流向医师,而在规模化方法中被整段丢弃。这套分工有其现实来历:医师复核认可度高,却慢、贵、难以复现与规模化,而自动化算法便宜、可复现、可扩展,只是先天缺少读叙事的能力。这项由俄亥俄州立大学Yue Chu、Samuel J. Clark与密歇根大学Zhenke Wu、华盛顿大学Tyler H. McCormick、加州大学圣克鲁兹分校Zehang Richard Li共同完成的研究,正是要测出这段被丢弃的文本究竟值多少个准确率百分点。
方法与数据:以医师判定死因为参考,叙事、结构化问卷与三层融合管道同台比较
样本来自南非全国登记死亡抽样,覆盖2017年9月至2018年4月登记的27个亚区,最终纳入4,999例12岁及以上死亡的口头尸检记录。参考标准为医师判定死因,由75名医师独立复核并经裁决形成ICD-10编码结果,再归并为19类死因。作者在此之上训练了三类管道,分别是仅用自由文本叙事微调的预训练语言模型、仅用结构化问卷的机器学习模型,以及两者在数据层、特征层与决策层的融合版本;此外还用本地部署的生成式大模型在不更新参数的前提下对同样的单模态与多模态输入做零样本提示。所有管道都与代表现行自动化实践的InSilicoVA对照,评估覆盖个体级归因、人群级一致性、校准与跨省泛化四个维度,作者明确不按任何单一指标给管道排名。
主终点数字:top-1准确率提高8.5–15.9个百分点,CSMF准确度提高3.5–7.1
主终点的表述方式是相对增量而非绝对值,这一点很重要。所有监督式管道相对InSilicoVA的top-1准确率提高8.5至15.9个百分点,代表模型为BioMed-RoBERTa的62.1%与CatBoost的64.1%,对照基线InSilicoVA为53.6%。这里有两组指标需要分清:top-1准确率衡量的是个体归因是否判对,CSMF准确度衡量的是人群死因构成是否被还原,二者可以同时被报告却不必同向改善,后文会看到它们确实分道扬镳。人群层面同步改善,全部监督式管道的CSMF准确度提高3.5至7.1,其中融合策略的表现最优。校准也是被单独核过的一项:监督式管道的类别期望校准误差落在0.010至0.025之间,低于InSilicoVA的0.035,意味着这类模型给出的概率更接近真实发生情况。泛化方面,增益在全部9个留出省份均成立,包括每一省的top-1比较以及几乎全部的宏F1与CSMF比较,省份内部的地区差异没有抹掉这个结论。
影响与数据双视角:63.9%预测一致,11.6%仅叙事管道判对、13.6%仅问卷管道判对
最有价值的发现是两种模态并不重复而是互补。总体上看两种管道表现相当,但当逐例比对时,63.9%的死亡得到完全相同的预测,11.6%只有叙事管道判对,13.6%只有问卷管道判对,且分化有明确方向:叙事管道对非传染性死因更准,问卷管道对传染性死因更准。对做产品的人来说,这意味着叙事不是问卷的替代品而是一条增量通道,两者合力才能覆盖完整病谱。融合策略的收益也按层次分化明显:决策融合相对单模态带来4.2至5.4个百分点的top-1提升,但增量集中在最常见死因;带跨模态注意力的特征融合则改善罕见死因,平衡准确率提升6.6(95%CI 1.7至11.5)、宏F1提升5.5(0.6至10.3),并取得最高的CSMF准确度95.7%。选型时应先问输出给谁用,是要个体的准确判定还是要人群构成的准确还原。零样本大模型的分化同样鲜明:gpt-oss-120b在个体级指标上超过InSilicoVA,取得所有管道中最高的平衡准确率60.6%,但CSMF准确度反而比InSilicoVA低2.9至4.0,擅长罕见死因而弱于还原人群分布。
冷静观察:预印本未经同行评审,单国数据,融合增益置信区间包含0
读这份报告需要保留三处余地。第一,它是2026年10月16日上线的medRxiv预印本,尚未经同行评审,数字与表述都可能在正式发表时调整;用作参照标准的医师判定死因本身也并非无误差的金标准,两位医师给出不同结论的情形在口头尸检中并不罕见。第二,数据来自单一国家南非,且限于12岁及以上死亡,跨国外推与向儿童死亡的外推都需另行验证,作者在结论中也明确把外部验证列为下一步。第三,融合相对较优单模态的配对差异在负0.2到正3.4个百分点之间,且所有区间均包含0,作者因此把它定性为方向性而非确认性增益,并刻意不按任何单一指标给管道排名。此外,研究没有评估把叙事纳入常态化采集后对死亡登记系统运行成本与时效的影响,而这恰是决定一项技术能否真正进入公共卫生常规流程的关键一环。
原文链接:medRxiv 预印本
千方医数集编辑部 出品
