FDA批准的肺栓塞AI在67869例真实世界CT中敏感度跌破审批基准,亚段栓塞降至72.9%
一项纳入67869例CT的肺栓塞AI真实世界研究显示,已获FDA批准的算法在临床实际使用中的敏感度,跌破了当初审批时的基准水平。其中30678例CT肺动脉造影与37191例增强CT构成对照,亚段栓塞的检出敏感度降至72.9%——而亚段栓塞恰恰是临床最需要AI辅助、也最容易漏诊的一类。审批基准与真实世界表现之间的落差,正在成为监管方与医院共同面对的新问题。
数据视角 × AI技术供应商/创业者 | 事实报道 × 医院信息化/临床医生 | 深度研报
肺栓塞是心血管死亡的主要原因之一,漏掉一次可能就是一条命。一款拿到FDA批准的AI,审批材料里的成绩单相当漂亮。可当研究者把它放进17家医疗机构、67869例真实CT里重新考一遍,敏感度跌破了审批基准,其中最容易漏的亚段栓塞只剩72.9%。审批时的考卷和临床里的病人,到底差在哪儿?
开场:审批基准与真实世界之间的那道缝
可以这样理解这件事。一款AI软件要拿到FDA批准,走的是510(k)这条路:申办方提交一批测试数据,证明自己在这个任务上足够可靠。这批数据通常由申办方准备,经过挑选——图像质量过关、病例标注清楚、阳性比例合适。
临床里发生的完全是另一回事。凌晨三点的急诊CT可能来自体型偏大的患者,呼吸伪影明显;门诊那张增强CT本来是查肝脏的,谁也没想到会扫到肺动脉里的栓子。前者是考卷,后者是日常工作,两者的难度分布不一样。
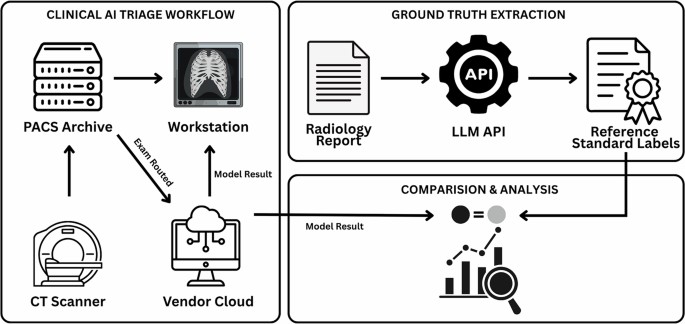
Emory University School of Medicine(埃默里大学医学院)放射与影像科学系牵头的这项研究,就是把两套标准放在一起比。研究在一个覆盖17家医疗机构的学术医疗系统内,回顾性评估了两款已获FDA批准的算法,两款出自同一商业平台Aidoc Medical BriefCase:一款用于专用CT肺动脉造影(CTPA)上的肺栓塞分诊,另一款用于常规增强CT上的偶发肺栓塞(iPE)检出。成果发表于npj Digital Medicine,2026年10月21日上线。
67869例CT给出的答案:敏感度跌破基准
两款模型加起来考了67869例CT:30678例专用CT肺动脉造影,加上37191例常规增强CT对照。规模的意义在于,它大到足以让审批材料里那些被平均掉的问题浮出水面。
参考标准怎么来的也值得说一句。研究者没有让人一份份重新标注,而是用一套经过验证的大语言模型流程从放射科报告里抽取标签,准确率97%,一致性κ=0.94。这是一条工程上高效、但对数据从业者更有启发的信息:真实世界评估的瓶颈,正在从「有没有模型」转向「有没有可信的标签」。
结论是这样的。
肺栓塞分诊模型:敏感度86.8%,特异度99.1%。偶发肺栓塞检出模型:敏感度73.5%,特异度99.8%。
原文给出的判断更直接:两款模型的敏感度都低于FDA审批基准,特异度则超过了获批时的水平。把这句话拆开看,AI在真实世界里变得「更保守」了——它很少误报,但会放过一些真阳性的病例。对肺栓塞这种漏诊代价极高的病,方向的偏离比数值的偏离更值得警惕。
亚段栓塞72.9%:最需要AI的地方反而最弱
肺栓塞按位置分几档:骑跨在肺动脉主干分叉处的是鞍状栓塞,往下是肺叶、肺段,再往下才是亚段。越往下,血管越细,栓子越小,人眼越容易漏。
而AI的表现,恰好沿着这条路径一路下滑。
鞍状栓塞敏感度99.3%,一路降到亚段栓塞的72.9%;急性肺栓塞89.7%,非急性降到65.3%。
这个梯度的形状很关键。它说明模型并没有学会某种人类不具备的识别能力,而是复现了人类读片者的困难结构:靠中心、典型、对比度高的病灶它抓得住,靠外周、不典型、非急性的它一样吃力。研究者自己的表述是:外周与非急性栓子上性能的衰减,与已知的人类读片者局限如出一辙。
这恰恰是最需要AI补位的地方。亚段栓塞诊断争议大、漏诊率高,临床上正是指望AI当第二双眼睛。结果是,在最需要它的那一档,它给出的敏感度是72.9%——每四个亚段栓塞,大约有一个会被放过。
对供应商与创业者,这里有一个具体的产品含义:整体敏感度这个数字会骗人。一款在鞍状栓塞上接近满分的产品,只要人群里亚段占比高,真实世界表现就会被拉下来。分层报数不是可选项,而是产品说明书的一部分。
这里也要说清边界。这是回顾性研究,标签由报告抽取而非统一的前瞻判定生成;数据来自单一学术医疗系统、单一商业平台的两款算法,换成别的厂商或别的地区未必成立。作者声明未获得专项资助,Aidoc提供了聚合预测输出,但未参与研究设计、数据分析、结果解读或文稿撰写——这些是评估时必须记录的背景。
冷静观察:真实世界性能该不该触发重新审评
先给一个明确判断:单次研究结果不足以触发重新审评,但足以改变采购与监测的默认动作。
从数据链路看,最值得记的是方法本身。用经过验证的LLM流程从放射科报告里抽标签,把真实世界评估的边际成本压到了可以常做的水平。过去上市后监测做不动,卡点一直在标注成本——要评价几万例,就得有几万例的金标准。这条路一旦走通,监测就从「偶尔做一次」变成「可以持续做」,而持续监测恰恰是捕捉性能漂移的唯一手段。
从合规角度看,争议点在于落差的性质。特异度超过基准、敏感度低于基准,两者不是同一类问题:误报多会让医生产生警报疲劳,漏报多会直接危及患者。对肺栓塞分诊这类用途,漏报的方向性风险远大于误报。现行审批给出的是一个静态基准,而真实世界性能是一个随时间、随人群、随设备漂移的变量,两者之间本来就存在结构性错配。作者的呼吁也落在这里:需要为AI赋能的医疗器械建立标准化的上市后监测。
落到医院一侧,两件事现在就可以做。其一,把分层性能写进采购验收条款——按栓子位置、按急慢性分别约定敏感度下限,而不是只谈一个总数;本院的急诊构成决定了这个分布,厂商的平均数回答不了。其二,把本院的AI预警与最终诊断做常规比对,用报告抽取这类低成本方法跑自己的监测曲线,一旦敏感度连续下滑就触发复评。审批基准回答的是「能不能上市」,真实世界性能回答的是「在谁手里、在哪种病人身上可靠」——后者不是前者的补充,而是另一套必须独立运行的度量。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
