换家医院AUC从0.90跌到0.60:22445次前列腺MRI跨国验证揭示泛化落差
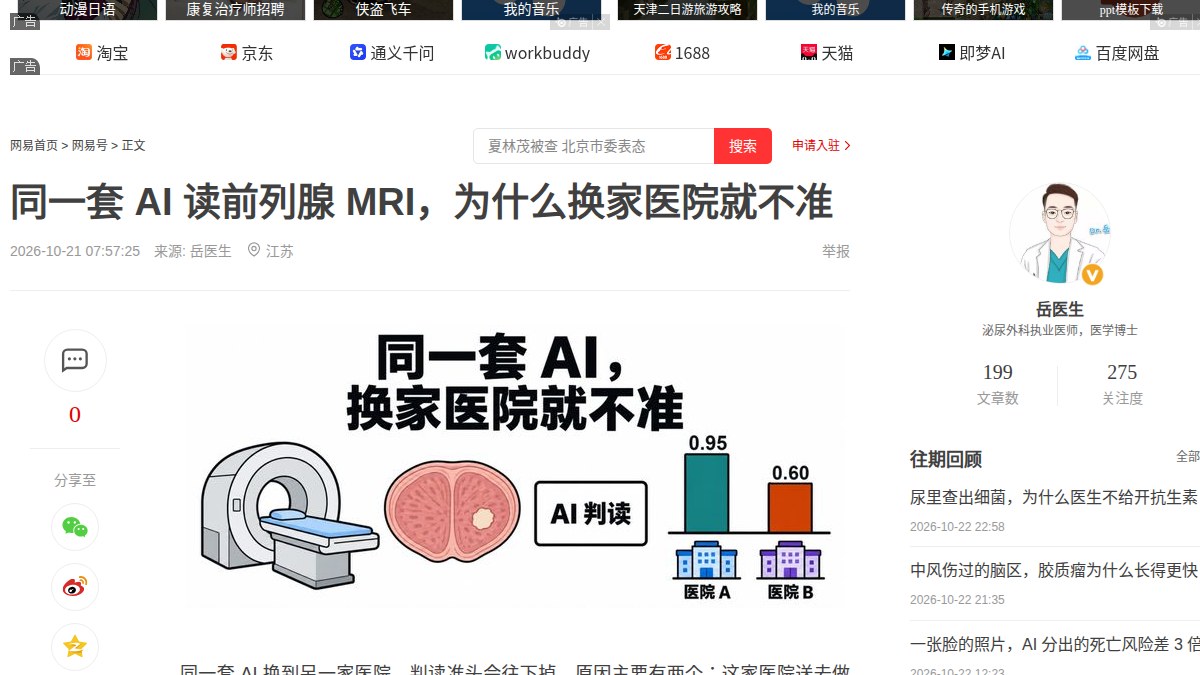
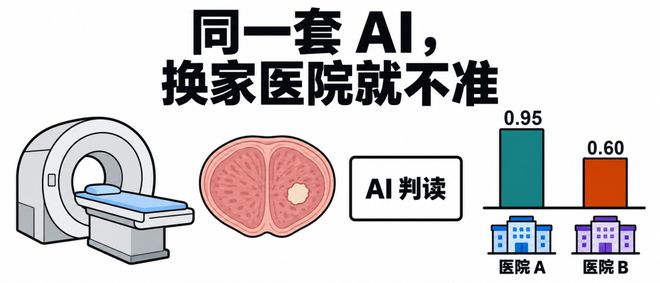
一项覆盖46座城市、22个国家的前列腺MRI跨国验证研究给出了一组不那么好看的数字:同一套AI模型在不同医院的表现,AUC从0.90以上的高水平跌到0.60至0.70区间。研究纳入22445次前列腺MRI检查、21252名男性,是目前该领域规模最大的多中心外部验证之一。对准备采购影像AI的医院来说,这组数字把「泛化能力」从论文里的术语,变成了可以直接写进招标条款的硬指标。
影响分析 × 医院信息化/临床医生 | 数据视角 × 医疗数据从业者 | 深度研报
一套AI模型在论文里拿到0.90以上的AUC,换家医院只剩0.60到0.70,中间没改一行代码。《放射学》2026年10月13日在线发表的SCARLET-1研究,动用22445次前列腺MRI、21252名男性、46座城市22个国家的数据,量出了这道落差。对准备采购影像AI的医院,泛化性由此从论文术语变成了可写进验收条款的硬指标。
开场:泛化性不再是论文里的术语
SCARLET-1给出的整体判断并不难看:三个外部队列上,这套AI与标准诊疗诊断的一致率,分别高出推导出的平均放射科医生15.5、13.3和14.9个百分点,全部达到预设的可互换标准。真正让人停下来的是拆开之后的分布。
采购逻辑长期建立在一个隐含假设上:厂家拿出的验证成绩,可以代表这套软件在自己医院的表现。25家中心从0.60排到0.95以上,这个假设不成立。
数据规模:22445次MRI、21252名男性、46城22国
- 总量:22445次前列腺MRI检查、21252名男性,覆盖46座城市、22个国家
- 人群特征:临床怀疑前列腺癌的成年男性,检查时间为2012年1月至2024年10月,中位年龄66岁,中位PSA 7 ng/mL
- 训练与内部测试:20471次检查,来自26座城市、14个国家
- 外部测试:1974人,来自20座城市、12个国家,挂在三项既有试验上
- 三项试验患病率差近八倍:PRIME为诊断场景476人、有临床意义癌占30%;STHLM3-MRI为瑞典人群筛查1108人、占17%;IP1-PROSTAGRAM为英国人群筛查390人、仅占4%
判定终点是Gleason分级分组2级及以上,即Gleason评分3+4及以上。1级癌生长慢、指南多走主动监测,AI报出1级病灶不算命中——这埋下了后面解释落差的伏笔。
核心落差:AUC从0.90以上跌到0.60至0.70区间
内部测试先给出第一道缝隙。4家三级医院的标准化数据上,AUC是0.92(95% CI 0.90–0.94);22座城市拼起来的异质数据上,AUC是0.84(0.82–0.87)。同一批权重,光是数据同质与否就差了0.08。
拆到单家中心,落差更直观。
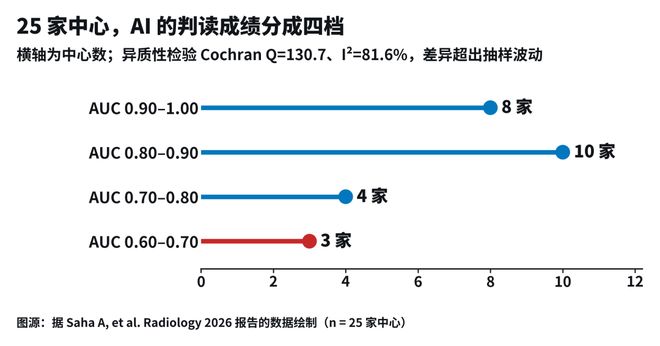
25家中心里,32%(8家)落在0.90到1.00,40%(10家)落在0.80到0.90,16%(4家)落在0.70到0.80,还有12%(3家)只有0.60到0.70。
异质性检验给出Cochran Q=130.7、I²=81.6%:中心之间的高低差已大到无法用抽样波动解释。原文Fig. 2里,广州、河内、安卡拉三家在0.95以上,瓦伦西亚和维尔纽斯两家在0.60附近。
三个外部队列的整体AUC分别是0.86(0.83–0.90)、0.89(0.86–0.92)和0.84(0.70–0.95)。最后一个队列只有390人、15例阳性,置信区间宽到几乎容得下从「勉强可用」到「相当不错」的全部可能。
溯源:扫描协议、人群结构与标注口径三处漂移
第一处漂移在人群结构。作者去查了表现最低的几家中心,看到的是病例构成严重偏斜:92%以上的MRI检查被报为阳性,20%到68%的患者最终诊断是Gleason 1级。AUC衡量的是区分两组人的能力,需要阴阳两侧都有足够人数;一家中心几乎人人报阳性,腾挪空间就被压掉大半。更麻烦的是1级癌在MRI上同样表现为弥散受限的低信号灶,与2级癌差别不大,按终点定义却算阴性,AI圈出来就记成假阳性。表现最高的几家正好相反:有的阳性率低到15%,有的29%到39%是Gleason 4到5级。
第二处漂移在扫描协议。合并外部队列按亚组拆,年龄、种族、癌灶位置、风险分层各组大同小异,AUC从0.82到0.87,平均差异只有0.02。唯一拉开明显差距的是图像质量:
用PI-QUAL第2版逐次打分后,1分(不合格)这一组AUC是0.78(0.68–0.87),3分(最佳)这一组是0.88(0.85–0.91),相差0.10。
这0.10有解剖学上的来由:前列腺MRI判读主要看T2加权像、高b值弥散加权像与ADC图三样信号,高级别癌细胞排列紧密、腺腔消失,水分子动不开,于是在高b值上发亮、在ADC图上发暗。直肠气体与蠕动会在前列腺后部留下伪影,患者动一下会让ADC图模糊——人与AI面对的是同一张不够好的图像。
第三处漂移在标注口径,也就是参考标准。三项试验的参考标准并不一致,组织病理主要来自MRI阳性或风险较高者,多数MRI阴性的人既没穿刺,也没有系统随访确认无病。这是典型的部分验证偏倚:AI与医生各自真实的漏诊率都算不出来。
还有一处口径必须说明:对照用的医生数字并非同期真人读片,而是从PI-CAI观察者研究推导出的「平均放射科医生」,且该值可能偏乐观。所以15.5个百分点不能直接读成「AI比医生强15个点」。
冷静观察:把外部验证结果写进验收条款
先把能说和不能说的分开。能说的是:这套AI在12个国家、20座城市的外部数据上,一致率达到预设的互换标准,且在年龄、种族、癌灶位置、风险分层之间表现稳定。不能说的是:这是回顾性研究,外部测试集用连续病例,而训练集与内部测试集是便利样本;存在部分验证偏倚;医生一侧为统计推导值且可能高估;它也没有回答用了AI之后患者结局是否更好,那需要前瞻性随机试验。研究未涉及中国境内已上市的具体产品。
从数据链路看,三处漂移里有两处发生在医院内部:人群结构由本院的转诊与筛查路径决定,扫描协议由本院的设备配置与技师执行质量决定。这两项是采购方唯一能自主改善、也最容易被忽略的变量。PI-QUAL那0.10的差距意味着,与其在招标里争0.02的模型指标,不如先把图像质量合格率做起来。
从合规与验收看,可操作的动作有三条。
- 要求厂商提供外部验证的分中心原始数据,而不是只给汇总AUC;25家中心从0.60排到0.95的分布,比平均值有信息量得多
- 把本院人群的患病率、Gleason构成、图像质量评分分布,与厂商验证集做对照;差异越大,本地验证越不可省
- 在合同里约定上线后的持续监测指标与复评周期,把「一次性验收」改成「全周期监测」
视角落到采购环节:外部验证成绩应当作为入场券,而不是终点。真正决定这套AI在本院价值的,是它与本院病人构成、成像条件的匹配程度——这一条,任何一家厂商的通用准确率都替你回答不了。
原文链接:Radiology / 网易
千方医数集编辑部 出品
