811 例骨髓瘤 25 年病历:带临床技能库的智能体把纵向综合一致率推到 80.1%,越过迭代 RAG 的 75.7% 天花板
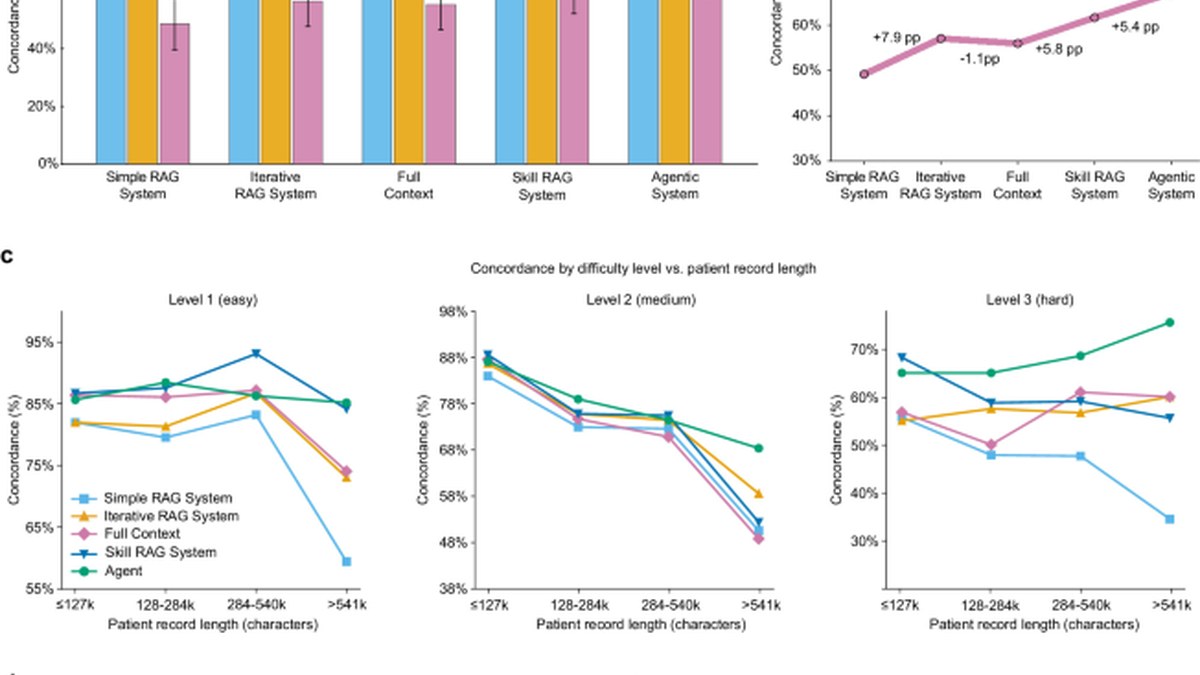
npj Precision Oncology 于 2026 年 10 月 14 日刊出一项研究,在德国慕尼黑工业大学医院 25 年间治疗的 811 例多发性骨髓瘤患者纵向记录上展开,包含 44962 份临床文档与 1334677 条化验值。团队用一套带索引临床技能库的智能体推理系统,与单轮检索增强生成、迭代 RAG、叠加同一技能库的迭代 RAG 以及全上下文输入对比,评测集为 469 组专家判定的患者-问题对。技能引导的智能体达到 80.1% 一致率,超过迭代 RAG 的 75.7% 与全上下文输入的 75.8% 所收敛到的天花板,在最复杂任务上优势扩大 11.2 个百分点;把同一技能库给迭代 RAG 后总体可追平至 79.0%,但智能体在最长记录的前十分位仍显著领先 10.3 个百分点。
811 例骨髓瘤 25 年病历实测:带临床技能库的智能体把纵向综合一致率推到 80.1%,越过迭代 RAG 的 75.7% 天花板
影响分析 × 医院信息化/临床医生 | 事实报道 × AI技术供应商/创业者 | 深度研报
npj Precision Oncology 于 2026 年 10 月 14 日刊出一项研究,在德国慕尼黑工业大学医院 25 年间治疗的 811 例多发性骨髓瘤患者纵向记录上,用一套带索引临床技能库的智能体推理系统处理 44962 份临床文档与 1334677 条化验值,在 469 组专家判定的患者-问题对上达到 80.1% 一致率,越过了迭代 RAG 的 75.7% 与全上下文输入的 75.8% 所共同收敛到的天花板。
开场:811 例患者、25 年、44962 份文档,一道此前没人验过的难题
多发性骨髓瘤以序贯治疗贯穿数年乃至数十年,患者会累积数百份临床文档,任何一次治疗决策都依赖对既往暴露、记录下来的疗效反应与不断变化的合并症的综合,而单份文档无法完整承载这些信息。对单个发现的解读,往往取决于跨越数年的时间关系,每个临床决策点都需要在文档类型与时间点之间做横向综合。这份认知负荷落在血液科医生身上,而他们本就承担着各专科中最高的电子病历负担,并且恰好随那些决策最关键的患者的病历变长变复杂而放大。大语言模型被提出用来分担这一负担,已发表的做法大致分为单轮检索增强生成、迭代 RAG 与在专用工具上推理的智能体系统三类,但它们的验证都集中在答案可从少量文档或数据行中定位的任务上,包括指南解读、事实核验与结构化数据库问答。同一批方法能否推广到更难的情形,即答案必须从多年部分矛盾的非结构化文档中拼装出来,此前一直是悬而未决的问题。已有研究在住院患者任务上观察到两条路线会收敛到难以区分的水平,并把更难测试的缺位归因于缺少专家判定的纵向数据集,面向真实骨髓瘤患者或可类比疾病轨迹的评测也一直未见报道。
对照了四种做法:单轮 RAG、迭代 RAG、全上下文输入与技能引导智能体
在这项研究中,团队把几条路线摆在同一批数据上对打:单轮检索增强生成、迭代 RAG、叠加同一技能库的迭代 RAG、全上下文输入,以及带索引临床技能库的智能体推理系统,共用 469 组由专家判定的患者-问题对作为评测集。临床问题按三个预设复杂度分层,依次是单条记录查询、跨文档或跨时间点的时间推理,以及按临床决策规则(例如治疗资格判定)进行的标准合成,这一分层直接对应真实病历综合的不同难度。数据底座来自德国慕尼黑工业大学医院 25 年间治疗的 811 例多发性骨髓瘤患者的纵向记录,包含 44962 份临床文档与 1334677 条化验值,团队另在 MIMIC-IV 上做了探索性跨数据集评测。对医院信息化与临床科室而言,把复杂度分成三层而不是只报一个总分,是这次评测设计中最值得借鉴的一点,院内选型与验收也应沿用这种分层口径,而不是拿一个平均分数做上线依据。分层还能把失败定位清楚,某一层掉分对应的是调阅、跨年推理还是规则合成能力缺失,改造方向也随之不同。
天花板被越过:80.1% 对 75.7% 与 75.8%,在最复杂任务上扩大到 11.2 个百分点
结果上,技能引导的智能体达到 80.1% 的一致率,越过了迭代 RAG 的 75.7% 与全上下文输入的 75.8% 所共同收敛到的那个天花板。两条路线收敛到几乎无法区分的水平,意味着单靠把检索做多轮,或者干脆把全部文本塞进上下文,都无法再把分数抬上去,瓶颈既不在检索轮次,也不在上下文长度本身。真正拉开差距的是任务难度,在最复杂任务上,智能体的优势扩大到 11.2 个百分点,并且在最长记录上优势最大。这一分布特征对临床场景格外关键,因为认知负荷最重、最需要机器分担的,恰恰是病历最长、轨迹最复杂的那批患者,而正是在这批患者身上,智能体与两种对照路线的差距被放大。换言之,天花板并不是被整体抬高了一点点,而是在最吃力的那一段被顶开了一个口子。对临床侧而言,这提示评估院内智能病历助手时,若只统计整体一致率,很可能漏掉最需要它发挥作用的那部分患者,把分层结果摊平之后,差距会重新被掩盖。
技能库单独给 RAG 会怎样:总体追平到 79.0%,但最长记录上仍差 10.3 个百分点
团队接着拆了一个更现实的问题,如果只把技能库单独交给迭代 RAG 而不改架构,会怎样。答案是总体可以追平到 79.0%,在较短记录上同样追平,说明索引化的临床技能本身是一项可迁移的资产,并不依赖某一种特定推理框架才能发挥作用。但把记录按长度分层之后,差异重新出现,在最长记录的前十分位,智能体仍显著领先 10.3 个百分点,p 值为 0.017;在最复杂问题上,智能体有 5.4 个百分点的数值优势,但未达统计显著。对医疗信息化与临床团队来说,这两组数字的读法应当分清,总体追平意味着日常大多数病例上两种方案的产出差距有限,选型可以更看重成本与集成难度,也说明技能库一旦建好,可以在不同推理框架之间复用,而不必与某一套架构绑定;而最长记录上的显著优势意味着,真正决定工作负荷上限的重症长病程患者,仍需按架构差异而不是按平均分来验收。最复杂问题上那 5.4 个百分点的优势未达统计显著,在样本之外能否复现仍待观察。
冷静观察:12.2% 的错误率接近专家分歧,但临床显著错误占比更高,高风险场景仍需人工复核
落到安全性上,系统总体错误率为 12.2%,与专家之间的分歧 13.6% 相当,这一对比常被读成机器已接近专家水平。但更值得警惕的是错误的性质,系统错误中临床显著的比例为 57.8%,明显高于专家分歧中的 18.8%,也就是说人与人的不一致大多落在无关紧要处,而模型的错误更多落在会影响判断的地方,同样的错误率之下风险分布并不相同。对高风险场景而言,人工复核仍不可省略,尤其在按临床规则合成的第三层问题上。此外,本次数据为单中心回顾性数据,MIMIC-IV 上的评测仅为探索性外验,不能解读为多中心验证结果,结论外推到本院人群时必须保留余量。一个务实的取舍是,先在单条记录查询与跨文档时间推理这类可核验任务上放量,把高复杂度问题留在医生复核闭环内,等本院数据上的分层表现跑出来再决定扩大范围。对血液科这类文档负担本就最重的科室,把机器能力优先投向长病程患者的纵向梳理,保留医生对结论的最终裁定,是当下更平衡的部署次序。
千方医数集编辑部 出品
