AI提升检出却不提升推理:GPT-4助医生76%对74%,模型单独92%
一篇发表于Frontiers in Digital Health的叙述性综述提出了一个尖锐区分:AI提升了医生的「检出率」,却没有同步提升「临床推理」能力。综述汇总9项原始研究,乳腺筛查中AI使检出率从每千人5.0例升至6.4例、工作量下降44.2%,但GPT-4辅助下的医生准确率为76%、仅略高于医生单独的74%,而模型单独表现可达92%。人机组合并未自动等于最优,这个反差值得所有部署临床AI的机构留意。
事实报道 × 监管与合规专家 | 趋势前瞻 × 投资人与产业分析师 | 深度研报
如果一款模型单独答题能拿92分,让医生拿着它一起答,成绩会是多少?答案是76分,只比医生单独作答的74分高出两个百分点。这是Frontiers in Digital Health 10月21日一篇叙述性综述里最扎眼的一组数字。同一批文献里,乳腺筛查AI把检出率从每千人5.0例推到6.4例、读片工作量下降44.2%。一边是提升,一边是停滞——差别不在模型,在任务。
开场:AI帮医生看得更多,却未必想得更准
设想两个诊室。第一个里,放射科医生要读一整天的乳腺筛查片,AI在旁边把可疑区域圈出来;第二个里,内科医生面对一个主诉模糊、检查结果互相打架的病例,GPT-4在旁边给出一份鉴别诊断清单。前者是找东西,后者是想办法。这篇综述提出的区分,就是把这两种能力拆开:AI提升了医生的检出能力,却没有同步提升临床推理能力。
文章题为「Augmentation or erosion? Artificial intelligence and the transformation of clinical reasoning: a critical narrative review」,2026年10月21日发表于Frontiers in Digital Health(Volume 8,Human Factors and Digital Health板块),作者为厄瓜多尔Universidad Tecnológica Indoamérica的José Daniel Sánchez。检索覆盖Scopus、PubMed/MEDLINE、SciELO与LILACS四个数据库,时间为2026年7月与8月,纳入2015年以来的英文、西班牙文与葡萄牙文文献,用改良CASP框架评价9项原始研究。
作者把分析单位定在「医生与系统一起工作」,而不是模型本身。这个选择决定了全文的落点:模型在基准上的准确率,不足以推出使用它的医生会更准。
检出端的收益:每千人5.0例升至6.4例
在感知类任务上,随机对照试验给出的答案是明确的正面。
- MASAI乳腺筛查试验:癌症检出率从每千人5.0例升至6.4例
- 同一试验:读片工作量下降44.2%,间期癌发生率非劣
- 结肠镜:计算机辅助检出(CADe)把腺瘤检出率从40.4%提到54.8%
这两个结果有个共同点:任务边界清晰,标准答案可定义,AI的输出是一圈可疑区域的坐标,医生的判断仍建立在自己看到的图像上。这类任务里,AI更像一张密度更大的渔网——网眼小了,漏网的鱼自然少。
乳腺筛查是少数已有随机对照证据支撑的场景:MASAI同时给出检出率上升、工作量下降、间期癌非劣三项结果。
推理端的停滞:76%对74%,只差两个百分点
换个任务,画面完全变了。在目前唯一一项针对开放式诊断推理的随机试验中,医生可以使用GPT-4,也可以不用。
GPT-4辅助下的医生得分76%,医生单独74%,而模型单独可达92%。
两个百分点,在统计上与临床上都很难称作提升。这组数字把「模型准确率」与「医生借助模型后的准确率」之间的等号彻底打断了。
模型单独92%:人机组合为何没有叠加
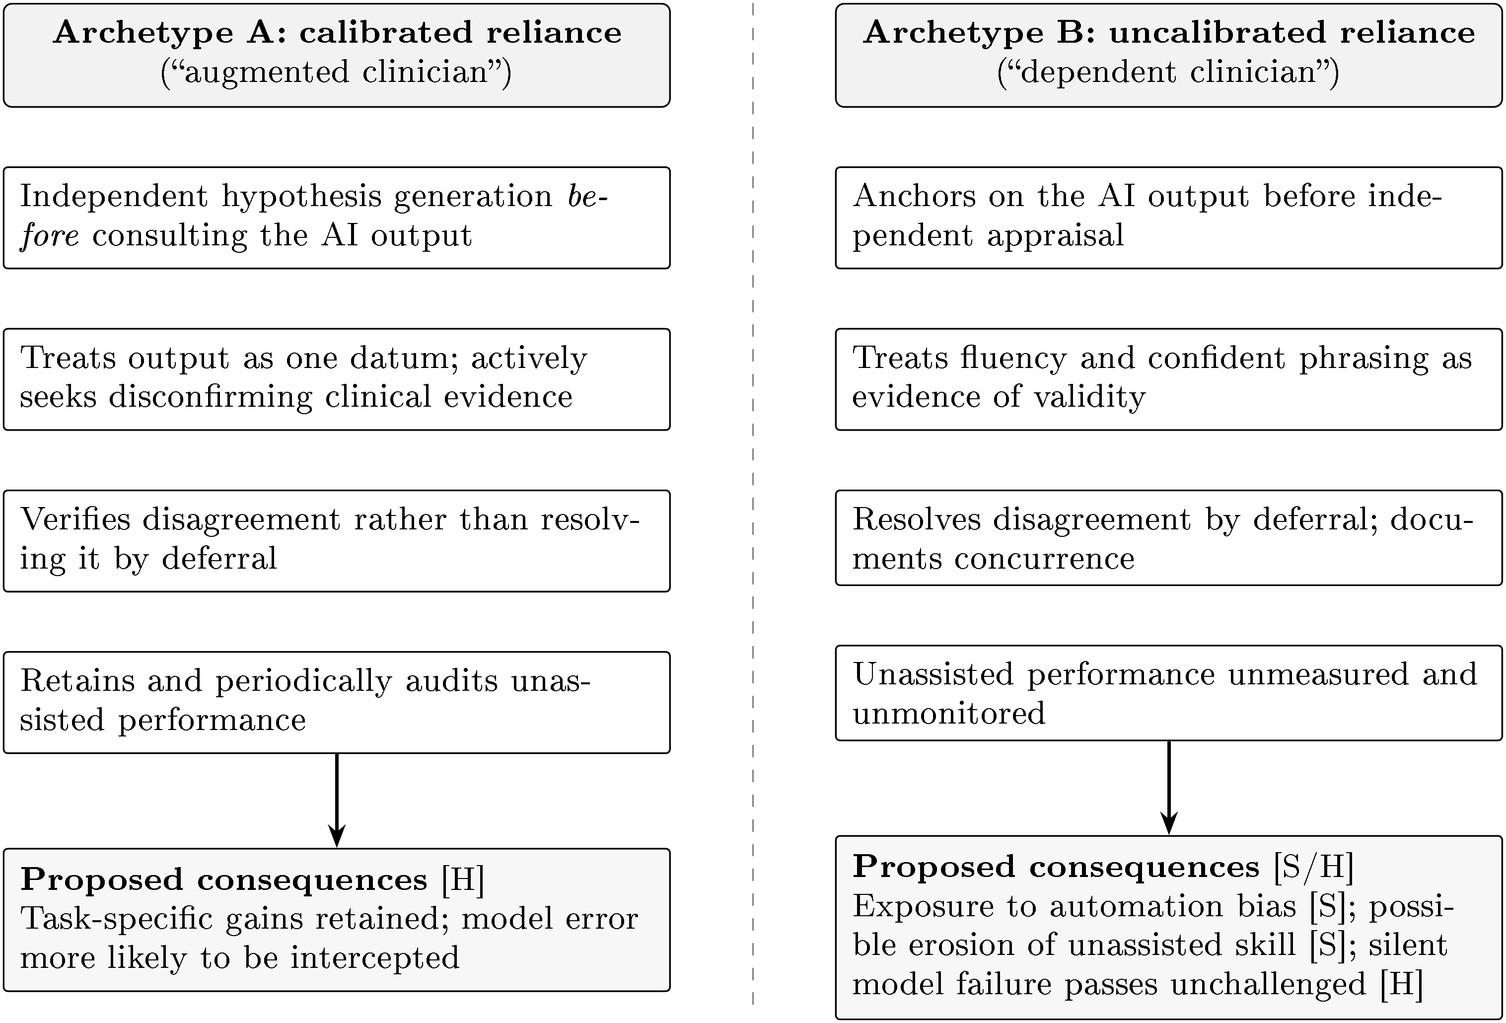
92、76、74三个数字放在一起,指向同一个机制:模型的能力不会自动叠加到人身上,中间要经过「依赖」这一层,而依赖是有损耗的。
综述梳理了四条可能的损害路径:自动化偏差,即医生倾向于默认AI的建议;无辅助状态下技能的流失;模型失效未被察觉;以及人群间的表现差异。证据来自规模较小或非随机的研究:当AI建议错误或AI漏掉癌灶时,读片者准确率明显下降;接受过AI素养培训的医生,仍会被错误的模型建议带偏;一项前后对照研究中,常规使用AI后医生在无辅助状态下的腺瘤检出率从28.4%掉到22.4%;一款已部署的脓毒症模型外部验证区分度很差,AUC仅0.63。
作者自己也强调,这类证据来自单项或设计受限的研究,不足以确定效应的大小与持续性。但它们共同说明:依赖确实会发生,而且不一定朝好的方向。
工作量下降44.2%的另一面
44.2%的工作量下降是这批文献里最容易被转述成好消息的数字,但含义需要放回语境。
MASAI是筛查场景,读片量大、阳性率低、阴性片占绝大多数,AI的价值是把大量不必深看的图像快速筛掉。这类收益可以量化,也确实成立。可工作量下降与推理能力提升不是同一件事:前者是效率,后者是正确性。省下的时间是否转化为更充分的鉴别诊断,目前没有证据支持。
反过来,节省时间也可能意味着更少的独立思考——那条「无辅助腺瘤检出率从28.4%掉到22.4%」的曲线,提示的正是这种可能性。效率收益与能力退化可能来自同一个动作,只考核效率的科室最容易踩进能力退化的盲区。
还有一个地域层面的空白:检索未识别出任何符合条件的拉丁美洲研究。作者所在的区域,恰恰是算法工具通常未经本地临床评估就被引入的市场。这个空白本身就是一个判断——现有证据适用范围有限,跨区域移植前必须本地验证。
冷静观察:把检出与推理拆开评估
先把口径收紧。这是叙述性综述而非系统综述,未做Meta分析、未重复筛选、未使用正式的偏倚评价工具,纳入由作者单人目的性选择;开放式推理的结论目前只来自一项基于病例情境的试验,9项原始研究样本量有限。这些限定决定了它给出的是方向性判断,不是效应量。
从数据链路看,最有价值的是它换掉了评估对象。过去评测的是模型在基准数据集上的分数,这里评测的是「医生+系统」这个组合在工作流里的表现。这一换,对数据的要求也变了:需要的不再只是一份标注好的题库,而是医生在辅助与无辅助两种条件下的配对表现记录,以及AI建议正确与错误两种情形下的分层结果。对医院信息化部门,这意味着上线前就要设计好对照采集方案,否则事后补不出来。
从合规与监管看,结论的落点很具体:不能从模型准确率推断收益,辅助与无辅助下的医生表现必须直接测量。这句话可以翻译成两份文件的要求——注册申报时提交人机组合作业数据,而不是只提交模型独立性能;采购验收时约定分层指标与持续复评,而不是一次性看总分。
趋势上,我们的判断是:临床AI的评估正在从「模型评测」转向「人因评测」,而后者目前几乎没有标准化度量。谁先把「医生+系统」的对照数据做成可复用资产,谁就在下一轮的准入与采购谈判里握有主动权。对产业侧,这同时意味着一个明确分野——感知类任务的红利基本兑现,推理类任务的价值主张尚未被证明,二者的估值逻辑不该继续混在一起。
原文链接:Frontiers in Digital Health
千方医数集编辑部 出品
