即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 1346 个数据集
CPIC — 把基因型翻译成剂量的那一层
132 个基因、324 种药、29 部指南、2,115 条推荐:它不做研究,只做一件事——把文献里的证据定级,然后落成一句「该加量、减量、还是换药」
Rfam — 4,227 个 RNA 家族,每个家族一个协方差模型
十个种子序列、一个协方差模型、一份共识二级结构:Rfam 是 RNA 世界的 Pfam,它不给你序列清单,给你的是「怎么在基因组里找出这个家族」的搜索器
RNAcentral — 六千万条非编码 RNA,四成是 rRNA
60,054,521 条序列、56 个专家库、110 万个物种:它不产生数据,只做一件事——把同一个 RNA 分子在不同库里的十几个编号,归并成一个 URS
NeuroVault — 71 万张脑成像统计图,7.6% 的集合有 DOI
18,020 个集合、715,894 张图、18 个模板图谱:这是全球最大的脑成像「结果图」公共库,存的是 z/t/F 值不是原始影像,也是「拿别人的结论当数据」最容易翻车的地方
Complex Portal — 两万个蛋白复合物,写着每个零件有几个
20,580 个复合物、27 个物种、人类占 2,436 个:这是目前唯一一个把「化学计量」写进数据的蛋白机器目录,也是 STRING 与 IntAct 都缺的那一层
GBIF — 四十亿条物种出现记录,七成七是动物,一成二是公民科学
3,983,162,286 条记录、124,867 个数据集、48,872,354 个物种:这是全世界最大的生物多样性出现记录网络,也是唯一一个靠博物馆标本和手机照片共同撑起来的库
ENA — 八十拍字节的核酸总账,四千万次测序的入口
1,098,568 项研究、55,877,279 个样本、44,433,186 次测序运行:INSDC 欧洲节点,从 1980 年的一条序列长到今天
IMGT — 十二万条等位基因的命名权威,没有 API
12,922 个基因、18,322 个等位基因、42 个物种:从 1989 年起,谁有资格给一个抗体基因命名,归这个库说了算
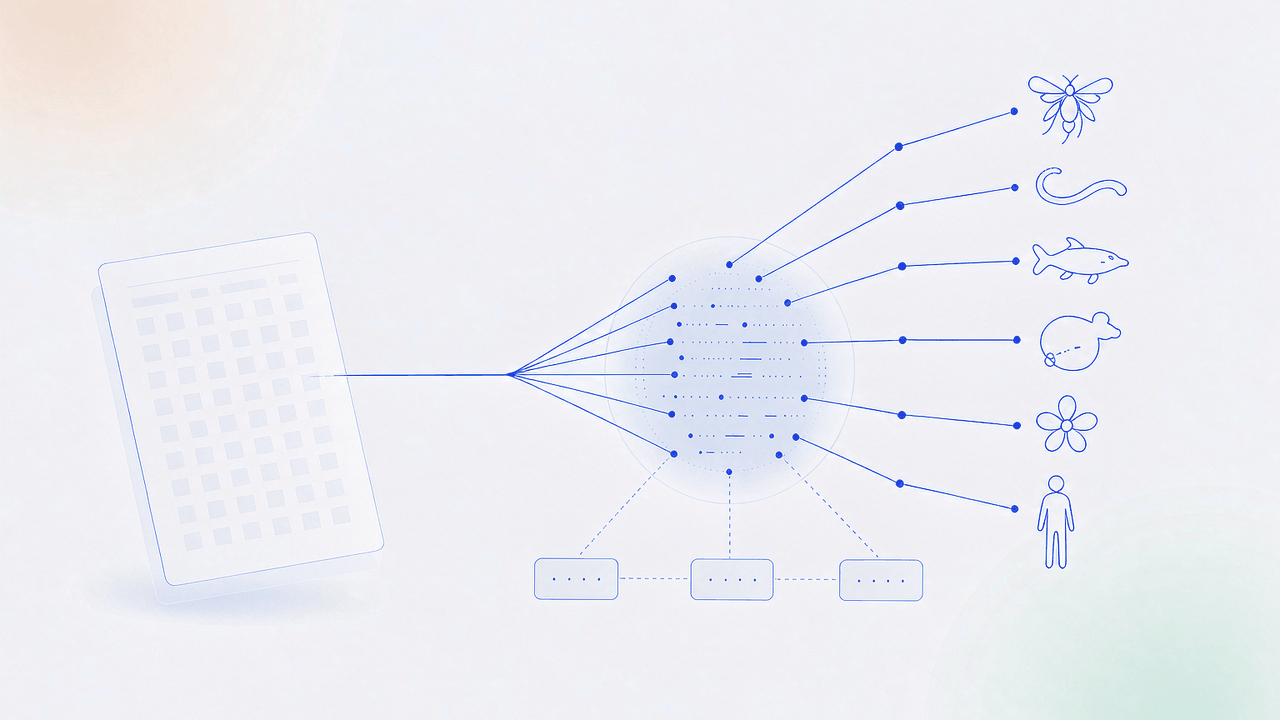
Alliance of Genome Resources — 九物种联盟,五成七是重复行
56,677,795 个实体、1,909,959 条表型注释、23.04 GB 下载:八个模式生物库合并成一个库之后,字段统一了,语义没有
BV-BRC — 一千七百万个病原基因组,九成是病毒
17,061,503 个基因组、89.6 亿条注释特征、8.69 亿条专项基因:NIAID 把细菌与病毒两个数据库焊在一起之后,数据长成了什么形状
MGI — 小鼠成为人类疾病模型的那本账
75,252 个基因、141,808 个突变等位基因、415,358 条表型注释:一个只服务一个物种、却支撑半个生物医学的知识库
IPD-IMGT/HLA — 免疫遗传学的命名权威
47,424 个官方命名的 HLA 等位基因:从 1998 年的 964 个到今天的超多态体系
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
