信息速览
INFOBOX
| 项 | 值 |
|---|---|
| 全名 | Alliance of Genome Resources(AGR) |
| 当前版本 | 9.1.0(2026-09-02) |
| 机构 | Alliance of Genome Resources Consortium |
| 成员库 | SGD、MGI、RGD、ZFIN、FlyBase、WormBase、XB(+ HUMAN 归集口径) |
| 全库实体数 | 56,677,795 |
| 物种数 | 9(诚实版:任何单一数据类别都远不到 9) |
| 表型注释 | 原始 4,442,123 行 → 语义去重 1,909,959 条 |
| 下载体积 | 23.04 GB / 1,848 个文件 / 31 个类别 |
| 许可 | 无全站统一文本,逐成员继承 |
| 最大的坑 | 分片间重复 57%,直接拼接会虚高 2.3 倍 |
§0 E-E-A-T 信任声明与免责声明
我们是谁:千方病案医学编辑部,为中文医学 AI 社区整理可训练数据集的结构化说明。
本条目怎么来的:全部数字来自 2026-10-22 至 10-23 的实测:(1) 官方 API /api/search?q=*&limit=0 的 total 与 aggregations;(2) 开放 S3 桶 download.alliancegenome.org 的逐前缀清点;(3) 下载 9.1.0/PHENOTYPE/ 全部 8 个分片(132 MB)后在本地逐条解析、去重、计数。第三步是本条目最有价值的部分——它揭示了一个官方文档没写的事实。
我们不做什么:本条目不提供模型性能数字。§7.7 的口径矩阵不是 benchmark,它只并列同一概念在不同来源下的取值。把本条目任何数字当作"准确率"引用都是误读。
已知局限:我们只全量下载了表型这一类(132 MB)。其余 30 个类别的数字来自 S3 元数据(文件数与字节数)与 API 计数,没有逐条验证其内部重复情况。如果其他类别也存在片间重复(从结构上看很可能),那么"23.04 GB"的有效信息量会低于标称值。这一点必须在使用前自行核查。
§1 数据集概览
§1.0 📌 30 秒速览
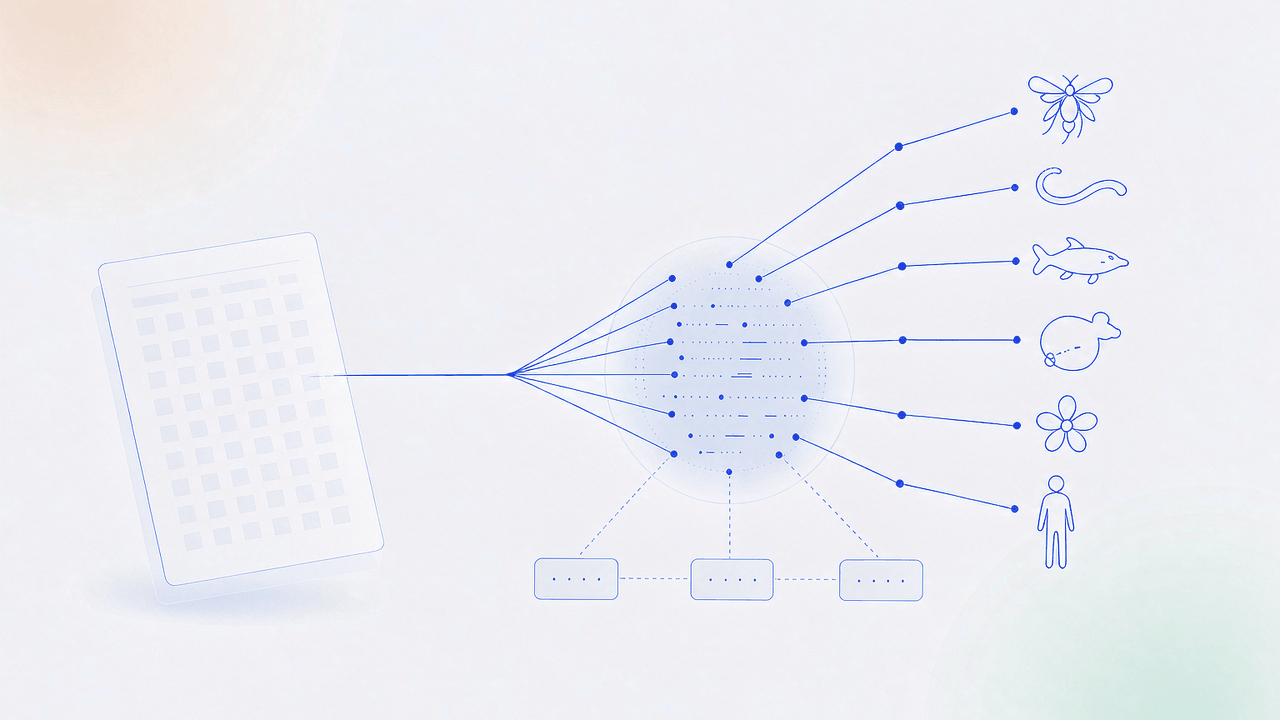
Alliance 把八个模式生物数据库塞进了一个统一的数据模型。它的卖点是"跨物种":你想知道某个基因在小鼠、斑马鱼、果蝇、酵母里分别长什么样、有什么表型、对应什么人类疾病,一个接口就能查到——不用分别去 MGI、ZFIN、FlyBase 注册四套账号。
但它有三个必须先知道的形状问题:
- 分片重复。表型 8 个分片原始 4,442,123 行,语义去重后只有 1,909,959 条(重复 57.0%);等位基因 3 个分片原始 241,014 条,去重后 80,626 条(重复 66.5%)。两类独立数据同一形态——这是系统性缺陷,不是偶发。
- "9 物种"是个平均数。变异占全库实体 90.3%,而变异只来自 3 个成员;表达只来自 4 个成员;等位基因只有斑马鱼一家有。
- 表型本体不统一。小鼠和大鼠用
MP、人用HP、酵母用APO、斑马鱼用PATO+ZFA+GO+CHEBI四本体组合。字段名统一了,语义没统一。
如果你要做跨物种迁移学习,这个库是目前最好的起点之一;如果你要的是"干净的表型标签矩阵",它需要你先做一轮去重和本体映射。
§1.1 技术摘要
| 维度 | 值 |
|---|---|
| 版本 | 9.1.0,2026-09-02 |
| 全库实体 | 56,677,795 |
| 变异 | 51,188,465(90.3%) |
| 等位基因 | 3,211,771(5.7%) |
| 基因 | 1,643,953(2.9%) |
| 疾病模型 | 561,158(1.0%) |
| GO 注释 | 38,092 |
| 高通量数据集 | 22,074 |
| 疾病 | 12,282 |
| 下载 | 23.04 GB / 1,848 文件 / 31 类别 |
| API | REST,免注册,疾病查询必须 POST 裸数组 |
| 证据 | 表型 100% 挂 PMID |
§1.2 战略价值
为什么这个库对医学 AI 特别重要:绝大多数人类疾病无法在人体上做因果实验。模式生物是"能做实验的那一侧"——你可以敲掉一个小鼠基因看它得什么病,这在人身上做不到。Alliance 的 is_implicated_in(基因牵连疾病)与 is_marker_for(基因是疾病标志物)这两类断言,加上跨物种同源映射,构成了一条从人类 GWAS 命中到可实验验证的动物模型的通路。
为什么它现在才有意义:在这之前,要回答"这个人类基因在小鼠里对应哪个基因",你得自己去 Ensembl 查同源、再去 MGI 查表型、再去 ZFIN 查斑马鱼。Alliance 把这条链做完了,而且用它自己的话说是"unified data model"。
但"unified"到什么程度,是本条目要检验的事。结论在 §7.7:字段层统一了,语义层没有。
§1.3 同类资源横向对比
| 资源 | 覆盖 | 与本条目的关系 |
|---|---|---|
| Alliance(本条) | 9 物种,跨库统一模型 | — |
| MGI(#1341) | 小鼠单物种,纵深极深 | Alliance 的成员之一。MGI 的 141,808 等位基因在 Alliance 里被并入统一模型 |
| Ensembl | 全物种基因组 | 提供同源关系,但不做表型策展。Alliance 的同源判断部分依赖它 |
| OMIM | 人类孟德尔遗传 | 只做人,不做模式生物实验数据 |
| Monarch Initiative | 跨物种表型-疾病 | 与 Alliance 功能重叠度最高。区别:Monarch 更强调本体语义推理,Alliance 更强调成员库原始数据的完整呈现 |
| BV-BRC(#1342) | 细菌与病毒病原 | 同为"跨库整合"思路,但分域完全不同:病原 vs 模式生物 |
一个值得记住的对照:Alliance 与 Monarch 都在做"跨物种表型整合",但路径不同。Alliance 是自下而上——八个成员库各自策展,然后合并;Monarch 是自上而下——先建本体语义层,再把数据映射进去。前者的数据更原始可信,后者的语义更一致。如果你想做语义推理,Monarch 更好;如果你想拿到成员库的原始策展细节,Alliance 更好。
§1.4 版本时间轴
| 时间 | 事件 |
|---|---|
| 2016 | Alliance 项目启动,最初由 NHGRI 资助 |
| 2019 | 首个公开 release |
| 2022 | 在 Genetics 发表方法论论文(数据协调) |
| 2023 | NAR 更新论文 |
| 2026-09-02 | release 9.1.0(本条目实测版本) |
注意 Alliance 只有 release 版本号,没有逐数据的更新时间戳。这意味着你无法回答"这条表型注释是 2026 年的还是 2024 年的"——除非你去成员库查原始记录。这是它在 DAIMS #14 上扣分的原因(见 §7.6)。
§1.5 典型应用场景
场景一:把一个人类 GWAS 命中推到动物模型上。 拿到 HGNC:xxxxx,查 crossReferences 拿到小鼠同源基因的 MGI ID,再查 gene/MGI:xxxxx/phenotypes。这条链在 Alliance 里是三次 API 调用,在以前是三个网站加手工对照。
场景二:跨物种表型保守性分析。 问题是——你不能直接用 phenotypeTermIdentifiers 做跨物种比较,因为小鼠用 MP、人用 HP、酵母用 APO。你需要先做本体映射(MP↔HP 有官方映射,MP↔APO 没有)。这个映射工作量不小,见 §5.3。
场景三:基因-疾病关联的金标准来源。 is_implicated_in 与 is_marker_for 两类断言都挂着 PMID。做"这个基因是否致病"的弱监督学习时,这是一个可用的正样本源。
场景四:同源基因功能注释的迁移。 果蝇基因没有人类临床数据,但有小鼠同源基因的表型——可以把小鼠表型迁移过来作为先验。这是 Alliance 的"同源"数据真正的用武之地。
§2 模式生物数据整合的生物学前提
§2.1 覆盖范围:9 个物种,但每个类别都不到 9 个
官方口径是"9 个物种"。实测下来,这个数字在各数据类别上的实际覆盖率差别极大:
| 数据类别 | 覆盖成员数 | 具体 |
|---|---|---|
| GO 注释(GAF) | 10 个目录 | FB, HUMAN, MGI, RGD, SGD, WB, XB, XBXL, XBXT, ZFIN ——最全 |
| 分子互作 | 12 个目录 | 含 COMBINED 与 SARS-CoV-2 |
| 表型 | 5 | HUMAN, MGI, RGD, SGD, ZFIN。果蝇、线虫、爪蟾全缺 |
| GFF | 5 | HUMAN, MGI, RGD, SGD, ZFIN |
| VEPGENE | 5 | FB, MGI, RGD, WB, ZFIN |
| HTPDATASET | 5 | MGI, RGD, SGD, WB, ZFIN |
| 表达 | 4 | MGI, RGD, SGD, ZFIN。人、果蝇、线虫、爪蟾全缺 |
| 变异 | 3 | MGI, RGD, ZFIN。而变异占全库实体 90.3% |
| 等位基因 | 1 | 只有 ZFIN |
| FASTA | 3 个条目 | GRCr8(大鼠组装)、GRCz12tu(斑马鱼组装)、ZFIN |
这张表是理解这个库的钥匙。宣传上的"9 物种联盟",在变异上只有 3 个成员,在等位基因上只有 1 个,在表达上只有 4 个。而变异占了 90.3% 的实体数。
换句话说:全库 90% 的数据来自 3 个物种。用"9 物种"去描述这个库的任何单一数据类别,基本都是错的。真正覆盖满 9 个物种的只有 GO 注释和分子互作这两类。
§2.2 为什么模式生物要合并:实验能力的互补
这 9 个物种不是随便选的,每个都带着一种独特实验能力:
| 物种 | 独特能力 | 代表 |
|---|---|---|
| 小鼠 Mus musculus | 与人类器官系统最接近,基因敲除技术成熟 | 疾病模型的金标准 |
| 大鼠 Rattus norvegicus | 体型更大,生理学与药理学实验更方便 | 心血管、行为学 |
| 斑马鱼 Danio rerio | 胚胎透明、体外发育、可高通量筛药 | 发育生物学、药物筛选 |
| 果蝇 Drosophila melanogaster | 世代短、遗传工具箱最完整 | 信号通路发现的经典系统 |
| 线虫 C. elegans | 细胞数目恒定、神经连接组已全测 | 衰老、神经 |
| 酿酒酵母 S. cerevisiae | 基因操作最快 | 细胞周期、基础代谢 |
| 非洲爪蟾 Xenopus | 卵母细胞可做电生理 | 离子通道、发育 |
这个互补性是 Alliance 的根本理由:一个人类基因的功能,可能在小鼠里看不出来(胚胎致死),但在果蝇或酵母里能看出来。跨物种的价值不在于"物种多",在于"实验能力互补"——所以缺了果蝇的表型数据这件事(§2.1)比它表面上看起来更严重。
§2.3 从基因到表型:三个层次的证据强度
Alliance 的注释不是同质的。按证据强度从高到低:
第一层:直接实验证据。 evidence.publicationId 指向原始文献,dateAssigned 记录策展时间。这类注释可以直接当标签用。
第二层:跨物种推断。 若小鼠基因与人类基因是同源且小鼠有表型,人类基因的"牵连疾病"注释可能来自同源推断。Alliance 的 providers 与 viaOrthology 相关字段(在疾病注释里是 viaOrthologyOrder)标识了这一点。
第三层:文本挖掘。 部分关联来自文献挖掘,未经人工复核。
必须做的区分:如果你把三层混在一起当训练标签,等于把"实验测得"和"推断得到"放在同一个置信度上。至少要按
providers字段分层——这是 Alliance 相比 BV-BRC 做得好的地方,它保留了来源,只是没有任何文档建议你这么用。
§2.4 数据来源人群:谁在策展,为什么形状是这样
Alliance 的数据不是"采集"来的,是八个团队各自手工策展然后合并的。这解释了三个现象:
为什么表型词汇量极小。 实测:MGI 211.7 万行表型注释只有 11,655 种不同的 phenotypeStatement;HGNC 46.6 万行只有 10,672 种;SGD 38.7 万行只有 709 种。这不是数据贫乏,是策展人用受控词汇表——同一句话被反复用在成千上万个基因上。这对机器学习是好消息(标签空间小),也是坏消息(表达力受限)。
为什么各物种的本体不一样。 每个成员库在成为联盟成员之前,已经用各自的本体做了十几年策展。小鼠用 MP(Mammalian Phenotype)因为它从一开始就是哺乳动物视角;酵母用 APO(Ascomycete Phenotype)因为它根本没有"器官"这个概念。统一本体意味着推翻十几年的策展成果,没有成员愿意付这个代价。
为什么成员间 release 日期不一致。 HUMAN 与 RGD 的表型快照标注 RGD-2024-SEP-12(2024 年 9 月),而全局 release 是 2026-09-02。ZFIN 的三个分片连 release 字段都是 null。这说明"release 9.1.0"只是打包日期,不是数据截止日期。
§2.5 为什么"统一"这个词在这里需要打折扣
Alliance 的官方定位是用 “unified data model” 整合八个库。实测下来,统一发生在这些层面:
| 层面 | 是否统一 | 证据 |
|---|---|---|
| 字段名 | ✅ 统一 | 所有表型的字段都叫 objectId / phenotypeStatement / phenotypeTermIdentifiers / evidence |
| ID 形式 | ✅ 统一为 CURIE | MGI: RGD: ZFIN: SGD: HGNC: 都是 前缀:本地ID |
| 文件格式 | ✅ 统一为 JSON/TSV | 按目录分格式,同类内一致 |
| 表型语义 | ❌ 未统一 | MP / HP / APO / PATO+ZFA 四套并存 |
| 数据截止时间 | ❌ 未统一 | 2024-09 到 2026-09 并存 |
| 重复控制 | ❌ 未统一 | 分片间重复率 0% 到 70% 不等 |
这是本条目最想传达的一个判断:"统一数据模型"说的是结构,不是语义。 这在前 3 行(字段、ID、格式)成立,在后 3 行(语义、时间、去重)不成立。而后者恰恰是做机器学习时最容易踩到的三件事。
§2.6 质量标准的边界:Alliance 保证什么、不保证什么
保证:
- 每条表型注释挂 PMID(实测 100%)。
- 每条表型注释挂本体术语(实测 100%)。
- 每个实体有 CURIE 形式的稳定 ID。
- 基因有完整的 SO 类型标注(含祖先链)。
不保证:
- 不保证分片不重复(实测整体重复 57%)。
- 不保证跨成员语义可比(四套本体)。
- 不保证数据新鲜度一致(最早 2024-09)。
- 不保证每个类别都覆盖所有物种(变异只有 3 个成员)。
- 不提供任何划分建议、泄漏警示、偏倚说明(DAIMS #15-#19 全空,见 §7.6)。
§3 数据库规格与通道抉择
§3.0 三条通道,各有各的坑
| 通道 | 地址 | 适用 | 坑 |
|---|---|---|---|
| REST API | https://www.alliancegenome.org/api/ |
按 ID 精确查、做交互式探索 | 端点不按常规命名,/api/species、/api/gene 全部 404 |
| S3 桶(推荐做训练集) | https://download.alliancegenome.org/?prefix=9.1.0/... |
批量下载、全量重建 | 分片间重复,需自行去重 |
| 网站 UI | https://www.alliancegenome.org/ |
人工检索、看渲染 | 纯 JavaScript 渲染,curl 只能拿到空壳 |
一个实测细节:
https://www.alliancegenome.org/downloads用curl抓回来只有一句 “You need to enable JavaScript to run this app.”。想拿到下载清单必须直接打 S3 桶,不能靠爬页面。
§3.1 31 个数据类别的地图
release 9.1.0 的 31 个顶层目录,按用途分组:
核心注释类(训练数据主力)
| 目录 | 文件 | 体积 | 覆盖成员 |
|---|---|---|---|
GENE-DESCRIPTION-JSON |
952 | 4.85 GB | 全成员 |
PHENOTYPE |
8 | 0.14 GB | 5 个 |
EXPRESSION |
6 | 0.07 GB | 4 个 |
VARIATION |
8 | 0.01 GB | 3 个 |
ALLELE |
3 | 0.01 GB | 1 个(ZFIN) |
GAF(GO) |
16 | 0.10 GB | 10 个目录 |
互作与网络类
| 目录 | 文件 | 体积 |
|---|---|---|
INTERACTION-MOL |
36 | 1.70 GB |
INTERACTION-GEN |
30 | 0.19 GB |
INTERACTION-SOURCE |
8 | 1.46 GB |
序列与坐标类
| 目录 | 文件 | 体积 |
|---|---|---|
FASTA |
3 | 1.70 GB |
GFF |
15 | 0.61 GB |
HTVCF |
4 | 0.16 GB |
HTPOSTVEPVCF |
4 | 4.75 GB |
VEPGENE |
16 | 0.10 GB |
VEPTRANSCRIPT |
16 | 0.23 GB |
本体与映射类
| 目录 | 文件 | 体积 |
|---|---|---|
ONTOLOGY |
46 | 0.18 GB |
GEOXREF |
68 | 0.00 GB |
GENE-DESCRIPTION-STATS |
136 | 0.00 GB |
其余:AGM(2)、BGI(4)、CONSTRUCT(3)、DAF(3)、HTPDATASAMPLE(16)、HTPDATASET(11)、MOD-GFF-BAM-KNOWN(2)、MOD-GFF-BAM-MODEL(2)、RESOURCE(2)、SQTR(3)、downloads(119, 6.07 GB 历史归档)。
downloads/那 6.07 GB 是历史归档,不属于 9.1.0 的当前数据。做体积预算时应该把它排除——排除后当前 release 实际约 16.97 GB。
§3.2 下载预算与实测吞吐
- 必下(做表型/疾病模型):
PHENOTYPE8 个分片,共 132 MB gz。解压后约 1.2 GB JSON。 - 建议下(做基因-疾病):
GENE-DESCRIPTION-JSON952 个文件,4.85 GB——这是体积最大的一块,但也是最有信息量的一块。 - 按需下:
GFF(0.61 GB)与FASTA(1.70 GB)只在需要坐标时用。 - 可以不下:
HTPOSTVEPVCF(4.75 GB)是变异效应预测的 VCF,除非做变异功能预测,否则不需要。
实测:单个 20 MB 的表型分片,在沙箱环境下 curl 约 3-8 秒。按此推算,PHENOTYPE 全量 132 MB 约需 1 分钟;GENE-DESCRIPTION-JSON 4.85 GB 约需 20-40 分钟(视并发)。
重要提醒:Alliance 的 S3 桶是公开匿名访问,不需要任何凭证。这既是优点(零门槛),也是隐含风险(没有任何速率保护,大规模下载可能被限流,且没有 SLA)。
§3.3 版本机制:有 release 号,没有逐数据时间戳
- 有 release 版本号(9.1.0)与发布日(2026-09-02)。
- 有 分片内
metaData.release字段——但各分片自己填、格式不一:
| 成员 | metaData.release |
|---|---|
| MGI | MGI 6.27 2026-06-30 与 MGI 6.27 2026-09-15(同一版本号两个日期) |
| SGD | SGD 9.1.0 2026-07-07 |
| HUMAN / RGD | RGD-2024-SEP-12(2024 年) |
| ZFIN | null |
- 没有 逐条记录的数据更新时间戳。
dateAssigned是注释被赋予的时间(如2006-05-12),不是数据更新的时间。
这个设计对训练集是致命的:你无法构造"截止到 2024 年的数据"来验证"模型能否预测 2024 年后的新知识"。时间切分在这个库上做不了——这是一个硬约束,只能通过成员库原始记录绕过。
§3.4 技术栈与溯源链
- 格式:JSON(
{data: [...], metaData: {...}})+ TSV + GAF 三种。 - 压缩:
.json.gz/.tsv.gz/.gaf.gz。 - 分片:按成员切,再按体积切(如 ZFIN 切成 3 片)。
- API:Spring Boot(错误信息是 Java 风格的
statusCodeName: Bad Request)。 - 溯源:每条注释的
evidence.publicationId指向 PMID,providers指向策展方。
§4 记录结构与字段字典
§4.1 表型记录:六个字段,两个陷阱
一条表型注释的全部字段(实测,SGD 实例):
{
  "dateAssigned": "2006-05-12T00:05:00-00:00",
  "evidence": {"publicationId": "PMID:21179023"},
  "objectId": "SGD:S000000890",
  "phenotypeStatement": "decreased resistance to chemicals",
  "phenotypeTermIdentifiers": [
    {"termId": "APO:0000003", "termOrder": 1},
    {"termId": "APO:0000087", "termOrder": 2}
  ],
  "primaryGeneticEntityIDs": ["SGD:S000281279"]
}
| 字段 | 含义 | 陷阱 |
|---|---|---|
objectId |
观察对象(通常是基因) | CURIE 前缀决定物种,不能只看本地 ID |
phenotypeStatement |
人类可读语句 | 不是标签——它是 phenotypeTermIdentifiers 的自然语言渲染 |
phenotypeTermIdentifiers |
本体术语有序数组 | 顺序有意义(termOrder),组合起来才是完整语义 |
evidence.publicationId |
PMID | 实测 100% 填充 |
primaryGeneticEntityIDs |
参与该表型的遗传实体 | 可以是多个,且可能是与 objectId 不同的实体 |
dateAssigned |
注释赋予时间 | 不是数据更新时间 |
陷阱一:把
phenotypeStatement当标签用。 它看起来最像一个标签(“对化学物质抗性降低”),但它是渲染出来的字符串。同一个本体术语组合在不同成员下可能渲染成不同文字。必须用phenotypeTermIdentifiers。陷阱二:把
objectId当唯一键。 一个基因对一个表型可能有多条注释(来自不同文献、不同实验条件)。objectId不唯一,这一点在算"每个基因有多少表型"时会导致虚高。
§4.2 各成员的表型规模(去重后)
全量下载后按语义键去重的结果:
| 主体前缀 | 物种 | 原始行 | 去重后 | 重复率 | distinct 基因 | distinct 语句 | 平均术语数 |
|---|---|---|---|---|---|---|---|
MGI |
小鼠 | 2,117,287 | 1,002,230 | 52.7% | 143,616 | 11,655 | 1.00 |
ZFIN |
斑马鱼 | 1,464,889 | 438,121 | 70.1% | 57,440 | 76,198 | 2.27 |
HGNC |
人 | 465,831 | 274,946 | 40.9% | 5,555 | 10,672 | 1.00 |
SGD |
酵母 | 386,523 | 187,461 | 51.5% | 20,898 | 709 | 1.93 |
RGD |
大鼠 | 7,593 | 7,201 | 5.2% | 2,214 | 1,289 | 1.00 |
| 合计 | — | 4,442,123 | 1,909,959 | 57.0% | — | — | — |
这几个数字放在一起讲了一个故事:
第一,"重复"不是简单的文件拷贝。 如果 ZFIN 三个分片是完全拷贝,去重率应该精确等于 2/3;但实际是 70.1%,且三者语义键交集只有 436,565、并集 438,121——说明它们是同一批数据的三种不同切片,部分重叠但不完全重合。这比"完全重复"更难处理:你不能只取第一片。
第二,各成员的重复率从 5.2% 到 70.1% 不等。 RGD 几乎不重复(5.2%),ZFIN 重复七成。同一个"去重脚本"不能套用在所有成员上,必须逐成员检查。
第三,平均术语数暴露了本体差异。 MGI / HGNC / RGD 都是 1.00(单术语);SGD 是 1.93、ZFIN 是 2.27(多术语组合)。这不是数据质量问题,是本体设计不同——但如果你用一个"取第一个术语当标签"的脚本,ZFIN 会丢掉一半语义。
§4.3 表型本体的真实分布
全库本体术语出现次数(去重前,反映实际使用量):
| 本体 | 出现次数 | 不同术语数 | 使用者 |
|---|---|---|---|
MP(Mammalian Phenotype) |
2,124,880 | 11,702 | MGI、RGD |
PATO(Phenotype And Trait Ontology) |
1,464,889 | — | 仅 ZFIN |
ZFA(Zebrafish Anatomy) |
1,397,447 | — | 仅 ZFIN |
APO(Ascomycete Phenotype) |
745,387 | 204 | 仅 SGD |
HP(Human Phenotype) |
465,831 | 10,672 | 仅 HGNC |
GO(Gene Ontology) |
403,543 | — | 仅 ZFIN |
CHEBI(化学实体) |
29,405 | — | 仅 ZFIN |
BSPO(空间本体) |
28,100 | — | 仅 ZFIN |
MPATH(小鼠病理) |
3,606 | — | 仅 ZFIN |
CARO(通用解剖) |
27 | — | 仅 ZFIN |
这张表是本条目最重要的结构发现。注意 ZFIN 一家用了 7 个本体(PATO、ZFA、GO、CHEBI、BSPO、MPATH、CARO),而 MGI 和 RGD 只用
MP一个。这不是"斑马鱼数据更丰富",是斑马鱼社区的表型描述传统不同:小鼠表型是"这个突变体有什么异常"(单一 MP 术语),斑马鱼表型是"这个基因突变后,某个解剖结构(ZFA)的某个质量(PATO)变成了什么样"。后者本质上是(实体, 质量)的二元组,前者是一元标签。
后果:
phenotypeTermIdentifiers这个字段在 MGI 和 ZFIN 下的语义结构完全不同。任何跨物种表型分析,第一步必须是结构对齐——而这一步 Alliance 没有帮你做。
§4.4 基因记录:{formatText, displayText} 双字段
Alliance 的基因对象有一个很容易忽略的设计:每个字段的值都是 {formatText, displayText} 对象,不是一个字符串。
HGNC:7881(NOTCH1)实测:
| 字段 | 值 |
|---|---|
primaryExternalId |
HGNC:7881 |
taxon |
NCBITaxon:9606 / Homo sapiens |
geneType |
SO:0001217 / protein_coding_gene + 8 条祖先链 |
geneSymbol |
NOTCH1 |
geneFullName |
notch receptor 1 |
geneSynonyms |
9 条(hN1、TAN1、AOS5、AOVD1…) |
geneSecondaryIds |
RGD:737367 |
geneGenomicLocationAssociations |
含 start / end / AssemblyComponent |
crossReferences |
≥6 类:RGD: ENSEMBL: HGNC: NCBI_Gene: OMIM: PANTHER: |
crossReferences里的resourceDescriptorPage.urlTemplate是可直接用的 URL 模板,形如https://www.ncbi.nlm.nih.gov/gene/[%s]。把[%s]换成 ID 尾部就能跳转。Alliance 顺手给了你到各成员库的链接构造规则——这是一个很少被提到但很实用的设计。陷阱:
formatText与displayText有时不同。formatText用于展示与排序,displayText用于渲染。取字段值时统一取formatText,否则同一个基因在不同记录里可能表现成两个值。另一个容易忽略的点:
geneGenomicLocationAssociations是数组,不是对象。 一个基因可能有多个位置记录(不同组装版本、或跨 scaffold 断裂)。取第一个元素当唯一定位的脚本,会在多组装并存的成员上出错——而 Alliance 的FASTA目录里确实同时存在GRCr8(大鼠第 8 版组装)与GRCz12tu(斑马鱼第 12 版组装)两个组装名,说明多组装并存是常态。
§4.5 疾病注释:两种断言强度
HGNC:7881 的疾病注释共 11 条(total: 11):
generatedRelationString |
疾病 | DOID |
|---|---|---|
is_implicated_in |
Adams-Oliver syndrome | DOID:0060227 |
is_implicated_in |
adult T-cell leukemia/lymphoma | DOID:0050523 |
is_implicated_in |
aortic valve disease 1 | DOID:0080333 |
is_marker_for |
cardiovascular system disease | DOID:1287 |
这两类断言的强度不同:
is_implicated_in(牵连)暗示因果或功能参与;is_marker_for(标志物)只是统计关联。合并成一个二分类标签会把因果与相关混为一谈。 这是 §6 坑点 3 的原始证据。
§4.6 等位基因:重复模式在第二类数据上被确认
ALLELE 目录只有 ZFIN 一个成员,3 个分片,文件大小几乎相同(2,965,584 / 2,965,510 / 2,968,246 字节)。这个"大小几乎相同"本身就是信号。
全量下载后逐条核对:
| 分片 | 行数 | 分片内 dateProduced |
|---|---|---|
ALLELE_ZFIN_0 |
80,302 | 2026-07-06 |
ALLELE_ZFIN_1 |
80,302 | 2026-07-07 |
ALLELE_ZFIN_2 |
80,410 | 2026-08-04 |
| 原始合计 | 241,014 | — |
| 三片交集 | 80,106 | — |
| 并集(去重后) | 80,626 | — |
| 重复率 | 66.5% | — |
这一节的意义不在于等位基因本身,在于它证明了重复不是表型类独有的问题。
表型类重复 57.0%,等位基因类重复 66.5%。两类数据的重复形态完全一致:几个文件、几乎相同的体积、
dateProduced相差几天到一个月、并集仅略大于单片。这说明 Alliance 的打包流程存在一个系统性的分片生成缺陷——它把某次快照切成了多个文件,而这些文件之间并没有做真正的分区。推论(必须写清楚这是推论):既然两类都这样,
VARIATION、EXPRESSION、INTERACTION-*等同样按成员切分的目录很可能也存在同类问题。本条目没有逐类验证——§7.2 已声明这个边界。但把"分片必须去重"当作使用这个库的第一条纪律,是有充分依据的。
单条等位基因记录的结构(ZFIN 实例):
{
  "primaryId": "ZFIN:ZDB-ALT-130530-487",
  "symbol": "sa15457",
  "taxonId": "NCBITaxon:7955",
  "crossReferences": [{"id": "ZFIN:ZDB-ALT-130530-487", "pages": ["allele", "allele/references"]}],
  "alleleObjectRelations": [
    {"objectRelation": {"associationType": "allele_of", "gene": "ZFIN:ZDB-GENE-131121-157"}}
  ]
}
注意
alleleObjectRelations里的associationType: "allele_of":等位基因与基因是多对一,但字段是关系数组——一个等位基因可能关联多个基因(如融合基因)。把它当一对一关系建模会丢数据。
§4.7 三个"小而关键"的参照物
ONTOLOGY/(46 个文件,0.18 GB):全部本体的原始 OBO/OWL 文件。做本体映射时必须用这个,而不是去各个本体官网下载——因为 Alliance 用的是特定版本的本体快照,用最新版可能导致术语已废弃。
GEOXREF/(68 个文件):基因 ID 的跨库映射表。做 ID 转换时用它,比自己拼 crossReferences 更可靠。
GENE-DESCRIPTION-STATS/(136 个文件):每个成员每个数据类别的条目数统计。这是唯一官方的"每类多少条"口径,做对账时用它。
§5 检索、抽样与泄漏分析
§5.0 Alliance 上能做的六类检索
| 检索 | 方式 | 实测 |
|---|---|---|
| 全局计数 | GET /api/search?q=*&limit=0 |
返回 total: 56,677,795 + 七类聚合 |
| 按类别计数 | GET /api/search?q=*&category=gene_search_result |
返回该类 total |
| 基因按 CURIE | GET /api/gene/HGNC:7881 |
200,返回 {gene: {...}} |
| 基因按符号 | GET /api/gene/NOTCH1 |
400——不认符号 |
| 疾病注释 | POST /api/disease,body 为 ["HGNC:7881"] |
200,返回 11 条 |
| 基因子资源 | GET /api/gene/{curie}/phenotypes 等 |
200,含 total |
POST /api/disease的请求体必须是裸 ID 数组。写成{"geneIds": [...]}会返回 400Not able to deserialize data provided.。这是实测踩到的坑(§6.5 坑点 1)。
§5.1 抽样策略:三种,都不是随机的
策略一:按成员抽样。 这是最自然的切分,但引入的偏倚最大——每个成员的策展标准不同、本体不同、数据新鲜度不同。用它做 train/test 分割,你测的是"跨库差异",不是"泛化能力"。
策略二:按物种抽样。 更糟。因为变异只有 3 个物种、表达只有 4 个——按物种切会导致某些切片的某一类别完全为空。
策略三:按基因家族或同源群抽样。 这是唯一在生物学上合理的做法:同一同源群内的基因功能高度相似,必须整群分配到同一侧。Alliance 提供了同源关系(在 INTERACTION 与外部的同源映射里),可以用来构造这个划分。
必须声明的边界:本条目没有构造任何"标准划分"。上面三条是方法建议,不是实测结果。Alliance 官方没有任何划分建议(DAIMS #15 ❌)。
§5.2 四类真实泄漏,按危害排序
泄漏一(最严重):同一分片的重复行跨训练/测试两侧。
这不是"数据质量问题",是直接的数据泄漏。如果 PHENOTYPE 的 ZFIN 三个分片各自被分到不同集合,那么同一个基因-表型对会同时出现在训练集和测试集——模型只需记住就能答对。
实测数据:ZFIN 三个分片原始 1,464,889 行,去重后 438,121 条。如果你把三片分别划给 train/val/test,重复率是 70%——意味着测试集里七成样本训练时见过。
正确做法:先对全部文件合并去重,再划分。去重键用
(objectId, phenotypeStatement, 术语ID序列),不要用行号。
泄漏二:跨物种同源基因跨侧。
小鼠 MGI:xxxx 与人类 HGNC:yyyy 如果是同源基因,它们的表型注释高度相关(甚至就是从一方推断到另一方的)。按基因划分而不按同源群划分,等于让模型在训练时见过"同一个基因的另一个名字"。
正确做法:先用同源关系做连通分量聚类,再按簇分配。
泄漏三:文献泄漏。 同一条 PMID 可能对应多条注释。如果按注释行划分,同一篇论文的结论会同时出现在两侧。实测:表型注释 100% 有 PMID——这个泄漏面是全覆盖的。
正确做法:按 PMID 做 group,或者更严格地按发表年份做时间切分(但 §3.3 说过,这个库没有逐数据时间戳,做不了)。
泄漏四:疾病注释的"牵连"与"标志物"混用。 is_implicated_in 与 is_marker_for 是两个强度的断言。如果合并成二分类,模型学到的是"有联系",而不是"有因果"。
§5.3 结构泄漏:从字段命名本身推断出的信息
objectId 的 CURIE 前缀直接暴露了物种。 MGI: 一定是小鼠、SGD: 一定是酵母、HGNC: 一定是人。
后果:如果你的模型用 objectId 的字符串形式作为特征,它会直接学到物种标签。而在表型预测任务里,物种与表型高度相关(酵母没有"器官形态"这一类表型)。模型会用一个物种捷径达到很高的准确率,然后在跨物种测试上崩盘。
正确做法:把 CURIE 拆成
(前缀, 本地ID)两列,前缀作为分组变量而不是特征。
phenotypeTermIdentifiers 的长度也是信息。 MGI 恒为 1、ZFIN 平均 2.27。"术语个数"这个特征本身就能区分物种。
dateAssigned 的年份分布携带策展历史。 早期注释集中在少数几个"明星基因"上,近年注释覆盖更广。用 dateAssigned 做特征会学到"这个基因是不是经典研究对象"。
§5.4 一个不该做的划分:按"人类 vs 模式生物"切
表面上看,"用小鼠/斑马鱼/酵母训练,用人类测试"是一个漂亮的跨物种泛化实验。实际上这个划分几乎必然失败,而且失败没有信息量:
- 本体不同。人类用
HP(10,672 个术语),小鼠用MP(11,702 个术语)。术语空间不重叠——模型在训练集里从没见过HP:开头的标签。 - 表型粒度不同。
HP描述的是临床症状(“癫痫”、“智力障碍”),MP描述的是实验观察(“异常惊跳反应”)。它们不是同一个粒度的概念。 - 人类表型注释只有 274,946 条(去重后),且只覆盖 5,555 个基因。这个规模不足以做测试集。
这类划分测出来的不是"跨物种泛化能力",是"两套不同本体能否对齐"。 如果你的研究问题真是"本体对齐",那这个划分是对的;如果问题是"模型能否泛化到人",必须先在
MP ↔ HP之间建立术语映射(有官方映射,但覆盖率不全),再谈泛化。
§6 AI 就绪指南
§6.1 最小可用 Pipeline
# ① 下载全部表型分片(8 个,132 MB)
import urllib.request, urllib.parse, re, os, gzip, json, glob

BASE = "https://download.alliancegenome.org/"
def keys(prefix):
    u = BASE + "?prefix=" + urllib.parse.quote(prefix)
    x = urllib.request.urlopen(u, timeout=90).read().decode()
    return re.findall(r'<Key>([^<]*)</Key>', x)

for k in keys("9.1.0/PHENOTYPE/"):
    if k.endswith(".json.gz"):
        fn = "/data/agr/" + k.split("/")[-1]
        if not os.path.exists(fn):
            urllib.request.urlretrieve(BASE + k, fn)

# ② 语义去重(这一步是整条 pipeline 的分水岭,不做等于样本量虚高 2.3 倍)
def sem_key(r):
    return (r.get("objectId"),
            r.get("phenotypeStatement"),
            tuple(t["termId"] for t in r.get("phenotypeTermIdentifiers") or []))

seen, rows = set(), []
for f in sorted(glob.glob("/data/agr/*PHENOTYPE_*.json.gz")):
    d = json.load(gzip.open(f, "rt"))
    for r in d["data"]:
        k = sem_key(r)
        if k not in seen:
            seen.add(k)
            r["_species"] = (r["objectId"] or "").split(":")[0]
            rows.append(r)

print("原始 ->", "去重后", len(rows))   # 期望约 1,909,959

# ③ 拆成 (物种, 基因, 术语集合) 三列,避免把 CURIE 前缀当特征
import pandas as pd
df = pd.DataFrame([{
    "species": r["_species"],
    "gene":    r["objectId"],
    "terms":   tuple(t["termId"] for t in r.get("phenotypeTermIdentifiers") or []),
    "pmid":    r.get("evidence", {}).get("publicationId"),
} for r in rows])

# ④ 划分:按 PMID 分组,绝不让同一篇文献跨侧
from sklearn.model_selection import GroupKFold
# (GroupKFold 用 df["pmid"] 作 groups,见 §6.2)
§6.2 DataLoader 与批组织
核心问题:表的形状不是"样本 × 特征",是"基因 × 术语集合"。
三种可用的组织方式:
| 组织方式 | 输入 | 输出 | 适用 |
|---|---|---|---|
| 多标签分类 | 基因特征向量 | 术语的 0/1 向量 | MGI/RGD/HUMAN(单术语) |
| 序列到序列 | 基因特征 | 术语序列 | ZFIN(termOrder 有意义) |
| 集合预测 | 基因特征 | 术语集合(无序) | 通用,推荐 |
推荐集合预测:把
phenotypeTermIdentifiers当无序集合,用 BCE 多标签损失。这样 MGI(长度 1)与 ZFIN(长度 2.27)可以在同一个框架下训练,只要先做术语空间对齐。
批组织注意:ZFIN 的 438,121 条里,每个基因平均只有 7.6 条注释(438,121 / 57,440)。MGI 的 1,002,230 条里,每个基因平均 7.0 条(1,002,230 / 143,616)。两个库的"每基因注释数"接近,但基因基数差 2.5 倍——批次采样时如果按注释行均匀采样,MGI 的基因会被重复采样更多次。
§6.3 评价指标:为什么不能只看 micro-F1
表型术语的长尾极重。实测:全库 29,935 个不同术语,但 MP 的 11,702 个术语支撑了 2,124,880 次出现——平均每个术语 181 次,但中位数远低于此(少数术语占大头)。
- micro-F1 会被高频术语主导。
- macro-F1 会被只出现 1-2 次的稀有术语拉低。
- 推荐:同时报 micro-F1、macro-F1,以及 top-k recall(k=1/3/5)——因为临床上"前 3 个候选里有没有正确答案"比"精确匹配"更有意义。
必须报告 per-species 指标。全库混合报一个数字会掩盖"模型只在 MGI 上学到了东西,在 SGD 上完全不工作"这类问题。
§6.4 MLOps:把快照钉死在数据集里
- 记录 release 号(9.1.0)+ 各分片的
metaData.release(它们不一致!) - 记录去重前后的行数(4,442,123 → 1,909,959)。这个比值是你数据集的指纹——下次 release 如果比值变了,说明重复模式变了。
- 把本体的版本钉死:用
ONTOLOGY/目录里的 OBO 文件,不要用在线最新版。 - 不要依赖 API 做训练数据:API 返回的是当前状态,没有版本快照。训练集必须从 S3 桶的固定 release 目录取。
§6.5 八个坑点(全部有实测依据)
坑点 1 · 类别:工程陷阱 — /api/disease 必须 POST 且请求体是裸数组
问题:想查一个基因的疾病注释,GET /api/disease?geneId=HGNC:7881 返回 405 Method Not Allowed。
症状:405,没有任何提示说要用 POST。
解决:
- 简单:改成
POST /api/disease。 - 进阶:请求体必须是裸 ID 数组——
["HGNC:7881"]。写成{"geneIds": ["HGNC:7881"]}会返回 400Not able to deserialize data provided.。这个报错信息完全没有提示正确格式。 - SOTA:先用一个已知 ID 试通,确认返回结构里带
total,再写批量逻辑。返回体里的total是真实总数,不必翻页数。
参考:实测四种请求体格式,只有裸数组可用(2026-10-22)。
坑点 2 · 类别:工程陷阱 — 端点不按常规 REST 命名
问题:想列物种,试 /api/species、/api/speciesList,全部 404。想列基因,试 /api/gene,也是 404。
症状:404 Resource not found(HTML,不是 JSON)。
解决:
- 简单:放弃猜路径。这个 API 只有少数几个"实体型"端点:
/api/gene/{curie}、/api/gene/{curie}/{subresource}、/api/disease(POST)、/api/search、/api/releaseInfo。 - 进阶:需要"列表"能力时,用
/api/search?q=*&category=xxx&limit=0拿总数,再分页取。 - SOTA:做批量数据不要用 API,用 S3 桶。API 是为交互式检索设计的,S3 桶才是为批量准备的。
参考:逐个探测 15 个可能的端点路径,12 个 404(2026-10-22)。
坑点 3 · 类别:标签理解 — is_implicated_in 与 is_marker_for 不是一回事
问题:把疾病注释全当一个二分类标签(“是否关联疾病”)。
症状:模型学得很好,但在"这个基因是否致病"的验证上失败。
解决:
- 简单:按
generatedRelationString分层,至少分成两类。 - 进阶:
is_implicated_in当正样本,is_marker_for当弱正样本或单独建模。不要把标志物当因果证据。 - SOTA:再叠一层证据强度——
providers里区分实验策展 vs 同源推断,viaOrthologyOrder标识跨物种推断。三层叠加后的标签才是可用的。
参考:HGNC:7881 的 11 条注释里,is_implicated_in 与 is_marker_for 并存(2026-10-22)。
坑点 4 · 类别:数据泄漏 — 分片间重复,直接拼接虚高 2.3 倍
问题:zcat *.json.gz | jq '.data | length' 累加得到 4,442,123 条,当作样本量。
症状:训练/测试划分后,测试集准确率异常高;或者模型在"新数据"上表现远差于预期。
解决:
- 简单:全部文件合并后用
(objectId, phenotypeStatement, 术语ID序列)做去重。实测 4,442,123 → 1,909,959(重复 57.0%)。 - 进阶:逐成员检查重复率——表型侧 ZFIN 70.1%、MGI 52.7%、SGD 51.5%、HGNC 40.9%、RGD 5.2%。差异这么大,说明不能用一个统一阈值判断"是否重复"。 更关键的是,这个毛病不只在表型:等位基因三个分片原始 241,014 条,去重后 80,626 条(66.5%)。
- SOTA:先用文件体积探测,再决定下哪几片。同一成员同一类别的分片,如果
<Size>相差不到 1%,几乎必定是同一批数据的多份拷贝。实测:ALLELE三片 2,965,584 / 2,965,510 / 2,968,246 字节,验证后确认重复 66.5%;EXPRESSION的MGI_0/MGI_1(12.52 MB / 12.58 MB)与ZFIN_0/ZFIN_1(20.43 MB / 20.44 MB)也是同一形态。这一步只需读 S3 的 XML,不用下载,成本几乎为零。
参考:全量下载表型 8 片(132 MB)+ 等位基因 3 片(8.9 MB)后本地重算,2026-10-23。
坑点 5 · 类别:偏倚陷阱 — "9 物种"在任何单一数据类别上都不成立
问题:按"9 个物种的变异数据"设计研究。
症状:下载 VARIATION/ 发现只有 3 个成员目录(MGI、RGD、ZFIN)。
解决:
- 简单:下载前先列目录。
?prefix=9.1.0/VARIATION/&delimiter=/就能看到成员列表。 - 进阶:把 §2.1 的覆盖矩阵当必读材料。变异只有 3 个成员、表达 4 个、等位基因 1 个。
- SOTA:每个数据类别单独建一份"成员 × 记录数"矩阵,把它作为数据集说明书的第一页。不做这一步,任何"跨 9 物种"的表述都是错的。
参考:逐目录清点成员,2026-10-22。
坑点 6 · 类别:预处理陷阱 — 四套表型本体,不能合并成一个标签空间
问题:把所有 phenotypeTermIdentifiers 的 termId 塞进一个标签编码器。
症状:标签空间有 29,935 个类,但每个物种只占其中一小块,跨物种样本几乎不共享标签。
解决:
- 简单:按物种分开建模,不做跨物种共享。
- 进阶:用
MP ↔ HP官方映射做人类-小鼠对齐(这一对有映射),其余不动。 - SOTA:把表型表示为(实体, 质量)二元组——ZFIN 本来就是这么编码的(ZFA + PATO),把 MGI 的 MP 术语也拆成这一形态,才能在结构层面对齐。这是一个真正的本体工程任务,不是数据清洗。
参考:全库术语前缀分布实测,MP 2,124,880 / PATO 1,464,889 / ZFA 1,397,447 / APO 745,387 / HP 465,831(2026-10-23)。
坑点 7 · 类别:评估误用 — dateAssigned 不是数据更新时间,做不了时间切分
问题:想构造"用 2024 年前的数据训练,预测 2024 年后的新知识"。
症状:dateAssigned 字段大量是 2006、2010 这样的老日期,但数据本身可能是 2026 年才进库的。
解决:
- 简单:
dateAssigned是"注释被赋予的时间",不是"数据被录入的时间"。两者不同。 - 进阶:分片级的
metaData.release能给一个粗粒度(但实测 HUMAN/RGD 停在 2024-09,ZFIN 是 null)。 - SOTA:这个库上做不了严格的时间切分。如果研究问题必须做时间泛化,必须回到成员库(MGI 有逐条
dateModified)拿原始时间戳。认清"这个库不提供什么",比硬凑一个假的时间切分更有价值。
参考:dateAssigned 实测为 2006-05-12,而 release 是 2026-09-02(2026-10-23)。
坑点 8 · 类别:工程陷阱 — curl 抓不到下载页,必须直接打 S3
问题:curl https://www.alliancegenome.org/downloads 想拿文件清单。
症状:只返回一句 You need to enable JavaScript to run this app.,1729 字节。
解决:
- 简单:放弃爬页面,直接请求 S3 桶的
ListBucketResult:https://download.alliancegenome.org/?prefix=9.1.0/&delimiter=/。 - 进阶:返回是 XML,用
<CommonPrefixes>拿目录、<Contents>拿文件、<Size>拿字节、<IsTruncated>判断是否要翻页(用<Marker>)。 - SOTA:这个桶是开放匿名访问的,可以直接用
aws s3 ls --no-sign-request或boto3的匿名 client。比手写 XML 解析稳。
参考:/downloads 页面实测 1729 字节纯壳;S3 桶实测 419,323 字节完整 XML(2026-10-22)。
§6.6 反模式清单
| 反模式 | 为什么错 | 正确做法 |
|---|---|---|
直接 cat *.json.gz 拼表型 |
分片重复 57%,虚高 2.3 倍 | 语义键去重后再用 |
用 phenotypeStatement 当标签 |
它是渲染字符串,非本体术语 | 用 phenotypeTermIdentifiers |
用 objectId 的 CURIE 前缀当特征 |
直接泄漏物种 | 拆成 (前缀, 本地ID),前缀作分组变量 |
| 说"9 物种变异数据" | 变异只有 3 个成员 | 逐类别查覆盖矩阵 |
| 跨物种直接合并术语空间 | 四套本体不重叠 | 按物种分开,或先做本体映射 |
用 dateAssigned 做时间切分 |
它是注释时间不是录入时间 | 这个库上放弃时间切分 |
| 按注释行做 train/test | 同 PMID / 同基因跨侧 | 按 PMID 或同源群分组 |
把 is_marker_for 当致病证据 |
只是统计关联 | 只用 is_implicated_in 作正样本 |
爬 /downloads 页面 |
纯 JS 渲染,只有空壳 | 直接打 S3 桶 |
| 用 API 拉训练数据 | 无版本快照,会漂移 | 从固定 release 目录下载 |
§7 质量评估、DAIMS 与口径交叉核对
§7.1 记录级质量:Alliance 保证到什么程度
| 检查项 | 结果 |
|---|---|
| 表型注释挂 PMID | 100.0%(4,442,123 / 4,442,123) |
| 表型注释挂本体术语 | 100.0%(4,442,123 / 4,442,123) |
| 实体 ID 唯一性 | ✅ CURIE 形式,前缀区分成员 |
| 基因 SO 类型 | ✅ 带完整祖先链 |
| 基因跨库引用 | ✅ 平均 ≥6 类 |
| 分片间去重 | ❌ 无任何控制,重复 57% |
| 跨成员语义一致 | ❌ 四套本体 |
| 数据新鲜度一致 | ❌ 2024-09 到 2026-09 并存 |
这是一个"单条记录质量极高、整表可用性靠你自己"的库。 每一条注释都是人工策展、挂文献、挂本体——单看任何一行都可信。但把它们拼成一张表,需要你自己做去重、本体对齐、时间对齐三件事。Alliance 只负责前者,不负责后者。
§7.2 抽样声明:本条目数字的边界
| 数字 | 覆盖范围 | 状态 |
|---|---|---|
| 56,677,795 实体 | 全库(API 聚合) | ✅ 全量 |
| 七类分项计数 | 全库(API 分项 + 交叉验证) | ✅ 全量 |
| 23.04 GB / 1,848 文件 | 全量 S3 清点(31 个目录) | ✅ 全量 |
| 4,442,123 → 1,909,959 | 全量下载 8 个表型分片 | ✅ 全量 |
| 各成员重复率 | 全量 | ✅ 全量 |
| 本体术语分布 | 全量 | ✅ 全量 |
基因 HGNC:7881 字段 |
单条实例 | ⚠️ 单例 |
| 疾病注释 11 条 | 单条实例 | ⚠️ 单例 |
| 等位基因重复率 66.5% | 全量下载 3 个分片(8.9 MB) | ✅ 全量 |
| 其余 29 个类别的内部重复 | 未验证 | ❌ 未做 |
最后一行必须强调:我们全量下载了表型(132 MB)与等位基因(8.9 MB)两类,两类都发现严重重复(57.0% 与 66.5%)。其余 29 个类别没有验证。 由于两类独立数据出现完全一致的重复形态,从结构上看(同样按成员切分、同样按体积再切),
VARIATION、EXPRESSION、INTERACTION-*很可能存在同类问题。请先自己跑一遍 §6.1 的去重逻辑再建训练集。
§7.3 三个必须知道的生物学效度问题
问题一:模式生物的表型不能直接映射到人类临床表型。 小鼠的"异常惊跳反应"与人类的"惊跳反射亢进"看起来对应,但两者的测量方法、阈值、临床意义完全不同。MP → HP 的映射覆盖率有限,且映射本身就有争议。
问题二:基因同源不等于功能同源。 小鼠有 4 个 Hox 基因簇,果蝇只有 1 个(且发生了基因重复)。同源关系是序列层面的,功能可能已经分化。
问题三:敲除表型 ≠ 药物靶点表型。 基因敲除是"从出生起就没有这个基因",药物抑制是"成年后抑制蛋白活性"。两者在发育相关基因上差异极大。
§7.4 偏倚清单(可核查)
| 偏倚 | 证据 | 后果 |
|---|---|---|
| 研究热度偏倚 | 5,555 个人类基因有表型注释,约占人类蛋白编码基因的 28% | 剩下的 72% 在训练集里是"无注释",不等于"无表型" |
| 物种不均衡 | MGI 1,002,230 条 vs RGD 7,201 条,差 139 倍 | 混合训练时小鼠主导 |
| 本体覆盖偏倚 | MP 11,702 术语 vs APO 204 术语 | 酵母的表型描述粒度粗 57 倍 |
| 文献年代偏倚 | dateAssigned 最早到 2006 年 |
经典基因注释多,新基因少 |
| 成员策展深度偏倚 | ZFIN 重复 70%、RGD 重复 5% | 重复率本身反映了策展流程成熟度 |
| 变异集中于 3 物种 | 51,188,465 条变异只来自 MGI/RGD/ZFIN | "跨物种变异研究"在数据上不可能 |
§7.5 数据完整性核查表
| 核查项 | 方法 | 期望 |
|---|---|---|
| 分片数 | 列 9.1.0/PHENOTYPE/ |
8 |
| 原始行数 | 逐个 len(d["data"]) 累加 |
4,442,123 |
| 去重后行数 | 语义键去重 | 1,909,959 |
| 重复率 | 1 − 去重/原始 | 57.0% |
| PMID 覆盖率 | evidence.publicationId 非空 |
100% |
| 术语覆盖率 | phenotypeTermIdentifiers 非空 |
100% |
| 总目录数 | 列 9.1.0/ |
31 |
| 总体积 | 逐目录累加 <Size> |
23.04 GB |
| 全库实体 | /api/search?q=*&limit=0 |
56,677,795 |
§7.6 DAIMS 24 项逐项评分
| # | 检查项 | 判定 | 依据 |
|---|---|---|---|
| 1 | 宽格式/长格式明确 | ✅ | 表型为长格式,一条注释一行,结构规整 |
| 2 | 唯一标识符 | ⚠️ | 有 CURIE ID,但无注释级唯一 ID——同一基因同一表型多条注释只能靠内容区分 |
| 3 | 特殊字符处理 | ⚠️ | phenotypeStatement 含逗号与括号(notch gene homolog 1, (drosophila));JSON 安全,TSV 需注意 |
| 4 | 重复行 | ❌ | 实测重复 57.0%,无任何文档提及 |
| 5 | 缺失编码统一 | ⚠️ | metaData.release 出现 null;JSON 中缺失字段直接不出现,无统一 null 标记 |
| 6 | 标签/标识符说明 | ✅ | 字段名自解释,且有 ONTOLOGY 目录提供本体定义 |
| 7 | 罕见类别分组 | ❌ | 29,935 个术语中大量只出现个位数次,无分组建议 |
| 8 | 偏倚评估 | ⚠️ | 官方无偏倚声明;本条目 §7.4 自建 |
| 9 | 数据字典 | ⚠️ | 无独立数据字典页;字段含义靠 API 返回结构反推 |
| 10 | 信息性缺失解释 | ❌ | 为何表达只有 4 个成员?为何等位基因只有 ZFIN?无任何说明 |
| 11 | 设备/平台记录 | ❌ | 模式生物注释数据,无测序平台概念;但连"实验方法"字段也没有 |
| 12 | 共线性处理 | ❌ | 无 |
| 13 | 编码映射 | ⚠️ | 有 GEOXREF 映射表,但本体间的术语映射无官方表 |
| 14 | 时间戳处理 | ❌ | dateAssigned 是注释时间非数据时间;各分片 release 不一致(2024-09 到 2026-09);ZFIN 为 null |
| 15 | 划分建议 | ❌ | 完全无。且因重复率高,不划分的建议本身就会导致泄漏 |
| 16 | 泄漏讨论 | ❌ | 完全无。57% 重复 + 同 PMID 全覆盖,两个泄漏面都未提 |
| 17 | 标签分布 | ⚠️ | 术语可计数,但无官方分布报告 |
| 18 | 测量偏倚 | ❌ | 无「不同成员策展标准不同」的任何说明 |
| 19 | 外部验证建议 | ❌ | 无 |
| 20 | 版本记录 | ⚠️ | 有 release 号与日期,但分片级 release 不一致且部分为 null,且无逐数据快照 |
| 21 | 预处理脚本 | ⚠️ | 有官方文档与 API,但去重脚本无、本体映射脚本无 |
| 22 | 合规要求 | ⚠️ | 无全站统一许可文本,逐成员继承 |
| 23 | 多模态对齐 | ⚠️ | 序列/变异/表达/表型/互作多模态齐全,但跨模态对齐无说明;且各模态覆盖物种不同 |
| 24 | 去标识化 | ✅ | 无人类个体级数据;HUMAN 轴是基因-疾病注释 |
DAIMS 总分:11.5 / 24(47.9%)
| 判定 | 计数 | 得分 |
|---|---|---|
| ✅ 满足 | 3 | 3.0 |
| ⚠️ 部分满足 | 11 | 5.5 |
| ❌ 不满足 | 10 | 0 |
这个分数(47.9%)低于 BV-BRC(58.3%)与 IPD(55% 区间),只略高于 MGI(45.8%)。原因很具体:
扣分集中在"表能不能直接用"这件事上:#4 重复行(57%)、#14 时间戳(三套口径)、#15 划分建议、#16 泄漏讨论、#18 测量偏倚、#19 外部验证——六项全空或满分扣。其中 #4 是本条目认为最致命的:一个重复率 57% 的表,在不做去重的情况下任何划分都会泄漏,而官方文档一个字都没提。
加分项也很明确:#1 结构规整、#6 字段自解释、#24 无个体数据。这三项是"联盟式策展"天然占优的地方。
§7.7 口径交叉核对矩阵(不是模型性能验证)
显式声明:本节不是模型性能验证,不提供任何 benchmark 数字。它做的是:把同一概念在不同来源、不同成员下的数字并列,指出哪个该用在哪。把本节当"准确率"引用是误读。
| 概念 | 口径 A(官方宣传) | 口径 B(API 实时) | 口径 C(本方全量实测) | 该用哪一个 |
|---|---|---|---|---|
| 物种数 | “9 物种” | — | 分类别:GO 10 个目录、表型 5、GFF 5、表达 4、变异 3、等位基因 1 | 用 C。任何单一类别都不到 9 |
| 全库实体数 | 无统一数字 | 56,677,795 | 七类分项交叉验证一致 | 用 B |
| 变异数 | — | 51,188,465(占 90.3%) | — | 用 B,但要马上补一句"只来自 3 个物种" |
| 基因数 | — | 1,643,953 | — | 用 B |
| 表型注释数 | 无 | — | 原始 4,442,123 / 去重 1,909,959 | 必须用 C 的去重值。用原始值等于报了一个虚高 2.3 倍的数 |
| 表型重复率 | 无任何提及 | — | 57.0%(ZFIN 70.1% / MGI 52.7% / SGD 51.5% / HGNC 40.9% / RGD 5.2%) | 用 C。这是本条目最重要的数字 |
| 疾病数 | — | 12,282 | — | 用 B |
| 疾病模型数 | — | 561,158 | — | 用 B |
| 下载体积 | 无 | — | 23.04 GB / 1,848 文件(含 downloads/ 6.07 GB 历史归档;剔除后 16.97 GB) |
用 C,但要说明是否含归档 |
| 表型证据覆盖 | 官方称"well-curated" | — | PMID 100.0% / 本体术语 100.0% | 用 C,这是它真正的强项 |
| release 日期 | 9.1.0 / 2026-09-02 | releaseInfo 一致 |
分片级:2024-09-12 到 2026-09-15 外加 null | 三者都要说。“Alliance release 9.1.0” ≠ “所有数据都是 2026 年的” |
| MGI 版本 | — | — | 两个分片都标 MGI 6.27,但日期 2026-06-30 与 2026-09-15 |
同版本号两个日期,说明分片独立生成 |
这张表最重要的一行是"表型重复率"。它揭示了一个一般性规律:联盟式数据库的"总量"口径天生不可靠——因为每个成员独立打包,没人负责全局去重。Alliance 至少在字段层面做了统一(比什么都没有强),但没有在行层面做统一。
第二重要的是"release 日期"那一行。全局 9.1.0(2026-09-02)与 HUMAN/RGD 的
RGD-2024-SEP-12并列看,就能明白:"release 版本"是打包动作,不是数据新鲜度的承诺。 这个区分在任何多成员合并库里都成立。
§8 生态位与相邻资源
§8.1 它在模式生物数据生态里的位置
| 层级 | 资源 | 关系 |
|---|---|---|
| 上游(原始策展) | MGI、ZFIN、FlyBase、WormBase、SGD、RGD、XB | Alliance 的成员,各自维护原始数据 |
| 本层(跨库整合) | Alliance、Monarch Initiative | 把成员数据合并成统一模型 |
| 下游(序列与同源) | Ensembl、UCSC、NCBI | 提供基因组坐标与同源关系 |
| 临床侧 | OMIM、ClinVar、HPO | 人类疾病与表型 |
一个关键定位:Alliance 不做原始策展。它的表型数据全部来自成员,自己的贡献是"合并 + 统一字段"。这决定了它的价值上限——它不可能比成员库更新(实测 HUMAN/RGD 落后两年),也不可能提供成员库没有的信息。
§8.2 与本站已收录条目的衔接
| 本站条目 | 关系 |
|---|---|
mgi(#1341) |
包含关系,不是并列。MGI 的 141,808 等位基因 / 415,358 表型注释在 Alliance 里被并入统一模型。两篇都要收,因为粒度不同:MGI 讲小鼠纵深,Alliance 讲跨物种 |
bv-brc(#1342) |
同为"跨库整合"型。BV-BRC 是 PATRIC + IRD/ViPR 合并,Alliance 是 8 个模式生物库合并。两者的通病完全一样:合并后总量口径不可靠、成员数据新鲜度不一致 |
ipd-imght-hla(#125) |
无直接重叠。HLA 是人的免疫遗传学参考库,Alliance 的 HUMAN 轴是基因-疾病注释 |
gtex / tcga / uk-biobank |
人类个体级观察数据;Alliance 的 HUMAN 轴不是个体级,是基因-疾病断言 |
dryad(#124) |
通用仓库 vs 领域联盟,正好对照"通用 vs 专用" |
一个跨条目的观察:本站已收录的四个"参考型/整合型"数据库,在 DAIMS 上的扣分模式高度一致——都在 #15(划分建议)、#16(泄漏讨论)、#18(测量偏倚)、#19(外部验证)这四项上拿零分。这四项的共同点是:它们都是"给 AI 用"的要求,而不是"给人查"的要求。
这个规律值得记住:传统生物数据库的设计目标是"让人能找到并相信某一条记录",不是"让模型能在整表上训练"。 DAIMS 那 24 项里,凡是偏向"单条可信"的(#2 唯一标识、#6 字段说明、#9 数据字典、#24 去标识化),老库普遍得分高;凡是偏向"整表可用"的(#4 重复、#15 划分、#16 泄漏、#18 偏倚),普遍得分低。这不是某个库的失职,是整个领域的结构性缺口。
§8.3 下游消费者:谁在用 Alliance
- 模式生物社区:作为"一个入口查九个物种"的日常工具。
- 疾病模型研究:用
is_implicated_in找候选动物模型。 - 本体工程:Alliance 的
ONTOLOGY/目录被用作本体版本快照源。 - 临床遗传学:把人类变异位点映射到模式生物同源基因做功能推断。
- 教学:跨物种比较基因组学的标准素材。
§9 资源、引用与复现
§9.1 必读文献
- Alliance of Genome Resources Consortium. Alliance of Genome Resources Portal: unified model organism research platform. Nucleic Acids Res. 2020;48(D1):D650-D658. doi:10.1093/nar/gkz813
- Alliance of Genome Resources Consortium. Harmonizing model organism data in the Alliance of Genome Resources. Genetics. 2022;220(4):iyac022. doi:10.1093/genetics/iyac022
- Alliance of Genome Resources Consortium. The Alliance of Genome Resources: a centralized resource for model organism data. Nucleic Acids Res. 2023;51(D1):D737-D742
- Diehl AD, et al. The Cell Ontology 2016. J Biomed Semantics. 2016;7:44
第 2 篇是方法论关键:它专门讲"如何在八个成员库之间协调数据"。如果你想理解为什么字段统一了但本体没统一,读这篇。
§9.2 关键链接
§9.3 复现本条目全部数字的脚本
#!/usr/bin/env bash
# agr_probe.sh — 复现本条目全部数字
# 前提:bash + curl + python3(仅标准库)

set -e
API=https://www.alliancegenome.org/api
S3=https://download.alliancegenome.org

echo "===== ① 版本 ====="
curl -s "$API/releaseInfo"

echo "===== ② 全库总数 + 七类分面 ====="
curl -s "$API/search?q=*&limit=0" | python3 -c "
import sys, json
d = json.load(sys.stdin)
print('全库实体:', f\"{d['total']:,}\")
for a in d['aggregations']:
    if a['key'] == 'category':
        for v in a['values']:
            print(f\"  {v['key']:34s} {v['total']:>14,}\")
"

echo "===== ③ 分项交叉验证(逐类别单查)====="
for c in gene_search_result allele_search_result variant_search_result \
         disease_search_result model_search_result go_search_result htp_dataset_search_result; do
  t=$(curl -s "$API/search?q=*&category=$c&limit=0" | python3 -c "import sys,json;print(json.load(sys.stdin)['total'])")
  echo "  $c -> $t"
done

echo "===== ④ 31 个顶层目录 ====="
curl -s "$S3/?prefix=9.1.0/&delimiter=/" | grep -o '<CommonPrefixes><Prefix>[^<]*' | sed 's/.*>//'

echo "===== ⑤ 单目录的体积(PHENOTYPE 为例)====="
curl -s "$S3/?prefix=9.1.0/PHENOTYPE/" | python3 -c "
import sys, re
x = sys.stdin.read()
n = x.count('<Contents>')
b = sum(int(s) for s in re.findall(r'<Size>(\d+)</Size>', x))
print(f'文件 {n}, 体积 {b/1e6:.1f} MB')
"

echo "===== ⑥ 下载并语义去重(关键一步)====="
curl -s "$S3/?prefix=9.1.0/PHENOTYPE/" | grep -o '<Key>[^<]*' | sed 's/<Key>//' | grep 'json.gz$' > /tmp/phe_keys.txt
mkdir -p /tmp/agr && cd /tmp/agr
while read -r k; do
  f=$(basename "$k"); [ -f "$f" ] || curl -s -o "$f" "$S3/$k"
done < /tmp/phe_keys.txt

python3 - <<'PY'
import gzip, json, glob
def key(r):
    return (r.get('objectId'), r.get('phenotypeStatement'),
            tuple(t['termId'] for t in r.get('phenotypeTermIdentifiers') or []))
raw, seen = 0, set()
for f in sorted(glob.glob('/tmp/agr/*PHENOTYPE_*.json.gz')):
    d = json.load(gzip.open(f, 'rt'))
    raw += len(d['data'])
    for r in d['data']:
        seen.add(key(r))
print(f'原始行 {raw:,}')
print(f'去重后 {len(seen):,}')
print(f'重复率 {(raw-len(seen))/raw:.1%}')
PY
§9.4 BibTeX
@article{agr2022harmonizing,
  title   = {Harmonizing model organism data in the {Alliance} of {Genome} {Resources}},
  author  = {{Alliance of Genome Resources Consortium}},
  journal = {Genetics},
  volume  = {220},
  number  = {4},
  pages   = {iyac022},
  year    = {2022},
  doi     = {10.1093/genetics/iyac022}
}

@article{agr2020portal,
  title   = {Alliance of {Genome} {Resources} Portal: unified model organism research platform},
  author  = {{Alliance of Genome Resources Consortium}},
  journal = {Nucleic Acids Research},
  volume  = {48},
  number  = {D1},
  pages   = {D650--D658},
  year    = {2020},
  doi     = {10.1093/nar/gkz813}
}
§10 复用边界与跨条目协作手册
§1 到 §9 讲的是这个库本身。这一节回答更实际的问题:当你要同时用好几个参考库时,Alliance 该被放在哪个位置。
§10.1 决策树:你的问题是"找到一个基因"还是"训练一个模型"?
如果是"找到一个基因的相关信息",Alliance 是一线工具。理由很简单:is_implicated_in + crossReferences + phenotype 子资源,三次 API 调用就能把一个人类基因的疾病关联、小鼠同源基因、斑马鱼表型全部拉出来。这在以前是三个网站加手工对照。这条链在交互式探索场景下几乎没有对手。
如果是"训练一个跨物种表型预测模型",Alliance 是起点,不是答案。你必须自己补三件事:语义去重(57% 重复)、本体对齐(四套本体)、划分设计(按同源群而非按行)。这三件事官方一件都没做,而它们恰恰决定了模型能不能用。
如果是"做变异功能预测",Alliance 是可选而非首选。虽然 VARIATION 目录有 51,188,465 条,但它只来自 MGI / RGD / ZFIN 三个物种,而且条目数与文件体积严重不成比例(8 个文件只有 0.01 GB)。这意味着它存的很可能是"变异 ID 与基因的关联",而不是带功能注释的完整变异记录。做变异效应预测,还是应该去 ClinVar、gnomAD 或 BV-BRC 的专门数据表。
§10.2 跨库拼接:CURIE 是唯一的公共语言
Alliance 最值得称道的一点是全面使用 CURIE。这让你可以在库之间直接对接:
| ID 空间 | 稳定性 | 跨库可用性 | 用它在哪拼 |
|---|---|---|---|
CURIE(MGI:, HGNC:, ZFIN:…) |
高——这是 Alliance 的第一等公民 | 全行业通用 | 与任何用 CURIE 的库(Monarch、BioLink、Hetionet)直接拼 |
crossReferences 里的 ENSEMBL: / NCBI_Gene: |
高 | 全行业通用 | 与 Ensembl / NCBI 系拼接 |
phenotypeTermIdentifiers(MP:, HP:, APO:) |
高 | 本体级通用 | 与本体系(OBO Foundry)拼接 |
DOID(疾病) |
高 | 本体级通用 | 与任何用 DOID 的疾病库拼接 |
三条断裂线:
断裂线一:CURIE 前缀暴露物种,做模型特征时必须剥离。 这是 §5.3 讲过的结构泄漏。拼接时没问题(前缀正是你需要的),建模时是灾难。
断裂线二:Alliance 的 HGNC: 与 IPD-IMGT/HLA 的 HLA: 是两个不相交的命名空间。 HLA 等位基因有自己的命名法(A*01:01:01:01),不在这套 CURIE 体系里。做免疫遗传学拼接时,没有现成的桥。
断裂线三:模式生物的表型本体与人类临床术语(ICD、SNOMED)之间没有官方映射。 MP → HP 有映射,但 HP → ICD-10 是另一段路。从"小鼠表型"走到"ICD 编码",中间要跨两道本体桥,且第二道桥的覆盖率很低。
§10.3 同一份"基因-疾病"信息在本站的三种形态
本站已收录的条目里,"基因与疾病的关系"会以三种形态出现,训练用途完全不同:
形态一:跨物种策展断言(本条 + mgi)。特征是"每条断言挂文献、挂本体、挂策展方"。适合做知识图谱补全、疾病基因优先级排序。偏倚是"研究热度"——只有 5,555 个人类基因有注释。
形态二:人类个体级观察(如 uk-biobank、gtex)。特征是"每个个体有基因型 + 表型观测"。适合做GWAS、孟德尔随机化。偏倚是"谁被纳入队列"。
形态三:临床变异解读(如 clinvar 类)。特征是"每个变异位点有临床意义判定"。适合做变异致病性预测。偏倚是"被送检的位点不是随机样本"——临床送检有强烈的先验筛选。
把三者拼起来时最容易犯的错:拿形态一的"基因牵连疾病"断言当形态三的"变异致病"标签。基因层面的关联不等于位点层面的致病性——一个基因与某疾病相关,不代表这个基因上的任何一个变异都致病。这两件事在数据上、在生物学上都是两回事。
§10.4 许可:逐成员继承,没有统一文本
| 成员 | 典型许可 | 能做什么 |
|---|---|---|
| MGI | CC BY 4.0(图片除外) | 打包、再分发、商用(署名) |
| SGD | CC BY 4.0 | 同上 |
| ZFIN | CC BY 4.0 | 同上 |
| RGD | CC BY 4.0 | 同上 |
| FlyBase / WormBase | 各自条款 | 需逐个核对 |
Alliance 层面没有一份统一的许可文件,它继承成员的许可。这在实操上意味着:你要对外分发一个包含 Alliance 数据的包,必须先确认包里每个成员的数据分别是什么许可。 好消息是主流成员都是 CC BY 4.0,坏消息是你得自己逐条核对,而不能引用一句话。
一条实践规则(与 BV-BRC 条目一致):最终包的许可由链条上最紧的一环决定。 如果某个成员是 CC BY-NC,整个包里含它的部分就不能商用。
§10.5 三个"不要在这个库上做"的研究
不要做一:用实体总数做"数据丰富度"排名。 56,677,795 这个数字里 90.3% 是变异,而变异只来自 3 个物种。用它去说"Alliance 比 MGI 数据多 40 倍"是错的——MGI 一个库的表型注释去重后是 1,002,230 条,而全库去重后是 1,909,959 条,MGI 占了 52.5%。按表型算,Alliance 只是 MGI 的两倍;按变异算,Alliance 是 MGI 的几十倍。“多"这个字在这个库里必须带上"哪个类别”。
不要做二:跨 9 物种的表型保守性分析,直接合并术语。 §4.3 与坑点 6 已经证明:MP / HP / APO / PATO+ZFA 四套本体的语义结构都不同——前三个是"标签",第四个是"实体+质量"二元组。直接合并等于把苹果、橘子、和"苹果的红色"这三样东西放进同一个分类器。
不要做三:假设 release 9.1.0 意味着所有数据都是 2026 年的。 HUMAN 与 RGD 的表型快照标着 RGD-2024-SEP-12——落后全局两年。ZFIN 三个分片连 release 都是 null。这不是疏漏,是多成员库的固有结构:版本号统一的是打包动作,不是数据本身。
§10.6 一句话总结这一节
Alliance 的价值在于"把九个物种的 ID 和字段对齐了",不在于"把九个物种的语义对齐了"。 拿它做交互式检索,它很好用;拿它做训练集,你必须自己补三道工:去重(57%)、本体对齐(四套)、划分设计(按同源群)。在这三道工之内用它,它能省掉你几个月的数据收集;省掉这三道工,它会用一份虚高 2.3 倍的样本量和一个被泄漏污染的测试集,给你一个漂亮而没有任何意义的准确率。
附录 A:本条目数字的一页速查
| 问题 | 答案 |
|---|---|
| 版本? | 9.1.0,2026-09-02 |
| 全库多少实体? | 56,677,795 |
| 有多少变异? | 51,188,465(90.3%),但只来自 3 个物种 |
| 有多少基因? | 1,643,953 |
| 有多少表型注释? | 原始 4,442,123 → 去重 1,909,959 |
| 表型重复率多少? | 57.0%(ZFIN 70.1% / MGI 52.7% / SGD 51.5% / HGNC 40.9% / RGD 5.2%) |
| 别的类别也重复吗? | 等位基因重复 66.5%(原始 241,014 → 去重 80,626)。两类独立数据同一形态,说明是系统性缺陷 |
| 几个物种? | 9(但表型 5 个、表达 4 个、变异 3 个、等位基因 1 个) |
| 下载多大? | 23.04 GB / 1,848 文件(剔除历史归档后 16.97 GB) |
| 有几个数据类别? | 31 |
| 证据覆盖? | PMID 100% / 本体术语 100% |
| 有几套表型本体? | 4 套:MP(小鼠、大鼠)、HP(人)、APO(酵母)、PATO+ZFA+GO+CHEBI(斑马鱼) |
| API 免注册吗? | 是 |
| 疾病注释怎么查? | POST /api/disease,body 为 ["HGNC:7881"] |
| 基因能按符号查吗? | 不能。/api/gene/NOTCH1 返回 400,只认 CURIE |
| 能做时间切分吗? | 不能。dateAssigned 是注释时间,各分片 release 不一致(2024-09 到 2026-09),ZFIN 为 null |
| 最大的坑是什么? | 分片间重复 57%,直接拼接虚高 2.3 倍 |
| 拿来做什么最合适? | 交互式基因检索、跨物种同源映射、疾病基因优先级、本体工程 |
| 绝对不能做什么? | 用实体总数排名、跨物种合并术语空间、假设 release 号等于数据新鲜度 |
最后更新:2026-10-23
数据采集:2026-10-22 至 2026-10-23(沙箱环境实测;表型类全量下载 132 MB 后本地重算,其余类别基于 S3 元数据与 API 计数)
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- ipd-imght-hla — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- mgi — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- sequence-ontology — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- cspec — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- hra-knowledge-graph — 共享标签:基因组学与多组学 / 多模态 / 知识图谱
- pfam — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- interpro — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- cath — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- ecod — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
- hpo — 共享标签:基因组学与多组学 / 变异与注释 / 知识图谱
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
