即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 1843 个数据集
PatchGastricADC22 — 胃腺癌活检 WSI 图文对 patch 数据集
Medmain Research 从 IUHW 三田医院 991 张胃腺癌内镜活检 H&E 全切片抽取 262,777 张 300×300 patch,每张切片配对一条诊断报告级 caption——病理图文配对与报告自动生成任务的 CC-BY-4.0 公开基准
Prov-GigaPath — 微软与 Providence 的 13 亿图块全片病理基础模型
基于 Providence 医疗系统 171,189 张全片病理图像、13.8 亿个 256×256 图块预训练的全片病理基础模型,以 LongNet 超长上下文建模整张 gigapixel 切片,26 项数字病理任务中 25 项达 SOTA——权重公开却受 gated 条款约束、官方明确 research-only 禁用临床与商业部署
Speech Commands Dataset — 105,829 条 1 秒关键词识别音频语料
Google Brain 发布的限定词表语音识别基准:35 个英文单词 + 背景噪声,2,618 名说话人,1 秒 16kHz WAV,CC BY 4.0 公开——端侧关键词识别的经典训练与评测集
SINAN-Dengue — 巴西法定疾病通报系统登革热与基孔肯雅通报数据(2013 — 2020)
巴西卫生部 SINAN 系统 2013–2020 年登革热与基孔肯雅通报记录的统一化数据集:原始 13,421,230 条 / 118 属性经预处理为 7,632,542 条 / 56 属性,含确诊登革热 4,307,513、确诊基孔肯雅 325,000 与排除/不确定 2,100,029 三分类,CC BY 4.0 于 Mendeley Data 公开
CAMI II — 宏基因组解读关键评估第二轮挑战基准
1,680 个微生物基因组 + 599 个环状元件模拟的海洋/高菌株多样性/植物相关三环境宏基因组基准,30 队 76 程序 5,002 组结果的全景评测——Nature Methods 2022,含组装/分箱/profiling/临床病原检测五任务
QMugs — 类药物分子量子力学性质数据集
ETH Zurich RETHINK 组从 ChEMBL 提取 665,911 个类药物分子、生成 1,992,984 个构象,在 GFN2-xTB 与 DFT(ωB97X-D/def2-SVP)双理论级别上计算能量、部分电荷、转动常数乃至 DFT 密度与轨道矩阵波函数,未压缩逾 7 TB——首个面向类药物大分子的第一性原理量化数据集合,为 Δ-learning 与构象感知的量子机器学习铺路,Sci Data 2022 开放获取
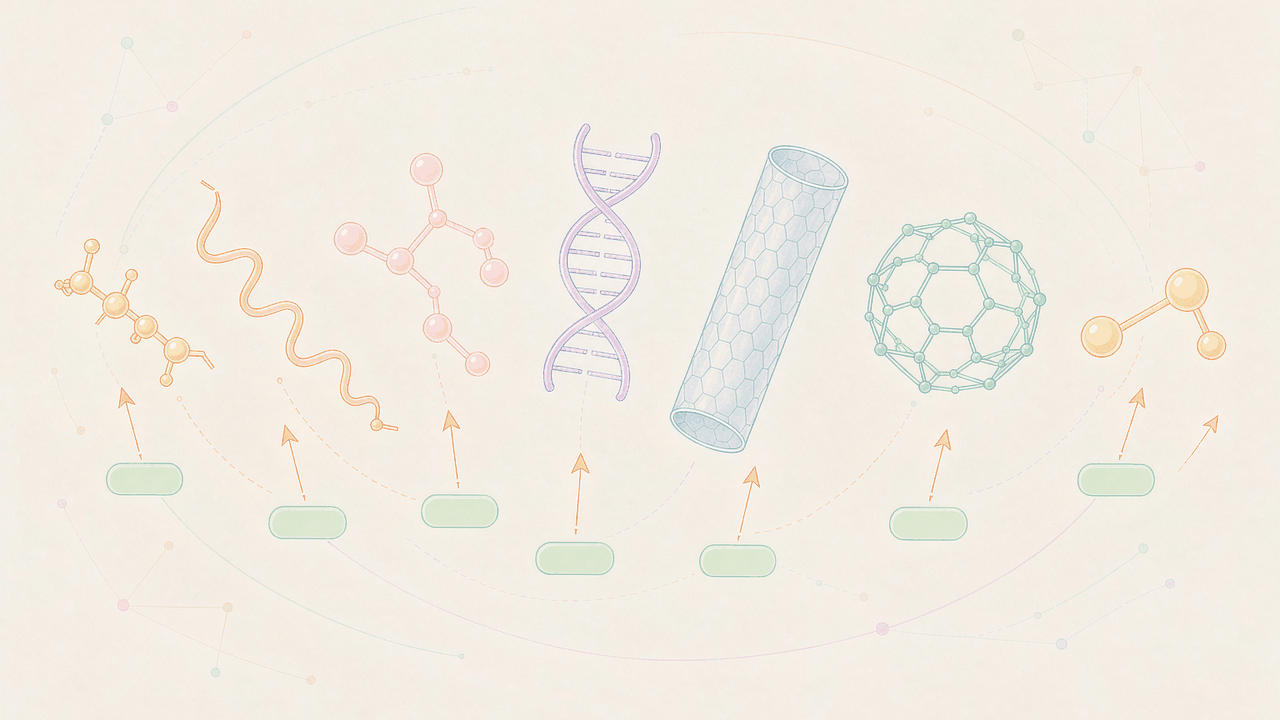
MD22 — 42 至 370 原子生物大分子的 DFT 轨迹与力场基准
MD17 的大体系升级版——7 个生物大分子/超分子(四肽、脂肪酸、四糖、DNA 碱基对、巴基球捕捉器、双壁纳米管)的 FHI-aims + i-PI 从头算 MD 轨迹,含 DFT-PBE+MBD 势能与原子受力标签,共 32 万余构型,CC0-1.0 于 sgdml.org 公开
ANI-1x — 主动学习生成的 500 万分子构象 DFT 数据集
Los Alamos 国家实验室用 Query by Committee 主动学习采样约 495.6 万 CHNO 有机分子非平衡构象、7570 万原子,以 ωB97X/6-31G(d) 标注能量/力/偶极,CC0 公共领域奉献,成为机器学习势与 ANI-1ccx 迁移学习的通用底座
Open Catalyst 2020 — Meta FAIR 与 CMU 的亿级 DFT 电催化数据集
Meta FAIR 与 CMU 合建的异相电催化开放数据集:1,281,040 次 DFT 弛豫、约 2.65 亿次单点计算、460,328 个吸附质-催化剂体系与 133,934,018 帧 S2EF 训练数据,CC BY 4.0 全开放,定义了 AI for Science 时代材料模拟数据集的规模标杆
CSAR — 社区结构-活性资源基准数据集
美国国立卫生研究院资助、密歇根大学 Carlson 团队主持的社区结构-活性资源:以 Binding MOAD 与 PDBbind 精选 343 个高质量蛋白-配体复合物及 Kd/Ki 亲和力构建 2010 基准实验,衍生 CSAR-NRC HiQ 与 2012 制药数据捐赠集,成为分子对接打分函数评测的公共标尺
Drug Target Commons — 社区众包的药物-靶点生物活性开放知识库
DTC 是赫尔辛基大学 FIMM 团队主持的众包平台:把 ChEMBL、BindingDB 与文献散落的数百万条药物-靶点生物活性数据统一提取、μBAO 协议注释、管理员审核后开放下载(CC BY-NC-SA 3.0),提供 CSV 全量导出、数据库 dump 与 API 三通道,是化学信息学与药物再利用研究的公共生物活性底座
AqSolDB — 9982 化合物水溶性参考数据集
荷兰 DIFFER 研究所 AMD 团队从 9 个公开数据集系统性策展出的最大开放水溶性参考库——统一 LogS 单位、SMILES 往返校验、多源竞争值统计选值算法加 RDKit 二维描述符,成为分子性质回归的经典基准
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
