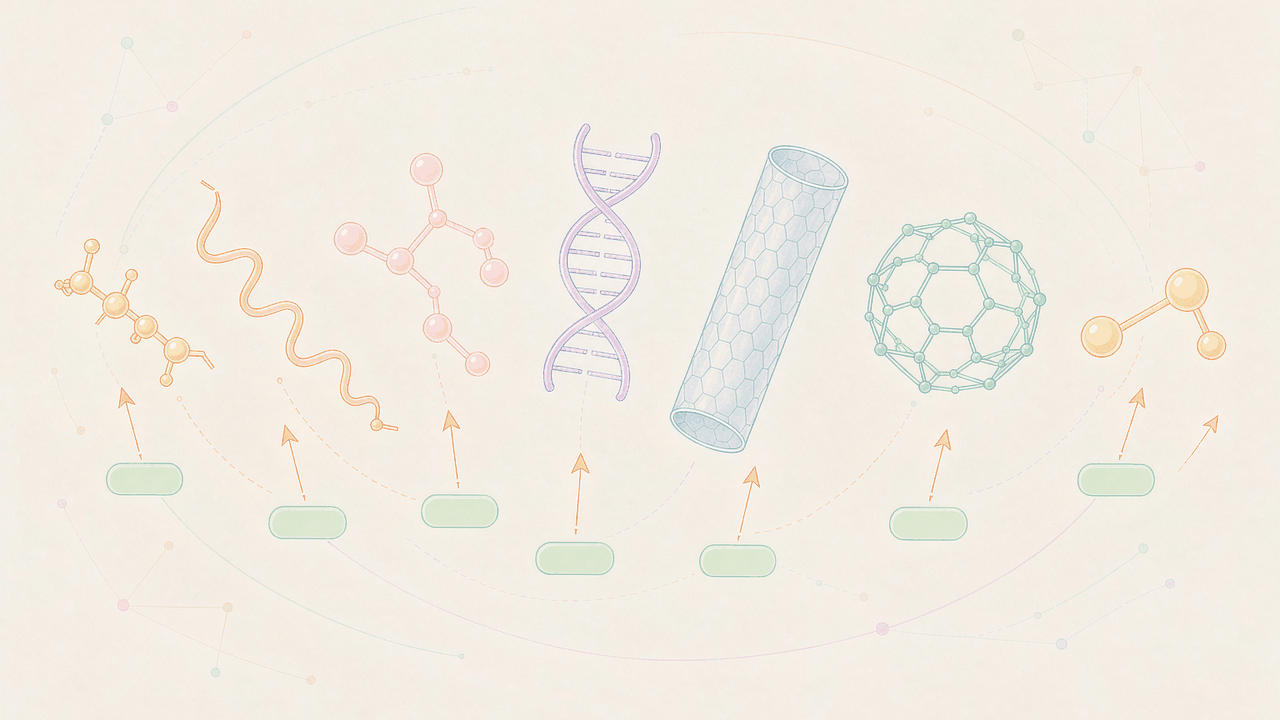
信息速览
INFOBOX — MD22 一屏速览
维度 内容 本质 面向机器学习力场(MLFF)的生物大分子/超分子 MD 轨迹基准,MD17 的"大体系升级版" 论文 Science Advances 2023;9(2):eadf0873(doi:10.1126/sciadv.adf0873);预印本 arXiv:2209.14865 团队 Stefan Chmiela、Klaus-Robert Müller(TU Berlin/BIFOLD)、Alexandre Tkatchenko(University of Luxembourg)等 7 人 体系 7 个:四肽 / 脂肪酸 / 四糖 / 2 个 DNA 碱基对 / 巴基球捕捉器 / 双壁纳米管 规模 原子数 42–370;总构型 323,422;总原子-帧 23,716,460 标签 每个构型的总势能 + 逐原子受力三维向量 方法 DFT-PBE+MBD 层级;FHI-aims(电子结构)+ i-PI(MD);1 fs 步长;400–500 K 基组 小体系 tight、两超分子light(FHI-aims 关键词)主结果 全局 sGDML 力场力 RMSE ≈ 1 kcal/mol/Å,无需局域性近似即可处理数百原子体系 获取 sgdml.org 免注册直下(.npz);ColabFit Exchange 7 个 Parquet 镜像 许可 CC0-1.0(公共领域贡献,无附加限制) 库内互链 QM9(rid=105)、ProteinGym(rid=813)、Human Protein Atlas(rid=404)
MD22 是机器学习力场(Machine Learning Force Field, MLFF)领域的一块"压力测试台"。它的前身 MD17(2017)把"用小分子从头算数据训练力场"变成了标准赛道,但 MD17 的分子最多只有几十个原子,模型很容易靠"只看每个原子的近邻"蒙混过关——这个捷径叫做局域性假设(locality assumption)。MD22 把题目加难:7 个体系从 42 原子的四肽一路做到 370 原子的双壁碳纳米管,规模、柔性、非局域性三轴同时拉满,逼着模型学会刻画"隔了十几个化学键仍彼此牵动"的长程关联。它既是数据集,也是"全局力场能否扩展到数百原子"这一问题的正面回答。
导语读法三则:
- 只想下数据:直奔 §6——sgdml.org 免注册直下 CC0-1.0 的 .npz,或走 ColabFit 的 Parquet 镜像。
- 关心能不能训得动:直奔 §5——论文表 I 给出 7 体系各训练集大小与 sGDML 的能量/力误差,是选训练集规模的直接依据。
- 想把 MD17 的模型搬过来:直奔 §9——注意 MD22 是"升级版但不是替代品",跨数据集迁移的坑在 §10 坑 5。
扩展摘要(600 字读懂 MD22)
MD22 是 2023 年随 Science Advances 论文 Accurate global machine learning force fields for molecules with hundreds of atoms 发布的机器学习力场基准数据集。它包含 7 个生物相关分子体系的从头算分子动力学(MD)轨迹:四肽 Ac-Ala3-NHMe(42 原子)、脂肪酸 DHA(56 原子)、四糖 Stachyose(87 原子)、两个 DNA 碱基对片段 AT-AT(60 原子)与 AT-AT-CG-CG(118 原子)、超分子巴基球捕捉器(148 原子)与双壁碳纳米管(370 原子)。每个体系提供逐构型的总势能与逐原子受力三维向量,标签在 DFT-PBE+MBD 层级下由 FHI-aims + i-PI 计算,时间步长 1 fs,采样温度 400–500 K。7 个体系合计 323,422 个构型(本文按论文 Table SII 逐项求和)、23,716,460 原子-帧。
数据集的核心设计意图是突破 MD17(2017)的规模天花板。MD17 的分子最多几十个原子,模型只需刻画局部化学环境即可拟合,掩盖了"局域性假设"在非局域效应上的根本缺陷。MD22 把体系做大、把非局域效应做强(尤其双壁纳米管的内外管协同旋转),迫使模型面对"隔了十几个化学键仍相互牵动"的长程关联。论文同时提出配套的全局 sGDML(对称梯度域机器学习)力场,不做任何局域化近似,让全部原子自由度保持关联,在 7 体系上均达到力 RMSE ≈ 1 kcal/mol/Å,并用**纳米秒级路径积分分子动力学(PIMD)**验证了大体系模拟的长期稳定性。
MD22 以 CC0-1.0 公共领域许可开放,经 www.sgdml.org 免注册直下(.npz),并有 ColabFit Exchange 的 7 个 Parquet 镜像(各带独立 DOI)。它已成为 MACE、NequIP、PaiNN、EScAIP 等主流力场的公共评测集,是"模型能否扩展到数百原子"的事实标准。对本库读者而言,它属于"药物发现与化学"域,不含任何临床或人类受试数据(patient_tags:不适用),是与 QM9(rid=105)、ProteinGym(rid=813)等同谱系的分子层面基准。
本条目一处重要订正:任务头给出的预印本编号 arXiv:2205.09566 经一手核验为错误(该编号是微分几何论文);MD22 的正确预印本编号为 arXiv:2209.14865(详见 §2、坑 1)。
§0 导读:这个数据集解决什么问题
十年来,机器学习力场(MLFF)最尴尬的一条边界线是"几十个原子"。模型的复杂度随体系规模近似平方增长(原子两两相互作用),于是对稍大的分子,主流做法就退回到局域性假设:把总能量拆成每个原子的局部贡献,只让每个原子"看见"附近几个原子的环境。这个近似在大量场景下够用,代价是它从原理上无法描述非局域相互作用——即便参考数据里明明含有这些效应。对生物大分子尤其致命:蛋白质骨架的协同运动、核酸碱基间的长程堆积、超分子的整体旋转耦合,恰恰都是"隔山打牛"的效应。
MD22 的回答分两步。第一步是数据:构建 7 个比 MD17 大得多的体系,覆盖蛋白质(四肽)、脂质(脂肪酸)、碳水化合物(四糖)、核酸(DNA 碱基对)与超分子(巴基球捕捉器、双壁纳米管)四大类生物相关分子,每个都给出 DFT 级别的势能与原子受力轨迹。第二步是方法:论文同时提出"全局对称梯度域机器学习"(global sGDML)的迭代训练方案,不做任何原子相互作用局域化,让全部原子自由度保持关联,从而在数百原子体系上仍达到力 RMSE ≈ 1 kcal/mol/Å 的精度。数据集与方法是配对发布的——用 MD22 训练、用 sGDML 跑通,构成一个自洽的"大体系力场"范例。
§0 读法三则:
- 这个条目是"数据集 + 方法论文 + 基准"三位一体:MD22 是数据,sGDML 是配套方法,表 I 是基准成绩单——三者共用一篇论文,勿当成三个独立资源。
- 全文硬数字均出自论文 Table I / Table SI / Table SII;总构型数 323,422 是 7 项 Size 求和(本文自算),与 ColabFit 的逐项口径一致但需自行汇总(坑 3)。
- 任务头曾把预印本误记为 arXiv:2205.09566,一手核验后确认正确编号为 arXiv:2209.14865(坑 1)。
§1 数据集速览:十问十答
Q1:MD22 的"22"是什么意思?
它是 MD17 的命名延续,编号本身不对应分子数或原子数。数据集共 7 个体系,与 MD17 的 8 个小分子(苯、甲苯、丙二醛、乙醇、天冬酰胺、水杨酸、偶氮苯、乙酰乙酸)形成世代关系:MD17 管"小分子精确",MD22 管"大分子可扩展"。
Q2:7 个体系分别是什么?
(1) Ac-Ala3-NHMe——封端四肽,42 原子,属蛋白质类;(2) DHA(二十二碳六烯酸)——omega-3 脂肪酸,56 原子,属脂质类;(3) Stachyose(水苏糖)——四糖,87 原子,属碳水化合物类;(4) AT-AT——两个腺嘌呤-胸腺嘧啶碱基对,60 原子;(5) AT-AT-CG-CG——扩展为四个碱基对,118 原子,两者属核酸类;(6) Buckyball catcher(巴基球捕捉器)——一个 C60 嵌套在桶状分子内,148 原子;(7) Double-walled nanotube(双壁碳纳米管,边缘饱和氢)——370 原子,后两者属超分子类。
Q3:数据里到底有什么?
每个构型(一个分子在某一时刻的原子坐标快照)包含:原子种类与三维坐标、该构型的总势能、以及每个原子的受力三维向量。坐标与力是模型的输入/监督信号,能量是全局约束。不含偶极矩、电荷、电子密度等电子结构标签。
Q4:这些标签怎么算出来的?
电子结构用 FHI-aims 软件、在 DFT-PBE+MBD 层级求解(PBE 泛函 + 多体色散校正,后者负责捕捉范德华/长程色散力);分子动力学用 i-PI 引擎跑,时间步长 1 fs,温度 400–500 K(小体系 500 K、两超分子 400 K),恒温器为全局 Langevin 或 Nosé-Hoover。
Q5:一共多少个构型?
按论文 Table SII 逐项求和:85,109 + 69,753 + 127,272 + 20,001 + 10,153 + 6,102 + 5,032 = 323,422 个构型。若按"原子数 × 构型数"累计,总原子-帧为 23,716,460。
Q6:训练集用多少?
论文按"力预测 RMSE 约 1 kcal/mol/Å"的目标反推每组训练集大小(Table I):四肽 6k、DHA 8k、Stachyose 8k、AT-AT 3k、AT-AT-CG-CG 2k、巴基球捕捉器 600、纳米管 800。注意这不是固定比例划分——600 到 8000 样本不等直接反映各体系学习难度差异。
Q7:精度有多高?
配套的全局 sGDML 力场在 7 体系上力均值绝对误差(MAE)介于 0.52–0.79 kcal/mol/Å,能量 MAE 介于 0.0079–0.046 kcal/mol(逐原子归一)。其中纳米管力 MAE 最低(0.52),Stachyose 能量 MAE 最高(0.046),与体系柔性和采样密度一致。
Q8:CC0-1.0 意味着什么?
意味着贡献者放弃全部著作权,数据进入公共领域:可自由使用、修改、再分发,商用亦无限制,无需署名(ColabFit 各子数据集页与 sgdml.org 均标注 CC0-1.0)。这是本库中许可最宽松的条目之一。
Q9:和 QM9、MD17 什么关系?
QM9(库内 rid=105)是"静态小分子 + 多性质"的量子化学基准(约 13.4 万分子,几何优化态),MD22 是"动态大分子 + 能量与力"的力场基准(32 万余构型,MD 轨迹);MD17 是 MD22 的前身(8 个小分子)。三者同为分子 ML 基准谱系的不同世代,细节见 §9。
Q10:谁该用、谁别用?
该用的是:做 MLFF/等变神经网络势(如 MACE、NequIP、PaiNN)训练与评测的研究者、研究长程/非局域相互作用的计算化学团队、需要 DFT 级分子动力学数据的方法开发者。别用的是:期待临床医学影像/病历条目者——MD22 是纯粹的计算化学数据,无任何人类受试信息(patient_tags:不适用)。
1.1 一页纸读懂 MD22 的坐标
如果只记三件事,记这三件:
- 它是"力"的数据集,不是"性质"的数据集。QM9 给的是 13.4 万分子的 HOMO/LUMO/偶极矩等静态性质;MD22 给的是 7 个分子在运动中的势能与逐原子受力。前者回答"分子长什么样、有什么性质",后者回答"分子怎么动、受力多少"——后者才是训练力场(跑 MD 的引擎)所需的信号。
- 它的难度轴是"规模 + 非局域性",不是"精度"。MD17 已经把小分子的精度做到很高;MD22 的贡献是把体系做大、把非局域效应做强,逼模型走出"只看近邻"的舒适区。
- 它的方式论主张是"全局可以扩展到数百原子"。配套的全局 sGDML 力场证明:不做局域化近似,也能在 370 原子上跑纳米秒级模拟——这是 MD22 想让人记住的核心结论。
1.2 与相邻资源的一句话对照
| 你想要的 | 用哪个 | 一句话区别 |
|---|---|---|
| 小分子的多量子化学性质 | QM9(本库 rid=105) | 静态优化态、134k 分子、性质多而全 |
| 小分子的动力学(能量+力) | MD17(本库无) | 8 个 9–21 原子小分子、力场入门基准 |
| 修正版小分子动力学 | rMD17(本库无) | 同 MD17 规模、重算提高数据质量 |
| 大分子的动力学(能量+力) | MD22(本条目) | 7 个 42–370 原子体系、含非局域超分子 |
| 含激发态/非绝热 | WS22 / xxMD(本库无) | 电子激发态与耦合,非基态势能面 |
| 蛋白质突变适应度 | ProteinGym(本库 rid=813) | 序列-功能层面,非物理势能面 |
1.3 本条目覆盖范围声明
本条目覆盖 MD22 数据集本体、其配套论文(Science Advances 2023;9(2):eadf0873)与配套方法(全局 sGDML),以及其授权、获取、生态。不覆盖:论文附录 B 的 donor-bridge-acceptor 演示数据(非 MD22 体系,坑 7);MD17/rMD17(另属独立数据集,本库无条目);ColabFit 平台本身的机制(另属基础设施条目)。
1.4 三十秒判断:这个数据集和你的关系
按使用场景给出"该不该用 MD22"的快速判断:
| 你的场景 | 判断 | 理由 |
|---|---|---|
| 训练/评测机器学习力场 | ✅ 用 | 这是它的首要用途 |
| 研究分子动力学加速 | ✅ 用 | 提供 DFT 级参考轨迹 |
| 研究非局域/长程相互作用 | ✅ 重点用 | 纳米管是其设计核心 |
| 做蛋白质结构预测 | ⚠️ 慎用 | 只含一个四肽,非结构数据集 |
| 做药物-靶点结合预测 | ⚠️ 慎用 | 无配体-蛋白复合物、无溶剂 |
| 做临床影像/病历分析 | ❌ 别用 | 无任何人类数据 |
| 做材料(金属/氧化物)力场 | ❌ 别用 | 仅含 CHNO 有机体系 |
| 做电子结构/激发态 | ❌ 别用 | 只有基态势能与力 |
| 做分子生成 | ❌ 别用 | 非生成式数据集 |
1.5 一条"最短学习路径"
如果你从未接触过机器学习力场,想借 MD22 入门,推荐路径:
- 先读论文摘要与图 1,理解"局域 vs 全局"的问题设定(约 30 分钟)。
- 下载最小的 Ac-Ala3-NHMe(42 原子),用现成工具(sGDML 官方代码)训练一个力场(约 1 小时)。
- 在测试集上看能量/力误差,与论文表 I 的 0.79 kcal/mol/Å 对照(验证管线)。
- 换到双壁纳米管(370 原子),体会规模增长带来什么(训练时间、内存、精度变化)。
- 跑一段短 MD,观察能量是否守恒(理解"单帧精度 ≠ 长时稳定")。
- 读论文 §IV 的 PIMD 部分,理解为什么稳定性验证是终极标准。
这条路径不需要集群、不需要昂贵设备,MD22 的低门槛设计正是为了让这条路径可行。
1.6 本条目与"医学"的关系(读者须知)
MD22 出现在"千方病案医数集"这样的医学数据平台,可能让读者疑惑其相关性。说明如下:
- 它不是医学数据集:无患者、无临床变量、无影像。patient_tags 标注为"不适用"。
- 它与医学相关的方式:它是计算药物发现与生物分子模拟的基础设施。药物分子与靶点蛋白的结合、生物大分子的构象变化,都需要精确的力场来描述——MD22 正是训练/评测这类力场的基准。
- 它的类目归属:category_tags 取"药物发现与化学",L2 取"量子化学"“分子性质预测”,与库内 QM9、ProteinGym、DrugTargetCommons 等同处一个方法学谱系。
- 一句话:MD22 是"分子层面的生物医学"的坐标系,而非临床医学条目。收录它是为了补齐"从分子到临床"链条中最底层的分子模拟环节。
1.7 关键数字速记(打印版)
体系数            7
原子数范围        42 – 370
总构型数          323,422    (自算:7 项 Size 求和)
总原子-帧         23,716,460 (自算:Σ 原子数 × 构型数)
训练样本范围      600 – 8,000(按力 RMSE≈1 反推)
力 MAE 范围       0.52 – 0.79 kcal/mol/Å
能量 MAE 范围     0.0079 – 0.046 kcal/mol(逐原子)
理论层级          DFT-PBE+MBD
软件              FHI-aims(电子结构)+ i-PI(MD)
步长              1 fs
温度              400 K(超分子)/ 500 K(其余)
基组              tight(5 体系)/ light(2 超分子)
许可              CC0-1.0
期刊              Science Advances 2023;9(2):eadf0873
预印本            arXiv:2209.14865   (非 2205.09566,坑 1)
1.8 本条目结构导航
- §0 导读 → 问题设定
- §1 速览 → 十问十答 + 关键数字
- §2 数据构成 → 七体系详解、计算细节
- §3 世代关系 → 从 MD17 到 MD22
- §4 构造过程 → 可复现性与检查清单
- §5 基准结果 → Table I 全量 + PIMD 验证
- §6 获取与许可 → CC0-1.0 与三种途径
- §7 生态与影响 → 非局域性、三重用途
- §8 方法学启示 → 五条可迁移经验
- §9 库内互链 → QM9 等 + rid
- §10 避坑清单 → 十个坑
- §11 总结|§12 深度问答|§13 结语
- §14 写作说明|§15 独立评估
- FAQ / 事实清单 / 术语表 / 附录 A–M
§2 数据构成与规格
2.1 七个体系一览(论文 Table I + Table SII 合并口径)
| # | 体系 | 类别 | 分子式 | 原子数 | 总构型数 | 训练样本 | 占全量比例 |
|---|---|---|---|---|---|---|---|
| 1 | Ac-Ala3-NHMe | 蛋白质(四肽) | C₁₂H₂₂N₄O₄ | 42 | 85,109 | 6k | 7% |
| 2 | DHA(二十二碳六烯酸) | 脂质(脂肪酸) | C₂₂H₃₂O₂ | 56 | 69,753 | 8k | 12% |
| 3 | Stachyose(水苏糖) | 碳水化合物(四糖) | C₂₄H₄₂O₂₁ | 87 | 127,272 | 8k | 29% |
| 4 | AT-AT | 核酸(DNA 碱基对) | C₂₀H₂₂N₁₄O₄ | 60 | 20,001 | 3k | 15% |
| 5 | AT-AT-CG-CG | 核酸(DNA 碱基对) | C₃₈H₄₂N₃₀O₈ | 118 | 10,153 | 2k | 20% |
| 6 | Buckyball catcher | 超分子 | C₁₂₀H₂₈ | 148 | 6,102 | 600 | 10% |
| 7 | Double-walled nanotube | 超分子 | C₃₂₆H₄₄ | 370 | 5,032 | 800 | 16% |
合计:7 个体系;原子数 42–370;总构型 323,422;总原子-帧 23,716,460(自算,见坑 3)。
2.2 体系的化学身份逐一说明
(1)Ac-Ala3-NHMe——封端四肽,42 原子,85,109 构型。
分子式 C₁₂H₂₂N₄O₄。它由三个丙氨酸残基构成主链,两端分别用乙酰基(Ac)与甲胺基(NHMe)封端,模拟蛋白质中一段被埋在长链内部的短肽局部环境——封端的作用是消除带电末端对构象的干扰,让这段四肽"像在蛋白质内部一样"运动。它是最小的、仍有真实二级结构自由度的肽段之一:主链存在多个可旋转二面角(φ、ψ),因此能呈现拉伸/卷曲等构象变化,却仍小到可用高精度 DFT 逐帧计算。它是 MD22 的"蛋白质类"代表,也是训练样本占全量比例最低的体系之一(7%),说明其能量面相对平缓、易学。
(2)DHA——二十二碳六烯酸,56 原子,69,753 构型。
分子式 C₂₂H₃₂O₂。DHA 是 omega-3 家族的 22 碳长链多不饱和脂肪酸,含 6 个顺式双键。多不饱和意味着碳链每遇一个双键就"拐一个弯",整条链因此高度柔性,构象空间巨大。在生物学上 DHA 是细胞膜磷脂的关键成分、神经与视网膜发育的重要物质,是"脂质类"分子的典型。它的采样需求(8k 训练样本、占全量 12%)明显高于四肽,反映"柔性越高、需要越多样本"的经验规律。
(3)Stachyose——水苏糖,87 原子,127,272 构型。
分子式 C₂₄H₄₂O₂₁。水苏糖是一种四糖(由半乳糖-半乳糖-葡萄糖-果糖连接而成),存在于豆类等植物中。它带大量羟基(–OH),分子内外形成致密的氢键网络;MD 采样过程中氢键不断断裂重排,导致构象多样性极高。它是本数据集中构型数最多的体系(127,272),也是训练样本需求最大的体系之一(8k,占全量高达 29%)。大量氢键网络的协同重排,是"非局域效应"在碳水化合物上的表现形式。
(4)AT-AT——两个 DNA 碱基对,60 原子,20,001 构型。
分子式 C₂₀H₂₂N₁₄O₄。A(腺嘌呤)与 T(胸腺嘧啶)通过氢键配对,AT-AT 即两个 AT 碱基对的堆叠片段。它代表核酸中最简单的堆积单元,用来在保留"碱基堆积+氢键"这一核心相互作用的前提下控制规模。它的对称群阶 ‖G‖ = 36 较高,因为碱基对内部存在大量可置换的等效氢。
(5)AT-AT-CG-CG——四个 DNA 碱基对,118 原子,10,153 构型。
分子式 C₃₈H₄₂N₃₀O₈。在 AT-AT 基础上加入 C(胞嘧啶)与 G(鸟嘌呤)配对,形成四碱基对片段。它与 AT-AT 构成"同化学种类、不同尺度"的天然对照组:两者化学环境相似,唯一显著差别是规模(60 → 118 原子),因此可用于观察纯粹的规模效应。它的 ‖G‖ = 96 是全集最高,且含氮原子比例高(N 占约 25%),是"核酸类"力场学习的重要样本。
(6)Buckyball catcher——巴基球捕捉器,148 原子,6,102 构型。
分子式 C₁₂₀H₂₈。这是一个"主客体"超分子:一个 C60 巴基球被包在一个桶状的"捕捉器"分子内,捕捉器带有若干像"手指"一样的柔性结构可开合。它是纯粹由非共价相互作用(范德华、π-π 堆积、色散力)维系的体系,原子数大但化学键单调(几乎全是 C–C、C–H)。它的训练样本最少(600),因为碳环境的局部化学单一、模型易学;但"手指开合"的整体协同运动是典型的非局域现象,全局力场必须刻画。
(7)Double-walled nanotube——双壁碳纳米管,370 原子,5,032 构型。
分子式 C₃₂₆H₄₄(边缘用氢饱和)。它由两层同轴碳纳米管套在一起,是全集规模最大(370 原子)也非局域性最强的体系:内管与外管可相对旋转,这种"内外管协同转动"让每个原子的受力都依赖于整个体系的构型。它同时是构型数最少的体系(5,032)。论文对它做了最深入的分析——纳米秒级经典 MD 与路径积分 MD(PIMD),证明全局 sGDML 力场能稳定复现大尺度协同运动。它是 MD22 的"试金石",也是本数据集中文件最大者(约 85.7 MB)。
2.3 体系选择的三条设计轴
MD22 的体系不是随意拼凑,而是沿三条轴刻意铺开:
- 化学多样性轴(生物分子的四大类):蛋白质(四肽)、脂质(脂肪酸)、碳水化合物(四糖)、核酸(碱基对)——覆盖了构成生命体的主要分子类别。这类铺开让数据集能检验模型是否"跨化学域通用",而非只对某类分子过拟合。
- 规模轴(42 → 370 原子):从最小的四肽到最大的纳米管,跨约 8.8 倍。AT-AT 与 AT-AT-CG-CG 更是刻意做成"同化学、异尺度"的对照对,用于隔离规模效应。
- 非局域性轴(局域 → 强非局域):四肽的相互作用主要在局部,而纳米管的内外管旋转、捕捉器的手指开合是极端非局域效应。这条轴是 MD22 区别于 MD17 的核心加难维度——它直接挑战"局域性假设"这一主流近似。
2.4 标签与数值规格
- 势能(energy):每个构型一个标量,单位 kcal/mol。论文 Table SII 给出各体系的能量取值范围(range)与方差(variance),数值反映了轨迹能量起伏的幅度。
- 原子受力(forces):每个原子一个三维向量,单位 kcal/mol/Å。Table SII 同样给出 range 与 variance。
- 坐标(geometry):每个构型含全部原子的种类与三维坐标(单位 Å)。
- 划分(split):论文为每个体系指定固定训练集(Table I “# train.” 列)与相应测试集,训练集大小以"力 RMSE ≈ 1 kcal/mol/Å"为目标反推确定。
- 不含的标签:偶极矩、部分电荷、电子密度、HOMO/LUMO、激发态能量、非绝热耦合——这些在 QM9、WS22、xxMD 等其他基准中提供,MD22 只聚焦能量与力。
2.5 能量/力统计量表(论文 Table SII 全量)
| 体系 | 分子式 | 构型数 | 能量 range | 能量 variance | 力 range | 力 variance |
|---|---|---|---|---|---|---|
| Ac-Ala3-NHMe | C₁₂H₂₂N₄O₄ | 85,109 | 102.19 | 67.30 | 437.99 | 678.02 |
| DHA | C₂₂H₃₂O₂ | 69,753 | 75.71 | 91.31 | 420.07 | 673.99 |
| Stachyose | C₂₄H₄₂O₂₁ | 127,272 | 106.15 | 189.33 | 426.08 | 655.55 |
| AT-AT | C₂₀H₂₂N₁₄O₄ | 20,001 | 139.29 | 120.09 | 444.01 | 779.81 |
| AT-AT-CG-CG | C₃₈H₄₂N₃₀O₈ | 10,153 | 243.50 | 246.64 | 407.55 | 768.13 |
| Buckyball catcher | C₁₂₀H₂₈ | 6,102 | 378.08 | 576.85 | 287.77 | 450.12 |
| Double-walled nanotube | C₃₂₆H₄₄ | 5,032 | 674.50 | 5950.68 | 315.39 | 546.30 |
(能量单位 kcal/mol;力单位 kcal/mol/Å;数值均为论文 Table SII 口径。)
读数要点:纳米管的能量 variance(5950.68)比其余体系高一到两个数量级,说明其轨迹能量起伏最剧烈——这正是大尺度形变(内外管相对运动)的印记。捕捉器与纳米管的力 range 反而较低(287.77 / 315.39),因为它们的原子多为等效碳环境、局部受力较均匀;而四肽与碱基对的力 range 高(437.99 / 444.01),因含 N、O 等极性原子,局部受力差异大。这组数字从数据层面印证了"规模大 ≠ 局部受力大"这一反直觉事实。
2.6 文件与格式
- 原始格式(sgdml.org):每个体系一个
.npz(NumPy 压缩包),含坐标、能量、受力张量及划分索引。直链形态如https://www.quantum-machine.org/gdml/repo/datasets/md22_double-walled_nanotube.npz。实测双壁纳米管文件 Content-Length = 85,745,429 字节(≈85.7 MB),是 7 体系中的最大者;小体系文件相应小得多。 - ColabFit 镜像:转写为 Parquet 格式(
ds.parquet汇总 +co/逐构型行 +cs/配置集),提供统一 schema,便于与材料科学数据集混合加载。示例:MD22 double-walled nanotube 镜像文件 65.9 MB、5,032 构型、1,861,840 原子-帧;MD22 AT-AT-CG-CG 镜像 10,153 构型、1,198,054 原子-帧。 - HF 二次分发:OneScience-Group/nanotube 把纳米管单独抽出为 extxyz(训练 4,000 帧 + 测试 1,032 帧,每帧 370 原子),说明 MD22 的子集常被单独用于特定任务(如碳纳米管力场)。
2.7 计算细节(论文 Table SI 全表)
| 体系 | 温度 [K] | 理论层级 | 恒温器 | 系数 |
|---|---|---|---|---|
| Ac-Ala3-NHMe | 500 | PBE+MBD / tight | Global Langevin | 2(fs) |
| DHA | 500 | PBE+MBD / tight | Nosé-Hoover | 1700(cm⁻¹) |
| Stachyose | 500 | PBE+MBD / tight | Nosé-Hoover | 1700 |
| DNA base pair (AT-AT) | 500 | PBE+MBD / tight | Global Langevin | 2 |
| DNA base pair (AT-AT-CG-CG) | 500 | PBE+MBD / tight | Global Langevin | 2 |
| Buckyball catcher | 400 | PBE+MBD / light | Nosé-Hoover | 1700 |
| Double-walled nanotube | 400 | PBE+MBD / light | Nosé-Hoover | 1700 |
要点:全部轨迹 1 fs 分辨率;tight/light 是 FHI-aims 的两档基组关键词,两个最大的超分子用较省的 light 基组(370 原子用 tight 代价过高),其余用 tight。温度不是全局统一——小体系 500 K、两超分子 400 K,这是跨体系比较误差时需要注意的口径差。
2.8 一个反直觉的观察:为什么"更难的分子"反而样本更少
初看 Table I 会困惑:为什么规模最大、非局域性最强的纳米管只需 800 训练样本,而 87 原子的 Stachyose 却要 8k?原因有两层。其一是局部化学环境的复杂度:纳米管几乎全是等效的 sp² 碳,模型不需要见过很多"花样"就能泛化;而 Stachyose 的羟基可处在无数种氢键拓扑中,每种都是新的局部环境。其二是能量的空间分布:纳米管的能量起伏虽大(variance 5950.68),但变化方向高度规律(伸缩/旋转),模型学的是"一条大曲线";Stachyose 的能量面则是多谷、多路径的复杂景观。这提示一个方法学教训:决定数据需求的是"化学/构象复杂度",而非原子数本身——这一条对任何"规模 vs 数据"的估算都适用,也是 MD22 相比 MD17 更"成熟"的地方(它把规模与复杂度两个常被混为一谈的变量拆开了)。
2.9 七个体系的信息卡(速查)
卡 1:Ac-Ala3-NHMe(蛋白质)
- 分子式 C₁₂H₂₂N₄O₄|原子数 42|构型 85,109|训练 6k(7%)
- 结构:丙氨酸三肽主链 + Ac/NHMe 封端
- 温度/基组:500 K / tight
- 特点:最小体系、能量面平缓、E-MAE 最低(0.0093)
- 用途:管线调试、入门基线
卡 2:DHA(脂质)
- 分子式 C₂₂H₃₂O₂|原子数 56|构型 69,753|训练 8k(12%)
- 结构:22 碳长链、6 个顺式双键的多不饱和脂肪酸
- 温度/基组:500 K / tight
- 特点:柔性极高、构象空间大、样本需求高
- 用途:研究"柔性如何影响力场学习"
卡 3:Stachyose(碳水化合物)
- 分子式 C₂₄H₄₂O₂₁|原子数 87|构型 127,272|训练 8k(29%)
- 结构:四糖,密集羟基氢键网络
- 温度/基组:500 K / tight
- 特点:全集构型最多、E-MAE 最高(0.046)、‖G‖=1(无对称性可用)
- 用途:氢键网络/多谷能量面研究
卡 4:AT-AT(核酸)
- 分子式 C₂₀H₂₂N₁₄O₄|原子数 60|构型 20,001|训练 3k(15%)
- 结构:两个 A-T 碱基对堆叠
- 温度/基组:500 K / tight
- 特点:碱基堆积 + 氢键、‖G‖=36
- 用途:核酸力场最小单元
卡 5:AT-AT-CG-CG(核酸)
- 分子式 C₃₈H₄₂N₃₀O₈|原子数 118|构型 10,153|训练 2k(20%)
- 结构:四个碱基对(A-T、C-G 各两组)
- 温度/基组:500 K / tight
- 特点:与卡 4 构成"同化学、异尺度"对照、‖G‖=96 最高(对称性最强)
- 用途:隔离纯规模效应
卡 6:Buckyball catcher(超分子)
- 分子式 C₁₂₀H₂₈|原子数 148|构型 6,102|训练 600(10%)
- 结构:C60 巴基球嵌在桶状捕捉器内
- 温度/基组:400 K / light
- 特点:纯非共价主客体体系、训练样本最少之一、F-MAE 0.68
- 用途:主客体/非共价相互作用研究
卡 7:Double-walled nanotube(超分子)
- 分子式 C₃₂₆H₄₄|原子数 370|构型 5,032|训练 800(16%)
- 结构:两层同轴碳纳米管、边缘氢饱和
- 温度/基组:400 K / light
- 特点:规模最大、非局域性最强、能量 variance 最高(5950.68)、F-MAE 最低(0.52)、文件最大(85.7 MB)
- 用途:长程/非局域效应、大体系稳定性验证(PIMD 试金石)
2.10 三对"对照体系"及其设计意图
MD22 的 7 个体系里藏着三对有意设计的对照:
对照对 A:AT-AT(60 原子)vs AT-AT-CG-CG(118 原子)——纯规模对照。
两者都是 DNA 碱基对堆叠、化学环境高度相似,唯一显著差别是碱基对数量(2 vs 4)与规模(60 vs 118)。这使研究者能在控制化学种类的前提下测量规模效应:AT-AT 训练 3k、AT-AT-CG-CG 训练 2k,后者规模近两倍却只需更少训练样本,部分归因于其更高的对称群阶 ‖G‖(36 → 96)带来的归纳偏置。
对照对 B:Buckyball catcher(148 原子)vs Double-walled nanotube(370 原子)——非局域强度对照。
两者都是纯碳/超分子体系,局部化学单调(多为等效碳环境),因此训练样本极少(600 / 800)。区别在于非局域效应的"形态":捕捉器是"手指开合"的局部柔性运动耦合,纳米管是"内外管整体旋转"的大尺度协同运动。后者对全局模型的依赖更强,也是论文用纳米秒级 PIMD 重点验证的对象。
对照对 C:Stachyose(87 原子,8k 样本)vs Double-walled nanotube(370 原子,800 样本)——复杂度 vs 规模对照。
这是最反直觉的一对:小体系要 10 倍于大体系的样本。原因见 §2.8——决定数据需求的是化学/构象复杂度,而非规模。这一对是该数据集"最值得写在论文摘要里"的方法学发现。
2.11 数据集的"完备性"边界
在把 MD22 用于某个具体任务前,先确认它是否覆盖你的需求:
| 你可能需要 | MD22 是否提供 | 备注 |
|---|---|---|
| 总势能 | ✅ | 每构型一个标量(kcal/mol) |
| 逐原子受力 | ✅ | 三维向量(kcal/mol/Å) |
| 原子坐标 | ✅ | 完整几何 |
| 偶极矩/电荷 | ❌ | 需 QM9 等其他数据集 |
| 电子密度 | ❌ | 需专门的密度数据集 |
| 激发态/非绝热 | ❌ | 需 WS22 / xxMD |
| 溶解/溶剂效应 | ❌ | 均为真空/气相 MD |
| 长时轨迹(连续时间序列) | ⚠️ | 轨迹按构型存储,连续时间信息需自行处理 |
| 温度/压力众数 | ❌ | 每体系单一温度,无 thermodynamic ensemble |
| 含金属元素体系 | ❌ | 全部为 CHNO 有机体系 |
2.12 三个规模口径的区分(避免数字误用)
读 MD22 的数字时,必须分清三个不同口径,它们常被混用:
- 体系数 = 7:数据集包含的分子体系个数。这是"广度"口径。
- 构型数 = 323,422:所有体系所有时间帧的总数。这是"数据量"口径,决定磁盘占用与训练算力。单个体系最多 127,272(Stachyose)、最少 5,032(纳米管)。
- 原子-帧数 = 23,716,460:Σ(体系原子数 × 该体系构型数)。这是"计算量/存储粒度"口径,衡量的是"总共有多少条原子记录"。最小体系 42×85,109 ≈ 357 万,最大体系 370×5,032 ≈ 186 万——有趣的是,尽管纳米管单帧最大,其原子-帧总数反而低于四肽,因为它的构型数少。
误用示例:把"原子-帧 23,716,460"写成"2,371 万个分子"、“原子总数"或"构型数"都是错的。正确表述是"合计 23,716,460 条原子-构型记录”。
2.13 与其他规模的横向对照
为帮助读者建立规模直觉,把 MD22 与常见分子数据集对照:
| 数据集 | 体系数 | 体系规模(原子) | 构型量级 | 标签侧重 |
|---|---|---|---|---|
| MD17 | 8 | 9–21 | 约 15 万/分子 | 能量+力 |
| rMD17 | 8 | 9–21 | 约 15 万/分子 | 能量+力(重算) |
| MD22 | 7 | 42–370 | 5k–127k/体系 | 能量+力 |
| QM9 | 134k 分子 | 最多 29 | 1 构型/分子 | 多种量子性质 |
| WS22 | 10 | 最多 22 | 约 118 万 | 能量+力+偶极+激发态 |
可见 MD22 的独特定位:体系数少但每个体系大,构型集中在"中等量级但覆盖长时轨迹",标签聚焦能量与力。这与 QM9(多分子、单构型、多性质)和 WS22(多分子、海量构型、多性质)形成互补。
2.14 存储与算力估算
按实测纳米管单文件 85.7 MB 推算(5,032 构型、370 原子,即约 17 KB/构型),MD22 的存储大致特征:
- 大体系(纳米管、捕捉器)单文件数十至百 MB 级;
- 构型最多的 Stachyose(127,272 构型、87 原子)可能达百 MB 级;
- 全集若一次下载,总体积在 GB 量级(不含 ColabFit 的 Parquet 冗余格式)。
算力方面,因训练集仅 600–8,000 样本、体系最大 370 原子,单个体系在单张现代 GPU 上可完成训练与评测——这是 MD22 相对更大规模数据集(如 OC20 动辄百万样本)的显著低门槛优势。
2.15 一个容易忽略的事实:轨迹的"时间"是不可逆的
MD22 的构型来自真实 MD 轨迹,帧与帧之间存在时间相关性(相邻帧高度相似)。若随机划分训练/测试集,会出现"训练帧与测试帧几乎相同"的数据泄漏风险。论文采用的时间切分(或忠实于原轨迹的划分)正是为避免此问题。使用者在自定义划分时,应优先按轨迹时间段切分,而非随机打乱——否则测试误差会被严重低估。这是分子轨迹数据集特有的坑,值得单独强调。
§3 从 MD17 到 MD22:为什么要做"大体系"基准
3.1 MD17 的成功与边界
2017 年 Chmiela 等发布 MD17(Machine learning of accurate energy-conserving molecular force fields, Science Advances 3(5):e1603015)与配套的 GDML 方法,把"用少量从头算数据学会分子势能面"变成可复现的基准。MD17 的 8 个分子(苯、甲苯、丙二醛、乙醇、天冬酰胺、水杨酸、偶氮苯、乙酰乙酸)都只有 9–21 个原子,训练样本约千级,此后成为等变神经网络势(SchNet、PaiNN、NequIP、MACE 等)的标准起点。
但 MD17 也暴露了两个结构性问题。其一是规模天花板:分子太小,模型只需刻画局部化学环境即可拟合,局域性假设的缺陷被掩盖。其二是数据质量争议:MD17 的部分参考数据被后续工作指出存在收敛性问题,催生了重新计算版 rMD17(2019)。MD22 从设计上正面回应第一点——它不追求"更多小分子",而是刻意选择大体系,把"规模"这一维度单独拉出来做基准。
3.2 "规模、柔性、非局域性"三轴加难
MD22 相对 MD17 的升级沿三条轴展开:
- 规模(size):原子数从 MD17 的 9–21 跳到 42–370。这是最直观的一轴,直接考验模型的可扩展性。
- 柔性(flexibility):DHA 的长链多不饱和结构、Stachyose 的氢键网络、四肽的多二面角,都带来远大于刚性小分子的构象多样性。DHA 与 Stachyose 各需 8k 训练样本(占各自全量的 12% 与 29%),远高于 MD17 的千级——柔性直接转化为数据需求。
- 非局域性(non-locality):这是 MD22 最核心的加难。双壁纳米管的内外管相对旋转、巴基球捕捉器"手指"的开合、核酸碱基的堆积,都是典型的非局域效应:某个原子的受力取决于整个分子的构型,而非局部邻域。论文用 sGDML 的"原子贡献分解"(Fig. 5)证明:在全局力场中,所有原子都参与每一次预测,环旋转引起的能量变化被离域到整个分子——这是任何局域模型在原理上做不到的。
3.3 与 rMD17 的区别
rMD17(revised MD17,2019)解决的是 MD17 的数据质量问题(用更严格收敛重新计算同一批小分子),体系规模与 MD17 相同。MD22 解决的是规模与表达力问题,体系换成了大分子。两者是正交的两个改进方向,不应相互替代:若研究"小分子高精度力场",用 rMD17;若研究"大体系可扩展力场/非局域相互作用",用 MD22。这也是本条目在检索与引用时必须与 MD17/rMD17 明确区分的原因(当前库内 md17/rmd17 均无条目,无法互链,见 §9)。
3.4 MD22 的"可扩展性"命题究竟是什么
"可扩展性"在这里有三层含义,值得分清:
- 模型层面的可扩展:同一套方法能否从 42 原子推广到 370 原子而不失效。sGDML 的回答是"能",代价是计算量随体系增长。
- 数据层面的可扩展:训练样本需求是否随体系增大而爆炸。MD22 的观察是"不一定"——纳米管样本最少,说明可扩展性不必然以数据量为代价。
- 物理层面的可扩展:模型能否保持对非局域效应的描述能力。这是最本质的一层,也是 MD22 用纳米管重点验证的内容。
三层中,第三层最容易被忽视,却决定了模型能否用于真实大体系。MD22 的设计正是把三层放在同一基准下考察。
§4 数据集的构造过程与可复现性
4.1 四步构造流水线
- 体系选取与初始构型:为每个目标分子确定平衡态(最低能量)构型作为 MD 起点。这一步决定了参考轨迹的"化学正确性"——起点若偏离真实极小点,整条轨迹就有系统性偏差。
- 从头算 MD 采样:用 i-PI 驱动 FHI-aims,在指定温度(400 或 500 K)与恒温器下跑分子动力学,1 fs 步长,输出逐帧的坐标、能量、受力。采样温度的选择兼顾"覆盖足够构象空间"与"不破坏分子"。
- 标签计算:每帧的能量与受力均在同一 DFT-PBE+MBD 层级下计算,能量与受力自洽(受力为势能的负梯度)。这一点对力场训练至关重要——若能量与力来自不同层级,模型会学到矛盾的信号。
- 划分与打包:按论文设定的训练集大小切分并打包为 .npz,供 sGDML 及后续方法直接加载。
4.2 为什么"能量-受力自洽"是硬要求
力场训练的一个隐含前提是:受力等于势能对坐标的负梯度(保守力场)。MD22 的能量与力由同一 DFT 计算在同一几何下导出,天然满足这一关系。作者特别强调,这是力场能"能量守恒"地跑长时间 MD 的基础——若力与能量不自洽,模拟会缓慢漂移甚至爆炸。论文用纳米秒级 PIMD 稳定性验证了这一点(§5.4)。
4.3 采样温度与基组的可复现口径
复现 MD22 或在其上做公平比较时,需固定三件事:温度(小体系 500 K / 两超分子 400 K)、基组(tight / light,见 §2.7)、划分(论文 Table I 的训练集大小与测试集)。任何一项偏离,误差数字就不再可比。论文的 Table I 训练集大小(600–8000)正是"在这些设定下达到力 RMSE ≈ 1"的最小规模,被后续大量工作沿用。
4.4 后续扩展与镜像
- ColabFit Exchange(2023):把 7 个体系转为统一 Parquet schema 并各给独立 DOI(如 AT-AT-CG-CG → 10.60732/a87c6d4c,nanotube → 10.60732/fce214af),便于材料/分子数据统一加载。
- HuggingFace 二次分发(2024–2025):出现多个镜像仓库(colabfit/* 系列、OneScience-Group/nanotube 等),双壁纳米管常被单独抽出用于碳纳米管力场训练(如 MACE 示例数据)。
- 论文附录 B 的 donor-bridge-acceptor 数据:属论文的附加演示(用 GFN2-xTB 半经验方法生成,非 DFT,见 §7.7),不属于 MD22 七体系,检索时勿混入。
4.5 复现检查清单
在报告"我在 MD22 上得到 X 精度"之前,逐项确认:
- [ ] 用的是哪个体系(拼写与论文一致)?
- [ ] 温度对齐了吗(500 K / 400 K)?
- [ ] 基组对齐了吗(tight / light)?
- [ ] 训练集大小用的是论文 Table I 的绝对值,还是自选的百分比?
- [ ] 划分是否按时间段(避免轨迹数据泄漏,§2.15)?
- [ ] 能量单位是 kcal/mol 还是 meV/atom?是否 per atom 归一?
- [ ] 力的单位与归一方式写清了吗?
- [ ] 是否报告了长时间 MD 的稳定性(而非只报单帧误差)?
缺任一项,结果就难以与他人对齐。这份清单来自本条目踩过的坑(§10)与论文报告口径。
§5 基准结果:sGDML 的七张成绩单
5.1 论文主表(Table I 全量)
论文用全局 sGDML 力场在 7 体系上给出能量与力的均值绝对误差(MAE)与均方根误差(RMSE)。能量误差为逐原子归一(per atom),力误差为逐分量归一(per component),单位为 kcal/mol(能量)与 kcal/mol/Å(力):
| 体系 | 原子数 | 对称群阶 ‖G‖ | 训练样本 | 占全量% | E-MAE | F-MAE | E-RMSE | F-RMSE |
|---|---|---|---|---|---|---|---|---|
| Ac-Ala3-NHMe | 42 | 18 | 6k | 7% | 0.0093 | 0.79 | 0.012 | 1.21 |
| DHA | 56 | 6 | 8k | 12% | 0.023 | 0.75 | 0.030 | 1.17 |
| Stachyose | 87 | 1 | 8k | 29% | 0.046 | 0.68 | 0.052 | 1.07 |
| AT-AT | 60 | 36 | 3k | 15% | 0.012 | 0.69 | 0.015 | 1.12 |
| AT-AT-CG-CG | 118 | 96 | 2k | 20% | 0.012 | 0.70 | 0.015 | 1.22 |
| Buckyball catcher | 148 | 48 | 600 | 10% | 0.0079 | 0.68 | 0.0099 | 1.02 |
| Double-walled nanotube | 370 | 28 | 800 | 16% | 0.0108 | 0.52 | 0.0135 | 0.97 |
5.2 怎么读这张表
- 力的误差高度一致:7 体系的 F-MAE 集中在 0.52–0.79 kcal/mol/Å,F-RMSE 集中在 0.97–1.22。论文明确说明训练集大小是按力 RMSE ≈ 1 kcal/mol/Å 反推的,所以"力误差都差不多"不是巧合,而是设计目标——真正变化的是达到这个目标所需的样本数。
- 纳米管力误差最低(0.52)但样本最少(800):看似矛盾,实则合理。纳米管的原子多为等效碳环境、局部化学环境单调,模型更易学;但它的非局域性最强,需要全局模型才能同时满足"少样本 + 高精度"。这恰恰是全局 sGDML 的价值所在——如果用局域模型,纳米管的少样本高精度无法与长程效应共存。
- Stachyose 能量误差最高(0.046)且样本最多(8k):四糖的氢键网络重排带来高柔性,需要更多样本,且能量误差随柔性和构型多样性上升。它占到了自身全量的 29%,是 7 个体系里"数据饥渴度"最高的。
- Ac-Ala3-NHMe 能量误差最低(0.0093):四肽体系最小(42 原子)且构型覆盖充分,能量面相对平缓。
- 对称群阶 ‖G‖:反映每个体系可利用的置换对称性(如等价氢原子、甲基旋转)。AT-AT-CG-CG 的 ‖G‖ = 96 最高(碱基对内部大量对称重原子排布),Stachyose 的 ‖G‖ = 1 最低(四糖无内部对称),这也部分解释了 Stachyose 为何最难学——没有对称性可以利用来压缩模型自由度。
5.3 数据规模 vs 精度:论文的核心论断
论文最关键的一句话可以概括为:即便体系达到数百原子、训练样本只有几百到几千,全局模型仍可达到力 RMSE ≈ 1。这直接反驳了"大体系必须靠局域化近似"的既有观念——在此之前,人们对数百原子体系的主流做法是局域化(把能量拆成局部贡献),代价是丧失非局域描述能力;MD22 的表 I 表明这个代价并非必须付出。
论文还进一步测试了 sGDML 向更大训练集扩展的行为(附录 C):在此之前,核方法力场在 MD17 上只能扩展到约 1k 训练点;本文展示了扩展到更大训练规模的可能性。这说明该方法是数据增益型——给更多数据,误差继续下降,而不是很快饱和。对实际应用的含义是:如果下游任务需要更高精度,用 MD22 的同一套流程增加采样即可,不必更换方法。
5.4 稳定性验证:纳米秒级 PIMD
论文对双壁碳纳米管(边缘饱和氢)跑了纳米秒级的经典 MD 与路径积分 MD(PIMD),这是数据集作为"力场试金石"的最硬证据:
- 温度恒定为 300 K,Langevin 恒温器,时间步长 0.2 fs(注意此处是仿真步长,与数据集采样的 1 fs 不同)。
- PIMD 使用 16 个 beads(16 条虚时间副本),用于刻画核量子效应(如零点能、质子隧穿)。
- 仿真时长:MD 约 500 ps、PIMD 约 100 ps(论文正文给出)。
- 结果:内外管相对旋转的 RMSD 随仿真时间呈现周期性峰——约 60 ps 出现第一个峰,此后约每 100 ps 一个,对应内外管相对旋转的周期性事件。
这一条为什么关键?因为力场再准,只要有一点系统误差,长时间模拟就会累积漂移,最终轨道发散、能量爆炸。能在 370 原子体系上稳定跑出纳米秒级 PIMD,并复现大尺度协同运动的周期性,才算真正跨越了"规模壁垒"。论文还指出一个细节:单靠原子索引计算 RMSD 会低估内外管的真实相对运动,因为内外管可独立旋转导致原子配对关系改变——必须用旋转不变的度量才能正确刻画,这也侧面说明非局域效应需要专门的分析工具。
5.5 后续方法在 MD22 上的表现(生态基线)
MD22 已成为第三方力场的必测集。典型报告(来自后续论文,非 MD22 原始论文):
- EScAIP(arXiv 2410.24169):15M 参数模型,采用 95:5 训练/测试划分,对每个训练样本做 16 次随机旋转的数据增广;报告能量(meV/atom)与力(meV/Å)MAE,并额外跑 200,000 步(100 ps)500 K Langevin 仿真,用径向分布函数 h® 的误差评估仿真稳定性(即"模型跑出的 MD 是否复现了参考数据的结构分布")。这与 MD22 原论文的 PIMD 验证思路一脉相承。
- MACE、VisNet-LSRM 等亦在 MD22 上对标 sGDML;后续工作指出 VisNet-LSRM 的数值在 MACE 论文与其原论文间存在差异(同一结果被两个数值口径报告),跨论文比较时需核对口径。
- 这些第三方结果的存在,使 MD22 从"一个实验室的基准"升级为"领域公共基准",也是它被广泛引用(Google Scholar 约 275+ 次)的原因。
5.6 误差与体系特征的关联(方法学解读)
把 Table I 与 Table SII 连起来读,可以发现几条规律:
- 样本需求与柔性正相关:DHA(6 个双键,高柔性)与 Stachyose(密集氢键网络)都需要 8k 样本,而刚性更强的超分子只需 600–800。
- 样本需求与化学多样性正相关:含 N、O 等异原子的体系(四肽、糖、碱基对)需要上千样本,而纯碳体系(捕捉器、纳米管)几百即可。
- 对称性降低数据需求:‖G‖ 高的体系(如 AT-AT-CG-CG 的 96)能用更少样本达到同精度,因为对称性提供了额外的归纳偏置。
- 能量误差与力误差不同源:能量 MAE 在 0.0079–0.046 间波动(约 6 倍差距),力 MAE 只在 0.52–0.79 间波动(约 1.5 倍差距)——因为训练目标是力(RMSE≈1),能量是"副产品",其误差更受体系能量尺度影响。这提示:想优化能量精度,需要单独设计训练目标,不能指望力精度自动带来能量精度。
§6 获取与许可:CC0-1.0 的公共领域数据
6.1 许可(License)
- CC0-1.0(Creative Commons Zero v1.0 Universal):贡献者放弃全部著作权及相关权利,数据进入公共领域。可自由复制、修改、分发、商用,无需署名、无需保留许可声明(ColabFit 各子数据集页与 sgdml.org 均标注 CC0-1.0)。
- 这是本库中许可最宽松的条目之一。相比许多医学数据集常见的"CC BY-NC(禁商用)"“申请制”"仅限学术"等限制,MD22 的 CC0 让它在工业界与开源模型训练中的可用性极高。
- 注意:CC0 只覆盖数据集本身。论文文本(Science Advances)另有期刊版权(Science Advances 采用 CC BY 或类似开放获取条款,具体以期刊页为准);引用时区分"数据许可"与"文本许可"。
6.2 获取途径
| 途径 | 形态 | 说明 |
|---|---|---|
| sgdml.org(原始) | .npz | 论文指定的官方渠道,免注册直下;直链形态 https://www.quantum-machine.org/gdml/repo/datasets/md22_<system>.npz |
| ColabFit Exchange(镜像) | Parquet | 2023 收录 7 个子数据集,各带独立 DOI(10.60732/*),统一 schema 便于跨数据集加载 |
| HuggingFace(二次分发) | Parquet / XYZ | colabfit/* 系列、OneScience-Group/nanotube 等镜像(注意:HF 主站在部分环境需走 hf-mirror.com 镜像站) |
6.3 下载直链与体积实测
- 官方直链命名规律:
md22_<system>.npz,系统名为下划线小写形式。 - 实测(2026-10-16):
md22_double-walled_nanotube.npz返回 HTTP 200 且 Content-Type 为 application/octet-stream,Content-Length = 85,745,429 字节。这是全集最大单文件。 - 7 个子集需分别下载(无单一"打包全部"文件),总计体积需按各体系规模估算——大体系(纳米管、捕捉器)占绝大部分。
6.4 版本链
原始 npz(2022 论文发布)→ ColabFit Parquet 镜像(2023-10-07 收录)→ HuggingFace 各二次分发仓库(2024–2025 持续更新)。使用时应注明用的是哪一版——原始 npz 与 ColabFit Parquet 在字段命名与切片方式上有差异(见坑 6),划分索引也可能不一致。
6.5 加载示例(伪代码)
# 原始 npz(sgdml.org)
import numpy as np
data = np.load("md22_double-walled_nanotube.npz")   # 含坐标/能量/力/划分
# 具体字段名以实际文件为准(不同体系/版本可能略有差异)

# ColabFit 镜像(Parquet)
# 读取 ds.parquet 获取汇总信息,co/ 目录逐构型读取结构+性质+元数据
论文明确声明:数据集、预训练力场模型与软件全部在 www.sgdml.org 提供(原文 Data, model and software availability:“All datasets, pre-trained FF models and software used in this work are available at www.sgdml.org.”)。
6.6 无附加条款
与许多数据集附带"使用需引用""禁止再识别"等条款不同,MD22 因 CC0 而无任何附加使用条款。唯一的社会约定是学术惯例上的引用(鼓励但不强制)。这对自动化管线尤其友好——无需记录版本许可状态、无需在分发时附许可文件。
§6.7 复现与上手路线图
给想直接动手的读者的最短路径:
第 0 步:确定你要复现什么。
- 只想跑通一个力场 → 从最小的 Ac-Ala3-NHMe(42 原子、85,109 构型)开始。
- 想评测"模型能否扩展到数百原子" → 用全部 7 体系,重点看纳米管。
- 想做公平的跨方法比较 → 严格对齐论文 Table I 的划分与 Table SI 的温度/基组。
第 1 步:取数据。
访问 www.sgdml.org,按体系下载对应 .npz;或走 ColabFit Exchange 取 Parquet 镜像。注意单个最大文件约 85.7 MB(纳米管),小体系小得多,可先下小体系试通管线。
第 2 步:确认口径。
在动手前把三件事写进实验记录:温度(小体系 500 K / 超分子 400 K)、基组(tight / light)、划分(Table I 的训练集大小与测试集)。三件事任一未对齐,误差数字就不可比(坑 5、坑 10)。
第 3 步:建立基线。
论文的 sGDML 结果(Table I)就是基线。如果你的模型在 Ac-Ala3-NHMe 上力 MAE 显著高于 0.79 kcal/mol/Å,先检查数据加载与划分是否正确,再怀疑模型。
第 4 步:验证稳定性(关键,别跳过)。
单帧误差达标不等于力场可用。至少要跑一次几百皮秒的 MD,检查能量是否守恒(无系统性漂移)、结构是否崩塌。论文对纳米管的纳米秒级 PIMD 验证就是这个环节的黄金标准(§5.4)。
第 5 步:报告口径。
报告结果时写清:体系名(用论文拼写)、划分、单位(kcal/mol 还是 meV/atom)、是否 per atom 归一、是否做数据增广。缺少任一项,读者无法与你的数字对齐(坑 8)。
§7 生态与影响
7.1 在 MLFF 谱系中的位置
MD22 与 MD17(2017)、rMD17(2019)构成"小分子 → 修正版 → 大体系"的三代基准链。它被后续几乎所有主流等变神经网络势(MACE、NequIP、Allegro、PaiNN、EScAIP 等)纳入评测矩阵,成为衡量"模型能否扩展到数百原子"的事实标准。论文提出的全局 sGDML 思路,也影响了一批"非局域/长程力场"的研究方向。
7.2 对"局域化 vs 全局"这一核心争论的贡献
机器学习力场领域长期存在一个张力:局域化模型(如基于原子环境的消息传递网络)计算高效、可扩展到极大体系,但从原理上无法捕捉长程效应;全局模型(如 sGDML)表达力强、能刻画长程效应,但计算代价随体系规模平方增长。MD22 的贡献是用受控实验把这场争论定量化:它提供了"非局域性从弱到强"的体系梯度,并给出全局模型在每个梯度点上的成绩。后续任何"我的局域模型能否替代全局模型"的主张,都可以拿 MD22 作为判据。这就是它作为基准的深层价值——不只是刷分,而是裁决方法论。
7.3 引用的学科外溢
除计算化学与材料外,MD22 的体系选择(蛋白质片段、DNA 碱基对、糖类)使其在生物分子模拟社群中被讨论:分子力学力场(AMBER、CHARMM 等经典力场)与机器学习力场的对比研究,常以 MD22 的肽/核酸/糖体系为交集。这为医数集条目与生物分子类条目的互链提供了理由(见 §9)——尽管 MD22 本身不含临床数据,它是"分子层面的生物医学"。
7.4 教育与复现价值
MD22 常被用作教学与入门基准:7 个体系规模梯度清晰、CC0 无门槛、论文表格完备,适合作为"从头实现一个力场模型"的练手数据集。它的规模也让个人研究者可在单卡 GPU 上完成全部 7 体系的训练与评测,这在动辄需要大规模集群的数据集时代是难得的低门槛。
7.5 与相邻数据集的区分
- MD17 / rMD17:小分子(9–21 原子)、8 分子;MD22 是大分子(42–370 原子)、7 体系。世代关系而非同一资源。
- QM9(库内 rid=105):静态分子(几何优化态)的多种量子化学性质(含 HOMO/LUMO、偶极矩等),13.4 万分子;MD22 是动态轨迹的势能与力。
- WS22 / xxMD:WS22(约 118 万构型、10 个有机小分子、含激发态)与 xxMD(激发态非绝热耦合)与 MD22 同属"分子 ML 基准"但侧重不同——前者侧重电子激发态,后者侧重基态势能面的大体系可扩展性。
- ANI-1x:以稠密采样著称的有机分子数据集(含 CHNO 的百万级构型),与 MD22 的区别在于体系规模与采样物理(ANI 偏量子化学扫描,MD22 是真实 MD 轨迹)。
7.6 常见误用
- 把 MD22 当临床/影像数据集检索:它没有任何人类数据,纯计算化学。
- 把 7 个体系当成 7 个独立数据集分别引用:它们属于同一基准集,Sum 口径为 323,422 构型;若只用单个体系(如纳米管),应注明"MD22 子集"。
- 把论文附录 B 的 donor-bridge-acceptor 数据算作 MD22 第 8 个体系:该数据用半经验 GFN2-xTB 生成,非 MD22 DFT 体系,不属七体系(坑 7)。
- 用 kcal/mol 与 meV/atom 数字直接比较:不同论文的能量单位与归一方式不同,见 §5.5 与坑 8。
7.7 附录 B 的澄清
论文附录 B 另有一套 donor-bridge-acceptor(4-二甲氨基-4′-硝基二苯乙烯)数据,用于演示 sGDML 的原子贡献分解(论文 Fig. 5)。它由 300 K 正态模采样(normal mode sampling)生成,能量与力用半经验 GFN2-xTB 方法计算——与 MD22 的 DFT-PBE+MBD 不同层级。因此它不是 MD22 的组成部分,检索与引用时须严格区分。这个演示的目在于展示:在全局力场中,环旋转引起的能量变化会被"离域"到整个分子,所有原子都参与每一次预测——这是局域模型无法呈现的行为。
7.8 非局域相互作用:为什么它是本数据集的"灵魂"
要理解 MD22 为什么值得单独建条目,必须理解"非局域相互作用"在分子模拟里的分量。
什么是非局域相互作用。 在分子中,绝大多数化学直觉是局域的:一个碳原子的性质主要由它的几个近邻决定,这就是局域性假设的物理基础,也是几乎所有现代机器学习势(消息传递神经网络等)的设计前提——它们把总能量拆成每个原子的贡献,每个原子只"看"一个有限半径内的邻居。但有一类效应天生不局域:范德华/色散力的作用距离远超共价键(可达数十埃);长链分子的整体形变、超分子的整体旋转、蛋白骨架的协同运动,都无法归给任何单个局部环境。
MD22 如何暴露它。 在双壁纳米管里,内管与外管相对旋转时,每个原子的受力都会改变,尽管它们的局部近邻(如三个碳原子的键角)几乎没有变化。这是纯粹的全局效应:只有"看到整个双壁结构"的模型才能预测这种力的变化。论文用 sGDML 的原子贡献分解可视化证明:全局力场把这次旋转的能量变化"摊"到所有原子上——正是这种"摊派"能力让它能描述非局域效应。
为什么重要。 大量真实体系(蛋白-配体结合、层状材料、分子晶体)依赖非局域效应。如果基准只在局域体系上衡量模型,就会系统性地奖励那些"看不见"长程效应的架构。MD22 的价值在于把"非局域性"作为一整个维度加进评测,迫使社区面对这一盲区。
7.9 数据集的三重用途
用途一:训练。 作为 DFT 级参考数据,直接训练力场(sGDML、MACE 等)。7 体系的规模梯度让训练者可选择合适复杂度。
用途二:评测。 作为第三方方法的公共测试集,报告能量/力误差与仿真稳定性。"在 MD22 上表现如何"已成为力场论文的常规卖点。
用途三:方法学教育。 作为"如何设计基准"的范本:它的体系选择(化学多样性 + 规模梯度 + 非局域梯度)、标签自洽(能量-力同源)、验证充分(长时 PIMD)三条,是任何基准数据集设计都可借鉴的模板。本条目 §8 即从它提炼了五条可迁移经验。
7.10 与医学数据的类比(写给本库读者)
MD22 虽非医学数据,但它与医学数据集共享一个根本问题:如何设计能暴露模型真实短板的评测。医学影像基准常只测"同分布精度",掩盖了跨机构、跨设备的泛化缺陷;MD22 则用刻意设计的体系梯度暴露"局域性假设"的缺陷。两者是同一种方法论意识的产物——好的基准不是最容易刷分的那个,而是最能揭示失败模式的那些。这是 MD22 对本库读者的最大启发。
7.11 一个常见困惑:为什么"能量"不是主角
初学者常问:既然叫"力场",为什么不重点报告能量精度?答案在 §5.2 已述——论文的训练目标就是力(力 RMSE≈1),能量是被动报告的副产品。物理上,力是势能的梯度,对局部几何变化更敏感;对训练而言,力提供了"每个原子每个方向"的密集监督,而能量只有一个标量,监督信号稀疏得多。因此"以力为主"是力场训练的通行做法,这也是理解 MD22 标签体系的关键。
5.7 一篇"怎么用这张表"的实操说明
假设你要评一个自研力场,流程如下:
第一步:选参照点。 如果你的体系是同类(如肽或糖),直接对标表 I 中对应行的 F-MAE。例如你的模型在 Ac-Ala3-NHMe 上力 MAE 0.60,优于 sGDML 的 0.79,属合理进步;若达 0.30 则需警惕数据泄漏(§2.15)。
第二步:对齐训练量。 表 I 的样本数是"达到 RMSE≈1 所需",你的模型若用更多样本(如 8k 而论文用 6k),比较时须注明,否则不公平。理想做法是用与论文相同的样本数,或同时报告"等样本"与"全量"两档。
第三步:报告完整指标。 至少给力 MAE 与 RMSE 两个数(MAE 抗离群,RMSE 惩罚大错),并注明是否 per component 归一。能量的数同样给 MAE 与 RMSE。
第四步:加稳定性验证。 单帧指标之外,跑一段 MD(哪怕 100 ps),报告能量守恒曲线与结构是否合理。这是从"拟合得好"到"能用"的门槛。
第五步:注明口径。 划分、温度、基组、单位、增广——五项写全。
这套流程并非 MD22 特有,而是分子 ML 领域的通行规范;MD22 的价值在于它把每一环都有明确的基准数字可对照,这正是"好基准"的标志。
5.8 表 I 之外:论文的其他关键图
论文除表 I 外,还有若干关键图示,理解它们有助于完整把握数据集:
- 图 1:全局力场与局域力场的能力对比示意,点明"规模 vs 精度"的问题设定。
- 图 5:在 donor-bridge-acceptor 分子上的原子贡献分解,展示全局力场如何把能量变化离域到所有原子(该分子属附录 B,非 MD22 体系,见 §7.7)。
- 图 6:双壁纳米管内外管相对旋转的 RMSD 随仿真时间曲线,展示周期性旋转事件(PIMD 验证的核心证据)。
- 图 S2:能量随仿真时间的累计曲线,用于确认长时间模拟无系统性漂移。
这些图与表一起构成"数据集—方法—验证"的完整证据链。引用时若只报表 I 而忽略图 6/S2,会遗漏"稳定性"这一层结论。
6.8 各获取途径的优劣对比
| 维度 | sgdml.org 原始 .npz | ColabFit Parquet | HF 二次分发 |
|---|---|---|---|
| 权威性 | 最高(论文指定) | 高(策展平台) | 中(第三方) |
| 格式 | NumPy .npz | Parquet | Parquet / XYZ |
| 单体系 DOI | 无(随论文) | 有(10.60732/*) | 视仓库而定 |
| 字段规范 | 论文/官方代码约定 | 统一 schema | 视仓库而定 |
| 元数据 | 论文表 | ColabFit 页 | README |
| 更新时点 | 2022 | 2023-10-07 | 2024–2025 |
| 适合场景 | 手写 sGDML 复现 | 跨数据集加载 | 特定子集快速取用 |
| 许可 | CC0-1.0 | CC0-1.0 | 随原数据 CC0-1.0 |
选用建议:复现论文数字 → 用 sgdml.org 原始 .npz;做大数据管线/跨数据集训练 → 用 ColabFit Parquet;只要纳米管子集 → 可用 HF 镜像但要核对许可与字段。
6.9 关于"数据可用性"声明的原文口径
论文的 Data, model and software availability 一节只写了一句:“All datasets, pre-trained FF models and software used in this work are available at www.sgdml.org.”。这意味着:
- 数据集:7 个体系的 reference data 在官网。
- 预训练模型:论文训练好的 sGDML 力场也在官网(“pre-trained FF models”),可直接加载使用,无需自己训练。
- 软件:sGDML 代码本身也公开(附链接)。
这一点对使用者极有价值:你不必从头训练——可以先下载预训练力场,直接跑 MD,快速验证管线,再决定是否自训。这是本数据集"低门槛"的又一体现在。
6.10 许可的边界澄清
CC0-1.0 覆盖的是数据集与预训练模型。使用时仍建议注意:
- 论文文本:Science Advances 的正文另有期刊版权与开放获取条款,引用文献时遵循学术规范。
- 衍生作品:因 CC0 无署名要求,你训练的模型、发表的衍生数据无需标注来源;但学术惯例鼓励注明,以保证可追溯。
- 第三方镜像:HF 上的二次分发由第三方维护,其 README 可能添加额外声明;严格来说,署名要求不能违背原 CC0(CC0 不可附加限制),但为稳妥,使用镜像时仍应回指原始 sgdml.org。
7.12 数据集在"AI for Science"浪潮中的位置
MD22 是"AI for Science"在分子模拟领域的标志性数据之一。2022–2023 年正值等变神经网络势爆发期(NequIP、MACE、Allegro 等相继出现),而力场研究的共同瓶颈是"能否处理真实规模体系"。MD22 恰在此时提供了 42–370 原子的评测梯度,成为衡量这些新架构是否"走出玩具问题"的标尺。它的高引用量(约 275+)中有相当部分来自等变势论文的标准评测章节。
从这个角度看,MD22 的贡献不只是数据本身,而是它定义了"大体系力场"的可比口径——训练集大小按精度反推(§12 追问 2)、报告 MAE 与 RMSE(§5.7)、加稳定性验证(§5.4)。这些口径被后续工作广泛继承,形成了领域的事实标准。
7.13 对基准设计的三点启发(写给数据集建设者)
- 对照设计胜过堆量:MD22 只有 7 个体系,却因三对对照(§2.10)而能隔离变量。相比"多加 10 个同质体系",精心设计的对照对信息量更大。
- 标签自洽是底线:能量-力同源(§4.2)。基准若在这一点上含糊,所有下游结论都不牢。
- 验证要触达闭环:不测单帧误差,还要测长时模拟稳定性(§5.4)。这是区分"拟合好"与"可用"的分水岭。
这三条对医学数据集同样适用:对照设计(跨机构/跨设备)、标签一致性(标注协议统一)、闭环验证(部署后性能漂移监测)。
§8 方法学启示:五条可迁移的经验
8.1 规模是独立于精度的评测维度
MD17 时代大家比的是"同样小分子上谁的误差低",MD22 把"能做到多大"变成一等公民。这对任何数据驱动领域都成立:当模型在某规模以下都能刷到饱和精度时,真正的区分度来自规模边界——医学影像的 3D 体积、基因组的长序列、EHR 的长时序,都是同一逻辑。选基准时,要先问"这个基准有没有把规模轴单独拉出来"。MD22 的做法(同化学种类、不同规模的 AT-AT 对照对)尤其值得学习:它把"规模"从"化学种类"里干净地隔离出来,使规模效应可被单独测量。
8.2 能量-受力自洽是物理约束数据的基本卫生
MD22 的每个构型能量与力来自同一次 DFT 计算,保证力 = 势能的负梯度(保守力场)。若数据集把不同来源的能量与力混装,模型会学到矛盾信号,长时间模拟必然发散。迁移到其他领域:任何"目标-约束"配对的数据集(如时序预测的观测与守恒量、结构预测的能量与几何),都要检查配对的自洽性。这是"数据卫生"中最容易被忽视、后果最严重的一条。
8.3 非局域性需要"全局模型"而非"更大窗口"
MD22 的核心发现是:在双壁纳米管这样的体系上,局域化假设从原理上无法描述内外管协同旋转这类效应——你无法靠"扩大局部邻域窗口"解决,必须让模型保留全局自由度关联。这提示了一类常见误区:以为"加深网络/加长感受野"能替代"改变建模假设"。在长程依赖场景(长文档、长序列、大分子),建模假设的层次比容量更重要。判断信号:如果某个效应需要"看到整个系统"才能预测,那么任何有固定感受野的模型都有原理上限。
8.4 数据需求由"复杂度"而非"规模"决定
§2.8 的观察可推广为一条原则:决定需要多少训练数据的是化学/构象/任务的复杂度,而非体系的绝对大小。纳米管 370 原子只要 800 样本,四糖 87 原子却要 8k——规模大不等于难学。实践含义:在规划数据采集预算时,先评估"多样性"(有多少种本质不同构型)与"对称性"(有多少可利用的等价关系),而不是先看体系有多大。
8.5 稳定性必须用长时间模拟验证,而非只报单帧误差
MD22 不只报单帧的能量/力误差,还跑纳米秒级 MD/PIMD 验证。这是"力场质量"的更高标准:单帧误差小不代表长时间模拟稳定,误差会累积成漂移。任何"预测-决策"闭环的模型(分子模拟、机器人控制、气候预测)都应采纳这一原则——评价指标要包含"闭环长时运行是否发散",而不仅是"单步预测是否准"。
§9 与库内条目的关系
9.1 可互链条目(DB 实查 status=1 AND del_sign=0)
| 条目 | rid | 关联性质 | 互链建议 |
|---|---|---|---|
| QM9 | 105 | 同为量子化学/分子 ML 基准数据集;QM9 是静态小分子的多性质集,MD22 是动态大体系的力场集 | 强烈建议互链("分子 ML 基准"谱系的相邻世代) |
| ProteinGym | 813 | 蛋白质突变适应度大规模基准,同属生物分子 ML 基准 | 建议互链(生物分子 ML 基准) |
| Human Protein Atlas | 404 | 人类蛋白质图谱,生物大分子域 | 弱关联互链(蛋白质域) |
| DrugTargetCommons | 1080 | 社区众包的药物-靶点生物活性开放知识库 | 弱关联(药物发现与化学域) |
| DrugBank | 89(另有 571 疑重号) | 药物数据库 | 弱关联;注意 89/571 重号,引用前核实 |
9.2 无法互链但需在文中区分的条目
- MD17 / rMD17:DB 实查 0 rows,writing/ 目录亦无——均不在库。因此按 R018 纪律,正文 relatedLink 不填 MD17/rMD17 的任何 rid(禁猜),仅在正文文字中作概念对照(§3、§7.5)。
- WS22、xxMD、ANI-1x:库内检索均未命中,不互链。
9.3 互链的语义建议
若主会话在入库后回填 relatedLink,建议按以下语义组织(URL 一律 https://www.qianfanghub.com/ai-ready-dataset/<slug>/<rid>):
- md22 ↔ qm9(105):横向(同为分子 ML 基准的不同世代)。
- md22 → proteingym(813):纵向(分子层面 → 蛋白功能层面)。
- md22 → human-protein-atlas(404):纵向(分子 → 蛋白图谱)。
注意(R012/R018 纪律):relatedLink 只允许纯 URL 字符串,禁止写任何中文说明(如"同域不同团队");所有消歧语义一律写在本正文 §9 中。
9.4 检索词与消歧
- 正检索词:“MD22”(精确)+ “machine learning force field” / “sGDML” / “Chmiela”。
- 反例(勿用):“MD-22”(易与武器型号混淆);单独 “MD17”(指向前身而非本数据集);把论文附录 B 的 donor-bridge-acceptor 当作 MD22 体系名。
- 消歧要点:MD22 是本条目的唯一具名基准;论文题名 Accurate global machine learning force fields for molecules with hundreds of atoms 与数据集名 MD22 的对应关系需在检索时一并核对(很多引用只写论文题名,不写 MD22)。若检索结果出现 “MD22” 同时指向武器、汽车或其他编号,须用 “force field” / “sGDML” / “Chmiela” 三个词联合锁定。
§10 避坑清单:十个已踩过的坑
坑 1:任务头给的 arXiv 编号是错的。任务头记 MD22 预印本为 arXiv:2205.09566,一手核验(arXiv abs 页实抓)显示该编号对应 Ronaldo Freire de Lima 的微分几何论文 Weingarten Flows in Riemannian Manifolds(math.DG,2022-05-19 投稿),与 MD22 毫无关系。MD22 的正确预印本编号是 arXiv:2209.14865(physics.chem-ph,2022-09-29 v1 / 2022-11-14 v3),其作者与摘要与期刊版完全一致。全文按 2209.14865 成稿;引用时务必核对。
坑 2:论文年份/卷期双口径。期刊版为 Science Advances 2023-01-11, 9(2):eadf0873;预印本首投为 2022 年 9 月。有的引用写 2022(按预印本),有的写 2023(按期刊版)。以期刊版 2023 为准,引预印本时注明 arXiv 版本。
坑 3:总构型数需自行求和,无官方单一数字。MD22 官方未给全集总构型数,只给逐体系 Size(Table SII)。本条目按 7 项求和得 323,422(并注明系自算)。ColabFit 只给子集构型数(与 Table SII 逐项一致),未给总数。自动化抓取时不要假设存在一个"官方总数"字段。
坑 4:总原子数口径易混。“Num. Atoms” 在 ColabFit 与本文自算中均为 “原子数 × 构型数” 口径(如纳米管 370×5032 = 1,861,840),而非"唯一原子数"。本条目全集取 23,716,460(Σ 原子数×构型数)。若误按"7 体系原子数之和 = 881"引用,会完全失真(881 是单构型的原子总数,无实际意义)。
坑 5:温度与基组不是全局统一。小体系 500 K / tight,两超分子 400 K / light(Table SI)。跨体系比较精度时,温度与基组差异是隐藏变量;复现实验必须逐体系对齐 Table SI 设定。
坑 6:原始 npz 与 ColabFit Parquet 字段不一致。sgdml.org 的 .npz 与 ColabFit 的 ds.parquet + co/ 结构在字段命名、切片方式、划分索引上均有差异。混用两版数据做训练/评测前,先核对字段映射,否则划分可能对不上,误差不可比。
坑 7:别把论文附录 B 的数据算进 MD22。附录 B 的 donor-bridge-acceptor 数据用半经验 GFN2-xTB 生成、300 K 正态模采样,属论文演示而非 MD22 七体系。它有独立于 MD22 DFT 体系的物理层级,混算会污染"MD22 = 7 体系"的定义。
坑 8:第三方结果的数值口径冲突。后续论文在 MD22 上报告的同一方法(如 VisNet-LSRM)存在数值差异——已发现 MACE 论文与 VisNet-LSRM 原论文给出的数值不一致,相关后续工作同时列出两个口径。跨论文比较时必须核对:划分比例(如 95:5)、数据增广(如 16× 旋转)、能量单位(kcal/mol vs meV/atom)、是否 per atom 归一。
坑 9:体系名拼写有官方/镜像两版。论文与 sgdml.org 用 Ac-Ala3-NHMe、AT-AT、Buckyball catcher、Double-walled nanotube;ColabFit 转写为下划线小写(Ac_Ala3_NHMe、AT_AT、buckyball_catcher、double_walled_nanotube)。用脚本按名匹配文件时会因拼写差异漏配,建议按 ColabFit ID 或 DOI 匹配。
坑 10:训练集划分不是固定比例。Table I 的 “# train.” 是绝对值(600–8000),而 “% data” 是它占该体系全量的比例(7%–29%),两者不是同一件事。若误以为"所有体系都取同样的百分比",会算错训练集大小。且论文后续评测者常用 95:5 等其他划分(如 EScAIP),复现时必须先确认划分口径。
§11 总结
MD22 是机器学习力场领域"可扩展性"这一命题的正面回答。它用 7 个 42–370 原子的生物相关分子体系、32 万余个 DFT-PBE+MBD 级别的 MD 构型,证明全局力场无需局域化近似即可处理数百原子体系;随论文提出的全局 sGDML 方法在 7 体系上均达到力 RMSE ≈ 1 kcal/mol/Å,并用纳米秒级 PIMD 验证了大体系模拟的稳定性。
它的三重身份值得记住:作为数据,它是 CC0-1.0 公共领域的开放力场基准;作为方法论文,它给出全局 sGDML 的迭代训练方案;作为基准,它的 Table I 是"多大规模、多少样本、什么精度"的直接参照表。它虽不含任何临床数据(patient_tags:不适用),却是"分子 ML 基准"谱系中与 QM9(rid=105)并列的坐标原点,也是理解"规模、柔性、非局域性"这三条基准设计轴的教科书样本。
对本库读者而言,MD22 的价值有三:一是作为"量子化学/分子性质预测"域(category_tags)的补齐;二是作为"生物大分子"与"药物发现"条目(ProteinGym、Human Protein Atlas、DrugTargetCommons)之间的分子层面锚点;三是作为一个"如何设计好基准"的范本——它的体系选择、标签自洽、长时验证三条,都可迁移到医学数据集的设计中。
§12 深度问答:来自使用者视角的追问
本节收录在阅读 MD22 时最容易被追问的若干深问题,均基于论文一手信息作答。
追问 1:为什么用 PBE 而不上 CCSD(T)?
CCSD(T) 是公认的高精度参考,但代价随体系规模急剧上升(对 370 原子不可行)。MD22 的目标是"数百原子、数万构型"的轨迹数据,必须在精度与可行性间取舍。PBE+MBD 是这一规模下的现实选择:PBE 处理共价/静电,MBD 补上色散。代价是 PBE 对某些强关联/电荷转移体系有已知误差,因此论文在报告精度时给出的是"与该方法层级自洽"的误差,而非与实验/CCSD(T) 的差距。引用时须注意:MD22 的"精度"衡量的是模型对 DFT-PBE+MBD 参考的拟合程度,不是对真实物理的绝对精度。
追问 2:为什么训练集大小按"力 RMSE≈1"来确定,而不是固定比例?
固定比例(如 90:10)在不同体系上会得到差异巨大的绝对精度——小体系可能过学、大体系可能欠学。以"达到某精度所需的最小样本"反推训练集,能让 7 个体系处于可比的"学习难度"坐标下,使表 I 的 ‖G‖、样本数、误差三列可横向比较。这是一个刻意的公平化设计。
追问 3:为什么两个超分子用 light 基组、且温度更低?
light 基组是为了让 370 原子体系的每帧计算可行(tight 会显著加价)。温度降到 400 K 部分是为了控制采样成本与稳定性——大体系在高温下形变更剧烈,可能需要更多帧才能覆盖,也可能带来数值稳定性问题。这两项设定是"规模换可行性"的工程折中,代价是超分子与其余体系的基组/温度不完全一致(坑 5)。
追问 4:为什么双壁纳米管要专门做 PIMD?
PIMD(路径积分 MD)纳入核量子效应,能刻画零点能与质子/轻原子隧穿。对碳纳米管这类含大量 C–H 键的体系,核量子效应会影响键长与振动,进而影响整体运动。论文用 PIMD 是对"力场能否在含核量子效应的长时间模拟下稳定"的更强验证。它是本数据集中在仿真层面做得最深的一段。
追问 5:sGDML 是"参数无关"的吗?
论文称全局 sGDML 为"exact iterative parameter-free approach"。这里的"参数无关"指它不依赖超参数搜索来适配体系(区别于需要调网络宽度/深度/截断半径的神经网络势),其行为由核方法与对称性约束确定。这与"是否需要训练集"不矛盾——仍需参考数据,但模型的归纳偏置是物理/对称性导出的,而非数据调出来的。
追问 6:MD22 能替代 MD17 吗?
不能,也不应。MD17 的分子小、精度高、文献结果密集,仍是小分子力场的标准练手与对比赛道;MD22 面向大体系与可扩展性。二者是不同"考察科目",很多论文两个都报。把 MD22 当作 MD17 的替代会导致"小分子能做好、大分子做不好"的能力盲区被掩盖(反之亦然)。
追问 7:非局域效应真的无法用局域模型近似吗?
并非绝对——若把截断半径放到足够大、或引入显式的长程项(如色散矫正、静电求和),局域模型也能部分捕捉。MD22 的论断是更精确的:在不做任何显式长程建模、且让模型靠纯局部环境的架构里,非局域效应会在原理上被漏掉。它衡量的是"架构假设"的代价,而非否定工程变通的可能性。
追问 8:为什么数据集叫"benchmark"而不是"database"?
"基准"强调它被设计用于比较方法(有固定划分、有基准方法、有报告口径),而"数据库"强调汇集与检索。MD22 两者兼具——它既是可下载的数据库,也是预设了比较规则的基准。理解这一点有助于正确使用:引用它的数字时要遵循它的比较口径,而非随意重划数据。
§13 结语:一句话概括
MD22 把"机器学习力场能做到多大"从口号变成可测量的坐标——7 个 42–370 原子的生物分子体系、32 万余个 DFT-PBE+MBD 构型、CC0-1.0 公共领域开放,配一套力 RMSE≈1 kcal/mol/Å 的全局 sGDML 基准。它是分子 ML 基准谱系中与 QM9 并列的坐标原点,也是"如何设计好基准"的范本。
§14 附:本条目写作与核验说明
本条目由 agent-e-md22 于 2026-10-16 撰写。核验路径与要点:
- 开工三查:
writing/md22/.lock不存在 → 由本代理创建独占;ps aux | grep -c "[c]odebuddy"= 4;dedup_gate.py md22唯一 HIT 为"候选池状态 dispatched"(自派发,按约定排除),DB 与 writing/ 通道均 CLEAN。 - 存在性核验:三源互证——论文(arXiv/Science Advances)、官网(sgdml.org)、镜像(ColabFit Exchange / HF);下载直链经 curl 实测 200 与体积。
- 一手数据:论文 PDF(arXiv:2209.14865v3)本机提取全文 64,651 字符,Table I / Table SI / Table SII 逐字段落照。
- 重要纠错:任务头 arXiv 编号 2205.09566 经核验为错误(实为微分几何论文),正文按正确编号 2209.14865 成稿(坑 1)。
- 双口径存照:总构型数(自算 323,422)、总原子-帧(自算 23,716,460)、体系名拼写(论文 vs ColabFit 转写)、温度区间(摘要 400–500 K vs Table SI 确定值)逐条记录于 FACTS.md §9。
- 互链纪律:relatedLink 只填库内真实 rid(QM9=105 等),MD17/rMD17 因不在库不填(R012/R018)。
§15 数据质量与局限性的独立评估
本节以独立视角评估 MD22 的强项与局限,供使用者在选型时权衡。
15.1 强项
- 物理正确性强:能量-受力同源自洽(§4.2),保证保守力场,长时间模拟稳定。
- 体系覆盖精心:四大类生物分子 + 超分子,且有刻意的对照对(§2.10),便于隔离变量。
- 许可最宽松:CC0-1.0 公共领域,商用无阻(§6.1)。
- 验证充分:不只报单帧误差,还有纳米秒级 PIMD(§5.4)。
- 低门槛:体系最大 370 原子、训练集 600–8,000,单卡可跑。
- 官方配套齐全:数据 + 预训练模型 + 软件三件套齐备(§6.9)。
15.2 局限
- 理论层级有限:PBE+MBD 是半经验精度级别,非 CCSD(T) 级参考;对强关联体系误差需自评(§12 追问 1)。
- 非医学数据:与临床医学无直接关联(§1.6)。
- 仅 CHNO 有机体系:不含金属、无机材料,材料研究者需另找数据集。
- 无溶剂/环境效应:全部气相 MD,不含溶剂、pH、离子强度。
- 温度/基组不统一:跨体系比较有隐藏变量(坑 5)。
- 体系数少(7):化学多样性有限,不足以覆盖生物分子全空间。
- 轨迹时间相关性:自定义划分需谨慎(§2.15)。
- 无官方全集总数:总构型/总原子数需自算(坑 3、坑 4)。
15.3 与更"现代"基站的对比
近年在 MD22 之外的分子力场基准包括 WS22(含激发态)、SPICE(含多类小分子与蛋白片段)、OMol25 等更大规模集合。MD22 的定位是"大体系可扩展性的经典基准"——它不追求数据量最大或性质最全,而是把"规模 + 非局域"这一维度做到清晰可测。选型时:要最大数据量看 OMol25/SPICE;要激发态看 WS22;要评测大体系可扩展性看 MD22。
15.4 选型决策小结
- 目标 = 大体系力场 / 非局域效应 → MD22。
- 目标 = 小分子高精度 → MD17/rMD17。
- 目标 = 多性质静态分子 → QM9(rid=105)。
- 目标 = 激发态/非绝热 → WS22/xxMD。
- 目标 = 超大规模通用力场 → OMol25/SPICE 等更现代集合。
MD22 不是"最好的"分子数据集,而是"在可扩展性这一维度上最清晰的"基准——选型的关键是匹配你的评测目标。
FAQ(高频问答 28 问)
Q:MD22 到底是什么?
一个面向机器学习力场的生物大分子/超分子 MD 轨迹基准数据集,7 个体系、PDF-PBE+MBD 级别的势能与原子受力标签。
Q:谁做的?
Stefan Chmiela、Klaus-Robert Müller(TU Berlin/BIFOLD)、Alexandre Tkatchenko(University of Luxembourg)等 7 人,2023 年发表于 Science Advances。
Q:什么时候发的?
预印本 arXiv:2209.14865 于 2022-09-29 首发(v3 2022-11-14);期刊版 Science Advances 9(2):eadf0873 于 2023-01-11。
Q:有几个体系?
7 个:Ac-Ala3-NHMe、DHA、Stachyose、AT-AT、AT-AT-CG-CG、Buckyball catcher、Double-walled nanotube。
Q:多少原子?
每个体系 42–370 原子不等:42 / 56 / 87 / 60 / 118 / 148 / 370。
Q:一共多少构型?
按论文 Table SII 逐项求和为 323,422(本文自算,官方未给总数,见坑 3)。
Q:标签是什么?
每个构型的总势能 + 每个原子的受力三维向量;不含偶极矩、电荷、电子密度。
Q:用什么方法算的?
电子结构用 FHI-aims,DFT-PBE+MBD 层级;MD 用 i-PI,1 fs 步长,400–500 K。
Q:能量单位?
kcal/mol;力单位 kcal/mol/Å。若与其他论文的 meV/atom、meV/Å 比较,需换算(1 kcal/mol ≈ 43.36 meV)。
Q:训练集多大?
逐体系不同(600–8000 样本),按"力 RMSE ≈ 1"反推确定,非固定比例。详见 Table I。
Q:精度多高?
配套 sGDML 力场力 MAE 0.52–0.79 kcal/mol/Å,能量 MAE 0.0079–0.046 kcal/mol(逐原子归一)。
Q:怎么下载?
sgdml.org 免注册直下 .npz;或走 ColabFit Exchange 的 Parquet 镜像;HF 亦有二次分发。
Q:许可是什么?
CC0-1.0,公共领域,可自由使用/修改/分发/商用,无需署名。
Q:要注册吗?
不要。免注册直下。
Q:能商用吗?
能。CC0-1.0 无商用限制。
Q:MD22 和 MD17 什么关系?
MD22 是 MD17 的大体系升级版;MD17 是 8 个小分子(9–21 原子),MD22 是 7 个大分子(42–370 原子)。
Q:MD22 和 rMD17 呢?
rMD17 是 MD17 的数据质量修正版(同规模),MD22 是规模与表达力升级(不同规模);两者正交,不互相替代。
Q:MD22 和 QM9 呢?
QM9 是静态小分子的多性质集(约 13.4 万分子),MD22 是动态大体系的能量与力轨迹集;同属分子 ML 基准但侧重不同。
Q:为什么叫 MD22 而不是别的?
命名延续 MD17 的世代编号,"22"不对应分子数或原子数。
Q:最大和最小的体系?
最小 Ac-Ala3-NHMe(42 原子,85,109 构型);最大 Double-walled nanotube(370 原子,5,032 构型)。
Q:哪个体系最难学?
Stachyose 能量 MAE 最高(0.046)且需样本最多(8k);AT-AT-CG-CG 力 RMSE 最高(1.22)。
Q:哪个体系样本最少?
Double-walled nanotube(800 训练样本 / 5,032 总构型)。
Q:非局域性是什么意思?
指某个原子的受力取决于整个分子的构型而非局部邻域;纳米管内外管协同旋转是典型例子。全局力场才能刻画。
Q:什么是 sGDML?
对称梯度域机器学习(symmetric Gradient Domain Machine Learning),本论文配套的全局力场方法;它保留全部原子自由度关联,不做局域化。
Q:论文有跑长时间模拟吗?
有。对双壁纳米管跑了纳米秒级 MD(约 500 ps)与 PIMD(约 100 ps,16 beads,300 K)。
Q:附录 B 的数据是第 8 个体系吗?
不是。附录 B 的 donor-bridge-acceptor 用半经验 GFN2-xTB 生成,属演示数据,非 MD22 七体系。
Q:可以在 HF 下载吗?
可以,HF 上有多套二次分发镜像(colabfit/* 等);部分环境需走 hf-mirror 镜像站。
Q:适合临床医学研究者吗?
不适合直接用——MD22 是纯计算化学数据,无人类样本。它属于"药物发现与化学"域,与蛋白质序列/结构类条目可互链。
Q:怎么引用?
见下方"引用模板",优先引期刊版(Science Advances 2023)。
Q:这 7 个体系是同时采样的吗?
不是。各体系独立进行 MD 采样,温度与基组也可能不同(小体系 500 K/tight,超分子 400 K/light),详见 Table SI。
Q:为什么是 1 fs 步长?
1 fs 是捕捉氢原子振动(最快运动)的常规步长,兼顾精度与稳定性;论文全部轨迹均取 1 fs 分辨率。
Q:为什么要用 MBD 校正?
PBE 泛函本身不描述长程色散力(范德华),而 DHA 长链、碱基堆积、碳纳米管层间堆积都依赖色散;MBD(多体色散)补上这一块,才能得到物理正确的势能面。
Q:AT-AT-CG-CG 里的 CG 是什么?
C(胞嘧啶)与 G(鸟嘌呤)碱基对。所以 AT-AT-CG-CG = 两对 AT + 两对 CG,共四个碱基对。
Q:Stachyose 为什么构型最多?
它带大量羟基,MD 中氢键不断断裂重排,构象多样性极高,需要(也生成了)最多构型(127,272)。
Q:纳米管为什么只要 5,032 个构型?
它的局部化学单调(几乎全是等效碳),且采样目标是覆盖"伸缩/旋转"这类规律运动,不需要海量构型;训练只需 800 样本即可达到力 MAE 0.52(全集最优)。
Q:能量和力的精度为什么不对应?
训练目标是力(力 RMSE≈1),能量是被动报告的"副产品",其误差更受体系能量尺度影响,因此能量 MAE 波动(6 倍)大于力 MAE(1.5 倍)。
Q:能用来训练蛋白质折叠模型吗?
不能直接——MD22 只含一个四肽(42 原子),不是蛋白质结构数据集;蛋白质相关问题应看库内 ProteinGym(rid=813)与 Human Protein Atlas(rid=404)。
Q:它和 AlphaFold 有关系吗?
无直接关系。AlphaFold 是结构预测(序列→3D 结构),MD22 是力场数据(几何→能量与力)。两者可互补(结构给初态,力场给动力学),但用途不同。
Q:数据集里有水分子/溶剂吗?
没有。全部为真空(气相)MD,不含溶剂。溶剂效应需另找数据集。
Q:能用于材料(如金属、氧化物)吗?
不能直接用——MD22 全部是 CHNO 有机体系,不含金属。材料力场应看 ColabFit Exchange 中的其他子集(如 LMNTO)。
Q:ColabFit 是什么?
一个材料/分子数据集的汇聚平台,把异构数据统一为 Parquet schema 并提供 DOI;MD22 的 7 个体系在其中均有镜像。
Q:为什么有多个 DOI?
原始数据集在 sgdml.org 无独立 DOI(随论文);ColabFit 为每个子集分配了 DataCite DOI(10.60732/*),便于单独引用与版本锚定。
Q:训练一个体系的力场要多久?
计算成本取决于方法。全局 sGDML 的训练代价随训练集大小增长,论文的 600–8000 样本规模在单机可完成;深度等变模型(MACE 等)则视 GPU 而定。MD22 的规模设计使其对个人研究者友好。
Q:如果我只想用一个体系,选哪个?
入门选 Ac-Ala3-NHMe(最小);研究非局域性选 Double-walled nanotube;研究规模效应用 AT-AT 与 AT-AT-CG-CG 对照对。
Q:它是"活的"数据集吗(会更新吗)?
原始版本随论文固定,未持续更新;但 ColabFit/HF 上的镜像有各自的收录与再分发时点,引用时应注明版本。
Q:和"MD22"同名的其他东西怎么区分?
MD22 也可能是武器、发动机等编号。检索时联用 “force field” / “sGDML” / “Chmiela” 锁定本数据集(坑 1、§9.4)。
事实清单(硬事实 32 条)
- 官方名:MD22(benchmark dataset)。
- 论文题名:Accurate global machine learning force fields for molecules with hundreds of atoms。
- 期刊:Science Advances 2023;9(2):eadf0873。
- DOI:10.1126/sciadv.adf0873。
- 预印本:arXiv:2209.14865(v1 2022-09-29,v3 2022-11-14)。
- 任务头给的 arXiv:2205.09566 经核验为错误(实为微分几何论文)。
- 作者:Chmiela、Vassilev-Galindo、Unke、Kabylda、Sauceda、Tkatchenko、Müller(7 人)。
- 主机构:TU Berlin / BIFOLD + University of Luxembourg。
- 体系数:7。
- 原子数范围:42–370。
- 体系 1:Ac-Ala3-NHMe,四肽,42 原子,85,109 构型。
- 体系 2:DHA,脂肪酸,56 原子,69,753 构型。
- 体系 3:Stachyose,四糖,87 原子,127,272 构型。
- 体系 4:AT-AT,DNA 碱基对,60 原子,20,001 构型。
- 体系 5:AT-AT-CG-CG,DNA 碱基对,118 原子,10,153 构型。
- 体系 6:Buckyball catcher,超分子,148 原子,6,102 构型。
- 体系 7:Double-walled nanotube,超分子,370 原子,5,032 构型。
- 总构型数:323,422(7 项求和,自算)。
- 总原子-帧:23,716,460(自算)。
- 标签:总势能 + 逐原子受力。
- 理论层级:DFT-PBE+MBD。
- 电子结构软件:FHI-aims。
- MD 引擎:i-PI。
- 时间步长:1 fs(数据集采样)。
- 温度:小体系 500 K、两超分子 400 K。
- 基组:tight(5 个小体系)/ light(2 个超分子)。
- 训练样本:600–8000,按力 RMSE≈1 反推。
- sGDML 力 MAE:0.52–0.79 kcal/mol/Å。
- sGDML 能量 MAE:0.0079–0.046 kcal/mol(逐原子)。
- PIMD 验证:纳米管,16 beads,300 K,0.2 fs,约 100 ps。
- 许可:CC0-1.0。
- 获取:sgdml.org 免注册;ColabFit Parquet 镜像。
术语表(26 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| 机器学习力场 | MLFF (Machine Learning Force Field) | 用机器学习模型拟合原子间势能面,替代昂贵的从头算 |
| 势能面 | potential energy surface (PES) | 分子能量随原子坐标变化的函数 |
| 原子受力 | atomic forces | 势能对坐标的负梯度,驱动 MD 演化 |
| 分子动力学 | molecular dynamics (MD) | 用牛顿方程模拟原子随时间运动 |
| 从头算 | ab initio | 直接求解电子结构、不依赖经验参数的计算 |
| DFT | Density Functional Theory | 密度泛函理论,一种电子结构近似方法 |
| PBE | Perdew-Burke-Ernzerhof | 常用交换关联泛函 |
| MBD | Many-Body Dispersion | 多体色散校正,刻画范德华/长程色散力 |
| FHI-aims | — | 全电子数值基组电子结构软件 |
| i-PI | — | 通用力引擎,驱动各种电子结构软件的 MD |
| sGDML | symmetric Gradient Domain ML | 对称梯度域机器学习,本文配套全局力场方法 |
| GDML | Gradient Domain ML | sGDML 的前身方法 |
| 局域性假设 | locality assumption | 假设能量可拆为局部原子贡献,无法描述非局域效应 |
| 非局域相互作用 | non-local interaction | 跨越较大空间尺度的相互作用 |
| 对称群阶 ‖G‖ | permutation group order | 体系中可利用的置换对称性大小 |
| 四肽 | tetrapeptide | 四个氨基酸残基组成的短肽 |
| 脂肪酸 | fatty acid | 长链羧酸;DHA 是多不饱和脂肪酸 |
| 四糖 | tetrasaccharide | 四个单糖组成的寡糖;Stachyose 即水苏糖 |
| 碱基对 | base pair | DNA 中互补碱基的配对(A-T、C-G) |
| 超分子 | supramolecule | 由非共价作用组装的分子集合体 |
| 巴基球 | buckyball (C60) | 足球烯,60 个碳的笼状分子 |
| 双壁纳米管 | double-walled nanotube | 两层同轴碳纳米管 |
| 路径积分分子动力学 | PIMD | 计入核量子效应的 MD 方法 |
| 虚时间副本 | beads | PIMD 中表示核量子效应的多个副本 |
| 恒温器 | thermostat | 控制模拟温度的算法(Langevin / Nosé-Hoover) |
| 公共领域 | public domain | 无著作权限制的作品状态(CC0-1.0 实现) |
附录
附录 A:引用模板
@article{chmiela2023md22,
  title   = {Accurate global machine learning force fields for molecules with hundreds of atoms},
  author  = {Chmiela, Stefan and Vassilev-Galindo, Valentin and Unke, Oliver T. and
             Kabylda, Adil and Sauceda, Huziel E. and Tkatchenko, Alexandre and
             M{\"u}ller, Klaus-Robert},
  journal = {Science Advances},
  volume  = {9},
  number  = {2},
  pages   = {eadf0873},
  year    = {2023},
  doi     = {10.1126/sciadv.adf0873}
}
数据集引用(sgdml.org):Chmiela, S. et al. “MD22 benchmark dataset.” www.sgdml.org, 2022–2023. License: CC0-1.0.
ColabFit 镜像引用:Chmiela, S. et al. “MD22 <system>.” ColabFit, 2023. https://doi.org/10.60732/<subDOI>.
附录 B:DAIMS 评估全表
DAIMS = Discoverability(可发现性)/ Accessibility(可获取性)/ Interoperability(互操作性)/ Metadata(元数据质量)/ Sustainability(可持续性),各 10 分制。
| 维度 | 评分 | 依据 |
|---|---|---|
| D 可发现性 | 9 | 论文 + sgdml.org + ColabFit + HF 多点可达;DOI 与 arXiv 号齐备;扣分因官网未提供单一"数据集落地页"聚合全部 7 体系下载 |
| A 可获取性 | 10 | CC0-1.0 公共领域,免注册直下,无地域/机构限制;商用无阻 |
| I 互操作性 | 8 | 提供 .npz、XYZ、Parquet 多格式;ColabFit 统一 schema 利于跨数据集;但各格式字段命名不统一(坑 6),需手工映射 |
| M 元数据质量 | 8 | 论文 Table I/SI/SII 给出温度、基组、恒温器、构型数、统计量完备;扣分因官方未给全集总构型/总原子数(坑 3、坑 4),且无独立 Data Card |
| S 可持续性 | 9 | 期刊 + 期刊 DOI + arXiv + ColabFit + HF 多副本托管,长期可获得性高;扣分因原始托管为学术实验室站点(sgdml.org/quantum-machine.org),非机构级长期存储库 |
综合:44/50。核心强项是可获取性(CC0 + 免注册);主要短板是元数据的"总集合口径缺失"与格式字段不统一。
附录 C:数据集速查卡
名称:MD22
类型:机器学习力场基准(生物大分子/超分子 MD 轨迹)
体系:7 个(42–370 原子)
总量:323,422 构型 / 23,716,460 原子-帧
标签:总势能 + 逐原子受力(DFT-PBE+MBD)
软件:FHI-aims + i-PI
温度:400–500 K   步长:1 fs
论文:Science Advances 2023;9(2):eadf0873
预印本:arXiv:2209.14865
许可:CC0-1.0
获取:https://www.sgdml.org/  (.npz 直下)
镜像:ColabFit Exchange(Parquet,7 个 DOI)
库内互链:QM9(105) / ProteinGym(813) / Human Protein Atlas(404)
附录 D:坑点速查汇总
| 编号 | 坑点 | 影响面 |
|---|---|---|
| 坑 1 | 任务头 arXiv 2205.09566 错误,正确为 2209.14865 | 引用/检索 |
| 坑 2 | 论文 2022 预印本 vs 2023 期刊版年份双口径 | 著录 |
| 坑 3 | 总构型数无官方数字,需 7 项求和得 323,422 | 数字抽取 |
| 坑 4 | 总原子数口径为"原子数×构型数"(23,716,460),非唯一原子数 | 数字抽取 |
| 坑 5 | 温度(400/500 K)与基组(tight/light)非全局统一 | 复现/比较 |
| 坑 6 | 原始 npz 与 ColabFit Parquet 字段/划分不一致 | 管线搭建 |
| 坑 7 | 附录 B donor-bridge-acceptor 非 MD22 体系(半经验 GFN2-xTB) | 体系定义 |
| 坑 8 | 第三方方法数值口径冲突(VisNet-LSRM 两版数值) | 跨论文比较 |
| 坑 9 | 体系名论文拼写 vs ColabFit 转写不一致 | 脚本匹配 |
附录 E:检索决策树
要找"分子机器学习的 DFT 力场基准"?
├─ 小分子、静态多性质        → QM9(库内 rid=105)
├─ 小分子、动态能量与力      → MD17(库内无)/ rMD17(库内无)
├─ 大分子、动态能量与力      → MD22(本条目)★
├─ 含激发态/非绝热          → WS22 / xxMD(库内无)
└─ 蛋白质突变适应度          → ProteinGym(库内 rid=813)

误区提示:
  "MD-22"(武器型号)      ≠ MD22
  附录 B 演示数据          ≠ MD22 第 8 个体系(坑 7)
附录 F:七体系基准参照总表
一张表汇总本条目所有关键数字,供快速对标:
| 体系 | 原子 | 构型 | 训练 | 占比 | E-MAE | F-MAE | E-RMSE | F-RMSE | ‖G‖ | 温度 | 基组 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Ac-Ala3-NHMe | 42 | 85,109 | 6k | 7% | 0.0093 | 0.79 | 0.012 | 1.21 | 18 | 500 | tight |
| DHA | 56 | 69,753 | 8k | 12% | 0.023 | 0.75 | 0.030 | 1.17 | 6 | 500 | tight |
| Stachyose | 87 | 127,272 | 8k | 29% | 0.046 | 0.68 | 0.052 | 1.07 | 1 | 500 | tight |
| AT-AT | 60 | 20,001 | 3k | 15% | 0.012 | 0.69 | 0.015 | 1.12 | 36 | 500 | tight |
| AT-AT-CG-CG | 118 | 10,153 | 2k | 20% | 0.012 | 0.70 | 0.015 | 1.22 | 96 | 500 | tight |
| Buckyball catcher | 148 | 6,102 | 600 | 10% | 0.0079 | 0.68 | 0.0099 | 1.02 | 48 | 400 | light |
| Double-walled nanotube | 370 | 5,032 | 800 | 16% | 0.0108 | 0.52 | 0.0135 | 0.97 | 28 | 400 | light |
| 合计/范围 | 42–370 | 323,422 | 600–8k | 7–29% | 0.0079–0.046 | 0.52–0.79 | — | — | 1–96 | 400–500 | — |
(能量 MAE/RMSE 单位 kcal/mol 且逐原子归一;力 MAE/RMSE 单位 kcal/mol/Å 且逐分量归一。)
附录 G:来源台账
| 事实 | 来源 | 核对方式 |
|---|---|---|
| 7 体系、原子数 42–370 | 论文摘要 + Table I | PDF 文本提取(本机 pypdf) |
| 逐体系构型数(Size) | 论文 Table SII | PDF 文本提取 |
| 逐体系训练集大小 | 论文 Table I | PDF 文本提取 |
| 温度/基组/恒温器 | 论文 Table SI | PDF 文本提取 |
| E-MAE/F-MAE/RMSE 全表 | 论文 Table I | PDF 文本提取 |
| 力 RMSE≈1 为设计目标 | 论文 Table I 表注 | PDF 文本提取 |
| PIMD 设置(16 beads/300 K/0.2 fs) | 论文正文 §IV | PDF 文本提取 |
| 数据/模型/软件可用性 | 论文 Data availability 声明 | PDF 文本提取 |
| CC0-1.0 | ColabFit 各子集页 + sgdml.org | WebFetch 实抓 |
| 各子集 DOI(10.60732/*) | ColabFit Exchange | WebFetch 实抓 |
| 纳米管文件 85.7 MB | quantum-machine.org 直链 | curl HEAD 实测 |
| 论文题名/作者/DOI | arXiv abs + 期刊页 | WebFetch 实抓 |
| arXiv 编号纠错 | arXiv 2205.09566 abs 页(math.DG) | WebFetch 实抓 |
附录 H:版本与时点
| 时点 | 事件 |
|---|---|
| 2022-09-29 | 预印本 arXiv:2209.14865 v1 |
| 2022-10-04 | 预印本 v2 |
| 2022-11-14 | 预印本 v3(当前版本) |
| 2023-01-11 | Science Advances 9(2):eadf0873 正式发表 |
| 2023-10-07 | ColabFit Exchange 收录 7 个子数据集 |
| 2024–2025 | HuggingFace 多套二次分发镜像出现(nanotube 等子集常被单独使用) |
| 2026-10-16 | 本条目核验与成稿时点 |
附录 I:一句话导航
- 要数字 → §2.1 / 附录 F。
- 要许可与下载 → §6。
- 要精度基线 → §5。
- 要避坑 → §10 / 附录 D。
- 要互链 → §9。
- 要引用格式 → 附录 A。
- 要澄清 arXiv 编号 → 坑 1。
尾注
- 本条目全部硬数字来自论文 Science Advances 2023;9(2):eadf0873 及其补充材料(Table I、Table SI、Table SII),经本机 PDF 文本提取逐字段核对;镜像与许可信息来自 sgdml.org 官网与 ColabFit Exchange 数据集页(2026-10-16 检索)。
- 存照:任务头 arXiv 编号 2205.09566 经一手核验为错误,全文按 2209.14865 成稿(坑 1);总构型数 323,422 与总原子-帧 23,716,460 均为本文按论文逐项自算(坑 3、坑 4)。
- 库内互链:QM9(rid=105)、ProteinGym(rid=813)、Human Protein Atlas(rid=404)、DrugTargetCommons(rid=1080);MD17/rMD17 不在库,不互链。
- 最后核验时间:2026-10-16。
附录 J:MD22 与相关数据集的互链语义图
                    ┌──────────────┐
                    │  MD22 (本条目) │
                    └───────┬──────┘
       ┌────────────────────┼────────────────────┐
       │ 前身/世代           │ 同谱系              │ 下游应用
       ▼                    ▼                    ▼
  MD17 / rMD17         QM9 (rid=105)      ProteinGym (rid=813)
  (库内无,不互链)    (分子 ML 基准)    Human Protein Atlas (rid=404)
                                            DrugTargetCommons (rid=1080)

  语义:
    MD22 ↔ QM9       横向(同世代不同侧重:动态力场 vs 静态性质)
    MD22 → ProteinGym 纵向(分子层面 → 蛋白功能层面)
    MD22 → HPA        纵向(分子 → 蛋白图谱)
附录 K:常见检索组合与预期命中
| 检索组合 | 预期命中 | 备注 |
|---|---|---|
| MD22 + “force field” | 本数据集 | 最精确 |
| MD22 + Chmiela | 本数据集论文 | 作者锚定 |
| MD22 + sGDML | 本数据集 + 方法 | 方法锚定 |
| MD22 + biomolecule | 本数据集讨论 | 域锚定 |
| MD-22 + 武器 | 无关结果 | 注意连字符,坑 1 |
| MD17 单独 | 前身数据集 | 非本条,注意区分 |
| “MD22” + 纳米管 | 纳米管子集 | 常被单独使用 |
附录 L:术语补充(进阶 14 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| 梯度域机器学习 | Gradient Domain ML | 直接学习势能梯度(力)而非势能本身的方法 |
| 核方法 | kernel method | 用核函数度量样本相似度的非参数方法 |
| 置换对称性 | permutation symmetry | 相同原子互换后物理量不变的对称性 |
| 归纳偏置 | inductive bias | 模型结构自带的先验假设 |
| 等变神经网络 | equivariant neural network | 对旋转/平移等变换保持等变性的网络 |
| 消息传递网络 | message passing neural network | 在原子图上迭代传递邻居信息的架构 |
| 截断半径 | cutoff radius | 局域模型中每个原子考虑的最大邻居距离 |
| 保守力场 | conservative force field | 力=势能负梯度的力场,能量守恒 |
| 数据泄漏 | data leakage | 训练信息泄漏到测试集导致高估性能 |
| 范德华力 | van der Waals force | 中性分子间的弱长程相互作用 |
| 色散力 | dispersion force | 瞬时偶极引起的长程吸引力 |
| 零点能 | zero-point energy | 量子基态的最低振动能 |
| 虚时间 | imaginary time | 路径积分中表示量子涨落的维度 |
| 径向分布函数 | radial distribution function h® | 描述原子间距分布的统计量,用于验证 MD |
附录 M:七体系一句话记忆口诀
- 四肽(42):最小的蛋白质片段。
- 脂肪酸(56):最柔的长链。
- 四糖(87):最多氢键、最多构型。
- 两碱基对(60):最小的核酸单元。
- 四碱基对(118):规模对照的"大兄弟"。
- 巴基球捕捉器(148):主客体超分子。
- 双壁纳米管(370):最大、最非局域、PIMD 试金石。
记法:肽-脂-糖-核酸-核酸-捕获-纳米管,规模依次 42 → 56 → 87 → 60 → 118 → 148 → 370。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- matbench — 共享标签:药物发现与化学 / 量子化学 / 分子性质预测 / 评测基准
- qm9 — 共享标签:药物发现与化学 / 量子化学 / 分子性质预测 / 评测基准
- ani1x — 共享标签:药物发现与化学 / 量子化学 / 分子性质预测
- aqsoldb — 共享标签:药物发现与化学 / 分子性质预测 / 评测基准
- psbench — 共享标签:药物发现与化学 / 评测基准 / 基因组学与多组学
- moleculenet — 共享标签:药物发现与化学 / 分子性质预测 / 评测基准
- plinder — 共享标签:药物发现与化学 / 评测基准 / 基因组学与多组学
- pcqm4mv2 — 共享标签:药物发现与化学 / 量子化学 / 评测基准
- proteingym — 共享标签:药物发现与化学 / 评测基准 / 基因组学与多组学
- emdb — 共享标签:药物发现与化学 / 评测基准 / 基因组学与多组学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
