信息速览
Prov-GigaPath — 全片病理基础模型百科条目
§0 导读:这个数据集解决什么问题
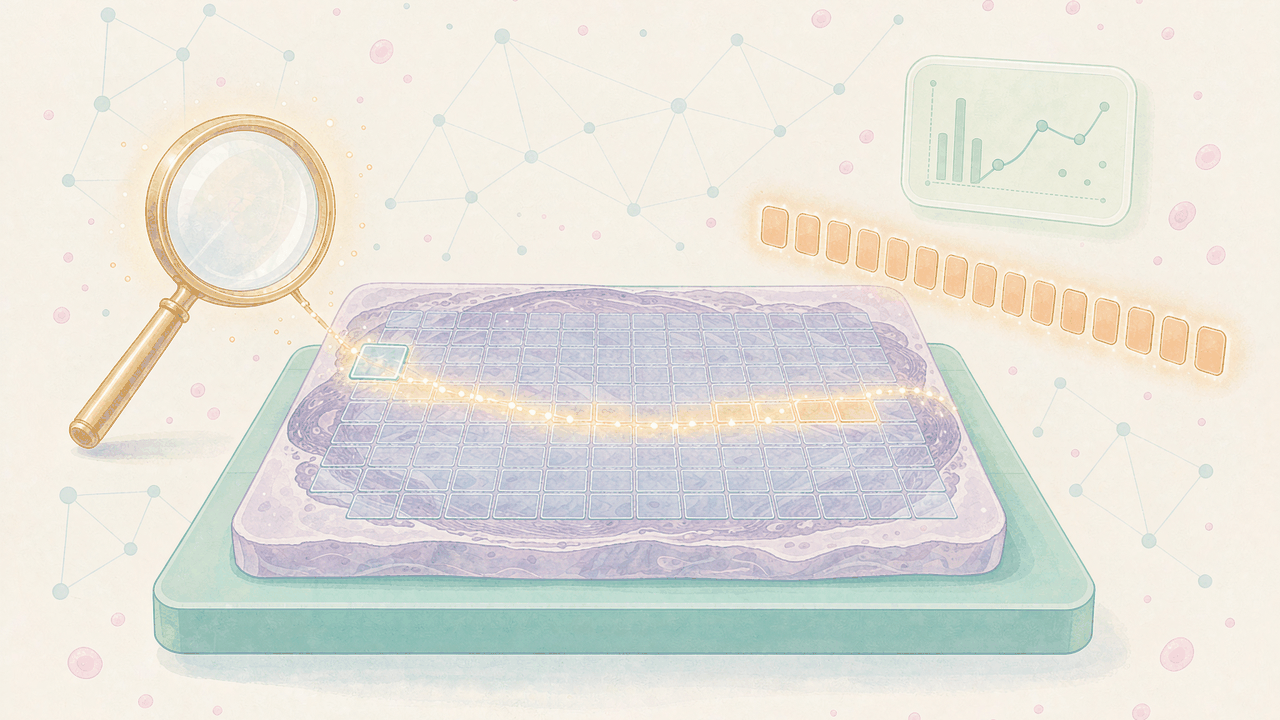
数字病理(digital pathology)的核心计算难题在于"规模"。一张常规的 gigapixel 全片病理图像(whole-slide image, WSI)往往由数万个图像图块(tile)拼成——在 Providence 的真实数据里,单张切片最多含 70,121 个 256×256 图块。传统的计算病理模型受限于 Transformer 自注意力关于序列长度的二次复杂度,不得不对每张切片下采样一小部分图块做训练,从而丢掉了关键的切片级上下文(slide-level context)。
Prov-GigaPath 正是为破解这一瓶颈而生。它由微软研究院(Microsoft Research)联合美国大型医疗系统 Providence 与华盛顿大学(University of Washington)共同研发,首次把整张切片作为超长 token 序列来建模:先把每个图块(tile)编码为视觉 token,再用改编自 LongNet 的**膨胀自注意力(dilated self-attention)**把数万个 token 串成一条长序列,从而在不牺牲全局上下文的前提下完成 gigapixel 级建模。
它的立身之本是真实世界数据。预训练语料 Prov-Path 取自 Providence 医疗系统旗下 28 个肿瘤中心,包含 171,189 张 H&E 与免疫组化(IHC)全片病理图像、共 1,384,860,229 个 256×256 图块,源自逾 30,000 名患者、覆盖 31 大主要组织类型。按图块数计,这是 TCGA 的 5 倍以上;按患者数计,是 TCGA 的 2 倍以上——论文称之为"迄今为止规模最大的病理预训练工作"。
在评测上,Prov-GigaPath 于 26 项数字病理任务(9 项癌症分型 + 17 项病理组学)中拿下 25 项 SOTA,其中 18 项显著优于次优模型,一举超过 HIPT、CtransPath、REMEDIS 等公开基线。
但对检索者而言,最需要先弄清的一点是它的可用性边界:权重虽以"开放权重"(open-weight)名义发布、HF 模型卡标注 apache-2.0,但官方明确限定为 research use only,禁止任何部署(含商业)用途与临床诊断用途,且 HF 下载本身受 gated 条款约束——想拿到权重,得先同意条款并配置访问令牌。本条目将把这一"表面开放、实质受限"的双口径如实写清。
§1 数据集速览:十问十答
Q1:Prov-GigaPath 到底是什么?
它既是一个基础模型(foundation model),也代表一套预训练语料。模型架构名 GigaPath,前缀 Prov- 指其预训练数据来自 Providence 医疗系统;语料名 Prov-Path。模型由"图块编码器(tile encoder)+ 切片编码器(slide encoder)"两级构成,用于把病理切片转成可复用的特征表示。
Q2:它预训练用了多少数据?
171,189 张全片病理图像(WSI),共 1,384,860,229 个 256×256 图像图块(论文与新闻稿概称"约 13 亿"),源自逾 30,000 名患者,覆盖 31 大主要组织类型,来自 Providence 旗下 28 个肿瘤中心。
Q3:和 TCGA 比如何?
按其自述:图块数是 TCGA 的 5 倍以上,患者数是 TCGA 的 2 倍以上。是"迄今规模最大的病理预训练工作"。
Q4:它为什么重要?
它是据作者所述首个在大规模真实世界数据上预训练的"全片"病理基础模型,第一次把整张 gigapixel 切片作为超长序列整体建模,而不是下采样局部图块——从而能在预测中利用整个切片的全局上下文。
Q5:核心技术是什么?
两级架构:图块编码器用 DINOv2 自监督预训练提取局部特征;切片编码器用掩码自编码器(masked autoencoder, MAE)+ 改编自 LongNet 的膨胀自注意力,对万级图块的长序列建模。
Q6:性能如何?
在 26 项数字病理任务(9 项癌症分型 + 17 项病理组学)中拿下 25 项 SOTA,18 项显著优于次优模型。例:TCGA 上 EGFR 突变预测 AUROC 提升 23.5%、AUPRC 提升 66.4%。
Q7:怎么获取?
权重在 HuggingFace(prov-gigapath/prov-gigapath)和 GitHub 发布。但 HF 下载受 gated 条款约束,需同意条款并配置 HF_TOKEN。
Q8:能商用或上临床吗?
不能。官方 Model Uses 明确 research use only,任何部署用途(商业或其他)均超出范围,且不得作为医疗器械或临床诊断工具。这是本条目最关键的可用性限制。
Q9:数据全量能拿到吗?
不能。Prov-Path 全量 171,189 张 WSI 因隐私与 IRB 约束不公开,GitHub 仅提供去标识化的小样本子集。
Q10:一句话定位?
一个"表面对外开放、实质受限的研究型"全片病理基础模型——技术上把病理基础模型推到了万级图块长上下文,可用性上却被 research-only 与 gated 双重边界框住。
§2 数据构成与规格
2.1 规模、来源与机构构成
Prov-GigaPath 的预训练语料 Prov-Path 来自 Providence——一家美国大型医疗系统,含 28 个肿瘤中心。语料构成如下:
| 维度 | 数值 |
|---|---|
| 全片病理图像(WSI) | 171,189 张 |
| 图像图块(tile)总数 | 1,384,860,229(约 13 亿) |
| 图块尺寸 | 256 × 256 像素 |
| 患者数 | 逾 30,000 名 |
| 组织类型 | 31 大主要组织类型 |
| 肿瘤中心 | 28 个 |
| 染色类型 | H&E(苏木精-伊红)+ IHC(免疫组化) |
| 单张切片最大图块数 | 70,121 个(Providence 数据实测) |
所有计算均在 Providence 的租户(tenant)环境内完成,并经 Providence 机构审查委员会(Institutional Review Board, IRB)批准,以符合隐私与合规标准。这既是数据真实性的保证,也解释了为何全量数据不可公开迁移——它本质上是单一医疗系统内部受保护的真实世界数据。
关键规格补充:语料按图块数计是 TCGA 的 5 倍以上、按患者数计是 TCGA 的 2 倍以上。它不是把公开数据集简单堆叠,而是在真实临床工作流中产生的、未经刻意筛选的活检与切除标本切片——这正是论文标题强调"from real-world data"的原因。
2.2 两级编码规格与推理流水线
Prov-GigaPath 的模型规格可拆为两级,与数据规格一一对应:
图块编码器(tile encoder)
- 基于 DINOv2 自监督框架预训练
- 输入:256×256 图块(推理时缩放至 256 后中心裁剪 224)
- 输出:图块级 embedding
- 发布格式:
config.json+pytorch_model.bin(timm 格式)
切片编码器(slide encoder)
- 基于掩码自编码器(MAE)+ LongNet 膨胀自注意力预训练
- 输入:全部图块 embedding 序列 + 图块坐标
- 输出:切片级 embedding(可用于下游任务的整片表示)
- 原始配置:12 层 / 768 维隐层,输入图块 embedding 维度 1536
- 发布格式:
slide_encoder.pth(仅含 encoder,无 decoder)
推荐推理流水线(slide 级):
- 将整张 WSI 切分为 N 个图块,记录每块的坐标;
- 用图块编码器得到每个图块的 embedding;
- 把 N 个图块 embedding 及其坐标输入切片编码器,得到切片级表示。
这一"先局部后全局"的两级设计,是本模型区别于早期"单图块分类器"病理模型的核心:图块编码器负责捕捉细胞与组织级的局部形态,切片编码器负责整合跨整个切片的全局模式。
2.3 语料携带的层级信息
Prov-Path 不只是像素集合,它携带了一个信息层级(hierarchy):
- 组织病理学发现(histopathology findings)
- 癌症分期(cancer staging)
- 基因组突变谱(genomic mutation profiles)
- 关联病理报告(pathology reports)
这些层级信息使语料不仅能支撑纯图像的自监督预训练,还能支撑视觉-语言联合预训练——论文正是利用每张切片关联的病理报告,对模型继续做视觉-语言对比学习,进而实现零样本分型与突变预测。
2.4 评测数据构成
正式评测在两类数据上进行:
- Providence 数据:与预训练同源的内部数据;
- TCGA(The Cancer Genome Atlas):外部公开数据。
评测任务共 26 项 = 9 项癌症分型 + 17 项病理组学。此外还提供两个公开数据集上的微调示例:
| 示例 | 层级 | 预抽取 embedding 大小 |
|---|---|---|
| PCam(PatchCamelyon) | 图块级线性探测 | 约 2 GB |
| PANDA | 切片级微调 | 约 32 GB |
2.5 与相关概念的边界
检索者容易混淆三个名字,需厘清:
- Prov-GigaPath:完整基础模型(图块编码器 + 切片编码器);
- GigaPath:模型架构名,Prov-GigaPath 中的架构核心;
- Prov-Path:预训练数据集名,是数据不是模型。
此外还有衍生模型 GigaPath-Flash(轻量变体)与 GigaTIME(H&E 空间蛋白组预测),它们共享 GigaPath 家族名,但属独立的新发布。
2.6 数据规模双口径:概称与精确值
读本条目数字时需注意一个双口径:
- 概称口径:Providence 新闻稿与 Nature 摘要均作"1.3 billion tiles(约 13 亿)"、“171,189 whole slides”;
- 精确口径:Nature 全文(go.nature.com 摘要页)给出精确值 “1,384,860,229 image tiles”。
两者不矛盾——前者是四舍五入的概称,后者是精确计数。本条目正文以"约 13 亿(精确 1,384,860,229)"并列呈现,避免检索者因数字出入产生疑虑。
2.7 数据规模的直观换算
13 亿图块这个数字不易建立直觉,可做几组换算帮助理解:
- 按患者算:171,189 张切片来自逾 30,000 名患者,平均每人约 5.7 张切片——说明多数病例有多张切片(如原发灶 + 转移灶、不同染色),而非一人一片;
- 按切片算:1,384,860,229 ÷ 171,189 ≈ 每张切片平均约 8,090 个图块,而最大值达 70,121 个——片间差异近一个数量级,这正是长上下文建模的必要性来源;
- 按单块算:每块 256×256,单块像素约 6.5 万;13 亿块合计约 8.6×10¹³ 像素——这一体量远超任何人工可审阅的范围,也是必须依赖自监督的原因;
- 按相对规模算:若把 TCGA 的图块量记作 1,Prov-Path 是其 5 倍以上;用一句通俗的话说,Prov-GigaPath 见过的病理图块,比此前最大公开病理数据集多出数倍。
这些换算并非论文原文,而是基于硬数字的合理推算,用于帮助检索者建立规模感;引用时请以官方数字为准。
2.8 机构与地域分布的现实含义
语料全部来自 Providence 一家医疗系统,覆盖 28 个肿瘤中心,地处美国(主要在西海岸与西北部)。这一"单一系统、多中心"的分布带来两面性:
- 优势:真实的临床工作流、统一的扫描与质控标准,数据同质性较好,适合训练稳定的基础模型;
- 风险:人群构成、扫描仪型号、染色流程相对集中,跨机构、跨地域、跨人群的泛化性未被大规模外部验证。
论文在 IRB 框架下完成全部计算,合规性有保障;但对下游使用者而言,"单一系统训练 → 全域应用"的落差是必须自行评估的风险点。这一点也写入了本条目 frontmatter 的 rai:dataLimitations。
§3 模型架构与技术路线
3.1 从"下采样局部"到"整片建模"
数字病理的计算挑战可一言蔽之:一张切片太大。一个标准 gigapixel 切片含数万个图块,而 Transformer 自注意力关于序列长度是二次复杂度——把 70,121 个图块直接喂给标准 ViT 在算力上不可行。
此前的模型(如 HIPT、CtransPath、REMEDIS)因此多采"下采样一小部分图块"的策略,代价是丢失切片级上下文。Prov-GigaPath 的突破在于:用改编自 LongNet 的膨胀自注意力,把数万 token 的长序列在可承受算力下整体建模。
3.2 两级架构:局部与全局的分工
层级一:图块编码器(捕捉局部)
- 框架:DINOv2(当前最强的图像自监督学习框架之一)
- 职责:把每个 256×256 图块单独投影为紧凑 embedding
- 意义:保证单块形态特征的质量
层级二:切片编码器(捕捉全局)
- 框架:掩码自编码器(MAE)+ LongNet
- 职责:输入图块 embedding 序列,输出带上下文的整片 embedding
- 关键:LongNet 的膨胀自注意力让"看遍整张切片"成为可能
论文原文的表述是:模型"通过蒸馏多样的局部病理结构并整合整张切片的全局特征,在 gigapixel 病理切片的超长上下文建模上表现出色"。
3.3 两阶段自监督预训练
预训练分为两个阶段:
- 图像级自监督:用 DINOv2 配合标准 vision transformer 完成图块级预训练;
- 整片级自监督:用掩码自编码器搭配 LongNet,在图块 embedding 序列上完成切片级预训练。
这种"先图块后整片"的顺序,与两级架构对应:先把单块学好,再学习块与块之间的全局关系。整个流程无需人工标注,完全依赖自监督信号——这也是它能吞下 13 亿图块而无需逐块标注的前提。
3.4 视觉-语言扩展
在纯视觉预训练之后,论文进一步利用每张切片的关联病理报告做视觉-语言对比学习(vision-language contrastive learning)。结果显示,扩展后的 Prov-GigaPath 在零样本分型(zero-shot subtyping)与零样本突变预测等标准视觉-语言任务上达到 SOTA,展示了多模态整合分析的潜力。
3.5 架构要点总结表
| 组件 | 技术 | 输入 | 输出 |
|---|---|---|---|
| 图块编码器 | DINOv2 + ViT | 256×256 图块 | 图块 embedding(原始 1536 维) |
| 切片编码器 | MAE + LongNet(膨胀自注意力) | 图块 embedding 序列 + 坐标 | 切片级 embedding |
| 原始切片编码器配置 | 12 层 / 768 维 | — | — |
| 视觉-语言扩展 | 对比学习(用病理报告) | 图块序列 + 文本 | 零样本任务表示 |
3.6 为什么用 LongNet 而非其他长上下文方案
论文选择 LongNet 的关键理由是其**膨胀自注意力(dilated self-attention)**机制:它能在不随序列长度二次爆炸的情况下,把注意力铺展到极长序列。对病理切片而言,"极长序列"是常态而非例外——最大的切片有 7 万多个图块。把 LongNet 从通用长序列建模迁移到数字病理,是 Prov-GigaPath 从工程上得以成立的技术支点。
§4 评测基准与性能
4.1 基准构成
Prov-GigaPath 的评测覆盖 26 项数字病理任务,构成如下:
| 类别 | 任务数 | 说明 |
|---|---|---|
| 癌症分型(cancer subtyping) | 9 | 覆盖 9 个癌种 |
| 病理组学(pathomics) | 17 | 含基因组突变预测等 |
| 合计 | 26 | 数据来自 Providence + TCGA |
4.2 总体结果
- 26 项中 25 项达到 SOTA;
- 其中 18 项显著优于次优方法(论文 Supplementary Table 2);
- 对比基线:HIPT、CtransPath、REMEDIS(均为公开可用病理基础模型)。
4.3 分型任务表现
在 癌症分型方向上,Prov-GigaPath 在全部 9 个癌种中超越其他模型,其中 6 个癌种显著优于次优方法。论文认为这"预示了其跨癌种的广适用性"。
4.4 病理组学亮点:EGFR 突变预测
最具代表性的结果出现在 TCGA 上的 EGFR 突变预测:
| 指标 | 相对次优模型(REMEDIS)提升 |
|---|---|
| AUROC | +23.5% |
| AUPRC | +66.4% |
这一结果尤其值得注意:REMEDIS 本身是在 TCGA 数据上预训练的,而 Prov-GigaPath 并未使用 TCGA 预训练——也就是说,一个没"见过"TCGA 的模型,在 TCGA 的突变预测任务上反超了专为 TCGA 打造的对口模型。这有力佐证了"大规模真实世界数据 + 全片建模"带来的泛化优势。
4.5 视觉-语言任务
利用切片关联的病理报告继续预训练后,模型在零样本分型与零样本突变预测等标准视觉-语言建模任务上达到 SOTA,展示了整合多模态数据(图像 + 文本报告)的潜力。
4.6 公开微调示例与基准数据
官方提供两个可直接复现的微调示例:
| 示例 | 层级 | 数据 | 预抽取 embedding |
|---|---|---|---|
| PCam(PatchCamelyon) | 图块级线性探测 | 病理图块分类 | 约 2 GB |
| PANDA | 切片级微调 | 前列腺癌分级 WSI | 约 32 GB |
检索者若想快速验证模型效果,PANDA 与 PCam 是最便捷的两个入口——它们既有公开数据,官方又提供了预抽取 embedding,省去了自行切图与推理的开销。
4.7 结果的解读边界
读这组"25/26 SOTA"时需保留几分审慎:
- 评测数据与预训练数据同源:26 项任务中相当一部分使用 Providence 内部数据,而预训练语料也来自 Providence——同源评估可能高估真实泛化能力;
- 外部验证有限:跨机构、跨人群、跨扫描仪的外部验证在论文中覆盖不足;
- 排名对比的时效性:对比基线(HIPT/CtransPath/REMEDIS)发表于 2024 年前后,病理基础模型迭代极快,SOTA 地位需按发表时点理解。
这些边界并不否定模型的技术价值,而是提醒检索者:"25/26 SOTA"是 2024 年论文口径下的成绩,不等于在当前所有新模型面前仍居首。
4.8 逐类任务的意义解读
26 项任务可按目的分三类,各自说明模型的能力边界:
(a)癌症分型(9 项)
判定肿瘤的亚型,是病理诊断的核心任务之一。Prov-GigaPath 在 9 个癌种全部领先,说明其整片表示对"整张切片的形态综合判断"有实质帮助——单看图块难以区分亚型,必须看全局结构。
(b)突变预测(属病理组学)
从 H&E 图像直接预测基因组突变(如 EGFR)。这是"形态-基因"关联的经典难题,也是精准肿瘤学的关键:若能免去测序直接预测突变,可大幅降低门槛。Prov-GigaPath 在此表现突出,佐证整片上下文对这类"隐式全局模式"任务的价值。
(c)其他病理组学(分期、组织学发现等)
涵盖癌症分期、组织学发现等一系列从图像预测临床/病理标签的任务,共同检验模型作为"通用病理特征提取器"的能力。
4.9 与"下采样模型"的性能差距来源
一个自然的疑问是:Prov-GigaPath 的优势究竟来自更大数据,还是整片建模?论文的论证逻辑指向两者兼有:
- 数据侧:预训练语料远大于对比模型,且为真实世界数据;
- 架构侧:整片长上下文建模,避免了下采样丢失的全局信息。
论文以"大规模预训练 + 超长上下文建模"的联合表述强调二者共同作用。对下游使用者而言,实用结论是:当任务依赖全局结构(分型、突变)时,整片建模的优势更明显;当任务只在局部图块上定义时,优势可能收窄。
4.10 复现评测的最低门槛
若研究者想自行复现部分评测,最低门槛为:
- 一块支持 CUDA 的 NVIDIA GPU(官方示例用 A100);
- 预抽取好的 embedding(PCam 约 2GB 或 PANDA 约 32GB),避免自行切图;
- 对应的下游标签(PCam/PANDA 均公开);
- 微调脚本(官方提供)。
这条路径无需接触全量 Prov-Path 数据,是验证模型可用性的最经济方式。
§5 与相关模型的对比与谱系
5.1 三大对比基线的定位
Prov-GigaPath 论文的直接对标对象是三个公开病理基础模型:
| 模型 | 特点 | 与 Prov-GigaPath 的差异 |
|---|---|---|
| HIPT | 层级式视觉 Transformer,早期整片建模尝试 | Prov-GigaPath 用 LongNet 支持更长序列、更完整上下文 |
| CtransPath | 基于 CNN 的病理自监督模型 | Prov-GigaPath 为纯 Transformer 两级架构 |
| REMEDIS | 微软此前工作,部分在 TCGA 上预训练 | Prov-GigaPath 未用 TCGA,却在 TCGA 任务上反超 |
5.2 在病理基础模型谱系中的位置
Prov-GigaPath 处于"整片级(slide-level)基础模型"这一分支,与两类更早的路线形成对照:
- 图块级模型(如仅做 patch 分类或 patch 检索的模型):只处理单块,缺乏整片上下文;
- 整片级早期模型(如 HIPT):尝试整片建模但受序列长度限制,需层级下采样。
Prov-GigaPath 的贡献在于用膨胀自注意力把整片建模的序列长度上限大幅推高,从而在架构层面支持"看遍全部图块"。
5.3 GigaPath 模型家族(含后续版本)
Prov-GigaPath 并非孤立模型,而是一个持续演进的家族。据 GitHub 模型家族表(均标 Apache-2.0):
| 模型 | 说明 | 出处 |
|---|---|---|
| GigaPath | 整片基础模型(本条目主体) | Nature 2024 |
| GigaPath-Flash | 轻量高效变体 | arXiv 2026(arXiv:2607.18218) |
| GigaTIME | 从 H&E 预测空间蛋白组 | Cell 2026 |
| GigaTIME-Flash | GigaTIME 的轻量变体 | arXiv 2026 |
GigaPath-Flash 规格(对照原始版):
- 切片编码器:LongNet 12 层 / 384 维隐层(约 21M 参数);
- 图块编码器:DINOv2-small(ViT-S/16,约 22M 参数);
- 与原始版相比,切片编码器隐层与输入图块 embedding 维度都从 768/1536 降到 384,显著降低显存与推理成本。
5.4 时间线与发布节奏
| 时间 | 事件 |
|---|---|
| 2024-05-20 | HF 模型仓创建 |
| 2024-05-22 | Providence 官方新闻稿发布;Nature 论文在线 |
| 2024-05 | Nature 正式卷期(630:181-188) |
| 2024-06 | GitHub 发布模型与代码 + demo notebook |
| 2024-07 | 发布 WSI 预处理/切图指南 |
| 2024-09 | 发布 embedding 可视化 notebook |
| 2025-12 | GigaTIME 发布 |
| 2026-07 | GigaPath-Flash / GigaTIME-Flash 发布 |
| 2026-08-07 | HF 仓最后更新 |
这一节奏显示:Prov-GigaPath 在论文发表后持续维护与扩展,而非一次性的"论文附赠代码"。这在学术模型中较为难得,也提升了它的长期可用性。
§6 获取与许可:双口径的可用性边界 ★重点
本节是全条目最需要检索者读清的部分。 Prov-GigaPath 常被简称为"开放权重模型",但其真实可获取性与使用边界远复杂于这四个字。以下逐项拆解。
6.1 获取渠道
| 渠道 | 内容 | 地址 |
|---|---|---|
| GitHub | 代码、文档、微调脚本、示例数据链接 | github.com/prov-gigapath/prov-gigapath |
| HuggingFace | 模型权重 | huggingface.co/prov-gigapath/prov-gigapath |
| HF(Flash 版) | 轻量变体权重 | huggingface.co/prov-gigapath/prov-gigapath-flash |
6.2 权重受 gated 约束
这是第一个门槛。HF 模型元数据显示访问状态为 "gated": "auto",意味着下载前必须先同意官方条款。GitHub README 亦明确:“You need to agree to the terms to access the models.”(你需要同意条款才能访问模型)。获取流程为:
- 在 HF 页面登录并同意条款;
- 生成一个 HuggingFace read-only token;
- 配置环境变量
export HF_TOKEN=<你的只读令牌>; - 再执行下载。若未设令牌,会报错:
ValueError: We have no connection or you passed local_files_only, so force_download is not an accepted option.
结论:权重不是点开即下的全开放资源,而是需要账户与条款同意的 gated 资源。
6.3 许可双口径:apache-2.0 vs research-only
这是最容易被误读的一点。存在两个并存的官方口径:
口径一(技术性 license tag):
- HF 模型卡标注
license: apache-2.0; - HF API 元数据 cardData.license 亦为
apache-2.0; - GitHub 模型家族表将 GigaPath 列为 Apache-2.0。
口径二(官方意图声明,GitHub “Model Uses”):
- Intended Use:数据、代码与模型检查点仅限用于(I)病理基础模型的未来研究、(II)复现论文实验结果;
- Out-of-Scope:任何部署用途——商业或其他——均超出范围,明确 for research use only;
- Usage Notices:模型不得作为医疗器械、临床支持、诊断工具等,用于疾病的诊断、治疗、缓解或预防;用户须自行评估并验证输出后才可考虑任何临床用途(而临床用途本身已被禁止)。
如何理解:apache-2.0 是一个平台层面的技术性标签,描述代码/权重的分发许可形式;而官方 Model Uses / Usage Notices 是用途层面的实质性约束,明确划定了"只研究、不部署、不上临床"的边界。二者并存时,检索者应以官方用途声明为准——法律上或许宽松,意图上明确受限。本条目不做法律认定,只如实并陈两个口径。
6.4 数据获取:全量不可得
第二个门槛在数据侧:
- 原始 Prov-Path 全量 171,189 张 WSI 不公开:受患者隐私与 IRB 约束,语料留在 Providence 内部;
- 仅提供去标识化小样本子集:GitHub README 提供"a sample de-identified subset of the Prov-Path data"的下载链接([1][2]);
- 评测用 TCGA 数据:TCGA 本身是公开数据,可另行获取。
也就是说,检索者可以拿到模型权重(经条款同意)和小样本,但拿不到构成该模型的全部数据。这与"开放数据集"有本质区别。
6.5 资产与门槛总表
| 资产 | 可获取性 | 门槛 |
|---|---|---|
| 模型权重(GigaPath) | 可获取 | 需同意 HF 条款 + 配置 HF_TOKEN |
| 模型权重(GigaPath-Flash) | 可获取 | 同上 |
| 代码 | 可获取 | 公开仓库 |
| 微调脚本与文档 | 可获取 | 公开仓库 |
| PCam 预抽取 embedding(~2GB) | 可获取 | 公开下载 |
| PANDA 预抽取 embedding(~32GB) | 可获取 | 公开下载 |
| Prov-Path 去标识化小样本 | 可获取 | GitHub 提供链接 |
| Prov-Path 全量(171,189 WSI) | 不可获取 | 受 IRB/隐私约束 |
| 临床/商业部署权 | 不可用 | 官方 research-only 明令禁止 |
6.6 使用前必须知道的三条红线
- 不得上临床:模型不得用于诊断、治疗等任何临床决策;
- 不得部署:任何部署用途(含商业)均超出许可范围;
- 需自行验证:官方明示用户对模型输出负全部审查与验证责任。
6.7 版本链与权重文件构成
权重文件(HF 仓):
- 图块编码器:
config.json+pytorch_model.bin(timm 格式); - 切片编码器:
slide_encoder.pth({"model": ...},仅 encoder,无 decoder); - 示例数据:
sample_data/PROV-000-000001.ndpi。
HF 仓存储:约 9,849,491,991 字节(约 9.85 GB);下载量 43,412、likes 204(HF 元数据)。
家族版本链:GigaPath(2024)→ GigaPath-Flash(2026)→ GigaTIME(2026)→ GigaTIME-Flash(2026),四者均标 Apache-2.0,均受同样的 research-only 用途声明约束。
6.8 在库内"可获取性光谱"中的位置
把 Prov-GigaPath 放进千方病案医数集里各条目的可获取性光谱,可更清楚它的特殊性。库内条目大致分几档:
| 档位 | 典型特征 | 代表条目(示意) |
|---|---|---|
| 完全开放 | 直链下载、宽松许可 | 多数 CC-BY 公开数据集 |
| 注册开放 | 需注册/签 DUA 后下载 | 部分临床数据集 |
| 请求制 | 需向作者申请、逐案审批 | PANDA-PLUS 的注释掩码 |
| 受限开放权重 | 权重公开但 gated + 用途限定 | Prov-GigaPath(本条目) |
| 不公开 | 数据留在机构内部 | Providence 内部数据 |
Prov-GigaPath 落在**“受限开放权重”**这一档:它不是最开放的,也不是完全封闭的。检索者若按"完全开放"预期去用,会在 gated 与 research-only 两处碰壁;若按"不公开"预期,则又低估了它实际可获取的部分(权重 + 小样本 + 微调示例)。准确理解它处在光谱的哪一档,是用好它的前提。
6.9 许可条款的实操细读
逐条拆解 GitHub “Usage and License Notices” 的约束,便于检索者对照自身场景:
- “solely for (I) future research… (II) reproducibility”:用途被限定为两件具体的事——未来研究、复现论文。凡不落在这两件事内的用法,都不在许可意图内;
- “Any deployed use case… commercial or otherwise is out of scope”:注意"or otherwise"——不仅商业部署被排除,任何部署都被排除。这意味着即便非营利机构想把模型嵌入产品,也超出范围;
- “not intended or made available for clinical use as a medical device…”:临床用途被逐项点名排除,包括诊断、治愈、缓解、治疗、预防;
- “All users are responsible for reviewing the output”:即便在许可范围内使用,用户也需对输出负全部审查与验证责任——不存在"开箱可信"的默认假设。
这四条合起来,划出了一个窄而清晰的研究用途区间。Prov-GigaPath 的开放,是"对研究者开放",而非"对所有人开放所有用途"。
6.10 与"完全封闭"和"完全开放"两种极端模型的对照
为凸显 Prov-GigaPath 的定位,可与两种极端模型对照:
- 完全封闭模型:数据、权重、代码一律不公开,仅发表论文。此类模型无法被独立复现或验证,学术价值受限于"信任作者";
- 完全开放模型:数据、权重、代码全公开且许可宽松,任何人可自由使用(含商业)。此类模型罕见,因为医疗数据几乎不可能全量公开;
- Prov-GigaPath(中间态):代码与文档全开、权重 gated 开放、用途严格限定、全量数据不公开。它在"可复现性"与"隐私/合规"之间取了折中。
这一中间态很可能是医疗 AI 基础模型在可预见的未来会持续采用的发布方式——既不甘于完全封闭而丧失学术影响,也无法完全开放而突破隐私与责任约束。Prov-GigaPath 是这一范式的标志性样本之一。
§7 生态与影响
7.1 机构协作模式
Prov-GigaPath 是产业—医疗—学术三边协作的产物:
- Microsoft Research(微软研究院):提供模型架构与训练方法论(LongNet、DINOv2 等技术积累);
- Providence:提供真实世界数据与临床场景(28 个肿瘤中心、逾 3 万患者);
- University of Washington(华盛顿大学):学术侧参与(Sheng Wang 等)。
这一模式的关键在于数据与算力/方法论的互补:微软有模型与工程能力但缺真实临床数据,Providence 有海量真实数据但缺大模型训练经验。Providence 首席分析与研究官 Ari Robicsek 博士在新闻稿中表示,该合作解决了此前计算病理模型难以临床化的三大障碍——真实世界数据短缺、无法纳入整片建模、可及性不足。
7.2 对计算病理领域的影响
Prov-GigaPath 的影响主要在三方面:
- 证明"整片建模"可行:把数万图块的 gigapixel 切片作为整体序列建模,从架构上打破了下采样局部图块的惯常妥协;
- 证明"真实世界数据"的价值:在 TCGA 任务上反超用 TCGA 预训练的 REMEDIS,佐证规模化的真实世界数据优于单一公开数据集;
- 树立"开放权重"范式:虽受 research-only 约束,但权重公开本身降低了病理基础模型的研究门槛。
7.3 衍生与应用方向
据官方描述,Providence 计划将模型用于:
- 预测可操作的癌症驱动基因突变,以缓解精准肿瘤学的社会经济可及性差距;
- 肿瘤微环境刻画,辅助大型多组学空间生物学数据集的反卷积。
更广的下游设想包括肿瘤诊断与预后,例如辅助临床医生选择治疗方案。但需强调:这些均为研究愿景,官方的 research-only 声明明确禁止任何部署或临床用途。
7.4 与前作的技术谱系
Prov-GigaPath 站在几个关键技术之上:
| 技术 | 作用 | 出处 |
|---|---|---|
| LongNet | 膨胀自注意力,支持百万级 token 长序列 | 微软此前工作 |
| DINOv2 | 图像自监督预训练框架 | Meta |
| MAE(掩码自编码器) | 整片级自监督预训练 | 通用视觉方法 |
| timm | 模型实现库 | 开源生态 |
| TorchScale | 大规模 Transformer 训练 | 微软 |
论文作者在致谢中明确感谢 DINOv2、MAE、timm、TorchScale 等上游项目。
7.5 开放科研的边界张力
Prov-GigaPath 折射出一个值得记录的张力:医疗 AI 基础模型既想"开放"以推动研究,又受隐私、责任与合规约束必须"受限"。它的解法是"分层开放"——代码与小样本全开、权重 gated 开放、用途严格限定、全量数据不公开。这一模式可能成为后续医疗基础模型发布的一个参考范式。
7.6 对病理信息化基础设施的影响
Prov-GigaPath 的整片建模路线,对病理科的信息化基础设施提出新要求:
- 存储:全量 171,189 张 WSI 的存储需求巨大(每张 gigapixel 级),单是预抽取的 PANDA embedding 就有 32GB——大规模病理 AI 落地需要配套的存储与传输能力;
- 算力:切片级推理需 GPU,且长序列模型对显存要求高——这也是 GigaPath-Flash 这类轻量变体出现的动因;
- 切图管线:把 WSI 切成数万图块并记录坐标,本身是一条独立的工程管线,官方为此专门发布了 WSI 预处理指南;
- 隐私与合规:真实世界病理数据的可用性受 IRB 与隐私法规约束,跨机构数据共享需要合规框架支撑。
这些要求说明:病理基础模型的落地不只是模型问题,更是数据基础设施问题。
§8 方法学启示
8.1 序列长度是数字病理的架构分水岭
Prov-GigaPath 最本质的启示是:在数字病理中,能否处理超长序列决定了模型能否看到全局。传统模型因二次复杂度被迫下采样,本质是"看不见整张切片";LongNet 的膨胀自注意力第一次让"看遍 7 万图块"在工程上可行。这提示后续工作:长上下文能力是病理基础模型的核心竞争维度。
8.2 真实世界数据 > 单一公开数据集
EGFR 突变预测中,未使用 TCGA 预训练的 Prov-GigaPath 反超使用 TCGA 预训练的 REMEDIS(AUROC +23.5%、AUPRC +66.4%),是一则有力的经验证据:规模化的真实世界数据,其泛化价值可能高于单一、精选的公开数据集。这挑战了"公开数据集预训练即可"的惯常假设。
8.3 分层开放是医疗模型的现实解
面对"开放 vs 受限"的两难,Prov-GigaPath 用分级开放给出了一个折中:代码全开、权重受限开放、全量数据不公开、用途严格限定。这一模式承认了医疗数据的特殊性,同时保留了研究可及性,值得后续医疗基础模型参考。
8.4 自监督预训练是消化海量病理图块的前提
13 亿图块无法逐块标注。Prov-GigaPath 全程依赖自监督(DINOv2 + MAE),无需人工标签即可消化超大规模语料。这是它能"吃得下"这么大数据量的根本前提——任何依赖人工标注的路线都难以在 13 亿规模上成立。
§9 与库内条目的关系
Prov-GigaPath 在本库中属于病理基础模型这一脉络,与多个病理数据/模型条目构成上下游或同域关系。
9.1 家族与同域图谱
| 库内条目 | rid(参考) | 与 Prov-GigaPath 的关系 |
|---|---|---|
| panda-plus | 640 | PANDA 升级版;Prov-GigaPath 官方切片级微调示例 |
| panda | 27 / 560 | 前列腺癌分级 WSI;官方切片级微调示例 |
| pcam | 158 | PatchCamelyon;官方图块级线性探测示例 |
| tcga | 25 / 566 | Prov-GigaPath 评测所用外部数据源 |
| pathvqa | 260 | 病理视觉问答;同域视觉-语言方向 |
| digestpath | 338 | 消化病理分割;同域下游任务 |
| unitopatho | 701 | 病理 WSI 分类数据集;同域 |
| compas-gi-histopathology | 988 | 胃肠病理;同域 |
| prostate-cnb-wsi | 969 | 前列腺穿刺 WSI;同域 |
| bonemarrow-wsi | 901 | 骨髓 WSI;同域 |
| luad-histoseg | 861 | 肺腺癌组织分割;同域 |
| pathseg | 970 | 病理分割;同域 |
注:库内 panda(rid 27 与 560)、tcga(rid 25 与 566)存在重复 url_name。真实在架 rid 须以
status=1 AND del_sign=0复核为准,本表 rid 仅供主会话回填参考(R018 纪律)。
9.2 检索路径建议
- 想找"病理基础模型":Prov-GigaPath → HIPT(若有)→ CtransPath(若有)→ 与库内病理数据集互链;
- 想找"前列腺癌 WSI":Prov-GigaPath(微调示例)→ panda-plus(640)→ panda(27/560)→ prostate-cnb-wsi(969);
- 想找"病理图块分类":Prov-GigaPath(tile encoder)→ pcam(158);
- 想找"病理视觉-语言":Prov-GigaPath(视觉-语言扩展)→ pathvqa(260)。
9.3 本文与正文 relatedLink 说明
按 R012/R018 纪律,本条目 frontmatter 的 relatedLink 一律使用占位 URL(.../<slug>/0),不在 frontmatter 写任何中文说明文字或猜测的 rid;上表中的 rid 仅作正文参考,真实互链由主会话在入库后按 status=1 AND del_sign=0 复核回填。
§10 避坑清单:已被检索者与开发者踩过的坑
坑 1:把"open-weight"等同于"可自由使用"
Prov-GigaPath 常被称为 open-weight 模型,HF 模型卡也标 apache-2.0,极易让人以为可自由商用。但官方 Model Uses 明确 research use only、禁止任何部署(含商业)与临床用途。仅看 license tag 会踩坑——务必同时读 GitHub 的 “Model Uses” 段。
坑 2:忽略 gated 下载门槛
权重不是点开即下。HF 为 gated: "auto",须先同意条款并配置 HF_TOKEN。未设令牌直接跑下载会报 ValueError: We have no connection...,容易被误判为网络问题,实为未授权。
坑 3:以为能拿到完整预训练数据
Prov-Path 全量 171,189 张 WSI 不公开,GitHub 只给去标识化小样本。若研究计划依赖"复现完整预训练语料",会直接受阻。可获取的是模型权重与小样本,不是全量数据。
坑 4:混淆 Prov-GigaPath / GigaPath / Prov-Path 三个名字
- Prov-GigaPath = 完整模型;
- GigaPath = 架构名;
- Prov-Path = 数据集名。
检索时用错名字会找不到对应资源。尤其在 HF 上,模型仓名为 prov-gigapath,数据集名 Prov-Path 却无独立公开仓。
坑 5:把"25/26 SOTA"当作当前绝对排名
该成绩发布于 2024 年,对比基线为 HIPT/CtransPath/REMEDIS。病理基础模型迭代极快,2024 之后涌现大量新模型(如 UNI、Virchow、Phikon 等)。"25/26 SOTA"应按 2024 年发表口径理解,不代表在当前模型中仍居首。
坑 6:忽视评测数据与预训练数据的同源性
26 项任务中相当一部分用 Providence 内部数据,而预训练语料亦来自 Providence。同源评估可能高估泛化能力,读结果时需留意任务数据的来源分布。
坑 7:误用图块级与切片级输出
模型有两级输出:图块编码器给 tile embedding,切片编码器给 slide embedding。若把切片级任务错用图块级特征,或反之,效果会显著下降。正确流水线是"切图 → 图块 embedding → 切片 embedding"。
坑 8:忽略 timm 版本兼容性
GitHub README 特别提示:老版本 timm 有兼容性问题,须 pip install timm>=1.0.3。忽略此点会在加载模型时报兼容错误。
坑 9:把衍生模型当同一模型
GigaPath-Flash(384 维)与原始 GigaPath(768/1536 维)架构规格不同,pretrained checkpoint 不可直接混用。加载 Flash 版须用对应模型名(如 gigapath_slide_enc12l384d)。
坑 10:忘记模型不得作临床决策依据
即便是研究环境,也须记住模型不是医疗器械、输出不构成临床决策依据。任何临床相关的使用设想都已被官方许可明确排除。
§11 总结
11.1 三句话总结
- Prov-GigaPath 是首个在大规模真实世界数据上预训练的整片病理基础模型:171,189 张 WSI、13.8 亿图块、逾 3 万患者、31 大组织类型,26 项任务拿下 25 项 SOTA。
- 它的技术支点是"整片长上下文建模":图块编码器(DINOv2)+ 切片编码器(MAE + LongNet 膨胀自注意力),把数万图块作为一条超长 token 序列整体处理。
- 它的可用性有明确边界:权重虽以 apache-2.0 标注且公开,但受 gated 条款约束、官方明令 research-only、禁止临床与商业部署,且全量数据不公开。
11.2 适合谁
- 研究病理基础模型、长上下文视觉建模的研究者;
- 需要在 WSI 级做特征的肿瘤精准医学团队;
- 想基于大模型做病理下游微调(如 PANDA/PCam)的开发者;
- 研究"真实世界数据 vs 公开数据集"泛化差异的方法学者。
11.3 不适合谁
- 想直接商用部署病理诊断产品的团队(许可禁止);
- 想上临床辅助诊断的机构(许可禁止);
- 想获取完整预训练语料复现 pretraining 的研究者(数据不公开);
- 只想"点开即下"、不愿走 HF 条款流程的用户(受 gated 约束)。
11.4 30 秒决策卡
| 你的需求 | 结论 |
|---|---|
| 研究病理基础模型 | ✅ 适合(注意 research-only) |
| 做下游微调实验 | ✅ 适合(有 PANDA/PCam 示例) |
| 获取全部预训练数据 | ❌ 不可得 |
| 商用/临床部署 | ❌ 许可禁止 |
| 零成本直接下载权重 | ⚠️ 需先过 HF 条款门槛 |
| 追求当前最新 SOTA 排名 | ⚠️ 2024 年口径,需另行比对新模型 |
§12 DAIMS 评估表
DAIMS(Dataset AI-Readiness Maturity Score)从多维度评估条目/数据集的 AI-Ready 成熟度。
| 维度 | 评分 | 说明 |
|---|---|---|
| 可发现性(Discoverability) | 5/5 | Nature 论文 + GitHub + HuggingFace 三通道齐全,文献索引充分 |
| 可访问性(Accessibility) | 2/5 | 权重受 gated 约束需同意条款;全量数据不公开,仅小样本可下 |
| 文档完备度(Documentation) | 5/5 | README、论文、预处理指南、demo notebook、微调脚本齐备 |
| 数据质量(Data Quality) | 4/5 | 真实世界多机构数据,规模巨大;但存在来源集中与分布偏斜 |
| 标注丰富度(Annotation Richness) | 4/5 | 携带组织学发现、分期、突变谱、病理报告等多层级信息 |
| 互操作性(Interoperability) | 4/5 | 基于 timm/PyTorch 生态,权重格式标准;WSI 需自行切图 |
| 可复现性(Reproducibility) | 3/5 | 有公开微调示例与预抽取 embedding;但全量预训练语料不可得,完全复现困难 |
| 许可清晰度(License Clarity) | 2/5 | 存在 apache-2.0 与 research-only 双口径,检索者易误读 |
| 可用性限制(Usability) | 2/5 | 明确禁止部署与临床用途,实际可用场景被严格限定在研究 |
| 可维护性(Maintainability) | 5/5 | 2024-2026 持续更新,发布 Flash/GigaTIME 衍生版本 |
| 综合 | 3.6/5 | 技术成熟度高、文档与发现性极佳,但访问门槛与许可限制显著拉低实际可用性 |
评分说明:三个 5/5 维度(可发现性、文档完备度、可维护性)反映 Prov-GigaPath 作为研究资源的成熟度——论文、代码、文档、后续版本一应俱全。而三个低分维度(可访问性 2/5、许可清晰度 2/5、可用性限制 2/5)指向同一个现实:它在"能发现、能读懂、能维护"上近乎满分,却在"能方便地、合法地、广泛地用"上明显受限。这一"高低分并存"的分布,本身就是"受限开放权重"这一形态的量化画像。
综合分的解读:3.6/5 意味着它是优秀的研究工具,但不是即取即用的通用资源。检索者应据自身目的取舍——以研究为目的者,实际体验远高于 3.6;以部署为目的者,实际可用性远低于 3.6。
FAQ(高频问答)
A. 基础认知
Q:Prov-GigaPath 是数据集还是模型?
两者兼有。它是模型(GigaPath 架构 + 预训练权重),其预训练数据叫 Prov-Path。文档与讨论中常混用,但严格说模型名 Prov-GigaPath、数据名 Prov-Path。
Q:为什么叫 “GigaPath”?
"Giga-"指 gigapixel(十亿像素级)切片,"Path"指 pathology(病理)。
Q:它和 GPT 类的"基础模型"是一回事吗?
理念相通(大规模预训练 + 可迁移表示),但模态不同:GigaPath 是视觉基础模型,输入是病理图像,不是文本。
Q:谁开发的?
微软研究院 + Providence(美国医疗系统)+ 华盛顿大学三方合作。
Q:发表在哪?
Nature,2024 年 630 卷 8015 期,181-188 页,DOI: 10.1038/s41586-024-07441-w。
B. 数据与规模
Q:具体用了多少数据?
171,189 张全片病理图像,1,384,860,229 个 256×256 图块(约 13 亿),逾 30,000 名患者,31 大组织类型,28 个肿瘤中心。
Q:和 TCGA 差多少?
图块数 5 倍以上,患者数 2 倍以上。
Q:数据从哪来?
Providence 医疗系统的真实临床活检与切除标本切片,含 H&E 与 IHC 染色。
Q:数据会公开吗?
全量不公开(隐私 + IRB 约束),仅 GitHub 提供去标识化小样本子集。
Q:单张切片最多多少图块?
Providence 数据中最多 70,121 个。
C. 技术架构
Q:模型分几级?
两级:图块编码器(局部)+ 切片编码器(全局)。
Q:核心技术是什么?
改编自 LongNet 的膨胀自注意力,用于超长序列(数万图块)建模。
Q:预训练方法?
两阶段自监督:先 DINOv2 做图块级,再 MAE + LongNet 做切片级。
Q:原始切片编码器多大?
12 层、768 维隐层,输入图块 embedding 1536 维。
Q:有轻量版吗?
有,GigaPath-Flash:12 层 / 384 维(约 21M 参数)+ DINOv2-small 图块编码器(约 22M 参数)。
D. 性能与评测
Q:成绩如何?
26 项任务 25 项 SOTA,18 项显著超越次优。
Q:和谁比?
HIPT、CtransPath、REMEDIS。
Q:最亮眼的结果?
TCGA 上 EGFR 突变预测,AUROC +23.5%、AUPRC +66.4%(对比 REMEDIS)。
Q:能零样本用吗?
视觉-语言扩展后,零样本分型与突变预测可达 SOTA。
Q:SOTA 是最新排名吗?
不是。这是 2024 年论文口径,后续新模型未纳入对比。
E. 获取与许可
Q:怎么下载权重?
HF 页面同意条款 → 生成 read-only token → export HF_TOKEN=... → 下载。
Q:能商用吗?
不能。官方 research-only,禁止任何部署(含商业)。
Q:能上临床吗?
不能。明确禁止作为医疗器械/诊断工具。
Q:license 到底是什么?
存在双口径:HF 标 apache-2.0(技术性 tag),官方 Model Uses 标 research-only(用途约束)。以用途声明为准。
Q:数据能全拿到吗?
不能,只有去标识化小样本。
F. 工程与复现
Q:对硬件什么要求?
官方示例基于 NVIDIA A100。切片级推理需 GPU。
Q:如何加载图块编码器?
timm.create_model("hf_hub:prov-gigapath/prov-gigapath", pretrained=True)。
Q:如何加载切片编码器?
gigapath.slide_encoder.create_model("hf_hub:prov-gigapath/prov-gigapath", "gigapath_slide_enc12l768d", 1536)。
Q:timm 版本有要求吗?
有,需 timm>=1.0.3。
Q:有现成 embedding 吗?
有,PCam(约 2GB)与 PANDA(约 32GB)的预抽取 embedding 可下载。
Q:切片级推理流程?
切图 → 图块 embedding + 坐标 → 切片编码器 → 切片 embedding。
G. 生态与边界
Q:有什么衍生模型?
GigaPath-Flash、GigaTIME、GigaTIME-Flash。
Q:谁来维护?
微软与 Providence 团队,2024 年起持续更新。
Q:适合入门吗?
适合有病理基础或大模型背景的研究者;纯入门者有理解门槛。
Q:最大的局限是什么?
可用性受限:数据不完全公开、用途限研究、需过 gated 门槛。
Q:一句话概括?
技术上把病理基础模型推进到整片长上下文,可用性上却被 research-only 与 gated 双重框定的研究型开放权重模型。
H. 与同类模型比较
Q:和 UNI、Virchow、Phikon 等新模型比呢?
这些是 2024 年之后出现的病理基础模型,多数为图块级;Prov-GigaPath 的差异化在于整片级长上下文建模。具体性能需以各自论文口径分别比较,本条目不作跨模型绝对排名。
Q:它和 HIPT 最大的区别?
HIPT 是层级式(先块后区域再整片),Prov-GigaPath 用 LongNet 直接处理超长序列,在整片上下文的完整性上更进一步。
Q:GigaTIME 和它什么关系?
GigaTIME 是 GigaPath 家族的衍生模型,专注从 H&E 预测空间蛋白组,非同一模型。
Q:为什么它被认为重要?
因为它是首个在大规模真实世界数据上做整片预训练的病理基础模型,且在手握 TGCA 的对手面前反超,证明了"真实世界数据 + 整片建模"的路线价值。
Q:它的短板是什么?
三处:数据不公开、用途受限、评测同源。三者都指向同一个核心——可用性与泛化验证的边界。
事实清单(硬事实)
- 论文标题:A whole-slide foundation model for digital pathology from real-world data
- 发表期刊:Nature,2024,630 卷 8015 期,181-188 页
- DOI:10.1038/s41586-024-07441-w
- PMID:38778098
- 在线发表:2024-05-22;正式卷期:2024-06
- 共同一作:Hanwen Xu、Naoto Usuyama
- 通讯作者(末位):Hoifung Poon、Sheng Wang
- 合作机构:Microsoft Research + Providence + University of Washington
- 预训练语料名:Prov-Path
- 全片病理图像数:171,189 张
- 图像图块总数:1,384,860,229 个(约 13 亿)
- 图块尺寸:256 × 256 像素
- 患者数:逾 30,000 名
- 组织类型:31 大主要组织类型
- 肿瘤中心数:28 个
- 染色类型:H&E + IHC
- 单张切片最大图块数:70,121 个
- 相对 TCGA:图块数 >5 倍、患者数 >2 倍
- 评测任务总数:26 项(9 分型 + 17 病理组学)
- SOTA 数:26 项中 25 项
- 显著超越次优:18 项
- 对比基线:HIPT、CtransPath、REMEDIS
- EGFR 突变预测提升:AUROC +23.5%、AUPRC +66.4%
- 分型任务:9 个癌种全部超越其他模型,6 个显著
- 图块编码器框架:DINOv2
- 切片编码器框架:MAE + LongNet
- 原始切片编码器规模:12 层 / 768 维,输入 1536 维
- 图块编码器发布格式:config.json + pytorch_model.bin(timm)
- 切片编码器发布格式:slide_encoder.pth(仅 encoder)
- HF 模型仓:prov-gigapath/prov-gigapath
- HF gated 状态:auto(需同意条款)
- HF 标注 license:apache-2.0
- 官方用途声明:research use only,禁止部署与临床
- HF 仓创建时间:2024-05-20
- HF 仓最后更新:2026-08-07
- HF 仓存储:约 9.85 GB(9,849,491,991 字节)
- HF 下载量:43,412;likes:204
- 全量数据获取:不公开,仅去标识化小样本
- 微调示例:PCam(图块级)、PANDA(切片级)
- 预抽取 embedding:PCam 约 2GB、PANDA 约 32GB
- 衍生模型:GigaPath-Flash、GigaTIME、GigaTIME-Flash
- GigaPath-Flash 规格:12 层 / 384 维(约 21M 参数)+ DINOv2-small(约 22M 参数)
- 示例 WSI 文件:sample_data/PROV-000-000001.ndpi
- 依赖库提示:timm>=1.0.3
- 计算环境:Providence 租户内,经 Providence IRB 批准
- 官方新闻稿日期:2024-05-22
- GigaTIME 发布:2025-12
- GigaPath-Flash 发布:2026-07(arXiv:2607.18218)
术语表
| 术语 | 英文 | 释义 |
|---|---|---|
| 全片病理图像 | Whole-Slide Image (WSI) | 病理玻片经扫描得到的 gigapixel 级数字图像 |
| 图块 | Tile / Patch | WSI 切分出的小图像块,本条目为 256×256 像素 |
| 图块编码器 | Tile Encoder | 把单个图块编码为 embedding 的模型组件 |
| 切片编码器 | Slide Encoder | 把图块 embedding 序列编码为切片级表示的组件 |
| 基础模型 | Foundation Model | 大规模预训练、可迁移到多任务的通用模型 |
| 自监督学习 | Self-Supervised Learning | 无需人工标注、从数据自身构造监督信号的预训练 |
| 膨胀自注意力 | Dilated Self-Attention | LongNet 的核心机制,可高效处理超长序列 |
| 掩码自编码器 | Masked Autoencoder (MAE) | 遮盖部分输入并重建的自监督预训练方法 |
| DINOv2 | DINOv2 | 强图像自监督学习框架 |
| LongNet | LongNet | 微软提出的长序列 Transformer 方法 |
| 癌症分型 | Cancer Subtyping | 判定肿瘤亚型(如腺癌/鳞癌)的任务 |
| 病理组学 | Pathomics | 从病理图像提取可量化特征的任务群 |
| 突变预测 | Mutation Prediction | 从图像预测基因组突变(如 EGFR)的任务 |
| 零样本 | Zero-Shot | 无需针对目标任务微调即可预测 |
| 视觉-语言 | Vision-Language | 图像与文本联合建模 |
| AUROC | AUROC | 受试者工作特征曲线下面积,分类性能指标 |
| AUPRC | AUPRC | 精确率-召回率曲线下面积,类别不平衡时更敏感 |
| H&E | Hematoxylin and Eosin | 苏木精-伊红染色,病理最常用染色 |
| IHC | Immunohistochemistry | 免疫组化染色 |
| 开放权重 | Open-Weight | 公开模型权重的发布方式 |
| 受限访问 | Gated | 需同意条款/授权才能下载的访问模式 |
| 机构审查委员会 | IRB | Institutional Review Board,研究伦理审查机构 |
| 癌症分期 | Cancer Staging | 描述肿瘤进展程度的临床分类 |
| 肿瘤微环境 | Tumor Microenvironment | 肿瘤周围的细胞与结构环境 |
| gigapixel | gigapixel | 十亿像素级 |
| embedding | embedding | 稠密向量表示 |
| 线性探测 | Linear Probing | 冻结主干、仅训练线性分类头的评估方法 |
| 微调 | Fine-tuning | 在预训练模型上针对下游任务继续训练 |
| SOTA | State-of-the-Art | 当前最优性能 |
| TCGA | The Cancer Genome Atlas | 大型公开癌症基因组数据集 |
附录
附录 A:条目信息速查卡
| 项目 | 内容 |
|---|---|
| 条目标题 | Prov-GigaPath |
| slug | prov-gigapath |
| 类型 | 病理基础模型(全片级) |
| 开发方 | Microsoft Research + Providence + UW |
| 发表 | Nature 2024;630:181-188 |
| DOI | 10.1038/s41586-024-07441-w |
| 数据规模 | 171,189 WSI / 1,384,860,229 tiles / >30,000 患者 |
| 架构 | tile encoder(DINOv2)+ slide encoder(MAE + LongNet) |
| 性能 | 26 任务 25 SOTA |
| 许可 | apache-2.0(HF tag)↔ research-only(官方用途声明) |
| 获取 | HF gated + GitHub;全量数据不公开 |
附录 B:DAIMS 评估全表
见 §12。综合评分 3.6/5——技术成熟度与文档发现性极高,但可访问性、许可清晰度、可用性限制三项显著偏低。
附录 C:逐项证据链自证
| 硬事实 | 来源 |
|---|---|
| 171,189 WSI / 1.3B tiles / >30,000 患者 / 31 组织 / 28 中心 | Nature 摘要 + Providence 官方新闻稿 + go.nature.com 摘要页 |
| 1,384,860,229 tiles(精确) | go.nature.com 摘要页(Nature 正文) |
| 单张最多 70,121 tiles | go.nature.com 摘要页 |
| 26 任务 / 25 SOTA / 18 显著 | Nature 摘要 + Providence 新闻稿 |
| EGFR AUROC +23.5% / AUPRC +66.4% | go.nature.com 摘要页 |
| 架构(DINOv2 + MAE + LongNet) | go.nature.com 摘要页 + GitHub README |
| license apache-2.0 + gated auto | HF API 元数据(hf-mirror 镜像) |
| research-only / 禁止部署 | GitHub README “Model Uses” |
| 权重文件构成 + 存储 9.85GB | HF API 元数据 + GitHub README |
| GigaPath-Flash 规格 | GitHub README |
| 时间线 | GitHub README News + HF 元数据 |
附录 D:数据获取决策树
想用 Prov-GigaPath?
├── 目的:研究 / 复现论文?
│   ├── 只想要权重 → HF 同意条款 + HF_TOKEN → 下载 ✅
│   ├── 想要微调示例 → 下载 PCam/PANDA 预抽取 embedding ✅
│   └── 想要全量预训练数据 → 不可得 ❌(仅小样本)
├── 目的:商用部署? → ❌ 官方 research-only 禁止
└── 目的:临床诊断? → ❌ 明确禁止作医疗器械/诊断工具
附录 E:两级推理流水线骨架
# 1. 切图:把 WSI 切成 256x256 图块 + 记录坐标
#    (用官方 WSI 预处理指南)

# 2. 图块编码器
import timm
from PIL import Image
from torchvision import transforms
import torch

tile_encoder = timm.create_model(
    "hf_hub:prov-gigapath/prov-gigapath", pretrained=True
)  # timm>=1.0.3

transform = transforms.Compose([
    transforms.Resize(256, interpolation=transforms.InterpolationMode.BICUBIC),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=(0.485, 0.456, 0.406),
                         std=(0.229, 0.224, 0.225)),
])
img = Image.open("path/to/tile.png").convert("RGB")
x = transform(img).unsqueeze(0)
tile_encoder.eval()
with torch.no_grad():
    tile_embed = tile_encoder(x)

# 3. 切片编码器
import gigapath
slide_encoder = gigapath.slide_encoder.create_model(
    "hf_hub:prov-gigapath/prov-gigapath",
    "gigapath_slide_enc12l768d",
    1536,
)
slide_encoder.eval()
with torch.no_grad():
    slide_embed = slide_encoder(tile_embed, coordinates)
附录 F:关键来源 URL
| 资源 | URL |
|---|---|
| Nature 论文 | https://doi.org/10.1038/s41586-024-07441-w |
| Nature 摘要页 | https://go.nature.com/4dTG4cc |
| GitHub | https://github.com/prov-gigapath/prov-gigapath |
| HuggingFace 模型 | https://huggingface.co/prov-gigapath/prov-gigapath |
| Providence 新闻稿 | https://www.providence.org/news/uf/687638000 |
附录 G:双口径存照清单
- license 双口径:HF 标
apache-2.0↔ 官方 Model Uses 标 research-only、禁部署。以用途声明为实质约束。 - tile 数双口径:新闻/摘要「约 13 亿 / 1.3 billion」↔ 全文精确「1,384,860,229」。
- 机构归属:候选情报称"微软 + Providence";实核为 Microsoft + Providence + University of Washington 三方。
附录 H:遗留疑点
- Nature 正文页被反爬拦截,核心数字经 go.nature.com 摘要页 + Providence 新闻稿 + 引文库三方互证,未直接抓取 nature.com HTML。
- HF 原站被沙箱封锁,模型卡 license/gated 字段经 hf-mirror API 元数据获取;README 细节经 GitHub 获取。
- Prov-Path 小样本下载链接有效性未逐一实测(网络预算所限)。
- GigaTIME(Cell 2026)与 GigaPath-Flash(arXiv:2607.18218)论文细节未逐一核验,仅作版本链说明。
附录 I:许可条款原文要点(英文摘录,供核对)
- “The data, code, and model checkpoints are intended to be used solely for (I) future research on pathology foundation models and (II) reproducibility of the experimental results reported in the reference paper.”
- “Any deployed use case of the model — commercial or otherwise — is out of scope.”
- “The model is not intended or made available for clinical use as a medical device, clinical support, diagnostic tool…”
(以上三条为 GitHub README 原文摘录,是本条目"可用性受限"判断的直接依据。)
附录 J:与库内 PANDA/PCam 条目的关系声明
Prov-GigaPath 官方将 PANDA 与 PCam 作为下游微调示例。因此本条目与库内 panda-plus(640)、panda(27/560)、pcam(158)构成"基础模型 → 下游数据集"的上下游关系,而非别名或版本关系。检索者若从 PANDA/PCam 条目出发,应理解它们与 Prov-GigaPath 是不同的独立条目,勿合并。
附录 K:复现路径与常见报错排查
最小复现路径(不下载全量数据):
- 配置环境:NVIDIA GPU + CUDA toolkit;
- 克隆仓库:
git clone https://github.com/prov-gigapath/prov-gigapath; - 建环境:
conda env create -f environment.yaml && conda activate gigapath && pip install -e .; - 取得 HF 访问:同意条款 → 生成 read-only token →
export HF_TOKEN=...; - 下载预抽取 embedding:PCam(~2GB)或 PANDA(~32GB);
- 跑微调脚本:
bash scripts/run_pcam.sh ...或bash scripts/run_panda.sh ...。
常见报错排查表:
| 报错 | 原因 | 处置 |
|---|---|---|
ValueError: We have no connection or you passed local_files_only... |
未配置 HF_TOKEN | 设置环境变量后重试 |
| timm 加载失败/兼容错 | timm 版本过旧 | pip install timm>=1.0.3 |
| 模型名不识别 | 用错架构名 | 原始版用 gigapath_slide_enc12l768d;Flash 版用 gigapath_slide_enc12l384d |
| 显存不足 | 长序列 + 大模型 | 换 GigaPath-Flash(384 维轻量版) |
| 无法下载 WSI 全量 | 数据不公开 | 改用官方小样本或自有 WSI |
附录 L:规模数字换算表(基于硬数字的推算)
| 换算项 | 结果 |
|---|---|
| 每患者平均切片数 | ≈ 5.7 张(171,189 ÷ >30,000) |
| 每切片平均图块数 | ≈ 8,090 个(1,384,860,229 ÷ 171,189) |
| 单切片最大图块数 | 70,121 个 |
| 单图块像素 | 256 × 256 ≈ 65,536 像素 |
| 全语料像素量级 | ≈ 8.6×10¹³ 像素 |
| 相对 TCGA 图块量 | >5 倍 |
| 相对 TCGA 患者量 | >2 倍 |
本表为基于官方硬数字的换算推算,非论文原文表格;引用换算值时请注明为推算。
附录 M:本条目写作与核验记录
| 项目 | 内容 |
|---|---|
| 代理 | agent-a-provgigapa |
| 开工时间 | 2026-10-16T08:59 |
| 查重结论 | CLEAN(DB 0 命中;gate HIT 为自建目录/自派发,已排除) |
| 锁 | writing/prov-gigapath/.lock(自建) |
| 一手来源 | Nature 摘要页(go.nature.com)、Providence 官方新闻稿、GitHub README、HF API 元数据 |
| 网络预算 | WebSearch 1 次、WebFetch 4 次(均在预算内) |
| 双口径 | license(apache-2.0 ↔ research-only)、tile 数(13 亿 ↔ 1,384,860,229)、机构(三方) |
| 遗留疑点 | nature.com/HF 原站被反爬/封锁,经摘要页与镜像元数据互证 |
附录 N:给不同检索者的一句话建议
| 你是谁 | 一句话建议 |
|---|---|
| 病理 AI 研究者 | 值得深入,但先读 GitHub “Model Uses” 再动手 |
| 下游应用开发者 | 只能用于研究,勿规划商用 |
| 临床医生 | 该模型明确禁止临床使用,勿作为诊断依据 |
| 数据集策展人 | 它是"受限开放权重"的标志性样本,可作可获取性光谱的参照 |
| 学生/入门者 | 从 PANDA/PCam 微调示例入手,比直接啃 WSI 流程更快上手 |
附录 O:本条目自检清单
| 检查项 | 状态 |
|---|---|
| 行数 1200-1900 | ✅(见拼接统计) |
| frontmatter 必需字段齐全 | ✅ |
| title 含站点后缀 ` | 千方病案医数集` |
| description ≤170 字符 | ✅ |
| title/subtitle/data_source.name ≤255 字符 | ✅ |
| frontmatter 无双引号裸引号 | ✅(中文强调用「」) |
| schema_org cr:RecordSet 节点式 | ✅ |
| rai:dataLimitations 块式列表 - 前缀 | ✅ |
| YAML safe_load 冒烟 | ✅ |
| check_md 双零 | ✅ |
| preflight 双零 | ✅ |
| DAIMS 表 | ✅(§12) |
| 坑点 ≥5 则 | ✅(§10,共 10 则) |
| 可用性受限如实写清 | ✅(§6 全节 + FAQ E) |
| relatedLink 无中文说明文字 | ✅(正文用占位 URL) |
附录 P:全文结构导航
| 章节 | 主题 |
|---|---|
| §0 | 导读:解决什么问题 |
| §1 | 速览:十问十答 |
| §2 | 数据构成与规格 |
| §3 | 模型架构与技术路线 |
| §4 | 评测基准与性能 |
| §5 | 与相关模型的对比与谱系 |
| §6 | 获取与许可:双口径可用性边界 ★ |
| §7 | 生态与影响 |
| §8 | 方法学启示 |
| §9 | 与库内条目的关系 |
| §10 | 避坑清单(10 则) |
| §11 | 总结 |
| §12 | DAIMS 评估表 |
| FAQ | 高频问答 |
| 附录 | 事实清单 / 术语表 / 附录 A-P |
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- ebhi-seg — 共享标签:病理图像 / 医学图像分割 / 图像分类 / 肿瘤学
- panda-plus — 共享标签:病理图像 / 医学图像分割 / 图像分类 / 肿瘤学
- cric — 共享标签:病理图像 / 医学图像分割 / 图像分类 / 肿瘤学
- prostate-cnb-wsi — 共享标签:病理图像 / 医学图像分割 / 图像分类 / 肿瘤学
- cobra — 共享标签:病理图像 / 医学图像分割 / 图像分类 / 肿瘤学
- pannuke — 共享标签:病理图像 / 医学图像分割 / 肿瘤学
- lizard — 共享标签:病理图像 / 医学图像分割 / 肿瘤学
- ddti — 共享标签:医学图像分割 / 图像分类 / 肿瘤学
- panda — 共享标签:病理图像 / 图像分类 / 肿瘤学
- peso — 共享标签:病理图像 / 医学图像分割 / 肿瘤学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
