乳腺钼靶影像与病灶标注数据集
四体位乳腺钼靶 DICOM 影像,配病灶检出框与像素级分割掩膜,标签按 BI-RADS 术语组织。
致力于为医疗 AI 研究人员找到合适的数据集。已收录 2,043 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。
需要具备完整溯源、伦理合规与工程化交付的专病训练集?进入医疗数据商城 →四体位乳腺钼靶 DICOM 影像,配病灶检出框与像素级分割掩膜,标签按 BI-RADS 术语组织。
液基薄层细胞学(TCT)数字图像,含阴阳性判读结果,适配宫颈癌细胞学筛查模型。
千方医数集支持按病种、模态合规定制采集。
提交定制需求共 1813 个数据集
56,677,795 个实体、1,909,959 条表型注释、23.04 GB 下载:八个模式生物库合并成一个库之后,字段统一了,语义没有
47,424 个官方命名的 HLA 等位基因:从 1998 年的 964 个到今天的超多态体系
CC0 强制的通用数据存储库:2024/25 财年 65,786 个已发布数据集、5,000 万+ 文件、全部 DOI 化
23 个 spike sorter、一个接口,和两次让旧代码全部失效的版本变更
12 个实验室、139 只小鼠、69.9 万次探针插入,拼出一张全脑活动图
它不是一个数据集,是上千个数据集的容器。首页写着一千零五十九个、九百二十二太比特,同一个站的 API 却报九百三十八、一千二百零九;四个官方来源给出四个规模数字。这个库真正值得学的是它怎么把「版本」和「许可」做成硬约束
三家医院、二百七十五名术前监测患者、四万五千小时连续脑电。它比此前所有公开脑电库加起来大两个数量级,却从不免费——按数据集个数分档售卖,两万五千欧元起。这份数据库真正稀缺的不是规模,是把一次发作拆成四个时刻的那种标注方式
一万六千小时的临床脑电里,只有百分之零点二的片段装着发作。为了把这些片段挖出来,一群工程师用关键词、商业软件和自研模型三方交叉筛了一遍,最后留下 675 名患者、1,476 小时、4,029 次发作
一万条初级保健呼吸病例:专家贝叶斯网络采出 16 个表格变量,GPT-4o 据此写出双版本临床笔记(正常版与精简版),再用 LLM 反抽 4.2 万个症状 span——把「表格背景知识能否补文本之不足」变成可复现的对照实验
Google Health 药物知识问答基准——Gemini 1.5 Flash 起草、8 名 board-certified 执业药师修订与五档难度评级,600 道四选一 MCQ(OpenFDA 300 开源 + BNF 300),高难度题 AMIE 准确率反超 21 名初级保健医生,Nature 正刊发表
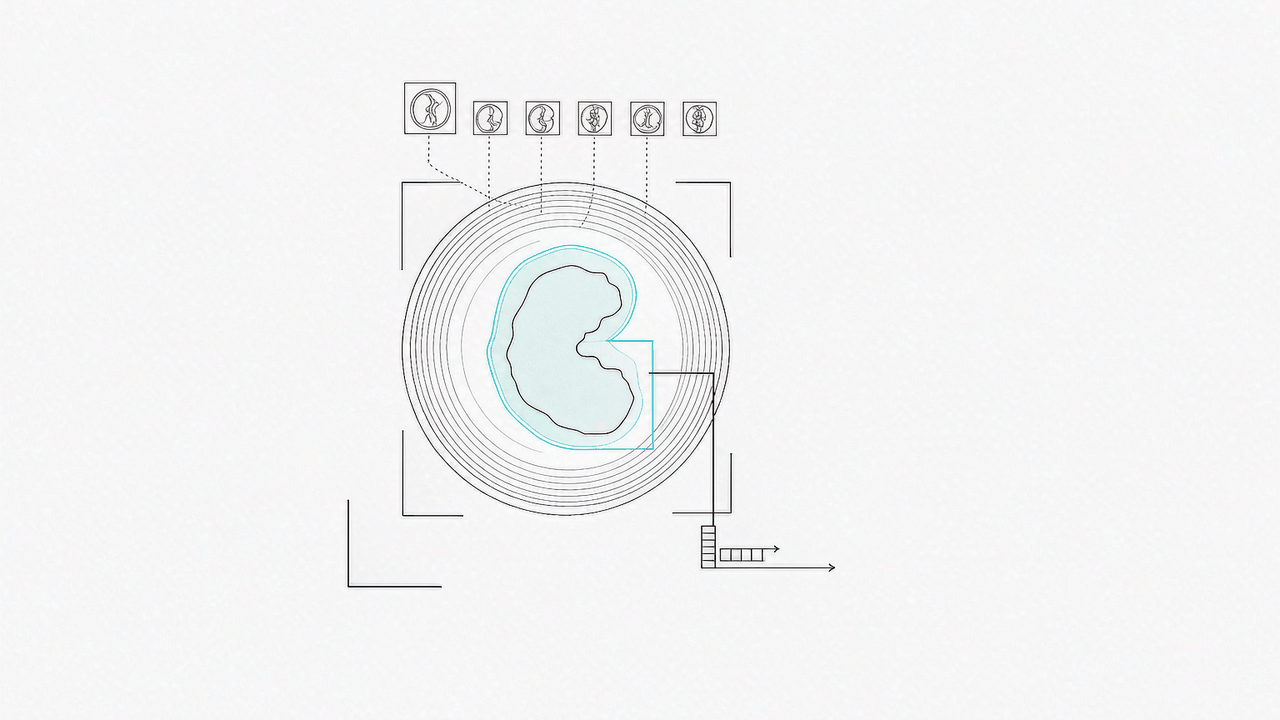
20,335 个病灶 / 7,795 例 CT / 3,793 名患者的病灶级描述、尺寸与 BBox 资源,叠加 2,850 道四选一难负例 QA,NIH 团队 GPT-4 预标+专家终审流水线产出,Kaggle 公开 CC BY-NC-SA 4.0
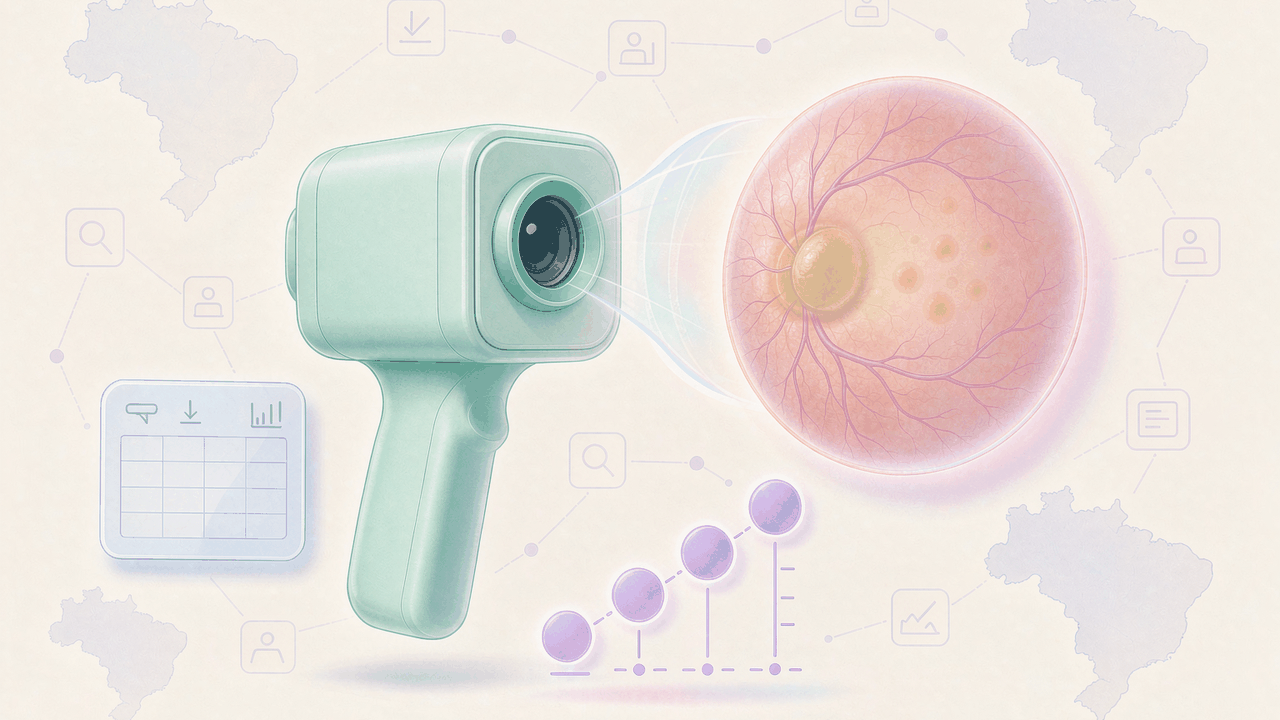
首个用 Phelcom Eyer 手持相机在巴西高负担社区场景采集的糖尿病视网膜病变数据集:5,164 张 / 1,291 名患者,附 ICDR 分级、黄斑水肿、教育/医保公平性标签
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
