乳腺阳性影像数据集
乳腺钼靶阳性病例影像数据,覆盖肿块、钙化等典型征象,面向乳腺 AI 辅助筛查模型训练。
去商城获取 →致力于为医疗 AI 研究人员找到合适的数据集。已收录 1,956 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。
需要具备完整溯源、伦理合规与工程化交付的专病训练集?进入医疗数据商城 →共 844 个数据集
斯坦福团队构建的医疗智能体交互式基准:300 个医生撰写任务 × 100 例去标识化 STARR 患者 × 785,207 条 FHIR 记录 × 9 个检索/开单函数,12 个前沿 LLM 在 pass@1 下最高仅 69.67%,首次把医疗 AI 评测从「静态问答」推向「多轮工具调用」
262 位执业于 60 国的医生手写 48,562 条 rubric 标准,为 5,000 段多轮健康对话逐题打分——OpenAI 用「医生出题、模型评分」把医疗 LLM 评测从选择题推向开放式临床对话,MIT 许可全量公开
NIH Bridge2AI 项目下首个儿科嗓音数据集:300 名 2-18 岁儿童、23,533 段录音的派生音频特征与表型数据;SickKids 单站点采集、年龄分层协议、注册凭证访问(DUA)
圣艾蒂安大学 ENES 团队在产科病房连续高保真录音,用主动学习+集成方法自动抽取 107,312 条哭声序列——迄今全球最大婴儿哭声音频库,CC BY 公开 81 GB,配音 176 个声学描述子,服务神经发育风险早筛
西班牙华亚多利德大学等发布的首个面向儿童步态三模态开放数据集——59 名参与者(CP 22 / ITW 12 / TD 25),Xsens 惯性运动捕捉 + Delsys Trigno 四通道表面肌电 + 三视角视频同步,含治疗前后 T0/T1/T2 纵向随访,Zenodo 公开 CC BY 4.0 直取约 9.5 GB
浙江中医药大学构建的证候辨证综合库:624 证候 / 133,518 处方 / 8,073 疾病 / 8,259 中草药 / 43,413 成分 / 17,602 靶点 / 8,182 药物,深度学习知识图谱 + BM25 证候预测,打通中医证候与西医分子层
中国中医科学院主导、发表于 Scientific Data 的首个中医证候诊断「思维过程」评测基准——300 例专家标注病例、四步推理链、十选项病机证候多选题、CC-BY 4.0 经 figshare 公开,覆盖 GLM/ChatGPT/通义千问/Gemini 四大模型辨证能力横评
6,719 张 D65 标准光源下采集的舌象高清图,20 类病理症状多标签(每图平均 2.54 标签,执业中医师双验证),三种标注格式 + YOLOv5/v7/v8/SSD/MobileNetV2 基准,CC BY 4.0 公开
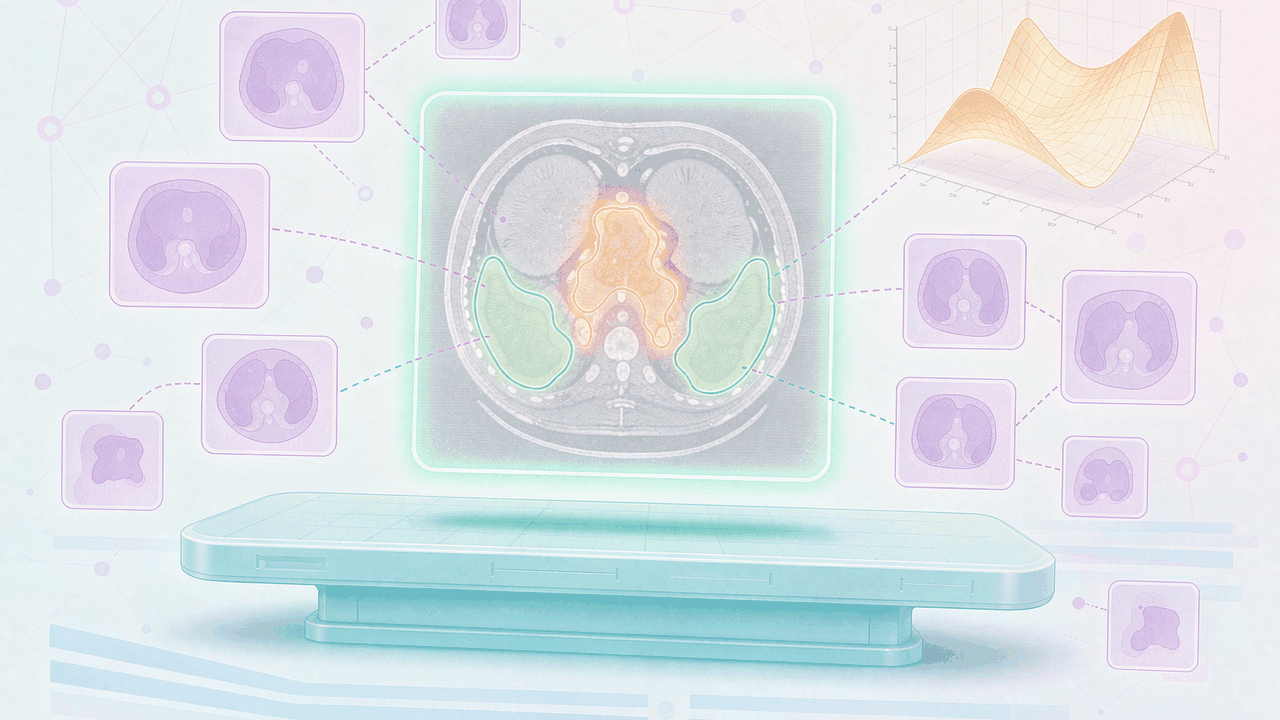
TCIA 上 HNSCC 父集合(627 例)的头号子项目:215 例 MDACC 头颈鳞癌放疗患者 433,381 个 DICOM(CT/PT/MR/RTPLAN/RTSTRUCT/RTDOSE),含危及器官与靶区轮廓、ICRU 50/62 勾画依据、L3 体成分指标与 AJCC 7 分期临床表;临床表 CC BY 3.0,影像走 NIH 受控访问
牛津 OPIG 把 SAbDab(2013 起)重构成 ML 时代的抗体结构库:21,237 个抗体实例 / 11,085 个 PDB ID / 6,540 个 SAbDab2 ID,IMGT+ANARCII 编号,CC-BY 4.0,附带 15,641 条 ML-grade 可变区结构与版本化 train/test 划分
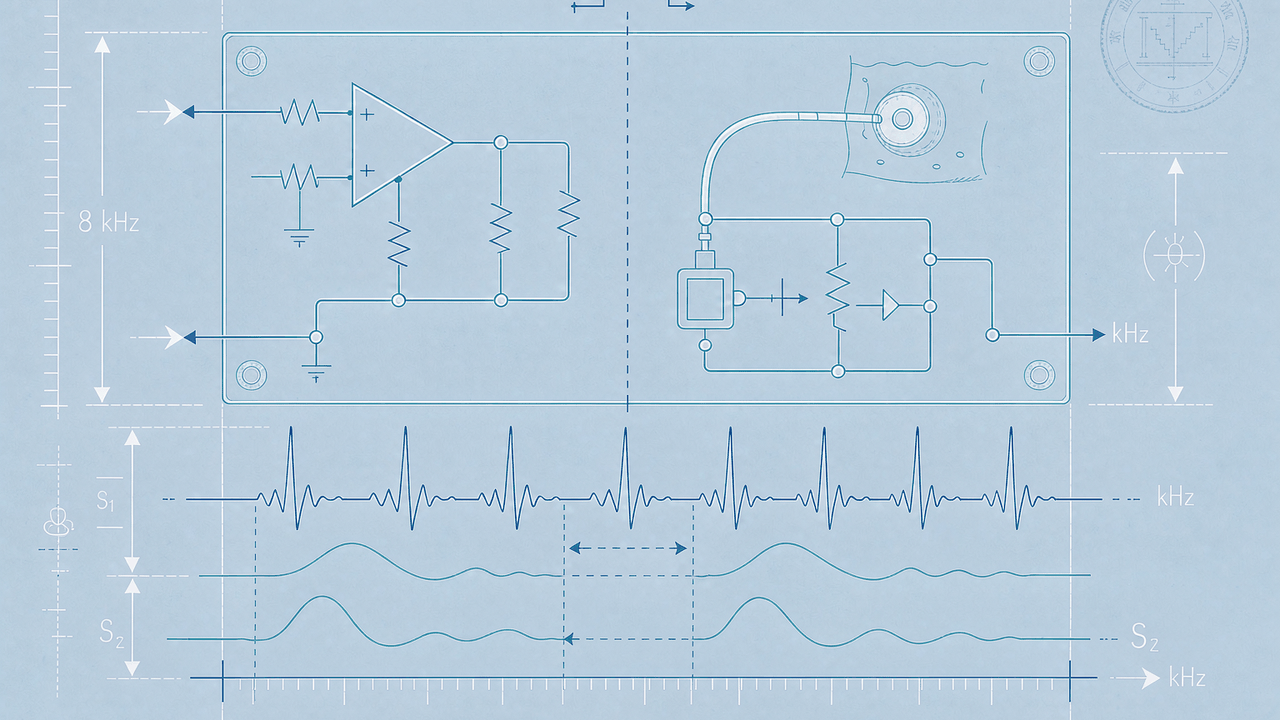
二〇二一年伊朗设拉子的一个课题组做了件别人没做过的事:让同一颗心脏的电与声在同一台设备上同时被录下来,一录半小时,而且是在跑步机上录。数据不大,十一吉字节,但它回答了一个心电和心音分开采的数据集永远答不了的问题
二〇一四到二〇一八年,巴西与美国的医生用数字听诊器在四个部位各录二十来秒,凑出一份真正按心动周期切好的心音数据。它最容易被误用的地方,也是它最好的地方:那些分段标签是算法吐出来的,不是医生一句一句听出来的
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
