信息速览
如果问一个做心音的人:你最缺什么?答案多半不是「更多数据」,而是「同时录到的心电」。心音告诉你心脏的机械动作,心电告诉你电信号什么时候到;两者隔着一段叫作电机械延迟的时间,这段延迟在健康人身上是几十毫秒,在病人身上会变。可是绝大多数公开数据集是分开采的——今天录心电,下周录心音,中间隔了七天,心率都变了。
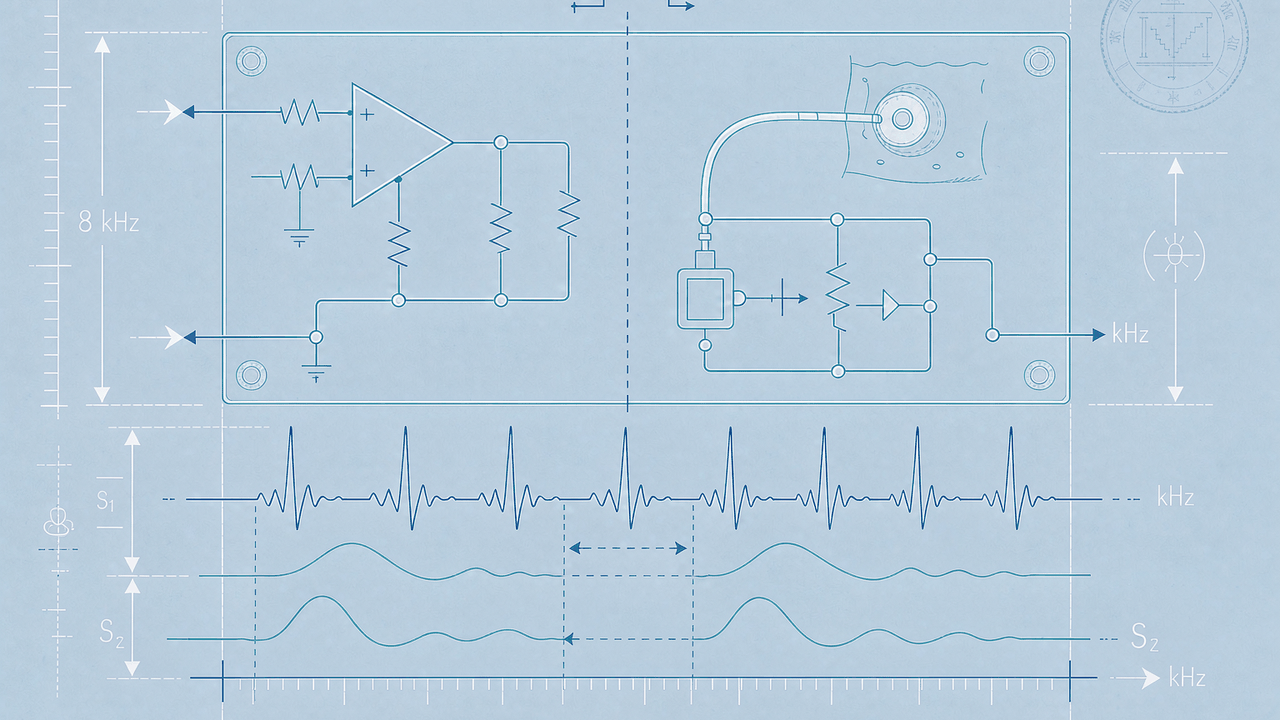
伊朗设拉子的一个课题组决定自己解决这件事。他们从零设计了一台便携采集设备,把心电前置放大和听诊器接在同一块板子上,同一个时钟采样。硬件改到 2.1 版才定稿,听诊器试了四种改法,最后选了「麦克风塞在导管里」这一种。
结果是一份十一吉字节的数据:二十四名健康男性,六十九段记录,多数是三十分钟,而且是在跑步机上录的。它不是最大的心音数据,但它是极少数能在同一毫秒上问「电到了多久之后,机械才动」的数据。
§1 它是什么:一台自建设备采出来的电声同步库
1.1 一句话定义与四条边界
这是一份电声同步的多负荷心音与心电数据集:二十四名二十三至二十九岁的健康男性,在休息与四种运动负荷条件下各录三十分钟,用一台自己设计的设备同时采集一导心电与一路听诊器心音,总时长三十点五七小时。
四条边界要先划清楚:
- **不是三导联。**条目页写「three-lead ECG」,但六十九个头文件里每一条记录只有一路
ECG通道。这一点在 §2.4 详述。 - **不是患者数据。**全部是健康志愿者,结构化访谈确认无自主神经或心血管疾病症状。没有任何诊断标签,也没有异常心电的标注(除了表格里一处备注写「Abnormal ECG」)。
- **不是静息数据。**六成半的记录是运动中的。跑步机上录心音,运动伪迹、呼吸、衣物摩擦全在里面,这与诊室里录的二十秒干净心音是两个物种。
- **不是双精度。**WFDB 那份是 16 位整数,MAT 那份是双精度。两者的差别在 §4.4。
1.2 五种负荷条件
| 条件 | 记录数(长) | 说明 |
|---|---|---|
| 休息(坐椅 / 卧床) | 11 | 基线,静息心率 |
| 固定自行车骑行 | 13 | 恒定功率踏车 |
| 匀速步行 3.7 公里每小时 | 13 | 平地走,速度固定 |
| Bruce 方案跑台 | 11 | 分级递增跑台,最接近临床负荷试验 |
| 自行车负荷试验 | 10 | 递增功率,两名志愿者因体力不支未完成 |
| 混合方案 | 3 | 慢走、快走、起坐、休息串起来 |
短记录(30 秒)另有八条,全是休息状态,用于快速预览。长记录六十一条,短记录八条,合计六十九。
**Bruce 方案那十一条最有价值。**它是临床上标准的跑台负荷试验,分七级,每级三分钟,速度与坡度同时递增。有了它,这批数据才能与真实的负荷试验研究对上话。其余几种条件是自由设计,别处没有对照。
1.3 同步到什么程度
同一块板子、同一个时钟、同一个 8 千赫兹的采样脉冲。这是硬件级同步,不是事后按时间戳对齐。
同步精度由什么决定?由采样时钟的抖动决定。设备用一个低功耗微控制器驱动两路 ADC,两路的转换在同一采样周期内串行完成,相隔微秒级。这个精度远高于任何基于时间戳的软件对齐。
这件事的意义在 §5.3 展开:它让「R 波到 S1 的间隔」这种以毫秒计的量第一次可以被批量计算。
1.4 设备是怎么做出来的
条目页把设计过程写得很细,值得摘出来:
**前端滤波。**一阶无源高通,负三分贝点在 0.1 赫兹,串一个五阶有源巴特沃斯低通。两个通道用同一套拓扑,只是截止频率不同:心电通道上限 150 赫兹、通带增益 30 分贝;心音通道上限 1 千赫兹、通带增益 5 分贝。
**抗混叠。**在 4 千赫兹的奈奎斯特频率处,心电通道衰减 90 分贝、心音通道衰减 25 分贝。
**采样。**8 千赫兹、12 位,有效位数 10.5 位。这个数字是设计者自己标的,说明他们量过噪声底。10.5 位有效意味着信噪比约 65 分贝,比标称的 12 位(约 74 分贝)差 9 分贝。
**听诊器的四种改法。**这是全篇最实在的部分:
- 麦克风塞进标准胸件的膜片正下方;
- 两个麦克风背靠背塞进胸件,一个朝膜片,一个朝钟形口;
- 麦克风放在导管末端(耳管接头处);
- 麦克风放在导管内、距接头几厘米处,另在设备壳内放辅助麦克风拾环境噪声。
第四种被选中。理由条目页没说透,但从数据能看出原因:第三种(导管末端)离耳朵太近,采集到的主要是耳管里的驻波;第一种(膜片下方)在运动时容易被胸件自身的振动污染。第四种把麦克风放在导管中段,既避开胸件的机械振动,又保留足够的声耦合。
1.5 环境噪声通道想干什么
设备有两路辅助通道 AUX1 与 AUX2,麦克风放在设备壳内,拾的是环境声音。
设计意图很明确:用环境噪声做主动噪声抵消(ANC)。心音采集的老问题是环境噪声(诊室空调、健身房音乐、跑步机马达)与心音在频带上重叠,单纯滤波去不掉。如果有两路参考噪声,可以用自适应滤波(比如最小均方算法)把噪声从主通道里减掉。
**这个想法在数据里实现了没有?**看 §2.7:AUX2 有五十八条记录全部标注为「量化噪声电平」——也就是说,这两路参考通道自己就没有信号。想法很好,落地没成。
1.6 版本与许可
版本 1.0.0,二〇二一年六月十一日。许可 ODC-By 1.0,署名即可商用。DOI 10.13026/tjtq-5911。未压缩体积约十一点三吉字节。
§2 数据构成:69 条记录的真实结构
2.1 目录与文件组织
WFDB/ECGPCG00XY.hea      × 69
WFDB/ECGPCG00XY.dat      × 69   (合计 8.0 GB)
MAT/ECGPCG00XY.mat       × 69   (合计 3.3 GB)
ECGPCGSpreadsheet.csv
Code/TestHeartRateCalculation.m
RECORDS
LICENSE.txt
SHA256SUMS.txt
对象清单一次取全,共二百一十二个对象,没有翻页。这个体量在 PhysioNet 上算小的。
RECORDS 六十九行、电子表格六十九行、头文件六十九个,三方完全对齐,零差异。SHA256SUMS.txt 覆盖二百一十一个对象——比对象总数少一个,少的应该是它自己。
**MAT 与 WFDB 是同一批数据的两种编码。**MAT 那份三点三吉字节,WFDB 那份八点零吉字节。体积差是因为 MAT 用双精度浮点(每样本八字节),WFDB 用 16 位整数(每样本二字节)。同一条记录,MAT 是 WFDB 的四倍大。
2.2 头文件长什么样
以 ECGPCG0001 为例:
ECGPCG0001 2 8000 14400000
ECGPCG0001.dat 16 46944.2574(-4733)/mV 0 0 -6017 15598 0 ECG
ECGPCG0001.dat 16 35704.6108(-2920)/mV 0 0 32767 27923 0 PCG
第一行:记录名、通道数、采样率、采样点数。1440 万点除以 8 千赫兹,等于 1800 秒,正好三十分钟。
每行信号头十个字段:文件名、格式、增益(含基线与单位)、ADC 分辨率、ADC 零点、初值、校验和、块大小、通道名。
**最后那个通道名不是 WFDB 标准字段。**标准 WFDB 头的第九个字段是描述文本,这里被写成了通道名。好在这份数据的通道名非常规整,只有五种:ECG、PCG、PCG2、AUX1、AUX2。
**格式是 16,不是 16+44。**这是裸二进制,没有 WAV 头。一条记录里所有通道的数据都在同一个 .dat 里,按记录(frame)交错存放:第 0 帧是通道 0 的第 0 点、通道 1 的第 0 点,第 1 帧是通道 0 的第 1 点……以此类推。用 Range 请求抓开头一百二十八字节解出来,能清楚看到这个交错模式。
2.3 69 条记录的形状
| 项 | 值 |
|---|---|
| 通道数 | 5 路共 58 条,2 路共 11 条 |
| 采样率 | 8,000 赫兹,全部一致 |
| 单条时长 | 30 分钟 61 条,30 秒 8 条 |
| 总时长 | 30.57 小时(110,040 秒) |
| 格式 | 全部 16 位整数 |
| 通道名组合 | ECG+PCG(11 条)、ECG+PCG+PCG2+AUX1+AUX2(58 条) |
| 总字节 | 约 11.3 GB(WFDB 8.0 GB + MAT 3.3 GB) |
五路的那五十八条,是后期硬件版本;两路的十一条,是早期或者没接辅助通道的。
2.4 一处必须更正:心电只有一路
条目页的方法段写「three-lead ECG」,数据描述段写「a three-lead ECG」,两处都说了三导联。
**但六十九个头文件里,每一条记录都只有一路名为 ECG 的通道。**核了三遍,不是解析问题:
- 头部第一行声明的通道数,五十八个是 5、十一个是 2;
- 信号行数与之严格相等;
- 通道名去重后只有五种,
ECG每条记录恰好出现一次。
所以硬件确实可能支持三导联(方法段说「电路包含三导联心电」),但发布的数据里只保留了其中一导。
这不是小事。三导联的价值在于空间信息——不同导联看同一颗心脏的不同角度,下壁与侧壁的缺血会表现出不同形态。只有一导,这个价值就没了。
好在同步这件事不受影响:一导心电照样能定 R 波,照样能算电机械延迟。**只是「哪一导」没有说明。**从形态看像胸导联(R 波幅度大、T 波明显),但数据集没有标注。这给复现带来了不确定性——不同导联的正常形态阈值不同。
2.5 增益:每个记录都不一样
这是这份数据最容易被忽略、也最容易出事的一处。
WFDB 的增益字段写成 46944.2574(-4733)/mV,意思是「每毫伏 46944.2574 个计数单位,基线在 -4733」。用这个增益把整数除以它,就还原成毫伏。
**关键在于:每条记录的增益都是独立的,跨记录完全不可比。**统计下来:
| 通道 | 增益范围 | 中位 | 相当于满量程 |
|---|---|---|---|
| ECG | 32,775 – 167,767 | 34,924 | 0.195 – 1.000 mV |
| PCG | 32,904 – 64,248 | 33,041 | 0.510 – 0.996 mV |
| PCG2 | 32,993 – 10,324,126 | 8,141,636 | 0.003 – 0.993 mV |
| AUX1 | 32,944 – 5,368,545 | 817,164 | 0.006 – 0.995 mV |
| AUX2 | 65,534 – 8,947,576 | 4,550,922 | 0.004 – 0.500 mV |
看出问题了吗?**PCG2 的增益中位数是八百一十四万,是 ECG 的两百三十三倍。**换算成满量程,只有三点二个微伏。这不是「小声」,这是「整段信号被压在了几十个量化台阶里」。
这解释了条目页为什么说「辅助通道在多数场次处于量化噪声电平」——它们不是坏掉了,是被归一化算法放大到了撑满量程。设计者大概对每一路都做了「除以该路最大值」的归一,结果一路几乎无信号的通道,最大值本来就小,归一化之后噪声反而占满了全量程。
用 Range 抓头部字节验证过:ECGPCG0004 的第 2 到第 4 路,一阶差分均值分别是 5705、4668、4551 个计数单位,而第 0、1 路只有 46 和 42。**噪声通道的逐点跳变是真实信号的百倍。**这是量化噪声的典型形态:相邻样本在几个台阶之间来回跳。
**结论:PCG2 与 AUX1/AUX2 不能当「低幅度信号」处理,它们是纯噪声。**任何想用它们做噪声抵消的尝试,都会拿噪声去减噪声。
2.6 增益归一化带来的另一个后果
既然每路都独立归一化,那么**「心音比心电响」这类跨通道的幅度比较是无效的。**
举个例子:某条记录里 PCG 的峰值是 20000 个计数,ECG 的 R 波峰值也是 20000 个计数。看起来两者一样大。但 PCG 的增益是一万,ECG 的增益是三万三,换算成毫伏是 2.0 与 0.6。差了三倍多。
**正确做法:一律先除以增益换算到毫伏,再做任何跨通道比较。**直接读整数比较幅度,会得到完全随机的结论。
2.7 初值与基线:296 处不一致
WFDB 信号头里有两个容易混淆的字段:ADC 零点(第五个字段)与初值(第六个字段)。
- ADC 零点是硬件定义的零点,在全部三百一十二个通道里都是 0;
- 初值是这一路第一个样本的值,本来应该等于基线。
按定义,增益(基线) 里的基线,与「初值」应当是同一个数——至少在该路信号以基线为起点时。
核对下来,三百一十二个通道里有二百九十六个的初值与基线不一致,只有十六个一致。以 ECGPCG0001 为例:ECG 初值 -6017、基线 -4733,差 1284;PCG 初值 32767、基线 -2920,差三万五千多。
PCG 那个尤其说明问题:32767 是 16 位有符号整数的上界。初值恰好等于上界,说明这一路信号在第一个样本就已经饱和。曲线开头是一段削顶。
**这不是致命的,但会让「用初值判断基线」的做法失效。**正确的基线永远取 增益(...) 括号里那个数,不要取初值。
2.8 采样点数与体积对不对得上
.dat 是裸二进制,一条五通道、1440 万点、16 位的记录应当是 1440 万 × 5 × 2 = 144,000,000 字节,也就是 144 MB。对象清单里五通道长记录的 .dat 全是 144.00 MB,对得上。
两通道的记录是 57.6 MB。八条三十分钟两通道加五十八条三十分钟五通道加八条三十秒记录,累加约八点零吉字节,与清单一致。
**这个自洽性说明没有文件被截断。**对于走 nginx 下载会无声截断的老问题,这里可以用「体积对不对」当作一道粗筛。
2.9 受试者贡献极不平衡
二十四名受试者贡献六十九条记录,平均每人二点九条。但分布极其不均:
- 一人(S009)贡献八条;
- 一人(S005)六条;
- 三人各五条;
- 五人各四条;
- 十人各一条。
那十个只有一条的人,大部分是短记录(三十秒),或者只做了一个条件(比如 S021 只做了匀速步行、S022 到 S024 只做了骑行)。
这个结构意味着:**如果按记录数算「样本量」,二十四个人会变成六十九条,放大近三倍。**而真正的独立个体只有二十四个。
更麻烦的是,贡献八条的 S009 里,有六条是「混合方案」——他一个人跑了慢走、快走、起坐、休息一整套,所以场景标签高度重复。用这批数据做「场景分类」任务时,S009 会过度代表混合方案这一类。
2.10 条三十秒短记录
八条短记录分别是 ECGPCG0003 到 ECGPCG0009,加 ECGPCG0040。全部是休息状态,全部三十秒。
它们的作用是快速预览:下一条长记录之前先看一眼信号质量。ECGPCG0003 与 ECGPCG0040 同属 S003,通道数都是 2;其余六条是五通道。
这八条应当从训练集里排除,或者至少不要在按记录计数时把它们和长记录等同。三十分钟与三十秒,信息量差六十倍。
2.11 三位一体的清单校验
表格、RECORDS、头文件三方逐项比对:
- 记录名集合:完全相等,零差异;
- 通道数:六十九条全部一致;
- 时长:六十九条全部一致(采样点数除以 8000 再除以 60,与表格的分钟数误差小于 0.01)。
**三方零差异是这份数据最让人放心的一点。**它说明发布前跑过完整性检查。
2.12 表格里的质量备注
电子表格有五列备注:ECG Notes、PCG Notes、PCG2 Notes、AUX1 Notes、AUX2 Notes。这些是人工写的自由文本,是这份数据最有价值的部分之一。
ECG Notes 的分布:
| 备注 | 条数 |
|---|---|
| Good | 36 |
| Noisy | 9 |
| Good; occasional saturation | 5 |
| Powerline noise | 2 |
| Noisy low amplitude | 2 |
| Partially noisy | 2 |
| 其余单条(饱和、断连、极噪、幅度波动、形态待查、异常心电等) | 13 |
只有三十六条心电被判为「好」,占五成二。其余三成多是各种问题,另外一成多是「好但有工频干扰」这类半好。
PCG Notes 好些:五十条 Good、九条 Partially saturated、四条 Saturated,其余是噪声或断连。
**这个质量分布决定了使用方式:**如果要做干净的心音分析,实际可用的大概五十条;如果要做噪声鲁棒性研究,那十九条有问题的正好是素材。
有一条备注格外值得注意:Good; Abnormal ECG。这是全库唯一的异常标注,但表格里没有说明异常是什么类型。想做「正常 vs 异常心电」的对比,只有一个正例,做不了。
2.13 每受试者做了几次、按什么顺序
表格的行序基本就是采集顺序。看每人的场景列表,能看出流程:
- S002 做了卧床休息、匀速步行、Bruce、自行车负荷四条;
- S005 做了坐姿休息(三十秒)加骑行两条、Bruce、步行、自行车负荷;
- S016 只做了四种运动,没有休息长记录;
- S018 只做了 Bruce 与步行两条。
**同一受试者的不同条件不在同一天。**条目页说「每位志愿者把某个任务做一次」,从表格无法判断是否跨日。这一点影响「条件之间的比较」——如果跨日,心率基线本身就变了。
2.14 文件命名与编号的空缺
记录编号从 ECGPCG0001 到 ECGPCG0069,连续无空缺。但表格的 Database Housekeeping 列揭示了另一件事:四条记录写过「Replaced file ID 01」「Replaced file ID 02」「Replaced file ID 03 (PG)」「Replaced file ID 040 (PG)」。
意思是这四条是重录替换的版本,原来的文件被换掉了。编号没有变,内容换了。
**(PG)这个标记没有解释。**从上下文推测是采集者姓名缩写,但数据集里没有对照表。
这四条是 ECGPCG0001、0002、0003、0040。前三条恰好是全库最前面的三条,说明项目启动初期返工最多。
2.15 采样率的代价与收益
8 千赫兹,是这份数据最容易被跳过的一个数字,但它决定了很多事。
**收益。**心音的瞬态含有高频成分——S1 的起始是一个陡峭的上升沿,陡沿的频谱一直延伸到几千赫兹。如果只采 1 千赫兹,这个上升沿会被抹平,S1 的起点位置估计会偏十几毫秒。对电机械延迟这种以毫秒计的量,十几毫秒是致命的。8 千赫兹给到了 4 千赫兹的奈奎斯特频率,S1 的陡沿被完整保住。
**代价。**三十分钟、五通道、8 千赫兹、16 位,一条记录就是 144 MB。六十一条下来八吉字节。这是为什么这份数据只有六十九条记录——不是招不到人,是存不下。
**还有一个隐性代价:后续处理的算力。**做一次 20 赫兹到 400 赫兹的带通,在 8 千赫兹的信号上要跑一个很长的滤波器。合理做法是先降采样到 2 千赫兹再滤——但这个降采样本身要先抗混叠,顺序不能反。
2.16 前端的通带与心音的频带对得上吗
条目页给的心音通道参数:高通 0.1 赫兹、低通 1 千赫兹。
低通 1 千赫兹这个选择值得说。心音的主要能量在 20 到 400 赫兹,但杂音——尤其是主动脉瓣狭窄的喷射性杂音——能量可以上到 600 到 800 赫兹。1 千赫兹的截止刚好把这些成分保住。
**代价是保留了更多的高频噪声。**肌电、摩擦音、设备自噪声都在这个频段。所以低通设 1 千赫兹,等于「宁可留噪声,也不丢杂音」。对一个以研究杂音为目标的项目,这个取舍是对的。
心电通道的 150 赫兹上限则是标准做法——诊断心电的常规带宽就是 0.05 到 150 赫兹。设得更高只会引入肌电。
**两路不同的截止频率,意味着两路的群延迟不同。**条目页特意提了一句「前端滤波器是非线性相位的,但群延迟在通带内相当恒定」。这句话的意思是:虽然相位非线性,但在各自的通带里延迟是平的,所以不会把波形形状搞歪。**但它没有说两路之间的延迟差是多少。**做电机械延迟分析时,这个差值会直接加进结果里。
如果两路的群延迟差是 5 毫秒,那么测出来的电机械延迟就整体偏 5 毫秒。这个偏差是常数,不影响「延迟随心率变化」的斜率结论,但影响绝对值的解读。条目页没有给出这个数,使用者只能自己从滤波器参数估算。
2.17 50 赫兹陷波:做了,但没做干净
设备在数字域做了 50 赫兹工频陷波(伊朗电网频率)。
但表格里仍有两条心电备注为 Powerline noise,四条提到工频(Good; powerline noise、Noisy; powerline、Low amplitute; powerline noise、Disconnected; saturated; powerline noise)。
**这说明陷波没有完全解决问题。**可能的原因:
- 陷波器带宽太窄,而实际干扰的频率在 49 到 51 赫兹之间漂移;
- 干扰太强,陷波后仍有残余;
- 干扰的谐波(100 赫兹、150 赫兹)没有被陷。
**用的时候要自己再查一遍。**方法很简单:算功率谱,看 50 赫兹及其谐波处有没有尖峰。有的话,要么加更宽的陷波,要么在特征提取时避开这一段频带。
2.18 那份示例脚本能干什么
Code/TestHeartRateCalculation.m 是一个 MATLAB 脚本,从心电和心音两路分别提取心率。
它的价值不在代码本身(心率提取是标准流程),而在于它示范了这份数据的预期读法:先读 MAT、再分通道、再各自处理。
值得注意的是它读的是 MAT 而不是 WFDB。这暗示作者的日常流程用的是 MAT 那份。如果你要复现他们的结果,用 MAT 更稳;如果你要做工程部署,用 WFDB 更合适。
2.19 数据里没有的东西,比有的更值得记
列一份「这份数据没有的字段」清单,比列有的更有用:
- 没有采集日期与时刻;
- 没有采集地点(哪间房、哪个健身房);
- 没有设备序列号与固件版本;
- 没有电极位置的具体描述(一导心电贴在哪两个点);
- 没有胸件的具体固定位置(只说「三尖瓣与二尖瓣之间」);
- 没有身高体重;
- 没有运动时的功率或速度曲线(Bruce 方案有标准protocol,但实际执行偏差不知道);
- 没有主观疲劳评分(Borg 量表);
- 没有运动后的恢复段(三十分钟一到就停);
- 没有血压。
**最后两条最可惜。**负荷试验的标准流程包含恢复期与血压监测,缺了它们,这份数据只能做「运动中的信号分析」,做不了「负荷试验的完整生理响应」。
**倒数第三条也值得说。**没有 Borg 评分,就无法判断「两名志愿者因体力不支未完成自行车负荷试验」里的「体力不支」是主观放弃还是客观极限。这个区别在生理学解释上很重要。
§3 怎么拿到:11 GB,先别全下
3.1 许可与门槛
ODC-By 1.0:署名即可商用,可再分发。没有申请、没有 DUA。真正 open。
3.2 引用
Kazemnejad A, Gordany P, Sameni R. EPHNOGRAM: A Simultaneous Electrocardiogram and Phonocardiogram Database (version 1.0.0). PhysioNet. 2021. https://doi.org/10.13026/tjtq-5911
配套论文(条目页引用):
Sameni R, et al. EPHNOGRAM: A Simultaneous Electrocardiogram and Phonocardiogram Database. 相关会议或期刊论文,引用时按实际发表信息取。
3.3 下载策略:先文本,后波形
十一吉字节不是小数目。合理的顺序:
   step 1 -- 列出对象(一次取全,无需翻页)
curl -s "https://physionet-open.s3.amazonaws.com/?list-type=2&prefix=ephnogram/1.0.0/&max-keys=1000" \
  | grep -o '<Key>[^<]*</Key>' | sed 's/<Key>//;s/<\/Key>//' > keys.txt

   step 2 -- 先取头文件与表格(不到 400 KB)
grep -E '\.(hea|csv|txt)$|RECORDS$|\.m$' keys.txt > small.txt
cat small.txt | xargs -P 16 -I{} sh -c \
  'f=$(basename {}); [ -s "hea/$f" ] || curl -s -o "hea/$f" "https://physionet-open.s3.amazonaws.com/{}"'

   step 3 -- 用 Range 抽头部,确认格式与通道交错
curl -s -r 0-255 "https://physionet-open.s3.amazonaws.com/ephnogram/1.0.0/WFDB/ECGPCG0004.dat" -o head.bin
第三步是关键:**先花两秒抓二百五十六字节,就能确认交错方式、通道数与幅度量级。**确认对了再决定要不要下整个文件。
3.4 MAT 还是 WFDB
条目页的建议是:除非需要双精度,用 WFDB 那份。
我同意,但补两条理由:
- **WFDB 是标准的。**一百四十多个生态工具都能直接读,MAT 要自己写解析。
- **体积小四倍。**十一吉字节里,MAT 占了三成,而它多出来的精度(双精度对 16 位)在这份数据上没有意义——原始设备的有效位数只有 10.5 位,16 位已经足够,双精度是浪费。
唯一该用 MAT 的场景:你想验证自己写的 WFDB 解析器对不对。两份数据同源,逐样本比对可以验证解析正确性。
3.5 校验
SHA256SUMS.txt 二百一十一行。注意它不覆盖自己。
对 11 GB 做全量校验要跑十几分钟。合理的做法是先校验头文件与表格(几秒),波形用体积比对当粗筛(§2.8),需要时再抽查。
§4 质量与已知问题
4.1 硬件是自己做的,这意味着什么
自建设备有好处:同步精度高、可以加辅助通道、成本低。代价是没有经过临床验证,也没有因型检验。
具体表现为:
- **没有标定记录。**设备出厂前有没有做过幅度标定?条目页没说。这意味着「毫伏」这个单位是设计值,不是量出来的值。
- **没有频响曲线。**说了通带增益与截止频率,但没给经仪器量过的幅频特性。滤波器是五阶巴特沃斯,理论曲线能算,实际元件容差带来的偏差不知道。
- **没有通道间串扰测试。**心电与心音在同一块板子上,心电的大幅度信号会不会串到心音通道?条目页没提。
**这些不是致命缺陷,但它们决定了「毫伏」这个数的可信度。**如果只是做相对分析(比如波形形状、间隔时间),影响不大;如果要做绝对幅度比较(比如心音强度分级),风险不小。
4.2 运动中的心音:伪迹比信号大
这是这份数据最本质的困难。
跑步机上录心音,会遇到三类伪迹:
- **运动伪迹。**每跑一步,身体上下起伏,胸件与皮肤的相对位移产生低频大振幅信号。这个信号的幅度往往比心音大一个数量级。
- **摩擦音。**胸件与皮肤、衣物与胸带之间的摩擦,是宽带噪声。
- **设备自噪声。**踏车时设备本身在振动,麦克风拾到的机体噪声。
条目页提到用了「弹性棉质胸带」固定胸件,这是必要措施,但解决不了第一类。
**结果:十九条记录的 PCG 被标为饱和或部分饱和。**九条 Partially saturated、四条 Saturated、两条噪声、一条断连。
**用的时候必须先做伪迹压制。**常见的做法是:用 ECG 的 R 波做时间锚点,只在 R 波前后的窗口里取心音(因为收缩期与舒张期的时间窗是已知的),其余时段丢弃。这个方法依赖同步——恰好这份数据同步得极好。
4.3 「Good」也是相对的
表格里五十条 PCG 被标为 Good。但这个 Good 是采集者当时的判断,标准是什么没说。
从数据看,Good 的记录仍然可能有:基线漂移(0.1 赫兹高通之后的残余)、工频干扰(虽然有数字陷波)、呼吸调制。
**不要以为标了 Good 就不用预处理。**它只意味着「没有明显的饱和与断连」。
4.4 16 位与双精度的差别有多大
条目页说转换后所有通道的信噪比在 60 分贝以上。这个数是设计者用 MATLAB 原文件与 WFDB 读回的文件逐通道比对算出来的。
60 分贝对应约 10 位有效精度。设备本身的有效位数是 10.5 位。所以 16 位存储几乎没有损失信息——瓶颈在设备,不在格式。
这也说明:非要用 MAT 双精度,得到的只是「把 10.5 位的信号用 53 位小数存起来」,没有增加信息。
4.5 高度不平衡的采样设计
二十四个人,六十九个条件。但不是「每人每种条件都有」的完全交叉设计:
- 休息长记录只有十一个人做了;
- 固定自行车骑行十三条,来自几个人重复做;
- Bruce 跑台十一条,来自十一个人各一次;
- 混合方案三条,全是一个人。
**这不是一个可以拿来做「条件效应」方差分析的平衡设计。**任何「骑行比步行心率高多少」的结论,都混杂了受试者个体差异——因为做骑行的人和做步行的人不完全重合。
**正确的做法:只用那些在同一受试者身上同时有两种条件的记录做配对比较。**按表格算,同时做了骑行与步行的受试者有几个,但每个条件下的记录数据量很小。
4.6 数据质量清单(DAIMS)
| 维度 | 评级 | 依据 |
|---|---|---|
| 完整性 | 高 | 表格、RECORDS、头文件三方零差异;SHA 覆盖 211 个对象 |
| 一致性 | 中 | 通道数与时长全一致;但条目页「三导联」与实际的单导联不符 |
| 准确性 | 中 | 自建设备无标定记录;幅度单位为设计值 |
| 唯一性 | 高 | 编号连续无重复;受试者编号唯一 |
| 时效性 | 中 | 采集于二〇二〇年前后,设备版本已过时 |
| 可追溯 | 低 | 无采集日期、无设备序列号、无标定文件 |
| 标注质量 | 中 | 只有自由文本质量备注,无结构化质量分 |
4.7 一条自相矛盾的记录数
条目页在数据描述段先写「69 条记录」,紧接着写「30 分钟记录(62 条)」。
核下来:30 分钟的是六十一条,30 秒的八条,六十一加八等于六十九。
**所以「62 条」这个数不对。**差一条。可能是把某条短记录算成长记录了,也可能是笔误。
这个差异不大,但它提醒一件事:条目页的数字不要直接抄,要自己数。
4.8 二十四个人的统计能说什么
二十四个独立个体,是这份数据的功效上限。
按二十四人、双侧检验、显著性零点零五算,能稳定检出(功效零点八)的效应量大约是 Cohen’s d 等于零点六。这个量级在生理学上属于「中等偏大」——比如「运动时电机械延迟比静息短 15%」这种效应,检得出;「短 5%」这种,检不出。
**这条约束决定了该问什么问题。**问「同步采集能不能做」——能,因为信号质量摆在那里,不需要统计检验。问「延迟与心率有没有关系」——能,因为关系很强,散点一看就清楚。问「Bruce 方案与自行车负荷的延迟差异有多大」——不能,因为效应小、样本少,且两种条件下的人不完全重合。
**最该避免的是「分组比较」。**二十四人分两组,每组十二人。这个规模下,任何组间差异都要大到 d 大于一点二才能检出,而生理指标很少有这么大的组间差。
4.9 一个被忽略的混淆:胸件位置不固定
条目页说胸件放在「三尖瓣与二尖瓣之间」,理由是那里能同时听清 S1 与 S2。
这是合理的选择,但没有说明每人是否用同一个位置、位置偏差有多大。胸壁上的两厘米位移,会让心音的幅度变化几个分贝,也会让 S1 的频谱重心移动。
对电机械延迟的影响更大:延迟是从 R 波峰到 S1 起点,而 S1 的起点位置取决于你听到的是哪个瓣膜的声音。三尖瓣关闭比二尖瓣晚十几毫秒,胸件偏一点,听到的成分比例就变了。
**所以跨受试者比较绝对延迟值时,这个混淆无法排除。**能做的只有:受试者内比较(同一人不同条件)、或者只看延迟随心率的变化率(斜率,位置偏差是常数,不进入斜率)。
4.10 运动强度的实际分布无法验证
五种条件里,只有 Bruce 方案有标准协议(七级,每级三分钟,速度从 2.7 公里每小时升到 6.7,坡度从 10% 升到 22%)。
其余四种是自由设计:
- 「固定自行车骑行」——功率是多少?没说。
- 「匀速步行 3.7 公里每小时」——坡度是多少?没说。
- 「自行车负荷试验」——递增的速率是多少?没说。
- 「混合方案」——每一段的时长有写,强度没写。
这意味着「运动强度」这个变量在数据里是定性的、不是定量的。
后果:不能算「延迟与功率的关系」,只能算「延迟与心率的关系」。心率是个替代量,它同时受强度、体能、情绪影响。
**这不是缺陷,是取舍。**要精确控制强度,就得用功率车加气体代谢分析,成本高十倍。用「条件标签 + 心率」做近似,是这类研究的常规做法。只是使用者要清楚:你测的是心率效应,不是强度效应。
§5 能做什么
5.1 电机械耦联:这份数据唯一的护城河
心电的 R 波是电学事件,心音的 S1 是机械事件(房室瓣关闭)。两者之间有一段延迟,健康成年人约三十到五十毫秒。
这段延迟受什么影响?受心肌收缩力、前后负荷、心率影响。运动时心率上升、收缩力增强,延迟会缩短。
**要研究这件事,必须有同步记录。**分开采的数据集做不了——两次采集之间心率就变了。
这份数据的价值全在这里:六十九条记录,其中六十一条是三十分钟的连续记录,运动过程中心率从静息一路升到峰值。这提供了一个连续变化的「心率-延迟」曲线。
条目页提到,配套论文里已经做过这件事,结论是:心率上升时,R-R 间期缩短,但 R 波到 S1/S2 的间隔并不按同样比例缩短。也就是说,电与机械的「变速比」不同,这个不同正是电机械耦联的指纹。
5.2 心率序列的双通道对照
同一个心脏,用 ECG 算心率与用 PCG 算心率,两条曲线应当高度一致但不完全相同。
差别在哪里?在心音检测的抖动。R 波是尖锐的(上升沿几毫秒),S1 是缓的(持续几十毫秒),所以 S1 的起点检测精度天然不如 R 波。
**这个差别本身就是研究对象。**如果某段记录里两条心率曲线突然分叉,说明心音检测错了,或者发生了某种心音形态变化(比如 S1 分裂)。
条目页提到配套论文算了样本熵,发现两条序列的随机特征不同。这类分析在这份数据上是天然可做的。
5.3 噪声抵消:一个还没做成的方向
数据里有 AUX1、AUX2 两路环境噪声,设计意图是做 ANC。
但如 §2.5 所说,这两路五十八条里有五十八条被标为量化噪声电平,增益被归一化到了撑满量程。
**这意味着这个方向在这份数据上做不成。**除非……
除非你换个思路:**把 PCG2 当作「第二路心音」,用两路心音的差异做文章。**PCG2 也是量化噪声,但它与 PCG 的噪声不完全相关(不同麦克风位置),理论上可以做互相关分析来估计噪声成分。
这个思路在数据上是否可行,需要先看看 PCG2 到底有没有一点信号残留。从头部字节看,PCG2 的一阶差分与 AUX 同量级,都是几千个计数——大概率全是噪声。
诚实的说法:这个方向需要先在波形层核实 PCG2 是否 100% 无信号,不能想当然。
5.4 心音分段:在运动伪迹下做分割
干净心音的 S1/S2 检测已经做得不错。运动中的心音分割是另一回事:伪迹会制造大量假峰。
这份数据提供了十九个「饱和或部分饱和」的难例。如果方法能在这十九条上也保持合理精度,说明它真的鲁棒。
这比在干净数据上刷高零点零一个百分点有意义得多。
5.5 心电质量筛查
只有三十六条心电被判为 Good。剩下三十三条有各种问题:噪声、饱和、工频干扰、断连、幅度过低。
**这三十三条正好是一份现成的心电质量评估素材。**有标签(备注文本)、有波形、有同步参考。
做心电质量指数(SQI)的研究者常苦于没有带标注的坏数据,这里有一批。
5.6 制作用于教学的心音-心电对照样本
同步记录最大的教学价值在于:同一条时间轴上,能看见 R 波之后多久出现 S1。
把一段记录切成单拍,上下两行:上行心电、下行心音,竖线对齐 R 波。学生会立刻看到:电来了,机械晚了几十毫秒才动。
这份数据能做出几百个这样的教学图,而且覆盖静息到极量运动的全过程。
5.7 它不适合做什么
- **诊断任何疾病。**全部是健康志愿者,没有患者对照。
- **成人-儿童对比。**只有二十三到二十九岁男性。
- **女性生理差异研究。**零女性。
- **长时程趋势分析。**单条最长三十分钟,且不同条件不在连续时间轴上。
- **绝对幅度比较。**增益逐记录归一化,跨记录不可比。
- **三导联空间分析。**数据里只有一导。
- **噪声抵消。**辅助通道已饱和到量化噪声。
§6 常见误读与引用陷阱
| 误读 | 事实 | 后果 |
|---|---|---|
| 「三导联心电」 | 头文件里每条只有一路 ECG | 按三导联写的解析器直接失败 |
| 「69 个样本」 | 24 个独立个体 | 交叉验证泄漏,置信区间虚窄 |
| 「62 条 30 分钟记录」 | 实际 61 条长记录 + 8 条短记录 | 时长统计错 |
| 「增益可以直接用」 | 每条记录每路增益不同 | 跨记录幅度比较完全无效 |
| 「AUX 通道可以做噪声抵消」 | 已归一化到量化噪声 | 拿噪声减噪声 |
| 「初值就是基线」 | 296 个通道初值与基线不一致 | 基线估计错,波形整体偏移 |
| 「Good 就是干净」 | 只是没饱和没断连 | 跳过必要预处理 |
| 「可以拿来做条件方差分析」 | 非平衡设计,条件与人混杂 | 把个体差异当成条件效应 |
| 「11 GB 都可以用」 | MAT 与 WFDB 同源,重复占 3.3 GB | 白下三成体积 |
| 「Abnormal ECG 那一条可以当正例」 | 全库只有一条 | 无法构成分类任务 |
| 「毫伏是量出来的值」 | 自建设备无标定记录 | 绝对幅度不可信 |
三条技术陷阱:
**第一,帧式交错。**一条记录的所有通道数据在同一个 .dat 里,按「每帧取各通道一个点」排列。用 numpy.fromfile 读成一维后必须 reshape(-1, nsig),再按列取通道。按「先存完通道 0 再存通道 1」的块式读法去读,会得到完全没有意义的波形。
第二,增益字段的格式。46944.2574(-4733)/mV 这三段要一起解析:增益、基线、单位。只取冒号前面的数字当增益,就会丢掉基线,波形会带一个恒定偏移。
第三,16 位有符号 vs 无符号。格式是 16,在 WFDB 里指 16 位有符号(与 circor 的 16+44 偏移二进制不同)。用无符号读,负半周全部折到正半周,波形会翻倍且变形。
§7 在生态中的位置
7.1 与相邻数据的分工
| 数据集 | 规模 | 同步 | 负荷 | 独特之处 |
|---|---|---|---|---|
| EPHNOGRAM(本页) | 24 人 / 69 条 / 30.6 小时 | 硬件级 | 五种,含 Bruce | 电声同步 + 运动中采集 |
| CirCor DigiScope | 942 人 / 3,163 段 | 不适用(仅心音) | 静息 | 四部位、杂音五维、儿科 |
| PhysioNet 2016 心音 | 3,240 段 | 不适用 | 静息 | 正常/异常/噪声/其他四分类 |
| PTB-XL | 21,837 条 | 不适用(仅心电) | 静息 | 十二导联、多诊断标签 |
分工很清楚:**CirCor 答「杂音在哪」,2016 那份答「有没有异常」,PTB-XL 答「心电诊断是什么」,本页答「电与机械怎么对上」。**四者不重叠,也不能互相替代。
7.2 规模在整个生态里处于什么位置
三十点五七小时、二十四个人,在生理信号数据集里属于很小的。心电有八十万条的,脑电有一万五千小时的。
但同步采集的数据本来就少。要在一颗心脏上同时测电与机械,还要连续测三十分钟、还在运动中测,这个门槛把绝大多数数据集挡在外面。
**规模小是结果,不是选择。**理解了这一点,就不会拿「才二十四个人」来否定它的价值——它填补的是一个别人没填的格子。
7.3 与研究线的接续
三个方向:
- **电机械延迟作为心功能指标。**静息时的延迟个体差异大,但同一个体的「延迟随心率的变化率」可能更稳定。这份数据能估计这个变化率。
- **心音辅助心电的节律分析。**房颤时 R-R 绝对不齐,但 S1 的强度也随前负荷变化。两路一起看,可能比单看心电更有信息。
- **低功耗设备的算法设计。**这份数据就是用低功耗设备采的,算法的算力预算应当与之匹配。
7.4 适合谁用
- 研究电机械耦联的组:这是目前公开数据里最合适的一份。
- 做运动心音鲁棒性的组:十九条饱和难例是现成素材。
- 做同步采集设备验证的组:可以拿它当参照,比对自家设备的同步精度。
- 不适合:做临床诊断、做女性或老年人群、做三导联分析的。
§8 怎么用:分析方案
8.1 读数据的最小代码骨架
import numpy as np, re

def read_hea(path):
    lines = [l for l in open(path) if l.strip() and not l.startswith('#')]
    name, nsig, fs, nsamp = lines[0].split()
    chans = []
    for s in lines[1:]:
        p = s.split()
        m = re.match(r'([\d.]+)\((-?[\d.]+)\)/(\S+)$', p[2])
        chans.append(dict(gain=float(m.group(1)),
                          base=float(m.group(2)),
                          unit=m.group(3),
                          name=p[8]))
    return dict(name=name, nsig=int(nsig), fs=int(fs),
                nsamp=int(nsamp), chans=chans)

def read_dat(hea_path, dat_path):
    h = read_hea(hea_path)
    raw = np.fromfile(dat_path, dtype='<i2')
    raw = raw[: h['nsamp'] * h['nsig']].reshape(-1, h['nsig'])
    out = {}
    for i, c in enumerate(h['chans']):
        out[c['name']] = (raw[:, i] - c['base']) / c['gain']
    return h, out
三步:解析头、按帧解交错、减基线除增益。别省第三步。
8.2 R 波与 S1 的时间差怎么算
流程:
- 从 ECG 通道检测 R 波(Pan-Tompkins 或更简单的阈值法都行,这份数据的心电质量总体可以);
- 从 PCG 通道检测 S1(在 R 波后 20 到 80 毫秒的窗口里找能量峰);
- 两者之差就是电机械延迟。
注意三件事:
- **必须逐拍算,不能整段平均。**延迟随心率变,整段平均会把变化抹平。
- **窗口要随心率调整。**心率快时延迟缩短,固定窗口会漏检。
- **饱和段要跳过。**十九条记录有饱和,饱和段的峰值位置不可靠。
8.3 划分策略:按人,不是按记录
二十四人、六十九条。按记录随机切会让同一个人的不同条件分到训练与验证两侧。
正确做法:
GroupKFold(n_splits=5, groups=subject_id)
但二十四人分五折,每折不到五人。这个划分的方差会很大,换一个随机种子结论可能就变。合理的做法是重复多次分组划分(比如十次不同的分组),报告均值与标准差,而不是单次结果。
另一个选择是留一法(Leave-One-Subject-Out),二十四个折。它没有随机性,但算二十四次训练,成本高。
8.4 指标怎么选
看任务:
- 心音分割:F1 与时间误差(毫秒)。别只看 F1,边界偏几十毫秒在临床上就是错的。
- 心率估计:与 ECG 心率的平均绝对误差(次每分)。这是有绝对标准的任务,误差可以直接解读。
- 电机械延迟:报告逐拍的分布,不是均值。中位数、四分位距、以及「延迟与 RR 的相关系数」。
- 质量分类:用表格的五列备注当弱标签,报宏平均 F1。注意
Good占多数,准确率没有意义。
8.5 五条失败模式
- 帧式交错读错:读出来的波形像噪声。检查方法:看 ECG 通道是否呈现规律的心搏形态。
- 忘除增益:跨记录比较幅度,得到随机结论。检查方法:随机取两条记录,比较静息段的心音峰值毫伏数,正常应当在同一量级。
- 按记录切分:验证集里出现训练集见过的人。表现是验证指标比测试高十几个点。
- 把短记录当长记录:八条三十秒记录混进去,把「平均时长」拉低。检查方法:按采样点数分组。
- 在饱和段算延迟:削顶的峰值位置随机,延迟估计变成噪声。检查方法:先看表格的
PCG Notes列。
8.6 一个贴合实际的最小实验
目标:验证「心率上升时,电机械延迟缩短,但缩短幅度小于 RR 的缩短幅度」。
- 取十一条 Bruce 跑台记录(分级递增,心率覆盖最宽);
- 逐拍检测 R 波与 S1,算 RR 与延迟;
- 按 RR 分箱,画延迟对 RR 的散点;
- 拟合斜率,与「斜率等于 1」的假设比较。
这个实验不需要深度学习、不需要大量算力,但它直接检验了这份数据的核心价值。如果斜率显著小于 1,说明机械系统有「缓冲」,这是生理学上说得通的结论。
8.7 一个容易被忽略的检查:饱和比例
每条记录的饱和比例 = 削顶样本数 / 总样本数。削顶判据:样本值等于 int16 上界 32767 或下界 -32768。
这个比例超过千分之一,就说明这段录音在运动最剧烈时丢失了信息。先算这个比例,再决定这条记录能不能进分析。
表格的备注是人工判断,饱和比例是机器判断,两者可以互相印证。核一遍两者是否一致,能发现备注漏标的情况。
8.8 别逐拍算显著性
逐拍算电机械延迟,会得到每条记录几百到上千个数。拿这些数去做 t 检验,是这份数据上最容易犯的统计错误。
原因:同一记录内的逐拍数据高度自相关(相邻两拍共享同一心率、同一负荷、同一体位)。按独立样本算 p 值,会把 p 压小几十倍。
正确做法:
- 先按记录聚合(每记录一个中位延迟),再对六十一条做检验;
- 或用混合效应模型,记录当随机截距;
- 或用分块置换,在记录层面打乱标签。
任何在拍层面报出 p 小于零点零零一的结论,都该重算。
8.9 双通道互相校验的做法
一个实用的技巧:用 ECG 算的心率去校验 PCG 的分割结果。
具体做法:以 ECG 的 R 波为锚,把每个心动周期切成固定长度的窗(比如 RR 的 1.2 倍),在这个窗里找 S1 与 S2。如果找到的 S1 位置落在 R 波前(物理上不可能),说明检测错了。
**这个校验不需要额外标注,纯靠物理约束。**它能筛掉大部分误检,成本极低。
§9 一个更宽的问题:为什么同步采集这么难
技术上,把心电和心音接到同一块板子上不难。难的是三件事:
**第一,两者的带宽差三个数量级。**心电的主要能量在 0.5 到 40 赫兹,心音在 20 到 400 赫兹,但 S1/S2 的瞬态含有上千赫兹的成分。要同时保住两者,采样率必须按高的那个定。这份数据选了八千赫兹,是心音上限的四倍过采样。
**第二,两者的幅度差两个数量级。**心电的 R 波是毫伏级,心音在胸壁上也是毫伏级,但经过听诊器导管衰减后是微伏级。要同时采,前端的增益必须分设——这正是条目页所说「心电通带增益 30 分贝、心音 5 分贝」的原因。
**第三,运动时两者的伪迹机制不同。**心电的伪迹主要来自电极-皮肤界面的阻抗变化(低频),心音的伪迹来自机械振动(宽带)。同一套滤波去不掉两者。
这三件事解释了为什么同步数据集这么少:**不是没人想做,是做了之后数据不好看。**这份数据的十九条饱和记录,就是「不好看」的证据。
但恰恰是这些不好看的部分,定义了这个领域的下一个问题:**运动中的心音,到底能不能用?**如果能,可穿戴心音监测就成立;如果不能,它就只能在诊室里做。
§10 术语与口径
| 术语 | 本页口径 |
|---|---|
| 记录 | 一条 .hea 加对应 .dat(及 .mat),对应一次采集 |
| 受试者 | S001 至 S024,二十四人 |
| 条件 / 场景 | 表格 Recording Scenario 列,五种负荷加混合方案 |
| 长记录 / 短记录 | 30 分钟 / 30 秒 |
| 帧 | .dat 里同一采样时刻各通道的一个点组成的一组 |
| 增益 | 每毫伏对应的整数计数,逐记录逐通道不同 |
| 基线 | 增益字段括号内的数,还原毫伏时须先减 |
| 电机械延迟 | ECG 的 R 波峰到 PCG 的 S1 起点之间的时间 |
| 饱和 | 样本值触及 int16 上下界,波形削顶 |
| 量化噪声电平 | 表格备注用语,指信号幅度低于量化台阶 |
| Good | 表格备注用语,仅指无饱和无断连 |
§11 事实清单
11.1 核心事实表
| 项 | 数值 | 来源 |
|---|---|---|
| 受试者 | 24(S001–S024,全部男性,23–29 岁) | 电子表格 |
| 记录数 | 69 | RECORDS / 头文件 / 表格三方一致 |
| 长记录 / 短记录 | 61 / 8 | 采样点数 |
| 总时长 | 30.57 小时(110,040 秒) | 采样点数 / 8000 |
| 采样率 | 8,000 赫兹(全部一致) | 头文件 |
| 通道数 | 5 路 58 条,2 路 11 条 | 头文件 |
| 通道名 | ECG、PCG、PCG2、AUX1、AUX2 | 头文件第九字段 |
| ECG 路数 | 每记录 1 路(非三导联) | 头文件逐条核对 |
| 格式 | 16 位有符号,裸二进制无头 | 头文件 |
| 总字节 | 约 11.3 GB(WFDB 8.0 + MAT 3.3) | 对象清单 |
| 对象总数 | 212 | S3 清单 |
| 增益范围 | ECG 32,775–167,767;PCG 32,904–64,248 | 头文件 |
| PCG2 增益中位 | 8,141,636(满量程 3.2 微伏) | 头文件 |
| 初值与基线不一致 | 296 / 312 个通道 | 头文件逐通道比对 |
| 三方清单差异 | 0(记录名、通道数、时长) | 交叉核对 |
| 心电质量备注 | Good 36 条,其余 33 条有问题 | 表格 |
| PCG 质量备注 | Good 50 条,饱和 13 条 | 表格 |
| PCG2 备注 | 量化噪声电平 55 条 | 表格 |
| AUX2 备注 | 量化噪声电平 58 条 | 表格 |
| 场景分布 | 休息 19、骑行 13、步行 13、Bruce 11、自行车负荷 10、混合 3 | 表格 |
| 每受试者记录数 | 最多 8(S009),10 人各 1 条 | 表格 |
| 重录替换记录 | 4 条(0001、0002、0003、0040) | 表格 Housekeeping 列 |
| 异常心电标注 | 1 条 | 表格 ECG Notes |
11.2 可立即验证的疑问
- **为什么头文件只有一导心电,而条目页写三导联?**是数据裁剪,还是发布时的简化?
- **「62 条 30 分钟记录」与实际 61 条差在哪?**笔误还是有一条被漏算?
- **增益归一化的规则是什么?**逐记录最大值归一?那为什么 PCG2 会归一到一个几乎无信号的值?
- **
(PG)这个标记指谁?**采集者缩写?没有对照表。 - 自建设备做过幅度标定吗?「毫伏」是量出来的还是按设计算的?
- **同一受试者的不同条件在同一天吗?**表格无日期字段。
- **那条
Abnormal ECG是什么异常?**唯一的异常标注,没有类型说明。 - **PCG2 到底有没有一点信号残留?**需要波形层核实,本页只看了头部字节。
11.3 证据链
- 对象清单:S3 ListObjectsV2 单次返回 212 个对象,无截断标记;按扩展名统计为
.hea69、.dat69、.mat69、.csv1、.txt2、.m1、RECORDS1。 - 头文件:69 个
.hea全部解析,首行四字段与每行九字段逐项统计;通道数、采样率、格式、通道名、增益、基线、初值全部提取。 - 电子表格:
ECGPCGSpreadsheet.csv六十九行十三列全部解析,受试者、场景、时长、通道数、五列质量备注逐项统计。 - 三方比对:记录名集合、通道数、时长三组关系逐条验证,零差异。
- 二进制抽查:对两条记录(两通道与五通道各一)以 HTTP Range 请求抓取头部二百五十六字节,按 int16 解包,确认帧式交错与各通道一阶差分统计量。
- 未下载:11.3 GB 波形。信噪比、饱和比例、实际心搏数三项未核。
编辑说明
本页依据 PhysioNet 条目页(https://physionet.org/content/ephnogram/1.0.0/)的公开表述撰写,完整下载并解析了全部 69 个头文件、电子表格、RECORDS 与校验文件,并以 Range 请求抽查了两条记录的二进制头部。未下载 11.3 GB 波形。
需要说明的几处判断:
一是关于导联数。条目页两处写「three-lead ECG」,头文件里每条记录只有一路 ECG。本页采信头文件,因为这决定了代码怎么写。同时说明硬件可能支持三导联而发布数据做了裁剪,不推断裁剪原因。
二是关于记录数。条目页写「30 分钟记录 62 条」,实际核出 61 条长记录加 8 条短记录。本页按采样点数判定,不采信条目页的 62。
三是关于增益。每个记录的每路增益都不同,这不是错误,是正常的归一化做法;但本页指出它带来的后果——跨记录幅度不可比,以及 PCG2 被归一化到满量程仅 3.2 微伏这一反常结果。后者由头文件增益直接推出,并用头部字节的一阶差分验证了噪声形态。
四是关于初值与基线。296 个通道不一致,本页只报事实并提示「基线取括号内那个数」,不推测不一致的原因。
五是关于辅助通道。AUX2 五十八条全部标注量化噪声,PCG2 五十五条同样。本页据此判定「噪声抵消方向在这份数据上做不成」,同时明确标注这个判定只基于头部字节,未做全波形核实。
六是关于人群。全部男性、23 至 29 岁、健康志愿者。这是硬限制,不是可打折的软限制。
未验证的部分:实际饱和比例;心搏总数;波形层的信噪比;设备的幅度标定;同一受试者不同条件的采集日期;(PG) 标记的含义;Abnormal ECG 的具体类型。
编辑说明(核对方式)
核对时间:2026-10-20。核对方式:S3 免签名直连十六并发下载全部头文件与表格(348 KB),二进制抽查用 HTTP Range 请求抓前二百五十六字节,不经 WFDB 库以避免库层对非标准第九字段(通道名)的容错掩盖问题。三方清单比对与头文件解析均用自写解析器。全部中间结果与脚本未随本页发布。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- qol-stress — 共享标签:生理信号 / 心电信号 / 多模态 / 可穿戴传感
- cardiowave-portable — 共享标签:生理信号 / 心电信号 / 多模态 / 可穿戴传感
- dreamer — 共享标签:生理信号 / 心电信号 / 多模态 / 可穿戴传感
- wesad — 共享标签:生理信号 / 多模态 / 可穿戴传感
- wearable-exercise-frailty — 共享标签:生理信号 / 心电信号 / 可穿戴传感
- heartcycle — 共享标签:生理信号 / 心电信号 / 多模态
- pulsedb — 共享标签:生理信号 / 心电信号 / 可穿戴传感
- cgmacros — 共享标签:生理信号 / 多模态 / 可穿戴传感
- ou-dataset-t1d — 共享标签:生理信号 / 多模态 / 可穿戴传感
- tame-pain — 共享标签:生理信号 / 多模态 / 可穿戴传感
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
