即取即用的 AI-Ready 医疗数据集库

致力于为医疗 AI 研究人员找到合适的数据集。已收录 1,952 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。

需要具备完整溯源、伦理合规与工程化交付的专病训练集?进入医疗数据商城 →

按工程化层级:

数据标签

官方自营 · 合规交易

千方医数集 · 商业级 AI-Ready 数据集

查看全部商业数据
影像服务最快 4 周

乳腺阳性影像数据集

乳腺钼靶阳性病例影像数据,覆盖肿块、钙化等典型征象,面向乳腺 AI 辅助筛查模型训练。

去商城获取 →
影像服务最快 4 周

TCT 宫颈细胞学数据集

液基薄层细胞学(TCT)数字图像,含阴阳性判读结果,适配宫颈癌细胞学筛查模型。

去商城获取 →

需要更多专病队列?

千方医数集支持按病种、模态合规定制采集。

提交定制需求

医学影像 AI-Ready 数据集

电子病历与文本数据集

病灶分割与标注数据集

共 843 个数据集

MedS-Ins — 面向医学大模型的大规模指令微调语料:58 个语料库、500 万实例、1.9 万条指令
医疗NLP医学问答与基准临床文本医学考试评测基准

MedS-Ins — 面向医学大模型的大规模指令微调语料:58 个语料库、500 万实例、1.9 万条指令

指令微调文本语料知识库未披露(数据集为指令-实例对语料,非患者级队列;官方口径 500 万实例(instances)/ 1.9 万条指令(instructions),据此可复核)

上海交通大学与上海 AI Lab 联合中国移动发布的首个全面医学指令微调数据集(与 MedS-Bench 基准、MMedIns-Llama 3 模型成对发布)——整合 58 个生物医学语料库,覆盖考试、临床文本、学术论文、医学知识库、日常对话五大来源共 122 项任务;现行口径计 500 万实例 + 1.9 万条指令(v1 论文因「指令与实例组合各计一样本」曾计 13.5M,双口径详见表),仓库许可 CC BY-SA、论文版权 CC BY 4.0,HuggingFace 公开约 7.58 GB
Speech Commands Dataset — 105,829 条 1 秒关键词识别音频语料
生理信号语音信号评测基准图像分类

Speech Commands Dataset — 105,829 条 1 秒关键词识别音频语料

原始数据公开数据集非患者数据;2,618 名众包志愿者说话人(无性别/族裔等人口学属性采集)

Google Brain 发布的限定词表语音识别基准:35 个英文单词 + 背景噪声,2,618 名说话人,1 秒 16kHz WAV,CC BY 4.0 公开——端侧关键词识别的经典训练与评测集
QMugs — 类药物分子量子力学性质数据集
药物发现与化学多模态评测基准

QMugs — 类药物分子量子力学性质数据集

原始数据计算生成数据结构化数据不适用(计算化学数据集,非患者数据)

ETH Zurich RETHINK 组从 ChEMBL 提取 665,911 个类药物分子、生成 1,992,984 个构象,在 GFN2-xTB 与 DFT(ωB97X-D/def2-SVP)双理论级别上计算能量、部分电荷、转动常数乃至 DFT 密度与轨道矩阵波函数,未压缩逾 7 TB——首个面向类药物大分子的第一性原理量化数据集合,为 Δ-learning 与构象感知的量子机器学习铺路,Sci Data 2022 开放获取
MD22 — 42 至 370 原子生物大分子的 DFT 轨迹与力场基准
药物发现与化学量子化学分子性质预测评测基准基因组学与多组学

MD22 — 42 至 370 原子生物大分子的 DFT 轨迹与力场基准

模拟数据原始数据开放数据不适用(非人类受试数据;7 个分子体系 / 323,422 个构型 / 23,716,460 原子-帧)

MD17 的大体系升级版——7 个生物大分子/超分子(四肽、脂肪酸、四糖、DNA 碱基对、巴基球捕捉器、双壁纳米管)的 FHI-aims + i-PI 从头算 MD 轨迹,含 DFT-PBE+MBD 势能与原子受力标签,共 32 万余构型,CC0-1.0 于 sgdml.org 公开
Open Catalyst 2020 — Meta FAIR 与 CMU 的亿级 DFT 电催化数据集
药物发现与化学量子化学分子性质预测化学信息学分子生成

Open Catalyst 2020 — Meta FAIR 与 CMU 的亿级 DFT 电催化数据集

计算模拟物理化学性质原始数据不适用——非临床数据集;规模口径为 1,281,040 次 DFT 弛豫 / 约 264,890,000 次单点计算 / 460,328 个 IS2RE/IS2RS 体系 / S2EF 训练集 133

Meta FAIR 与 CMU 合建的异相电催化开放数据集:1,281,040 次 DFT 弛豫、约 2.65 亿次单点计算、460,328 个吸附质-催化剂体系与 133,934,018 帧 S2EF 训练数据,CC BY 4.0 全开放,定义了 AI for Science 时代材料模拟数据集的规模标杆
CSAR — 社区结构-活性资源基准数据集
药物发现与化学化学信息学分子对接虚拟筛选评测基准药物-靶点相互作用

CSAR — 社区结构-活性资源基准数据集

实验测定结构数据专家整理非患者数据集:2010 基准集 343 个蛋白-配体复合物;CSAR-NRC HiQ 176+167 个复合物(52 靶点多结构+191 单结构);2012 数据集 6 个蛋白靶点、757 个化合物(

美国国立卫生研究院资助、密歇根大学 Carlson 团队主持的社区结构-活性资源:以 Binding MOAD 与 PDBbind 精选 343 个高质量蛋白-配体复合物及 Kd/Ki 亲和力构建 2010 基准实验,衍生 CSAR-NRC HiQ 与 2012 制药数据捐赠集,成为分子对接打分函数评测的公共标尺
AqSolDB — 9982 化合物水溶性参考数据集
药物发现与化学化学信息学分子性质预测评测基准

AqSolDB — 9982 化合物水溶性参考数据集

原始数据开源软件公开数据9982 个唯一化合物(非患者数据);HuggingFace 社区镜像 train 7488 / test 2494

荷兰 DIFFER 研究所 AMD 团队从 9 个公开数据集系统性策展出的最大开放水溶性参考库——统一 LogS 单位、SMILES 往返校验、多源竞争值统计选值算法加 RDKit 二维描述符,成为分子性质回归的经典基准
GEOM — 45 万分子、3700 万构象的能量标注分子几何系综数据集
药物发现与化学化学信息学分子性质预测分子生成量子化学虚拟筛选

GEOM — 45 万分子、3700 万构象的能量标注分子几何系综数据集

计算生成实验标注原始数据不涉及人类受试者;450,000+ 分子物种 / 约 37,000,000 条构象

哈佛大学 Axelrod 与 MIT Gómez-Bombarelli 团队以 CREST 采样与半经验 DFT 生成的 Geometric Ensemble Of Molecules:覆盖 QM9 133,258 个小分子与 317,928 个带实验数据的药物类/生理类物种,另含 1,511 个 BACE-1 抑制剂的高精度隐式水 DFT 自由能标注,是 3D 分子机器学习时代构象生成与预训练的基石数据集
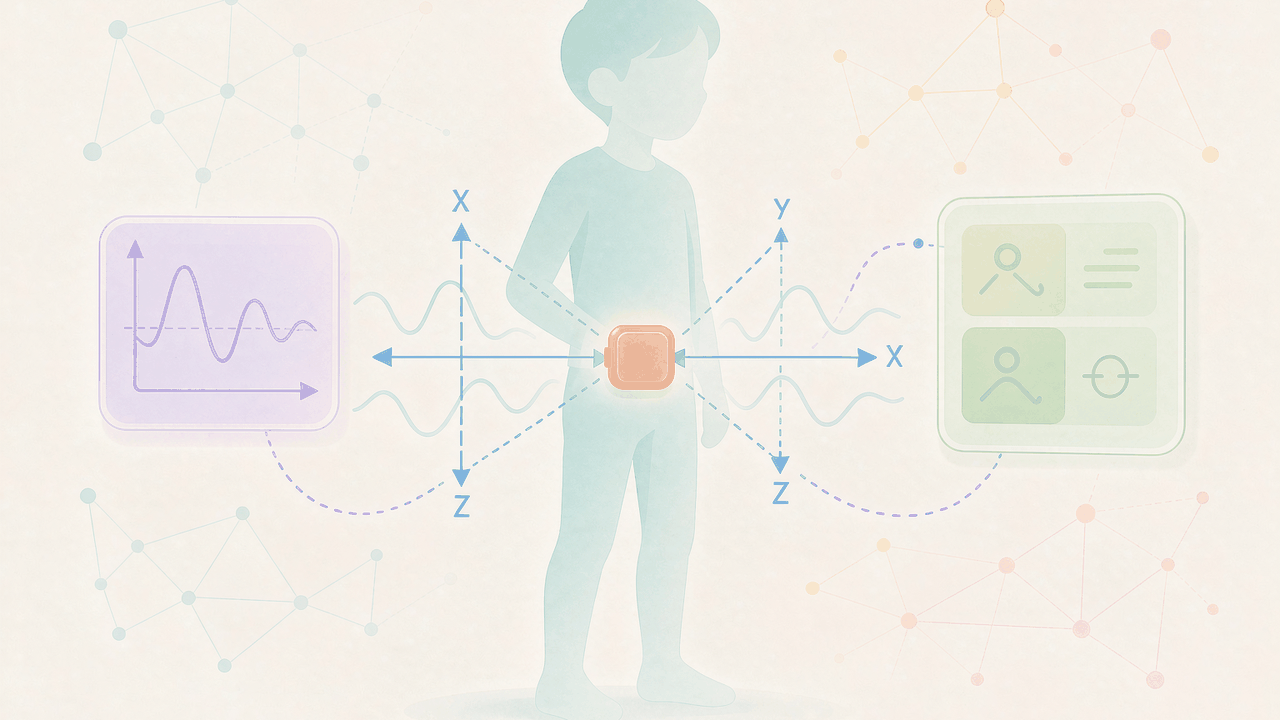
SisFall — 可穿戴惯性传感跌倒检测数据集
生理信号可穿戴传感步态与运动时序数据评测基准

SisFall — 可穿戴惯性传感跌倒检测数据集

原始数据时序数据传感器数据38 名受试者(青年组 23 人 19-30 岁 + 老年组 15 人 60-75 岁,含 60 岁参与者 SE06)

哥伦比亚安蒂奥基亚大学自研腰部佩戴设备(双加速度计+陀螺仪,200 Hz)采集 38 名受试者的 19 种日常活动与 15 种模拟跌倒共 4504 条记录,是跌倒检测领域最常被引用的公开惯性传感器基准数据集
GLOBEM — 多年纵向可穿戴感知与心理健康数据集
生理信号可穿戴传感睡眠信号队列研究评测基准神经科学

GLOBEM — 多年纵向可穿戴感知与心理健康数据集

时序数据调查数据真实世界数据705 人年(person-years);497 唯一参与者;四年子集 INS-W_1=155 / INS-W_2=218 / INS-W_3=137 / INS-W_4=195

首个公开四年(2018-2021)被动移动与可穿戴感知数据集:705 人年 / 497 唯一参与者 / 24×7 追踪六类传感器流,以抑郁检测为起点基准 18 种算法,揭示行为模型跨数据集泛化的普遍坍塌
TUH Abnormal EEG Corpus — 天普大学异常脑电语料库 · 临床正常/异常二分类基准
生理信号脑电信号癫痫评测基准

TUH Abnormal EEG Corpus — 天普大学异常脑电语料库 · 临床正常/异常二分类基准

原始数据临床数据人工标注2,993 条 EDF 记录 / 2,383 名受试者(官方 AAREADME 表:Normal 1,385 + Abnormal 998);eval 253 唯一受试者 / train 2,076

天普大学医院 2002-2017 临床 EEG 中 2,993 条已判读记录、2,383 名受试者构成的正常/异常二分类子语料——由 López 2017 硕士论文建立、NEDC 维护至 v3.0.1,是 EEG 病理筛查的起步基准,并衍生出 TUABEX/TUABEXB/AutoTUAB 扩展谱系
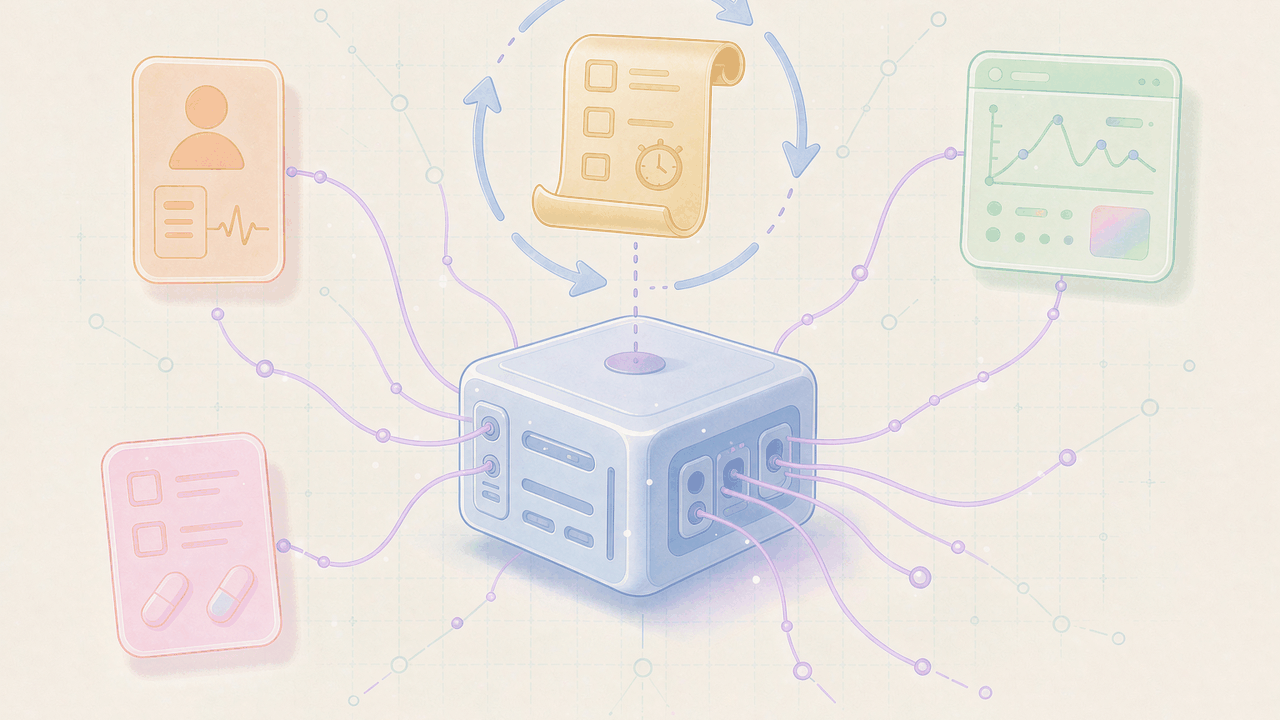
MedAgentBench — 虚拟 EHR 环境下的医学 LLM 智能体评测基准
电子健康记录医学问答与基准临床电子病历评测基准医疗NLP

MedAgentBench — 虚拟 EHR 环境下的医学 LLM 智能体评测基准

合成数据文本数据结构化数据人工标注100 例去标识化患者档案(unique individuals=100;平均年龄 58.15±19.82 岁;女性 47%);数据点 785,207 条;时间跨度近 5 年(截止 2018-11-1

斯坦福团队构建的医疗智能体交互式基准:300 个医生撰写任务 × 100 例去标识化 STARR 患者 × 785,207 条 FHIR 记录 × 9 个检索/开单函数,12 个前沿 LLM 在 pass@1 下最高仅 69.67%,首次把医疗 AI 评测从「静态问答」推向「多轮工具调用」

定制数据集服务

无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。