即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 1384 个数据集
Complex Portal — 两万个蛋白复合物,写着每个零件有几个
20,580 个复合物、27 个物种、人类占 2,436 个:这是目前唯一一个把「化学计量」写进数据的蛋白机器目录,也是 STRING 与 IntAct 都缺的那一层
GBIF — 四十亿条物种出现记录,七成七是动物,一成二是公民科学
3,983,162,286 条记录、124,867 个数据集、48,872,354 个物种:这是全世界最大的生物多样性出现记录网络,也是唯一一个靠博物馆标本和手机照片共同撑起来的库
ENA — 八十拍字节的核酸总账,四千万次测序的入口
1,098,568 项研究、55,877,279 个样本、44,433,186 次测序运行:INSDC 欧洲节点,从 1980 年的一条序列长到今天
IMGT — 十二万条等位基因的命名权威,没有 API
12,922 个基因、18,322 个等位基因、42 个物种:从 1989 年起,谁有资格给一个抗体基因命名,归这个库说了算
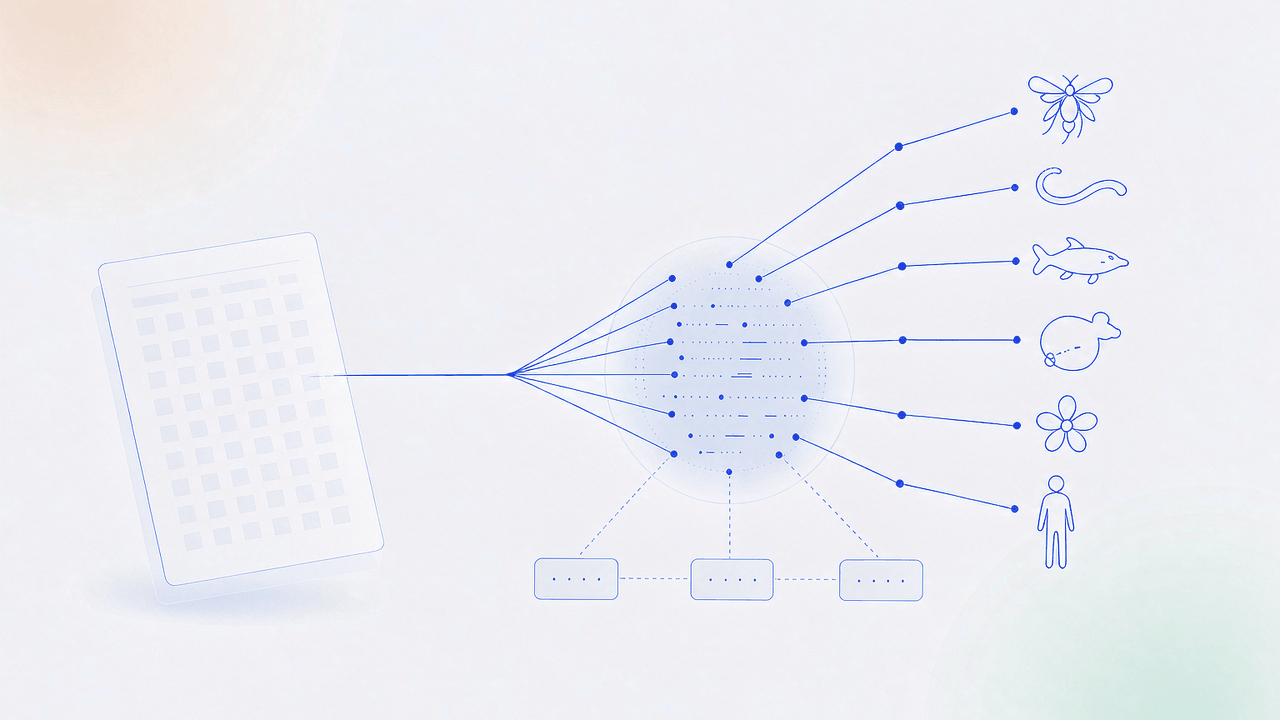
Alliance of Genome Resources — 九物种联盟,五成七是重复行
56,677,795 个实体、1,909,959 条表型注释、23.04 GB 下载:八个模式生物库合并成一个库之后,字段统一了,语义没有
BV-BRC — 一千七百万个病原基因组,九成是病毒
17,061,503 个基因组、89.6 亿条注释特征、8.69 亿条专项基因:NIAID 把细菌与病毒两个数据库焊在一起之后,数据长成了什么形状
MGI — 小鼠成为人类疾病模型的那本账
75,252 个基因、141,808 个突变等位基因、415,358 条表型注释:一个只服务一个物种、却支撑半个生物医学的知识库
IPD-IMGT/HLA — 免疫遗传学的命名权威
47,424 个官方命名的 HLA 等位基因:从 1998 年的 964 个到今天的超多态体系
Dryad — 论文附录数据的第一落点
CC0 强制的通用数据存储库:2024/25 财年 65,786 个已发布数据集、5,000 万+ 文件、全部 DOI 化
IBL Brain-Wide Map — 小鼠全脑决策活动图谱
12 个实验室、139 只小鼠、69.9 万次探针插入,拼出一张全脑活动图
DANDI Archive — 神经电生理数据联邦档案库
它不是一个数据集,是上千个数据集的容器。首页写着一千零五十九个、九百二十二太比特,同一个站的 API 却报九百三十八、一千二百零九;四个官方来源给出四个规模数字。这个库真正值得学的是它怎么把「版本」和「许可」做成硬约束
UPenn-Mayo — 颅内脑电癫痫检测挑战赛
十二个受试者、四只狗、八个人、一秒一段。它用一场 Kaggle 竞赛把癫痫检测的算法门槛一次性抬到 AUC 0.96,也留下了一个更难堪的后续:前三名里有两个换一份数据就跌回随机水平
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
