即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 1434 个数据集
OncoKB — 全球首个获 FDA 认可的肿瘤体细胞变异临床注释知识库
MSK 维护的精准肿瘤知识库:1,033 基因 / 11,515 体细胞变异 / 143 癌种 / 171 药物的循证注释,Levels of Evidence 七档体系与 AMP/ASCO/CAP 共识 1:1 对齐,2021 年获 FDA partial recognition,学术免费、商业合同制,REST API 与签约 JSON 快照双通道获取
Head-Neck-PET-CT — 蒙特利尔与舍布鲁克四中心 298 例头颈癌治疗前 PET/CT 影像组学合集 — 1615 特征×三特征组×复发/转移/生存三终点基准
Vallières 团队 2017 年发布于 TCIA 的头颈鳞癌影像组学基准:298 例患者 72.46GB DICOM(CT/PT/RTSTRUCT/RTDOSE/RTPLAN/REG 六模态),配 CC BY 3.0 临床结局与 GTV 轮廓表、GNU GPL 特征提取源码;GTV 原发灶+淋巴结双 ROI,1-5mm 五档体素×2 量化×4 灰阶共 40 参数组合提取每模态 1615 特征,局部区域复发/远处转移/总生存三终点基线 AUC 0.69/0.86
Drug Repurposing Knowledge Graph — AWS 与明尼苏达等四方共建的药物重定位知识图谱:97,238 实体与 587 万三元组整合六大数据库直击 COVID-19 老药新用
Drug Repurposing Knowledge Graph——AWS AI labs、明尼苏达大学、俄亥俄州立大学与湖南大学 2020 年联合发布的综合生物医药知识图谱,把 DrugBank、Hetionet、GNBR、STRING、IntAct、DGIdb 六大公开数据库与 COVID-19 文献抽取三元组归一整合为 13 类实体、107 种关系,配套 TransE_l2 400 维预训练 embedding 与 DGL-KE 工具链,开源后成为药物重定位研究的标准底座之一
LapGyn4 — 妇科腹腔镜图像四任务基准:手术动作、解剖结构、动作-解剖对应与器械计数,AAU Klagenfurt 从 500+ 台手术提取 59,621 张图
LapGyn4 是 Alpen-Adria 大学 ITEC 与 Ulm 医学院发布的妇科腹腔镜图像数据集(The ITEC LapGyn4 Gynecologic Laparoscopy Image Dataset),从 500+ 台手术视频提取 59,621 张图(v1.2),拆为手术动作、解剖结构、部位动作判别、器械计数四个子集,配套 5-fold 划分(仅 v1.0)与首个 baseline,CC BY-NC 4.0 仅供科研
DementiaBank English Pitt Corpus — 语音阿尔茨海默检测的事实标准语料库
匹兹堡大学 1983-1988 年阿尔茨海默纵向研究的语音遗产:约 33 小时访谈音频加 CHAT 逐句转写,Cookie Theft 图片描述为主任务,经 CMU TalkBank 会员制发放四十年,孵化 ADReSS 与 ADReSSo 两个国际挑战赛(百度研究院夺魁 ADReSS),是语音自动痴呆检测论文引用最密集的语料库
cMedQA v2.0 — 中文社区医疗问答匹配数据集
国防科技大学团队从寻医问药网采集的中文医疗问答答案选择基准——v1.0 字符级多尺度 CNN(Appl. Sci. 2017)到 v2.0 多尺度注意力交互网络 MPAN(IEEE Access 2018),108,000 问配 203,569 答、候选池机制产生任务标签,2017-2020 年中文医疗问答匹配事实标准评测集,reranker 时代仍在活跃服役
Huatuo-26M — 2600 万级中文医疗问答数据集
CUHKSZ FreedomIntelligence 团队发布、截至发布时全球最大的中文医疗问答数据集:26,504,088 条 QA 对来自在线问诊记录、医学百科与知识图谱三源,检索/生成双基准,四大应用(LLM 微调、RAG、零样本迁移、持续预训练),Apache 2.0 公开并衍生 Huatuo-Lite 精修子集
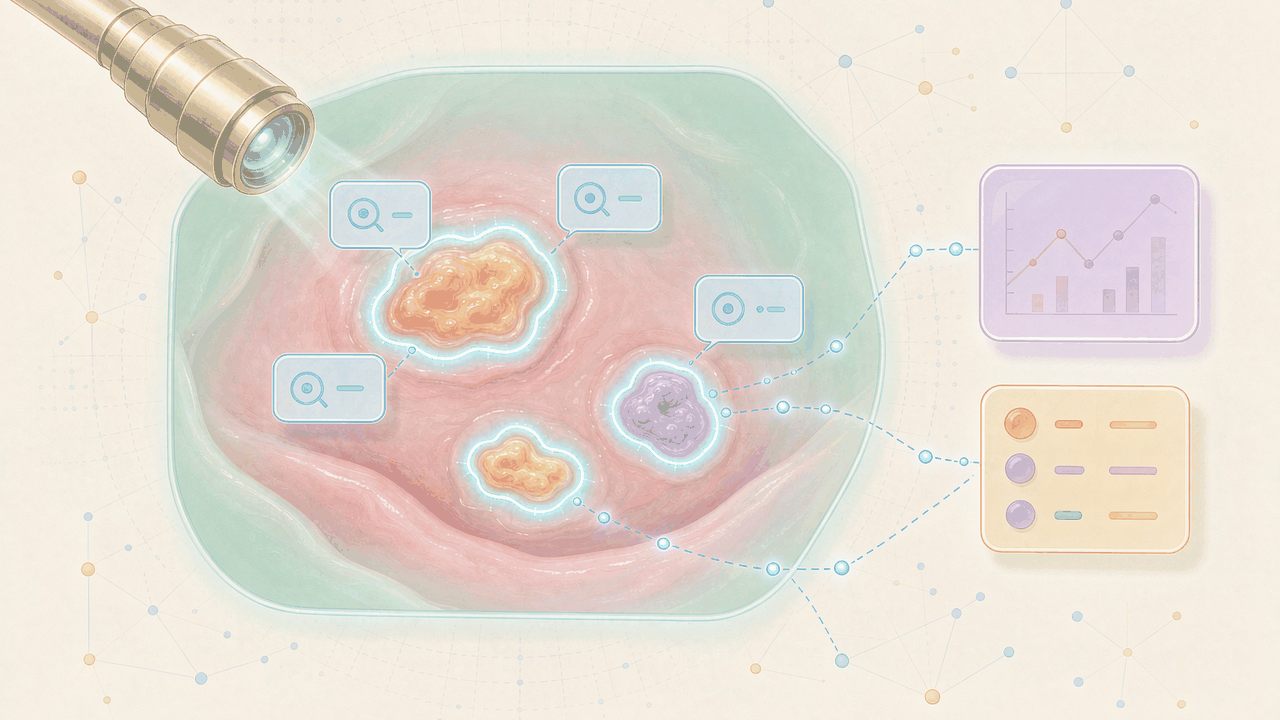
GLENDA — 妇科腹腔镜子宫内膜异位症病灶标注数据集
Klagenfurt 大学 ITEC 联合 LMU/Ulm 妇产科发布的妇科腹腔镜子宫内膜异位症病灶区域标注集:从 400+ 台真实手术视频语料池中截取病灶帧与序列,v1.0 矩形框+二元掩码、v1.5 多边形精细轮廓两代发布,五类 rASRM 风格病灶分型(peritoneum/ovary/uterus/DIE/no pathology),自带诚实低基线(mAP ≤0.030),是医学视频领域少见的疾病特异性标注集
PPB-Affinity — 面向 AI 蛋白质药物发现的蛋白-蛋白结合亲和力数据集
整合 SKEMPI v2.0 / PDBbind v2020 / SAbDab / ATLAS / Affinity Benchmark v5.5 五大来源,汇聚 3032 个 PDB 条目、12062 条带结构-突变-链信息的蛋白-蛋白结合亲和力(pKD/ΔG)标注样本,并配套不变点注意力(IPA)基线模型与 AlphaFold3 结构子集
ProteinGym — 蛋白质突变适应度预测大规模基准
牛津 OATML × 哈佛 Marks 实验室出品的蛋白质适应度预测与设计基准套件:聚合 217 个深度突变扫描替换 assay(约 250 万突变体)与 66 个插入缺失 assay(约 30 万突变体),叠加 ClinVar 专家注释的临床基准,以 MIT 许可开源代码、数据、MSA、结构与 70+ 模型预测分数
Mother of All BCI Benchmarks — 脑机接口算法可复现性聚合基准
EEG 领域迄今最大规模的 BCI 算法基准框架——把 36 个公开数据集(MI 14 / P300 15 / SSVEP 7)用统一接口装载、30 条机器学习流水线(Raw 11 + Riemannian 13 + DL 6)统一评价、统计元分析汇总,得出「Riemannian 几何在数据稀缺区间全面领先深度学习」的可复现结论
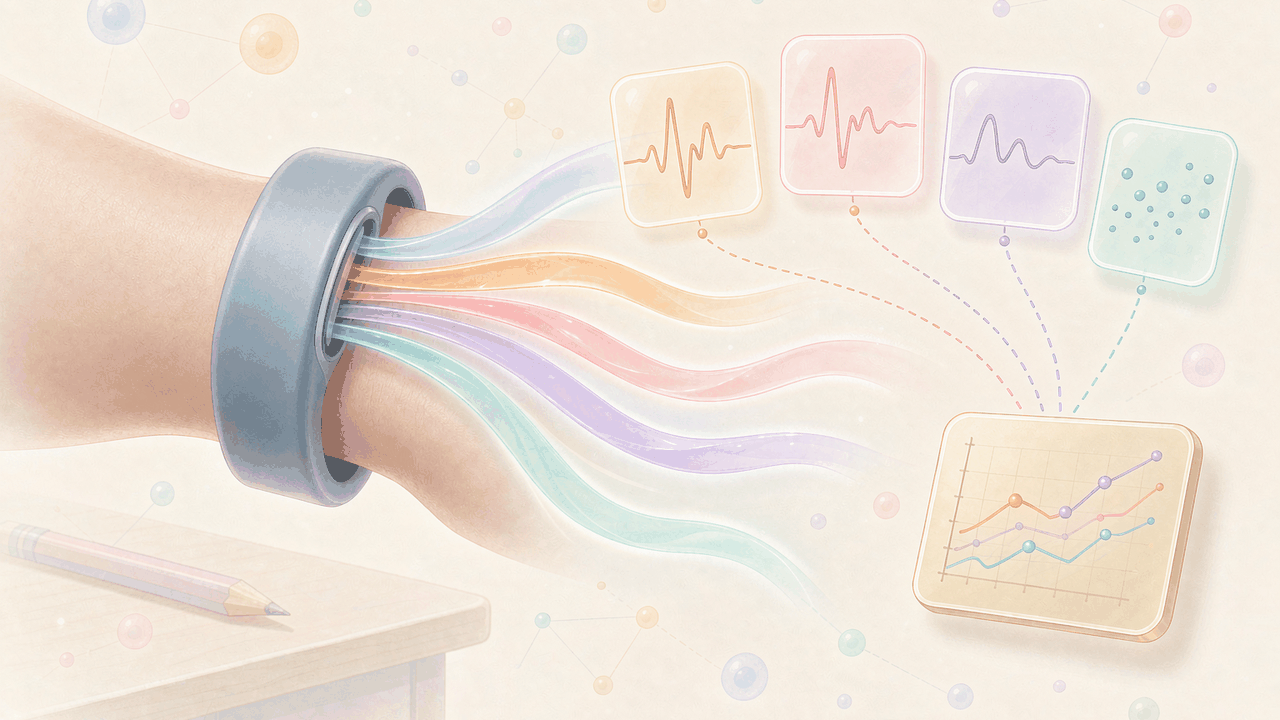
A Wearable Exam Stress Dataset — 真实考场可穿戴生理信号与认知表现数据集
休斯顿大学 Faghih 组用 Empatica E4 腕带在真实考场采集 10 名学生三次考试的多模态外周生理信号(EDA/HR/BVP/TEMP/IBI/ACC),配成绩标签用于预测认知表现——ODC-By-1.0 完全开放,是 WESAD 式实验室数据集的真实世界对照
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
