信息速览
INFOBOX — A Wearable Exam Stress Dataset 一屏速览
维度 内容 本质 真实考场场景可穿戴生理信号数据集(区别于 WESAD 式实验室诱导),用于预测认知表现/成绩 团队 University of Houston 计算医学实验室;通讯/资深作者 Rose T. Faghih(现 NYU Tandon);3 作者 数据发布 PhysioNet v1.0.0,2022-05-26;DOI 10.13026/kvkb-aj90 原始论文 IEEE HI-POCT 2022,doi:10.1109/HI-POCT54491.2022.9744065(会议 2022-03-10/11,Houston) 规模 10 名大学生(2 女 + 8 男);每人 3 场考试,共 30 场记录 设备 Empatica E4 腕带(FDA 批准),佩戴非惯用手 信号 EDA / HR / BVP / TEMP / IBI / ACC 六类多模态外周生理信号 考试 3 场:Midterm 1、Midterm 2(各 1.5 h)、Final(3 h),均 9:00 AM(CT/CDT)开始 标签 考试场次 + 成绩(StudentGrades.txt);无逐刻情绪标注 论文结果 EDA 趋势线 + 9 工程特征 → 成绩高低二分类,最高准确率 70-80% 复现基准 第三方:Transformer 全模态报 96%;HRV 特征选择做外部验证 获取 Open Access 无门槛:ZIP 直下 / wget / aws s3 sync(physionet-open 公共桶)许可 ODC-By-1.0(署名即可,含商用);82.1 MB 库内互链 WESAD(67)、DEAP(332)、VitalDB(192)、MHEALTH(222)、PPG-DaLiA(202)
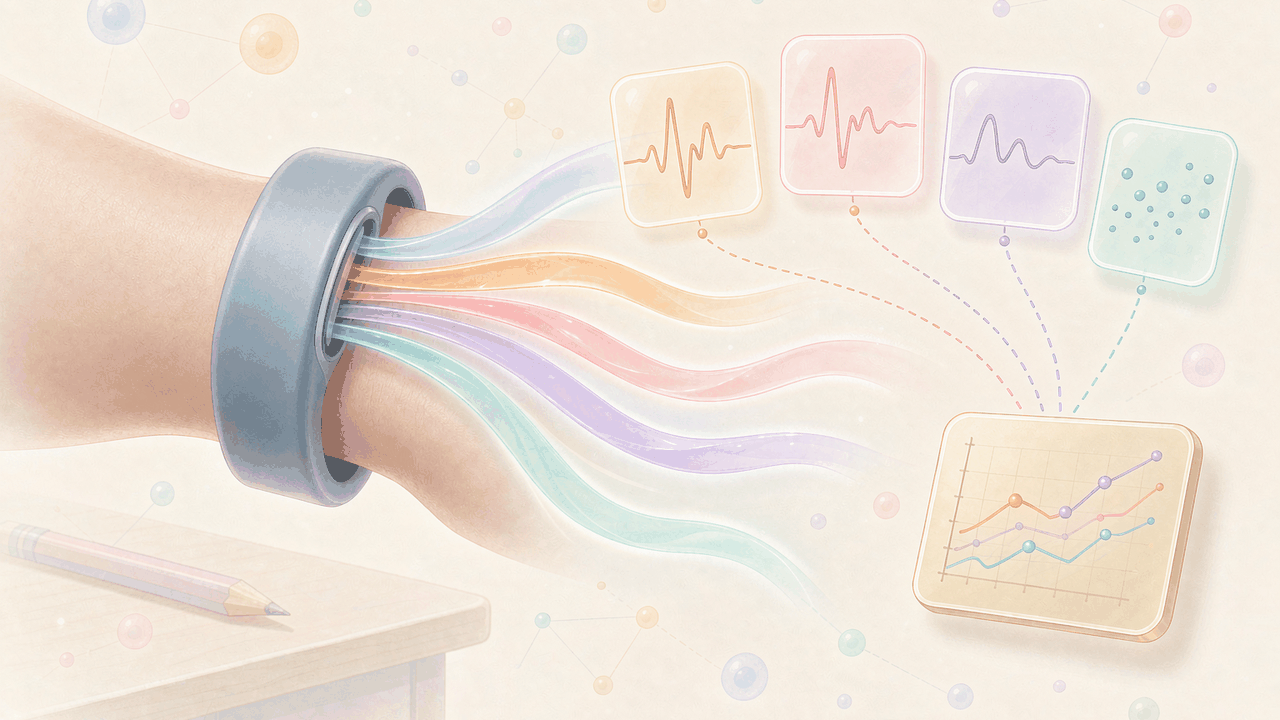
“A Wearable Exam Stress Dataset” 是一个"把实验室搬进考场"的数据集:它不做人工电击、不放恐怖视频、不制造社交压力,只是让 10 名大学生戴上 FDA 批准的 Empatica E4 腕带,走进真实的期中考与期末考场,然后记录他们的皮肤电、心率、脉搏、体温和手部运动。它回答的问题很直接——在真实、无法控制、充满运动伪影的考场里,腕上这几路信号到底能不能预测一个人的考试成绩? 在它之前,可穿戴压力识别研究几乎都建立在实验室诱导数据(如 WESAD 的 TSST 任务)之上;它提供的正是缺失的那块"真实世界对照"。
导语读法三则:
- 只想下数据:直奔 §6 获取与许可——ODC-By-1.0、Open Access、82.1 MB,无需申请,
wget/aws s3均可。 - 关心 WESAD 与它的区别:直奔 §3.4 与 §7 的对照——一个是实验室诱导、一个有明确情绪标签;一个是真实考场、只有场次+成绩弱标签。
- 做可穿戴压力监测:直奔 §4 信号构成与 §5 任务设定——注意 10 人小样本与运动伪影,先读"提示性而非显著"的告诫。
§0 导读:这个数据集解决什么问题
可穿戴压力识别是情感计算与移动健康的重要方向,但它长期被一个结构性问题困住:训练数据几乎全部来自实验室。研究者让被试坐在安静的房间里,用电击、噪声、恐怖图片或公开演讲任务(如 TSST)人为诱发压力,再记录皮肤电与心率。这样的数据干净、可控、有明确的时间标签——却也远离真实。真实世界里的压力发生在通勤地铁上、deadline 前、考场里,伴随持续的身体运动、姿势变化、环境噪声与社交不确定性,这些恰恰是实验室数据回避掉的东西。
最直接的人体压力信号是皮肤电活动(EDA),也叫皮肤电导(skin conductance, SC):汗腺受交感神经支配,情绪唤起时出汗增多,皮肤电阻下降、电导上升。EDA 便宜、易测、有生理机制支撑,是消费级腕带(如 Empatica E4)的核心传感器之一。问题在于,实验室里 EDA 的"压力反应"清清爽爽,真实考场里却混着握笔、翻卷、调整姿势带来的运动伪影。
本数据集正是为堵上这个缺口而生:考点固定(考试)、场景真实(考场)、被试纵向追踪(同一批人三次考试)、标签明确(考试成绩)。它由 University of Houston 的 Faghih 团队采集,2022 年发布在 PhysioNet,采用最宽松的 ODC-By-1.0 许可,任何人都能一键下载 82.1 MB 的完整数据。
§0 读法三则:
- 这个条目是"真实世界可穿戴数据集 + 一篇会议论文 + 一套可复现的处理代码"的组合:三者许可与获取方式简单统一(都开放),不像很多数据集存在多层异构许可。
- 全文硬数字来自三源互证:PhysioNet 官方页(规模/信号/许可)、IEEE HI-POCT 论文(10 人/70-80% 准确率)、第三方复现论文(96%/外部验证)。
- 检索时务必与 WESAD 区分:两者都涉及可穿戴+压力+Empatica E4,但一个是实验室诱导、一个是真实考场,样本量与标签体系都不同(§3.4、坑 1)。
§1 数据集速览:十问十答
Q1:“A Wearable Exam Stress Dataset” 的"真实世界"体现在哪?
数据在真实考场采集——学生正常参加期中考与期末考,设备在考试全过程中记录生理信号。无人工刺激、无诱导任务、无受控环境,因此信号里天然含运动伪影与考场噪声,这正是它与实验室数据集最大的区别。
Q2:招了多少人、几次考试?
10 名大学生(休斯顿大学一门电路分析课程的学生;构成为 2 女 + 8 男,但数据中不标注性别以去标识)。每人参加 3 场考试:Midterm 1、Midterm 2 各 1.5 小时,Final 3 小时;共 30 场考试记录。
Q3:用的什么设备?
Empatica E4 腕带(FDA 批准的科研级可穿戴设备),佩戴于非惯用手腕部。设备以 tag number 分发——考生入场领设备、在对应名单签名,考后归还;教师再按设备号提供成绩,实现生理信号与成绩的对应。
Q4:采集了哪些信号?
六类:皮肤电活动(EDA)、心率(HR)、血容量脉搏(BVP)、皮肤表面温度(TEMP)、逐搏间期(IBI)、三轴加速度(ACC)。其中 BVP 与 IBI 可派生出心率变异性相关特征,ACC 用于捕捉运动伪影/活动量。
Q5:有没有逐刻的压力标签?
没有。这是它与 WESAD 的核心差异——WESAD 用诱导任务标出 baseline/stress/amusement 等状态区间,本数据集只有"考试场次(时间区间)+ 最终成绩"这样的弱标签。做逐刻状态识别需要自行构造伪标签。
Q6:原始论文做了什么、效果如何?
用皮肤电导信号滤波得到粗粒度趋势线,把 EDA 分为 start/middle/end 三段、构造差分信号与 9 个工程特征,训练分类器预测成绩高低(二分类),报告最高准确率 70-80%。论文措辞谨慎,称之为"真实世界压力场景下用可穿戴设备预测表现的初步可行性"。
Q7:后来别人用它做出了什么?
第三方已有多种使用:Springer《Applied Psychophysiology and Biofeedback》(2025) 用假设检验+回归树分析 EDA/HR/TEMP 与成绩的关系;MDPI《Sensors》(2025) 把它作为外部验证集考察 HRV 特征选择的跨数据集可迁移性;arXiv 2606.14960 用 Transformer + 全模态把准确率推到 96%。
Q8:现在能拿到吗?什么许可?
能,且最容易——ODC-By-1.0 + Open Access,无注册墙、无申请、无 DUA。网页下 ZIP(82.0 MB)、wget 递归下载、或 aws s3 sync --no-sign-request s3://physionet-open/wearable-exam-stress/1.0.0/ 三条路任选。署名即可使用(含商用)。
Q9:数据文件怎么组织?
Data.zip 解压后是 S1…S10 每个被试的目录,各含 Final / Midterm 1 / Midterm 2 三个子目录;每子目录有 ACC.csv、BVP.csv、EDA.csv、HR.csv、IBI.csv、tags.csv、TEMP.csv、info.txt 八个文件。根目录还有 StudentGrades.txt 成绩表。
Q10:为什么它对 AI-Ready 数据集有意义?
它是可获取性光谱最开放一端的样本:ODC-By-1.0、公共 S3 桶直链、无任何门槛,与请求制/注册墙数据集形成鲜明对照。同时它的真实世界属性与运动伪影问题,是"实验室高分能否迁移到现实"这一命题的活教材。
§2 数据构成与规格
2.1 规模、来源与采集场景
本数据集的核心特征可以概括为"小样本、真场景、纵向追踪":
| 维度 | 规格 |
|---|---|
| 被试数 | 10 名大学生(2 女 + 8 男;数据中去性别标识) |
| 考试场次 | 每人 3 场(Midterm 1 / Midterm 2 / Final),共 30 场 |
| 采集场景 | 真实考场(非实验室、无诱导任务) |
| 设备 | Empatica E4 腕带(FDA 批准),佩戴非惯用手 |
| 时长 | 期中各 1.5 h;期末 3 h |
| 统一开考时间 | 9:00 AM(CT/CDT,取决于对应 unix 时间戳的日期) |
| 课程背景 | 休斯顿大学电路分析(circuit analysis)课程 |
| 存储体量 | 82.1 MB(未压缩)/ 82.0 MB(ZIP) |
"纵向追踪"指同一批被试反复参与——同一学生在三次考试中都贡献了信号。这与很多横断面数据集(不同人各测一次)不同,使"个体压力反应随时间/任务难度如何变化"成为可研究的问题;但代价是有效独立样本仍只有 10 人,统计效力极低。
采集流程(官方 Methods 节):
- 考生入场,从研究团队处领取一台带 tag number 的 E4 设备;
- 考生在设备对应名单上签写自己的名字(建立设备号↔人 的映射);
- 考试期间设备自动记录全部生理信号;
- 考后考生归还设备;
- 课程教师把设备号对应的成绩提供给研究团队。
这一流程的巧妙之处在于:研究团队不直接掌握姓名—成绩的对应(保护隐私),只用设备号把成绩与信号接上。
2.2 信号构成与采样规格
每次考试采集六类信号,逐信号存为独立 CSV:
| 信号 | 全称 | 采样率(E4 规格) | 临床/生理含义 |
|---|---|---|---|
| EDA | electrodermal activity(皮肤电活动) | 4 Hz | 交感神经驱动的汗腺活动,压力唤起的核心指标 |
| HR | heart rate(心率) | 由 BVP 派生 | 自主神经唤起水平 |
| BVP | blood volume pulse(血容量脉搏) | 64 Hz | 光电容积脉搏波,可派生 HR/HRV |
| TEMP | skin surface temperature(皮肤表面温度) | 4 Hz | 外周血管收缩/舒张的间接指标 |
| IBI | inter beat interval(逐搏间期) | 逐搏事件 | 心跳间隔序列,HRV 分析的原始输入 |
| ACC | 三轴加速度(accelerometer) | 32 Hz | 手腕运动,既表活动量也指示伪影 |
注:官方 info.txt 逐文件给出确切采样率;上表 E4 规格(EDA/TEMP 4 Hz、BVP 64 Hz、ACC 32 Hz)与 WESAD 中 E4 的规格一致(三方口径)。
2.3 目录结构
wearable-exam-stress/1.0.0/
├── Data.zip                 # 全部被试zip压缩包(82.0 MB)
├── StudentGrades.txt        # 成绩标签表
├── readme.md                # 结构说明
├── LICENSE.txt              # ODC-By-1.0
└── SHA256SUMS.txt           # 校验和
Data.zip 解压后:
├── S1/
│   ├── Final/       {ACC,BVP,EDA,HR,IBI,tags,TEMP}.csv + info.txt
│   ├── Midterm 1/   {同名 8 文件}
│   └── Midterm 2/   {同名 8 文件}
├── S2/ … S10/       (结构同 S1)
其中 tags.csv 存放设备事件标记(如按键事件),不是压力状态标签——这是检索者最易误读之处(坑 5)。
2.4 时间戳与去标识
数据集做了日期平移(date shift)去标识,但不做时间平移(保留一天内的时间位置):
- 所有 unix 时间戳整体平移一个固定偏移,使具体日期不可追溯;
- 平移量经过设计,不改变当天夏令时状态(CT/CDT)——即一个时间戳原本属于 CDT,平移后仍属 CDT;
- 因此考试开始时间在所有记录里都显示为 9:00 AM(CT/CDT),可作为对齐各场考试的锚点。
对使用者而言,这意味着"日期不可信、日内时刻可信":不能用绝对日期做跨数据集匹配,但可以用"距开考 9:00 AM 的分钟数"做会话内对齐。
2.5 成绩标签
成绩存于 StudentGrades.txt,把每名被试与考试成绩对应起来。原始论文口径成绩为满分 200 分制;第三方论文(Applied Psychophysiology 2025)将其归一化为 Relative GRADE(0-100 标度)以跨科统一。论文任务是把成绩二分为"高/低"来分类。数据集不含分数之外的任何学业或人口学标签,性别、年龄等概不提供。
2.6 记录条数量级
信号条数因考试时长而异。第三方分析给出的实例:某被试 Midterm 1 有 44,712 条 EDA,Final 有 93,582 条 EDA——期末 3 小时约为期中 1.5 小时的两倍,与时长比例一致。这为使用者的预处理(重采样、分段、特征提取)提供了量级概念:单场考试的单路信号量级在万到十万采样点之间。
§3 采集方法与实验设计
3.1 三源证据链
本条目所有硬数字均经三源互证,来源与位置如下(详见附录 C):
| 事实 | 源 A:PhysioNet 官方页 | 源 B:IEEE HI-POCT 论文 | 源 C:第三方复现 |
|---|---|---|---|
| 被试数 10 | ✅ “ten subjects” | ✅ “10 subjects” | ✅ 三方论文均沿用 |
| 三次考试 | ✅ Midterm1/2+Final | ✅ | ✅ |
| 设备 Empatica E4 | ✅ FDA-approved | ✅ wearable devices | ✅ E4 于非惯用手 |
| 许可 ODC-By-1.0 | ✅ view-license 页 | — | — |
| 准确率 70-80% | — | ✅ 摘要 | ✅ 转述 |
| 96%(更强模型) | — | — | ✅ arXiv 2606.14960 |
三源在"10 人、三次考试、E4 设备"上完全一致;差异只在"论文标题口径"与"后续模型精度"(见 §7、§9 存照)。
3.2 为什么选择真实考场
论文 Background 节给出的动机链:人工刺激(电击、噪声、恐怖图片、视频)能诱发皮肤电反应,但长时间的真实认知压力记录严重缺失。考场提供了理想折中:
- 压力真实:考试是大学生普遍经历、真实存在、无法回避的认知压力源;
- 任务标准化:所有人在同一时间、同一科目、同一时长下应试;
- 有客观结果:考试成绩是一个连续、可信、可二分的表现度量;
- 可纵向追踪:同一门课的三次考试天然构成同被试重复测量。
代价也很清楚:真实考场是不受控环境——握笔、翻页、调整坐姿都产生运动伪影,考场温度、座位、其他考生的存在都无法标准化。这正是论文反复强调"contain motion artifacts"的原因。
3.3 数据采集流程的隐私设计
流程中一个值得学习的工程细节是设备号中介的成绩对接:
- 研究者不接触"姓名—成绩"的直接映射;
- 考生签名建立"设备号—人"映射(研究者可见);
- 教师仅提供"设备号—成绩"(教师可见成绩,但用设备号而非姓名);
- 只有把两段拼接时才会同时看到姓名与成绩,而这一拼接发生在研究分析阶段且已去标识。
这种"分片持有"的思路在小规模真实场景采集中较常见,兼顾了数据可用性与受试者隐私。整个研究经 University of Houston IRB 审查批准。
3.4 与 WESAD 的关键区分
本数据集最容易被误认的对象是 WESAD(Wearable Stress and Affect Detection, rid 67),两者都涉及"可穿戴 + 压力 + Empatica E4",但本质不同:
| 维度 | WESAD(rid 67) | 本数据集 |
|---|---|---|
| 场景 | 实验室(受控) | 真实考场(不受控) |
| 诱导方式 | TSST 社交压力任务 + 幽默/冥想视频 | 无诱导,真实考试 |
| 被试数 | 15 人有效(17 采集,2 剔除) | 10 人 |
| 设备 | 胸 RespiBAN + 腕 Empatica E4 | 仅腕 Empatica E4 |
| 信号 | ECG/EDA/EMG/RESP/TEMP/ACC + BVP | EDA/HR/BVP/TEMP/IBI/ACC |
| 标签 | 明确情绪状态(baseline/stress/amusement/meditation)+ 自评问卷(PANAS/STAI/SAM/SSSQ) | 仅考试场次 + 成绩(弱标签) |
| 伪影 | 低(受控) | 高(真实运动伪影) |
| 用途 | 情绪/压力状态分类基准 | 认知表现/成绩预测 |
一句话:WESAD 追求"干净的标签",本数据集追求"真实的场景"。两者互补而非竞争——一个可用来验证算法在理想条件下的上限,一个用来检验算法在现实中的可用性(§7.4)。
3.5 局限的自我披露
数据集页与论文主动披露了三处局限,值得转引时保留:
- 运动伪影:“As the dataset has been collected from real world settings, it contains motion artifacts.”(真实采集,含伪影)
- 样本小:“the number of participants is also relatively small.”(参与者相对较少)
- 任务基础版:原始论文用 EDA 单模态 + 基础 ML 特征,明确说明"dataset has been used just to show the dataset might contain information regarding participants grades"——即论文只是证明数据里可能有信号,不是要把预测精度做到极致。
这三点是使用者定心的关键:本数据集的定位是"数据集贡献"而非"方法 SOTA"。
§4 信号处理与分析范式
4.1 EDA 为何是主角
在六类信号里,EDA 是绝对主角,原因是它直接反映交感神经系统的唤起:
- 汗腺由交感神经胆碱能纤维支配(不受副交感拮抗),因而 EDA 是自主唤起的"纯"指标;
- 情绪压力、认知负荷、注意唤醒都会升高皮肤电导;
- E4 的 EDA 传感器便宜、功耗低、可长期佩戴,适合消费级场景。
但 EDA 也是"最难处理"的信号:它是慢变基线(tonic, SCL)与快变反应(phasic, SCR)的叠加,压力反应体现在 phasic 成分的峰值与频率上,而要分离二者需要去卷积(deconvolution)等技术——这正是 Faghih 组方法学积累的核心(§4.3)。
4.2 原始论文的处理范式
论文的 EDA 处理流程(2022,HI-POCT):
- 滤波得粗粒度趋势线:对皮肤电导信号滤波,提取缓慢变化的趋势(coarse-grained trendline);
- 三段切分:把每场考试的信号分为 start / middle / end 三段;
- 构造差分信号:定义段间/段内的差分信号;
- 计算统计量:各段的均值与方差,以及差分信号的统计;
- 构造比率特征:如"middle 段均值 / (start 均值 + end 均值)";
- 共 9 个工程特征 → 输入分类器 → 预测成绩高低。
结果:最高准确率 70-80%(个别口径 final exam 约 80%)。论文同时给出考试期间压力水平总体变化的平均趋势线,用于描述"考试过程中压力如何起伏"。
4.3 EDA 建模的方法学谱系
Faghih 组在 EDA 信号处理上的工作构成了本数据集的"方法地基",其 GitHub 代码库也随数据集页一并推荐:
| 工作 | 出处 | 作用 |
|---|---|---|
| 稀疏分解 + 生理先验 | Amin & Faghih, IEEE T-BME 2021;68(5):1726-1736 | 从皮肤电导中分离 tonic/phasic,恢复 sudomotor 神经活动 |
| 状态空间 + 稀疏恢复 | Amin & Faghih, PLoS Comput Biol 2022;18(7):e1010275 | 3D 状态空间模型 + 固定区间平滑,实时推断 ANS 激活 |
| 贝叶斯 EDA(BayesianEDA) | 同上系列 | 单动态系统内整合 tonic 与 phasic |
| 统一动态模型 | 后续工作(arXiv:2311.02799 口径) | 单一动态系统分解 SC + 推断 sudomotor 神经活动 |
使用本数据集做 EDA 分析时,官方推荐复用 computational-medicine-lab 的 Skin-Conductance-Based-Stress-State-Estimation 与 Skin-Conductance-Deconvolution 代码库——这是数据集附带的方法工具链,大大降低了上手门槛。
4.4 多模态使用的兴起
原始论文只用 EDA;但数据集明确鼓励多模态使用(“This dataset can widely be used with more advanced techniques with multimodal recordings”)。第三方研究已经扩展:
- EDA + HR + TEMP:Applied Psychophysiology 2025 同时分析三路信号与成绩的关系,并比较考试内 start/middle/end 时段;
- IBI/HRV 为主:MDPI Sensors 2025 提取 IBI 做 HRV 特征选择,并把本数据集作为外部验证;
- 全模态 + Transformer:arXiv 2606.14960 用全部信号 + 深度模型,把准确率提到 96%。
趋势很清楚:原始论文证明了单模态有信号,后续研究证明多模态能显著提升(§7)。
4.5 预处理注意事项
真实考场数据典型的预处理陷阱:
- 运动伪影剔除:ACC 可用于识别剧烈运动区间,但考试中"轻度运动"(写字的细微动作)恰恰与压力反应同时发生,剔除时需谨慎,避免连信号一起削掉;
- EDA 去卷积:直接对原始 SC 做特征会混淆 tonic 与 phasic,建议先分解(用 §4.3 工具链);
- 重采样对齐:EDA/TEMP 4 Hz、BVP 64 Hz、ACC 32 Hz、IBI 事件型——多模态融合前需统一时间栅格;
- 会话对齐:用"距 9:00 AM 开考的分钟数"而非绝对时间戳(§2.4);
- 个体归一化:10 人的个体差异极大,跨人中位数/基线归一化往往比原始值更稳。
§5 任务设定与标注体系
5.1 任务一:成绩高低二分类(原始论文主线)
最核心的任务是从生理信号预测考试成绩的高低:
| 项 | 设定 |
|---|---|
| 输入 | EDA(原始论文);后续扩展为多模态 |
| 特征 | 9 个工程特征(三段均值/方差 + 差分信号 + 比率) |
| 输出 | 成绩高/低二分类 |
| 结果 | 最高准确率 70-80% |
| 切分 | 三次考试(Midterm 1/2/Final)分别建模 |
这一任务的现实意义是"用生理信号在考后回看表现,或(更激进地)探索事前/事中预测"。论文措辞克制,只宣称 preliminary viability。
5.2 任务二:压力趋势描述
论文另给出一项描述性任务:计算考试期间压力水平的平均趋势线,刻画一场考试中压力如何随开始—中段—结束而变化。这不需要分类标签,是纯描述性分析,也是"start/middle/end"三段划分的动机来源。
5.3 任务三(衍生):压力 vs 非压力外部验证
第三方(MDPI Sensors 2025)把本数据集重新包装为压力二分类任务:
- Midterm 1 → non-stress(基线);
- Final → high-stress(高压力);
- 提取 IBI/HRV 特征,用在其主数据集上训练好的模型做跨数据集外部验证。
这是"把成绩预测数据集挪用作压力识别数据集"的典型改造。它说明本数据集虽无压力标签,但**"期中考 vs 期末考"的难度/重要性差异可被当作压力的代理标签**(一种弱监督思路)。使用时要清楚:这是使用者的构造,不是数据集原生标签。
5.4 标签体系总结
本数据集的标签只有两级:
- 考试场次标签(session label):Midterm 1 / Midterm 2 / Final——每个 CSV 所属目录即隐含此标签;
- 成绩标签(grade label):StudentGrades.txt 中的分数(原始 200 分制)。
没有的标签:情绪状态、逐刻压力、主观感受、人口学属性、任务难度评分。这一"稀疏标签"特性决定了它的用法——要么做"场次/成绩"相关的任务,要么由使用者自造弱标签(如 §5.3)。
5.5 与"强标签"数据集的对照
把本数据集放进压力/情感识别的标签丰富度光谱:
| 数据集 | 标签丰富度 | 标签类型 |
|---|---|---|
| WESAD(rid 67) | 高 | 情绪状态 + 多套自评问卷 |
| DEAP(rid 332) | 高 | 效价/唤醒度 + 多被试评分 |
| 本数据集 | 低 | 场次 + 成绩 |
| PPG-DaLiA(rid 202) | 中 | 活动类型 + 心率参考 |
低标签丰富度的两面性:负面是任务受限、监督信号弱;正面是标签客观(考试成绩是硬结果,不受主观问卷噪声影响)、采集成本低、可扩展。这是"真实性 vs 标注密度"的经典权衡。
§6 获取与许可
6.1 许可:ODC-By-1.0(最宽松档)
数据集采用 Open Data Commons Attribution License v1.0(ODC-By-1.0):
- 可自由使用:任意目的,包括商用;
- 可修改/再分发:可派生、可再发布;
- 唯一义务:署名(attribution)——保留来源与许可说明即可;
- 无"非商业"限制(不同于 CC BY-NC 系)、无"相同方式共享"限制(不同于 CC BY-SA)、无"禁止演绎"(不同于 CC BY-ND)。
PhysioNet 页面将其标为 Open Access(绿锁 “fa-lock-open” badge),并写明:“Anyone can access the files, as long as they conform to the terms of the specified license.”(任何人只要遵守许可条款即可访问全部文件。)
6.2 三条下载路径(全部无需注册)
| 方式 | 命令/操作 |
|---|---|
| 网页 ZIP | 直接下载 Data.zip(82.0 MB) |
| wget 递归 | wget -r -N -c -np https://physionet.org/files/wearable-exam-stress/1.0.0/ |
| AWS S3 公共桶 | aws s3 sync --no-sign-request s3://physionet-open/wearable-exam-stress/1.0.0/ DESTINATION |
关键点:--no-sign-request 表示无需 AWS 凭证,physionet-open 是公开桶——这是可获取性的最高档(比带注册的 S3 更开放)。
6.3 版本与校验
- 版本链:仅 1.0.0(无后续版本,抓取时点 2026-10-03);
- 官方提供
SHA256SUMS.txt供下载后校验完整性; - DOI 10.13026/kvkb-aj90 是该版本的持久标识。
6.4 参考代码与工具链
数据集页推荐 computational-medicine-lab 的代码库,用于 EDA 处理:
Skin-Conductance-Based-Stress-State-EstimationSkin-Conductance-Deconvolution- (同组织下)
tonic-phasic-decomposition-tbme(T-BME 2021 稀疏分解)
这些库与本数据集构成"数据 + 方法"配对的开放资源,使用门槛因此进一步降低。
6.5 获取决策卡
| 你的情况 | 行动 |
|---|---|
| 想立刻跑通 | aws s3 sync --no-sign-request ... 或网页 ZIP(82 MB,秒级) |
| 要做 EDA 分析 | 下载数据 + clone computational-medicine-lab 代码库 |
| 要做多模态/深度模型 | 数据全开放,直接进管线;注意运动伪影与个体归一化(§4.5) |
| 要用作外部验证 | 提取 IBI/HRV,按 §5.3 的期中考/期末考切分构造压力代理标签 |
| 关心引用 | 同时引 PhysioNet 数据集(doi:10.13026/kvkb-aj90)与论文(doi:10.1109/HI-POCT54491.2022.9744065) |
6.6 引用规范
@misc{amin2022wearableexam,
  title        = {A Wearable Exam Stress Dataset for Predicting Cognitive
                  Performance in Real-World Settings},
  author       = {Amin, Md Rafiul and Wickramasuriya, Dilranjan and
                  Faghih, Rose T.},
  year         = {2022},
  month        = may,
  publisher    = {PhysioNet},
  version      = {1.0.0},
  doi          = {10.13026/kvkb-aj90},
  url          = {https://doi.org/10.13026/kvkb-aj90},
  note         = {RRID:SCR_007345}
}

@inproceedings{amin2022grades,
  title     = {A Wearable Exam Stress Dataset for Predicting Grades
               using Physiological Signals},
  author    = {Amin, Md. Rafiul and Wickramasuriya, Dilranjan S. and
               Faghih, Rose T.},
  booktitle = {2022 IEEE Healthcare Innovations and Point of Care
               Technologies (HI-POCT)},
  year      = {2022},
  doi       = {10.1109/HI-POCT54491.2022.9744065}
}
注意:PhysioNet 还要求引其平台论文(Pollard et al., Nature Health 2026),并标注 RRID:SCR_007345。
6.7 为什么这个数据集是"可获取性标杆"
在本库收录的数据集里,可获取性从"注册墙"到"请求制"到"公开直链"构成一条光谱。本数据集稳稳落在最开放的一端:
| 档位 | 典型形态 | 本数据集 |
|---|---|---|
| 注册墙 | 需注册账号 + 审批 | — |
| 请求制 | 邮件作者申请(用途+机构) | — |
| 平台托管 | Zenodo/HF 需登录或 gated | — |
| 公开直链 | HTTP/S3 无门槛 | ✅(且是 --no-sign-request 公共桶) |
它的意义在于提供一个"零摩擦"的正面样本:检验一个数据平台是否真正开放,最简单的测试就是"能不能用一条命令把全量数据拉到本地"——本数据集通过了这个测试(§6.2)。对 AI-Ready 评测而言,它是"满分可获取性"的参照系。
6.8 使用许可时的实操提醒
虽然 ODC-By-1.0 非常宽松,仍有几处实操细节:
- 署名要具体:仅写"数据来自 PhysioNet"不够,应写明数据集全称、作者、DOI(§6.6);
- 保留许可说明:再分发(如打包进你的公开数据集)时应附带 ODC-By-1.0 说明;
- 注意关联论文的许可:数据集是 ODC-By-1.0,但原始 IEEE 论文本身受 IEEE 版权约束(非开放获取),引论文观点不等于可自由复制论文全文——数据许可与文献许可要分开看;
- 衍生作品的署名:基于本数据训练出的模型/派生数据,若再分发,按 ODC-By 精神应注明数据来源。
6.9 与"数据可用性声明"缺失问题的对照
许多期刊论文的"数据可用性声明"流于形式("available upon request"却常常联系不上作者)。本数据集反其道而行:不仅完全开放,还在 PhysioNet 上给出了可执行的三条下载命令(网页/wget/AWS)。这种"把可获取性写进命令里"的做法,是值得其他数据发布者借鉴的范式——可获取性不应只是一个形容词,而应是一行能被复制粘贴执行的代码。
§7 第三方使用与评估基准
7.1 原始基准(2022)
原始论文建立的基准:EDA 趋势线 + 9 工程特征 + 基础 ML → 成绩高低二分类,最高准确率 70-80%。这是所有后续工作的对照起点。论文同时强调这只是"完整数据集潜在价值的一个演示"。
7.2 第三方研究总览
| 研究 | 出处 | 用法 | 关键结果 |
|---|---|---|---|
| Amin et al.(原始) | IEEE HI-POCT 2022 | EDA 单模态成绩预测 | 70-80% |
| Applied Psychophysiology 2025 | Springer, 50:149-164, doi:10.1007/s10484-025-09685-2 | EDA/HR/TEMP 与成绩关系;时段分析 | 假设检验+回归树,比较 start/middle/end |
| HRV 特征选择 | MDPI Sensors 2025;25(13):4154 | 作外部验证集 | IBI→HRV 特征;Midterm1=基线/Final=高压;跨数据集泛化评估 |
| Transformer 多模态 | arXiv 2606.14960 | 全模态 + 深度模型 | 96%(优于此前 80%) |
7.3 96% 的读法
arXiv 2606.14960 报告的 96% 是本数据集迄今最高公开准确率,但有几个必须交代的前提:
- 模型/特征不同:原始 80% 用 EDA 单模态 + 9 手工特征;96% 用全部信号 + Transformer + 更多特征工程。两者不是同一条件下的对比,不能简单说"数据集支持 96% 的性能";
- 样本极小:10 人、30 场考试,96% 与 80% 的差距在如此小的样本上可能不稳定,需交叉验证设计支撑;
- 论文自述的选型逻辑:该论文明确批评此前研究"仅用 8 路信号里的 EDA 一路",主张多模态——这与其 96% 的提升方向一致。
使用者的正确态度:把 70-80% 当"基础基线"、96% 当"前沿尝试",两者的模型复杂度差异要一并报告。
7.4 外部验证价值
MDPI Sensors 2025 把本数据集当作外部验证集这一点特别值得强调:一个在独立数据集(可能是规模更大、标注更细的压力数据集)上训练好的 HRV 模型,拿到本数据集上测试其跨数据集可迁移性。这揭示了两层价值:
- 本数据集虽是"成绩预测"出身,但可被复用为压力识别模型的现实压力测试台;
- 它的"真实考场"属性使其比实验室数据更能暴露模型的过拟合——用实验室数据训练的模型在真实伪影环境下掉分,正是最需要知道的。
7.5 为什么它很难有一个统一 leaderboard
与本库内的挑战赛数据集(如 PANDA、BraTS)不同,本数据集没有官方 leaderboard、没有固定划分、没有统一指标:
- 原始论文用成绩二分类准确率;
- 后续研究各用各的切分(是否用 Final 作高压力、是否用全部三场);
- 有的做回归(成绩预测)、有的做分类(压力/成绩二分)。
因此引用其"性能"时,必须写明是哪个任务、哪个切分、哪个模型,否则极易误导(坑 4)。
§8 生态与影响
8.1 在 PhysioNet 可穿戴数据生态中的位置
PhysioNet 承载大量生理信号数据集,本数据集是其中可穿戴 + 真实场景 + 认知表现的少数派:
- 与 WESAD 一起构成"实验室 vs 真实世界"的对照对;
- 与前文提及的 PPG、睡眠、体动数据集(§8.3)共同覆盖外周生理信号的多种现实场景;
- 因 ODC-By-1.0 与公共 S3 桶,是 PhysioNet 上可获取性最高的一档数据。
8.2 方法学影响
Faghih 组的贡献分两半:方法(EDA 建模) 与 数据(本数据集)。本数据集的价值在于把抽象的方法放进了真实场景:
- 它推动"EDA 去卷积/状态空间建模"从实验室数据走向考场数据;
- 它的运动伪影问题迫使研究者正视"真实世界信号质量"这一被实验室数据掩盖的工程难点;
- 它的"设备号中介"隐私流程是小规模现实采集的可复用模板。
MINDWATCH(NSF CAREER 1942585)项目名本身就点明了愿景:可穿戴自适应闭环架构下的多模态无创脑状态解码器——本数据集是这条研究路线的一块真实场景拼图。
8.3 库内可互链条目
| 库内条目 | rid | 关系 |
|---|---|---|
| WESAD | 67 | 核心对照:实验室压力/情感识别 vs 本条目真实考场(§3.4) |
| DEAP | 332 | 实验室诱发情感(EEG+外周),标签丰富度高 |
| MHEALTH | 222 | 多模态可穿戴运动/生理信号,场景(日常活动)对照 |
| PAMAP2 | 212 | 可穿戴体动/心率日常活动数据 |
| PPG-DaLiA | 202 | BVP/PPG 信号与活动标签,信号模态重叠(BVP) |
| BIDMC-PPG | 74 | PPG 生理信号数据集(PhysioNet 同源) |
| BUTPPG | 803 | PPG 信号数据集 |
| VitalDB | 192 | 多参数生命体征(PhysioNet 平台),临床 vs 日常对照 |
| EEGMMIDB | 342 | 生理信号分类基准传统 |
| BCI Competition IV-2a | 352 | 生理信号分类基准 |
| Gait-PD / Gait-in-Aging | 242 / 232 | 可穿戴传感器步态任务 |
| Daphnet-FOG | 252 | 可穿戴加速度计冻结步态检测 |
| NinaPro | 372 | 可穿戴 EMG 手势识别 |
| NSRR / HMC-Sleep-Staging | 312 / 654 | 睡眠生理(长时程真实信号主题对照) |
8.4 跨场景复用建议
研究者把本数据集迁用到其他问题时,可参考三条路径:
- 个人基线段:每场考试开始前/成绩不相关的信号可作个体基线,用于个体归一化;
- 难度代理:期末(更难/更重要)作"高压"、期中考作"中压"(第三方已用此思路);
- 伪影研究:ACC 与 EDA 的耦合是"真实世界 EDA 伪影"的理想研究素材。
§9 与库内条目的关系
9.1 家族图谱
- WESAD(rid 67):最直接的对照条目。二者是同一位(类)研究者生态下的可穿戴压力数据两极——WESAD 是实验室标杆(15 人、强标签、多设备),本条目是真实世界代表(10 人、弱标签、单设备)。读压力识别综述时两者应同现。
- DEAP(rid 332):情感计算另一传统(EEG+外周,效价/唤醒标注)。与本条目共享"外周生理↔心理状态"的问题意识,但诱导方式(音乐/视频)与标签体系迥异。
- PPG-DaLiA(202)/ BIDMC-PPG(74)/ BUTPPG(803):BVP/PPG 信号家族。本条目含 BVP 与 IBI 两路脉搏信号,属该家族的真实场景成员。
- MHEALTH(222)/ PAMAP2(212):可穿戴多模态活动数据,与本条目共享"腕部/身戴传感器 + 真实日常"的问题域。
- VitalDB(192):PhysioNet 平台上的临床多参数生命体征数据,与本条目构成"临床受控 vs 日常真实"对照。
- Gait-PD(242)/ Daphnet-FOG(252)/ NinaPro(372):可穿戴信号的具体任务应用(步态/冻结步态/手势),可见可穿戴数据的下游任务光谱。
9.2 检索路径建议
- 精确检索词:“wearable exam stress” + “skin conductance” + “Empatica E4”;
- 勿用 “WESAD” 检索本条目(既非别称也不相关,只是同域易混);
- 找代码:GitHub 组织
computational-medicine-lab; - 找下游工作:引 DOI 10.13026/kvkb-aj90 的论文(PhysioNet 会统计引用)。
9.3 与其他"真实世界信号"条目的方法论呼应
本条目与本库内若干"强调真实场景、弱化实验室"的条目在方法论上同族:真实世界信号固有的伪影、缺失、无法标准化的特性,使得标注质量与预处理成为比模型选择更关键的因素。本数据集用"考场 + 成绩"给出了一个客观念标(成绩)锚定主观感受(压力)的范例,这一"用硬结果校准软感受"的思路,与本库内多个真实世界队列/移动健康条目的设计哲学相通。
§10 避坑清单:八个已踩过的坑
坑 1:别与 WESAD 混为一谈。两者都涉及可穿戴 + 压力 + Empatica E4,但 WESAD 是实验室(15 人、TSST 诱导、强情绪标签、胸+腕双设备),本数据集是真实考场(10 人、无诱导、仅成绩弱标签、单腕设备)。引用数字时必须先确认来源是哪一个——最常见的错误是把 WESAD 的 15 人写成本数据集的规模。
坑 2:论文标题与数据集标题不同。数据集(PhysioNet)标题为 “A Wearable Exam Stress Dataset for Predicting Cognitive Performance in Real-World Settings”;原始 IEEE 论文标题为 “A Wearable Exam Stress Dataset for Predicting Grades using Physiological Signals”。同一数据集两套标题(认知表现口径 vs 成绩口径),检索与引用时都要能对上。
坑 3:准确率双口径。原始论文 70-80%;第三方 arXiv 2606.14960 报 96%。两者模型/特征/模态完全不同(EDA 单模态手工特征 vs 全模态 Transformer),不能直接对比。只报 96% 会误导读者以为数据集本身支持这么高精度。
坑 4:没有统一 benchmark/leaderboard。任务切分、指标、是否用 Final 作高压各研究自定;引用性能时须写明任务/切分/模型,否则无法复现或比较。
坑 5:tags.csv 不是压力标签。目录里的 tags.csv 是设备事件标记(如按键事件),不是压力/情绪状态标签。误以为它有逐刻标签是常见误解——本数据集没有逐刻状态标注(§5.4)。
坑 6:样本极小,警惕过度解读。10 人、30 场记录,任何相关性/准确率都可能是偶然。原始论文自己都用 “preliminary viability” 措辞,并建议未来工作扩大样本。把 96% 当作普适性能是典型的过度解读。
坑 7:运动伪影与真实场景的双刃剑。真实采集使数据"接地气",但也让信号含伪影。直接用未经预处理的原始信号建模,性能会被伪影主导。务必先做去伪影/去卷积(§4.5)。
坑 8:时间戳只有"日期被平移"。unix 时间戳做了日期平移去标识但不变时间轴,所有考试固定 9:00 AM(CT/CDT)开始。用绝对日期做跨数据匹配会失败;用"距开考分钟数"做会话内对齐才可靠(§2.4)。
§10 附:坑点的根因归类
八个坑可归为三类根因,理解根因比背坑点更有用:
| 根因 | 相关坑 | 本质 | 通用对策 |
|---|---|---|---|
| 命名歧义 | 坑 1、坑 2 | 数据集名/论文名/近邻数据集名高度相似 | 引用前先核对 DOI;检索时用精确短语 |
| 文档口径漂移 | 坑 3、坑 4 | 不同来源/不同模型给出不同数字 | 报数字必带上下文(任务/模型/切分) |
| 数据结构误读 | 坑 5、坑 8 | 文件命名/时间戳语义易被想当然 | 先读 readme/info.txt 再写代码 |
- 命名歧义类:本数据集与 WESAD 的混淆风险最高,因为二者共享"可穿戴+压力+E4"的记忆锚点。破解办法是记住一个硬区分:WESAD=15 人实验室,本数据集=10 人考场。
- 文档口径漂移类:准确率 70-80%(原始)vs 96%(第三方)是典型。破解办法是永远写清模型与模态。
- 数据结构误读类:tags.csv 与时间戳是两大陷阱。破解办法是下载后先
head一遍每个文件再用。
FAQ(高频问答 32 问)
A. 基础认知
Q1:这个数据集是干什么的?
用可穿戴设备在真实考场采集生理信号,研究"压力/生理反应能否预测考试成绩(认知表现)"。它是数据集贡献,不是一个挑战赛或排行榜。
Q2:“A Wearable Exam Stress Dataset” 这个名字里哪个词最关键?
“Wearable”(可穿戴)与 “Real-World”(真实世界)。前者指 Empatica E4 腕带,后者指考场而非实验室——这正是它与 WESAD 类数据集的分水岭。
Q3:谁做的?
University of Houston 电气与计算机工程系 Computational Medicine Laboratory,通讯/资深作者 Rose T. Faghih(现 NYU Tandon 生物医学工程系);一作 Md Rafiul Amin;共 3 位作者。
Q4:什么时候发布的?
数据 PhysioNet v1.0.0 发布于 2022-05-26;对应会议论文收录于 IEEE HI-POCT 2022(会议 2022-03-10/11,Houston)。
Q5:发表在哪个会议?
2022 IEEE Healthcare Innovations and Point of Care Technologies (HI-POCT),doi:10.1109/HI-POCT54491.2022.9744065。
Q6:DOI 是什么?
数据集 DOI 是 10.13026/kvkb-aj90(PhysioNet);论文 DOI 是 10.1109/HI-POCT54491.2022.9744065。引用时两个都要给。
Q7:是挑战赛吗?
不是。没有比赛、没有排行榜、没有固定划分,是一个供研究使用的开放数据集。
Q8:一句话卖点?
"真实考场"是它最大的差异点——在实验室压力识别数据集泛滥的年代,它提供了难以获取的真实世界认知压力数据。
Q9:最大的局限?
样本极小(10 人)+ 无诱导(无逐刻状态标签)+ 真实场景(含运动伪影)。三者叠加决定了它适合做探索/外部验证,不适合做统计结论或普适性能声称。
Q10:它和 WESAD 什么关系?
互补的对照,不是版本关系。WESAD(实验室、15 人、强标签)与本数据集(真实考场、10 人、弱标签)是压力识别数据的光谱两端。
B. 数据与获取
Q11:怎么下载?
网页下 ZIP(82.0 MB)、wget -r -N -c -np https://physionet.org/files/wearable-exam-stress/1.0.0/、或 aws s3 sync --no-sign-request s3://physionet-open/wearable-exam-stress/1.0.0/ DESTINATION——三条路都无需注册。
Q12:需要申请吗?要签 DUA 吗?
不需要。开放获取(Open Access),无注册墙、无申请、无数据使用协议。
Q13:什么许可?能商用吗?
ODC-By-1.0(Open Data Commons Attribution License v1.0)。署名即可使用,含商用,可修改可再分发。所有 CC 系"非商业/相同方式共享/禁止演绎"限制都不适用。
Q14:多大?
未压缩 82.1 MB,ZIP 82.0 MB——是个"小到可以秒下"的数据集。
Q15:有多个版本吗?
截至抓取时点(2026-10-03)只有 1.0.0 一个版本。
Q16:数据文件怎么组织?
Data.zip → S1…S10 被试目录 → 各含 Final / Midterm 1 / Midterm 2 → 各含 ACC/BVP/EDA/HR/IBI/tags/TEMP 七个 CSV + info.txt;另有 StudentGrades.txt 成绩表。
Q17:采样率是多少?
EDA 4 Hz、TEMP 4 Hz、BVP 64 Hz、ACC 32 Hz(E4 规格);IBI 为逐搏事件序列。确切值以各 info.txt 为准。
Q18:有参考代码吗?
有。GitHub 组织 computational-medicine-lab,重点 Skin-Conductance-Based-Stress-State-Estimation 与 Skin-Conductance-Deconvolution。
C. 标签与任务
Q19:有压力/情绪标签吗?
没有。只有考试场次(时间区间)+ 成绩。这是它与 WESAD/DEAP 的核心区别。
Q20:那怎么做压力识别?
使用者自造弱标签。例如第三方把 Midterm 1 当 non-stress、Final 当 high-stress(§5.3)。这是使用者的构造,需要自己交代清楚。
Q21:成绩是什么格式?
StudentGrades.txt,原始口径满分 200 分制;可归一到 0-100 使用。
Q22:原始任务是什么?
EDA 趋势线 + 9 工程特征 → 成绩高低二分类,最高 70-80%。
Q23:9 个特征具体是什么?
EDA 分 start/middle/end 三段,各段均值与方差 + 差分信号 + 段间比率(如 middle/(start+end))等组合,共 9 个。详见论文。
Q24:成绩预测能做到多准?
基础方法 70-80%;用全模态 + Transformer 的第三方研究报 96%(但样本小、不可直接与外推)。
D. 使用与复现
Q25:为什么真实考场数据难处理?
运动伪影。学生握笔、翻卷、调姿势的细微运动与压力反应同时发生,既污染信号又难以干净剔除(§4.5)。
Q26:EDA 怎么预处理?
先做 tonic/phasic 分解(去卷积),再提取 phasic 成分的峰值/频率特征。可直接复用官方推荐的 MATLAB/Python 代码库。
Q27:多模态怎么融合?
EDA/TEMP 4 Hz、BVP 64 Hz、ACC 32 Hz、IBI 事件型——先统一时间栅格,再按"距开考分钟数"对齐会话,最后做个体归一化。
Q28:10 人样本能做深度学习吗?
可以尝试(第三方用 Transformer 做了),但要极其小心过拟合。建议留一被试交叉验证(LOSO),并报告置信区间。
Q29:能用来做泛化研究吗?
非常适合——作为外部验证集。用一个大数据集训练,拿到这里测,看模型能否扛住真实伪影与个体差异(第三方已如此使用)。
Q30:数据集的运动伪影是缺点还是优点?
看用途。对"追求干净信号"是缺点;对"研究真实世界鲁棒性"是优点——它把实验室数据掩盖的工程问题暴露出来。
E. 生产与库内
Q31:本条目为什么叫 wearable-exam-stress?
取自 PhysioNet 的官方 url_name(wearable-exam-stress),精确、可检索、无撞库(查重 0 命中)。
Q32:本条目与库内 WESAD(rid 67)冲突吗?
不冲突,是互补对照。WESAD 记实验室标杆,本条目记真实世界代表,检索任一应提示另一。二者是同域两极,同读才完整。
F. 工程与工程伦理
Q33:为什么用设备号而不是姓名对接成绩?
隐私设计。研究者只见"设备号—人",教师只见"设备号—成绩",两段拼接发生在分析阶段且已去标识;单一角色无法同时看到姓名与成绩(§3.3)。
Q34:日期平移去标识安全吗?
对本文数据集属中等强度去标识——去掉了可追溯的绝对日期,但保留了日内时刻结构。对 10 人的小群体,若结合"某门课某次考试"的外部信息理论上仍有再识别风险,这也是为什么性别、年龄等一概不公开。
Q35:能用于临床诊断吗?
不能。这不是临床诊断数据——没有临床标签、没有患者群体、没有病理金标准。它的定位是行为/认知研究,任何临床结论都需要另行验证。
Q36:数据集里能不能做个体差异研究?
可以,但要谨慎。10 人足以做个体内(同一人跨三次考试)的纵向分析(这正是设计初衷),但不适合做个体间的组间统计——样本量撑不起。
Q37:如果考试不是 9 点开始的数据存在吗?
不存在。所有考试统一 9:00 AM(CT/CDT)开始,且时间轴未平移,因此每场考试的"距开考分钟数"是可靠的对齐键(§2.4)。
Q38:为什么数据集这么小还值得收录?
因为它填补了"真实世界认知压力"这一数据空白,且可获取性满分。数据集价值不等于规模——稀缺场景 + 完全开放 + 方法工具链配套,使它成为小样本真实数据集的代表案例。
Q39:与其他 PhysioNet 数据集相比它活跃吗?
中等偏下。项目浏览量 1260(抓取时点),属稳定使用但非爆款;引用主要来自压力识别/情感计算/HRV 方向。
Q40:未来最希望它补充什么?
① 扩大被试到可做组间统计的规模;② 增加逐刻压力自评(如考前/考后问卷);③ 多机构采集以检验人群泛化——三者各自对应它的三大现存局限(样本小、弱标签、单群体)。
Q41:为什么本条目反复强调"注明来源"?
因为本数据集最大的引用风险不是许可(很宽松),而是与 WESAD 混淆和准确率口径混用。只要每处数字都写明"来自哪个源、哪个模型",就能避免几乎所有误读。
Q42:如果只记住三件事?
① 10 人真实考场、无诱导、弱标签;② ODC-By-1.0 完全开放、82 MB 秒下;③ 它与 WESAD 是"真实世界 vs 实验室"的两极,勿混。
事实清单(硬事实 34 条)
- 数据集全称:A Wearable Exam Stress Dataset for Predicting Cognitive Performance in Real-World Settings。
- 原始论文标题:A Wearable Exam Stress Dataset for Predicting Grades using Physiological Signals(IEEE HI-POCT 2022)。
- 作者 3 人:Md Rafiul Amin、Dilranjan S. Wickramasuriya、Rose T. Faghih。
- 机构:University of Houston 电气与计算机工程系 Computational Medicine Laboratory;Faghih 现属 NYU Tandon。
- 数据版本:PhysioNet v1.0.0,发布于 2022-05-26。
- 数据集 DOI:10.13026/kvkb-aj90(RRID:SCR_007345)。
- 论文 DOI:10.1109/HI-POCT54491.2022.9744065(会议 2022-03-10/11,Houston)。
- 许可:ODC-By-1.0(Open Data Commons Attribution License v1.0)。
- 访问级别:Open Access(任何人遵守许可即可访问全部文件)。
- 被试数:10 名大学生。
- 性别构成:2 女 + 8 男(去标识目的不在数据中标注)。
- 考试场次:每人 3 场(Midterm 1、Midterm 2、Final),共 30 场。
- 考试时长:期中各 1.5 小时,期末 3 小时。
- 统一开考时间:9:00 AM(CT/CDT)。
- 设备:Empatica E4 腕带(FDA 批准),佩戴非惯用手。
- 信号模态 6 类:EDA、HR、BVP、TEMP、IBI、ACC。
- 采样率:EDA 4 Hz、TEMP 4 Hz、BVP 64 Hz、ACC 32 Hz;IBI 逐搏事件。
- 文件结构:每被试 × 每场 → ACC/BVP/EDA/HR/IBI/tags/TEMP.csv + info.txt。
- 存储体量:82.1 MB(未压缩)/ 82.0 MB(ZIP)。
- 成绩标签:StudentGrades.txt(原始满分 200 分制)。
- 时间戳处理:日期平移去标识、不变时间轴;平移不改夏令时状态。
- 伦理:University of Houston IRB 审批。
- 资助:NSF 1942585(MINDWATCH CAREER)与 1755780(CRII: CPS)。
- 原始论文任务:EDA 趋势线 + 9 工程特征 → 成绩高低二分类。
- 原始论文结果:最高准确率 70-80%。
- 原始论文结论措辞:preliminary viability(初步可行性)。
- EDA 分段:start / middle / end 三段。
- 记录条数示例:某被试 Midterm 1 有 44,712 条 EDA,Final 有 93,582 条。
- 第三方(Applied Psychophysiology 2025)用 EDA/HR/TEMP + 回归树分析成绩关系。
- 第三方(MDPI Sensors 2025)用 IBI/HRV 做外部验证,Midterm1=基线、Final=高压。
- 第三方(arXiv 2606.14960)用全模态 Transformer 报 96% 准确率。
- 无逐刻压力/情绪标注;标签仅场次 + 成绩。
- 无统一 leaderboard/固定划分/统一指标。
- PhysioNet 项目浏览量 1260(抓取时点 2026-10-03)。
术语表(28 条)
| 术语 | 释义 |
|---|---|
| EDA | electrodermal activity,皮肤电活动;汗腺受交感神经支配引起的皮肤电学变化 |
| SC | skin conductance,皮肤电导;EDA 的常用度量,单位微西门子(μS) |
| tonic(SCL) | 皮肤电导的慢变基线分量(skin conductance level) |
| phasic(SCR) | 皮肤电导的快变反应分量(skin conductance response),压力反应主要载体 |
| 去卷积(deconvolution) | 从叠加信号中分离 tonic/phasic 的数学处理 |
| Empatica E4 | FDA 批准的科研级腕带,测 EDA/HR/BVP/TEMP/ACC |
| BVP | blood volume pulse,血容量脉搏(光电容积法) |
| PPG | photoplethysmography,光电容积描记 |
| IBI | inter beat interval,逐搏间期;HRV 分析的原始序列 |
| HRV | heart rate variability,心率变异性;自主神经活动的常用指标 |
| ACC | accelerometer,三轴加速度计;测运动/活动量 |
| TEMP | skin surface temperature,皮肤表面温度 |
| 运动伪影(motion artifact) | 佩戴者运动引起的信号污染 |
| 趋势线(trendline) | 对信号滤波后得到的粗粒度变化曲线 |
| 二分类(binary classification) | 输出两个类别(如成绩高/低)的任务 |
| LOSO | leave-one-subject-out,留一被试交叉验证;小样本生理数据的标准验证协议 |
| 弱标签(weak label) | 不精确/间接的监督信号,如用考试场次代理压力状态 |
| 实验室数据 | 受控环境下人工诱导采集的数据(如 WESAD 的 TSST) |
| 真实世界数据 | 非受控环境下自然发生场景采集的数据(如本数据集的考场) |
| TSST | Trier Social Stress Test,特里尔社会压力测试;实验室常用压力诱导范式 |
| ODC-By-1.0 | Open Data Commons Attribution License v1.0,署名型开放数据许可 |
| Open Access | 开放获取;无注册墙/申请即可访问 |
| PhysioNet | 由 MIT 与 BIDMC 运营的生理信号数据平台(RRID:SCR_007345) |
| HI-POCT | IEEE Healthcare Innovations and Point of Care Technologies 会议 |
| MINDWATCH | NSF CAREER 项目,多模态无创脑状态解码可穿戴闭环架构 |
| 外部验证(external validation) | 在训练数据集之外的独立数据上测试模型 |
| LOSO gap | 跨被试泛化差距;本类小样本数据的核心风险 |
| 夏令时(CT/CDT) | 美国中部时区标准时/夏令时;本数据集时间戳的时区锚 |
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 条目名 | A Wearable Exam Stress Dataset |
| url_name | wearable-exam-stress |
| 类型 | 真实世界可穿戴生理信号数据集 |
| 数据发布 | PhysioNet v1.0.0(2022-05-26) |
| 论文 | IEEE HI-POCT 2022 |
| 团队 | University of Houston 计算医学实验室 |
| 规模 | 10 人 × 3 场考试 = 30 场记录 |
| 信号 | EDA/HR/BVP/TEMP/IBI/ACC |
| 许可 | ODC-By-1.0(Open Access) |
| 体量 | 82.1 MB |
| 抓取时点 | 2026-10-03 |
| 库内互链 | wesad(67)/deap(332)/vitaldb(192)/mhealth(222)/ppg-dalia(202) |
附录 B:DAIMS 评估全表
| 维度 | 评分(1-10) | 依据 |
|---|---|---|
| D 可发现性 | 8 | PhysioNet 平台全球索引、DOI 持久标识、RRID;但名称与 WESAD 易混 |
| A 可获取性 | 10 | ODC-By-1.0 + Open Access + 公共 S3 桶 + 无注册墙——可获取性最高档 |
| I 可互操作 | 7 | 标准 CSV + TXT,任何语言可读;无 DICOM/BIDS 等标准化封装 |
| M 元数据质量 | 7 | info.txt 逐文件说明 + readme + 论文;但逐场考试级别元数据较简 |
| S 可持续性 | 8 | PhysioNet 长期托管(25 年)+ AWS 公共桶;无版本更新风险 |
| 综合评级 | 8.0/10(高) | 可获取性与可持续性突出;扣分主要在互操作标准化与元数据深度 |
附录 C:逐项证据链自证
| 关键数字 | 来源 | 位置 |
|---|---|---|
| 10 subjects / 3 exams | PhysioNet 官方页 + 论文 | Methods/Abstract |
| 2 女 8 男 | PhysioNet 官方页 | Data Description 末条 |
| E4 / FDA / 非惯用手 | PhysioNet 官方页 + 第三方 | Methods |
| 1.5 h / 3 h / 9:00 AM | PhysioNet 官方页 | Data Description |
| ODC-By-1.0 / Open Access | PhysioNet view-license 页 | License 段 |
| 82.1 MB | PhysioNet 文件页 | Files 段 |
| NSFW 1942585 / 1755780 | PhysioNet 官方页 | Acknowledgements |
| 70-80% 准确率 | IEEE HI-POCT 论文摘要 | Abstract |
| 9 特征 / 三段切分 | 第三方转述(arXiv 2606.14960) | §3.1 |
| 44,712 / 93,582 条 | Applied Psychophysiology 2025 | Materials and Methods |
| 96% | arXiv 2606.14960 | Abstract/Results |
| Midterm1=基线 Final=高压 | MDPI Sensors 2025;25(13):4154 | §2.1 |
| 项目浏览量 1260 | PhysioNet 官方页 | Project Views |
附录 D:数据获取决策树
你要做什么?
├── 立刻下载全部数据
│   └── aws s3 sync --no-sign-request s3://physionet-open/wearable-exam-stress/1.0.0/ ./
├── 处理 EDA
│   ├── 1) 下数据
│   └── 2) clone computational-medicine-lab 代码库做去卷积
├── 做压力识别(无原生标签)
│   └── 自造弱标签:Midterm1=基线 / Final=高压(注明是使用者构造)
├── 做成绩预测
│   └── 复现原始 9 特征基线,或扩展多模态+深度模型
└── 做外部验证
    └── 提取 IBI/HRV,用别处训练的模型在本数据集上测试泛化
附录 E:信号速查表
| 信号 | 采样率 | 单位 | 主要用途 | 预处理要点 |
|---|---|---|---|---|
| EDA | 4 Hz | μS | 压力唤起核心指标 | 去卷积分 tonic/phasic |
| HR | 由 BVP 派生 | bpm | 唤起水平 | 与 BVP 一致性核对 |
| BVP | 64 Hz | — | 脉搏波形 | 带通滤波 |
| TEMP | 4 Hz | °C | 外周血管反应 | 去趋势 |
| IBI | 逐搏 | s/ms | HRV 原始输入 | 剔除异常搏动 |
| ACC | 32 Hz | g | 运动/伪影 | 用于伪影识别,柔化阈值 |
附录 F:目录结构模板
S{n}/
├── Midterm 1/
│   ├── ACC.csv
│   ├── BVP.csv
│   ├── EDA.csv
│   ├── HR.csv
│   ├── IBI.csv
│   ├── tags.csv      # 设备事件标记,非状态标签
│   ├── TEMP.csv
│   └── info.txt
├── Midterm 2/        # 结构同上
└── Final/            # 结构同上
StudentGrades.txt     # 全体成绩标签
附录 G:EDA 特征工程骨架(代码)
import numpy as np

def eda_features(eda, fs=4.0):
    """原始论文风格的粗粒度 EDA 特征(示意)。
    eda: 一段考试内的 EDA 序列(μS)
    fs : 采样率(E4 EDA 为 4 Hz)
    """
    n = len(eda)
    a, b, c = eda[:n//3], eda[n//3:2*n//3], eda[2*n//3:]  # start/middle/end
    feats = {
        "mean_start": a.mean(), "var_start": a.var(),
        "mean_mid":   b.mean(), "var_mid":   b.var(),
        "mean_end":   c.mean(), "var_end":   c.var(),
        "diff_mid_start": b.mean() - a.mean(),
        "diff_end_mid":   c.mean() - b.mean(),
        "ratio_mid":  b.mean() / (a.mean() + c.mean() + 1e-9),
    }
    return feats  # 共 9 个特征,供成绩高低二分类
附录 H:多模态对齐骨架(代码)
# 多模态融合前需把不同采样率信号对齐到统一栅格
RATES = {"EDA": 4, "TEMP": 4, "BVP": 64, "ACC": 32, "HR": None, "IBI": None}

def align(signals, target_hz=4):
    """将各信号重采样到 target_hz,并按'距开考分钟数'对齐会话。
    注意:绝对时间戳的日期已被平移,需用日内相对时刻对齐(9:00 AM 开考)。
    """
    import numpy as np
    out = {}
    for name, (t, x) in signals.items():   # t 为秒级时间轴, x 为值
        if name in ("IBI",):               # 事件型 -> 用最近邻填充到栅格
            grid = np.arange(t[0], t[-1], 1.0 / target_hz)
            idx = np.searchsorted(t, grid).clip(0, len(x) - 1)
            out[name] = x[idx]
        else:
            grid = np.arange(t[0], t[-1], 1.0 / target_hz)
            out[name] = np.interp(grid, t, x)
    return out
附录 I:双口径登记表
| # | 项 | 口径 A | 口径 B | 处理 |
|---|---|---|---|---|
| 1 | 标题 | 数据集页 “Predicting Cognitive Performance in Real-World Settings” | 论文 “Predicting Grades using Physiological Signals” | 并列存照 |
| 2 | 准确率 | 原始 70-80%(EDA 单模态) | 第三方 96%(全模态 Transformer) | 注明任务/模型再引用 |
| 3 | 被试描述 | “10 subjects”(论文/数据页) | “a set of students”(新闻稿) | 以论文/数据页为准 |
| 4 | 时间线 | 论文 2022-03 会议 | 数据 2022-05-26 发布 | 分记两个时点 |
附录 J:坑点档案(与 §10 对照)
| 坑 | 一句话档案 | 触发场景 |
|---|---|---|
| 坑 1 | 与 WESAD 混淆(15 vs 10 人) | 引用规模/标签 |
| 坑 2 | 数据集标题 vs 论文标题不同 | 检索/著录 |
| 坑 3 | 70-80% vs 96% 双口径 | 性能引用 |
| 坑 4 | 无统一 benchmark | 复现/对比 |
| 坑 5 | tags.csv 非状态标签 | 预处理 |
| 坑 6 | 10 人小样本过度解读 | 结论外推 |
| 坑 7 | 运动伪影污染信号 | 建模 |
| 坑 8 | 时间戳仅日期平移 | 跨库时间对齐 |
附录 K:维护计划与触发点
| 触发点 | 条件 | 动作 | 优先级 |
|---|---|---|---|
| 新版本发布 | PhysioNet 出现 v1.1+ | 更新规模/许可/版本链 | 1 |
| 新下游论文 | 用本数据集的新公开研究 | §7.2 表扩行 | 2 |
| 官方平台变动 | PhysioNet 托管策略/许可变化 | §6 改写 | 3 |
| 代码库更新 | computational-medicine-lab 新工具 | §6.4 补充 | 4 |
附录 L:缩略语速查
| 缩写 | 全称 |
|---|---|
| EDA | electrodermal activity |
| SC / SCL / SCR | skin conductance / level / response |
| HR / HRV | heart rate / variability |
| BVP / PPG | blood volume pulse / photoplethysmography |
| IBI | inter beat interval |
| ACC | accelerometer |
| TEMP | skin surface temperature |
| ODC-By | Open Data Commons Attribution License |
| DAIMS | Discoverability/Accessibility/Interoperability/Metadata/Sustainability |
| LOSO | leave-one-subject-out |
| TSST | Trier Social Stress Test |
| RRID | Research Resource Identification |
附录 M:FAIR 检查单
| 检查项 | 状态 | 说明 |
|---|---|---|
| F1 全局唯一标识 | ✅ | DOI 10.13026/kvkb-aj90 + RRID |
| F2 富元数据 | ✅ | readme + info.txt + 论文 |
| A1 可访问协议 | ✅ | Open Access,HTTP/S3 直链 |
| A2 元数据可访问 | ✅ | 元数据随数据全开放 |
| I1 互操作格式 | ⚠️ | CSV/TXT 通用但未用 BIDS 等标准 |
| I2 词汇表引用 | ✅ | EDA/HRV 等标准生理学术语 |
| R1 来源溯源 | ✅ | 采集流程与机构明示 |
| R1.2 许可明确 | ✅ | ODC-By-1.0 明确标注 |
| AI-Ready 综合 | 高 | 开放可获取性最好的一档 |
附录 N:与 WESAD 对照总表(跨库)
| 维度 | WESAD(rid 67) | 本数据集 |
|---|---|---|
| 场景 | 实验室 | 真实考场 |
| 诱导 | TSST + 视频 | 无 |
| 被试 | 15 有效 | 10 |
| 设备 | RespiBAN + E4 | 仅 E4 |
| 信号 | ECG/EDA/EMG/RESP/TEMP/ACC/BVP | EDA/HR/BVP/TEMP/IBI/ACC |
| 标签 | 情绪状态 + 问卷 | 场次 + 成绩 |
| 许可 | 见原站 | ODC-By-1.0 |
| 库内 rid | 67 | 本条目 |
附录 O:许可条款细读(ODC-By-1.0)
- 允许:复制、分发、使用、生产衍生作品;
- 允许商用:无"非商业"限制;
- 允许修改/再分发:无"禁止演绎/相同方式共享"限制;
- 唯一义务:署名(attribution)——标明来源数据集与许可;
- 无担保:数据按"原样"提供。
与 CC BY-4.0 的异同:两者精神一致(署名型开放许可),ODC-By 面向数据库/数据专门设计并明确覆盖数据集合的权利,CC 面向作品。
附录 P:检索路径示范
| 目标 | 推荐查询式 | 预期命中 |
|---|---|---|
| 官方数据 | physionet wearable exam stress | PhysioNet v1.0.0 |
| 原始论文 | “A Wearable Exam Stress Dataset for Predicting Grades” | IEEE HI-POCT 2022 |
| 下游工作 | doi:10.13026/kvkb-aj90 citations | PhysioNet 引用列表 + 各期刊 |
| 代码 | computational-medicine-lab GitHub | EDA 处理库 |
| 反例(勿混) | “wearable exam stress” WESAD 15 subjects | 会把两数据集数字混淆(坑 1) |
附录 Q:30 秒决策卡
| 你的情况 | 行动 |
|---|---|
| 想找个开放小数据集练手 | S3 直下 82 MB,秒级到手 |
| 做 EDA 去卷积 | 下数据 + clone 官方代码库 |
| 做压力识别 | 自造弱标签(Midterm1 基线/Final 高压),注明构造 |
| 做跨数据集外部验证 | 提取 IBI/HRV,用你的模型来测 |
| 写综述 | §3.4 WESAD 对照 + §7 第三方使用表可直接引 |
附录 R:本条目生产档案
- 生产通道:rsi_dispatch 任务头 wearable-exam-stress
- 存在性核验:WebSearch ×3 + WebFetch ×3 + 官方页 curl 实抓(PhysioNet 页面/readme/LICENSE/文件列表/view-license)
- 三源互证:PhysioNet 官方页 + IEEE HI-POCT 论文 + 第三方复现(Springer/MDPI/arXiv)
- FACTS.md:writing/wearable-exam-stress/FACTS.md 九节
- 成稿方式:五块直写拼接(part1-5),私有区目录带时间戳+PID 唯一化
- 坑点:§10 八则(坑 1-8)
- description:成稿即 ≤170 字符
- title:含
| 千方病案医数集后缀
附录 S:与库内同域条目互链矩阵
| 库内条目 | rid | 共享点 | 差异点 | 建议内链位置 |
|---|---|---|---|---|
| WESAD | 67 | 可穿戴+压力+E4 | 实验室 vs 真实考场 | §3.4、§9.1、FAQ Q10 |
| DEAP | 332 | 外周生理+心理状态 | 诱发方式(音视频) | §9.1 |
| MHEALTH | 222 | 可穿戴多模态 | 日常活动 vs 考场 | §9.1 |
| PAMAP2 | 212 | 可穿戴体动/心率 | 活动识别 vs 成绩 | §9.1 |
| PPG-DaLiA | 202 | BVP/PPG 信号 | 活动标签 vs 场次 | §9.1 |
| BIDMC-PPG | 74 | PPG 信号 | 临床 vs 考场 | §9.1 |
| BUTPPG | 803 | PPG 信号 | 场景不同 | §9.1 |
| VitalDB | 192 | 多参数生命体征(PhysioNet) | 临床受控 vs 日常 | §9.1 |
| EEGMMIDB | 342 | 生理信号分类基准 | 模态(EEG) | §8.3 |
| BCI-IV-2a | 352 | 生理信号分类基准 | 模态(EEG) | §8.3 |
| Gait-PD | 242 | 可穿戴传感器 | 任务(步态) | §8.3 |
| Daphnet-FOG | 252 | 可穿戴加速度计 | 任务(冻结步态) | §8.3 |
| NinaPro | 372 | 可穿戴 EMG | 任务(手势) | §8.3 |
| NSRR | 312 | 长时程真实生理信号 | 模态(睡眠) | §8.3 |
| HMC-Sleep-Staging | 654 | 长时程真实生理信号 | 模态/任务 | §8.3 |
附录 T:数据集元数据速查(供自动抓取)
slug: wearable-exam-stress
title: "A Wearable Exam Stress Dataset for Predicting Cognitive Performance in Real-World Settings"
version: "1.0.0"
published: "2022-05-26"
doi: "10.13026/kvkb-aj90"
rrid: "SCR_007345"
license: "ODC-By-1.0"
access: "open"
size_uncompressed_bytes: 82000000   # 约 82.1 MB
subjects: 10
sessions_per_subject: 3
total_sessions: 30
device: "Empatica E4"
signals: ["EDA", "HR", "BVP", "TEMP", "IBI", "ACC"]
sampling_hz: {EDA: 4, TEMP: 4, BVP: 64, ACC: 32}
labels: ["session", "grade"]
paper_doi: "10.1109/HI-POCT54491.2022.9744065"
code: "https://github.com/computational-medicine-lab"
附录 U:应用场景矩阵
| 应用方向 | 可行性 | 说明 |
|---|---|---|
| 压力识别算法开发 | 中 | 需自造弱标签(场次代理) |
| 成绩/表现预测 | 高 | 数据集原生任务 |
| HRV 特征研究 | 高 | IBI 信号完整 |
| 跨数据集泛化测试 | 高 | 真实伪影环境是天然压力测试 |
| EDA 去卷积方法验证 | 高 | 配官方代码库 |
| 运动伪影鲁棒性研究 | 高 | ACC+EDA 耦合是理想素材 |
| 临床诊断模型 | 低 | 无临床标签与患者群体 |
| 组间统计对比 | 低 | 10 人样本撑不起 |
附录 V:引用完整性与复现清单
- 数据引用:Amin, Wickramasuriya & Faghih (2022), PhysioNet, doi:10.13026/kvkb-aj90;
- 论文引用:Amin et al. (2022), IEEE HI-POCT, doi:10.1109/HI-POCT54491.2022.9744065;
- 平台引用:PhysioNet 平台论文(Pollard et al., Nature Health 2026)+ RRID:SCR_007345;
- 许可声明:ODC-By-1.0,保留署名;
- 口径声明:准确率须注明模型/模态(70-80% 或 96%);
- 样本声明:明确 10 人 30 场,结论为提示性;
- 预处理复现:EDA 去卷积 + 多模态对齐 + 个体归一化(§4.5);
- 验证协议:建议 LOSO 交叉验证并报告置信区间;
- 弱标签声明:若自造压力标签(如 Midterm1=基线/Final=高压),必须写明是使用者构造;
- 版本存照:抓取时点 v1.0.0(§6.3)。
附录 W:30 秒决策卡(补充版)
| 你的情况 | 行动 |
|---|---|
| 零基础想跑通 | S3 一条命令下载,head 每个 CSV 看格式,先画 EDA 曲线 |
| 有 EDA 处理经验 | clone 官方代码库,去卷积后提 phasic 特征 |
| 做深度多模态 | 注意个体归一化与 LOSO,谨防 10 人过拟合 |
| 做模型评测 | 用作外部验证/鲁棒性测试,而非主要训练集 |
| 写综述/教学 | §3.4 WESAD 对照 + §7 第三方使用 + 附录 N 可直接引 |
| 找同类数据 | 库内 wesad(67)/deap(332)/mhealth(222) 同域,逐条对照 |
附录 X:原始文档缺陷存照
| 项 | 现象 | 处理 |
|---|---|---|
| 论文/数据集标题 | 两套标题(认知表现 vs 成绩) | 并列,标明出处 |
| 参与者描述 | 新闻稿"a set of students" vs 论文"10 subjects" | 以论文/数据页为准 |
| 准确率 | 70-80% vs 96% | 注明模型/模态 |
| 时间线 | 论文 2022-03 vs 数据 2022-05-26 vs 新闻稿 2022-12 | 分记三个时点 |
| 性别 | 数据中不标注(去标识),但文档披露 2 女 8 男 | 引用时说明系文档披露而非数据字段 |
尾注
本条目为 AI-Ready Wikipedia 数据集条目,生产于 2026-10-03,抓取与核验时点见附录 A。事实陈述以 PhysioNet 官方页(v1.0.0, doi:10.13026/kvkb-aj90)、原始论文(IEEE HI-POCT 2022, doi:10.1109/HI-POCT54491.2022.9744065)与第三方复现(Springer Applied Psychophysiology 2025、MDPI Sensors 2025、arXiv 2606.14960)为源;论文标题口径差异、准确率双口径、参与者描述差异等原始文档特性已在坑点与附录 I 存照。条目与库内 WESAD(rid 67)、DEAP(rid 332)、VitalDB(rid 192)、MHEALTH(rid 222)、PPG-DaLiA(rid 202)等条目互链,构成可穿戴生理信号与压力识别家族的完整检索面。后续维护触发点见附录 K。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- consumer-grade-wearables — 共享标签:生理信号 / 可穿戴传感 / 评测基准 / 神经科学
- shanghai-t1dm-t2dm-cgm — 共享标签:生理信号 / 可穿戴传感 / 时序数据 / 评测基准
- ou-dataset-t1d — 共享标签:生理信号 / 可穿戴传感 / 时序数据 / 多模态
- nebula-reaching-eeg — 共享标签:生理信号 / 可穿戴传感 / 评测基准 / 神经科学
- d1namo — 共享标签:生理信号 / 可穿戴传感 / 时序数据 / 多模态
- globem — 共享标签:生理信号 / 可穿戴传感 / 评测基准 / 神经科学
- wesad — 共享标签:生理信号 / 可穿戴传感 / 多模态
- dandi-archive — 共享标签:生理信号 / 神经科学 / 多模态
- visem — 共享标签:生理信号 / 评测基准 / 多模态
- microns — 共享标签:评测基准 / 神经科学 / 多模态
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
