即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 1840 个数据集
Lacuna — 跨三大洲 60 万住院的重症监护协调时序数据集
把美欧中九个 ICU/ED 源库用 ricu 概念层协调成近 10 亿数据点的超大规模时序集合——首次纳入治疗变量(给药速率与剂量),并为跨院迁移学习立基准:LightGBM 仍胜深度模型
MAUDE — FDA 医疗器械不良事件报告数据库
美国 FDA 依 21 CFR Part 803 强制收集的医疗器械不良事件(MDR)库:制造商/进口商/使用机构/自愿者四路报告,1991 年以来累计逾 2,300 万条,CC0 公有领域开放,配套 openFDA API 与全量 pipe-delimited 下载——器械安全监测的全球基准库
PLUMBER — 蛋白-配体未见靶点匹配基准,180 万条序列基结合活性数据
Bioptic 出品的序列基蛋白-配体结合预测基准:整合 ChEMBL+BindingDB+BioLip2 三源、经 PAINS 过滤与标准化得约 180 万条活性值,采用 PLINDER 未见靶点 split 做泛化压力测试,CC-BY-4.0 发布于 Polaris Hub
MotifBench — 基序支架蛋白质设计的标准化评测基准
30 个来自 PDB 实验结构的挑战性 motif 测试问题 × 每问题 100 个骨架 = 3,000 个 backbone 的评测规范,以 ProteinMPNN 序列设计 + ESMFold 折叠验证的双 RMSD 判据量化基序支架方法,含开源实现与社区排行榜
CZ CryoET Data Portal — 冷冻电子断层扫描标准化注释门户
Chan Zuckerberg 影像研究所(CZ Imaging Institute)构建的 cryo-ET ML-ready 门户——以统一 schema 与云优化 OME-Zarr 格式聚合标准化三维细胞断层数据,五级实体(Deposition/Dataset/Run/Tomogram/Annotation)配 CC0 开放许可,为分割、粒子挑选与亚断层平均算法提供跨库训练与基准底座
OpenADMET ExpansionRx — 真实药企先导优化 ADMET 盲挑战数据集
Expansion Therapeutics 开源 7,600+ 分子、9 个 ADMET 端点的真实先导优化数据,2025-10 至 2026-01 由 OpenADMET 与 Hugging Face 联合主办盲挑战,370+ 参赛者用时间切分预测晚期分子性质,CC-BY-4.0 全量公开
PSBench — 蛋白复合物结构模型准确性估计的大规模基准
密苏里大学 2025 年 NeurIPS Datasets & Benchmarks 基准套件:5 个数据集、逾 140 万个由 AlphaFold2-Multimer 与 AlphaFold3 生成的蛋白复合物结构模型,逐模型标注全局/局部/界面三层共 10 种质量分数,衍生图变换器基线 GATE 在 CASP16 社区盲测名列前茅
MTCMB — 多任务中医评估基准
中山大学等四机构联合持证中医师共建的中医药大模型评测基准:12 个子数据集、5 大维度(知识问答/语言理解/诊断推理/方剂推荐/安全评价)、7,100 条标注样本,源自国家执业考试题库、十三五教材与《中国药典》,CC BY 4.0 开放
COBRA — 基底细胞癌及多样皮肤恶性肿瘤全切片病理数据集
Radboudumc 出品的皮肤病理全切片图像(WSI)数据集:BCC 活检 + 非 BCC 多样病变 + 带像素级标注的切除标本,配荷兰语病理报告与 PRISM 基础模型嵌入,兼顾分类、分割、OOD 检测与视觉语言研究
RareBench — 大语言模型罕见病诊断能力评测基准
首次系统性评估 LLM 罕见病诊断的四维基准——1,197 例开源罕见病病例覆盖表型提取/筛查/比较分析/鉴别诊断,GPT-4 top-1 52.0% 头对头胜过资深专科医师 44.7%,动态少样本提示让六模型 top-1 召回平均 +108%
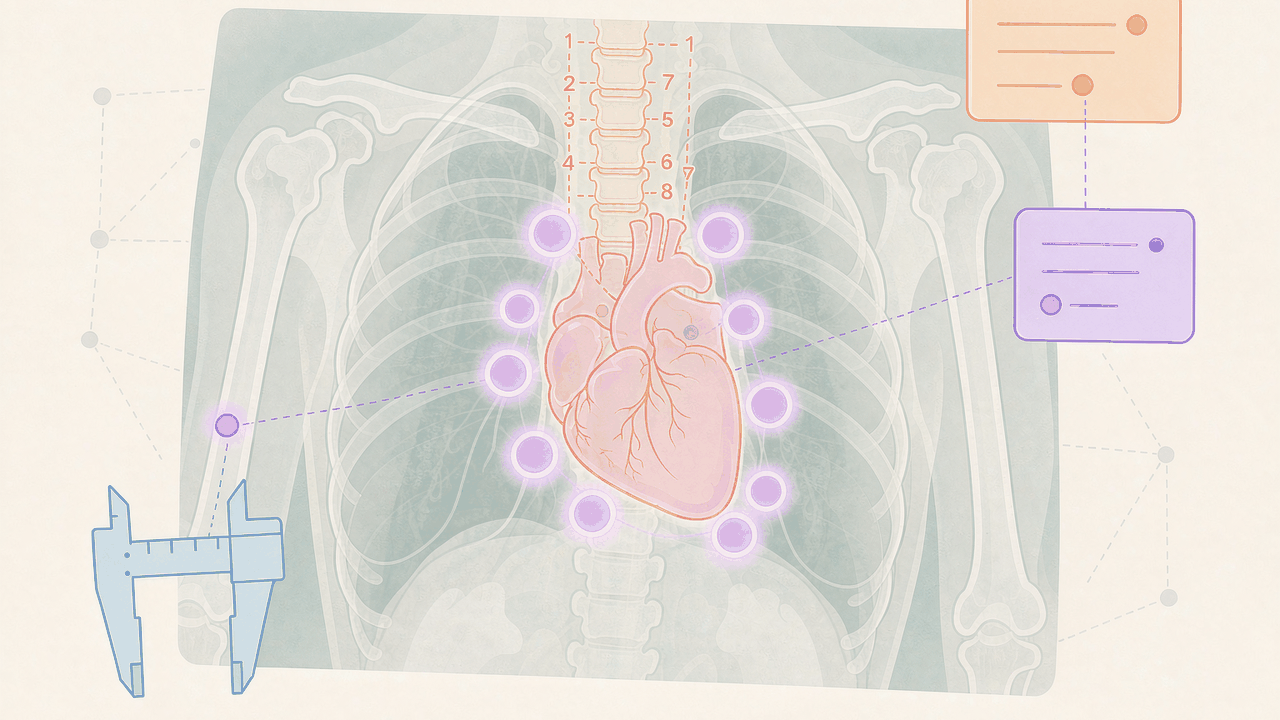
CCK / VHSMarker — 犬类胸片心脏关键点与椎体心脏评分基准
21,465 张犬侧位胸片、12,385 只犬、144 品种的六点心脏关键点标注集——配套 10-12 秒/图标注工具 VHSMarker 与状态空间基线 MambaVHS(91.8%),把兽医胸片的心大评估从人工卡尺推向可复现基准
Spatial Touchstone — 影像型空间转录组学界首个标准化评测与重现性基准
St. Jude 牵头·三站点双平台(Xenium+CosMx SMI)跨机构重复实验,FFPE 六组织 203 个空间 profile(公共 127+自产 76)、800 万+细胞,配套 SpatialQM 软件与 Spatial Touchstone Portal 在线质控门户,把「先跑一遍看质量」变成空间生物学开工前的标准动作
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
