即取即用的 AI-Ready 医疗数据集库

致力于为医疗 AI 研究人员找到合适的数据集。已收录 1,907 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。

需要具备完整溯源、伦理合规与工程化交付的专病训练集?进入医疗数据商城 →

按工程化层级:

数据标签

千方医数集 · 商业级 AI-Ready 数据集

官方自营 · 合规交易

乳腺阳性影像数据集

乳腺钼靶阳性病例影像数据,覆盖肿块、钙化等典型征象,面向乳腺 AI 辅助筛查模型训练。

TCT 宫颈细胞学数据集

液基薄层细胞学(TCT)数字图像,含阴阳性判读结果,适配宫颈癌细胞学筛查模型。

需要更多专病队列?

千方医数集支持按病种、模态合规定制采集。

提交定制需求

医学影像 AI-Ready 数据集

电子病历与文本数据集

病灶分割与标注数据集

共 1681 个数据集

SpikeInterface — 细胞外电生理统一分析框架
神经科学生理信号脑电信号多模态

SpikeInterface — 细胞外电生理统一分析框架

MIT 许可58 个 PyPI 版本23 个 spike sorter17 个外部 sorter4 个内部 sorter0.105.3 当前版Python 3.10+10 种以上格式0

23 个 spike sorter、一个接口,和两次让旧代码全部失效的版本变更
IBL Brain-Wide Map — 小鼠全脑决策活动图谱
神经科学生理信号脑电信号多模态

IBL Brain-Wide Map — 小鼠全脑决策活动图谱

12 个实验室139 只小鼠459 个 session699 次探针插入62.2 万个单元7.5 万个良品单元279 个脑区AWS 公开桶0

12 个实验室、139 只小鼠、69.9 万次探针插入,拼出一张全脑活动图
DANDI Archive — 神经电生理数据联邦档案库
神经科学生理信号电子健康记录多模态

DANDI Archive — 神经电生理数据联邦档案库

NWB 格式BIDS 格式OME-Zarr上千个 dandisets版本化数据集CC-BY-4.0元数据 CC0单文件 5 TB 上限embargo 6 个月0

它不是一个数据集,是上千个数据集的容器。首页写着一千零五十九个、九百二十二太比特,同一个站的 API 却报九百三十八、一千二百零九;四个官方来源给出四个规模数字。这个库真正值得学的是它怎么把「版本」和「许可」做成硬约束
EPILEPSIAE — 欧洲癫痫长程脑电数据库
生理信号脑电信号癫痫队列研究

EPILEPSIAE — 欧洲癫痫长程脑电数据库

长程脑电监测颅内脑电发作预测四段时刻标注空间扩散标注症状学描述表面与颅内双模态术前评估275

三家医院、二百七十五名术前监测患者、四万五千小时连续脑电。它比此前所有公开脑电库加起来大两个数量级,却从不免费——按数据集个数分档售卖,两万五千欧元起。这份数据库真正稀缺的不是规模,是把一次发作拆成四个时刻的那种标注方式
TUSZ — 坦普尔大学医院癫痫发作脑电语料库
生理信号脑电信号癫痫评测基准

TUSZ — 坦普尔大学医院癫痫发作脑电语料库

癫痫发作检测长程脑电事件级标注类别失衡跨中心泛化BIDS 格式临床脑电基准评测675

一万六千小时的临床脑电里,只有百分之零点二的片段装着发作。为了把这些片段挖出来,一群工程师用关键词、商业软件和自研模型三方交叉筛了一遍,最后留下 675 名患者、1,476 小时、4,029 次发作
SimSUM — 结构化表格×GPT-4o 临床笔记的合成临床信息抽取基准
电子健康记录临床电子病历医疗NLP临床文本医学问答与基准评测基准

SimSUM — 结构化表格×GPT-4o 临床笔记的合成临床信息抽取基准

合成数据文本数据结构化表格人工标注机器标注10,000 条虚构患者就诊记录(全合成,无真实患者);每条含 1 份正常笔记 + 1 份精简笔记

一万条初级保健呼吸病例:专家贝叶斯网络采出 16 个表格变量,GPT-4o 据此写出双版本临床笔记(正常版与精简版),再用 LLM 反抽 4.2 万个症状 span——把「表格背景知识能否补文本之不足」变成可复现的对照实验
RxQA
医学问答与基准评测基准药物安全医疗NLP

RxQA

文本数据标注数据评测集无真实患者数据(题面为药师改写的合成病例情境);600 题 = OpenFDA 300(美)+ BNF 300(英);开源半区实测长题干(>400 字符)198 道

Google Health 药物知识问答基准——Gemini 1.5 Flash 起草、8 名 board-certified 执业药师修订与五档难度评级,600 道四选一 MCQ(OpenFDA 300 开源 + BNF 300),高难度题 AMIE 准确率反超 21 名初级保健医生,Nature 正刊发表
CT-Bench — DeepLesion 病灶级图文重标注与七任务 CT 视觉问答基准
医学影像CT视觉问答评测基准目标检测影像-文本对齐

CT-Bench — DeepLesion 病灶级图文重标注与七任务 CT 视觉问答基准

人工标注影像数据原始数据3,793 名患者 / 7,795 例 CT 检查 / 20,335 个病灶实例(训练 2,835 人 / 验证 342 人 / 测试 616 人)

20,335 个病灶 / 7,795 例 CT / 3,793 名患者的病灶级描述、尺寸与 BBox 资源,叠加 2,850 道四选一难负例 QA,NIH 团队 GPT-4 预标+专家终审流水线产出,Kaggle 公开 CC BY-NC-SA 4.0
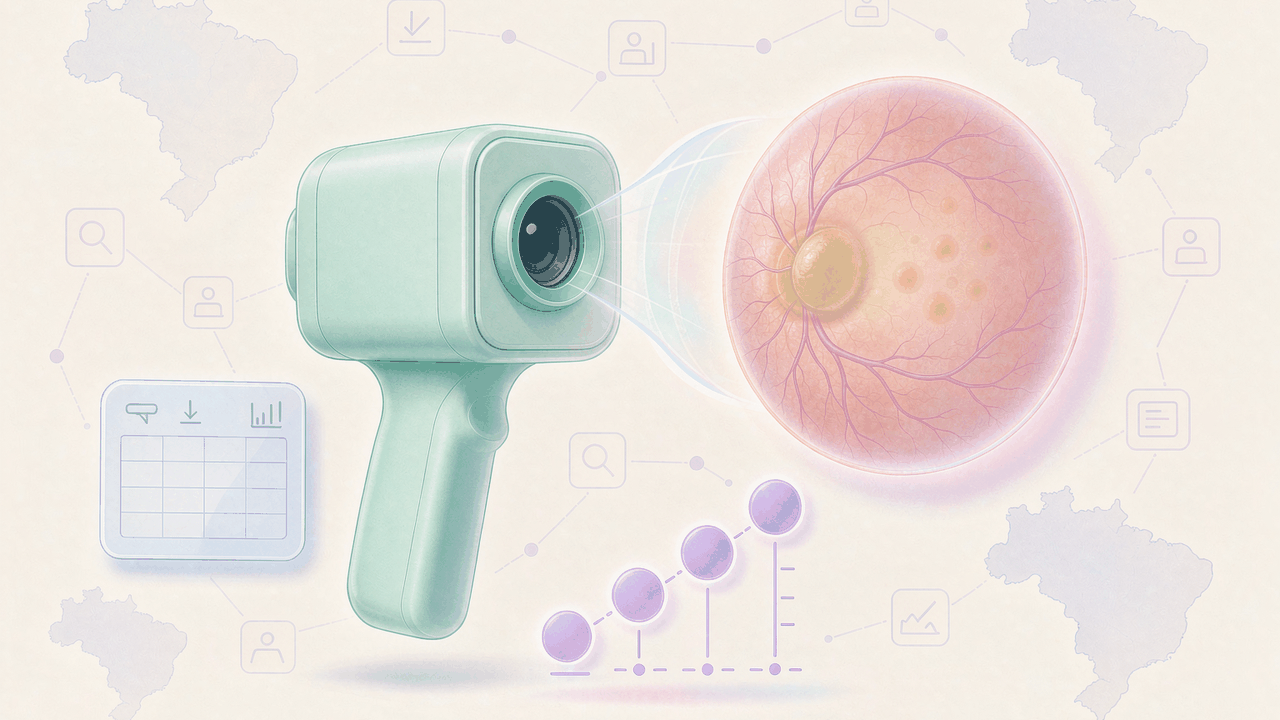
mBRSET — 移动巴西视网膜数据集 5,164 张手持眼底照
医学影像眼科影像图像分类糖尿病视网膜病变公共卫生与流行病学评测基准

mBRSET — 移动巴西视网膜数据集 5,164 张手持眼底照

人工标注影像数据原始数据1,291 名糖尿病患者 / 5,164 张眼底彩照(单次筛查活动,2022 年 11 月)

首个用 Phelcom Eyer 手持相机在巴西高负担社区场景采集的糖尿病视网膜病变数据集:5,164 张 / 1,291 名患者,附 ICDR 分级、黄斑水肿、教育/医保公平性标签
MIMIC-Ext-SynNotes — 用 LLM 改写 MIMIC-III/IV 生成的十亿词级合成临床笔记语料
医疗NLP临床文本电子健康记录重症监护医学问答与基准

MIMIC-Ext-SynNotes — 用 LLM 改写 MIMIC-III/IV 生成的十亿词级合成临床笔记语料

合成数据文本数据原始数据约 464 万条唯一笔记(~1.4B 词,来源 MIMIC-III v1.4 与 MIMIC-IV-Note v2.2 去重后);患者级数量沿用上游 MIMIC 口径(MIMIC-III 约 4 万

五个开源权重 LLM(Llama/Mistral/Qwen/Gemma/Mixtral)把 MIMIC-III v1.4 与 MIMIC-IV-Note v2.2 的全部 464 万条真实笔记改写为 8 个合成语料、合计 137 亿词——粗粒度任务保住效用、细粒度细节丢失,分片改写挽细节却增幻觉,是全库最大的 LLM 合成临床文本样本
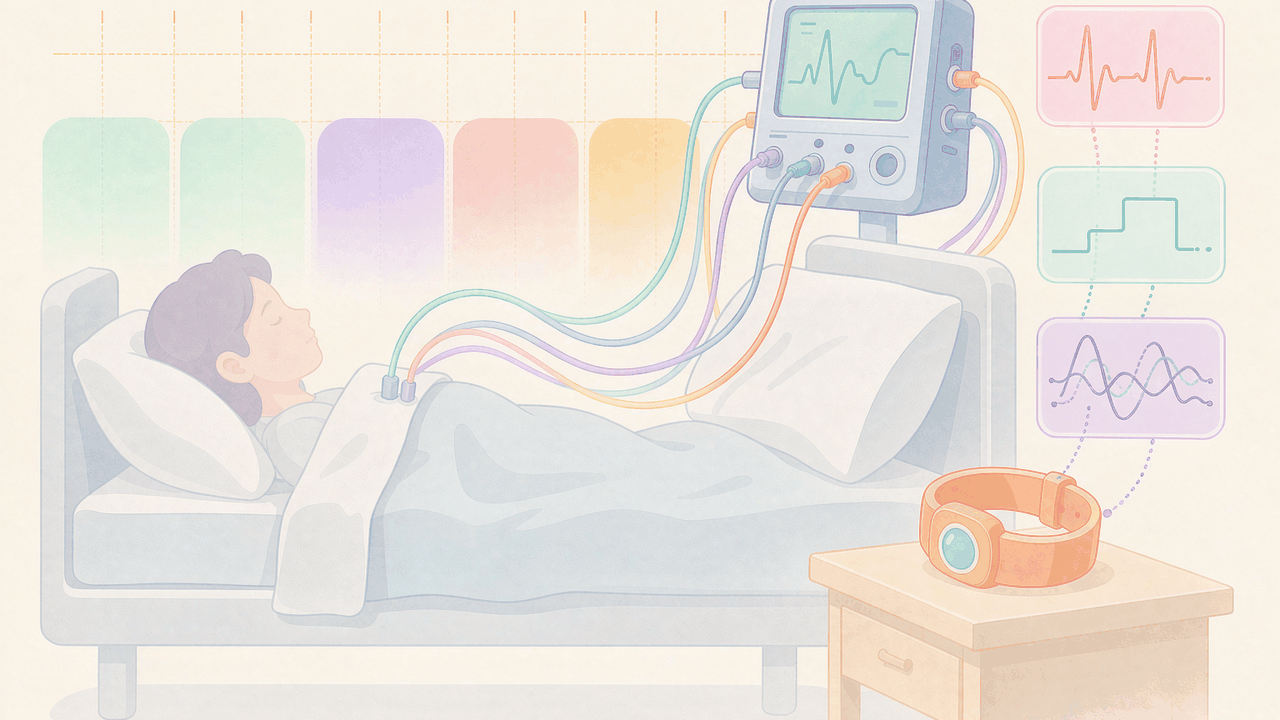
DREAMT
生理信号睡眠信号可穿戴传感评测基准

DREAMT

时序信号数据人工标注原始数据100 名受试者(每人一夜同步记录;SID 编号 S002-S103 非连续)

Duke 大学 Jessilyn Dunn 团队的单晚临床 PSG + Empatica E4 腕式可穿戴时序对齐多模态数据集——100 名睡眠障碍门诊患者、64Hz/100Hz 双目录、30 秒 AASM 分期,CHIL 2024 提出 LSTM 后处理与混合效应提升树集成,PhysioNet 受限访问发布
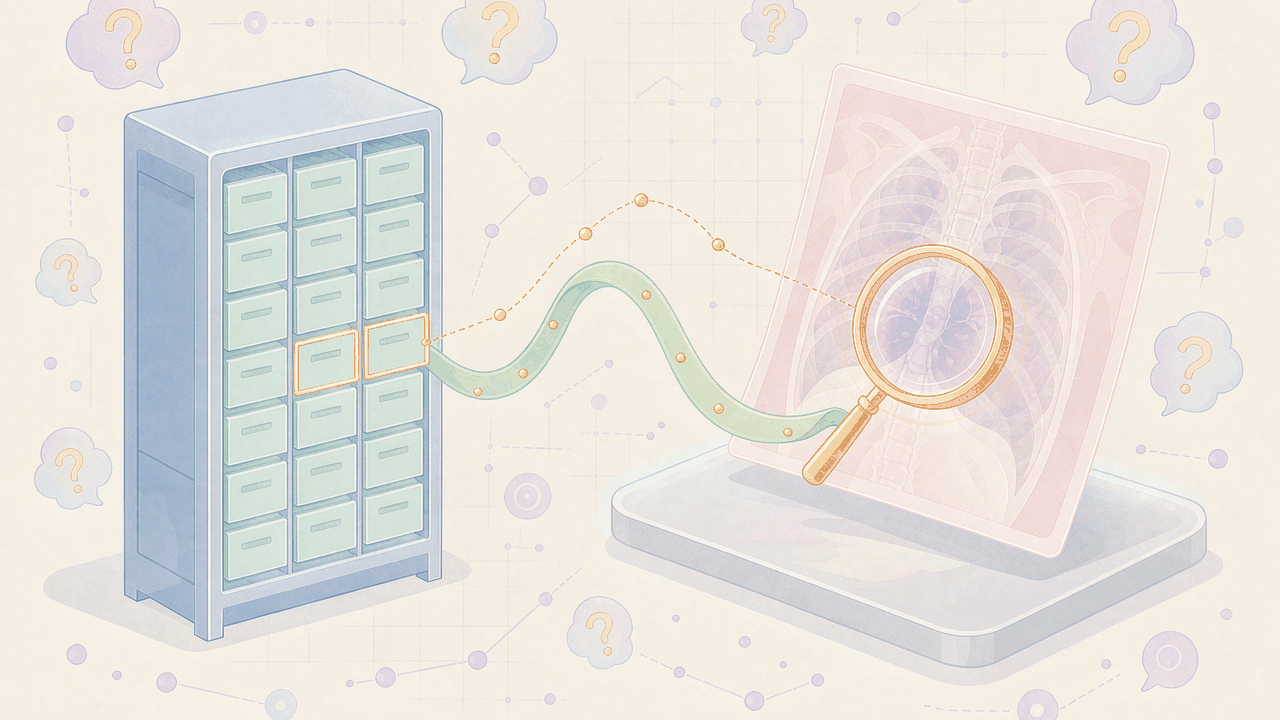
EHRXQA
电子健康记录医学问答与基准多模态X光影像

EHRXQA

影像数据时序数据派生数据一体化数据库 silver 800 患者(训练/验证,机器标注)+ gold 400 患者(测试,人工标注);三上游共享患者 19,264;QA 对 46,152(train 36,174 / val

首个融合结构化电子健康记录与胸片图像的多模态问答基准——NeuralSQL 把视觉问答函数嵌进 SQL 执行流,417 个模板机器生成 46,152 道临床题,NeurIPS 2023 Datasets & Benchmarks 发表、PhysioNet v1.0.0 凭证获取

定制数据集服务

无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。