即取即用的 AI-Ready 医疗数据集库

致力于为医疗 AI 研究人员找到合适的数据集。已收录 1,866 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。

需要具备完整溯源、伦理合规与工程化交付的专病训练集?进入医疗数据商城 →

按工程化层级:

数据标签

千方医数集 · 商业级 AI-Ready 数据集

官方自营 · 合规交易

乳腺阳性影像数据集

乳腺钼靶阳性病例影像数据,覆盖肿块、钙化等典型征象,面向乳腺 AI 辅助筛查模型训练。

TCT 宫颈细胞学数据集

液基薄层细胞学(TCT)数字图像,含阴阳性判读结果,适配宫颈癌细胞学筛查模型。

需要更多专病队列?

千方医数集支持按病种、模态合规定制采集。

提交定制需求

医学影像 AI-Ready 数据集

电子病历与文本数据集

病灶分割与标注数据集

共 1640 个数据集

ENPD 2018 — 阿根廷全国残疾人群画像调查的微观数据
公共卫生与流行病学公共卫生统计调查数据卫生服务研究

ENPD 2018 — 阿根廷全国残疾人群画像调查的微观数据

个体级微观数据抽样调查重复权重设计82,327 条个体记录,加权代表 39,922,669 人;其中 6 岁及以上有功能困难者 3,571,983 人

82,327 份个体记录 / 39,922,669 人加权 / 300 组 bootstrap 权重
MEROPS — 把蛋白酶切了什么、切在哪记下来的库
基因组学与多组学蛋白质组学药物-靶点相互作用

MEROPS — 把蛋白酶切了什么、切在哪记下来的库

酶分类体系切割位点表序列比对库不涉及患者数据;记录对象是蛋白质序列、切割事件与化合物

277 个家族 / 114 万个序列编号 / 91 次切割的位点偏好

BioSamples — 5,610 万条生物样本元数据的中枢登记处
基因组学与多组学变异与注释测序数据

BioSamples — 5,610 万条生物样本元数据的中枢登记处

样本元数据结构化注释表不直接涉及患者个体;但 56M+ 样本中包含大量人类样本(taxId 9606),其 age、cell_type、disease 等字段属可识别性敏感信息,使用须评估

把分散在 ENA、NCBI、ArrayExpress 的样本记录按一个键聚合,每条最多 50 个特征字段
Single Cell Expression Atlas — 正迁往 FENIX 的单细胞重处理库
基因组学与多组学单细胞基因组学转录组

Single Cell Expression Atlas — 正迁往 FENIX 的单细胞重处理库

表达矩阵细胞类型注释样本注释表不直接涉及患者个体;样本级元数据含年龄、性别、疾病、组织部位等公开信息

384 个实验、1,537 万个细胞,31% 有细胞类型标签;2026 年 11 月起分批迁移
Tahoe-100M — 亿级单细胞药物扰动图谱:50 癌系 × 379 化合物
单细胞基因组学转录组药物发现与化学评测基准基因组学与多组学

Tahoe-100M — 亿级单细胞药物扰动图谱:50 癌系 × 379 化合物

原始数据实验数据公开数据不适用:全部为 50 个商品化癌细胞系(47 个进入下游分析),非患者样本;单细胞数 95,624,334

Tahoe Therapeutics × Arc Institute × Parse Biosciences 用 Mosaic 平台把 50 个癌细胞系混养在「cell village」中同步给药 24 小时,得到 95,624,334 个通过全过滤的单细胞转录组;CC0-1.0 全量开放于 HuggingFace,FASTQ 因 125 TB 体量与 Parse 合同限制不公开
NMSC Spatial Multi-omic Atlas — 免疫抑制非黑素瘤皮肤癌的空间多组学图谱
基因组学与多组学转录组单细胞基因组学皮肤癌肿瘤学

NMSC Spatial Multi-omic Atlas — 免疫抑制非黑素瘤皮肤癌的空间多组学图谱

原始数据多组学数据138 例患者 / 150 份标本(55 免疫正常 IC + 83 免疫抑制 IS);GEO 层:GSE316922 36 样本来自 30 例,GSE306129 论文口径 14 例 / GEO 口径

GSE306129 空间 ATAC 28 样本 x GSE316922 scRNA-seq 36 样本 的双层 GEO 资源:MD 安德森 138 例 BCC/cSCC 队列揭示「免疫抑制不是免疫细胞变少,而是巨噬细胞抗原呈递失灵 + 空间组织被拆散」
Expression Atlas — 重新计算过的公共基因表达数据
基因组学与多组学转录组单细胞基因组学变异与注释

Expression Atlas — 重新计算过的公共基因表达数据

表达矩阵差异分析结果样本注释表不直接涉及患者个体(样本级元数据含年龄、性别、疾病等字段,属公开文献与数据库已发布信息)

EMBL-EBI 手工策展、统一重处理的 4,562 个转录组与蛋白组实验
GHDx — 全球健康数据的总目录与可获取性登记册
公共卫生与流行病学公共卫生统计全球健康调查数据

GHDx — 全球健康数据的总目录与可获取性登记册

目录元数据混合数据类型不涉及患者个体(目录层,条目指向外部数据集)

16 类数据、200 余国家地区、四级获取门槛的健康数据索引

Cellosaurus — 16.9 万细胞系的鉴定权威与误认档案
基因组学与多组学变异与注释知识图谱肿瘤学

Cellosaurus — 16.9 万细胞系的鉴定权威与误认档案

文本与本体数据人工标注不涉及患者个体(细胞系条目 169,026 个,含物种、性别、年龄与疾病标签)

16.9 万细胞系、904 物种、47 万条交叉引用的细胞系知识库

HMD — 41 个国家的死亡率,能一路算到 1751 年
公共卫生与流行病学死亡登记公共卫生统计流行病学全球健康

HMD — 41 个国家的死亡率,能一路算到 1751 年

41 个国家地区回溯至 1751 年单岁年龄STMF 38 国周数据HCD 18 国死因CC BY 4.0需注册不适用(国家级聚合统计,非个体级记录;最小统计单元为年龄×年份×性别的暴露人年)

同一个方法协议做了 26 年:把各国统计局口径不一的出生数、死亡数、人口数,重建成年龄×年份×性别的单岁标准网格。瑞典那条序列从 1751 年开始,跨越 274 年没有断过——这是全人类最长的一条连续死亡记录
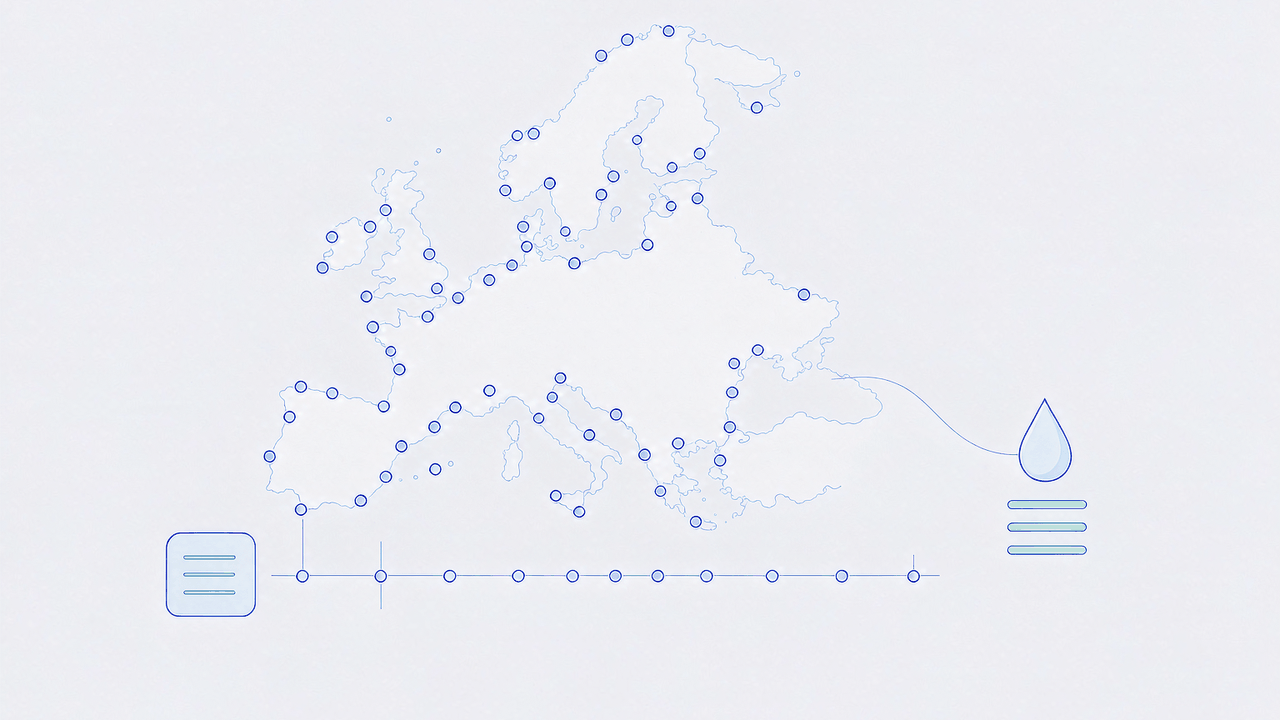
SHARE — 28 国 17.5 万人,欧洲老去过程的统一标尺
电子健康记录队列研究调查数据公共卫生与流行病学全球健康

SHARE — 28 国 17.5 万人,欧洲老去过程的统一标尺

28 个国家175,000 名受访者690,000 次访谈10 个波次22 年跨度21 项干血斑标志物四国行政记录链接严禁商用175,000(28 国 50 岁以上受访者;DBS 子样本约 27,000)

同一份问卷、同一套变量名、同一套缺失码,在 28 个国家问了 22 年:它让「德国的老人比意大利健康吗」这个问题第一次变得可以计算——而它最锋利的部分,是那 2.7 万份干血斑
CPIC — 把基因型翻译成剂量的那一层
基因组学与多组学电子健康记录医学问答与基准

CPIC — 把基因型翻译成剂量的那一层

132 个基因324 种药物29 部指南2,115 条推荐112,820 条双倍型开放式 REST无需注册不适用(指南与推荐表,无真实患者记录)

132 个基因、324 种药、29 部指南、2,115 条推荐:它不做研究,只做一件事——把文献里的证据定级,然后落成一句「该加量、减量、还是换药」

定制数据集服务

无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。