乳腺钼靶影像与病灶标注数据集
四体位乳腺钼靶 DICOM 影像,配病灶检出框与像素级分割掩膜,标签按 BI-RADS 术语组织。
致力于为医疗 AI 研究人员找到合适的数据集。已收录 2,151 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。
需要注册级、带专家标注的合规可交易临床数据? 前往医疗数据商城 →
四体位乳腺钼靶 DICOM 影像,配病灶检出框与像素级分割掩膜,标签按 BI-RADS 术语组织。
眼底彩照与 OCT 报告图文配对,一眼一报告可回溯,含逐项所见与 AI 辅诊结论。
千方医数集支持按病种、模态合规定制采集。
提交定制需求共 1886 个数据集
Broad Bioimage Benchmark Collection 第 051 号:3 例人体肾皮质组织的 DAPI 单通道共聚焦荧光显微图像(3D 体积 / 2D 投影 / 2D 切片三形态),VTEA 半自动流水线标注 8 类肾皮质细胞类型,NephNet3D 仅凭细胞核 DAPI 特征即达 balanced accuracy 80.26%,衍生 MedMNIST 轻量基准 TissueMNIST
OSIC 联盟 2020 年 Kaggle 肺纤维化进展预测挑战赛数据集——176 例训练患者的基线胸部 CT + 用力肺活量(FVC)纵向随访,任务是用影像与临床元数据预测肺功能下降轨迹并给出置信度,评测采用修正拉普拉斯对数似然(mLLL)
2019 Kaggle 气胸像素级分割竞赛数据集:12,047 张 NIH 胸片 + RLE 掩码,1,475 队竞逐 mean Dice,原始 GCP 通道已下线、竞赛规则禁再分发,AI-Ready 光谱上「技术可用、治理受限、存续脆弱」的典型样本
贵州六院联盟 1,338 例颅内动脉瘤 CTA 的大规模分割数据集——GLIA-Net 全局定位+局部分割双通路,配套医师人机协同临床实验;数据需机构邮箱邮件申请、非商业用途
哈佛 Rajpurkar 组的医学照片理解统一基准——484 张源自 PMC 文献的'野外'普通照片配 955 道两阶段临床医生审核的多选题,覆盖七临床主题,通用旗舰模型 68-78% 而医疗专用 MedGemma 仅 37%,CC BY-NC-ND 3.0 HuggingFace 公开直链
Microsoft Research 提出的 LLM 主张抽取方法 Claimify 的官方配套标注数据集——6,490 句 Copilot 问答输出句子级二分类标注(59.1% 含可验证事实主张),CDLA-Permissive-2.0 于 HuggingFace 公开直链,配套 ACL 2025 主会四阶段流水线论文
UCSF 40 份乳腺癌与胰腺癌进展笔记的专家级深标注肿瘤信息抽取基准——59 实体/23 属性/26 关系 schema、9028 实体/9986 修饰符/5312 关系人工注释,外加 200 份 GPT-4 自动标注扩展与 GPT-4/GPT-3.5-turbo/FLAN-UL2 八任务零样本评测
深圳大学 FreedomIntelligence 团队发布的六语言(en/zh/es/fr/pt/hi)医疗 LLM 预训练+SFT 混合语料:374 万文档、预训练部分 2.5B tokens、首创 QA-Augmented Pre-training 与 Priority sampling,Apache-2.0 于 HuggingFace 公开
挪威 SimulaMet 与 OsloMet 发布的 85 名男性精子显微视频 + 精液分析 + 脂肪酸 + 性激素 + 人口学五模态开放数据集,人类生殖领域首个开放多模态数据集,MediaEval 2019 Medico 任务官方基准,35.2 GB 直链下载、CC BY-NC 4.0(仅限研究与教育用途)
Common Longitudinal ICU data Format——跨 12+ 机构的开源重症监护纵向数据标准与联邦研究联盟:939K+ 患者、67 家医院,写一次分析代码跨站运行、患者级数据永不出院,MIMIC-IV-Ext-CLIF 参考实现落 PhysioNet
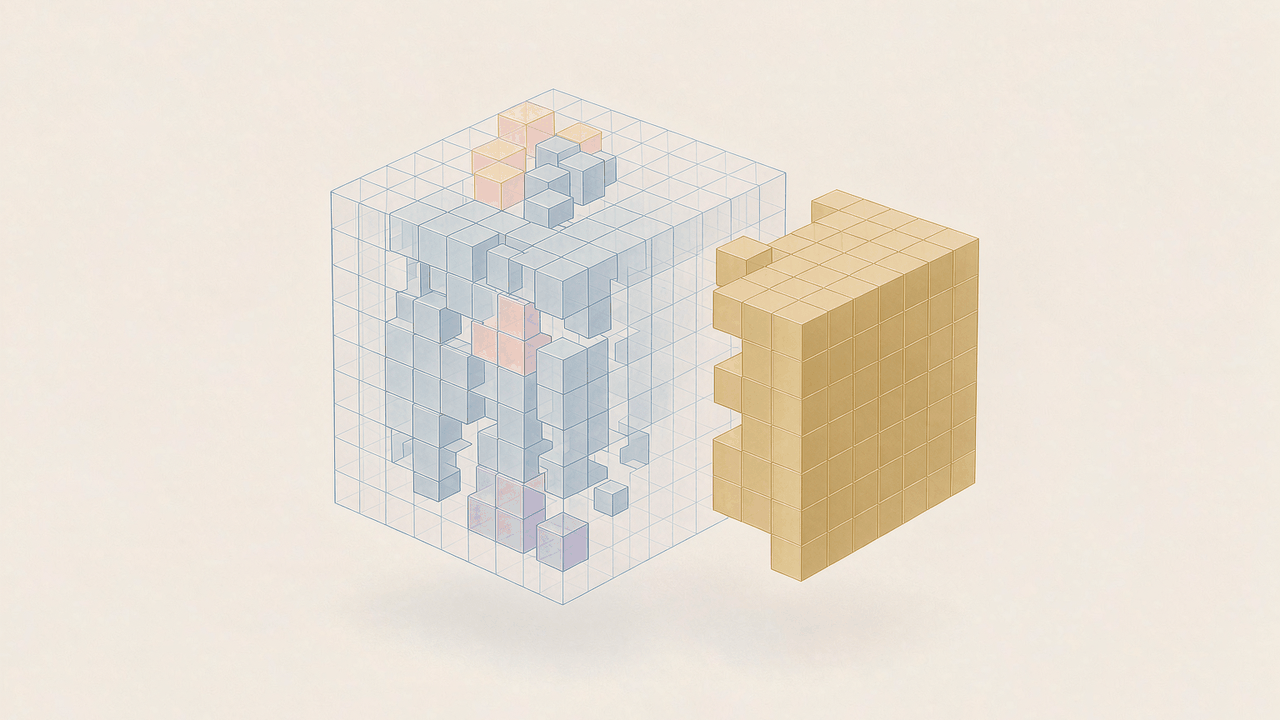
以 CT-RATE 为源队列,为 2,201 例非增强胸部 CT 提供 12×12×24 三维 patch 网格上九类临床显著异常的 token 对齐二值标注——医学生初注+资深医师终审三段质控,patch 级监督定位 Dice 42.2% 碾压弱监督基线 15.6%
首个评估大语言模型医学计算能力的评测基准——55 个临床计算器、1,047 例人工复核测试题,GPT-4 one-shot CoT 仅 50.9%,NeurIPS 2024 Datasets & Benchmarks Oral,NLM/NIH 主导,CC BY-SA 4.0 于 HuggingFace 公开
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。