医疗 AI-Ready 训练数据集库(上万即取即用)

致力于为医疗 AI 研究人员找到合适的数据集。已收录 2,151 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。

需要注册级、带专家标注的合规可交易临床数据? 前往医疗数据商城 →

按工程化层级:

数据标签

千方医数集 · 商业级 AI-Ready 数据集

官方自营 · 合规交易

乳腺钼靶影像与病灶标注数据集

四体位乳腺钼靶 DICOM 影像,配病灶检出框与像素级分割掩膜,标签按 BI-RADS 术语组织。

眼底照相与 OCT 影像数据集

眼底彩照与 OCT 报告图文配对,一眼一报告可回溯,含逐项所见与 AI 辅诊结论。

需要更多专病队列?

千方医数集支持按病种、模态合规定制采集。

提交定制需求

医学影像 AI-Ready 数据集

电子病历与文本数据集

病灶分割与标注数据集

共 1886 个数据集

BCCD — 外周血细胞目标检测数据集
医学影像目标检测病理图像评测基准

BCCD — 外周血细胞目标检测数据集

影像数据人工标注原始数据不适用——细胞级显微图像数据集,无患者级标注;共 364 张血涂片图像、4,888 个目标框(RBC 4,155 / WBC 372 / Platelets 361)

364 张 640×480 显微镜血涂片、4,888 个 VOC 边界框、RBC/WBC/Platelets 三类的经典血细胞检测数据集——MIT 许可 GitHub 开源,被 TensorFlow Datasets 官方收录,是白细胞计数与血细胞检测模型最常用的入门基准与训练集
CDetector — 少样本宫颈细胞检测基准与比较检测器方法
医学影像病理图像目标检测评测基准肿瘤学

CDetector — 少样本宫颈细胞检测基准与比较检测器方法

人工标注影像数据原始数据7,086 张显微图像(论文口径,Df 6,667 + test 419;README 口径 7,410 张)——患者级数量与采集医院未披露

中南大学团队 7,086 张 TCT 液基薄层涂片显微图像、48,587 个病理医生标注 bbox、11 类 Bethesda 体系——配套比较检测器少样本方法,小训练集上 mAP 26.3% 对 baseline 6.6%,Neurocomputing 2021 正式发表
PLIP
医学影像多模态病理图像图像分类影像-文本对齐评测基准

PLIP

影像数据文本数据原始数据不适用(公开社交媒体图文对与网络图像,无患者级信息;本体为 208,414 病理图像-自然语言描述对)

PLIP 是斯坦福团队在 OpenPath(208,414 对病理图文对,取自 32 个 hashtag 的 Medical Twitter 与 LAION-5B)上对 CLIP ViT-B/32 对比学习微调得到的首个病理学视觉-语言基础模型:零样本 F1 0.565-0.832,Nature Medicine 2023 发表,权重 HuggingFace 公开。
RadLex — RSNA 放射学术语本体与 Playbook 术式词典
医学影像知识图谱命名实体识别影像-文本对齐

RadLex — RSNA 放射学术语本体与 Playbook 术式词典

文本数据专家构建原始数据不适用(术语本体资源,不含患者级数据、不含影像,仅收录放射学概念术语)

RSNA 2003 年启动的放射学统一术语本体:RID 标识放射学概念、is-a 层级最深 20 层、4.3 版统计页录 58,065 术语与 67 槽,配套 Playbook 约 1000 术式操作编码,经 BioPortal、WebProtégé、FHIR、Playbook 四渠道免费获取,是放射报告 NLP 与影像标签工程的术语底座
SemMedDB — 1.3 亿语义谓词织成的文献知识图谱
医疗NLP生物医学文献关系抽取知识图谱命名实体识别

SemMedDB — 1.3 亿语义谓词织成的文献知识图谱

自动抽取知识图谱原始数据不适用:37,233,341 篇 MEDLINE 引文级文献记录,非患者队列

NLM LHNCBC 用 SemRep 1.8 全自动抽取 MEDLINE 3723 万篇引文标题与摘要的语义谓词数据库:130,480,195 条 predications、六表结构、30 种语义谓词、UMLS Metathesaurus 许可,semmedVER43_R 为官方声明的最终版
Human Disease Ontology — 人类疾病的统一命名世界语
医疗NLP知识图谱命名实体识别生物医学文献公共卫生与流行病学

Human Disease Ontology — 人类疾病的统一命名世界语

原始数据知识本体不适用——本体为知识资源,不含患者级数据;共 11,953 个疾病类(v2025-09-30,DOI 10.5281/zenodo.17238005)

OBO Foundry 旗下覆盖全部医学专科的开源疾病本体:十五年从 8,043 个疾病类长到 11,953 个,9,656 条结构化定义、35,984 条指向 OMIM、UMLS、ICD 的跨库链接,逾 150 万条标注元素挂在这副骨架上;CC0 许可、五种格式发布,是疾病命名实体识别、富集分析与临床数据归一化的默认共享词表
DISC-Med-SFT
医疗NLP医学问答与基准医学问答临床文本知识图谱

DISC-Med-SFT

指令微调对话数据合成数据未披露(宣称 47 万+ 条医疗咨询对话样本;患者级去重数量无官方口径;HF size_categories 100K<n<1M)

复旦 FudanDISC 实验室为 DISC-MedLLM 而建的中文医疗对话式 SFT 指令数据集——MedDialog 40 万单轮咨询经 LLM 重构为多轮策略性问诊、CMeKG 知识图谱三元组转问答、2k 人工行为偏好对齐,宣称 47 万+ 样本,HuggingFace 公开约 2.03 GB 子集(apache-2.0),与模型成对发布、一次性交付无后续更新
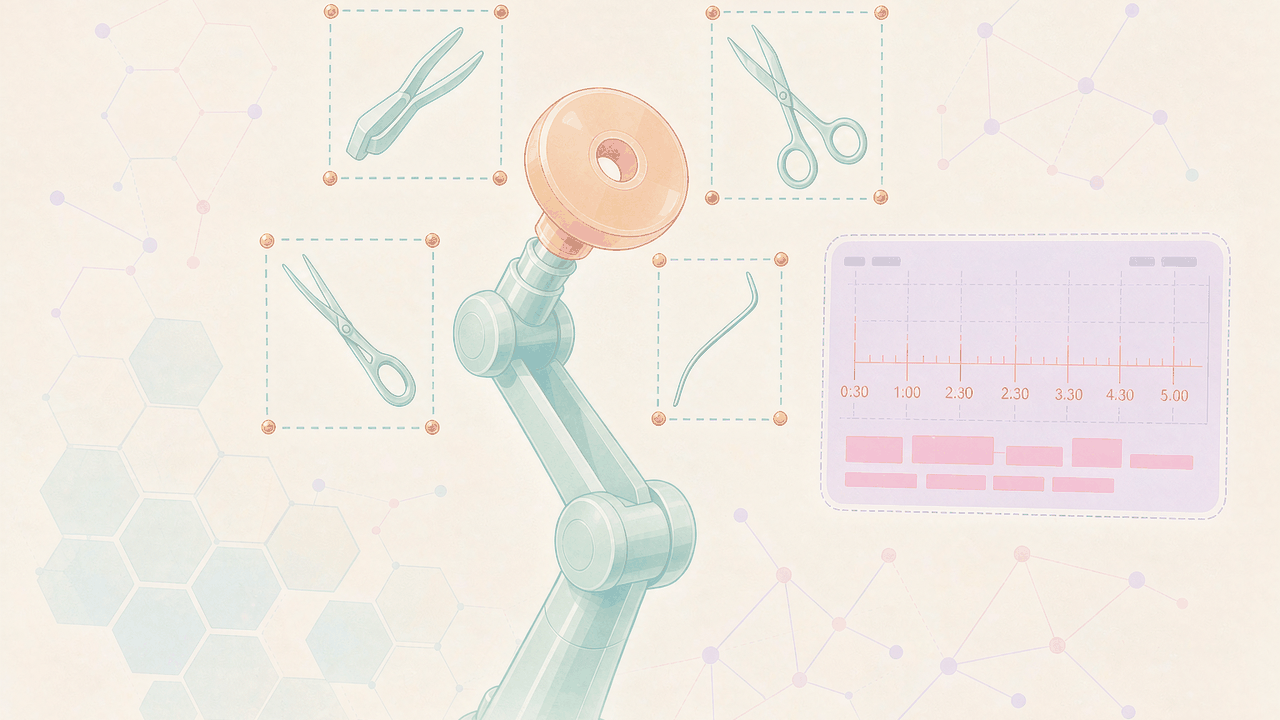
SurgToolLoc 2022 — MICCAI 2022 弱监督手术器械定位挑战赛数据集
医学影像手术视频内窥镜影像目标检测挑战赛数据集

SurgToolLoc 2022 — MICCAI 2022 弱监督手术器械定位挑战赛数据集

人工标注影像数据原始数据弱标签无人类患者——da Vinci 机器人培训练习(受训者与专家在猪模型上执行标准化操作);11 场独立培训练习、24,695 个 30 秒视频片段

Intuitive Surgical 发布的 MICCAI 2022 EndoVis 弱监督挑战赛数据集:24,695 个 da Vinci 培训视频片段、14 类工具在位标签、GCS 公开直链——机器人手术视频 AI 的规模基准与弱标签教科书
PGB: A PubMed Graph Benchmark — 面向生物医学文献异质图表示学习的 PubMed 图基准
生物医学文献知识图谱评测基准医学问答与基准队列研究

PGB: A PubMed Graph Benchmark — 面向生物医学文献异质图表示学习的 PubMed 图基准

异质信息网络图神经网络文献计量MeSH引文网络系统综述筛选0

把 3000 万篇 PubMed 文献聚合成 5 类节点、7 类边的异质信息网络,附带系统综述摘要筛选、节点分类与节点聚类三大评测任务
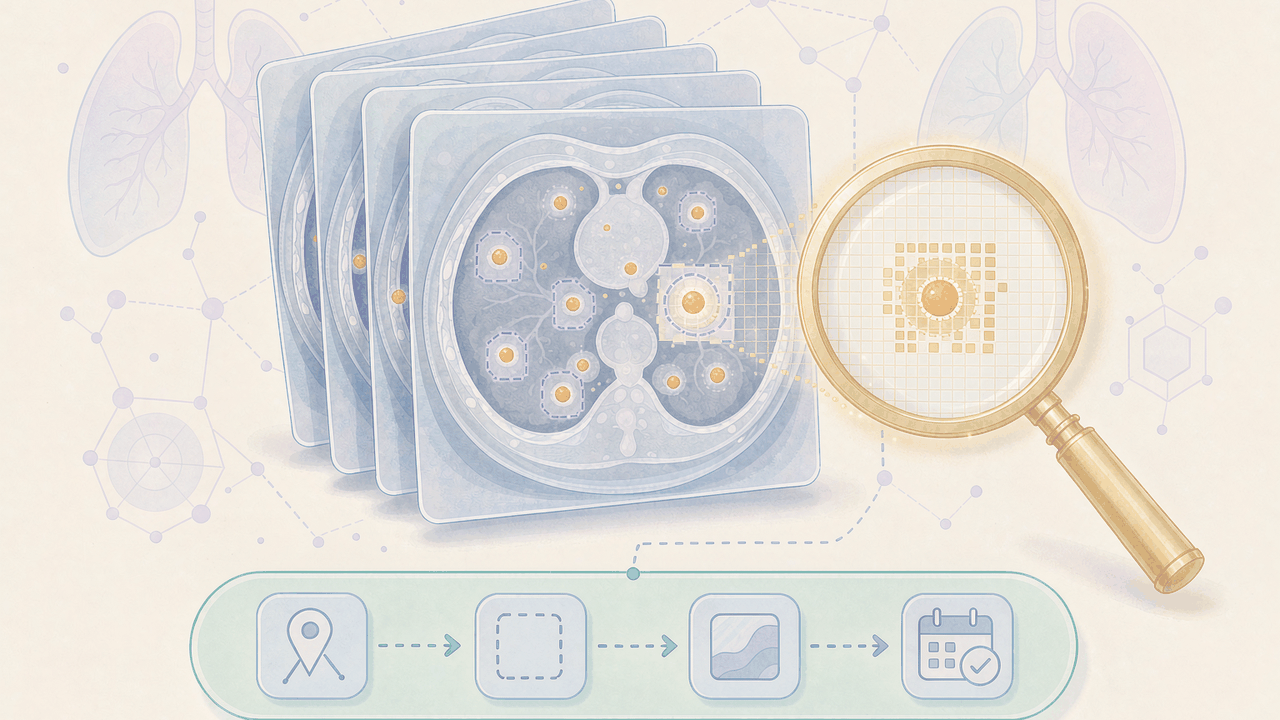
LNDb — 肺结节 CT 外部验证数据库与 Fleischner 随访挑战赛
医学影像CT医学图像分割目标检测挑战赛数据集肺癌

LNDb — 肺结节 CT 外部验证数据库与 Fleischner 随访挑战赛

人工标注影像数据原始数据294 例 CT(294 患者;164 例男性占 55.8%;中位年龄 66,范围 19-98);训练/验证集 236 + 独立测试集 58

葡萄牙波尔图 CHUSJ 单中心 294 例胸部 CT 与 1429 个唯一发现——LIDC-IDRI 的独立外部补充库,单盲标注暴露真实观察者间变异,附 312 次眼动追踪与 2017 Fleischner 随访四任务挑战赛
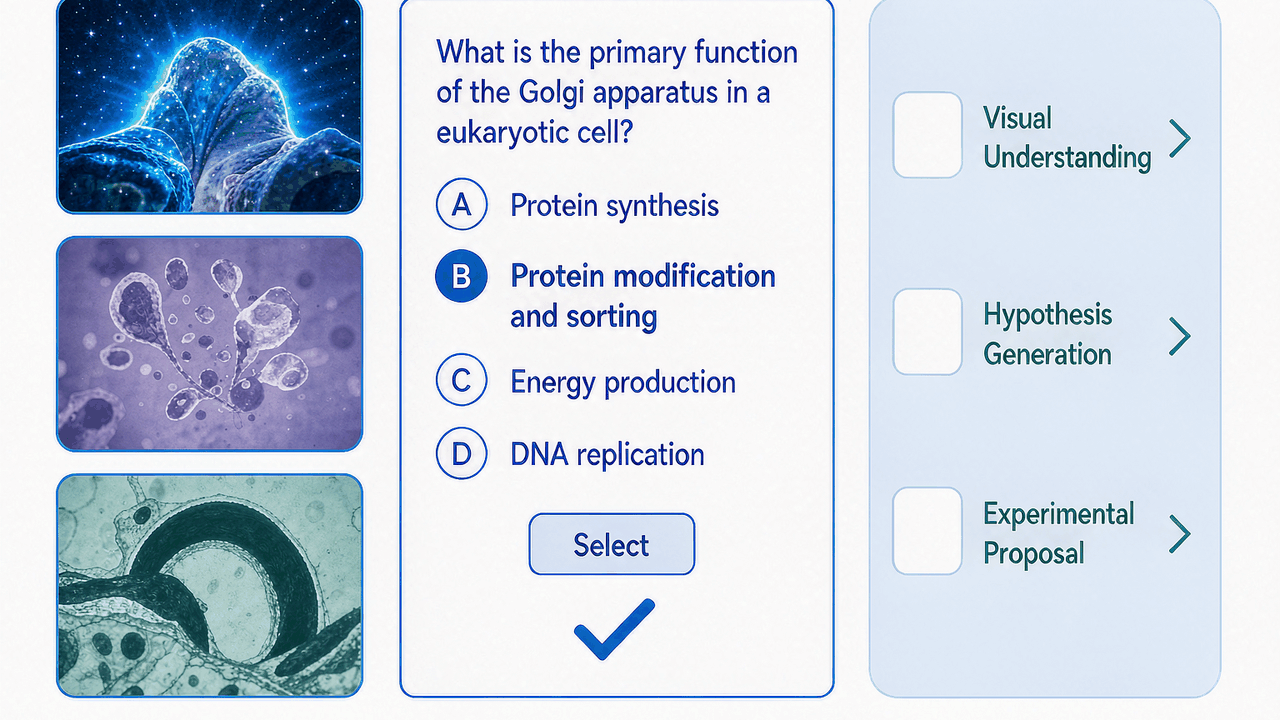
MicroVQA — 面向显微成像科研的多模态推理基准
多模态医学问答与基准医学影像评测基准

MicroVQA — 面向显微成像科研的多模态推理基准

图像文本多选题科研推理0

1042 道专家编写多选题,覆盖专家视觉理解、假设生成与实验方案设计三类科研推理任务
Orphanet Rare Disease Ontology — 全球罕见病标准本体 ORDO 4.9 中文百科
罕见病知识图谱命名实体识别公共卫生与流行病学变异与注释

Orphanet Rare Disease Ontology — 全球罕见病标准本体 ORDO 4.9 中文百科

知识库本体术语开放数据不以患者为单位;ORDO 4.9 收录 10,110 个临床实体类(Clinical entity,含失活概念),命名表口径 9,784 个 active clinical entities

Orphanet 与 EMBL-EBI 联合构建的罕见病领域本体:以 ORPHAcode 为锚,把疾病-基因-流行病学关系形式化为 OWL 图,4.9 版 10,110 个临床实体类、4,626 个遗传物质类,CC BY 4.0 开放下载

定制数据集服务

无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。