乳腺阳性影像数据集
乳腺钼靶阳性病例影像数据,覆盖肿块、钙化等典型征象,面向乳腺 AI 辅助筛查模型训练。
致力于为医疗 AI 研究人员找到合适的数据集。已收录 1,968 个 AI-Ready 数据集,覆盖医学影像、电子病历与文本、病灶分割与标注等多模态数据。
需要具备完整溯源、伦理合规与工程化交付的专病训练集?进入医疗数据商城 →乳腺钼靶阳性病例影像数据,覆盖肿块、钙化等典型征象,面向乳腺 AI 辅助筛查模型训练。
液基薄层细胞学(TCT)数字图像,含阴阳性判读结果,适配宫颈癌细胞学筛查模型。
千方医数集支持按病种、模态合规定制采集。
提交定制需求共 1822 个数据集
GSE306129 空间 ATAC 28 样本 x GSE316922 scRNA-seq 36 样本 的双层 GEO 资源:MD 安德森 138 例 BCC/cSCC 队列揭示「免疫抑制不是免疫细胞变少,而是巨噬细胞抗原呈递失灵 + 空间组织被拆散」
NIH/NIDDK 资助肾脏精准医学项目 · 612 名参与者 · 22,824 个文件的 WSI+单细胞+空间多组学图谱
Tahoe Therapeutics × Arc Institute × Parse Biosciences 用 Mosaic 平台把 50 个癌细胞系混养在「cell village」中同步给药 24 小时,得到 95,624,334 个通过全过滤的单细胞转录组;CC0-1.0 全量开放于 HuggingFace,FASTQ 因 125 TB 体量与 Parse 合同限制不公开
702,968 个单细胞 · 60 种人体组织 · Microwell-seq 构建的中文人群细胞图谱
16 类数据、200 余国家地区、四级获取门槛的健康数据索引
16.9 万细胞系、904 物种、47 万条交叉引用的细胞系知识库
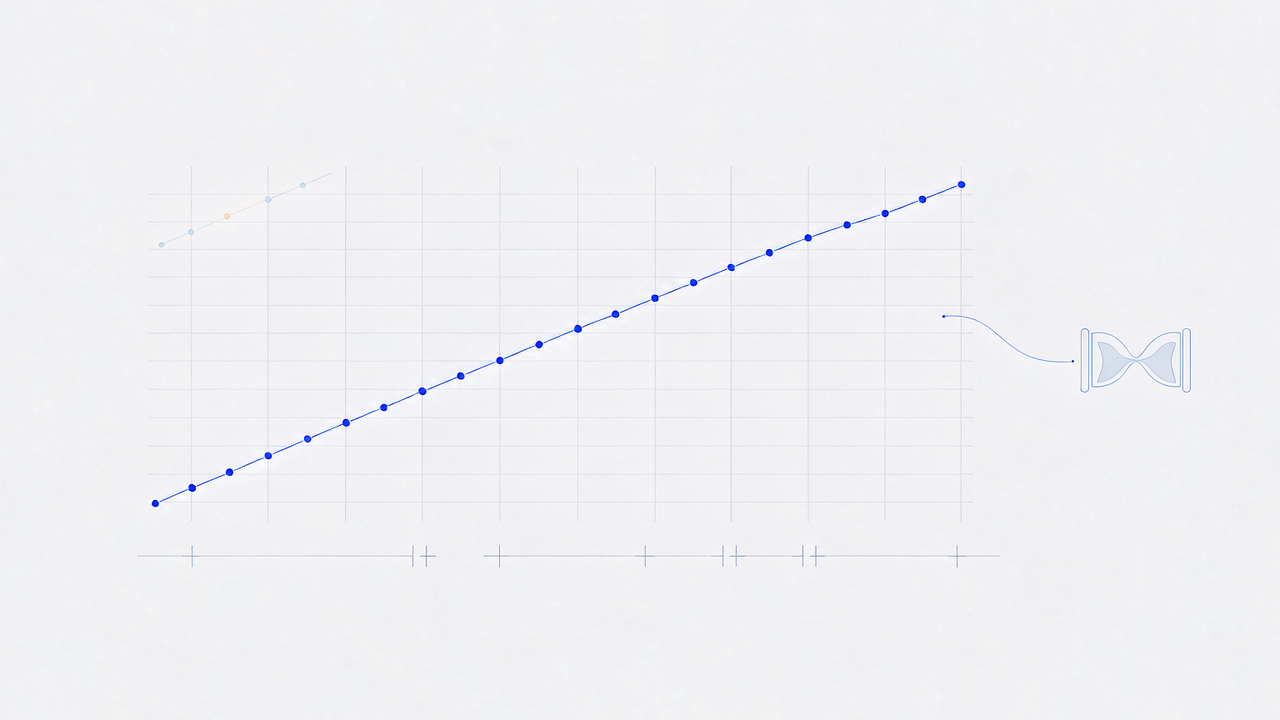
同一个方法协议做了 26 年:把各国统计局口径不一的出生数、死亡数、人口数,重建成年龄×年份×性别的单岁标准网格。瑞典那条序列从 1751 年开始,跨越 274 年没有断过——这是全人类最长的一条连续死亡记录
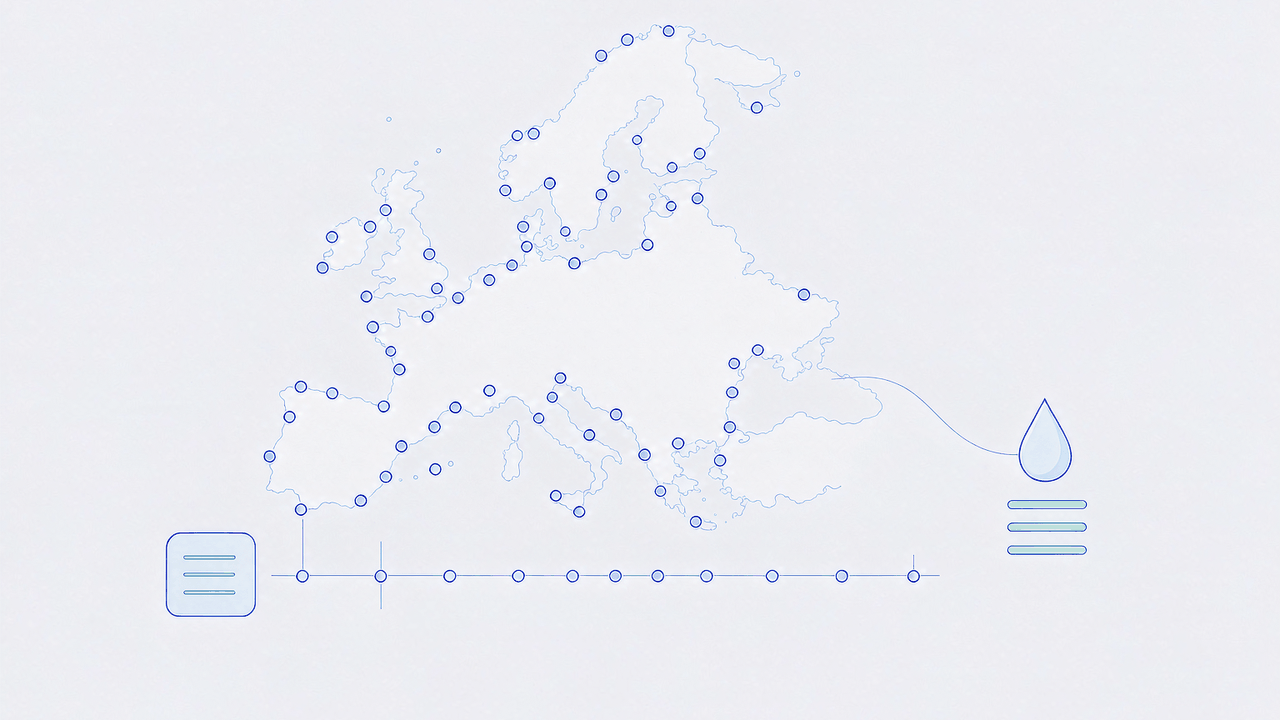
同一份问卷、同一套变量名、同一套缺失码,在 28 个国家问了 22 年:它让「德国的老人比意大利健康吗」这个问题第一次变得可以计算——而它最锋利的部分,是那 2.7 万份干血斑
免费的老版 2.3 只有 502 味药材和 13,729 个化合物,但每一个化合物都配齐 OB、DL、Caco-2、BBB、溶解度——这是网络药理学十年来的筛选口径本身
132 个基因、324 种药、29 部指南、2,115 条推荐:它不做研究,只做一件事——把文献里的证据定级,然后落成一句「该加量、减量、还是换药」
十个种子序列、一个协方差模型、一份共识二级结构:Rfam 是 RNA 世界的 Pfam,它不给你序列清单,给你的是「怎么在基因组里找出这个家族」的搜索器
60,054,521 条序列、56 个专家库、110 万个物种:它不产生数据,只做一件事——把同一个 RNA 分子在不同库里的十几个编号,归并成一个 URS
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
