即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 785 个数据集
MedS-Ins — 面向医学大模型的大规模指令微调语料:58 个语料库、500 万实例、1.9 万条指令
上海交通大学与上海 AI Lab 联合中国移动发布的首个全面医学指令微调数据集(与 MedS-Bench 基准、MMedIns-Llama 3 模型成对发布)——整合 58 个生物医学语料库,覆盖考试、临床文本、学术论文、医学知识库、日常对话五大来源共 122 项任务;现行口径计 500 万实例 + 1.9 万条指令(v1 论文因「指令与实例组合各计一样本」曾计 13.5M,双口径详见表),仓库许可 CC BY-SA、论文版权 CC BY 4.0,HuggingFace 公开约 7.58 GB
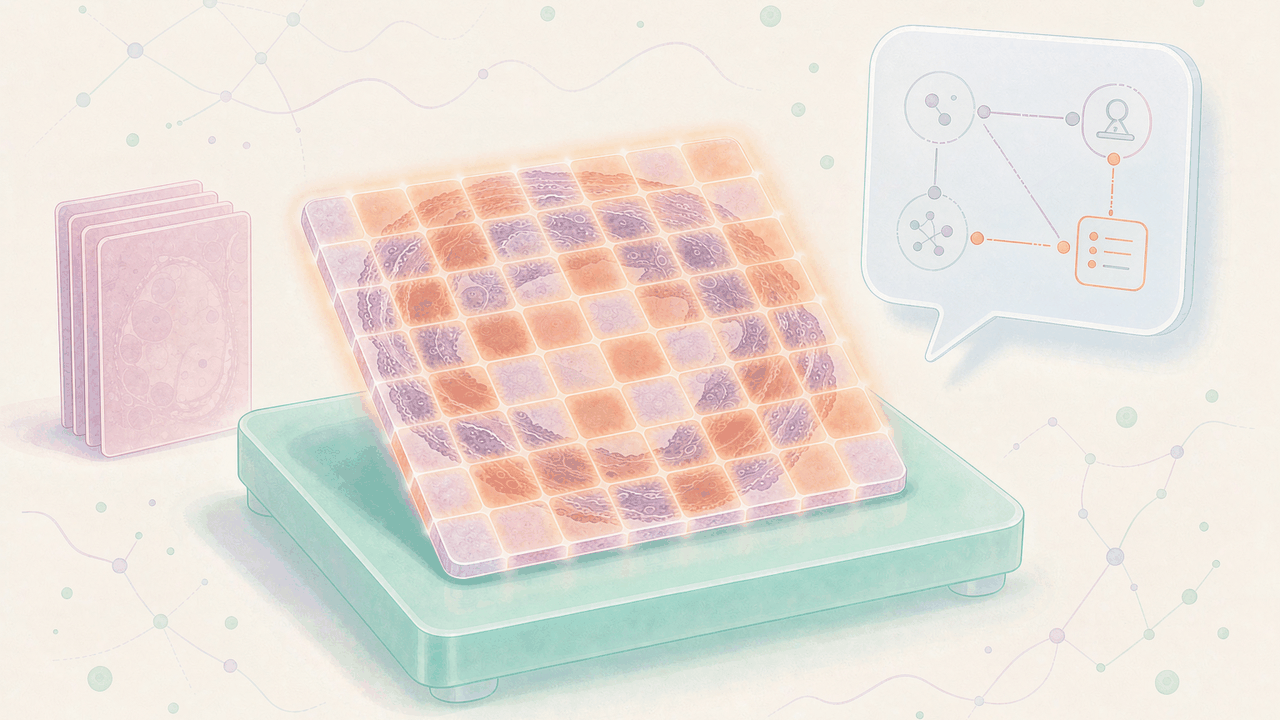
PatchGastricADC22 — 胃腺癌活检 WSI 图文对 patch 数据集
Medmain Research 从 IUHW 三田医院 991 张胃腺癌内镜活检 H&E 全切片抽取 262,777 张 300×300 patch,每张切片配对一条诊断报告级 caption——病理图文配对与报告自动生成任务的 CC-BY-4.0 公开基准
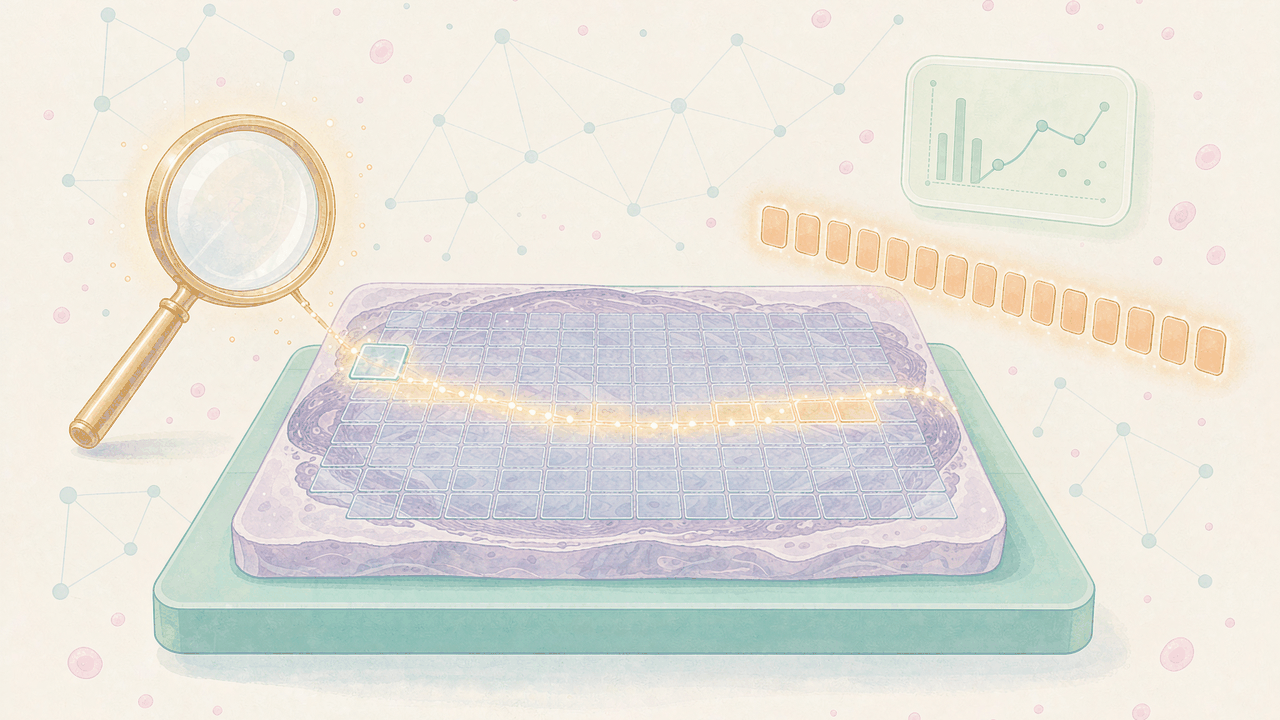
Prov-GigaPath — 微软与 Providence 的 13 亿图块全片病理基础模型
基于 Providence 医疗系统 171,189 张全片病理图像、13.8 亿个 256×256 图块预训练的全片病理基础模型,以 LongNet 超长上下文建模整张 gigapixel 切片,26 项数字病理任务中 25 项达 SOTA——权重公开却受 gated 条款约束、官方明确 research-only 禁用临床与商业部署
LIVECell — 无标记活细胞相差显微实例分割数据集
Sartorius 出品、Nature Methods 2021 发表的 5,239 张无标记相差显微图像、168 万余个逐细胞多边形标注——迄今最大规模人类—小鼠细胞系活细胞实例分割基准,用 Incucyte S3 每四小时连续成像捕捉从稀疏到汇合的全形态谱系
SisFall — 可穿戴惯性传感跌倒检测数据集
哥伦比亚安蒂奥基亚大学自研腰部佩戴设备(双加速度计+陀螺仪,200 Hz)采集 38 名受试者的 19 种日常活动与 15 种模拟跌倒共 4504 条记录,是跌倒检测领域最常被引用的公开惯性传感器基准数据集
Neurofeedback Skull-stripped — 脑部 MRI 颅骨剥离金标准库
NKI Enhanced Rockland Sample 神经反馈子研究 125 例 T1 加权 MRI 的手工校正颅骨剥离库——BEaST 自动初剥 + Freeview 逐例手修(85 例编辑)的迭代 bootstrap 工艺,无条件开放、无需数据使用协议,为脑提取算法提供金标准训练/测试数据
Siena Scalp EEG Database — 14 例癫痫患者头皮脑电 47 次发作长程参考集
锡耶纳大学神经内科与神经生理学科 14 例癫痫患者视频-EEG,512 Hz、国际 10-20 导联、47 次发作 / 约 128 小时,CC BY 4.0 于 PhysioNet 公开;源自托斯卡纳 PANACEE 非侵入式发作预测项目,是成人头皮脑电发作检测与预测的经典长程数据锚点
TUH EEG Events Corpus — 天普大学脑电事件语料库,六类 EEG 事件逐通道标注基准
TUH EEG Corpus(TUEG)的六类事件标注子集 v2.0.1:棘波尖波/全面性周期性放电/偏侧性周期性放电/眼动/伪影/背景逐通道秒级标注,NEDC 专家生产,患者级 train/eval 官方划分,EEG 基础模型事件分类事实基准,免费注册 rsync 获取、无需 IRB 或 DUA
HealthBench — OpenAI 医疗对话评测基准
262 位执业于 60 国的医生手写 48,562 条 rubric 标准,为 5,000 段多轮健康对话逐题打分——OpenAI 用「医生出题、模型评分」把医疗 LLM 评测从选择题推向开放式临床对话,MIT 许可全量公开
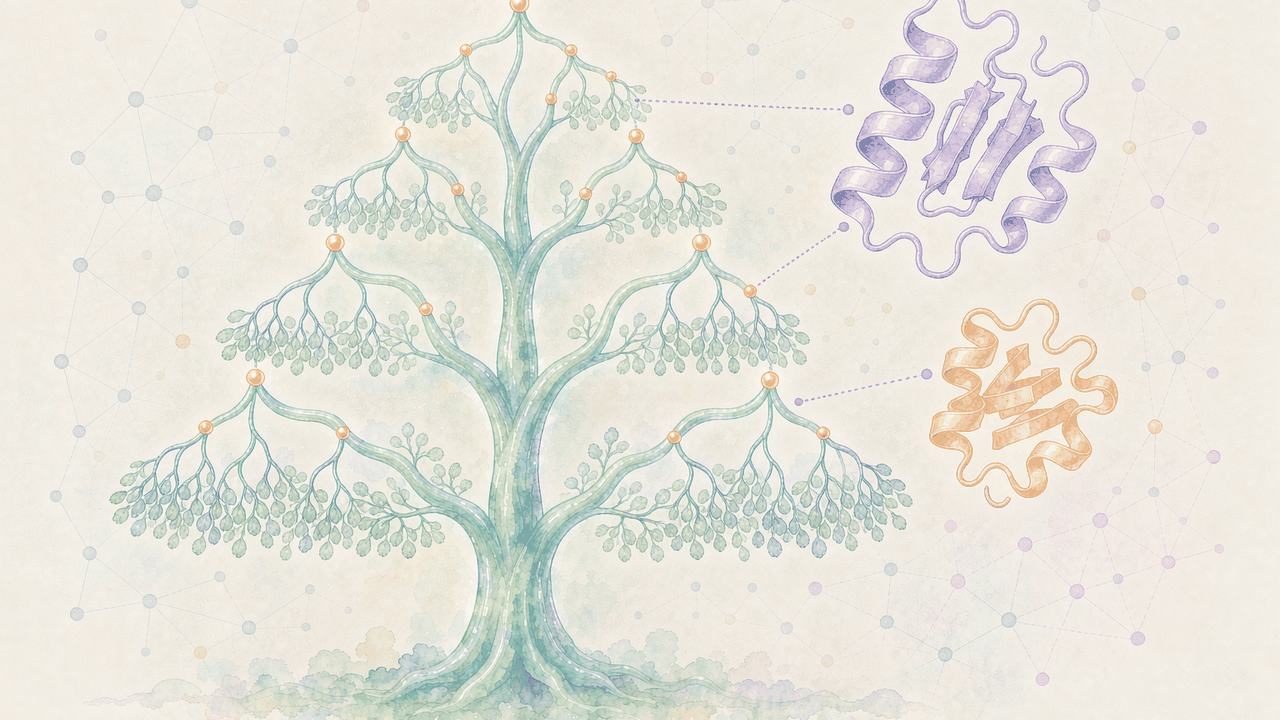
ECOD — 蛋白质结构域演化分类数据库,PDB 与 AlphaFold 结构的同源层级体系
ECOD(Evolutionary Classification of Protein Domains)把 PDB 实验结构与 AlphaFold 预测结构中的蛋白结构域按演化同源关系组织成 Architecture/Possible-homology/Homology/Topology/Family 五级层级,以同源优先于拓扑、每周跟随 PDB 发布更新的独特定位,编录超 180 万个结构域,成为区分 CATH/SCOP 结构分类的关键互补资源
CATH-Gene3D — 蛋白质结构域层级分类数据库
UCL Orengo 组自 1990 年代维护的蛋白结构域分类体系:按 Class/Architecture/Topology/Homologous superfamily 四级层级分类 15 万 PDB 结构、1.51 亿蛋白域,融合 AlphaFold 预测打造 TED 与 6,573 个超家族——与 SCOP/ECOD 并列的三大结构分类资源之一
BABYCRY-UJM-AXA — 1,000 名足月新生儿哭声声音库
圣艾蒂安大学 ENES 团队在产科病房连续高保真录音,用主动学习+集成方法自动抽取 107,312 条哭声序列——迄今全球最大婴儿哭声音频库,CC BY 公开 81 GB,配音 176 个声学描述子,服务神经发育风险早筛
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
