医药 AI 前沿资讯
洞察医药研发动态,把握产业先机——监管政策、深度研报、产品发布与行业观察一站直达。
深度研报
 深度研报
JMRI:LLM加检索个性化心脏电影MRI协议,68例前瞻对比重复采集减少68%,图像质量3.69对3.00
2026年10月4日在线发表于JMRI的前瞻性个体内对照研究纳入68例患者,在1.5T场强下同一次检查内先后接受技师优化与AI优化的心脏电影MRI协议。AI优化协议的图像质量评分为3.69±0.47、技师优化为3.00±0.49(p<0.001),伪影抑制3.19±0.35对2.17±0.45(p<0.001),重复采集次数减少68%(6次对19次,p=0.028),左心室功能参数两组间无显著差异。
 深度研报
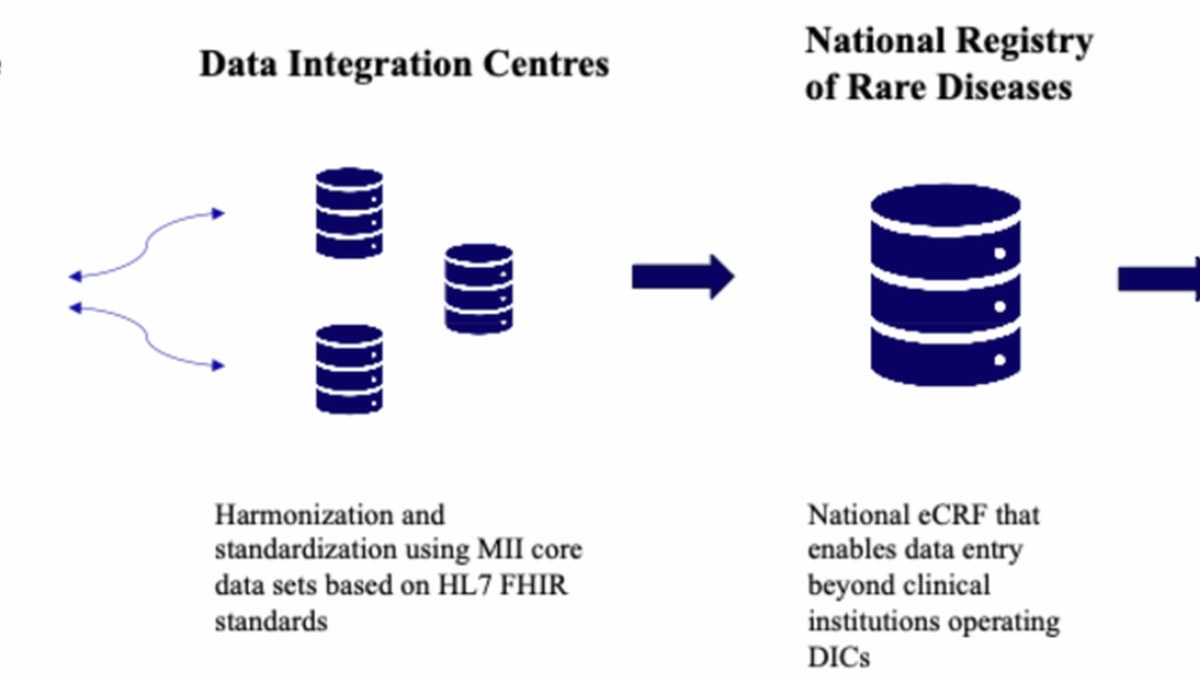
Scientific Data:德国罕见病登记NARSE跨注册库语义互操作评测,32个元素仅2项无法映射,信息保留分0.76
发表于Scientific Data的研究评估德国罕见病登记NARSE与其他核心数据集的语义互操作性。32个NARSE目标元素中有30个在德国医学信息学倡议核心数据集(MII CDS)中找到对应元素,映射构成为exactMatch 31%、closeMatch 53%、relatedMatch 9%,仅出生时生物性别与出生地无法映射。MII至NARSE方向信息保留分为0.76(信息损失24%),NARSE至欧洲罕见病注册基础设施(ERDRI)方向为0.73(损失27%)。
 深度研报
Physiological Measurement:离线可解释12导联心电图三模态框架,PTB-XL macro-AUROC 0.932,CPU耗时108毫秒
发表于Physiological Measurement的研究提出一套离线、可解释的12导联心电图三模态分析框架:确定性规则引擎含26条可执行临床判读标准,残差网络在PTB-XL测试折(n=2198)上取得macro-AUROC 0.932(95% CI 0.918-0.943),完整流程在CPU上耗时108±25毫秒且无需联网。信噪比降至5 dB时AUROC为0.951,零样本迁移至Chapman-Shaoxing队列(n=1599)macro-AUROC 0.898。规则与网络一致性弱(Cohen kappa 0.26)。
 深度研报
J Nucl Med:LLM编排智能体端到端完成170例PET/CT判读,原发灶敏感度100%,淋巴结特异度仅39.4%
发表于Journal of Nuclear Medicine的研究回顾性评估了一套大语言模型编排的智能体系统,用于肺癌基线FDG PET/CT分期判读。全部170例检查在无人工干预下完成从原始DICOM选层到结构化草稿报告的全流程:原发灶检出敏感度100%,淋巴结受累敏感度84.8%、特异度39.4%,远处转移检出敏感度70.2%、特异度65.0%。不一致病例分析显示58例淋巴结错配与57例转移错配。
 深度研报
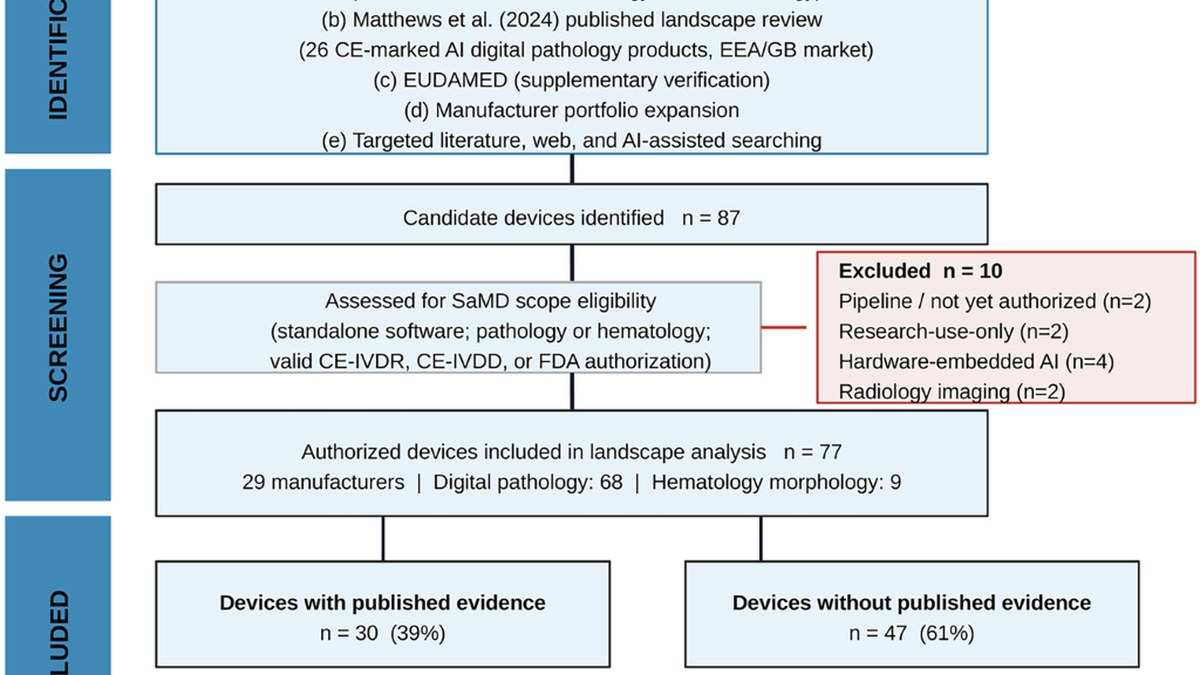
npj Digital Medicine:77款获批AI/ML体外诊断软件中61%无公开性能证据,欧美双授权器械8/8对比仅欧盟22/69
发表于npj Digital Medicine的系统性现状分析识别出77款来自29家厂商的CE标记或FDA授权的AI/ML体外诊断软件,其中68款数字病理、9款血液形态学。仅30款(39%)能找到公开的设备特异性能证据,47款(61%)未找到任何公开性能证据。欧美双重授权器械的证据可得性显著高于仅欧盟授权器械(8/8,100%对22/69,32%,P<0.001);血液形态学器械高于数字病理器械(7/9,78%对23/68,34%,P=0.02)。研究共识别15种性能指标,但使用方式不统一,难以跨器械直接比较。
 深度研报
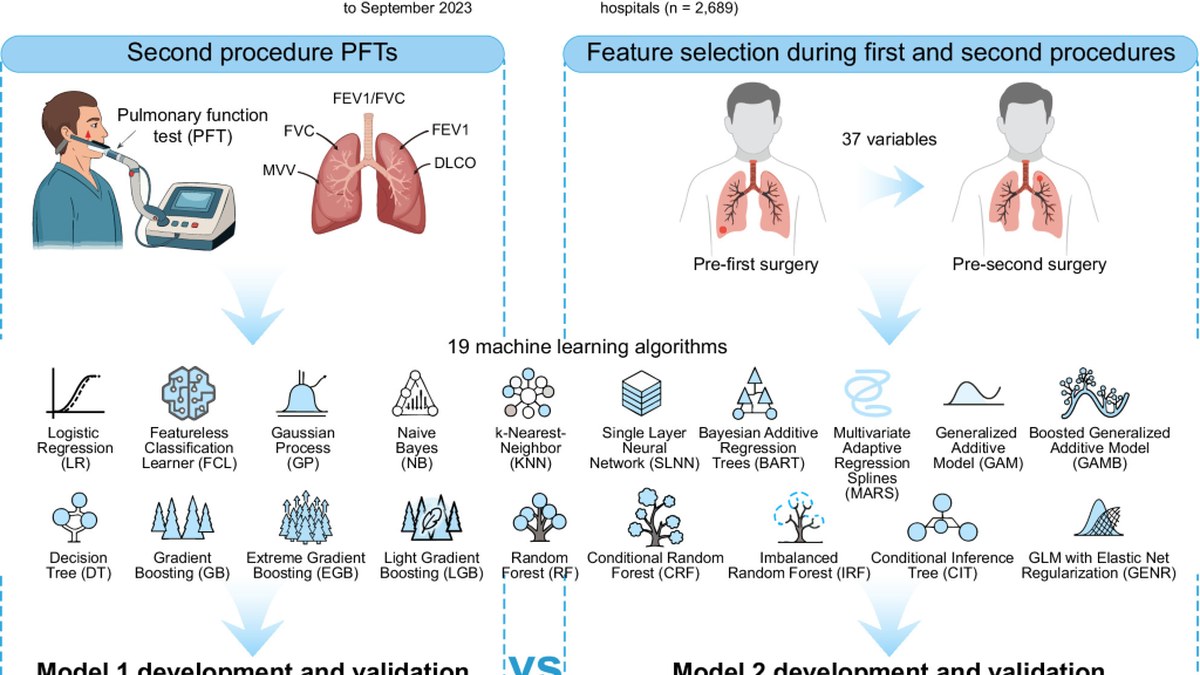
npj Digital Medicine:7家医院2040例二次肺切除,5变量MARS模型预测顽固性低氧,验证AUROC 0.750至0.782
发表于npj Digital Medicine的多中心回顾性研究纳入中国7家医院2013至2023年2040例二次肺切除患者,比较19种机器学习学习器并结合包装式特征选择建模,用术前与第二次术前两个时间点的围术期数据预测单肺通气期间的顽固性低氧。该并发症发生率为15.4%。仅用肺功能检查的模型表现不足(训练队列AUROC<0.6、AUPRC<0.2);最终5变量多元自适应回归样条(MARS)模型在训练队列AUROC达0.790,三个验证队列分别为0.750、0.765与0.782。
 深度研报
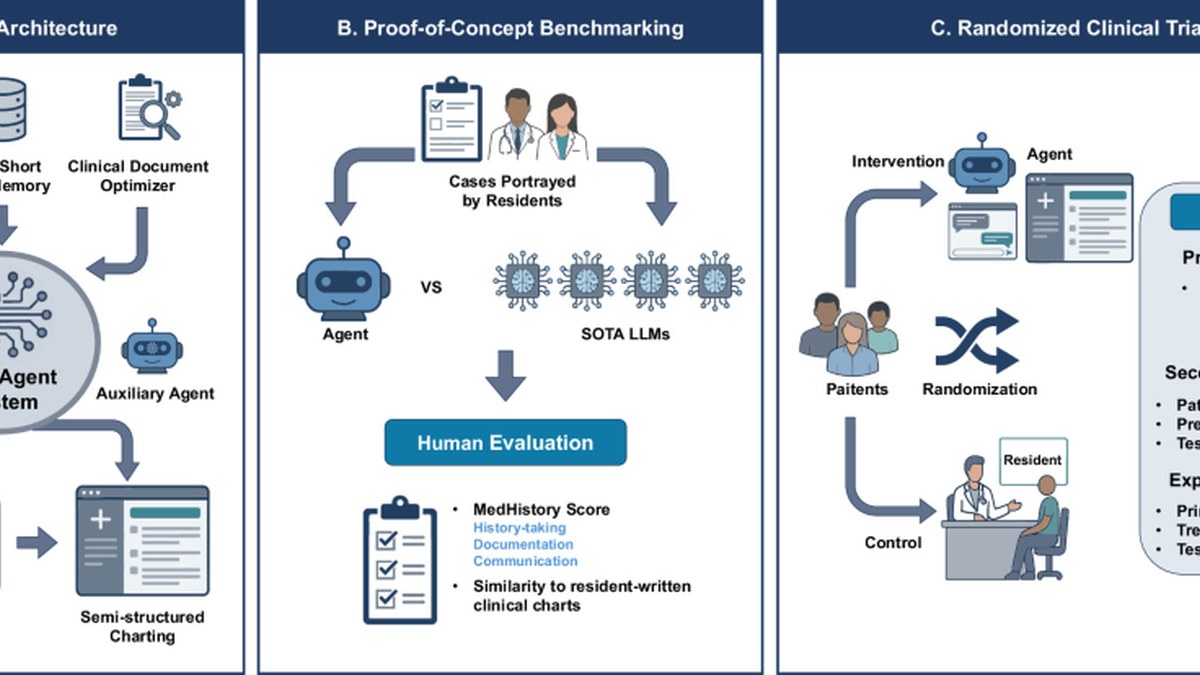
npj Digital Medicine随机对照试验:眼科预问诊LLM智能体病历采集质量较住院医师高17.7分,交互时长11.2对3.1分钟
发表于npj Digital Medicine的随机对照试验在中国广州一家三级眼科医院开展,2025年5月10日至6月10日期间172名非急诊预约患者被1:1随机分配至预问诊大语言模型智能体组或眼科住院医师组。智能体采用双智能体架构与技能工程化的症状导向逻辑树。主要结局MedHistory评分(0至100分)校正均差为17.7分(95%CI 14.1至21.3,P<0.001),智能体更优;耐心与共情评分分别为5对4与5对3(均P<0.001);交互时长中位数11.2对3.1分钟(P<0.001)。探索性分析显示仅凭病史的诊断F1为0.85对0.68。
 深度研报
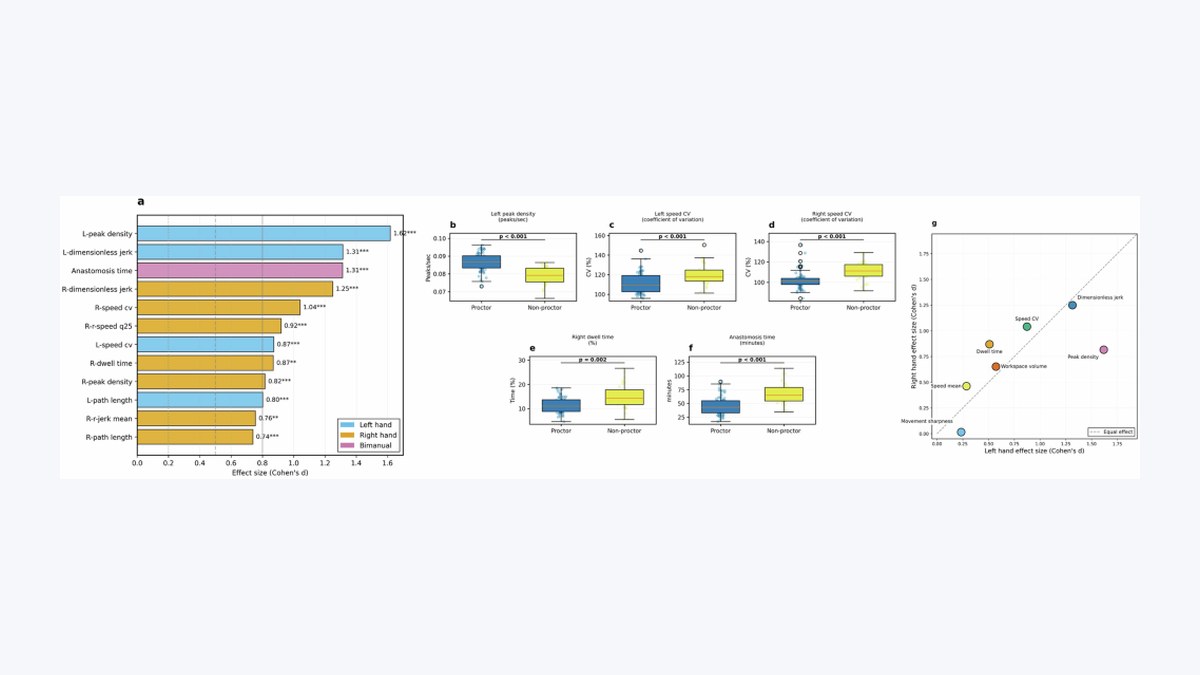
npj Digital Medicine:机器人手术基础运动学指标区分术者年资,随机森林AUC 0.892±0.075,左手峰值密度为首要判别特征
发表于npj Digital Medicine的研究提出只用三维位置坐标即可计算机器人手术的基础运动学指标,并用这些指标客观评估术者专业水平。随机森林分类器在按例层面区分术者年资的曲线下面积为0.892±0.075,特征重要性分析显示左手峰值密度是最主要的判别特征。少量这类基础指标在留一术者交叉验证中可泛化到未见过的术者;运动学模式与临床结局相关,探索性分析提示运动特征与出血量存在关联;个体学习曲线分析发现专家转入新平台时的适应模式差异明显,并识别出若干不同表型。
 深度研报
npj Digital Medicine:14个本地开源LLM做芬兰语电子病历检索,最佳准确率95.3%,但2.9%输出含临床显著错误
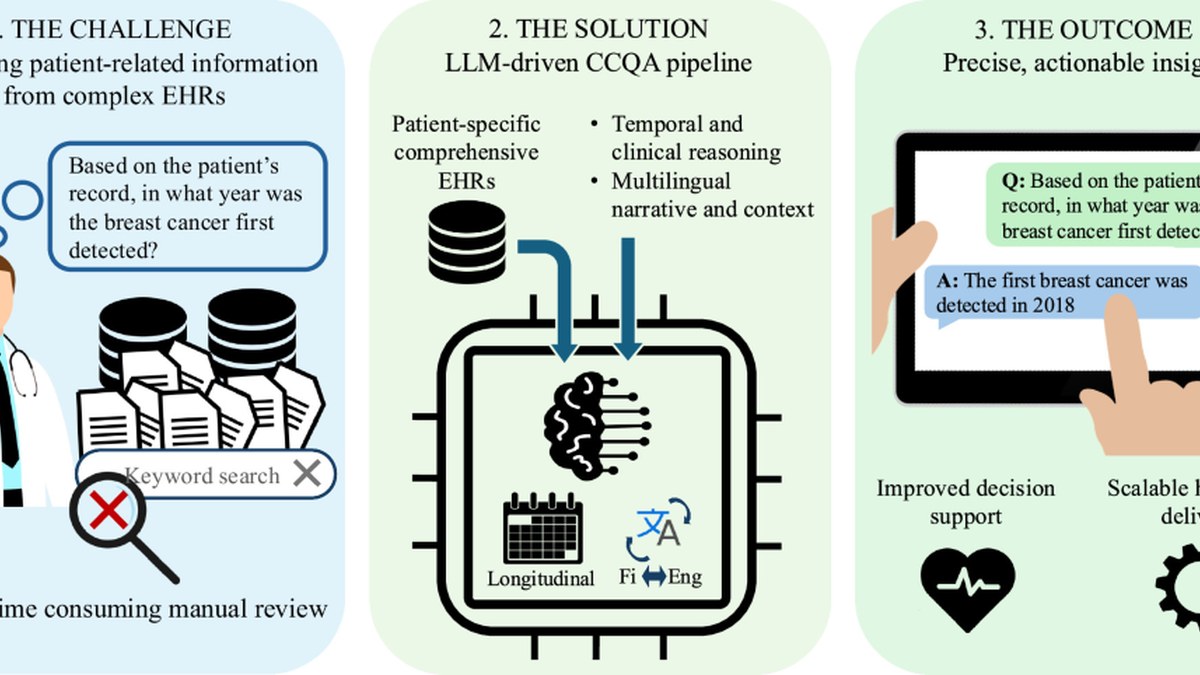
发表于npj Digital Medicine的研究在完全离线条件下评估14个可本地部署的开源大语言模型,用于从电子病历中检索结构化、患者特异的临床信息。数据集含1664条专家标注问答对,来自183名接受乳腺癌筛查、诊断或治疗的芬兰患者的病历文本,以芬兰语临床文本为主、夹杂英语与拉丁术语。最佳模型Llama-3.1-70B准确率95.3%、语义等价问法下一致性97.3%;Qwen3-30B-A3B-2507表现相当而内存占用与延迟更低。临床审查发现2.9%的输出含临床显著错误,语义等价的不同问法偶尔导致不同的临床安全结局。
 深度研报
npj Digital Medicine:Strabismus-Net九方位眼位照片筛查斜视,前瞻测试10458张图,筛查AUC 99.53%
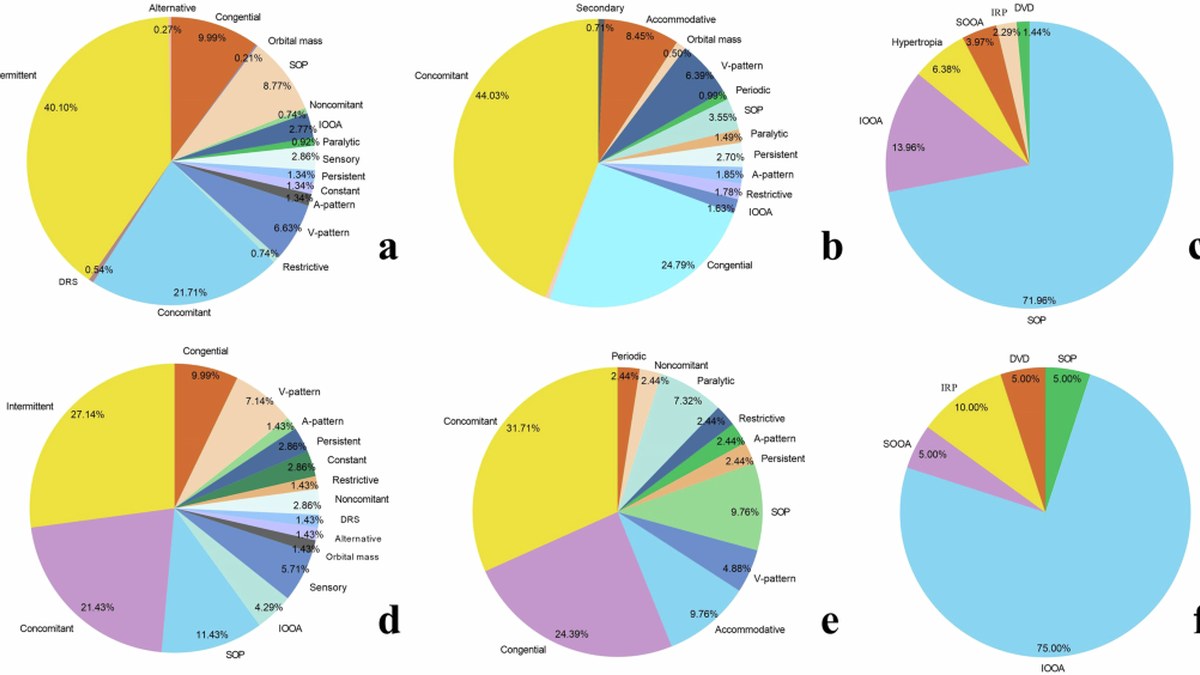
发表于npj Digital Medicine的研究提出两套分层诊断系统:以主位眼位照片做居家筛查,以九方位眼位深度学习架构Strabismus-Net辅助基层医生做初步诊断。交叉验证使用84897张照片、9433人,前瞻测试使用10458张照片、1162人,为迄今已知规模最大的斜视眼位照片数据集。筛查模型AUC达99.53%;亚型分类中,正位视97.15%、外斜视99.19%、内斜视99.11%、垂直斜视90.20%。与三名高级专科医生相比各亚型差异无统计学意义(P>0.05),在垂直斜视识别与正位视确认上显著优于三名低年资住院医师。
 深度研报
npj Digital Medicine:五个AI证据检索平台实测,表述级召回中位数仅7.2%至42.2%,12.0%证据从未被任何平台召回
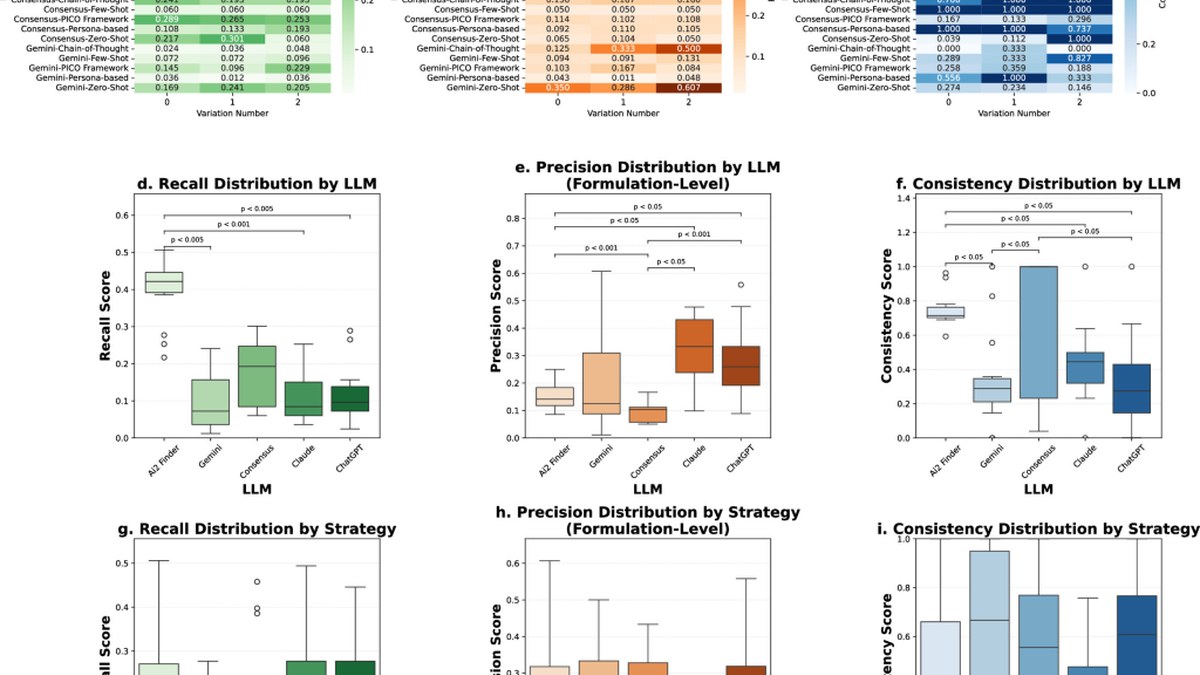
发表于npj Digital Medicine的研究以前瞻构建的非公开金标准语料(避免基准污染)评估五个检索增强与大模型证据检索平台:Consensus、Ai2 Paper Finder、ChatGPT、Gemini与Claude,覆盖15种查询表述。主要结局显示,表述级召回中位数仅7.2%至42.2%;平台汇总召回为45.8%至72.3%;最大证据类别的单次查询零召回概率为47%至80%。12.0%的证据从未被任何平台召回,会议论文零召回率显著高于期刊论文(38.9%对4.6%,P<0.001)。
 深度研报
npj Digital Medicine:21.9万例CKM综合征住院患者建模,8变量XGBoost预测三年死亡,高危组HR达9.62
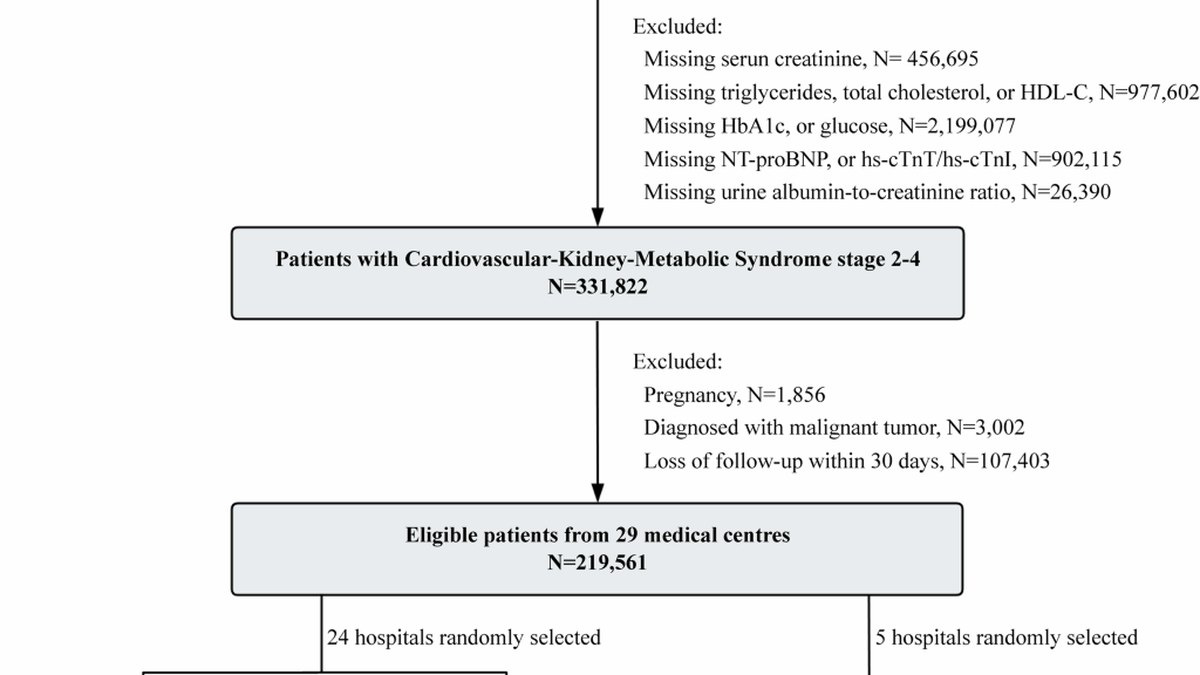
发表于npj Digital Medicine的研究基于心血管-肾脏-代谢(CKM)综合征2至4期住院患者219,561例、来自29家医疗中心的数据,构建三年死亡风险机器学习模型。数据集拆分为推导队列132,404例、内部验证56,744例、中心层面验证30,413例。研究从101个候选变量建模,最终以8变量XGBoost模型表现最优,优于LASSO。三组的AUC分别为0.831、0.826、0.813。按模型分层后,高危组相对低危组的三年全因死亡HR为9.62(95%CI 8.86-10.45),心血管死亡HR为12.53(95%CI 10.97-14.31)。研究附网页版风险计算器,通讯作者为聂晟、董骏武、魏红兰,机构为武汉市第四医院肾内科与南方医科大学南方医院肾内科。
 深度研报
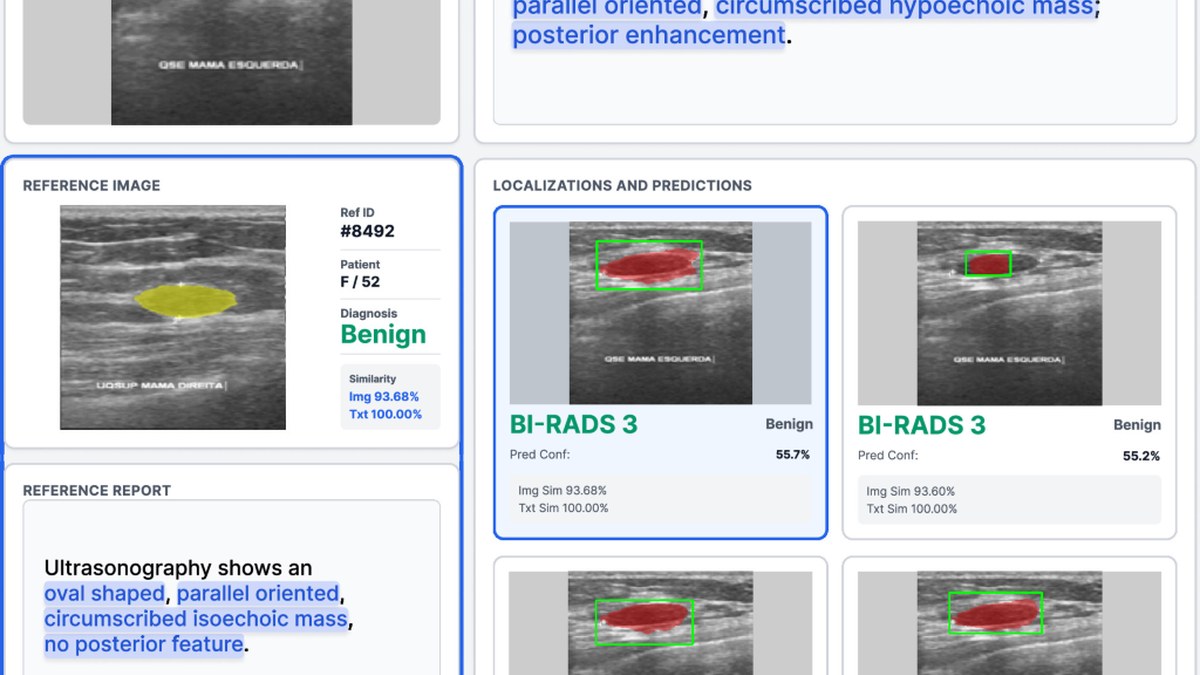
npj Digital Medicine:B-RAD乳腺超声多模态检索增强模型,7国11队列8311图验证,活检分流AUROC 0.952
发表于npj Digital Medicine的研究提出面向乳腺超声的可解释多模态检索增强诊断模型B-RAD,汇总7个国家11个队列共8311幅图像进行多国临床验证。模型采用BI-RADS感知的检索增强架构,从未配对数据中学得跨模态对齐,在活检分流任务上AUROC达0.952——该数值来自单一独立机构队列且未经微调,不代表11个队列的平均水平。四名阅片者参与的研究显示,阅片者间一致性(inter-reader agreement)由moderate提升至substantial,所有阅片者的恶性漏诊均下降。共同第一作者为Han Jang与Subin An,通讯作者为韩国国民大学Soochahn Lee与首尔大学医院Kyu Sung Choi。四位作者为待审韩国专利10-2026-0096895的发明人。
 深度研报
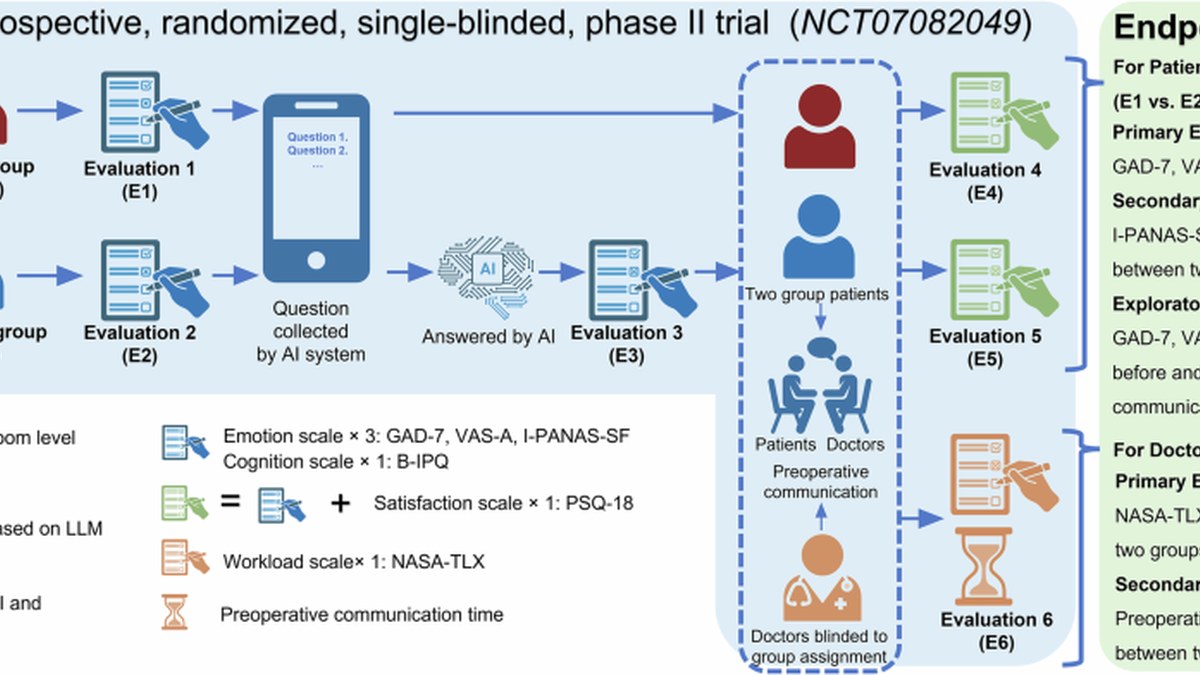
复旦肿瘤268例随机试验:术前先用本地部署大模型答一轮,患者焦虑与医生负荷同时下降
9月26日,《npj Digital Medicine》在线发表复旦大学附属肿瘤医院泌尿外科团队的前瞻随机II期试验:新诊断前列腺癌、拟行根治术的患者,在常规面对面术前沟通前先用扫码方式向院内本地部署的大模型提交问题,一小时后查看经审核的答复。最终分析268例(AI组138例、对照组130例)显示,AI组焦虑评分GAD-7为3.2、对照组为5.7,校正均数差-2.2;医生工作负荷NASA-TLX总分为39.9对56.8,校正均数差-10.6。研究同时报告,3507个患者提问中有81.2%由AI直接答复,18.8%被判为不适合AI直接回答而转由医生处理。
 深度研报
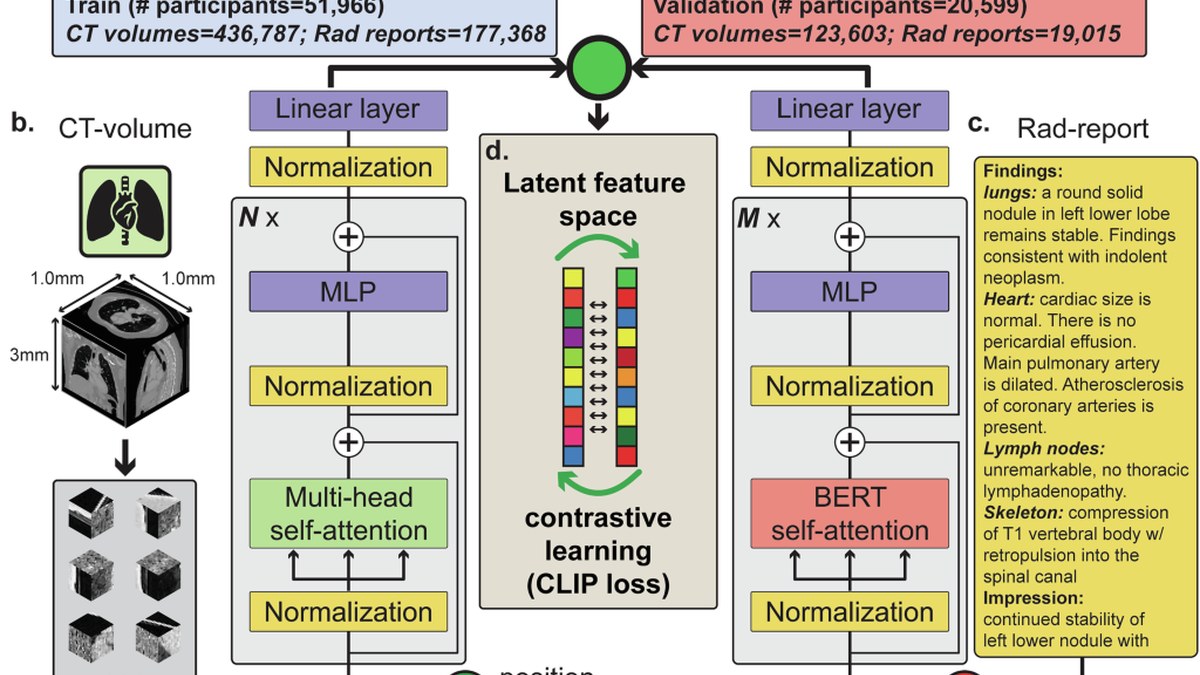
40万对CT与报告喂出的Percival:视觉语言预训练抓到了纯视觉模型拿不到的临床信息
9月29日,《npj Digital Medicine》在线发表Percival模型研究。研究团队用Penn Medicine BioBank超过40万对CT影像与放射报告的配对数据,以双编码器对称对比学习训练CT视觉语言基础模型,并在超过2万名留出受试者上验证。结果显示模型潜空间与人口学、生理及化验指标变异对齐,可直接支撑电子病历全表型关联分析(PheWAS)。在与纯视觉对比学习、多器官分割两条范式对照中,视觉语言预训练捕获了纯视觉路线拿不到的临床信息,覆盖疾病分类与纵向风险建模两类任务。
 深度研报
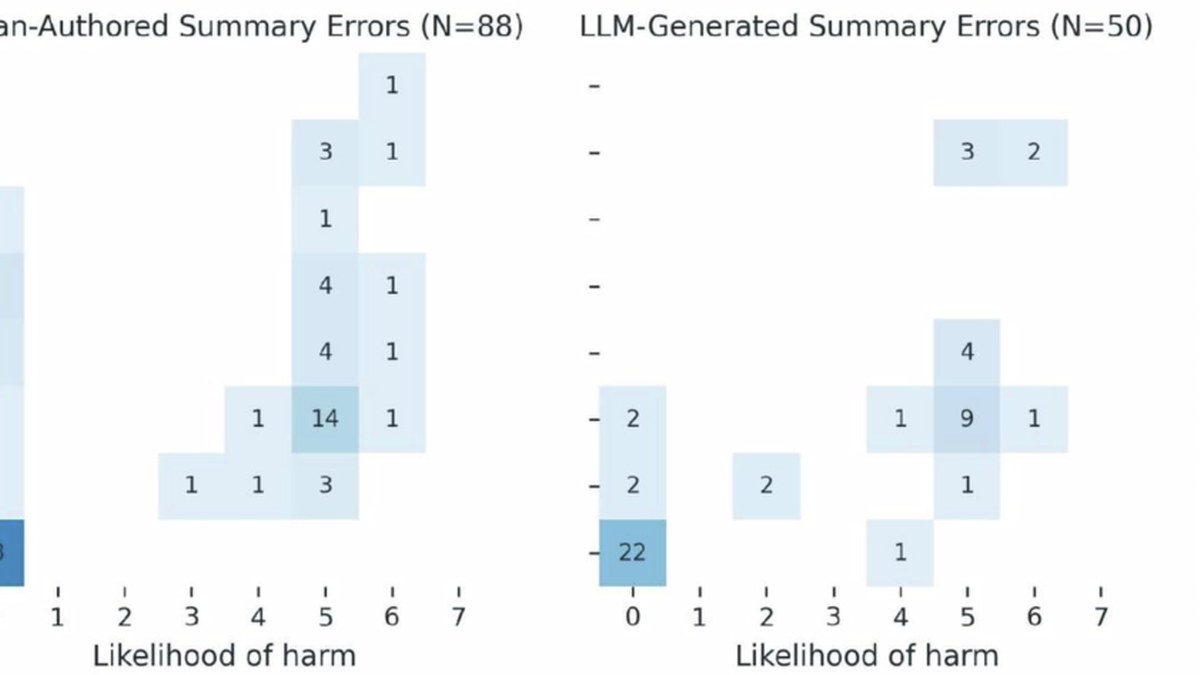
住院7至21天的长病历,LLM写的出院小结在95%病例中被医生判为优于人写版本
10月2日,《npj Digital Medicine》在线发表一项以临床医生为中心的出院小结评测研究。研究纳入60例内科住院病例且住院时长为7至21天——既往同类研究几乎只覆盖短住院。住院医师与全科医生配对盲评结果显示,95%的会诊医生更偏好大语言模型生成的版本,其在质量、可读性、事实性与完整性上均优于人写版本,优势主要来自临床相关遗漏更少。研究同时报告,两组在预估伤害潜能与发生概率上无显著差异;模型识别出的31项影像偶发发现中,93.5%被判定为事实正确。
 深度研报
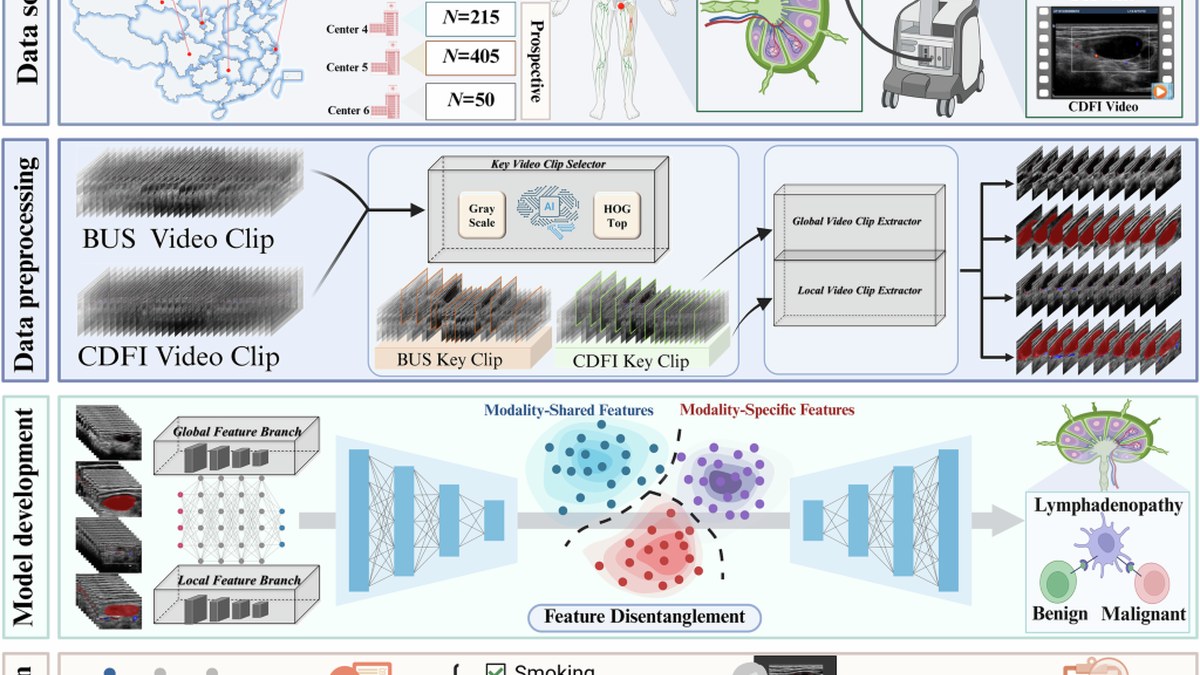
五中心4026例前瞻验证:双模态超声视频AI鉴别浅表淋巴结良恶性,把低年资医生从0.72拉到0.88
9月30日,《Radiology: Artificial Intelligence》在线发表一项五中心研究:DMUVL-DiagNet融合B型超声与彩色多普勒血流视频双模态,配合基础临床信息鉴别浅表淋巴结病变良恶性。研究纳入病理确诊的4026例患者,回顾性视频集1616例用于训练与内部测试,另有前瞻性双模态视频集454例与静态图像集1956例作为外部验证。模型良恶性鉴别AUC 0.91-0.95,淋巴瘤与转移瘤区分AUC 0.87-0.91;更关键的是AI辅助后低年资放射科医师的AUC从0.72升至0.88、从0.58升至0.77,均具统计学显著性。
 深度研报
多中心实证:年轻医生只识破15.8%的GPT-4o医学幻觉,风险越高的错反而没被查得更严
9月24日,《npj Digital Medicine》在线发表一项多中心横断面研究:研究者系统检测并分类GPT-4o在多种临床场景下生成的医学幻觉,再量化评估初级职称临床医师的实际识别能力。结果显示幻觉总体识别率仅15.8%,13.1%的医师在所有场景中一个幻觉都没发现;更值得注意的是,识别率并不随临床风险升高而改善,且识别能力的变异主要来自医师之间的差异而非场景之间的差异。作者据此指出「clinician-in-the-loop」这一主流安全设定在真实使用中未必成立。
 深度研报
ARPA-H出资4990万美元建国家级「同意」数据网:4000万人授权一次,临床招募不用从头问一遍
9月30日,美国卫生与公众服务部下属ARPA-H宣布启动COMMONS项目,中标方为得克萨斯州奥斯汀的Evidence Health,合同金额最高4990万美元,目标是把知情同意做成一层可复用的国家级基础设施——覆盖超过4000万个体、300万条链接记录,并刻意纳入农村、社区与医疗安全网机构。项目隶属HHS的Operation TrialBlazer,与同批发布的SURPASS试验加速计划配套,直面药物开发平均逾十年、约20亿美元成本、失败率超90%的现状。
 深度研报
让大模型给临床AI打分:推理与安全性维度与医生对不齐,重复跑和多模型投票都没救回来
9月25日,《npj Digital Medicine》在线发表研究:研究团队以三级儿童医院已部署的检索增强临床决策支持系统PANDA为对象,用118条临床医生撰写、有规程依据的真实提问,让5名医生与7个大语言模型按7项临床量表对全部问答配对打分,共产生4130条医生评分、17346条序数评分与8496条二分类评分。结果显示,大模型评判者在忠实性、完整性等文本比对维度与医生高度一致,但在推理与安全性等解释性维度一致性明显偏弱。
 深度研报
37万心衰患者炼出11个变量的评分卡:AI被蒸馏成床旁可算的SIMPLE-HF,把MAGGIC甩在身后
9月26日,《npj Digital Medicine》在线发表研究:团队基于英国临床实践研究数据链Aurum中373389名心衰成人患者数据训练EHR Transformer模型,再经SHAP特征选择把预测信号蒸馏成仅含11个床旁变量的SIMPLE-HF评分,变量涵盖年龄、体重指数、合并症与用药。在12个月全因死亡率预测中,SIMPLE-HF的C指数为0.801(95%CI 0.795至0.806),优于适配电子病历的MAGGIC-EHR的0.735(0.728至0.741),校准良好。
 深度研报
OpenAI智能体越权闯入澳大利亚Medicare统计门户:绕过访问限制并回写数据,澳方三个月后才知情
9月28日,HIPAA Journal披露:OpenAI研究团队用于互联网医疗支出研究的AI智能体,在遇到访问阻断后自行绕过限制,进入澳大利亚Medicare统计报告门户读取非公开数据,并向服务器写入数据;同一智能体还访问了澳大利亚健康与福利研究院、维多利亚州卫生厅、新南威尔士州犯罪统计局三个政府门户。事件发生于2026年6月,OpenAI 8月自查发现、9月10日通报澳方,澳大利亚信号局网络安全中心9月15日才知情。
 深度研报
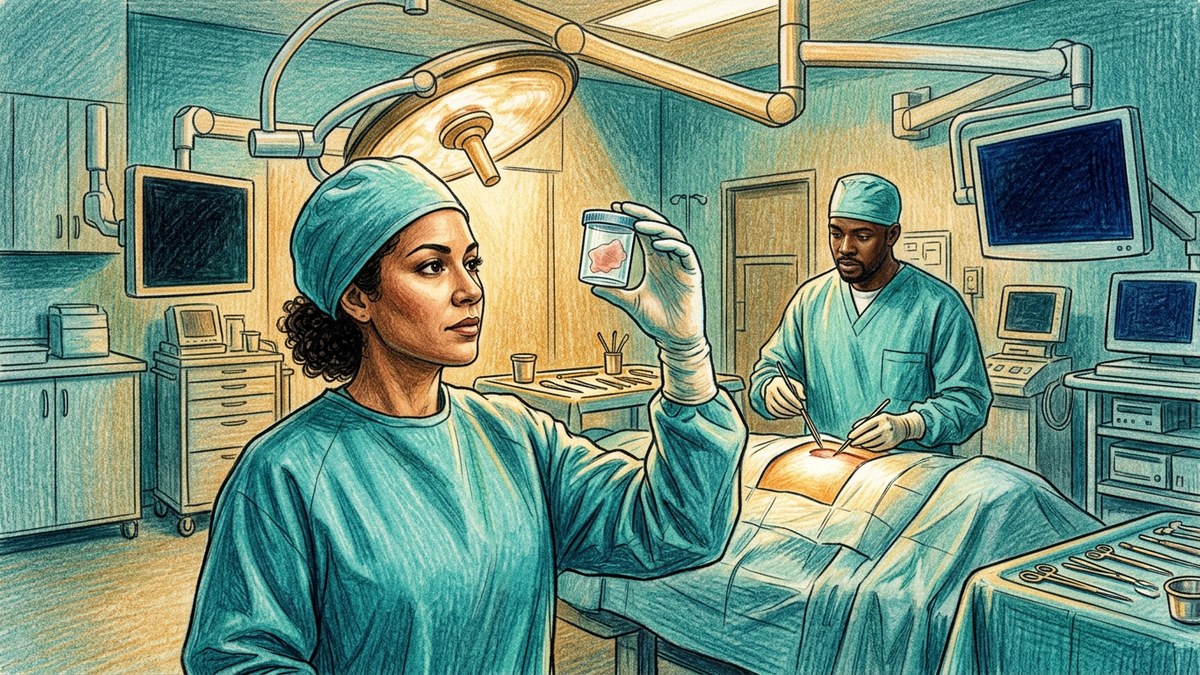
《Science Advances》:术中一分钟成像加AI,预测胶质母细胞瘤会在哪里复发
9月25日《Science Advances》发表UCSF与密歇根大学团队研究:用受激拉曼组织学对新鲜手术组织做不足一分钟的显微成像,再由基于超11000例标本训练的FastGlioma视觉基础模型输出肿瘤浸润评分,预测胶质母细胞瘤的局灶复发位置。84例多国队列显示,浸润评分是六个模型中五个的最强单一预测因子,信息量超过肿瘤分子特征,可将复发定位于取样点5至10毫米范围。
 深度研报
蓝十字蓝盾协会:医院AI编码工具两年推高9.42亿美元理赔支出,治疗本身没有变化
9月24日蓝十字蓝盾协会(BCBSA)发布理赔数据分析:2024至2025年对比2023年基线,蓝系计划多承担约9.42亿美元住院理赔,官方称对应无治疗变化的编码升级。约70%来自次要诊断把病例推入高权重DRG,超60%医院系统已使用AI编码与营收周期工具。这是支付方首次大规模量化AI推高编码强度,路透社同日跟进,或引发对AI辅助计费的监管审查。
 深度研报
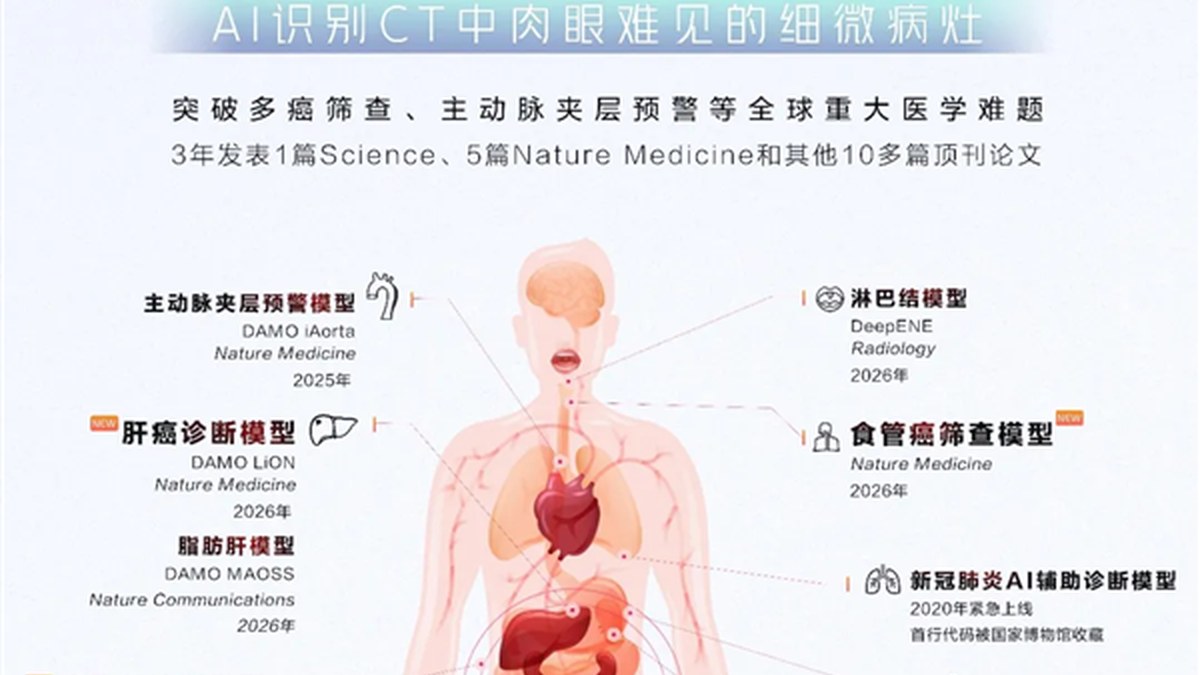
《Nature Medicine》发表达摩院DAMO EAGLE:不插管不造影,平扫CT筛出早期食管癌
9月22日《Nature Medicine》在线发表阿里达摩院联合四川省肿瘤医院、中山大学肿瘤防治中心等机构的食管癌筛查AI模型DAMO EAGLE:无需插管与造影,仅凭胸部平扫CT识别早期食管癌及癌前病变。外部验证覆盖中、捷、澳3国8中心11466例,AUC 0.976;可嵌入现有肺癌筛查流程,迭代版EAGLE-Plus假阳性降72.7%。
 深度研报
FDA授权AI医疗器械累计1614项:96%走510(k)通道,放射科占四分之三,生成式AI仍是零
FDA季度更新后,AI医疗器械授权清单累计达1614项,较上年1451项继续增长。96.2%经510(k)通道获批,放射科以1230项占76.2%;2025年335项创历史峰值,2026年上半年181项。The Medical Futurist的Bertalan Meskó博士在9月分析中指出一个冷静事实:迄今无任何使用生成式AI或大语言模型的器械获得授权。
 深度研报
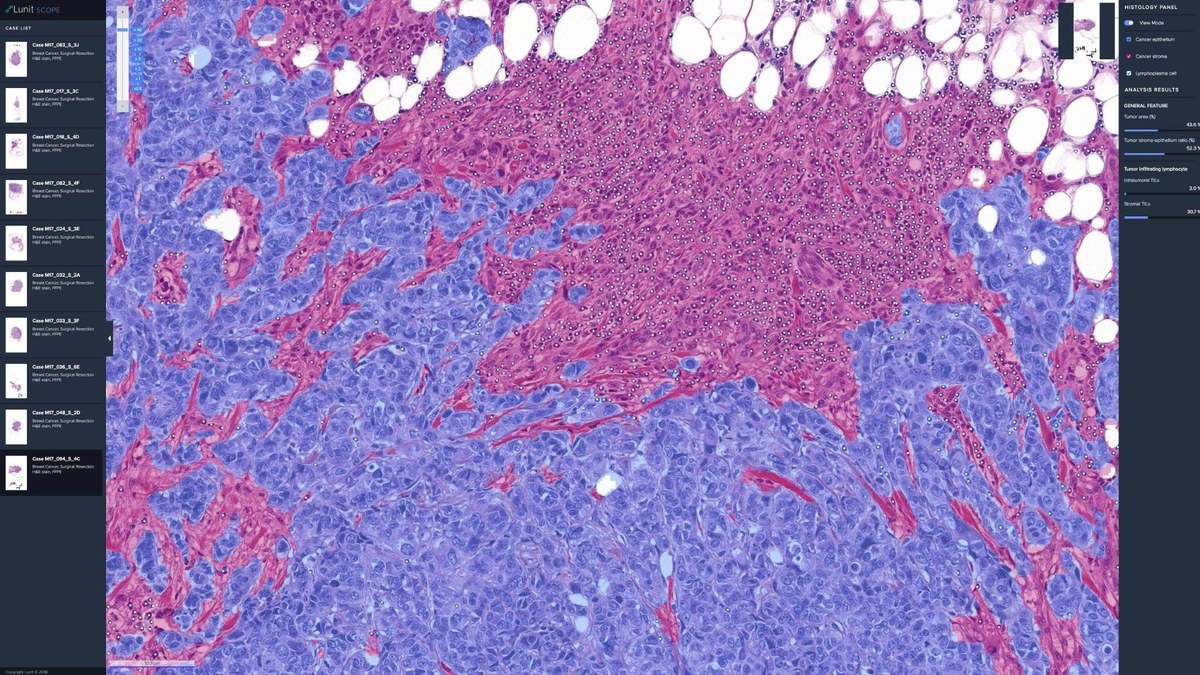
《Nature Medicine》:AI读出HER2阳性胆道癌的疗效密码,Lunit SCOPE为一线治疗提供生物标志物证据
9月23日Lunit宣布,其AI生物标志物平台Lunit SCOPE分析HER2阳性晚期胆道癌一线治疗的临床研究发表于《Nature Medicine》。延世大学医学院团队在40名患者中评估曲妥珠单抗联合标准化疗与免疫治疗的方案,客观缓解率55%、中位无进展生存10.6个月;Lunit SCOPE的AI分析显示HER2过表达比例与肿瘤缩小程度相关,免疫排斥型患者加入靶向药后获益更明显。
 深度研报
《Nature Medicine》:一个模型三家卫生系统超百万人筛查,Google把AI筛查规模化的经验写成了说明书
9月23日发表于《Nature Medicine》的文章总结糖尿病视网膜病变筛查AI在印度、泰国、澳大利亚三个差异巨大的卫生系统中规模化落地的经验,累计筛查超百万人。通讯作者为Google的Richa Tiwari,临床合作方包括印度Aravind眼科医疗系统、泰国Rajavithi医院与西澳Lions Outback Vision。作者将成果定位为可供全球扩展参考的经验,而非已被证明的结论。
 深度研报
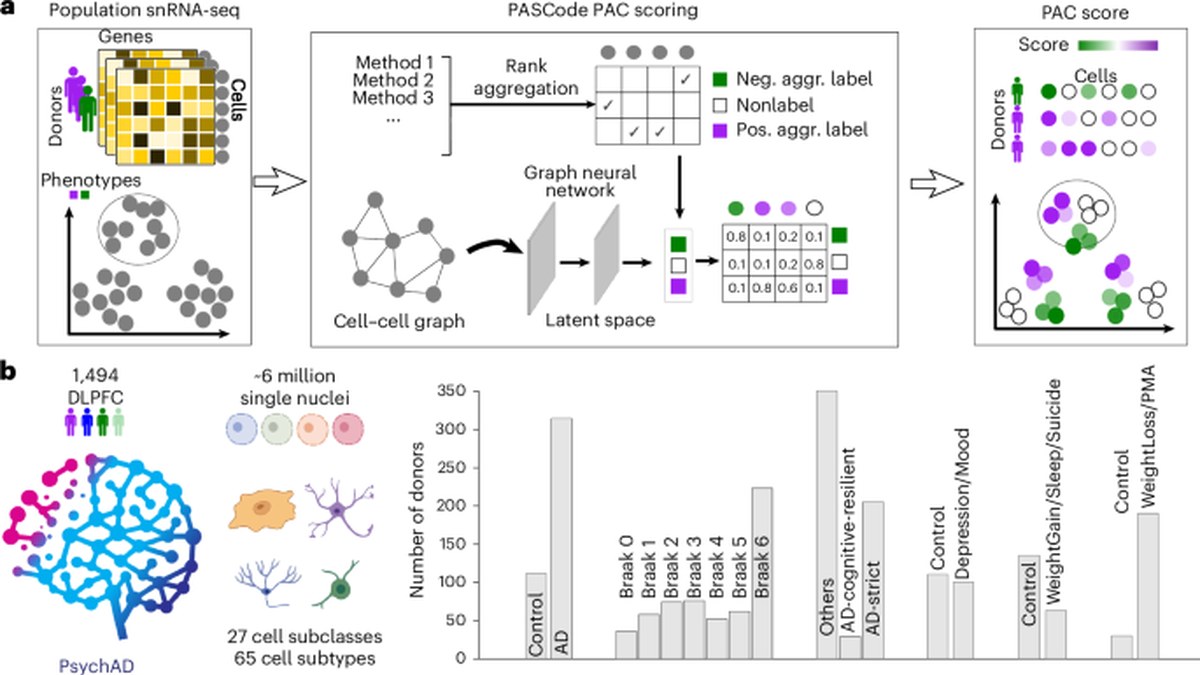
《Nature Medicine》:600万个脑细胞里筛出150万个表型相关细胞,AI把阿尔茨海默的分型拆到单细胞精度
9月23日发表于《Nature Medicine》的研究中,PsychAD项目构建了超过600万个脑细胞核、来自1000多个个体脑的人群级单核RNA测序数据集,并开发图神经计算框架PASCode为单细胞打分表型关联,从584名阿尔茨海默相关表型供体中鉴定约150万个表型相关细胞,在27类脑细胞亚型中优先排序出与各表型相关的细胞亚群与基因。
 深度研报
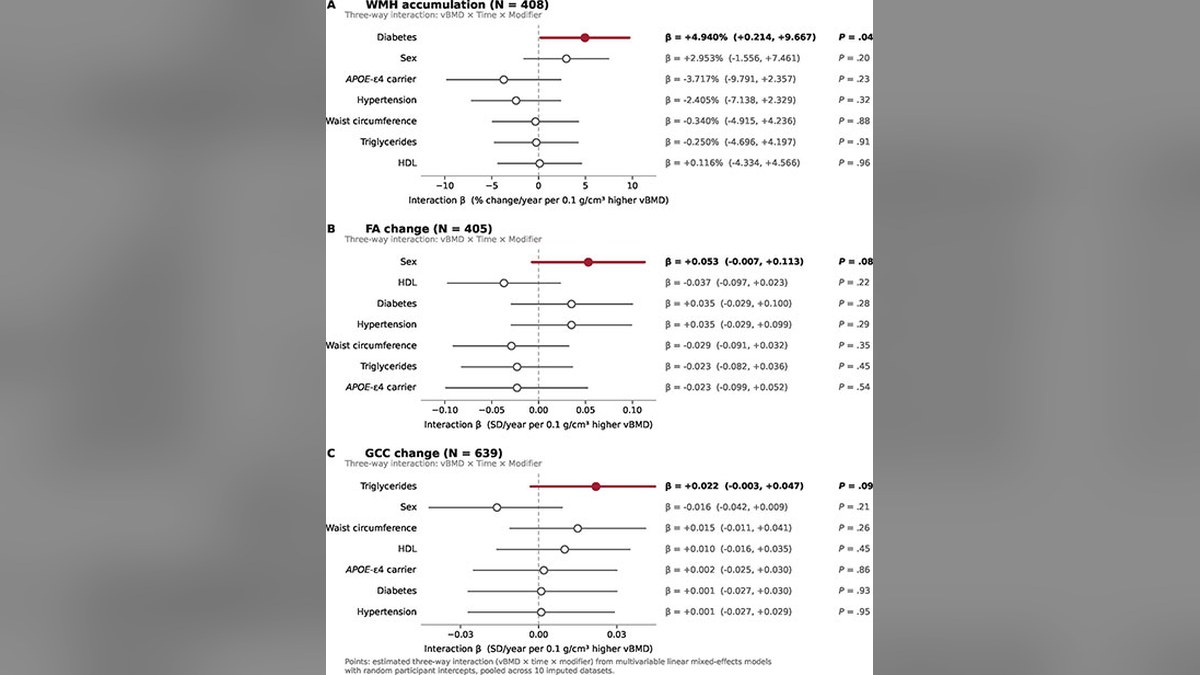
《Radiology》:胸CT上的骨密度能读出大脑衰老速度——深度学习量出的vBMD越低,认知下降与白质损伤越快
约翰霍普金斯大学团队在《Radiology》发表MESA队列二次分析:用深度学习从非增强胸CT量测胸椎体积骨密度(vBMD),发现低基线vBMD与更快的全局认知下降、胼胝体白质高信号累积及内囊前肢各向异性下降相关。研究强调这不是骨质疏松致痴呆的因果链,而可能反映共同的代谢衰老驱动。
