即取即用的 AI-Ready 医疗数据集库
千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。
数据标签
共 1832 个数据集
OpenBind — 首届 OpenBind 社区盲测:寨卡病毒 NS2B-NS3 蛋白酶 400 化合物结构预测挑战
400 个从碎片到类先导的小分子、一个 46+168 氨基酸的双链靶点、一条收紧到 1.5 Å 的及格线:OpenBind 联合 OpenADMET 与 ASAP 把结构预测从回顾性打分推进到前瞻性盲测
InteractBind — 9.9 万蛋白-配体对的残基级非共价相互作用图谱基准
从 PDB 实验结构出发,用 PLIP 与 GetContacts 把六类非共价接触投影成与 FASTA 序列对齐的残基级指纹;二元结合预测 AUROC 98.3% 的模型在结合位点定位上 BRHR@1 仅 21.6%——一个把「猜对结果」与「看懂位点」拆开来评的基准
Med-ReasonSeg — 54 万条影像-掩码-问答三元组的医学推理分割数据集
90,021 例扫描 / 16 个公开分割库 / 9 种模态 / 539,383 条三元组:两阶段 Gemini 流水线为每张掩码配 6 条问答(3 referring + 3 semantic),每图恰 5.99 条,服务于 MedFuse-Seg(MICCAI 2026)
X-PCR — 跨模态渐进式眼科临床推理基准
26,415 张眼科影像与 177,868 条专家核验 VQA,覆盖六模态与 52 病种,以六级因果链与跨模态对齐方式测量多模态大模型的诊断连贯性、幻觉与置信校准
NEJM-Bench — 二十年 NEJM 临床图像挑战的千题多模态基准
《新英格兰医学杂志》Image Challenge 栏目 2005-2026 年 1,063 例临床图像五选一题:公开版剥离答案键、双场景(MCQ/开放作答)评测、本地 Qwen3.5-27B 裁判与训练截断过滤,暴露约 30 个百分点「选项红利」与放射学 25.7% 的难度下限
MedSynth — 万对合成医患对话-SOAP 病历数据集
10,035 对全合成医患对话与 SOAP 病历、覆盖 2,001 个 ICD-10 码:以 IQVIA 理赔分布定病种、GPT-4o 六代理流水线反向生成对话,陪审团偏好率对比 NoteChat 达 95%,并以 Dial2Note 基准身份进入 SMM4H-HeaRD 2026 共享任务
CATS-58 — 临床缩写义项消歧平衡基准集
58 个高歧义临床缩写 × 2 义项 × 150 受控生成句 = 17,400 条——为临床缩写消歧(clinical acronym disambiguation)提供按义项完全均衡的合成基准,CC BY 4.0 于 HuggingFace 公开直链
CliniQ — MIMIC-III 电子病历实体检索基准:1,246 条查询 × 77,206 条 LLM 相关性判定,五类语义匹配首次量化
首个公开电子病历(EHR)实体检索基准:基于 MIMIC-III 1,000 份出院小结切成 16,550 个语块,从 ICD-9 与 NDC 处方标签转写 1,246 条疾病/操作/药物查询,GPT-4o 逐语块标注 77,206 条相关性判定(与专家 Kappa 0.985),并首创字符串/同义词/缩写/下位词/隐含五类语义匹配评估体系
LiveClin — 无泄漏活临床多模态评测基准
半年一换血的活临床基准:1,407 例 PMC 病例、6,605 道十选一顺序 MCQ、3,757 张图与 634 张表,26 个模型最高仅 35.7%,ICLR 2026
CARE-Bench — 面向患者的医疗大模型分诊能力基准:每轮四类当前行动评测,500 案例 1,059 披露前缀
CARE-Bench——以源可溯(source-grounded)方式从真实医患对话与门诊咨询重构 500 例临床案例与 1,059 个患者信息披露前缀,将面向患者的 LLM 分诊形式化为每轮四类当前行动任务(询问澄清/自我照护/常规就医/紧急升级),以固定 GPT-5.5 盲映射器对 11 个模型在 269 个保留轮次上做确定性评分,暴露模型在行动时机判断上的系统性安全缺陷
BedsideBench — 500 例床旁临床问答评测基准
Doximity 出品的 10 面板×50 例临床问答基准:8 面板用签名加权 points rubric、2 面板用严重度加权 F1 管理计划评分;公开 250 例 + 私有 250 例,CC BY-NC-SA 4.0,附完整 judge 协议与 runner
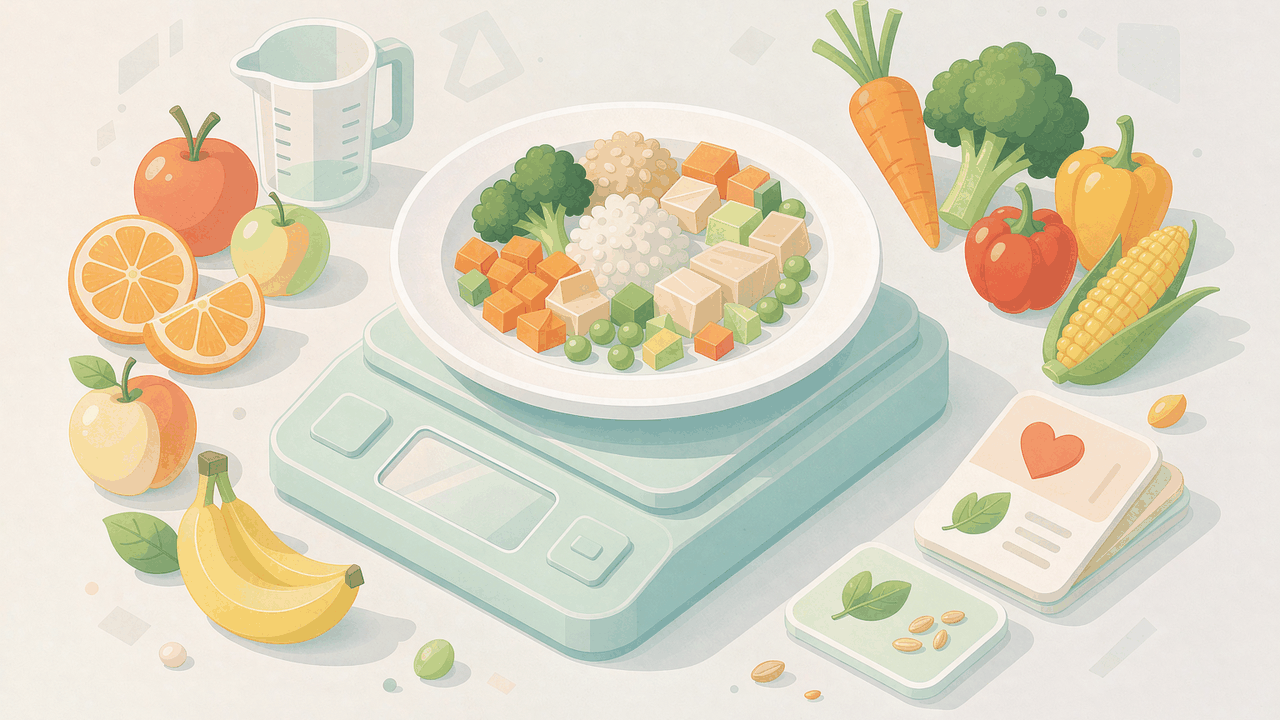
Nutrition5k — 食物营养成分视觉理解基准数据集
Google Research 于 CVPR 2021 发布的通用食物营养理解数据集——加州园区自助餐厅采集 5,006 盘真实餐盘,配 4 路侧角扫掠视频、俯拍 RGB-D 图像、电子秤逐成分克重与 USDA 数据库换算的高精度营养标注,官方基线模型对卡路里的预测误差低于专业营养师的视觉估计,全量数据以 CC BY-4.0 许可公开
定制数据集服务
无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。
