即取即用的 AI-Ready 医疗数据集库

千方医数集致力于为医疗 AI 研究人员找到合适的数据集,让你的 AI 感知模型能够更快地学习、更准确地运行,并无缝适应现实世界的环境。

数据标签

医学影像 AI-Ready 数据集

电子病历与文本数据集

病灶分割与标注数据集

共 1676 个数据集

GuacaMol 与 MOSES 分子生成基准套件
药物发现与化学医学问答与基准分子生成评测基准

GuacaMol 与 MOSES 分子生成基准套件

SMILESmolecular generation benchmarkdistribution learninggoal-directed optimization0

Molecular Generation Benchmark Suites — GuacaMol (BenevolentAI) 与 MOSES/Molecular Sets (Insilico Medicine) 的并置条目
ReXPref-Prior 胸片报告先验幻觉偏好数据集
医疗NLP临床文本医学影像医学问答与基准

ReXPref-Prior 胸片报告先验幻觉偏好数据集

衍生数据文本数据自动生成标注24,462 份报告对应的 MIMIC-CXR study(患者数未单独披露,继承母库口径)

基于 MIMIC-CXR 的句级偏好对数据集——GPT-4 改写胸片报告中的先验检查指称,配合同名方法论文以直接偏好优化抑制报告生成模型的先验幻觉行为
MS-CXR-T — 胸片时序视觉语言基准
医学影像医疗NLP多模态X光影像影像-文本对齐评测基准

MS-CXR-T — 胸片时序视觉语言基准

时序标注人工标注基准评估集800 名患者(1,326 图像对)+ 361 报告句对(MIMIC-CXR v2 派生,板证放射科医生金标准)

1,326 对胸片 + 361 对报告句的时序双任务基准:给医学 VLP 模型装上'时间之眼'
ReXVal:放射报告六类错误的医师计数标注
医学影像影像-文本对齐评测基准临床文本

ReXVal:放射报告六类错误的医师计数标注

胸部X光报告生成错误标注多标注者人工评测50

五十项检查、四份高分候选报告、六位执业放射科医生,按六类错误逐个计数并区分临床意义,这份阶梯式样本把「报告哪错了」从一句评语变成可加总的向量
IMCS-21 — 中文医患多轮对话基准
医疗NLP临床文本儿科

IMCS-21 — 中文医患多轮对话基准

4,116 条儿科对话164,731 句10 种儿科疾病5 任务多级标注GitHub 公开测试集走 CBLUE 天池非患者数据,对话语料(4,116 条儿科问诊记录)

4,116 条儿科医患对话 · 5 任务多级标注 · 中文医疗对话理解基准

PadChest — 西班牙大规模胸片多标签数据集
医学影像X光影像图像分类多模态

PadChest — 西班牙大规模胸片多标签数据集

- "约 1TB(DICOM 原图)" - "160,868 张影像" - "297 个 UMLS 标签" - "27% 医师人工标注" - "西班牙语报告" - "免费申请获取"6.7 万名患者

西班牙最大胸片公开数据集 · 16 万影像 · 西班牙语报告 + UMLS 多标签
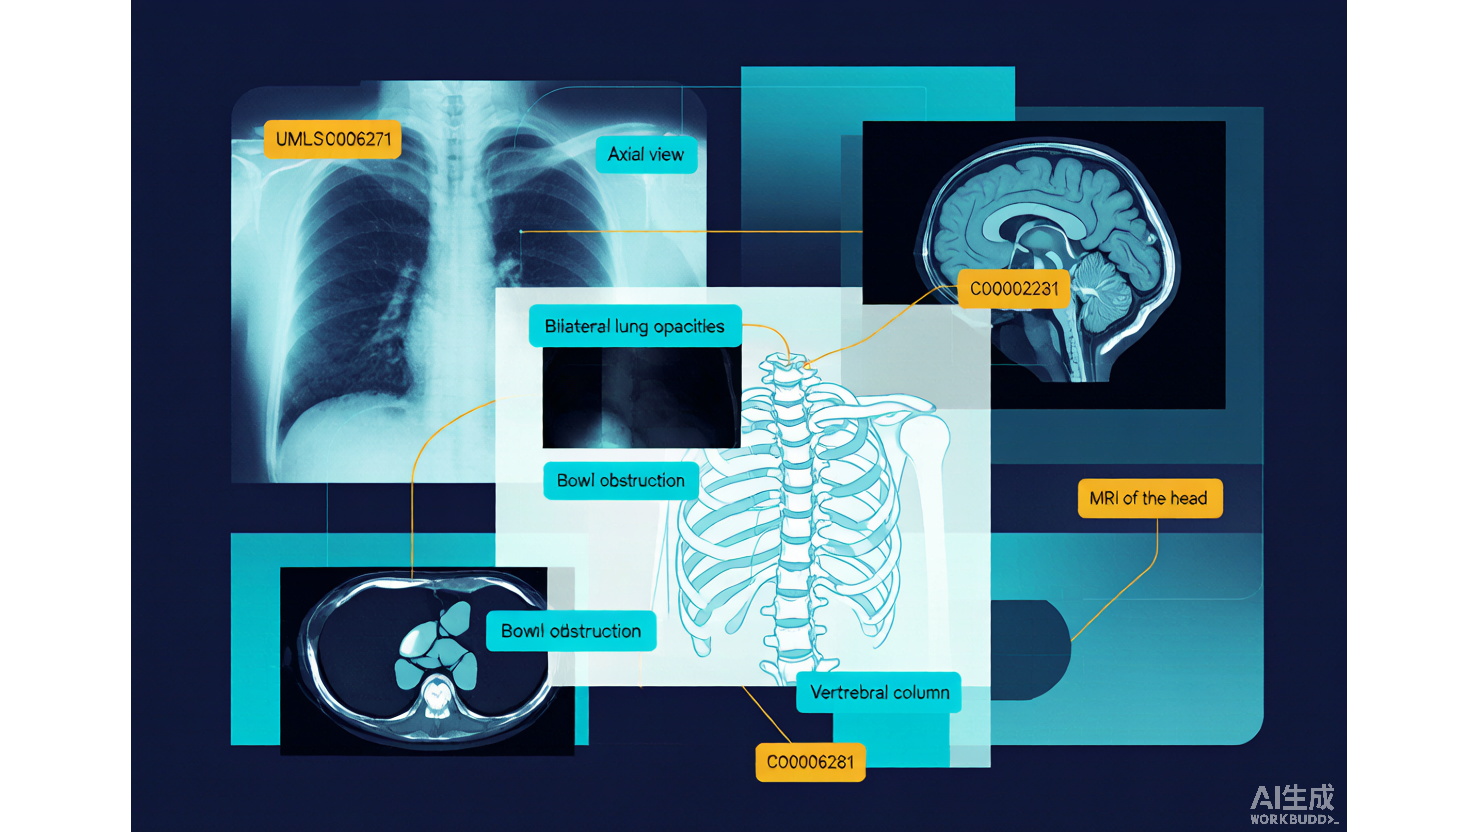
ROCO — 放射学图文多模态数据集
多模态医学影像分子生成影像-文本对齐目标检测

ROCO — 放射学图文多模态数据集

81,825 张放射学图像6,127 张 out-of-class 图像ROCOv2 79,789 张图像1,947 个 UMLS 概念约 6.3 GB 图像包免费开放下载不适用(源自公开文献图像,无患者队列)

81,825 张放射学图像配英文图注与 UMLS 概念标注的多模态数据集

Swiss-Mammo — 德文乳腺报告合成数据集
医疗NLP临床文本医学影像乳腺影像

Swiss-Mammo — 德文乳腺报告合成数据集

合成数据标注数据评测基准28 份德文报告(+28 份英文翻译)——全库最小数据集;BI-RADS 0-6 每类 4 份均衡分层;全部虚构、零真实患者数据

28 份医生手写的德文乳腺报告:训练语料被锁死后,合成数据的'替代发布'方法论教科书
CXR-PRO — 去 prior 引用胸片报告集
医疗NLP临床文本医学影像

CXR-PRO — 去 prior 引用胸片报告集

报告文本去幻觉语料金标准测试集374,139 份放射报告及关联胸片(MIMIC-CXR study 级衍生,无新增患者)

删掉教材里的谎言:37.4 万份报告的 token 级手术,治好报告生成模型的幻觉
MIMIC-IV-Note — 去标识化临床自由文本语料库
医疗NLP医学影像X光影像生物医学文献

MIMIC-IV-Note — 去标识化临床自由文本语料库

约 45GB(压缩 CSV)331794 份出院摘要2321355 份放射报告HIPAA 去标识化14.6 万名患者
REVA-PO — 胸片报告生成强化学习稳定化框架与 MIMIC-CXR/IU-Xray 复现包
医学影像多模态影像-文本对齐医疗NLP评测基准

REVA-PO — 胸片报告生成强化学习稳定化框架与 MIMIC-CXR/IU-Xray 复现包

文本数据影像数据派生数据上游规模:MIMIC-CXR 377,110 张 / 227,835 份报告 / 65,379 名患者(库内 rid=16 口径);IU-Xray 3,955 份报告(库内 rid=107 口径);R

以 Qwen2.5-VL-7B 为底座的三阶段流水线(连接层预热→分类器引导 SFT→无 Critic 的组相对策略优化),用响应加权正则与验证锚定策略重置驯服长期 RL 训练中的 KL 压力的开源复现包
IU X-Ray:胸片报告生成领域的第一个公开基准
医学影像X光影像医疗NLP多模态医学问答与基准

IU X-Ray:胸片报告生成领域的第一个公开基准

原始影像配对报告人工标注元数据3,955 例检查 / 七千余张影像

7,470 张胸片 / 3,955 份报告 / 千余个 MeSH 标记

定制数据集服务

无法找到所需数据?我们提供个性化的临床数据采集与高精度人工标注服务,满足您的特定算法研发需求。