信息速览
2026 年 7 月 1 日,Zenodo 上线了一份编号 21083480 的记录。它只有 8 段视频、8 只狗,却同时带着三层标注:帧级边界框、跨帧轨迹、以及其中 3 段的行为类别与个体身份。拍摄地不在非洲草原,而在美国俄亥俄州坎伯兰一处由露天煤矿复垦而来的大围栏保护中心。
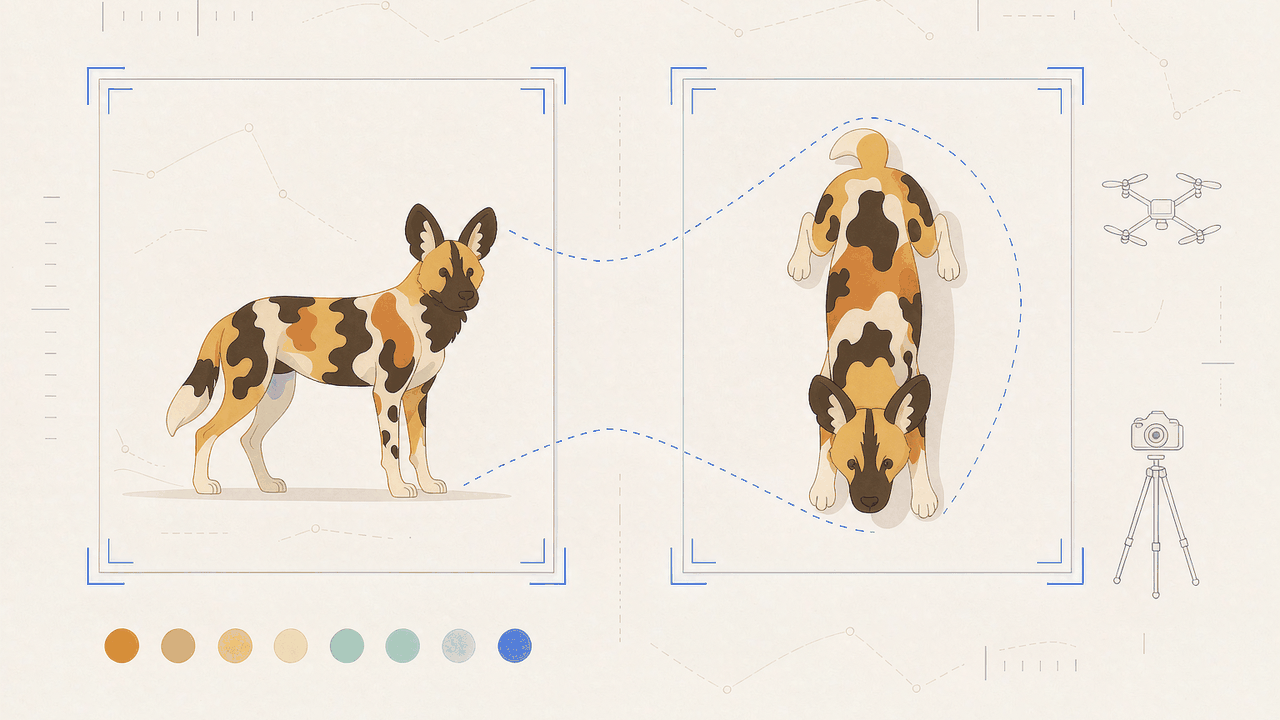
这份数据真正稀缺的地方,是它把「同一批个体」放进了「两类完全不同的拍摄几何」里:地面固定机位的广角近景,与无人机的俯视远景。同一只狗在这两路画面里的尺度可以差十倍,而它身上那块斑驳的三色毛皮,恰好是天然的个体指纹。身份因此成了一个可以把两种视角缝合起来的锚点。
它同时有三处必须先说的硬伤:记录状态是受限访问,公开渠道拿不到一个字节的视频;作者与机构因双盲评审被完全脱敏;9 类行为谱只公布了类别数,没公布类别名。一屏速览见下表。
| 项目 | 内容 |
|---|---|
| 官方全称 | WildDog-Videos: A Multi-View Video Dataset of African Wild Dog Behavior |
| 物种 | 非洲野犬 Lycaon pictus(IUCN 濒危) |
| 个体数 | 8 只,均可单独识别 |
| 视频段数 | 8 段原始视频 |
| 带行为谱的段数 | 3 段(另有 9 类行为谱 + 个体身份标注) |
| 行为类别数 | 9 类(类别名称未在公开元数据中列出) |
| 行为与身份标注量 | 16.1 万条帧级标注(仅限那 3 段) |
| 检测与跟踪覆盖 | 全部 8 段,帧级边界框 + 跟踪 |
| 采集设备 | GoPro Hero 7、GoPro Hero 11(固定机位)+ DJI 无人机(型号未披露) |
| 采集时间 | 2024 年 4 月至 5 月 |
| 采集地点 | The Wilds Conservation Center,坎伯兰,俄亥俄州,美国 |
| 发布 | 2026-07-01,版本 1.0.0-review,Zenodo 记录 21083480 |
| DOI | 10.5281/zenodo.21083480(概念 DOI 10.5281/zenodo.21083479) |
| 许可 | 元数据标 CC BY 4.0,但记录状态为 restricted |
| 作者 | Anonymous, Anonymous(双盲评审期间脱敏) |
| 代码仓 | etho-tools,托管于 anonymous.4open.science |
§1 它到底是什么:一份「身份锚定」的多视角行为录像
一句话:这是同一批 8 只非洲野犬在两个拍摄几何下、被逐帧标注到个体与行为层面的短视频集,发布时处在「论文在审、作者匿名、文件受限」的三重中间态。
它不是一个「野生动物版 MOT 数据集」。区别在于:通用多目标跟踪数据集关心「这一帧里有几个目标、它们怎么移动」,身份只是内部编号;这里身份是外部给定的、跨视频段共享的、与毛皮图案一一对应的真实个体。8 只狗在两个机位、8 段视频里始终是这 8 个 ID,这才是它区别于其他视频集的地方。
1.1 为什么野生动物数据会进 AI-Ready 版图
本站此前没有任何一条野生动物、相机陷阱或保护生物学方向的数据。查库确认过一次:按 %wild%、%animal%、%camera-trap%、%conservation%、%wildlife% 五个模式检索,只命中一条 rex-in-the-wild(rid 731),而那是哈佛 Rajpurkar 组的医学照片理解基准——「in the wild」在这里指的是「普通相机拍的非标准医学照片」,与野生动物无关。也就是说,这个方向在库内是真正的空白,不是稀疏。
空白不等于值得填。这份数据能进版图,靠的是三件在别处很难同时凑齐的事:
第一,它把三个任务挂在同一个键上。 检测给出框,跟踪给出一段视频内的连续轨迹,身份给出跨视频段的同一只狗,行为给出这一帧它在做什么。四者共用一套帧号与个体 ID,所以「这只狗在这个机位被框住、在那个机位被认出、它在两个机位里做的是同一件事」这句话是可验证的。多数数据集只能验证其中一两句。
第二,它的「难」是结构性的难,不是数据量堆出来的难。 地面广角与无人机俯视之间不存在共同的地面平面,做不了单应变换,也就不存在「先配准再匹配」这条捷径。这个约束会逼着方法去处理真正的跨视角表征问题,而不是绕过去。
第三,它的规模小到可以整份看完。 8 段视频意味着一天能把全部素材过一遍,建立起对数据的主观判断。在一个还要申请才能拿到的数据集上谈「AI-Ready」,凭的不是规模,而是结构模板——一套把多视角、个体身份、行为谱三层对齐的标注范式。范式可以被复制到更大的采集上,规模不能。
1.2 三层标注的读法
这份数据的标注不是并列的四个标签,而是三个逐层收紧的层次。理解这个次序,是理解全文结构的前提。
| 层 | 回答什么问题 | 覆盖范围 | 缺失时会怎样 |
|---|---|---|---|
| 检测层 | 这一帧里狗在哪 | 8 段全覆盖 | 连目标都定位不到,后面两层无从谈起 |
| 跟踪层 | 这段视频里哪几帧是同一只 | 8 段全覆盖 | 只能做逐帧分类,无法做行为片段切分 |
| 身份层 | 这只狗是 8 只里的哪一只 | 3 段 | 跨视角、跨视频段的对照全部断裂 |
| 行为层 | 这一帧它在做什么 | 3 段 | 只能做「有没有狗」,做不了行为理解 |
这个结构有一个直接后果:能用满四层的只有 3 段,能用两层的才是 8 段。任何声称「在全部 8 段上做行为识别」的说法,都要先解释另外 5 段的行为标签从哪来。
三层之所以分开讲,是因为它们对应三类使用者:做检测与跟踪的关心前两层,做重识别的关心第三层,做行为识别的关心第四层。混成一张字段表,三类人就都读不到自己要的那一段。
1.3 三十秒决策卡
| 你的处境 | 这份数据能帮你什么 |
|---|---|
| 在做跨视角重识别,缺「同一批个体、两套拍摄几何」的对照素材 | 8 只个体 × 2 类视角,是目前少见的干净对照 |
| 在多目标跟踪,想测尺度剧变下的 ID 保持能力 | 地面近景与无人机远景的尺度差可达一个数量级 |
| 做小样本行为识别的方法学研究,需要「类别少、样本少、但有真值」的场景 | 8 只 × 9 类,极端小样本的天然试验台 |
| 想验证自己的行为谱标注工具链 | 随附匿名代码仓 etho-tools,指向的正是标注工具 |
| 需要一份能整份看完、建立直觉的视频数据集 | 8 段,一天可以过完 |
| 想找一份能直接下载、立刻开跑的数据 | 拿不到,记录是受限访问 |
| 需要野生动物种群层面的统计结论 | 8 只个体不构成种群样本 |
| 要训练通用动物检测器 | 单一物种、8 个固定机位,域窄到几乎不能泛化 |
前四行是「能」,后三行是「不能」。这份数据的边界比它的规模更值得记住。
1.4 不适合谁
如果你的需求是「找一批野生动物图片训检测器」,这份数据给不了你。 8 段视频、单一物种、8 个固定机位,训练出来的模型换个机位就会掉得很厉害。真正的通用动物检测要走相机陷阱的大规模图库路线,那是另一个量级的东西。
如果你的需求是「保护区巡护的自动预警」,这份数据也不适用。 The Wilds 是大围栏保护中心,画面里没有偷猎者、没有车辆、没有夜间红外,而巡护系统真正要处理的是这些。
如果你的需求是「行为学的定量结论」,要格外小心。 8 只圈养个体的行为谱,不能直接当作野生种群的参数。圈养环境里狩猎、长距离迁移、领地巡逻这些行为在结构上就不会出现,行为谱的第 9 类里有没有它们,官方没有说。
如果你需要立刻能跑的数据,这份记录在当下就是不合适的。 受限访问意味着你得先走授权流程,而授权方的身份在双盲期间是隐藏的。
§2 数据构成与规格
2.1 只有五个数字是确证的
这份记录的元数据极简:一段 200 词左右的描述,加上标题、关键词、许可、版本号。所有能确证的规模数字只有五个。
| 指标 | 数值 | 出处 |
|---|---|---|
| 原始视频段数 | 8 | 官方描述原文 “Eight raw videos are included” |
| 可识别个体数 | 8 | 官方描述原文 “eight individually identifiable African wild dogs” |
| 行为谱类别数 | 9 | 官方描述原文 “a 9-category behavioral ethogram” |
| 行为与身份标注条数 | 161,398 | 官方描述原文的括号内数字 |
| 带行为谱的段数 | 3 | 官方描述原文 “three are additionally annotated” |
除此之外的一切都是空白:没有逐段时长,没有分辨率与帧率,没有文件格式,没有总体积,没有标注文件的字段说明,没有训练/验证/测试划分。这些不是「没查到」,是记录本身没有公开——受限访问状态下,Zenodo 的 files 数组返回为空,文件清单接口直接回 403。
这件事必须写清楚,因为它决定了整篇的写法:任何以「下载后统计得到」为口吻的描述都是编的。下文所有推算都会标出依据。
2.2 八段视频与两种视角
8 段视频由两类设备产生,但官方没有披露逐段的视角归属。也就是说,我们不知道 8 段里有几段来自固定机位、几段来自无人机,也不知道那 3 段带行为谱的视频分别属于哪一类。
这是文档层面最大的缺口,因为它直接决定一个关键问题:带行为谱的 3 段是否覆盖了两种视角? 若分别来自两类设备,跨视角的同一只狗就有标注支撑,可以直接做「同一身份在不同视角下的行为一致性」研究;若全部来自同一类设备,跨视角只能靠检测与跟踪层勉强支撑,行为层的对照就落空了。两种情况的差别足以决定一个选题是否成立,而当前公开信息无法判断。
| 维度 | 已知 | 未知 |
|---|---|---|
| 段数 | 8 | 逐段时长、逐段帧率 |
| 视角类型 | 固定机位(GoPro 7/11)+ 无人机 | 每种视角各几段 |
| 行为谱覆盖 | 3 段 | 这 3 段属于哪种视角 |
| 检测与跟踪 | 8 段全覆盖 | 每段的框数、轨迹数 |
| 空间分辨率 | 未披露 | 是否统一 |
| 画面尺寸 | 未披露 | 是否裁切、是否统一缩放 |
| 时间跨度 | 2024 年 4 至 5 月 | 8 段的拍摄日分布 |
这张表右列的空白,构成了使用这份数据时最先要问的问题清单。实际拿到数据后的第一件事,不是跑模型,是把这张表填满。
2.3 三层标注的分布,以及一个极易误读的括号
官方那句描述值得逐字拆开:
Eight raw videos are included: all eight have frame-level bounding-box
detection and tracking annotations; three are additionally annotated
with a 9-category behavioral ethogram and individual identity labels
(161,398 frame-level annotations).
分号把句子切成两截。前半截说「8 段都有框与跟踪」,后半截说「其中 3 段另外有行为谱与身份」,括号里的那个数字紧跟在后半截之后。
从语法上讲,这个数字修饰的是后半截——也就是那 3 段的行为与身份标注。从量级上讲,这个解释也更合理:假如这个数字是 8 段的框标注总量,那么平均每段只有约 2 万条框,对一段几分钟的视频来说偏少;而作为 3 段「每帧每只狗一条行为标签 + 一条身份标签」的总量,则完全说得通(见 §5.3 的推算)。
所以正确的读法是:
| 标注层 | 覆盖段数 | 条数 |
|---|---|---|
| 边界框检测 | 8 | 未披露 |
| 跟踪轨迹 | 8 | 未披露(以轨迹条数计,非帧级条数) |
| 行为类别 | 3 | 与身份层合计 16.1 万 |
| 个体身份 | 3 | 与行为层合计 16.1 万 |
把它当成「全库标注量」,会同时犯两个错:高估了覆盖范围(8 段 vs 3 段),也误解了标注的含义(框 vs 行为标签)。这是这份数据最容易被引用错的一个数字。
2.4 一条帧级标注该长什么样
官方没有公布标注文件的字段结构。下面这张表分两部分:前三行是官方描述里能确证存在的语义,其余是这类任务在工程上必需的字段,属于「应当存在但未见于公开元数据」。
| 字段 | 语义 | 状态 |
|---|---|---|
| frame_id | 帧序号,标注的时间基准 | 必然存在(帧级标注的前提) |
| bbox | 边界框,通常为 x, y, w, h | 官方明确有检测标注 |
| track_id | 段内轨迹编号 | 官方明确有跟踪标注 |
| identity | 8 只个体之一的身份标签 | 官方明确有身份标注(仅 3 段) |
| behavior | 9 类行为之一的类别标签 | 官方明确有行为谱(仅 3 段) |
| video_id | 所属视频段 | 必然存在(多段数据的组织前提) |
| occlusion / truncation | 遮挡与截断标志 | 未确认 |
| confidence | 标注置信度或难度标记 | 未确认 |
一条记录在语义上大致是这句话:在第 3 段的第 1,204 帧,个体 ID 为 5 的那只狗位于框 (x, y, w, h) 内,正在做第 7 类行为,轨迹编号为 12。 框喂检测器,轨迹喂跟踪器,身份喂重识别,行为喂分类器,四者共用 frame_id 与 video_id,「联合任务」才成立。
需要提醒的是轨迹编号与身份不是一回事:轨迹号通常只在单段内有效,狗走出画面再回来可能拿到新号;身份是全局的,8 只的 ID 跨段不变。两者混用会在跨段评估时产生大量假阴性。
2.5 与同类资源的定位差异
野生动物视频这个方向上,公开资源大致分三类。这份数据站在第三类里,且站得很靠边。
| 类型 | 典型形态 | 标注粒度 | 与这份数据的差别 |
|---|---|---|---|
| 相机陷阱图库 | 大量定点红外照片/短视频 | 物种级框(动物/人/车) | 只回答「有没有动物、是什么物种」,不区分个体 |
| 动物姿态与行为视频 | 单视角、多为室内或动物园 | 关键点或行为片段 | 有行为、无身份,也无跨视角 |
| 多相机阵列 | 演播室式同步多机位 | 三维姿态或同步框 | 几何可标定,与本文的「不可标定」正相反 |
| WildDog-Videos | 地面固定机位 + 无人机,8 只个体 | 框 + 轨迹 + 身份 + 行为 | 唯一同时给出跨视角与跨段身份的一类 |
第一类解决的是「筛」的问题——把海量红外照片粗分成动物、人、车,个体身份不在它的目标里。第二类的行为标注通常以片段为单位(这段 30 秒在打斗),逐帧标注贵一个量级,但换来行为转换时刻的精确性,这份数据给的是帧级。第三类的几何条件最好,相机位置精确已知、可标定与三角化,而这份恰恰相反:没有共同地面平面,也没有标定参数。这个区别不是缺陷,而是价值来源——真实野外观测就是这个条件。
§3 身份层:斑点就是指纹
3.1 为什么偏偏是非洲野犬
非洲野犬的毛皮是犬科里最特殊的一种:黑、褐、黄白三色斑驳,没有两只个体的图案完全相同,而且图案终身稳定。这个特征在野外研究里被用了很多年——识别个体不靠项圈、不靠芯片,靠拍一张侧面照比对花纹。
IUCN 红色名录把 Lycaon pictus 列为濒危。它的社会结构也特殊:群体合作育幼、集体狩猎、极低的繁殖成功率。这些特征使得「知道每一只谁是谁」在保护生物学里不是锦上添花,而是必需品——群体构成、个体分工、扩散事件,全都建立在个体识别之上。
于是这份数据的身份标注就有了一层额外意义:它把野外研究者手工做的事,变成了机器可学的问题。手工比对花纹一次只能处理几百张照片,而视频是每秒几十帧。
3.2 一个外部实证:同一物种,两个种群,差距 26 个百分点
个体重识别在非洲野犬上不是没人做过,而且做出来的结果很能说明问题。
de Lorm 等人在 2023 年发表的一项研究,比较了三种常用个体识别软件(Hotspotter、I3S-Pattern、WildID)在非洲野犬上的表现。结论有两条:Hotspotter 在三种软件里表现最好;但它的匹配准确率在两个种群之间差得很远——津巴布韦种群 88%,肯尼亚种群只有 62%。
这个 26 个百分点的落差,原因是两个种群的毛皮图案本身的可辨性不同。有的种群图案对比强烈、斑块边界清晰;有的种群整体偏暗、斑块细碎,个体间差异小。
这个结果对理解本文这份数据有三重意义。一是「这个物种适合做重识别」是个不严谨的说法——适合与否取决于具体种群,而 The Wilds 这 8 只属于哪一类,官方没有描述,也没有公开样本图。二是它给出了现实的性能锚点:成熟算法在难种群上只有 62%,那么在一个 8 只、圈养近缘的子集上,任何「接近满分」的识别率都要先怀疑任务太简单。三是它指明了这份数据该用来做什么:不是刷高准确率,而是测「在难样本上的退化」。
3.3 身份层的三条硬约束
身份标注看着只是一个整数标签,实际用起来有三条约束必须提前想清楚。
约束一:8 类是封闭集,不是开放集。 模型只能从 8 个候选里选一个;来了一只第 9 只狗,它必然会错分到 8 个之一,而且会给一个很高的置信度。野生场景需要的恰恰是开放集——判「不认识」比判「是谁」更重要。这份数据无法评测「拒识」能力,因为没有负样本。
约束二:身份是跨段的,轨迹是段内的。 8 段视频里出现的是同一批 8 只狗,这个设定让「跨段重识别」成为可能:用第 1 段做 gallery,第 5 段做 probe。但如果某段视频里只出现了 6 只,那么剩下 2 只在该段就是「未出现」而不是「标签缺失」,这两种情况在评测时的处理方式完全不同。
约束三:圈养群体降低了类间差异。 8 只长期共处的个体,很可能来自少数几个 bloodline。近缘个体的花纹相似度更高,这会同时抬高「类内差异」和压低「类间差异」——两个方向都让识别变难,但也让「在难样本上仍然能分开」这件事变得更有说服力。
3.4 8 只个体做重识别的真实含义
把「8 只」这个数字放到任务定义里,会得到一个有点反直觉的结论:它足够做方法验证,远远不够做能力证明。
| 任务设定 | 8 只个体下的可行性 |
|---|---|
| Closed-set 分类(8 选 1) | 可行,但天花板很低,随便一个 CNN 就能到很高 |
| Open-set 识别(含拒识) | 不可行,无未知类样本 |
| 跨视角 gallery/probe 检索 | 可行,前提是那 3 段覆盖两种视角 |
| 跨时段重识别 | 可行,若 8 段的拍摄日分布足够散 |
| 个体级行为差异分析 | 勉强可行,每只狗的样本量太小 |
| 种群密度估计 | 不可行,采样设计与个体数都不支持 |
最值得说的是第四行。若 8 段集中在两三天内拍完,「跨时段」实际只是「跨几小时」,毛皮图案几乎不变,重识别成了送分题——真正的跨时段要处理换毛、污渍与季节光照,而这些在 4 至 5 月的两周窗口里都不会出现。
所以「规模小」在这里不是体量问题,而是结论强度问题:8 只狗、两周窗口、一处场地,能支撑「这个方法在这个条件下有效」,撑不起「这个方法是物种层面的通解」。
§4 视角层:两种几何,无法配准
4.1 固定机位与无人机的差别,不只是「远近」
两类设备的差异是四重的,每一重都会独立地破坏模型。
| 差异 | 固定机位(GoPro 7/11) | 无人机(DJI,型号未披露) |
|---|---|---|
| 俯角 | 接近水平,常见略俯 10–30 度 | 接近垂直俯视,或 45–60 度斜俯 |
| 主体尺度 | 大,狗可占画面高度的相当比例 | 小,狗在画面里往往是几十像素的斑块 |
| 镜头畸变 | 广角,边缘桶形畸变明显 | 视场较窄,畸变相对小但仍有 |
| 运动模糊 | 前景狗动、背景静,模糊方向单一 | 整幅画面随飞行器轻微位移,模糊全屏 |
| 遮挡来源 | 草丛、地形起伏、同伴身体 | 树冠、围栏阴影、同伴重叠 |
| 可用时长 | 电池与存储限制下的长时录制 | 单次飞行 20–30 分钟量级,受空域与电量双重限制 |
第三行的畸变值得单独说。GoPro 的广角在画面边缘会把直线拉弯,同一只狗走到画面角落时,它的形状会被拉伸;而检测器如果在画面中心训练得好,到边缘就会掉。这一点在固定机位数据集里是常见陷阱,而这份数据的 8 段全部来自广角或无人机,两种畸变模式并存。
4.2 尺度差的量级估算
官方没有给分辨率,也没有给飞行高度。这里做一个量级估算,只为说明「差多少」,不作为数据事实。
假设 GoPro 按 4K 广角录制、狗距离机位 5 至 10 米,一只成年非洲野犬肩高约 0.75 米、体长约 1 米,在画面里可能占到高度的五分之一到三分之一。再假设无人机在 30 至 50 米高度作业、俯视拍摄,同样的 1 米体长在 4K 画面里可能只对应几十个像素。
两者一比,同一只狗在两路画面里的像素尺度可以差一个数量级。后果很具体:小目标召回率天然低,无人机画面里的狗容易漏;目标只有几十像素时,相邻两帧位移可能就占了目标尺寸一大半,IOU 匹配失效;重识别几乎没有花纹细节可用,只能靠体型、姿态与群体上下文;行为标注也分不出「嗅闻」与「站立」。
最后一条是这份数据最该在文档里说明、却没有说明的地方:9 类行为谱在两个视角下的可判定性是否一致? 如果无人机画面里的狗太小,标注员只能靠群体运动推断行为,同一类标签在两个视角下的语义强度就不同,混训会引入系统性噪声。
4.3 为什么不能像多相机阵列那样做几何对齐
这是本文最硬的一条技术判断,值得展开。
多相机阵列(比如演播室里的几十台相机)之所以能做三维重建,靠的是两条:相机内外参可标定,且相邻相机之间存在足够的共视区域与共同特征点。有了这两条,就能算出相机之间的旋转与平移,把不同视角的像素映射到同一个坐标系。
固定机位与无人机之间,这两条都不成立:
- 没有标定参数。 无人机是移动平台,每个航段的位姿都不同,而数据里没有提供任何位姿或 GPS/IMU 记录。
- 没有共同地面平面。 单应变换(homography)成立的前提是所有感兴趣点位于同一平面。地面相机看到的是侧视的狗,无人机看到的是俯视的狗和地面——狗本身不是平面,地面在侧视里又几乎退化成一条线。
- 没有时间同步。 两类设备的时钟独立,元数据里没有任何同步信息。即便画面里能对上「同一时刻」,也是靠行为事件反推,精度到不了帧。
所以跨视角对齐只能走语义路线而不是几何路线:不靠坐标变换,靠「这是同一只狗」这个判断本身。这也是为什么身份层在这份数据里如此关键——身份是唯一的跨视角对应关系。
4.4 一个贯穿全文的场景:同一只狗的两副面孔
设想第 5 号个体。在地面机位的画面里,它从左下角入画,占画面高度约四分之一,三色斑块清晰,能看见左肩那块形状像逗号的深褐斑;它低头嗅地面,然后小跑出画,全程约 40 帧。
同一时段,无人机在 40 米高度俯视同一片围栏。画面里能看见七八个移动的小色块,其中一个的轨迹与地面机位的入画方向吻合。它的尺寸只有几十像素,颜色被压缩成一团模糊的赭黄,肩部斑块完全不可辨;它的形状因为俯视而变成一个短棒,四条腿只在迈步的瞬间分开。
要把这两段画面判为「同一只狗」,能用的证据只剩三条:出现与消失的时间窗吻合、运动方向连续、以及它与相邻个体的相对位置关系一致。斑块匹配在这里完全失效。
这个场景说明三件事:跨视角重识别在这份数据上不是「花纹匹配」问题,而是「时空上下文约束下的关联」问题;检测与跟踪的质量直接决定身份能否跨视角——无人机画面里那只狗若在第 30 帧漏检,关联就断了;8 只的封闭集在这里反而是优势,候选只有 8 个,外观证据再弱也能靠时空约束收敛,换成开放集则几乎无解。
WildDog-Videos 的价值很大程度压在这个场景上:它提供了一个外观证据会失效、但真值存在的跨视角对照。这种对照在实验室里造不出来,因为实验室不会让一只狗同时被地面相机与无人机以如此不同的几何拍到。
§5 行为层与取数:9 类、小样本、要申请
5.1 9 类行为谱,官方只给了数字
这是本次核查最需要如实交代的一点:官方公开的元数据里只有「9-category behavioral ethogram」这一个说法,没有任何一处列出这 9 类的名称。
我尝试过的路径包括:Zenodo 记录的 API 元数据(完整取回,无类别名)、记录页 HTML(被站点限流拦截)、文件清单接口(403,受限记录不返回)、匿名代码仓 etho-tools(返回空)、以及公开检索(未检出与该数据集相关的论文或预印本)。结论是:在 2026 年 10 月 29 日这个时点,9 类的具体名称不对公开渠道开放。
这件事的处理方式只有一种:不猜。 编一份看起来合理的 9 类清单,会让后面所有引用它的文章跟着错。
能说的只有三件有据可查的事:
第一,「9 类」这个数字本身是可靠的,它出现在官方描述里,且与「16.1 万条帧级标注」并列,属于作者主动披露的核心参数。
第二,行为谱有成熟的方法学传统。 一份 ethogram 由「行为目录 + 每类的操作定义 + 采样规则」组成,类别数从 6 到 20 不等。太细则一致性差,太粗则丢信息,9 类属中等粒度。
第三,可以给出文献里野犬行为谱的常见类目作为参照,但必须标明那不是本数据集的清单。 公开文献中对非洲野犬(含圈养群体)的行为谱,通常覆盖这几组:休息与睡眠、站立与警戒、行走与小跑、奔跑、进食与饮水、嗅闻与标记、自我修饰、社会亲昵(相互理毛、蹭脸)、游戏(追逐、扑咬)、攻击与对峙、发声。把这些归并成 9 类,是一个合理的粒度,但具体怎么归并,只有作者知道。
5.2 小样本 + 长尾:8 × 9 = 72 个格子
把 8 只个体和 9 类行为摆成一个矩阵,得到 72 个格子。16.1 万条标注撒进这 72 个格子里,看似不少,实际分布会极端不均。
| 情形 | 后果 |
|---|---|
| 休息类占大头 | 可能一半以上的帧是「趴着」,模型只要全predict休息就能拿到很高的帧级准确率 |
| 稀有行为只有几十帧 | 攻击、交配、育幼这类行为在两周窗口里可能只出现几次,无法训练也无法评估 |
| 某些个体缺少某些行为 | 8 只狗的社会角色不同(优势个体与从属个体),行为分布天然不同,某些格子直接为空 |
| 行为共现 | 一只狗可能同时「行走」与「嗅闻」,单标签体系会丢信息 |
第一行是这类数据集最经典的陷阱:帧级准确率会被多数类吃掉。一份 80% 的帧是休息的数据集,一个永远输出「休息」的分类器就能到 80%。评估必须用按类召回、宏平均 F1,或按行为片段而非帧来评。
第三行则决定「个体级分析」能不能做。若优势个体承担了大部分社会行为的发起,按个体切分训练/测试就会造成严重泄漏——模型学到的是「这只狗爱打架」,而不是「什么姿态预示打架」。
5.3 从 16.1 万反推视频长度
这是一个能做、且能自证的推算,前提写在这里:3 段里每帧为每只出现的狗记一条,行为与身份合并计数,即一条记录对应「一帧一只狗」;若 8 只都在画面内,则每帧 8 条。
| 推算步骤 | 结果 |
|---|---|
| 3 段合计帧级记录 | 161,398 |
| 若平均每帧 8 条(8 只全在画面) | 约 20,175 帧/段 |
| 若平均每帧 4 条(半数在画面) | 约 40,350 帧/段 |
| 按 25 fps 折算、每帧 8 条 | 每段约 13.5 分钟 |
| 按 25 fps 折算、每帧 4 条 | 每段约 26.9 分钟 |
| 按 30 fps 折算、每帧 8 条 | 每段约 11.2 分钟 |
也就是说,这 3 段的每段时长大概率在十分钟量级,而不是几十秒的片段。用途有二:估计下载体积(十分钟的 4K 视频约几个 GB 量级),以及判断行为长尾的严重程度(十分钟里能观察到的稀有行为非常有限)。必须强调这是推算而非官方数据;若标注实际按「行为片段」记录,整套推算不成立——但从「frame-level annotations」这个措辞看,按帧记录的可能性更大。
推算过程可以复算,改一个假设就能看到结果怎么变:
#-- 复算上表:标注条数 → 每段帧数 → 每段分钟数,两根轴分别是每帧目标数与帧率
TOTAL = 161_398          # 3 段的行为与身份标注合计
for per_frame in (8, 4):          # 8 只全在画面 / 半数在画面
    frames_per_seg = TOTAL / per_frame / 3
    for fps in (25, 30):
        print(f"每帧 {per_frame} 条, {fps} fps -> 每段 {frames_per_seg/fps/60:5.1f} 分钟")
把 per_frame 从 8 改成 2(极少几只同时在画面),每段时长会翻到 40 分钟量级——这说明这个推算对「每帧目标数」这个未知量极其敏感,它给出的只是量级,不是定值。
5.4 受限访问意味着什么,以及怎么走
Zenodo 的访问级别有四档:open、restricted、closed、embargoed。这份记录是 restricted,含义是:元数据(标题、描述、作者、许可、DOI)完全公开可读,但文件需要记录持有者授权后才能下载。
这个状态与「已经下线」是两件不同的事。记录是 published 状态,DOI 已注册且可解析,统计里有浏览与下载计数(说明授权通道是通的)。所以它不是失效数据,是门禁数据。
实际影响有四条:无法核对文件格式与体积;无法验证标注质量(一致性、漏标率、框的紧密度全无从判断);授权方身份在双盲期间不可见——creators 写的是 “Anonymous, Anonymous”,机构字段为空,你甚至不知道该向谁申请;以及最容易混淆的一条,许可与准入是两件事。license 标 CC BY 4.0 说的是「拿到之后能怎么用」,准入说的是「能不能拿到」,两者不能互相替代。
要拿到数据,路径只有一条:走 Zenodo 记录页的「Request access」通道,说明用途与身份;待论文发表、作者信息公开后才真正可操作。在那之前,能做的只有读元数据、读代码仓、以及等。
5.5 用 API 把能拿到的元数据全部取回
受限记录虽然不给文件,但元数据接口是开放的。下面这段脚本把能确证的信息一次性取回并结构化,用于核对本文引用的每个数字。
#-- 取回受限记录的完整元数据(文件数组为空,属预期)
curl -sL "https://zenodo.org/api/records/21083480" -o wilddog.json

#-- 逐项打印本文引用的字段,便于与正文对照
python3 - <<'PY'
import json
d = json.load(open("wilddog.json"))
m = d["metadata"]
print("标题      :", m["title"])
print("版本      :", m["version"])
print("发布日期  :", m["publication_date"])
print("许可      :", m["license"]["id"])
print("作者      :", [c["name"] for c in m["creators"]])
print("关键词    :", ", ".join(m["keywords"]))
print("代码仓    :", m.get("custom", {}).get("code:codeRepository"))
print("文件数    :", len(d.get("files", [])))          # 受限记录为 0
print("记录状态  :", d.get("status"))
print("访问级别  :", m.get("access_right"))
PY
这段代码的价值不在技术含量,而在可复现:任何人跑一遍,都能得到与本文相同的五个数字,并亲眼看到 files 长度为 0。对一个受限记录来说,「证明它确实受限」本身就是核查的一部分。
反过来,下面这段是跑不通的,写出来是为了说明边界:
#-- 受限记录的文件清单接口会直接回 403,不要用它判断数据集是否失效
curl -s -o /dev/null -w "%{http_code}\n" \
  "https://zenodo.org/api/records/21083480/files"
#-- 预期输出 403,属访问控制而非下线
把 403 读成「数据集没了」是一个真实会发生的误判。状态字段 status: published 才是判断存活与否的依据。
§6 与库内既有条目的关系
6.1 关系图谱
库内与「活体动物」沾边的数据,此前只有两类:一类是兽医学,把犬猫当作临床对象;一类是跨物种病理,把动物当作人类疾病的模型。野生动物作为观测对象这一格,是空的。rex-in-the-wild(rid 731)名字里带 wild,但那是医学照片基准,「in the wild」修饰的是拍摄条件而非物种。
所以这份数据在库内的位置不是「补一个同类」,而是「开一个方向」。它的邻居不是野生动物数据集,而是那些同样处理「跨视角」「跨个体」「小样本」问题的条目。
6.2 分工说明
| 库内数据集 | 与它的分工 | 边界提醒 |
|---|---|---|
| gbif(rid 1346) | GBIF 回答「某物种在某时某地被见过」,这份数据回答「这一只在这一帧做了什么」 | 一个是出现记录的聚合,一个是单一个体的深描;GBIF 的 8 只狗只会是 8 条坐标点,没有行为 |
| eurosat(rid 1781) | 都涉及「同一片地表的不同拍摄」,EuroSAT 的教训是地理泄漏 | 那份数据的泄漏来自瓦片空间相邻,这份的泄漏来自同一只狗跨段出现;两者的划分纪律可以互借 |
| plantvillage(rid 1782) | 都是「受控环境下的生物对象」影像,都有背景单一的问题 | 叶片数据集可以靠换背景增强,狗不能——换背景等于换了拍摄几何 |
| oppd(rid 1784) | 都是细粒度、小样本、类别不均衡的分类问题 | 杂草的类间差异是形态学的,狗的类间差异是花纹的,后者的类内差异更大 |
| icdc-glioma(rid 1734) | 都是跨物种视角:那份把犬的自发肿瘤当人类模型 | 那份的价值在「自然发病」,这份的价值在「多视角同一性」,两条路不交叉 |
| veterinary-vitals-anesthesia(rid 1789) | 都是犬,都在兽医/保护机构场景内采集 | 那份是术中生理信号、无个体标识;这份恰恰以个体标识为核心 |
| overture-maps(rid 1786) | 都涉及「许可与准入分离」的问题 | 那份是多个许可拼在一起,这份是单一许可加一道门禁;两种复杂度不同 |
| aqs(rid 1755) | 都是「固定站点 + 长期观测」的网络型数据 | 空气质量站是标定过的固定点,这份的无人机是移动且未标定的平台 |
| rex-in-the-wild(rid 731) | 仅名字相近,实质无关 | 检索 %wild% 会误命中,判断依据要看物种而不是词形 |
6.3 检索路径建议
按需求走三条线:
- 要物种分布与出现记录,去 GBIF;要单一个体的行为序列,只有这一份。
- 要犬的临床与生理,去兽医麻醉库与犬胶质瘤集;要犬的行为与身份,只有这一份。
- 要小样本细粒度分类的方法参照,去看植物病害与苗圃杂草两条;要跨视角的对照,只有这一份。
三条线之间没有合并的合理路径。原因很直接:它们连「观测单元」都对不上——GBIF 的单元是「一次出现」,兽医库的单元是「一次麻醉」,这份数据的单元是「一帧一只狗」。
§7 质量评估与局限性
7.0 阅读本节前需要知道的一件事
评估这份数据时,最容易发生的框架错位有两个,方向相反。
第一种错位是拿「规模」当尺子。 8 段、8 只,在任何「数据量越大越好」的评比里都排在末位。但规模尺子量的是「能不能训出一个泛化模型」,而这份数据想回答的是「跨视角的同一性能不能被建模」。后一个问题不需要大数据,需要的是干净对照——同一批个体、两类几何、身份已知。用规模尺子量它,等于用体重秤量身高。
第二种错位是拿「可及性」当尺子。 记录受限、作者匿名、文件拿不到,很容易被读成「这数据不存在」或「这数据有问题」。但受限访问在野生动物领域是常态:精确位置与个体身份对濒危物种是敏感信息,不少同类数据集都选择模糊化或分级授权。真正该警惕的不是「受限」,而是「受限且文档缺失」——后者这份记录确实有。
把两件事分开之后,才能看清它真实的质量水平:结构设计是好的,文档完整性是不足的,可验证性是零的。
7.1 DAIMS 视角下的判定
DAIMS(Data and AI Maturity 评估框架)用一组维度判断数据在 AI 流程中的成熟度。逐项落到这份记录上,画像很不均匀:
| 维度 | 判定 | 依据 |
|---|---|---|
| 可发现性 | 良好 | 有 DOI、有 Zenodo 固定入口、有概念 DOI 指向版本谱系 |
| 可访问性 | 差 | restricted,文件不可下载,需授权且授权方匿名 |
| 文档完整性 | 差 | 无格式说明、无字段字典、无逐段清单、无划分建议 |
| 元数据粒度 | 中等 | 段级与个体级参数齐,帧级与文件级全缺 |
| 标识与关联 | 好 | 个体 ID 跨段共享,这是它最强的一项 |
| 标签与监督信号 | 好 | 四层标签(框/轨迹/身份/行为)同源,覆盖 3 至 8 段 |
| 机器可读性 | 未知 | 标注格式未公布,无法判断是否需要专用解析器 |
| 可复现性 | 差 | 他人无法下载,复现依赖授权;作者匿名使引用不可追溯 |
| 伦理与合规 | 良好 | 明确声明不含人类主体,濒危物种信息控制得当 |
| 版本管理 | 中等 | 有版本号 1.0.0-review,但仅一个版本,无变更记录 |
十项里三项好、三项差、一项未知。这个分布说明它是一份设计成熟、交付未完成的数据:标注体系想清楚了,发布工程没做完。
最值得注意的是「可复现性」这一项。DAIMS 里这一项通常被理解成「别人能不能重跑你的实验」,而在这份数据上它退化成了「别人能不能拿到数据」。当可复现性依赖于一个匿名持有者的授权意愿时,它就不再是技术属性,而是社会属性。
7.2 逐条局限
| 局限 | 具体表现 | 应对 |
|---|---|---|
| 无法获取文件 | restricted,files 为空,格式与体积未知 |
走 Request access;论文发表后再试 |
| 作者匿名 | creators 为 Anonymous,机构字段空 | 引用时只能引 DOI,不能引作者 |
| 行为类别名缺失 | 只有「9 类」这个数字 | 拿到数据后第一件事是把类别表抄下来 |
| 标注总量易误读 | 16.1 万只属于 3 段 | 引用时必须带上「仅 3 段」的限定 |
| 视角归属未披露 | 不知 3 段行为谱属于哪类设备 | 逐段检查画面几何后再设计跨视角任务 |
| 时间窗窄 | 仅 2024 年 4 至 5 月 | 不能做季节性、换毛期、年度对比 |
| 单一机构 | 全部来自 The Wilds | 结论外推到野生种群前必须加限定 |
| 圈养环境 | 大围栏、投喂与巡护人工安排 | 狩猎、迁移类行为结构性缺失 |
| 无划分建议 | 未给 train/val/test | 自建划分,且必须按段或按个体分组 |
| 无基线结果 | 未报告任何模型性能 | 无法判断方法好坏,只能自建基线 |
第九行值得展开:划分方式直接决定结论真假。按帧随机划分会让同一只狗、同一段视频同时进训练与测试,模型只需记住背景就能拿高分——这是泄漏,不是能力。按段划分是底线,按个体留出 1 至 2 只狗才能测出真泛化。
7.3 三个真实难点,逐个说清
野生动物数据进 AI 版图,不是把「猫狗识别」换个物种那么简单。这份数据把三个难点同时摆在了台面上。
难点一:个体重识别(Re-ID)——斑点既是线索也是陷阱。
非洲野犬的三色毛皮是个体识别的天然依据,野外研究用了它几十年。做成算法有三个具体问题。一是视角与姿态:花纹在侧面最清晰,正脸与背影几乎没有信息,而视频里的狗大部分时间不在侧身;地面机位能拍到侧面,无人机俯视只拍到背脊,而背脊恰是两侧图案的过渡带,辨识度最低。二是类间相似与类内差异失衡:8 只圈养个体可能来自相近血统,类间差异本就小,而同一只狗在不同光照、姿态、沾泥之后类内差异又大,两个方向同时挤压判别空间。三是评价指标的陷阱:closed-set 8 分类不允许「不认识」,准确率必然虚高;有意义的指标是 rank-k 检索与跨视角 rank-1,而若那 3 段全部来自同一类视角,跨视角 Re-ID 根本无法评估,只能做同视角的 upper bound。
难点二:多视角不一致——几何不可对齐,只能靠语义。
这一点在 §4.3 已论证:没有标定参数、没有共同平面、没有时间同步,单应变换不成立。连锁反应比想象中长。没有几何对齐,就做不了「先把两个视角的像素映射到同一坐标系再融合」的标准流程,替代方案只剩语义关联:靠时空连续性把两个视角的目标串起来,而关联精度依赖检测与跟踪质量。
更深一层是标注语义的可迁移性。同一个行为类别(比如「嗅闻」)在地面视角下靠头部低垂判断,无人机视角下根本看不见头部姿态,标注员只能靠身体朝向与移动模式推断。同一个标签在两个视角下的判定依据不同,噪声结构也不同;混在一起训练,模型学到的是「两个不同的任务」,而不是「一个任务的两个视角」。这一点在任何文档里都没有被讨论,是使用时最需要自己补上的分析。
难点三:小样本 + 长尾——8 只个体撑不起行为识别。
8 只个体、9 类行为、两周窗口,三个数字叠在一起,得到的样本结构是这样的:多数类(休息、站立)占绝对多数,少数类(攻击、育幼、交配)可能只有几十帧;某些个体根本不表现出某些行为;按个体切分后,每一折的类别分布都不一样。
在这样的结构上做监督学习,会遇到三重困难:
一是评估不稳定。测试集里稀有类只有十几帧,一次误判就能让该类召回率跳动十几个百分点。报告单一数字没有意义,必须给置信区间或逐类明细。
二是无法做个体独立评估。留一法在 8 只上可行,但每折只有 7 只训练、1 只测试,测试集行为分布与训练集差异极大,方差会很大。
三是预训练权重的诱惑。拿 ImageNet 或通用视频模型微调再报高准确率最省事,但这个准确率里有多少来自「狗的姿态先验」、多少来自「这个围栏的背景」,无法分离。要诚实就得做背景替换或跨段测试的对照。
三个难点的共同点是:都不是靠更多数据能解决的,而是靠更好的实验设计。这解释了为什么 8 段数据仍有存在价值——它逼着使用者把设计做对。
7.4 外部验证矩阵
| 验证方式 | 可行性 | 说明 |
|---|---|---|
| 与公开野犬重识别文献比准确率 | 有限 | 文献多为静态照片、野生种群,任务设定不同,只能比量级 |
| 用通用动物检测器做零样本基线 | 可行 | 可作为下限,但需注意广角畸变与俯视小目标 |
| 用通用视频模型做行为分类基线 | 可行 | 需报告按类召回,不能只报总体准确率 |
| 与相机陷阱数据集交叉验证 | 部分可行 | 域差异极大(红外 vs 可见光、定点 vs 航拍) |
| 与野生种群数据对照 | 不可行 | 无公开的同物种同任务野生视频集 |
| 用作者代码仓复现 | 待定 | etho-tools 仓在核查时不可访问 |
第二、三行是最该先做的:先跑一个通用基线,看「不针对这份数据做任何设计」能到多少,再决定要不要做专用方法。基线已经很高说明任务太简单,低得离谱说明域差太大。
§8 版本与生态
8.1 版本节奏
目前只有一个版本:1.0.0-review。版本号里的 review 后缀是作者自己加的,含义很明确——这是配合一篇正在双盲评审的论文发布的版本,评审结束后可能会变。
| 项 | 值 |
|---|---|
| 当前版本 | 1.0.0-review |
| 版本数 | 1(概念 DOI 下无其他版本) |
| 首次上传 | 2026-06-30(UTC) |
| 正式发布日 | 2026-07-01 |
| 变更记录 | 无 |
| 后续版本预告 | 官方说明:论文发表后补入作者、仓库与引用信息 |
这个状态意味着两件事。一是现在引用的任何细节都可能变:作者信息会补、仓库地址会从匿名换成正式地址、行为类别名可能会写进描述里。二是现在拿不到数据是设计的一部分,不是疏漏——双盲评审要求作者身份不可追溯,而 Zenodo 的授权申请会把申请人暴露给记录持有者,两者天然冲突。
8.2 生态位
它站在三个圈的交汇处,但每个圈里它都很边缘。
| 生态 | 它的位置 |
|---|---|
| 计算机视觉数据集 | 极小规模的领域数据集,价值在结构不在量 |
| 动物行为学 | 一份可复用的标注范式与工具链样本,不是行为学结论的来源 |
| 保护生物学 | 一个方法学试验,不是监测产品 |
| 开放数据基础设施 | 一个「受限 + 匿名」的极端案例,检验开放科学的边界 |
第四行值得留意:开放科学常假设「有 DOI = 可获取」,而这份记录是反例——DOI 已注册、记录已发布、许可写着 CC BY 4.0,但文件拿不到,作者也不知道是谁。它把「开放」拆成可发现、可引用、可获取三层,并证明三者可以彼此独立。
8.3 双盲脱敏的代价
作者栏写的是 “Anonymous, Anonymous”,机构为空,代码仓指向 anonymous.4open.science(一个专门为双盲评审提供匿名仓库的服务)。这套做法在 ML 会议里是标准流程,但用在数据发布上,代价比用在论文上大得多。
| 维度 | 论文匿名 | 数据匿名 |
|---|---|---|
| 影响范围 | 评审期内 | 评审期 + 数据被引用的全部时间 |
| 可追溯性 | 录用后即恢复 | 已发布的 DOI 无法回填作者 |
| 使用决策 | 评审人看内容 | 使用者要判断「这份数据可信吗」 |
| 授权通道 | 不需要 | 需要,但不知道向谁申请 |
第三行是关键。判断一份数据可不可信,常规依据是「谁做的、哪个机构、有没有过往工作」,这三条在匿名状态下全部失效,只剩「描述写得清不清楚」这一条。描述确实清楚——八个数字、两类设备、三层标注,一句废话没有——但这只能证明作者严谨,不能证明数据质量。
所以目前的信任只能建立在一个间接推理上:可核查的细节都对得上(段数、个体数、类别数、标注量与推算时长自洽、设备型号具体到 Hero 7 与 Hero 11)。这是弱证据,却是匿名状态下能拿到的最好证据。
8.4 它靠什么活着、为何能持续
一份 8 段视频的数据集,如果不维护,几年后就会变成一条「打不开的 DOI」。它能不能持续,取决于四件事。
第一,机构承载。 The Wilds 是一家持续运营的保护中心,隶属哥伦布动物园与水族馆体系,园区由 1980 年代退役的露天煤矿复垦而来。这意味着采集条件可重复:同一批围栏、同一套机位、同一群动物,明年还能再拍一轮。数据可以长大,这是最关键的一点。
第二,论文挂钩。 数据与一篇在审论文绑定,论文发表会带来引用与访问请求;反过来,若论文被拒,曝光度会大幅下降。这是它当前最大的单点风险。
第三,工具链外溢。 匿名代码仓叫 etho-tools,名字指向「行为谱工具」而不是「这份数据集的脚本」。若它真如名字所示是一套通用标注工具,价值就不依附于这 8 段视频——工具可以被别的物种复用,数据只是第一个用例。这是最健康的持续模式。
第四,许可的松绑空间。 CC BY 4.0 本身相当宽松,受限访问只是评审期的临时状态;一旦转开放,使用门槛会降到零,被引量也会有一波跳升。
四条里,第一与第三条是结构性的,第二与第四条是时点性的。结构性的那两条成立,它就不会消失;时点性的那两条决定它什么时候被看见。
§9 使用指引
9.1 三种角色的路径
| 角色 | 第一步 | 第二步 | 不要做 |
|---|---|---|---|
| 算法研究者(做 Re-ID) | 逐段确认视角归属 | 按段划分 gallery/probe,报告 rank-1 与 rank-5 | 不要做帧级随机划分 |
| 行为分析者 | 抄下 9 类的类别名与操作定义 | 统计每类的帧数与个体分布 | 不要只报总体准确率 |
| 数据工程 | 记录文件格式、体积、帧率 | 建立段-个体-行为的索引表 | 不要假设标注格式是 COCO |
第一行与第三行的差别,反映两种用法:一个把它当基准,一个把它当素材。前者关心可比性,后者关心可加工性。
9.2 拿到数据后先做的五项检查
在跑任何模型之前,这五项检查能把后续大半的坑提前排掉。
#-- 拿到数据后的五项前置检查(字段名按实际标注格式调整)
import json, collections

ann = json.load(open("annotations.json"))          # 官方格式未公布,先看结构
frames = ann["annotations"] if isinstance(ann, dict) else ann

#-- 1. 段数是否真是 8,每段的帧号范围是否连续
seg = collections.defaultdict(list)
for a in frames:
    seg[a["video_id"]].append(a["frame_id"])
for k in sorted(seg):
    ids = sorted(set(seg[k]))
    gaps = sum(1 for i in range(1, len(ids)) if ids[i] - ids[i-1] > 1)
    print(f"段 {k}: 帧数 {len(ids)}, 断点数 {gaps}")

#-- 2. 每段出现的个体集合,验证「8 只」是否每段都在
for k in sorted(seg):
    who = {a["identity"] for a in frames if a["video_id"] == k}
    print(f"段 {k}: 个体 {sorted(who)}")

#-- 3. 行为类别的实际取值与频次(这是唯一能确证 9 类名称的地方)
cnt = collections.Counter(a["behavior"] for a in frames if "behavior" in a)
print("行为类别数:", len(cnt))
for b, c in cnt.most_common():
    print(f"  {b}: {c} 帧 ({c/len(frames):.1%})")

#-- 4. 每帧的目标数分布,判断是否多目标同步标注
per_frame = collections.Counter((a["video_id"], a["frame_id"]) for a in frames)
print("每帧目标数: 最小", min(per_frame.values()), "最大", max(per_frame.values()))

#-- 5. 类别与个体的交叉表,找出空格子
cross = collections.Counter((a["identity"], a["behavior"]) for a in frames if "behavior" in a)
empty = [(i, b) for i in range(1, 9) for b in cnt if (i, b) not in cross]
print("空格子数:", len(empty), "(8 只 × 9 类 = 72 格)")
第三项是整段代码里最重要的一行:行为类别的实际取值,只能从标注文件里读出来。官方描述只给了「9 类」,没有给名字;跑完这段,才能把 9 个名字落实。
第五项的空格子统计,直接决定了「个体级行为分析」这个任务能不能做。如果 72 个格子里有 20 个是空的,那么任何按个体切分的交叉验证都会在测试集上遇到训练时从未见过的组合。
9.3 一个最小可用的评估流程
拿到数据后,一个诚实的基线应该长这样:
#-- 最小基线:按段划分 + 按类召回,避免帧级随机划分的泄漏
import numpy as np
from sklearn.metrics import classification_report

SEGMENTS = [f"seg{i:02d}" for i in range(1, 9)]
TRAIN, TEST = SEGMENTS[:5], SEGMENTS[5:]        # 按段划分,不按帧

#-- 训练:只用带行为标签的段,若 3 段中有 2 段落在 TRAIN 内才成立
train_segs = [s for s in TRAIN if s in ANNOTATED_SEGMENTS]
test_segs  = [s for s in TEST  if s in ANNOTATED_SEGMENTS]
assert train_segs and test_segs, "行为标签段太少,无法按段划分——只能退化为留一个体"

y_true, y_pred = [], []
for s in test_segs:
    for frame in load_frames(s):
        y_true.append(frame.behavior)
        y_pred.append(model.predict(frame.image))

#-- 关键:报告宏平均,而不是总体准确率
print(classification_report(y_true, y_pred, zero_division=0))
print("宏平均 F1:", f1_score(y_true, y_pred, average="macro"))
这段代码里有两个刻意的设计。一是 assert:如果带行为标签的 3 段不足以分成两组,就必须显式失败,而不是悄悄退化成一个没有意义的划分。二是 average="macro":宏平均让每个类别权重相同,稀有类的表现不会被多数类淹没。
对一个 9 类、且大概率存在长尾的数据集来说,宏平均 F1 是唯一诚实的单一指标。总体准确率在这种分布下几乎总是虚高。
§10 AI 使用声明
| 项 | 声明 |
|---|---|
| 性质 | 公开元数据可读、数据文件受限的科研数据集,版本 1.0.0-review |
| 可否用于模型训练 | 需先取得授权;即便取得,8 段规模也只支持方法验证,不支持生产训练 |
| 可否用于评测 | 可以,且这是最合适的用途;须按段或按个体划分,报告宏平均指标 |
| 不建议的用途 | 声称种群级结论、声称模型具备开放集识别能力、把 16.1 万当作 8 段总量做数据效率比较 |
| 伦理边界 | 濒危物种的个体身份与位置信息应谨慎外传;不得用于追踪、捕捉或干扰野生个体 |
| 人类受试者 | 无。官方声明全部素材经人工复核、不含人类主体 |
| 引用方式 | 现阶段只能引 DOI(10.5281/zenodo.21083480)与版本号;作者信息待论文发表后补入 |
| 核查时点 | 2026-10-29。所有规模数字取自 Zenodo 公开元数据,未下载文件,未做质量审计 |
最后一行值得强调:本页没有对标注质量做任何判断。框的紧密度、行为标签的一致性、轨迹的断裂率,这三项都需要拿到文件才能评,而文件在此刻不可得。任何转述本页内容的场合,都应保留这个限定。
常见误读(避坑清单)
| 常见说法 | 实际情况 | 证据 |
|---|---|---|
| 「16.1 万条标注覆盖全部 8 段」 | 只属于那 3 段带行为谱的视频 | 官方描述分号后的括号紧跟「three are additionally annotated」 |
| 「许可写 CC BY 4.0,所以可以直接下载商用」 | 许可管的是拿到之后怎么用,准入是另一回事;记录状态是 restricted | 元数据 access_right: restricted,files 数组为空 |
| 「非洲野犬的数据当然是在非洲拍的」 | 拍于美国俄亥俄州坎伯兰的 The Wilds 保护中心 | 官方描述原文给出 Cumberland, Ohio, USA |
| 「8 段 8 只,规模太小没有价值」 | 价值在结构:同一批个体 × 两类几何 × 三层标注,这种组合很少见 | 与相机陷阱图库、单视角行为集的定位差异见 §2.5 |
| 「track_id 就是个体身份」 | 轨迹通常只在单段内有效,身份跨段共享;混用会造成大量假阴性 | 官方把 tracking 与 identity 列为两层不同标注 |
| 「9 类行为谱是行业通用标准」 | 是本数据集自定义的 ethogram,类别名称未公开 | 官方仅给出「9-category」,无类别清单 |
| 「无人机与地面机位可以像多相机阵列那样配准」 | 无标定参数、无共同平面、无时间同步,单应变换不成立 | 几何前提见 §4.3 |
| 「8 只个体可以训练一个可用的个体识别模型」 | 封闭集 8 类,无开放集能力,遇到第 9 只必然错分且高置信 | closed-set 定义,无未知类样本 |
| 「作者匿名说明数据不可信」 | 双盲评审的标准流程,与数据质量无关;但也确实无法核验团队资质 | creators: Anonymous, Anonymous,官方说明录用后补入 |
| 「在审版本的数据会随时变,不能用」 | 版本号 1.0.0-review 已标明状态;结构层面(三层同源)不会变 | 官方版本号 + 变更预告 |
| 「有 bbox 就能直接训一个野犬检测器」 | 单一物种、8 个固定机位,域窄到几乎不能泛化 | 8 段全部来自同一场地,跨季节跨地点样本为零 |
十一条里,前两条是最容易在转述中被丢掉的限定。一条关于标注量,一条关于许可——两个数字都印在最显眼的位置,也都最容易被单独摘出来用。
FAQ
Q1 现在能下载吗?
不能。记录状态是 restricted,元数据公开、文件需授权,文件清单接口直接回 403。要走 Zenodo 记录页的请求访问通道,且在双盲评审结束前,你无法知道向谁申请。
Q2 16.1 万条标注到底怎么算出来的?
官方没有说明计数口径。从「frame-level annotations」的措辞推断,最可能是「每帧 × 每只出现的狗 = 一条」,即行为标签与身份标签合并计数。若按此推算,3 段视频每段约在十分钟量级(详见 §5.3)。
Q3 9 类行为分别是什么?
公开渠道查不到。官方描述只写「9-category behavioral ethogram」,没有类别名。可以确定的是数字 9 本身可靠;类别名称需要在拿到标注文件后从取值中读出(见 §9.2 的第三项检查)。
Q4 为什么说它是「多视角」,但又不给逐段视角归属?
「多视角」指采集用了两类几何不同的设备(固定机位与无人机),这一点官方明确。但哪一段来自哪类设备没有披露,所以无法确认那 3 段带行为谱的视频是否覆盖了两种视角。这个缺口直接影响跨视角任务能否成立。
Q5 能不能用它证明我的跨视角重识别方法更好?
能证明「在这个条件下更好」,不能证明「在这个物种上更好」。8 只个体、单一地点、两周窗口,三个条件叠起来,结论的外推半径非常小。要外推,必须再找野生种群的独立测试集。
Q6 无人机拍的狗只有几十像素,行为还能标吗?
这是这份数据最需要自己补的分析。俯视小目标下,头部姿态、口部动作这类行为线索基本不可辨,标注只能靠身体朝向与移动模式推断,标签噪声结构与地面视角不同。混训前应先分视角评估。
Q7 圈养环境会不会让行为谱失真?
会,而且是结构性的。The Wilds 是大围栏保护中心,动物在人工管理的牧场里活动,狩猎、长距离迁移、领地巡逻这些行为没有发生的条件。9 类里是否包含它们,官方没说;若包含,那几类大概率样本极少。
Q8 为什么不直接用一个通用动物检测器?
可以,而且应该先做这个基线。但要注意两点:广角边缘的桶形畸变会让画面角落的目标检测变差;俯视几十像素的小目标召回率天然低。通用模型的成绩只能当下限看。
Q9 论文发表后这份数据会变成开放下载吗?
不确定。官方只说「作者、仓库与引用信息将在发表后补入」,没有承诺改变访问级别。许可已经是 CC BY 4.0,若届时放开,门槛会降到零;也有可能继续维持申请制。
附录 A 视频清单与设备
八段视频的逐段属性,官方只披露了两项(是否带行为谱、是否有检测跟踪),其余全部为空。正因为 8 段之间在公开信息里没有任何区分性属性,下表只能按区间合并——这不是省略,是它们确实长得一样。
| 段 | 检测与跟踪 | 行为谱与身份 | 视角归属 | 时长 | 帧率 |
|---|---|---|---|---|---|
| 01–04 | 有 | 未披露 | 未披露 | 未披露 | 未披露 |
| 05–08 | 有 | 未披露 | 未披露 | 未披露 | 未披露 |
「未披露」不等于「没有」。3 段带行为谱的具体是哪三段,官方没有逐段指明,只给了总数。这意味着上表第二列的设计是诚实的下限:能确证的只有「8 段全有检测与跟踪」这一句。
设备侧的信息稍多一些:
| 设备 | 角色 | 已知参数 | 未知 |
|---|---|---|---|
| GoPro Hero 7 | 固定机位 | 型号确证 | 分辨率、帧率、镜头模式、安装高度 |
| GoPro Hero 11 | 固定机位 | 型号确证 | 同上 |
| DJI 无人机 | 航拍 | 品牌确证,型号未披露 | 型号、飞行高度、航线、云台角度 |
两种 GoPro 并用的原因没有说明。合理猜测是不同机位按安装条件选型(Hero 11 更新、低光与防抖更好),但这属于推测,不能当事实写。
附录 B 标注格式与字段
官方未公布标注文件格式。下面给出一个最小可用的内部表示,用于在拿到真实文件后做映射,而不是假装它就是官方格式。
{
  "video_id": "seg03",
  "fps": 25,
  "frames": [
    {
      "frame_id": 1204,
      "objects": [
        {"track_id": 12, "identity": 5, "behavior": 7,
         "bbox": [412, 208, 186, 244], "occluded": false}
      ]
    }
  ],
  "ethogram": {"1": "<类别名待填>", "2": "<类别名待填>"}
}
三个字段的语义必须在映射时明确下来,因为不同数据集的口径不同:
| 字段 | 常见歧义 | 建议处理 |
|---|---|---|
| bbox | [x, y, w, h] 还是 [x1, y1, x2, y2] |
拿到文件先算一批框的宽高,看是否出现负值 |
| frame_id | 从 0 起还是从 1 起 | 与视频总帧数比对,差 1 帧会影响末帧 |
| behavior | 整数编码还是字符串 | 有字符串就直接用,纯整数必须找类别表 |
| identity | 从 0 起还是从 1 起 | 与「8 只」比对,出现 8 说明从 0 起 |
第四行是实际最容易出错的地方:如果 identity 从 0 起,那么 8 只狗的编号是 0 至 7,任何假设「1 至 8」的代码都会在最后一只上出错。
附录 C 术语表
| 名称 | 说明 |
|---|---|
| 行为谱(ethogram) | 一份行为目录,列出研究关注的行为类别及其操作定义与采样规则 |
| 非洲野犬(Lycaon pictus) | 犬科单型属物种,三色斑驳毛皮,社会性合作育幼,IUCN 列为濒危 |
| 个体重识别(Re-ID) | 在跨时间、跨视角、跨设备的画面中判定「是不是同一个个体」 |
| closed-set / open-set | 测试个体是否必在训练集出现过的两种设定;后者要求模型能判「不认识」 |
| gallery / probe | 检索式评估的两个集合:底库与待检索样本 |
| track_id | 跟踪算法给出的段内轨迹编号,通常跨段不连续 |
| 单应变换(homography) | 把同一平面上的点从一个视角映射到另一个视角的变换,需共同平面与标定 |
| 宏平均(macro average) | 各类指标先算再平均,每类权重相同,不吃多数类红利 |
| 相机陷阱(camera trap) | 定点自动拍摄设备,触发式或定时录制,广泛用于野生动物监测 |
| DAIMS | 数据与 AI 成熟度评估框架,用可发现性、可访问性、文档、标识、标签等维度打分 |
| Cumberland | 美国俄亥俄州马斯金格姆县的一个村落,The Wilds 所在地 |
| The Wilds Conservation Center | 由 1980 年代退役露天煤矿复垦而成的保护中心,与哥伦布动物园合作运营 |
| anonymous.4open.science | 为双盲评审提供匿名代码仓托管的服务,评审结束后可揭示真实地址 |
| etho-tools | 匿名代码仓名,指向行为谱标注工具链,具体内容在核查时不可访问 |
| Hotspotter | 一种基于局部特征的花纹匹配软件,常用于野生动物个体识别 |
| MegaDetector | 微软维护的通用相机陷阱目标检测模型,输出动物/人/车三类框 |
| IUCN 红色名录 | 全球物种灭绝风险评估体系,非洲野犬被列为濒危(EN) |
| 时空约束 | 利用出现时间、消失时间、运动方向与相对位置来关联跨视角目标的策略 |
附录 D 常见误读问答补遗
Q11 8 段视频是 8 个机位同时拍,还是 8 个时间段?
官方没有明说。从描述里「stationary camera traps and a DJI drone」并列来看,两类设备都有素材,但没出现「synchronized」这个词。最可能是 8 个时段、每段单路,若真为严格同步的多路,作者通常会明确标注。
Q12 为什么行为谱只有 3 段有,另外 5 段不做?
行为标注的成本远高于框标注:框画一个矩形,行为需要判断这一帧在做什么,且需要两人以上交叉校验。3 段很可能是「够用于论文实验」的最小量。这是成本约束,不是数据缺陷。
Q13 这份数据和「动物姿态估计」数据集有什么不同?
姿态数据集给关键点(关节坐标),用于分析步态与运动学;这份给框、轨迹、身份与行为类别,用于分析「谁在做什么」。前者关心身体结构,后者关心行为语义。
附录 E 许可与引用
许可与准入必须分开看,这是这份记录最容易被误读的地方。
| 项 | 状态 | 含义 |
|---|---|---|
| 元数据许可 | CC BY 4.0 | 若拿到数据,可商用、可改编,需署名 |
| 记录访问级别 | restricted | 文件需持有者授权,公开渠道不可下载 |
| 元数据可读性 | 完全公开 | 标题、描述、关键词、DOI、许可均可自由读取 |
| 作者信息 | 脱敏 | creators 为 Anonymous,机构字段空 |
| 版本状态 | 1.0.0-review | 配合在审论文发布,发表后可能更新 |
现阶段唯一可用的引用形式是 DOI 引用,因为没有作者名可写:
Anonymous. (2026). WildDog-Videos: A Multi-View Video Dataset of
African Wild Dog Behavior (Version 1.0.0-review) [Data set].
Zenodo. https://doi.org/10.5281/zenodo.21083480
用 BibTeX 时,author 字段只能填 Anonymous,year 用 2026,note 里应写明「作者信息因双盲评审脱敏,发表后以正式版本为准」。这不是格式瑕疵,是这份记录当前的真实状态——把它写成某个具体作者,就是在造一个不存在的事实。
论文发表后应回到记录页重新取一次元数据,核对作者列表、版本号与访问级别,再更新引用。三项里任何一项变了,旧引用就该作废。
编辑说明
核验时间 2026-10-29。核验方式:调用 Zenodo 记录 API(/api/records/21083480)取回完整元数据,读取 metadata、access_right、files、stats、relations 各字段;调用文件清单接口确认返回 403;读取记录页 HTML 时被站点限流拦截,未获正文;匿名代码仓 etho-tools 在核查时返回空;公开检索未检出与该数据集绑定的论文或预印本。未下载任何数据文件(受限状态下不可得),未做标注质量审计,未统计类别分布。规模数字均按官方口径转述;涉及推算的三处(§5.3 视频时长、§4.2 像素尺度、§2.3 标注归属)已在正文标明推算依据与假设。9 类行为谱的类别名称在公开渠道不可得,正文未作任何推测性补全。站内互链 rid 均已查库确认存在:gbif 1346、eurosat 1781、plantvillage 1782、oppd 1784、icdc-glioma 1734、veterinary-vitals-anesthesia 1789、overture-maps 1786、rex-in-the-wild 731、aqs 1755。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- cern-cms-opendata — 共享标签:多模态 / 目标检测 / 图像分类
- tcm-tongue — 共享标签:多模态 / 目标检测 / 图像分类
- modus — 共享标签:目标检测 / 图像分类
- cornorb — 共享标签:多模态 / 图像分类
- soilgrids — 共享标签:多模态 / 图像分类
- nasa-exoplanet-archive — 共享标签:多模态 / 图像分类
- randolph-glacier-inventory — 共享标签:多模态 / 图像分类
- wesad — 共享标签:多模态 / 目标检测
- padchest — 共享标签:多模态 / 图像分类
- kvasir-capsule — 共享标签:目标检测 / 图像分类
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
