信息速览
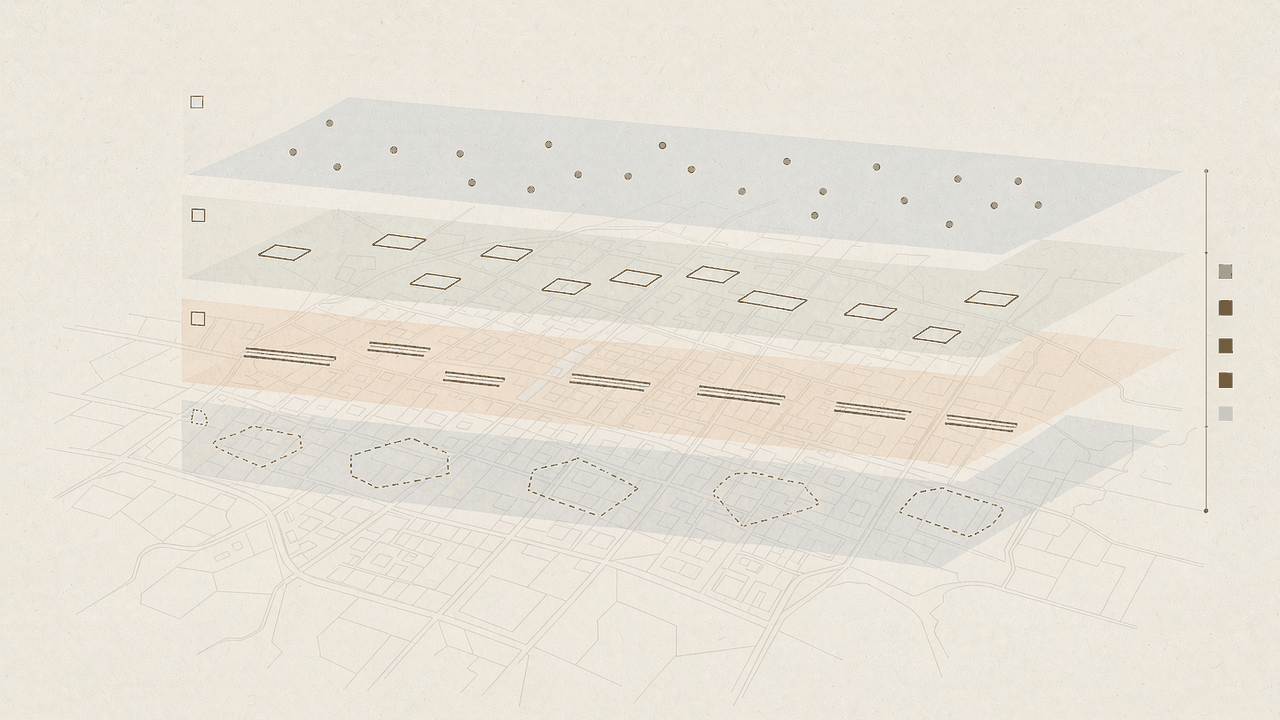
Overture Maps 是当前少有的、以「全球」为单位的开放矢量地图。它把 OpenStreetMap 的骨架、商业地图公司的路网、机器学习的建筑轮廓、各国政府的地址库拼到同一套模式里,再按月重新发布一次。它解决的是「同一栋楼在五个数据源里有五种写法」这件事,而不是「再多一幅卫星图」。
它的性质由三个数字定调:一栋建筑物、一条道路的一段、一个地名的点位。这些东西加起来是二十多亿个矢量要素,存成 GeoParquet,躺在 AWS 与 Azure 的公开前缀里,用一个 SQL 就能查。
但这个数据集最容易翻车的地方不在规模,而在许可。它不是一个「开放数据集」,而是四五个许可叠在一起的拼盘:底图、建筑、行政区划、交通沿 OpenStreetMap 的 ODbL,地点是 CDLA-Permissive,地址逐条看上游。用错主题,商业闭源的边界就变了。一屏速览见下表。
| 项目 | 数值 | 来源 |
|---|---|---|
| 当前数据版本 | 2026-10-21.0 | 官方发布日历 |
| 对应 schema 版本 | v2.0.0 | 同上 |
| 主题数 | 6 | 文档云存储页的主题映射表 |
| 要素类型数 | 12 | 同上 |
| 首次公开数据发布 | 2023-10-19(alpha) | 发布历史 |
| 最近一次大版本跨入 GA | 2024-07-22 | 该版发布说明 |
| 存储格式 | GeoParquet,另有 PMTiles 瓦片 | 云存储页 |
| 托管位置 | AWS S3 与 Microsoft Azure Blob | 每版发布说明 |
| 访问门槛 | 免注册,公开前缀直读 | 云存储页 |
| 公共保留窗口 | 最近两个月 | 发布日历的数据保留政策 |
| 许可 | 按主题分层,见 §4 | 各主题指南的 Sources 段 |
§1 速览:它是什么,也不是什么
§1.1 一句话定义
Overture Maps 是一份按主题分区、按月重发、许可分层、以矢量要素为单位的全球开放地图。
它不是一张能被渲染出来的图,不是一套影像,也不是一份统计表。它是一堆可以被 SQL 扫描的点、线、面和它们身上的属性列。
§1.2 它最不可替代的一件事
如果换个问法:这份数据如果消失,世界上会缺什么?
缺的不是「地图数据」。OpenStreetMap 本身就是一份极大的开放地图,全世界几百万志愿者在维护它。缺的是把多个来源的地物对齐到同一条身份线上的那套机制。
同一家便利店,在 Meta 的库里有一行记录,在 Foursquare 的库里有一行记录,在 OpenStreetMap 里是一个节点,在 TomTom 的道路数据里根本不出现。它们在同一个街区,名字拼写不同,坐标差几十米。想把它们合成一件事,就得两两做空间连接,做完还要在白名单里人工核对,每次任何一方更新就得重来一遍。
Overture 把这项工作挪到了上游:它为每个要素发一个稳定标识,叫 GERS ID,登记在一份注册表里,记录它第一次出现、最后一次出现、最后一次变更的时间。你把自有数据与 Overture 匹配一次,之后按标识连接即可,月度更新靠变更日志跟进。这个故事在官方 GERS 文档里被写成一句话:把连接的工作前置,而不是每对数据集各做一次。
这条主线决定了它的一切设计:为什么要有六个主题而不是一个大文件,为什么每版要发变更日志与桥接文件,为什么身份标识从 H3 哈希换成了纯随机 UUID。
这里要补一句澄清。上面说的「同一家便利店有五行记录」,指的是一次性匹配的难题。Overture 给出的解法不是「让所有来源都变成同一行」,而是「让所有来源都指向同一个标识」。两件事的差别很关键:前者要求数据本身被合并成一份,后者只要求数据在身份上可对齐,各自的属性仍然分开存。因此 Overture 的每个要素都带一个 sources 数组,记录它由哪几个上游记录贡献而来,以及每条上游记录的时间戳与置信度。融合只发生在几何与少量核心属性上,其余字段保持各自的来源痕迹。
这套设计也解释了为什么它的数据形态是「宽列 + 嵌套结构」而不是「一张大宽表」。一栋楼可能有三种来源,一条路可能有五段限速,一个地点可能有三套分类,这些都不适合压成定宽列。数据模型的选择不是审美偏好,是被身份机制逼出来的。
§1.3 三十秒决策卡:你的处境,它能帮你什么
| 你的处境 | 它能帮你什么 | 需要注意 |
|---|---|---|
| 要一个不依赖 Google 的地图底图 | Base 主题的水陆与土地覆盖,Transportation 的路网 | 两主题都沿 ODbL,商用须署名并回授衍生库 |
| 要训练一个 POI 分类或地址解析模型 | Places 的八千八百多万个点位,带分类体系与置信度 | 无 ODbL 传染性,但如果与 OSM 融合则仍可能触发 |
| 要把自己的客户表挂到世界地图上 | 用 GERS 匹配一次,之后按 UUID 连接 | 地址主题不进注册表,别拿 address 的 id 当稳定主键 |
| 要做行政管理与人口普查的空间连接 | Divisions 的三类要素与层级数组 | 国家级覆盖好,县级以下的 spotty |
| 要一份全球建筑轮廓做城市形态分析 | Buildings 的二十五亿条轮廓,含建筑部分 | 多数来自机器学习,精度不均 |
| 要一份全球路网做导航试验 | Transportation 的段与连接点,含限速与通行限制 | 属性是线性引用的,不要按单值读 |
| 要街景或卫星影像 | 给不了,这里没有像元 | 影像请走遥感数据集 |
§1.4 不适合谁
不适合把「开放」理解成「无义务」的人。四个主题沿 ODbL,一旦你把 Overture 的底图与自有数据合成为一个可公开使用的数据库,衍生数据库就可能需要以 ODbL 回授。这条约束在商业闭源产品里是硬边界,不是提示。
也不适合把它当成「全球最全的 POI 库」直接拿去评估市场容量。Places 的主要来源是 Meta,覆盖率与门店真实存在之间不是等号,官方在指南里也把它描述为「多来源融合的协调结果」,不承诺穷尽某个国家或某条街的每一家店。
不适合需要逐要素许可标记的自动化合规流水线。Overture 的许可落在主题这一级,不是每个要素一个字段。如果你的系统需要按要素类型自动判定许可,得自己建一张主题到许可的映射表,因为数据里读不到这个信息。
不适合把它当作历史数据。它每月重发,但公开发布的只有最近两个月。想做「过去三年的路网演化」,必须在每个版本发布时自行留存,事后再补是不可能补回来的。
§2 数据构成:六个主题怎么切,十二种要素怎么分
§2.1 全量规模
按 2026-10-21.0 这一版的发布说明,各主题的要素数量如下。数字取官方发布的表格,未做核对性重算。
| 主题 | 要素类型 | 要素数 | 说明 |
|---|---|---|---|
| Buildings | building | 二十五亿三千多万 | 含七个来源,OSM 优先级最高 |
| Buildings | building_part | 四百四十八万余 | 仅来自 OSM |
| Places | place | 八千八百多万 | 本版增长 8.55% |
| Addresses | address | 四亿七千五百多万 | 覆盖 41 个国家 |
| Base | infrastructure | 一亿五千八百多万 | 桥梁、机场、电力线等 |
| Base | land_cover | 一亿二千三百多万 | 来自 ESA WorldCover |
| Base | land | 七千六百多万 | 来自 OSM 海岸线取反 |
| Base | water | 六千六百多万 | 来自 OSM |
| Base | land_use | 五千六百多万 | 来自 OSM 的 landuse 标签 |
| Base | bathymetry | 四十万余 | 来自 ETOPO1 与 GLOBathy |
| Divisions | division | 四百七十万余 | 点 |
| Divisions | division_area | 一百零八万余 | 面 |
| Divisions | division_boundary | 八万七千余 | 线 |
交通主题的数量按要素与长度两种口径给出,因为一条道路的中心线被切成多段之后,「多少条路」本身没有意义。
| 来源 | 要素数 | 总长度(公里) |
|---|---|---|
| OpenStreetMap | 七亿六千六百万余 | 九千五百余万 |
| TomTom | 一千一百余万 | 二百零三万余 |
按子类型拆长度,公路占九千三百多万公里,铁路二百八十八万余公里,水路五十九万余公里。三者的量级差两个数量级,直接把「交通」当成均匀的一类来处理会得到荒谬的平均值。
这些数字之间还有一个不显眼的比例关系,值得单独提出来。建筑要素数约等于地点要素数的一千三百倍,地址要素数不到建筑的五分之一。这不是数据缺陷,而是三种对象的物理数量本来就不在同一个量级:一栋楼可以容纳几十家店,一个地址通常对应一栋楼或一套房。把这三者放进同一张统计表比较「完备度」会得到误导性的结论——它们在真实世界里的分母本来就不同。
另一组数字更值得注意:交通主题里 OpenStreetMap 来源的要素数是七点六亿,TomTom 来源是一千一百多万,相差近七十倍,但两者的总长度相差不到五十倍。差值来自两个来源对「一条线段能有多长」的定义不同:TomTom 的路网向两端延伸得更远,OSM 在细分道路上的切分更碎。这也解释了为什么融合后不能简单按要素数相加来估算覆盖率。
§2.2 主题的切法不是按数据类型,是按「谁来维护」
六个主题看起来像按几何形状切的,其实不是。Base 里同时有点、线、面;Divisions 三类各有各的几何。真正的切分逻辑是上游来源与融合方式:
- Base 是单源直通主题。每种要素类型只来自一个来源,OSM 的搬 OSM,水深搬 ETOPO1 与 GLOBathy,土地覆盖搬 ESA WorldCover。没有匹配,没有融合。官方明说「no matcher and no conflation process」。
- Buildings 是多源融合主题。七个来源,按 IoU 阈值 0.5 做几何匹配,OSM 优先,其余按质量排序填补。
- Places 是多源融合主题,但一个 OSM 要素都不含。这是它与其余主题最关键的差别,直接决定了许可。
- Transportation 是多源融合主题,OSM 加 TomTom,通过一个叫 Orbis 的图做匹配。
- Divisions 是 OSM 与 geoBoundaries 的协调,去重后按层级组织。
- Addresses 是多源拼接,一百七十五个以上来源,逐条保留,不做属性合并。
这个切法解释了一个常常被忽略的事实:Base 的要素不在 GERS 注册表里。它是单源直通,没有跨源匹配,因此不需要身份对齐,Overture 也不为它承诺稳定性。它的 id 是确定性 UUID,合法但不是 GERS ID。
同样的逻辑可以解释另一个现象:为什么 Divisions 只有三类要素,却是整个数据集里结构最复杂的主题。因为行政区划不是一个平面上的多边形集合,而是一棵树。同一个地理位置同时属于国家、大区、县、市、社区,每一级都有自己的边界、自己的名称、自己的上下级关系。把树拍平成三层要素,用 id 链把它们串起来,是这套模式的必然选择。
§2.3 一次空间查询长什么样
官方推荐的最小路径是用 DuckDB 直读云上的 GeoParquet,只取需要的行。以下以当前版本为例,查询费城附近名称含 wawa 的地点。
--# 载入空间与对象存储扩展
LOAD spatial;
LOAD httpfs;

--# 访问 AWS 上的公开前缀,无需凭证
SET s3_region = 'us-west-2';

COPY (
  SELECT
    id,
    names.primary AS name,
    taxonomy.primary AS category,
    geometry
  FROM read_parquet(
    's3://overturemaps-us-west-2/release/2026-10-21.0/theme=places/type=place/*',
    filename=true, hive_partitioning=1)
  WHERE
    names.primary ILIKE '%wawa%'
    AND bbox.xmin BETWEEN -76.5 AND -74.5
    AND bbox.ymin BETWEEN 39.5 AND 40.5
) TO 'wawa_stores.geojson' WITH (FORMAT GDAL, DRIVER 'GeoJSON');
这段查询有三个细节值得单独记住。第一,过滤用的是 bbox 列而不是 geometry,因为 bbox 是预先算好的结构体,能在扫描阶段下推,而几何判定要等读出行之后才算。第二,hive_partitioning=1 让 theme= 与 type= 从路径推断成列,否则这两列不会出现。第三,路径里的 * 会展开成该目录下所有分区文件,量级很大,不加过滤直接 SELECT * 会拖垮本地内存。
§2.4 版本与路径的对应关系
路径的结构是固定的三段:release/<版本>/theme=<主题>/type=<要素类型>/*。版本是带日期的 yyyy-mm-dd.x,x 是同一日期的补丁号。
这个结构意味着两件事。其一,跨主题的联合查询必须写两条路径,没有「全主题视图」这样的对象。其二,版本号写死在 SQL 里会让脚本在两个月后失效,因为公共存储只留最近两个月。官方提供的替代方案是 STAC 目录,根目录里有一个 latest 字段指向当前版本。
--# 从 STAC 根目录读当前版本号,避免硬编码
SELECT latest FROM 'https://stac.overturemaps.org/catalog.json';
还有一个更省事的做法:官方提供 latest.ddb,一个带好视图的 DuckDB 文件,每个要素类型一个视图,挂载后直接按名字查。缺点是它跟着最新版走,要复现某一次实验必须回到写死版本号的路径。
LOAD spatial;

--# 挂载后每个要素类型对应一个视图
ATTACH 'https://stac.overturemaps.org/latest.ddb' AS overture (READ_ONLY);

SELECT count(*) FROM overture.place;
§2.5 与遥感数据集的根本区别
这一节是给从影像方向过来的人看的。
遥感数据集给的是栅格:一个矩形的像元矩阵,每个像元有若干波段值,坐标藏在 GeoTIFF 的仿射变换参数里。EuroSAT 的瓦片就是 64×64 的像素方块。你关心的是像元。
Overture 给的是矢量:一个点、一条线、一个多边形,几何存成 WKB 二进制,属性存在并排的列里。你关心的是要素。一栋建筑是一个多边形,不是一个 30×30 米的像元块。它的边界是画出来的,不是拍出来的。
两者不能互相替换,但可以互相使用。用 Buildings 的轮廓去裁 Sentinel-2 瓦片,就能得到带建筑面积标注的训练样本;用 Base 的水系面去过滤卫星影像里的水体误判;用 Divisions 的行政边界去做空间交叉验证,防止相邻行政区的样本串味。反过来,卫星影像可以校验建筑轮廓是否已经停产、是否新建。这是两种数据在同一个流水线里的正常关系。
这个区别也解释了为什么 Overture 不发布「影像」:它的存在意义是把地物抽象成可连接的实体,而影像恰恰是不可连接的。
还有一层差别在数据结构上。遥感瓦片的信息密度是均匀的:每个像元都有一个值,没有空白。矢量要素的信息密度是不均匀的:一栋楼有面积、有高度、有来源,旁边一片空地可能什么都没有。用矢量数据训练模型时,「没有要素」本身就是一个有意义的信号,而栅格数据里它只是个背景值。这个差别在处理稀疏地物(比如道路、河流)时会立刻显形:矢量给的是线本身,栅格给的是线周围的一圈像元,后者的标签噪声要大得多。
第三层差别在时间。遥感数据的时间由成像任务决定,同一地点可能一周一次,也可能一年一次,且没有规律。Overture 的时间由发布日历决定,全球同步、每月一次。这意味着做时空分析时,两边的时间轴无法直接对齐:一个是稀疏的观测时刻,一个是规则的发布时刻。把两者按「同一时刻」合并,是一种虚构。
§3 拿到手:三种入口与两种字段结构
§3.1 三条路径,按场景选
官方给出三条主路径,外加若干镜像。
| 路径 | 适合 | 代价 |
|---|---|---|
| DuckDB 直读云上 GeoParquet | 做分析、写 SQL、只取一小块 | 需要本机能连 S3 或 Azure |
Python 命令行工具 overturemaps |
按包围盒下载成 GeoJSON 或 Parquet | 需要装包,一次只取一个要素类型 |
| 浏览器 Explorer | 看一眼、点一个要素、导出一小块 | 不能批处理,不能写查询 |
三条路径都免注册。AWS 的公开前缀支持无签名访问,命令行工具用 --no-sign-request;Azure 侧用 AzCopy 直连。
批量抓取的典型命令如下,注意这是个完整拉取,不要对全主题执行。
#-- 无凭证拉取 Base 主题下 infrastructure 类型的一个版本
aws s3 cp --no-sign-request --recursive \
  s3://overturemaps-us-west-2/release/2026-10-21.0/theme=base/type=infrastructure/ .
按区域取数则用 Python 客户端,只传包围盒内的要素,其余不下载。
pip install overturemaps

#-- 取波士顿市中心一小块建筑轮廓,输出 GeoJSON
overturemaps download \
  --bbox=-71.068,42.353,-71.058,42.363 \
  -f geojson \
  --type=building \
  -o boston_buildings.geojson
§3.2 字段结构:顶层列与嵌套结构并存
Overture 的每一行不是一个扁平的表格行。它的列有两类:一类是扁平的原语列,比如 id、bbox、version;另一类是嵌套的结构列,比如 names、sources、categories、taxonomy。
嵌套结构在 DuckDB 里用点号取,在 Athena 里用箭头取。这是新手最常撞的一道墙:SELECT names FROM ... 返回的是一整个结构体,而不是名字。
| 字段 | 层级 | 典型取值 | 常见误用 |
|---|---|---|---|
| id | 顶层 | UUID 字符串 | 以为前缀有意义(2025-06 前才有) |
| bbox | 顶层结构 | xmin/ymin/xmax/ymax | 用 geometry 过滤,慢一个数量级 |
| names.primary | 嵌套 | 「星巴克」 | 直接比较 names,永远不相等 |
| sources | 嵌套数组 | dataset、record_id、update_time | 当成单值字段 |
| taxonomy.primary | 嵌套 | 分类路径字符串 | 和旧版 categories 混用 |
| geometry | 顶层 | WKB 二进制 | 不载 spatial 扩展就存成 blob |
§3.3 主键选择:哪个 id 能拿来当稳定键
这是使用这份数据时最需要想清楚的一件事,比选哪个主题还重要。
| 主题与类型 | id 性质 | 是否进 GERS 注册表 | 能否跨版本追踪 |
|---|---|---|---|
| Place | GERS ID | 是 | 能,官方承诺稳定性 |
| Building | GERS ID | 是 | 能 |
| Building part | 确定性 UUID | 否 | 不能 |
| Division 三类 | GERS ID | 是 | 能 |
| Segment、Connector | GERS ID | 是 | 能 |
| Base 全部类型 | 确定性 UUID | 否 | 不能 |
| Address | 不进注册表 | 否 | 不能,属性一变就换 id |
这个表的意义在于:如果你打算把 Overture 当成一份会每月刷新的基础表,只有进注册表的那几类可以按 id 做增量合并,其余都应当按几何或业务键重新匹配。
还有一个容易漏掉的细节:GERS 注册表的覆盖是逐要素类型的,不是逐主题的。Buildings 主题里 building 有 GERS ID,building_part 没有;同一个主题内两种要素的稳定性承诺不同。写增量同步代码时要按类型分支,不能按主题分支。
§3.4 变更日志与桥接文件的用法
每版发布都带三个附属产物。变更日志按要素记录四种状态:新增、删除、数据变化、未变。桥接文件把上游的记录号映射到 GERS ID,例如某个 OSM 的 way id 对应哪个 Overture 建筑。
这两类文件解决的是不同的痛点。变更日志回答「我上次匹上的那个要素这次还在不在」,桥接文件回答「我已经有 OSM 数据了,能不能不重新匹配就直接拿到 Overture 的标识」。两者都不在 STAC 目录里,路径要单独记。
变更日志里有四种状态,处理它们的方式不同。标记为「未变」的可以直接沿用上版的属性,省掉重新计算;标记为「数据变化」的要检查哪些列变了——官方会记录变更列的清单,只取变化的列就够了;标记为「新增」的要重新跑一遍匹配;标记为「删除」的要从下游产物里摘掉,否则会留下悬空的引用。
桥接文件覆盖的范围也有边界。官方说明它只对一对一的匹配提供,多对一或多对多的情形不给。这一点直接影响「用 OSM 反查 Overture」的可行性:如果你手上有一条 OSM 的 way 记录,通过桥接文件未必能直接拿到 Overture 的 ID,因为这条 way 可能对应多栋融合后的建筑。
§3.5 用 Explorer 做一次人工核验
在写任何代码之前,先用浏览器看一眼数据的实际形态,能省掉大量试错。
Explorer 的用法很直接:拖动到目标区域,关掉不需要的图层,点一个要素,右侧会显示它的全部属性。这份属性视图里能看到 id、sources、names 与各分类字段的原样结构,等于是一份免费的字段字典。
它的局限也要提前知道。官方明说 Explorer 用的是 PMTiles 矢量瓦片,这些瓦片仅供检视,图层与属性可能在任何一版里变化,不对生产环境做承诺。所以用它来确认「某个字段叫什么、长什么样」是可靠的,用它来确认「全量有多少条」是不可靠的——瓦片覆盖的要素是经过层级抽稀的。
§4 许可分层:全篇最关键的一节
§4.1 三个许可族,不是一个大许可
把 Overture 称作「开放地图数据」在事实层面对,在合规层面远远不够。它内部至少叠着三个许可族:
- ODbL 1.0:开放数据库许可,带传染性。底图、建筑、行政区划、交通四个主题沿它发布,因为它们都含 OpenStreetMap 数据。
- CDLA-Permissive 2.0 与 Apache 2.0:宽松许可,无传染性。地点主题沿它发布,因为它一个 OSM 要素都不含。
- 逐条适用:地址主题不设统一许可,每个上游数据集带自己的条款,署名与义务要按来源清点。
还有一个补充来源的许可要单独看:Base 里的土地覆盖来自 ESA WorldCover,水深来自 ETOPO1 与 GLOBathy。这两个来源本身不是 ODbL,但整个 base 主题因为含 OSM 数据而以 ODbL 发布。官方在 Base 指南里写得很直接:因为它包含 OpenStreetMap 数据,base 主题以 ODbL 发布。
§4.2 逐主题许可表
| 主题 | 许可 | 是否含 OSM | 传染性 | 主要义务 |
|---|---|---|---|---|
| Base | ODbL | 是(land、water、infrastructure、land_use) | 有 | 署名,衍生数据库回授 |
| Buildings | ODbL | 是,且优先级最高 | 有 | 同上 |
| Divisions | ODbL | 是,主源 | 有 | 同上 |
| Transportation | ODbL | 是,主源 | 有 | 同上 |
| Places | CDLA-Permissive 2.0 + Apache 2.0 | 否 | 无 | 保留署名与变更说明 |
| Addresses | 逐来源适用 | 否 | 视来源 | 逐来源清点 |
地点主题内部的来源分布也不统一。按 Places 指南的表,Meta 贡献了六千万余条、CDLA-Permissive 2.0;BrightQuery 一千五百多万条、CDLA-Permissive 2.0;Foursquare 三百七十余万条、Apache 2.0;AllThePlaces 一百九十多万条、CC0-1.0。混合结果就是主题级的双许可。
这张表要横着读,也要竖着读。横着读是按主题看义务:四个 ODbL 主题的义务一致,都是署名加回授;Places 是两个宽松许可叠加,义务是署名与变更说明;Addresses 没有统一答案。竖着读是按「是否含 OSM」看:含 OSM 的四个主题全部统一到 ODbL,不含 OSM 的两个主题各自分散。这条规律比逐个背表更省事:先问这个主题里有没有 OSM,再问有几个其他来源。
地址主题的分散程度最需要警惕。它的一百七十五个以上来源里,既有 OpenAddresses、AddressForAll 这样的开放聚合组织,也有各国政府发布的开放数据,还有市政部门的数据门户。这些来源的许可从公共领域到要求署名都有,且有一部分带「不得用于商业」的限制。官方明确说这个主题「carries a variety of source licenses rather than a single overall license」,所以任何把地址数据商用的人,都必须先把自己的上游来源清单拉出来逐条核对,而不是看主题级的一句话。
§4.3 ODbL 到底约束什么
ODbL 的传染性不是「你用了就得开源」。它约束的是衍生数据库:如果你把 ODbL 数据与自有数据合成为一个新的数据库,并对公众提供,那么这个新数据库的核心部分需要以 ODbL 提供。与之并行的是「集体数据库」概念:如果你的自有数据与 ODbL 数据只是并列存放、分开分发,两者之间的分界清楚,那么自有部分不必回授。
这个分界在实操里非常难画。把 Overture 的建筑轮廓与自家的楼宇能耗表按 id 连接,导出一份「楼宇能耗地图」并对外提供服务,很有可能被认定为衍生数据库。把两者分别提供给不同团队,内部各自使用,边界就清楚得多。
官方的做法是给出署名模板而不是法律意见。Explore 工具用了含 OSM 的数据,所以在页面上写了 © OpenStreetMap contributors, Overture Maps Foundation。这个串就是遵守 ODbL 署名义务的最小形式。
ODbL 还有一条常被忽略的义务:保持开放。如果你把衍生数据库以技术手段限制(比如只能通过你的 API 访问、不能批量导出),就违反了「以同样许可提供」的要求。这一条对把地图封装成 SDK 分发的产品尤其敏感——用户必须能拿到可用的原始数据,而不只是渲染好的瓦片。
§4.4 地点主题的边界,以及它为什么会破
Places 是这份数据里唯一「干净」的部分:官方明说它不含 OpenStreetMap 数据,也不带 ODbL 的 share-alike 义务。这是它能在商业产品里直接用的前提。
但这个干净是有条件的。官方在 Places 指南里加了一条提醒:把 CDLA-Permissive 2.0 的数据与 OpenStreetMap 连接是被允许的,但如果结果构成衍生数据库,仍可能需要以 ODbL 发布,具体见 OSM 的集体数据库指引。
这条提醒出现在 Places 指南的查询示例之前,而那个示例恰好就是把 Overture 的餐厅数据与 OSM 的餐厅节点做去重合并。也就是说,官方一边说 Places 没有传染性,一边在你最想做的事上放了一个风险提示。这不是自相矛盾,而是许可本身的性质:干净的输入可以做出脏的输出。
§4.5 一个常见的误判
把「Overture 采用 ODbL」和「Overture 全部是 ODbL」当成一回事,是使用这份数据时最常见的错误,并且它会往两个方向出错。
一个方向是过度保守:因为听说 ODbL,连 Places 都不敢碰,绕开了一份实际上没有传染性、且是全文最密集 POI 数据的输入。
另一个方向是过度乐观:因为 Places 是宽松许可,就默认整个 Overture 都可以直接塞进商业产品,最后在底图或建筑主题上踩线。
两种错误的成本不对称。过度保守损失机会,过度乐观损失合规。所以在任何用到 Overture 的项目里,第一步不该是选主题,而该是列出你实际会读取的要素类型,逐类对照许可表,再决定哪些能进产品、哪些只能进内部分析用。
§4.6 许可分层如何影响 AI 训练
对模型训练而言,数据许可的传染性在设计阶段就要考虑,而不是训练完再补。
若训练出的模型只学参数、不复制数据,通用观点是不构成衍生数据库,ODbL 的传染性不会被触发。但这条判断在不同法域的解释并不一致,且近年关于训练数据许可的判例在变化,不能当成定论。
真正会触发问题的是分发衍生数据,例如把「Overture 建筑 + 自有属性」的合并结果打包成一份新数据集对外发布,或者把合并结果内嵌进一个可被用户下载的产品。此时数据许可证与实际交付物一致,是唯一安全的做法。
§4.7 一张自查清单
在把 Overture 的任何数据放进产品之前,按顺序问五个问题。
第一,我读了哪几种要素类型?把它们逐个写出来,不要写「读了 Overture」。要素类型是许可的最小单位。
第二,这几种类型分别属于哪个主题?主题是许可的判定层级。同一要素出现在不同主题里的情况不存在,一个要素类型只属于一个主题。
第三,其中有没有 ODbL 的?如果有,最终产物的许可就默认按 ODbL 规划,剩余的问题只是边界怎么划。
第四,我的产物会公开吗?公开包括两种形式:作为独立数据集提供,或内嵌进一个用户可以下载的产品。只是内部使用不触发传染性。
第五,我能不能把 ODbL 部分与自有部分分开交付?如果能,分开交付是最省心的方案;如果不能,就按合并后的整体按 ODbL 处理。
这五个问题花不了五分钟,但能挡掉大多数事后补救。
§5 质量层:它好在哪,坏在哪
§5.1 身份连续性:GERS 的真实承诺
GERS 的价值不在「有 id」,而在「承诺这个 id 下次还在」。官方的做法是把注册表当唯一凭据:一个标识是不是 GERS ID,不能从字符串本身看出来,必须去注册表查它是否在列。
这个设计是为了修正一次教训。在 2025-06-25.0 之前,标识是十六进制串,里面编了 H3 网格单元和主题字节。结果是当实体跨网格移动或换主题时,标识会碰撞。那一版之后全部换成 128 位随机 UUID,字符串里不再携带任何含义。
代价是:在 2025-06-25.0 之前抓取的 id 全部失效,无法对上新数据。同时,用 id 前缀做空间过滤从来就不可靠,应当改用 bbox 列。
§5.2 覆盖的不均匀
Divisions 的官方说明承认了分层覆盖的落差:国家、属地、大区、县这四级是全球覆盖,但县以下的 locality、borough、neighborhood、microhood 虽然应该存在于每个国家,实际覆盖率「often spotty」。macroregion 与 macrocounty 两个层级存在但当前被误分类到其他子类型。
Buildings 的官方说明承认机器学习来源的精度问题,且明确指出这一问题在「全球南方」最明显,原因是那里机器学习来源的建筑占比最高。
这两条共同指向一个判断:Overture 的「全球」在顶层是真的,在细粒度上是不均匀的,且不均匀的方向与数据基础设施的分布一致。
§5.3 融合的取舍
Buildings 的融合逻辑值得单独说,因为它是理解这类数据集的一把钥匙。
匹配按几何 IoU 进行,阈值 0.5。融合时 OSM 优先级最高,其次是 Esri 的社区数据,然后是政府来源,最后是机器学习来源。官方给出的效果描述是:在美墨边境看,Esri 与 OSM 的建筑呈大片块状,Google 与 Microsoft 的建筑混合成一片。这就是优先级在空间上的可视化。
这个设计的意图很明确:让社区的人工编辑始终压过机器推断,且每一次更新都重新压过一遍。官方甚至把这个当作一种维护接口:如果发现某栋建筑有问题,去 OSM 里改它,下一版 Overture 就会体现。
代价是:数据在 OSM 覆盖薄的地方完全依赖机器推断,而机器推断的质量与影像分辨率和训练集的地区分布强相关。
§5.4 已知的过滤规则
Buildings 在融合前后有一串过滤规则,有些会直接丢掉要素。位于水中的建筑被排除;几何尖角过多的多边形被排除;机器学习来源中面积过小的被排除(这些通常是集装箱、车棚、太阳能板);height 大于等于 900 米的被排除。
这些规则是为了减少误检,代价是会漏掉一些真实要素。官方明说了这一点,并给出补回的办法:在 OSM 里补。
§5.5 一个贯穿全文的例子:华盛顿特区那栋楼
下文的讨论会反复回到一个具体对象:一栋位于华盛顿特区、在官方探索器里常见的联邦政府建筑。选它是因为它能同时展示四件事。
第一件事是身份。它在 Buildings 主题里有一个 GERS ID。这个 ID 从它第一次被纳入参考地图起就固定,即使轮廓在某一版被修正、高度被补上,标识不变。
第二件事是来源。它的 sources 数组里可能同时列出 OpenStreetMap 与 Esri Community Maps。若两者几何 IoU 超过 0.5,它们被判定为同一栋楼,各得到一个指向同一 GERS ID 的桥接记录。
第三件事是许可。它属于 Buildings 主题,沿 ODbL。如果某人把它与自家的会议室预订数据合并发布,衍生数据库的边界问题立刻出现。
第四件事是模态。它的几何是多边形,不是像元。任何试图把它当作「一块 30 米格网」的做法都会丢失轮廓信息。
后面讨论 GERS 注册表、融合优先级、许可分层与查询写法时,都会回到这栋楼。
§5.6 变更节奏的代价
月度发布听起来很顺,但有一个常被忽略的后效:GERS churn。
2026-10-21 这一版里,Places 的 churn 是 11.92%,新增八百三十多万个、删除一百三十多万个。原因是 BrightQuery 的西欧扩张。Divisions 的 churn 很低,三类分别在 0.45% 到 0.56% 之间。Transportation 的 connector 与 segment 分别是 0.70% 与 0.83%。
对按 id 增量同步的使用者来说,11.92% 意味着一个月里每九个点里就有一个换掉了。这个比例如果事先不知道,增量管道会在第一次全量对比时崩掉。
churn 的来源值得拆开看。Places 这一版的高 churn 不是随机重排,而是由一次集中的来源替换引起的:西欧十国的存量地点换成了 BrightQuery 的数据,但标识保留了下来。也就是说,「换掉」在这批数据里指的是属性变化,不是标识失效。这提示一个实操要点:churn 高不等于主键失效,要区分「同一个 id 的属性更新」与「实体消失、新实体出现」两种情况,前者只需重跑属性同步,后者才需要重建关联。
§5.7 它不会告诉你的三件事
第一,某个地点是不是真实存在。Places 的每个记录都有一个置信度字段,但置信度描述的是「多个来源是否一致」,不是「这个地方是否营业」。官方这一版把营业状态的覆盖率从 23.74% 提升到 32.54%,也就是说仍有近七成地点没有营业状态。
第二,某个建筑的高度是否准确。高度字段来自上游,可能是现场量测、可能是按楼层估算、可能是模型推断,数据里没有一个字段区分这三种来源。用高度做三维渲染时,这一点必须在方法里声明。
第三,某个行政区划的边界是否被所有相关方承认。Divisions 的官方描述是「as seen from a given political perspective」,这句话是有意写的。争议地区的边界在不同视角下不同,数据只给出其中一种。
§6 使用层:把它接进一条流水线
§6.1 最小可用流程
一条典型流程有五步,每步都对应一个具体的坑。
第一步,确定要读的要素类型,逐类查许可。这一步不能跳过,因为它决定了后面能不能把结果发出去。
第二步,用 STAC 读当前版本号,不要写死。写死的版本在两个月后会因为公共存储清理而 404。
第三步,用 bbox 过滤,只取需要的地理范围。DuckDB 的空间下推在这个列上工作良好。
第四步,用 hive_partitioning=1 把 theme 与 type 读成列,便于后续合并多类型结果。
第五步,导出时保留 id 与 sources。前者是未来增量同步的钥匙,后者是事后追溯的凭据。
§6.2 按行政边界取数
Divisions 的 division_area 常被用作空间裁剪的模具。下面的示例取美国犹他州的地址点,导出为 CSV。
LOAD spatial;
LOAD httpfs;

SET s3_region = 'us-west-2';

COPY (
  WITH utah AS (
    SELECT geometry AS utah_geom
    FROM read_parquet(
      's3://overturemaps-us-west-2/release/2026-10-21.0/theme=divisions/type=division_area/*',
      filename=true, hive_partitioning=1)
    WHERE names.primary = 'Utah' AND subtype = 'region'
  )
  SELECT a.id, a.street, a.number
  FROM read_parquet(
    's3://overturemaps-us-west-2/release/2026-10-21.0/theme=addresses/type=address/*',
    filename=true, hive_partitioning=1) AS a
  INNER JOIN utah ON ST_WITHIN(a.geometry, utah.utah_geom)
  WHERE a.country = 'US'
) TO 'utah_addresses.csv';
这段查询有一个隐含前提:division_area 里同一个州可能有多条记录,分别对应「仅陆地」「含领海」「未裁剪」三种范围,由 is_land 与 is_territorial 两个布尔量区分。不显式限定时会得到多份几何,ST_WITHIN 的连接结果会重复。
§6.3 层级查询:从国家一路读到街道
Divisions 的 hierarchies 数组是这份数据里比较少见的「自带关系」设计。每个 division 都带一条从国家到自身的链,链上每一项都是一个 GERS ID。
LOAD httpfs;
SET s3_region = 'us-west-2';

--# 读出某个 locality 的完整行政层级链
WITH locality AS (
  SELECT hierarchies
  FROM read_parquet(
    's3://overturemaps-us-west-2/release/2026-10-21.0/theme=divisions/type=division/*',
    filename=true, hive_partitioning=1)
  WHERE names.primary = 'Salt Lake City' AND subtype = 'locality'
)
SELECT h.name, h.subtype, h.division_id
FROM locality
CROSS JOIN unnest(hierarchies[1]) AS t (h);
这段的意义不在结果,而在示范一种用法:层级不是靠字符串拼接「国家/省/市」得来的,是靠 id 链串起来的。把 division_id 再去 join division_area,就能一次拿到每一级的面。
§6.4 交通数据的两种读法
交通主题的属性是线性引用的,也就是说,同一个属性可以只作用于一条线段的某一段。限速从第 0 公里到第 500 米是 50,之后是 30,这在数据里是一条线段加两个引用区间,而不是两条线段。
这种设计对路由很友好,对随手取数很不友好。如果你只想要「这条路的限速」,必须处理多个区间的情况,而不能取第一个元素了事。
LOAD spatial;
LOAD httpfs;
SET s3_region = 'us-west-2';

--# 取柏林范围内所有停车通道段
COPY (
  SELECT *
  FROM read_parquet(
    's3://overturemaps-us-west-2/release/2026-10-21.0/theme=transportation/type=segment/*',
    filename=true, hive_partitioning=1)
  WHERE class = 'parking_aisle'
    AND bbox.xmin > 13.0897 AND bbox.xmax < 13.6976
    AND bbox.ymin > 52.3100 AND bbox.ymax < 52.7086
) TO 'berlin_parking_aisles.parquet';
§6.5 用建筑轮廓给卫星影像打标签
这是 Overture 与遥感数据集唯一稳固的结合点,也是它在本库中的位置。
思路很直接:取一块建筑轮廓,按轮廓生成缓冲区,再在 Sentinel-2 影像里裁出对应的像元块。结果是「影像块 + 建筑掩码」的配对。这一步不需要任何 Overture 的元数据,只需要几何与坐标参考。
反过来的用法也成立:用卫星影像检验建筑轮廓的时效性。若某块轮廓所在的位置在最新影像里已经是裸地,说明该建筑已拆除而数据未更新。这类交叉校验对机器学习来源的建筑尤其有用。
关键的边界是:影像里有而矢量里没有的东西,矢量永远无法提供。 草地纹理、屋顶材质、施工状态,这些是像元层面的信息。把 Overture 当成「免费的标注来源」可以,把它当成「免费的影像替代品」不行。
§6.6 三个会立刻绊倒人的细节
其一,names 是结构体。任何按名字模糊匹配的查询都必须写 names.primary,否则比较的是整个结构体,结果恒为空。
其二,sources 是数组。一栋楼可能来自多个来源,取 sources[1] 只是取了第一个,未必是主来源。要判定主来源,得看融合优先级,不能靠数组顺序。
其三,geometry 在未载入 spatial 扩展时是二进制块。用 DuckDB 读出来看着像乱码,其实是 WKB,加上扩展就会自动转成几何类型。
§6.7 一份增量同步的骨架
如果要把 Overture 接进一个长期运行的管道,光靠全量重拉是不现实的——光是建筑一个主题,全量就在两亿五千万条以上。增量同步的骨架如下。
#-- 按要素类型分别同步:先对变更日志,再回源取新数据
import duckdb

con = duckdb.connect()
con.execute("INSTALL spatial; LOAD spatial;")
con.execute("INSTALL httpfs; LOAD httpfs;")
con.execute("SET s3_region = 'us-west-2';")

prev = "2026-09-23.1"
curr = "2026-10-21.0"

#-- added 与 data_changed 需要回源补齐属性,removed 只需在下游删除
rows = con.execute(f"""
  SELECT type, change_type, count(*) AS n
  FROM read_parquet(
    's3://overturemaps-us-west-2/changelog/{curr}/theme=places/*/*',
    filename=true, hive_partitioning=1)
  GROUP BY type, change_type
  ORDER BY n DESC
""").fetchall()

for t, c, n in rows:
    print(t, c, n)
这段只统计了变更分布,没有回源下载。实际同步时,added 与 data_changed 两类要按 id 回到对应的数据分区取行,removed 只需要在下游按 id 删除。三类分开处理,比整表重拉快一个数量级。
要注意的是 prev 这个值不能省,也不能随便填。变更日志只描述相邻两次发布之间的差异,跳过一个版本就会漏掉中间的变化;如果中间隔了两个月以上,公共存储里已经找不到旧版,只能走全量重建。
§7 评估层:不该按什么标准评它
§7.0 前置校正:这不是一份「数据集」,是一套「数据产品线」
在给 Overture 打分之前,先要把评价对象校正过来。
普通数据集的评价框架假设对象是一个冻结的集合:一共有多少条、覆盖哪些字段、标注质量如何。Overture 不是冻结的。它每月重发一次,每次发布是一个带日期的新产品,上一版两个月后从公开桶里消失。你评价的若是「一份数据集」,那连评价对象本身都会过期。
正确的评价对象是这条产品线:它的模式是否稳定、它的身份机制是否可靠、它的来源是否可追溯、它的许可是否清晰。这也是本节使用 DAIMS 框架时的口径——DAIMS 在这里用来检查这条产品线在数据治理各环节的完备度,而不是用来给某一次发布打分。
§7.1 DAIMS 对照
DAIMS 是数字广告的标准化框架,但它对「标识、元数据、血缘、许可」四件事的划分方式,恰好适合描述一个跨源合并的地图产品线。以下按 DAIMS 的维度逐项对照。
| DAIMS 维度 | Overture 的做法 | 评价 |
|---|---|---|
| 标识(Identifier) | GERS ID,128 位随机 UUID,注册表为准 | 强。放弃可读性换取稳定性,判断清晰 |
| 标识覆盖 | base 与 building_part 不覆盖 | 弱。使用者须自己记住哪里没覆盖 |
| 元数据(Metadata) | Pydantic 生成的模式文档,逐列可查 | 强。比自由标签的语义清晰度高一个量级 |
| 血缘(Lineage) | sources 数组 + 桥接文件 | 中强。可追到上游记录号,但只在有桥接的主题 |
| 变更记录(Change Log) | 每版按要素记四态变更 | 强。这是跨版同步的关键件 |
| 许可表达(License) | 按主题分层,逐主题文档说明 | 中。分层清楚,但没有机器可读的逐要素许可标记 |
| 保留(Retention) | 公开桶留两个月 | 弱。长期复现须自建镜像 |
| 一致性(Consistency) | 字段名跨主题统一,类型受控 | 中强。跨主题的同一概念字段名一致 |
按这个表看,Overture 的长板在标识机制与元数据,短板在保留策略与许可的机器可读性。
§7.2 不该追问的问题
以下问题看似合理,但对这份数据的形态并不成立,问出来只会得到错误的结论。
「它的标注准确率是多少」——它不是一个带金标准的评测集,没有统一的准确率口径。官方给的是来源分布、融合规则与已知问题。
「它有多少 TB」——官方发布说明没有给出总体积,且总体积随主题与压缩参数变化。有意义的是要素数与长度,不是字节数。
「它能不能替代 OpenStreetMap」——关系是下游与上游,不是替代。官方在文档里反复把它描述为对 OSM 的翻译与叠加。
「它的 id 是不是可以解析出位置」——2025-06-25.0 之后不能,这是刻意的设计。
§7.3 该追问的问题
反过来,有四个问题值得在每个项目开始时问清楚。
第一,我需要的要素类型在 GERS 注册表的覆盖范围内吗?如果不在,跨版本同步方案要另设计。
第二,我的产品会对外发布吗?如果会,读到的主题里有几个是 ODbL 的?
第三,我需要的粒度在官方承认的覆盖薄弱区之内吗?县级以下行政单元、全球南方的建筑,都需要单独验证。
第四,我需要的复现周期长于两个月吗?如果是,现在就得规划镜像。
§7.4 用华盛顿那栋楼检验一次
回到 §5.5 的例子。假设某人要做一份「联邦建筑」的专题地图,流程如下。
从 Buildings 取那栋楼的轮廓,得到 GERS ID 与 sources。从 Places 取同一位置附近的政府机构点位,得到另一批记录。从 Divisions 取它所在的 county,拿到行政面。
三份数据分属三个主题:Buildings 是 ODbL,Places 是宽松许可,Divisions 是 ODbL。合并成一张专题图之后,整体落在 ODbL 之下。若要把这张图作为数据产品发布,Places 那部分的宽松优势就被 Buildings 与 Divisions 的传染性覆盖了。
这就是许可分层在真实项目里的样子:不是「挑一个条款最宽松的主题」,而是「最终产物的许可由其中最严格的输入决定」。
§8 生态:它靠什么活着
§8.1 时间线
| 时间 | 事件 |
|---|---|
| 2022-12 | 由 AWS、Meta、Microsoft、TomTom 发起,隶属 Linux 基金会的联合开发基金会 |
| 2023-07 | 首个 alpha 数据版本 2023-07-26-alpha.0 |
| 2023-10 | 月度发布节奏开始,2023-10-19-alpha.0 |
| 2024-07 | 数据版本升到 1.0 系列,base、buildings、divisions、places 进入 GA |
| 2024-07 | 新增 addresses 主题,alpha 状态 |
| 2025-06 | 标识体系从 H3 哈希换成 128 位 UUID |
| 2026-09 | 数据版本进入 v2.0.0 模式 |
| 2026-10-21 | 当前版本 2026-10-21.0 |
这条时间线上有两个值得注意的转折。
第一个是 2024-07 的 GA 公告。那一版里,addresses 作为新主题加入,同时 divisions 主题把 boundary 要素类型改名为 division_boundary,并把 divisions 属性改成 divisions_id。改名这件事本身说明了一个问题:早期的要素类型命名是各主题各自为政的,直到那时才统一到「跨主题唯一」的规则上。
第二个是 2025-06 的标识重构。把带 H3 单元的哈希换成随机 UUID,等于承认「把语义编进标识」是一个错误。官方给出的理由是:当实体跨网格移动或换主题时,标识会碰撞;而从标识前缀做空间过滤从来就不可靠。
§8.2 它为什么能持续
这份数据能持续,靠的不是「开放」这个标签,而是三个具体的结构。
第一个是成员制。发起方是四家要做地图产品的公司,之后扩展成一众贡献公司。它们的动机是共同的:地图数据自建的边际成本极高,共享的边际成本低。这种动机让「每月重发」有了资金与人力的来源,也让社区贡献者知道该向谁提需求。
第二个是GERS 作为公共品。身份标识本身可以脱离 Overture 的数据单独使用。一个路况数据商可以只发路况、按 GERS ID 挂到路上,不必连路网一起发。这种「数据可分开卖、但能按 id 拼起来」的模式,把生态里其他参与者变成了它的使用者与推广者。
第三个是与 OpenStreetMap 的双向关系。Overture 拿 OSM 当骨架,同时鼓励把修正写回 OSM。Buildings 的官方文档明说:如果某栋楼有问题,去 OSM 改,下一版就会体现。这让它的维护负担部分转移到了 OSM 社区,而 OSM 也从这份数据里获得了一个大规模的使用场景。
§8.3 它在本库中的位置
本库的遥感与地理方向刚起步,已有的三条是与它关系最近却最容易被混淆的。
eurosat 是 64×64 像素的 Sentinel-2 瓦片分类基准,给的是像元矩阵与地表覆盖标签。它与 Overture 的唯一交集是空间:同一块地方,一个用像元描述,一个用多边形描述。
multimodal-satellite-data 是哥伦比亚的城市地面变化观测,时间序列与地面调查对齐。它的空间单元是街区,与 Overture 的 Divisions 有对应关系,但前者是观测序列,后者是边界几何。
aqs 是美国空气质量监测站点库,核心字段是站点经纬度。这些经纬度可以拿去与 Overture 的 places 或 divisions 连接,得到「这个站点在哪个市、周边有哪些设施」的上下文,但连接本身不改变 aqs 的数据性质。
world-bank-open-data 与 ucdp 是国家级或事件级的表格数据,与 Overture 的 Divisions 可以按国家代码或坐标连接,用于把统计量落到地图上。
gbif 是物种出现记录,带经纬度,可以与 Overture 的 land_cover 与 water 做空间叠加,研究物种分布与地表覆盖的关系。
这些连接都有一个共同前提:Overture 提供的是空间骨架,其他数据集提供的是附着在骨架上的观测值。这个分工也是矢量地图在 AI 流水线里的典型角色。
§8.4 镜像与替代入口
除了官方两个云,还有若干镜像:BigQuery、Databricks、Fused、Snowflake、Wherobots、Source Cooperative。这些是社区或平台方维护的,访问方式与数据新鲜度各不相同,官方把它们标注为「community-maintained」。
镜像的价值在于避免了跨云出网成本。一个已经在 BigQuery 里做分析的项目,从 BigQuery 读 Overture 比从 S3 读要省事得多。代价是镜像的更新节奏未必与官方同步,引用时要注明是从哪个镜像读的、读的是哪一版。
§8.5 它与商业地图的关系
这一层关系常被误解成「免费的 Google Maps 替代」,实际上差别很大。
商业地图服务卖的是一整套:底图、搜索、路线规划、实时路况、街景、以及背后的运营团队。Overture 只提供原料:要素、几何、属性。路线规划要用它的路网自己做,搜索要用它的地名自己建索引,实时路况完全不在范围内。
真正接近的类比是:它把过去各家地图公司各自维护的「底图」,变成了一份可以共同维护的公共资产,然后各家在上面做自己的产品。这也是它为什么强调 GERS——只有身份能对上,各家才能在公共底图上叠自己的差异层。
对中国大陆的使用者还有一层额外注意:数据的覆盖密度与监管环境与欧美不同,边界数据的表达涉及法域差异,不能直接当作国内地图产品的基础数据。
§9 实践指引:三条路径与一份最小实现
§9.1 三种角色,三条路
| 角色 | 主要诉求 | 推荐路径 | 首要风险 |
|---|---|---|---|
| 分析师 | 快速看一小块,验证可行性 | Explorer + Python 客户端 | 把 Explorer 看到的当作全量 |
| 工程师 | 接进数据处理管道 | DuckDB 直读 + STAC 版本发现 | 写死版本号导致两月后失效 |
| 研究者 | 可复现、可引用 | 自建镜像 + 写死版本 + 记录抓取日期 | 未留镜像导致无法复现 |
§9.2 接到 AI 流水线里的位置
Overture 在一条典型的 AI 流水线里处在特征与标签的供给端,不在输入端。
它不是训练样本的原始数据,因为训练样本要么是影像块,要么是文本,要么是表格。它的作用是提供这些样本的空间上下文与标注:用建筑轮廓生成掩码,用 land_cover 生成地表类型标签,用 divisions 做地理划分防泄漏,用 places 做地名与类别的弱标签。
这一定位决定了两个实践要点。第一,任何用到它的环节都应当把使用的版本号记进元数据,否则样本无法复现。第二,任何跨主题的连接都应当先做许可检查,再决定结果能不能发布。
§9.3 一份最小可跑的实现
下面这段把「取一个城市、一个主题、一小块范围」走完整,输出带版本标注的本地文件。
#-- 用 DuckDB 直读云端 GeoParquet,只取一小块,并记录版本号
import duckdb

con = duckdb.connect()
con.execute("INSTALL spatial; LOAD spatial;")
con.execute("INSTALL httpfs; LOAD httpfs;")
con.execute("SET s3_region = 'us-west-2';")

#-- 版本号不写死,从 STAC 根目录取
latest = con.execute(
    "SELECT latest FROM 'https://stac.overturemaps.org/catalog.json'"
).fetchone()[0]
print("当前版本:", latest)

sql = f"""
COPY (
  SELECT id, names.primary AS name, taxonomy.primary AS category, geometry
  FROM read_parquet(
    's3://overturemaps-us-west-2/release/{latest}/theme=places/type=place/*',
    filename=true, hive_partitioning=1)
  WHERE bbox.xmin BETWEEN 13.30 AND 13.50
    AND bbox.ymin BETWEEN 52.45 AND 52.55
) TO 'berlin_places_{latest}.parquet' (FORMAT PARQUET);
"""
con.execute(sql)
print(con.execute(f"SELECT count(*) FROM 'berlin_places_{latest}.parquet'").fetchone())
这段代码的三个设计点都与前文对应:版本号从 STAC 取,避免两月后失效;过滤用 bbox,让下推发生在扫描阶段;输出文件名带版本号,让产物可追溯。
§9.4 最少要报的三件事
任何一份以 Overture 为输入的研究,方法部分至少应当写清三件事。
第一,读的是哪个版本,什么时候读的。版本号与读取日期缺一不可,因为公共桶只留两个月,其他人未必能复现同一个版本。
第二,读了哪些主题与要素类型,各自的许可是什么。这一条不是为了合规形式,而是为了让使用者判断结果的可用边界。
第三,是否使用了镜像。官方两个云的版本是同一个,镜像的同步情况不保证,从镜像读到的结果应视为不同的取数来源。
§10 AI 使用声明
| 项目 | 内容 |
|---|---|
| 数据性质 | 公开矢量地图要素,非个人数据,非医疗数据 |
| 建议用途 | 空间上下文构建、地理划分、弱标签生成、地图底图 |
| 不建议用途 | 当作卫星影像替代品、当作穷尽性 POI 普查依据 |
| 许可注意 | 按主题分层,产物许可由最严格输入决定 |
| 版本锁定 | 引用具体日期版本,并自行留存或建镜像 |
| 标识注意 | 只有注册表内的 GERS ID 可跨版追踪 |
| 页面状态 | 已发布,最后核对 2026-10-29 |
常见误读
| 常见说法 | 实际情况 | 证据 |
|---|---|---|
| 「Overture 有五个图层」 | 当前是六个主题、十二种要素类型 | 云存储页的主题与类型映射表 |
| 「它整体是 ODbL」 | 四个主题 ODbL,地点是两个宽松许可,地址逐来源 | 各主题指南的 Sources 段 |
| 「Places 也是 OSM 来的」 | Places 不含任何 OSM 要素,故不带 ODbL 传染性 | Places 指南显式声明 |
| 「Base 的行政边界与 Divisions 重复」 | Base 不含行政区划,Divisions 才是 | Base 六类型清单里无 boundary |
| 「每月发布,旧版随时能下」 | 公开桶只留最近两个月 | 发布日历的数据保留政策 |
| 「id 里能看出经纬度和主题」 | 2025-06-25.0 起改为随机 UUID | GERS 文档说明 |
| 「所有 id 都能跨版追踪」 | base 与 building_part 不在注册表 | GERS 文档明确排除 |
| 「它是 OSM 的替代品」 | 它是 OSM 的下游合并者与翻译层 | Base 指南的 pass-through 描述 |
| 「Parquet 就是普通表格」 | 地理列是 WKB,需要 spatial 扩展 | 查询示例均先 LOAD spatial |
| 「地址主题也是稳定主键」 | 地址不进 GERS,属性一改就换 id | Addresses 指南的已知问题 |
| 「下载整份数据不会太大」 | 建筑单主题就有二十多亿要素 | 发布说明的要素数表 |
附录 A 图层清单
| 主题 | 要素类型 | 几何 | 主要来源 | 许可 |
|---|---|---|---|---|
| addresses | address | 点 | OpenAddresses、AddressForAll 等一百七十五个以上 | 逐来源 |
| base | bathymetry | 面 | ETOPO1、GLOBathy | ODbL(主题级) |
| base | infrastructure | 点线面 | OSM | ODbL |
| base | land | 面 | OSM 海岸线取反 | ODbL |
| base | land_cover | 面 | ESA WorldCover | ODbL(主题级) |
| base | land_use | 面 | OSM landuse 标签 | ODbL |
| base | water | 面 | OSM | ODbL |
| buildings | building | 多边形 | OSM、Google、Microsoft、Zenodo、Esri、IGN、温哥华市 | ODbL |
| buildings | building_part | 多边形 | OSM | ODbL |
| divisions | division | 点 | OSM、geoBoundaries | ODbL |
| divisions | division_area | 面 | 同上 | ODbL |
| divisions | division_boundary | 线 | 同上 | ODbL |
| places | place | 点 | Meta、BrightQuery、Microsoft、Foursquare 等 | CDLA-Permissive 2.0 / Apache 2.0 |
| transportation | segment | 线 | OSM、TomTom | ODbL |
| transportation | connector | 点 | OSM、TomTom | ODbL |
附录 B 字段与主键
| 字段 | 类型 | 说明 |
|---|---|---|
| id | 字符串 | GERS ID 或确定性 UUID,见 §3.3 |
| version | 整数 | 要素的版本序号 |
| geometry | 几何 | WKB,需 spatial 扩展 |
| bbox | 结构体 | 外包框,空间下推首选列 |
| names | 结构体 | primary 加各语言标签 |
| sources | 数组 | dataset、record_id、update_time、confidence |
| class / subclass | 字符串 | 分类,跨主题命名一致 |
| confidence | 浮点 | 融合置信度,仅部分主题有 |
| is_land | 布尔 | 仅 division_area |
| is_territorial | 布尔 | 仅 division_area |
| hierarchies | 数组 | 仅 division,从国家到自身的 id 链 |
主键规则一句话:认注册表,不认字符串。
附录 C 术语表
| 术语 | 含义 |
|---|---|
| Overture Maps Foundation | 2022 年由 AWS、Meta、Microsoft、TomTom 发起的开放地图基金会 |
| 主题(theme) | 顶层的分区单位,当前六个 |
| 要素类型(type) | 主题下的次级分区,当前共十二种 |
| GERS | 全球实体参考系统,提供跨源稳定标识 |
| GERS 注册表 | 记录标识稳定性承诺的清单 |
| 桥接文件 | 上游记录号到 GERS ID 的映射 |
| 变更日志 | 逐要素记录增删改的产物 |
| GeoParquet | Parquet 的地理扩展,列式存储加几何元数据 |
| WKB | 几何的二进制编码 |
| PMTiles | 单文件矢量瓦片格式,Overture 仅供检视 |
| STAC | 时空资产目录,Overture 用它索引全部版本 |
| ODbL | 开放数据库许可,带传染性 |
| CDLA-Permissive | 社区数据许可,宽松型,无传染性 |
| 衍生数据库 | 与 ODbL 数据合并后形成的整体 |
| 集体数据库 | 与 ODbL 数据并列存放、分开分发的自有数据 |
| IoU | 交并比,建筑融合的匹配度量 |
| 线性引用 | 属性只作用于线段一部分的表达方式 |
| churn | 两次发布之间的要素更替比例 |
| full freeform | 地址的自由文本形式 |
附录 D 常见误读 FAQ
问:六个主题是不是近两年才拆出来的?
不是拆出来的,是逐步加出来的。最初只有 buildings、roads 这类基础层,2024-07 加了 addresses,2025-2026 期间 base 内部细分为六个类型,divisions 在 2024-04 替换了旧的 admins 主题。这是个只增不减的过程。
问:Base 里有行政边界吗?
没有。Base 的六个类型是 bathymetry、infrastructure、land、land_cover、land_use、water。行政边界在 Divisions。
问:为什么建筑主题的许可会覆盖到机器学习来源?
因为整个主题以 ODbL 发布,所以每个被纳入的来源必须在 ODbL 或兼容许可之下。官方明说加入前会做许可兼容性核验。
问:能不能只用 Places,完全避开 ODbL?
可以用 Places,但要看你怎么用它。只读、不合并、不分发衍生库,是安全的。一旦与 OSM 或其他 ODbL 主题合并发布,产物仍可能落入 ODbL。
问:latest.ddb 是什么?
是官方托管的 DuckDB 文件,每个要素类型一个视图,挂载后按名字查。适合探索,不适合复现,因为它跟着最新版走。
问:为什么用 bbox 不用 geometry 过滤?
bbox 是预先算好的最小外包框,能在扫描阶段下推,代价低。geometry 的判定要读出几何之后才做,全表扫描。
问:交通数据的「一条路」为什么这么长?
因为属性是线性引用的,一条线段可以承载多个区间上的不同属性,不必在属性变化处切断几何。要切成单属性段,官方提供了一个 splitter 工具。
问:地址主题为什么还在 alpha?
因为它缺一个稳定的匹配器。目前的匹配靠精确值比对,属性一变就产生新 id,无法做出稳定性承诺,因此不进注册表。
问:Explorer 里能看到的范围就是全量吗?
不是。Explorer 加载的是 PMTiles 瓦片,覆盖范围与瓦片层级有关,官方明说这些瓦片仅供检视,不保证在生产中使用。
问:它和 GPS 或轨迹数据是什么关系?
没有直接关系。轨迹是移动个体的时间序列,Overture 是静态的路网。轨迹匹配路网可以用 Overture 的 segment 做地图匹配,但那是在用它的几何,不是用它的观测。
附录 E 许可分层与合规
按使用场景给出的合规线索,不构成法律意见。
| 场景 | 涉及主题 | 主要义务 | 建议动作 |
|---|---|---|---|
| 内部探索与分析 | 任意 | 无对外分发义务 | 记录版本号即可 |
| 内部产品使用 ODbL 主题 | Base、Buildings、Divisions、Transportation | 署名,衍生库回授 | 在产品里写明 ODbL 提示 |
| 公开发布地图产品 | 同上 | 署名,衍生库以 ODbL 发布 | 评估哪些部分是衍生库 |
| 公开发布 POI 产品 | Places | 保留 CDLA 与 Apache 的署名 | 逐来源清点 |
| 把 Places 与 OSM 合并 | Places + OSM | 可能触发 ODbL | 参见 OSM 集体数据库指引 |
| 发布合并多主题的产品 | 全部涉及 | 由最严格输入决定 | 默认按 ODbL 规划 |
| 训练模型 | 全部 | 分发衍生数据时才有义务 | 区分「学参数」与「存数据」 |
| 发布地址数据 | Addresses | 逐来源适用 | 逐条建来源清单 |
署名的最小形式可以直接沿用官方的串:© OpenStreetMap contributors, Overture Maps Foundation。这是 Explore 工具页面上的写法,也是覆盖 ODbL 义务的最小集合。
编辑说明
核验时间 2026-10-29。方法:直接读取官方文档站的发布日历、schema 概览、各主题指南、GERS 文档、云存储访问页与当前版本发布说明;读取基金会网站与 Linux 基金会的成立公告,确认发起方与隶属关系。未下载任何数据文件,未做要素数与体量的核对性重算,因此文中所有数量均为官方发布说明的原文口径。体积方面,官方发布说明只给要素数与长度,未给总体积,故本文不提供 TB 级估计,以免臆造。当前版本的数据规模(建筑二十五亿余、地点八千八百余万、地址四亿七千五百余万)取自 2026-10-21.0 的发布说明;其中建筑一项在该版说明中标注为「无变化,沿用九月版数据重新发布」。许可分层以各主题指南的 Sources 段为据,地址主题因来源过多,仅给出分层原则与几个代表来源。与投稿预设不符处已在正文更正,主要集中在:主题数由五改为六、新增 addresses 主题;Base 网页版许可中的行政区划实际归属 Divisions;当前版本号与 schema 版本;以及与 OpenStreetMap 的关系应表述为下游合并而非替代。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- nhanes — 共享标签:公共卫生与流行病学 / 调查数据
- brfss — 共享标签:公共卫生与流行病学 / 调查数据
- nhis — 共享标签:公共卫生与流行病学 / 调查数据
- mics — 共享标签:公共卫生与流行病学 / 调查数据
- dryad — 共享标签:公共卫生与流行病学 / 调查数据
- chns — 共享标签:公共卫生与流行病学 / 调查数据
- elsa — 共享标签:公共卫生与流行病学 / 调查数据
- hunt-study — 共享标签:公共卫生与流行病学 / 调查数据
- nsduh — 共享标签:公共卫生与流行病学 / 调查数据
- namcs — 共享标签:公共卫生与流行病学 / 调查数据
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
