信息速览
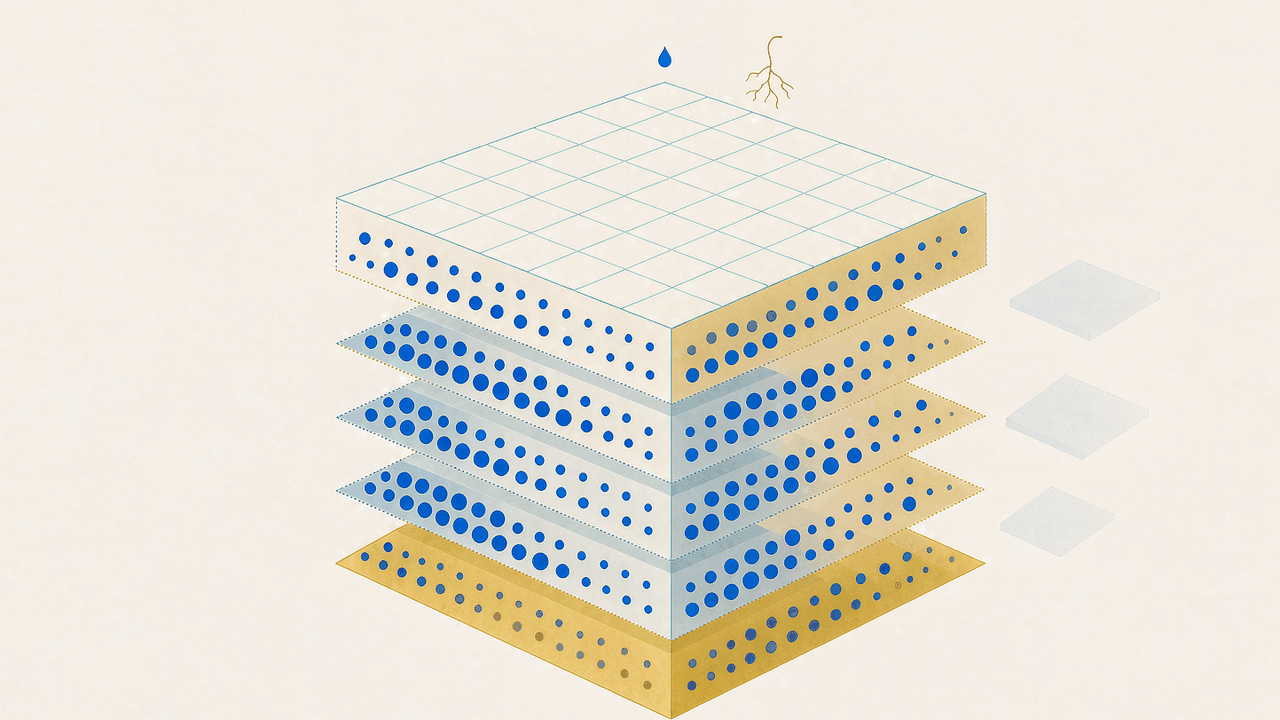
SoilGrids 是全球土壤数据里被引用得最多、被误解得也最深的一份。它把一个连续的自然介质切成了 250 米见方的方格,每个方格、每一层深度、每一个属性,都给出五个数字:一个均值、三个分位数、一个不确定度。这不是一份观测记录,而是一份带自我怀疑的预测。
它的分量不在于分辨率——250 米在遥感里算粗的——而在于它把「这个格子有多不确定」做成了可以直接下载的图层。绝大多数全球栅格只给你一个数,然后让你自己去猜这个数有多可信。
对做农业、水文、碳循环、土地退化评估的人来说,这是少数几个能直接进模型、还能顺手做敏感性分析的公开底图。但它同时是一份 2020 年的快照,一个自 2021 年后没再整版重跑的产品,一条 latest 路径下面藏着的不是「最新」,而是「最后一次全量」。
| 项目 | 数值 | 来源 |
|---|---|---|
| 空间分辨率 | 250 米 | ISRIC 介绍页与 FAQ |
| 标准深度层 | 6 个(0–5 至 100–200 cm) | GlobalSoilMap 规范,官方沿用 |
| 连续属性 | 11 个(250 米版) | data/ 目录实际列出 |
| 每层产品数 | 5 个(mean、Q0.05、Q0.5、Q0.95、uncertainty) | 各属性子目录 |
| 全图网格 | 159,246 列 × 58,034 行 | clay_0-5cm_mean.vrt 头 |
| 单图瓦片子文件 | 3,749 个(以 clay 0–5 cm 均值层为例) | 同前 VRT 的 SourceFilename 计数 |
| 训练剖面 | 约 24 万条、逾 92 万个土层 | Poggio 等 2021 摘要 |
| 环境协变量 | 400 余层 | 同上 |
| 投影 | Interrupted Goode Homolosine | VRT 的 SRS 字段 |
| 许可 | CC-BY 4.0 | ISRIC 介绍页原文 |
| 主引用 | 10.5194/soil-7-217-2021 | SOIL 7:217–240 |
§1 速览:它是什么,也不是什么
§1.1 一句话定义
SoilGrids 是 ISRIC 用机器学习把全世界零散的土壤剖面观测「铺」成一张全球栅格的结果:输入是约 24 万条剖面和 400 余个环境协变量,输出是 250 米网格上 11 个属性在 6 个深度上的预测值,每个格子配三个分位数和一个不确定度。
这句话里每个词都要抠。「铺」意味着它是对观测的内插与外推,不是观测本身;「剖面」意味着训练样本在地理上极度不均;「预测值」意味着每个格子都有一个置信区间,而这个区间在数据稀薄的地方会宽到没有实用价值。
§1.2 三层身份
第一层身份是土壤属性的全球底图。做作物模型的人拿它当土壤参数表,做水文模型的人拿它当田间持水量的先验,做碳核算的人拿它当 0–30 cm 有机碳储量的基线。这一层用法最朴素:把栅格裁到研究区,读进模型,结束。
第二层身份是带不确定度的概率产品。SoilGrids 2.0 相对上一代最大的改动不是分辨率,而是把分位数回归森林的整套输出都放了出来:不只有中位数,还有 5% 与 95% 分位,以及一个派生出的相对不确定度。这让它成为少数几个可以拿来做「保守决策」的全球栅格:要修水库,取 Q0.05 的渗透性;要算碳汇上限,取 Q0.95。
第三层身份是一份可以被审计的模型产物。每个产品的 VRT 文件头部都写着模型版本、树的数量、变换方式、训练数据快照,甚至写着这一版哪里有缺口。这种把「我们哪里没做好」写进文件头部的做法,在全球栅格产品里并不常见。
§1.3 三十秒决策卡:你的处境,它能帮你什么
| 你的处境 | 它能帮你什么 | 代价 |
|---|---|---|
| 手上有一个流域水文模型,缺土壤参数 | 直接给 6 层容重、粒径、有机碳,按深度加权 | 参数是 250 米尺度的有效值,与模型网格要对齐 |
| 要做区域尺度的施肥处方图 | 用 Q0.05 的黏粒含量做保守配方,避免过量 | 单田块尺度误差大,必须用本地采样校正 |
| 要估一个国家的 0–30 cm 有机碳储量 | ocs 层直接给吨/公顷,乘面积即可 | ocs 与 soc×bdod×深度 的乘积不完全自洽 |
| 要评估某个全球模型对土壤参数的敏感性 | 三个分位数天然构成扰动集合 | 分位数之间高度相关,不是独立抽样 |
| 要找一份能代表 2024 年土壤状况的数据 | 它给不了,输出停在 2020 年那一版 | 重新训练需要 WoSIS 授权与算力 |
| 要查一个点的土壤剖面化验单 | 它给不了,这是栅格不是剖面库 | 需要 WoSIS 点数据或国家土壤库 |
§1.4 不适合谁
不适合点位尺度的农艺决策。一个 250 米像元覆盖 6.25 公顷,中国北方一个村民小组的耕地可能只有三十亩;把像元值直接当田块值用,误差可能超过本地实际变异的一倍。
不适合需要时间序列的研究。SoilGrids 没有时间维。目录名里没有年份,文件名里没有日期,VRT 里没有时间戳。多次下载得到的文件若有差异,那是产品更新,不是土壤变化。
不适合要引用「最新数据」的合规场景。latest 是路径别名,不是版本号。核验时该路径下的瓦片文件时间戳集中在 2020 年 4 月,聚合版是 2022 年 6 月,校验清单是 2023 年 1 月。三个时间点说的是三件不同的事:预测产出、聚合重算、清单重签。
不适合把不确定度当方差用的统计建模。uncertainty 层的定义是四分位距与中位数之比,是一个无量纲的相对量,在中位数趋近 0 的地方会发散。
§1.5 贯穿本文的案例:一个县的水稻施肥处方图
后面每一章都会回到同一个场景,因为土壤栅格的价值只有在具体决策里才看得清。
某南方水稻主产县,农业农村局要在全县 1,800 平方公里的耕地上出一张氮肥基肥处方图,按方给补贴。他们手上没有本县土壤普查数据,最近一次普查是二十年前,且只覆盖了 12% 的耕地。预算允许买一次商业土壤采样,两百个样点,平均每 9 平方公里一个。
他们的技术路线是:用 SoilGrids 的黏粒、砂粒、有机碳、容重四层做基础参数,用两百个采样点做残差校正,最后按 Q0.05 的黏粒含量给保守配方。这条路的每一步都会踩到本文后面要讲的坑——latest 路径停在哪一年(§6)、不确定度层能不能直接当方差用(§4)、ols 层与 soc×bdod 的乘积为什么不自洽(§2),以及为什么他们最后发现「两百个点校正 250 米栅格」在数学上是个亏本买卖(§8)。记住 §1.5 的案例,比记住任何一个字段名都有用。
§2 数据构成:305 个产品怎么数出来的
§2.1 十一个连续属性,加两个非属性目录
data/ 根目录下一共 13 个目录,按字母序是 bdod、cec、cfvo、clay、landmask、nitrogen、ocd、ocs、phh2o、sand、silt、soc、wrb。
前十个加 ocs 是 11 个连续属性,覆盖容量、化学、粒径、养分、碳五个方面:容重(bdod)、阳离子交换量(cec)、粗碎屑体积占比(cfvo)、黏粒(clay)、粉粒(silt)、砂粒(sand)、全氮(nitrogen)、有机碳含量(soc)、有机碳密度(ocd)、有机碳储量(ocs)、水浸 pH(phh2o)。
landmask 与 wrb 不是属性。landmask 是一张陆表掩膜,整个目录里只有一个文件 landmask_SG_052020_COG512.tif,约 684 MB,2020 年 5 月生成,加一个校验清单。它的作用是告诉你哪些像元有土壤预测、哪些是水面或无数据,避免把海洋当零值。
wrb 是 World Reference Base 土壤类型的概率分布,结构完全是另一套,留到 §2.5 单说。
§2.2 六个深度,但 ocs 只有一个
深度是 GlobalSoilMap 工作组定的六个标准区间:0–5、5–15、15–30、30–60、60–100、100–200 厘米。前三个是表土分层,后三个是心土与底土。这套切法的好处是与大量已有土壤调查的采样层段对得上,坏处是层界不等于发生层界,一个跨 15 厘米边界的耕作层会被硬切开。
目录名把深度写成 0-5cm,短横线相连,不带下划线,不带 cm 后的点。写成 0_5cm 或 0-5 都会 404。
ocs 是唯一的例外:它只有一个深度,0-30cm。原因是土壤有机碳储量本身是一个累积量,30 厘米是国际通用的碳核算标准深度(对应 IPCC 的矿质土上层),按 5 厘米分层的储量没有约定俗成的意义。所以 ocs 目录下只有 5 个子目录,不是 30 个。
这一处不一致经常把人绊住:写循环时按「6 个深度 × 5 个产品」去遍历,跑到 ocs 就会抛异常。
§2.3 五个产品:均值、三个分位数、一个不确定度
每个(属性,深度)组合下有 5 个并列目录,后缀分别是 _mean、_Q0.05、_Q0.5、_Q0.95、_uncertainty。
三个分位数里,Q0.5 就是中位数,mean 是均值。两个都给了,说明分布不对称——对数正态或偏态分布下,均值会被右尾拉高。什么时候用哪个,是有讲究的(见 §4.5)。
uncertainty 不是标准差,也不是方差。它的定义是四分位距除以中位数,即 (Q0.95 − Q0.05) / Q0.5 一类的相对离散度。这个定义的好处是与量纲无关,可以横向比较黏粒和 pH 的可信度;坏处是中位数接近 0 时比值发散,pH 在酸性极强的土壤上、有机碳在贫碳沙地上,都会出现数值巨大但没有实际意义的格子。
数一下总量:10 个属性各 6 个深度、每个深度 5 个产品,得 300;ocs 一个深度 5 个产品,得 5。合计 305 个产品目录,每个目录对应一个 .vrt 文件放在属性目录下(如 clay/clay_0-5cm_mean.vrt)。这 305 个 VRT 是整份数据的主入口。
§2.4 一个产品的解剖
以 clay_0-5cm_mean 为例,它由三样东西组成。
第一样是 clay/clay_0-5cm_mean.vrt,一个约 1.7 MB 的 XML 文件,声明了整幅全球栅格的行列数、投影、地理变换、波段数据类型、无效值,以及一张长长的源文件清单。GDAL 打开这个 VRT,看到的就是一整幅连续的全球图;实际读某个窗口时,它按需去取对应的瓦片。
第二样是 clay/clay_0-5cm_mean/ 下的 tileSG-* 目录。这个产品有 1,131 个这样的目录,每个目录名形如 tileSG-000-019,前两位与后三位是行号与列号。目录里面是若干 450×450 像素的 GeoTIFF 子文件,命名形如 tileSG-000-019_4-4.tif,末尾的 _r-c 是子瓦片在父块内的行列。
第三样是每个目录里的 checksum.sha256.txt。子瓦片目录给一行,只校验那一个 tif;属性目录级、顶层目录级也各有清单。这是整份数据唯一的内建完整性机制。
VRT 引用源文件用的是 ComplexSource 而不是简单的 SimpleSource,这让文件比同类 VRT 大三到四倍,但也让每个瓦片可以带自己的统计量与缩放。代价是:用文本编辑器打开 VRT 会看到几万行 XML,别试图人眼读完。
§2.5 wrb 是另一套结构
wrb/ 下有 31 个目录:30 个 WRB 土壤类型的英文复数名,加一个 MostProbable。
30 个类型是 Acrisols、Albeluvisols、Alisols、Andosols、Arenosols、Calcisols、Cambisols、Chernozems、Cryosols、Durisols、Ferralsols、Fluvisols、Gleysols、Gypsisols、Histosols、Kastanozems、Leptosols、Lixisols、Luvisols、Nitisols、Phaeozems、Planosols、Plinthosols、Podzols、Regosols、Solonchaks、Solonetz、Stagnosols、Umbrisols、Vertisols。
这份名单本身就是一条边界信息:里面有 Albeluvisols,没有 Retisols。Albeluvisols 在 WRB 2014 版里被并入 Retisols,说明这套分类沿用的是更早的 WRB 版本。名单里也没有 Anthrosols 与 Technosols 这两个与人为土相关的类型,城市与矿区基本落在其他类的高概率区或低概率区里。
每个类型目录下是 100 个 tif,名字是 0.tif 到 99.tif,没有任何深度后缀,也没有 VRT。同样的内容还各有一份 .geotiff 扩展名的副本,体积一致。也就是说 wrb 一个类型目录里躺着 200 个栅格文件,一半是重复的扩展名变体。
MostProbable 是 30 个概率层的 argmax 结果,给的是类型编码而非概率。要用它,必须先拿到编码与类名的对应表,而这个表不在下载目录里,得从官方文档或 REST API 的 schema 里找。
§2.6 输入:24 万条剖面、92 万个土层、400 层协变量
SoilGrids 2.0 的论文摘要写得明确:输入是「全世界约 24 万个位置」的土壤观测,配合「400 余个全球环境协变量」,涵盖植被、地形、气候、地质、水文五类。正文里进一步说明,这一版用了约 24 万条剖面、超过 92 万个土层记录,比上一版多出 6 万余条剖面。
另外还有一个数字常被混进来:WoSIS 2023 快照包含 22.8 万条剖面、分布在 21.7 万个样点。这是 WoSIS 数据库自身的规模,不是 SoilGrids 的训练集。SoilGrids 这一版的训练数据是 2020 年 3 月的快照(VRT 头写 WoSIS_version: Data stream 7),两者不是同一批数据,数量也不同。把 22.8 万当 SoilGrids 的训练样本数,是把上游数据库的现状扣在了下游产品上。
WoSIS 2023 那篇论文还顺带解释了一件对使用者很重要的事:2019 至 2023 年间各机构共享给 ISRIC 的 10.7 万条剖面里,只有 3.4 万条因为数据提供方的许可限制能够进入快照。土壤数据的第一道门槛不是技术,是授权。
§3 结构层:命名、投影与像素账
§3.1 命名公式
一个产品的完整路径是:
data/<property>/<property>_<depth>_<statistic>.vrt
data/<property>/<property>_<depth>_<statistic>/tileSG-<行>-<列>/tileSG-<行>-<列>_<r>-<c>.tif
属性名用小写缩写,深度用 起-止cm,统计量用 mean、Q0.05、Q0.5、Q0.95、uncertainty 五种之一。
这条公式有一个容易踩空的地方:点号。Q0.05 里的点是文件名的一部分,在 shell 里要引号,在 Python 里要当普通字符。写成 Q05 会得到 404 而不是报错,因为服务器只是找不到这个目录。
另一处是 tileSG 后面没有下划线,直接跟短横线;子瓦片才是下划线加分格号。看错一层,拼出来的路径就全错。
§3.2 投影:不是等经纬度
VRT 的 SRS 字段写的是 PROJCS["Interrupted_Goode_Homolosine", ...],像元大小 250 米见方,地理变换的左上角是 (-19949750, 8361000)。
这意味着三件事。
第一,这不是经纬度网格。全球 1 度格子在不同纬度对应的米数不同,而这里每个像元都是 250 米乘 250 米,面积守恒。做面积统计、做碳储量汇总时,这一点让求和变得简单:数像元乘 6.25 公顷即可。
第二,Interrupted Goode Homolosine 是分瓣的。为了让大陆连续、把海洋切开,这个投影在特定经线处断口。断口附近的像元在平面上相邻,在地球上可能隔了半个大洋。任何基于平面邻域的卷积、窗口统计、连通域分析,在断口处都会出错。
第三,从经纬度到行列号必须做投影变换,不能线性换算。随手写 col = (lon + 180) / 360 * width 是错的,误差在低纬度就能到几十个像元。
§3.3 像素账:159,246 × 58,034
VRT 头给出 rasterXSize="159246"、rasterYSize="58034",两者相乘约 92.4 亿个像元位置。这是整幅投影范围的完整包围盒,包含大片没有土壤预测的海洋与冰盖。
真正有数据的位置由瓦片清单决定。以 clay 0–5 cm 均值层为例,VRT 里列了 3,749 个源文件,每个 450×450 像素,约 7.6 亿个像元有值。这个差距说明一件事:不要按包围盒去估算数据量。按 92 亿像元乘 2 字节算会得到 18 GB,比实际大一个量级。
单幅图的真实体积要看瓦片总和。一个 450×450 的 Int16 瓦片,压缩后在一百多 KB 到几百 KB 之间(赤道附近块大、极区块小),3,749 个加起来在 GB 量级。规划存储时按 GB 而不是按 TB 估算,按属性乘深度乘产品,全套 250 米数据的量级是几百 GB。
§3.4 dtype 与 nodata:两种类型并存
属性层与分位数层是 Int16,无效值 -32768。
uncertainty 层是 UInt16,无效值 65535。
同一个属性目录下,clay_0-5cm_mean.vrt 与 clay_0-5cm_uncertainty.vrt 的波段类型不同。如果有代码写了「按属性统一读成 Int16」,读不确定度层时就会把 65535 溢出成 -1,或者把大值截断。
还有一处更隐蔽的不一致:均值层 VRT 的 SRS 里写的是 GCS_WGS_1984 ellipse,不确定度层写的是 GCS_WGS_1984。两者指的是同一个基准面,但 PROJ 字符串不同,gdalwarp 在拼接两类层时可能判定坐标系不一致而拒绝直接叠加,需要显式 -s_srs 指定。
这不是缺陷,是两批产物分别生成留下的痕迹。知道它存在,比争论它该不该存在有用。
§3.5 数值标度:整数存储,要除以因子
栅格存的是整数,物理量是小数。每个属性有自己的缩放因子。
以 clay 为例,VRT 头里的统计量写着 STATISTICS_MAXIMUM=658、STATISTICS_MEAN=244.5。黏粒含量的物理上限是 100%,所以 658 对应 65.8%,因子是 10。同理 phh2o 存的是 pH 乘 10,32767 的上限对应 pH 3.3 到 10 左右的实际范围。
但因子不是全局统一的。容重存的是 cg/cm³、有机碳密度存的是 hg/m³、有机碳储量存的是 t/ha,各自的换算系数不同。判断某个属性的因子,最稳的办法是看官方图层说明里的单位列,次稳的办法是看 VRT 头的统计极值反推。
这条坑的破坏力在于它不报错。忘除 10,模型照跑,只是所有黏粒含量都大了十倍,土壤质地分类全错,而且从损失曲线上看不出来。
§3.6 目录树长什么样
data/
├── clay/
│   ├── clay_0-5cm_mean.vrt
│   ├── clay_0-5cm_mean/
│   │   ├── tileSG-000-019/
│   │   │   ├── checksum.sha256.txt
│   │   │   └── tileSG-000-019_4-4.tif
│   │   └── tileSG-000-020/
│   ├── clay_0-5cm_Q0.05.vrt
│   ├── clay_0-5cm_uncertainty.vrt
│   └── ...
├── landmask/
│   ├── checksum.sha256.txt
│   └── landmask_SG_052020_COG512.tif
├── wrb/
│   ├── Ferralsols/
│   │   ├── 0.tif
│   │   ├── 0.geotiff
│   │   └── ...
│   └── MostProbable/
└── ocs/
    └── ocs_0-30cm_mean.vrt
顶层还有三样东西常被忽略:data_aggregated/(1 公里与 5 公里聚合版)、legends/(每个属性的 QGIS 样式 qml 与 OGC SLD)、docs/(论文 PDF 与一份旧版协变量清单 CSV)。
§3.5 瓦片编号与投影:为什么不能按经纬度直接算行列
瓦片目录名形如 tileSG-000-019,其中 SG 指 Interrupted Goode Homolosine 投影的南半球分支(Northern/Southern/Global 的分支标识随之不同),后两段是该分支下的行列索引。这个编号体系与经纬度没有线性关系,也不能靠整除推出来。
后果是两件事。第一,想取某个市范围的数据,不能靠「算出对应瓦片号再下载其中几个」来省流量,只能走 VRT 让 GDAL 处理。第二,跨瓦片拼接必须依赖 VRT 或 gdalbuildvrt,手工 merge 容易在瓦片接缝处出现半像元错位。
全库的 VRT 都带 GeoTransform 与 SRS,这两项是唯一权威。按 §1.5 的案例,县域裁切时必须显式传 -t_srs EPSG:4326,否则 GDAL 会按 VRT 原有的等积投影输出,后续与行政边界叠加时会出现数十米的系统性偏移——在 250 米格网上这已经足以跨过一档。
§3.6 缩放因子:读到 658 不是 658%
多数属性按整数存储,真实值需要乘一个缩放因子。clay、sand、silt、bdod、soc 等常用属性的因子是 0.1,所以 658 表示 65.8%,15 表示 1.5。phh2o 的因子不同,nitrogen 与 ocd 的单位也不是百分数。
缩放因子写在 VRT 的 <Scale> 与 <Offset> 元素里,而不是写在目录名或文档首页。用 gdalinfo 能读到,用 numpy 直接读 .tif 读不到——这是 §8 表里「值就是物理量,直接进模型」那一条的根源。稳妥的做法是先 gdal_translate -unscale 落地,或在读取时显式应用 VRT 声明的因子,并把因子一并写进处理日志。
§4 质量层:不确定度怎么读
§4.1 九十区间与相对离散度
三个分位数直接给出 90% 预测区间的下界与上界:Q0.05 与 Q0.95。这不是置信区间——它描述的是「在这套模型与这套协变量下,真实的土壤属性值有九成概率落在这个范围里」,属于预测区间,包含模型误差也包含空间变异。
回到 §1.5 的案例。他们原本想用 uncertainty 层当权重,做「不确定度高就多采样」的布点设计,这个思路在概念上是对的,但直接拿比值当方差用会出事:县里有几片丘陵地的黏粒中位数接近 20%,uncertainty 大约 0.15;而河谷冲积区有些像元中位数只有 3%,uncertainty 冲到 0.6 以上。后者的绝对值波动其实远小于前者,但比值把它抬成了「最不可信的地方」。按比值布点,两百个点会有一大半撒在本来就不需要精查的砂质河滩上。
区间宽度除以中位数,就是 uncertainty 层的内容。它是一个相对量,单位是「倍」。数值 0.5 意味着这个格子的 90% 区间宽度约为中位数的一半。
读法上有个陷阱:宽区间不一定代表预测差。在土壤属性本身变异极大的地方(冲积平原的粒径、火山灰土的磷吸附),即使模型很好,区间也会宽。反过来,在中位数接近零的地方,区间哪怕很窄,比值也会很大。判断一个格子可不可信,看绝对宽度比看相对宽度更可靠。
§4.2 官方对精度的说法
论文的评估结论有两句关键表述:定量指标与前人在全球、洲际、大区尺度上的研究「处于同一水平」;定性评估显示「粗尺度格局被很好地再现」。
这两句话合起来的意思是:大尺度格局可信,小尺度细节不可信。落到实操上,拿 SoilGrids 画一张全国土壤质地分区图,形态是对的;拿它去判断某块地的黏粒是不是超过 30%,就得看那个格子的区间宽度。
论文还明确指出,全球尺度的空间不确定度分析表明「需要更多土壤观测,尤其是在高纬度地区」。这是作者的自我评价,不是外部批评。
§4.3 缺口写在了文件里
VRT 头的元数据里有一行容易被忽略的字段:Outputs_abstract,内容是 no WISE, March 2020 snapshot, NZ and Siberia gaps。
翻译过来:这一版没有并入 WISE 数据库,训练数据是 2020 年 3 月的快照,新西兰与西伯利亚存在缺口。
新西兰与西伯利亚是全球土壤数据的老大难:前者是岛国、剖面少且分散;后者面积巨大、冻土采样成本极高。这两个区域的预测基本靠协变量外推,可信度显著低于欧洲与北美。
§4.4 两百厘米以下没有答案
六个深度止于 200 厘米。这不是因为土壤只有两米深,而是因为 GlobalSoilMap 规范把标准剖面定在 2 米,且大多数土壤调查的描述深度也止于此。
对深根系作物、地基工程、地下水补给评估,200 厘米以下的信息是缺失的,不能靠最后一层的值往下延拓。VRT 里所有深度层的下边界都是硬截断,没有「更深层」的占位。
另一个相关边界是岩层。SoilGrids 的属性层在基岩出露的地方仍然给出数值——因为模型不知道那里没有土。有独立产品给有效土层厚度,但不在本数据集里。把属性层直接乘深度算储量,在浅薄土地区域会系统性高估。
§4.5 什么时候该用 Q0.05 而不是 mean
这是整份数据最实用的一个设计,也是最容易被浪费的一个。
均值层的语义是「期望值」。用它做规划,等于假设误差会互相抵消。但工程与农业决策往往不是对称的:施肥不足会减产,施肥过量会污染;堤坝渗透性低估会溃坝,高估只是多花钱。这类场景要的是保守分位数,不是期望。
豫北砂壤土麦区的一个变量施肥项目就是这么用的。项目要在一块两万亩的连片麦田上生成基肥处方图,约束是氮肥总量不能超,同时不能让任何一块地缺氮。做法是:用 nitrogen 的 0–30 cm 与 30–60 cm 两层,分别取 Q0.05 与 Q0.5,前者算保底供应量,后者算常规供应量,两者之差作为「风险缓冲」,再按地块均摊。
这个用法只有在有分位数层时才成立。如果数据只给均值,项目只能自己假定一个误差范围,而假定出来的范围没有任何空间信息——它无法告诉你哪块地更不确定。
§4.6 它给不了的东西
给不了点位真值。250 米像元的预测中位数,与一个 10 厘米土钻的化验结果,支撑尺度差了六个数量级。拿后者去校验前者,得到的「误差」里绝大部分是尺度不匹配,不是模型错误。
给不了时间变化。这不是时间序列,不能算年际差异、不能做趋势检验。
给不了管理信息。没有土地利用、没有耕作方式、没有施肥历史。wrb 给的是土壤类型,不是土壤状态。
给不了本地校准。ISRIC 不做区域化重训服务,产品是全局一套模型。
§5 获取层:三条路与它们的现状
§5.1 WebDAV 匿名读,不需要注册
入口是 https://files.isric.org/soilgrids/latest/data/。用浏览器打开会看到一个 WsgiDAV 的目录索引页,页面顶部明确写着当前用户是 anonymous、权限 read-write。
这带来一个反直觉的事实:这个 WebDAV 端点允许匿名写入。它显然不是给公众写数据用的,但协议层面没有拦。任何自动化脚本都不该往里面写东西,也不该假设它永远可写。
访问方式有三种:浏览器直接点、WebDAV 客户端挂载、或者用 HTTP 直接 GET 文件。第三种最快,因为目录索引页本身只是 HTML,真正的文件路径可以直接拼。
§5.2 用 VRT 而不是逐个下瓦片
不要下载瓦片。VRT 的存在就是为了让你不用下载瓦片。
GDAL 支持 /vsicurl/ 直接读远程文件,VRT 里的相对路径会被解析成同目录下的 HTTP 请求。所以打开一个远程 VRT 就能按需只取需要的瓦片,代价是每次读都要走网络。
gdalinfo /vsicurl/https://files.isric.org/soilgrids/latest/data/clay/clay_0-5cm_mean.vrt
这条命令会输出投影、尺寸、波段类型与统计量,几秒钟返回,不会下载整幅图。
要长期使用,正确做法是下载 VRT 加需要的瓦片,保持目录结构不变,让 VRT 的相对路径仍然指得到。VRT 只有 1.7 MB,瓦片按需取舍。
§5.3 聚合版:1 公里与 5 公里
data_aggregated/ 下有两个分辨率:1000m 与 5000m。结构比 250 米版简单得多:每个属性每个深度一个 COG 文件,只有 mean,没有分位数,没有不确定度。
5000m 版一个深度一个文件,约 9 MB,六个深度加起来五十多 MB,全球尺度做快速预览、做教学演示、做粗分辨率模型,这一版是最省事的入口。
1000m 版每个深度约 190 MB。它的价值在于:当你不需要 250 米细节但需要比 5 公里更细时,它是唯一选项。
聚合版还多出三个属性:wv0010、wv0033、wv1500,分别是 10、33、1500 千帕吸力下的体积含水率。这三个属性在 250 米版里没有,只在聚合版里有。所以「14 个属性」这个官方数字,只有在算上聚合版时才成立。
§5.4 REST API 目前是停的
ISRIC 在 SoilGrids 介绍页顶部挂了公告:REST API 出现问题,服务已暂停,且无法给出恢复时间表;公告同时说明这个 API 本就是测试阶段,不承诺可用性,并建议改用其他更稳定的访问方式。
核验时 rest.isric.org 的查询端点无响应,与公告一致。
这意味着网上大量教程里那句「一行 API 查任意经纬度的土壤属性」现在跑不通。依赖它的流水线必须改成读 VRT 或读瓦片。这也是 latest 路径的价值所在:文件式接口比服务式接口抗停服。
§5.5 WCS 与 WMS
maps.isric.org 仍在响应,提供 OGC 服务。对 GIS 用户,WCS 可以直接按范围取子集,比下载瓦片省事;对脚本用户,WCS 的 URL 拼装比 /vsicurl/ 麻烦,且取不到分位数层之外的元数据。
两者取舍:要批量、要可复现、要离线,走文件;要交互看图、要少量点位,走服务。
§5.6 校验:每个目录都有清单
每个瓦片目录、每个属性目录、每个顶层目录都有 checksum.sha256.txt。格式是标准的 sha256sum 输出:哈希加两个空格加文件名。
cd clay_0-5cm_mean/tileSG-000-019
sha256sum -c checksum.sha256.txt
这条命令在目录内执行,会逐行校验并打印 OK 或 FAILED。批量校验可以写成循环,对每个 tileSG-* 目录进一次。
注意清单里的文件名是相对路径,跨目录执行会全部报 missing。
§5.7 一次读一个点
用 rasterio 读某个经纬度下的值,需要先把经纬度投影到 IGH:
import rasterio
from rasterio.warp import transform
from pyproj import CRS

url = "/vsicurl/https://files.isric.org/soilgrids/latest/data/clay/clay_0-5cm_mean.vrt"
lon, lat = 114.35, 36.10

with rasterio.open(url) as src:
    xs, ys = transform("EPSG:4326", src.crs, [lon], [lat])
    row, col = src.index(xs[0], ys[0])
    window = rasterio.windows.Window(col - 1, row - 1, 3, 3)
    block = src.read(1, window=window)
    nodata = src.nodata
    valid = block[block != nodata]
    clay_pct = float(valid.mean()) / 10.0 if valid.size else float("nan")

print(clay_pct)
这段代码做了三件容易被省略的事:投影转换、取 3×3 邻域而不是单像元(避免落在无值格子上)、除以 10 还原量纲。
src.index 返回的是行与列,顺序不能反。取 3×3 是为了抗单像元噪声,代价是空间精度下降一个像元。
§5.8 一次裁一块
要给一个县的范围裁图,用 gdalwarp 加 -te 与 -t_srs 最省事:
gdalwarp -t_srs EPSG:4326 \
  -te 113.5 35.2 115.2 36.8 \
  -tr 0.0025 0.0025 \
  -r bilinear \
  /vsicurl/https://files.isric.org/soilgrids/latest/data/clay/clay_0-5cm_mean.vrt \
  clay_0-5_county.tif
-te 用的是目标坐标系下的范围,所以要和 -t_srs 一起看。-tr 0.0025 约等于赤道上的 250 米,在高纬度会变成更窄的实际距离,做面积统计时要留意。
重采样用 bilinear 是安全的,因为属性是连续量。切到 wrb 的概率层时要换 nearest,否则会把类型编码混成不存在的值。
§5.5 匿名可写这件事,比它听起来严重
WebDAV 目录页把访问权限标成 read-write。这不是文档笔误,是服务端真的没拦写入请求。对使用者来说这有两层含义。
第一层是操作风险。任何一个脚本里的 PUT、MOVE、DELETE,只要路径写错一位,改动就落在公共产品目录上。用 rclone 做双向同步尤其危险:同步工具的正确行为是「让目标与源一致」,而这里的「源」是 ISRIC 的产品目录。一次误配的 sync 就足以把本地目录结构投影上去。
第二层是完整性风险。既然目录可写,那么「从官方 WebDAV 下载的文件」这句话,严格说来不构成完整性保证。真正能当凭证的只有两样:一是 checksum.sha256.txt 里的哈希值,二是 VRT 头部写着的模型版本与树的数量。校验哈希是唯一能把「我下的这份」和「ISRIC 发布的那份」绑定起来的手段。这一点在 §1.5 的案例里也被沿用——方案书要求随数据一并归档校验清单,否则复核时无法证明数据未被改动。
顺带一句:/vsicurl/ 直读 VRT 的用法很方便,但它只做范围读取,不做哈希校验,也不缓存校验结果。生产流程里应当先用 wget 落地并核哈希,再用 gdalwarp 处理本地文件。
§5.6 三条路的取舍
| 场景 | 该走哪条 | 理由 |
|---|---|---|
| 一次性裁一个小区域 | /vsicurl/ 直读 VRT |
无需落地 TB 级数据,GDAL 自动做范围读取 |
| 要长期复现的实验 | wget 落地 + 核 sha256 |
只有哈希能把文件与发布批次绑定 |
| 要批量取多个属性多层 | rclone 同步指定子目录 | WebDAV 支持目录列举,比逐文件拼接路径可靠 |
| 要接入 GIS 桌面 | OGC WCS / WMS | 服务端做重投影与裁切,客户端不用装 GDAL |
| 要按点查值 | 官方 REST 已暂停 | 只能本地裁切后自己采样 |
§6 版本与身份:latest 停在哪一年
§6.1 三个时间戳说的是三件事
latest 目录下三类文件的时间戳分布很能说明问题。
250 米瓦片的时间戳集中在 2020 年 4 月前后。这是预测产出的时间。
聚合版(1000m、5000m)的时间戳是 2022 年 6 月。这是聚合重算的时间。
各目录的 checksum.sha256.txt 时间戳是 2023 年 1 月底到 2 月初。这是清单重签的时间。
§1.5 的案例里,方案书原本写「采用 SoilGrids 最新版本(2026 年下载)」,这句话在评审会上被退回过一次。评审专家指出:2026 年下载不等于 2026 年的土壤。这个县最后在方案里改成「采用 ISRIC SoilGrids 2.0 产品,瓦片产出批次 2020 年 4 月」,并附上 VRT 头部的模型版本号作为凭证。改一行字,把一项无法答辩的表述变成了一项可追溯的表述——这是 latest 这种路径别名最容易被忽视的代价。
看到一个 2023 年的清单,不能推断数据是 2023 年的。清单重签可能只是换了哈希算法或补了漏项。
§6.2 latest 是别名,不是版本
路径里的 latest 是一个稳定别名。它的设计意图是让引用链接长期有效,代价是内容会在某次整版更新时整体替换。
对论文写作,这既是好事也是风险。好处是不用维护版本号;风险是三年后有人重跑你的代码,拿到的可能是另一版数据。
稳妥做法是引用时同时写清版本与访问日期,并把用到的 VRT 下载存档。VRT 有 1.7 MB,存档成本极低,而它完整记录了模型参数与训练快照,是最小可复现单元。
§6.3 与 WoSIS 的关系:上游与下游
WoSIS 是数据库,SoilGrids 是它的一个消费者。WoSIS 持续更新(2023 快照、之后还会有新的),SoilGrids 只在整版重跑时同步一次。
所以「SoilGrids 是最新全球土壤数据」这句话在 2021 年成立,在 2026 年不成立。它是一份用 2020 年数据训练、2021 年发表、之后没再全量重跑的产物。
想用更新的剖面数据,得去 WoSIS 下载点数据自己做插值,或者等下一次整版重跑。
§6.4 与 SoilGrids1km 的关系:前辈
2014 年的 SoilGrids1km 是这一系列的第一代,分辨率 1 公里,用的是随机森林点预测,没有分位数输出,训练样本约 13 万条剖面。
从 1 公里到 250 米,从单值到分位数,从随机森林到分位数回归森林,两代之间的差别不只是精度,是产品哲学:第一代给答案,第二代给答案加怀疑。
现在还有论文与教程在引用 1km 版的结果,检查方法是否过时,第一步是看它引的是 2014 还是 2021。
§6.5 引用哪一篇
主引用是 Poggio 等 2021 年发表在 SOIL 上的方法论文,DOI 10.5194/soil-7-217-2021,卷 7、页 217–240,2021 年 6 月 14 日出版。
三个含水率属性(wv0010、wv0033、wv1500)另有专文:Turek 等 2023 年发表在 International Soil and Water Conservation Research 上的文章,讲用 WoSIS 映射 100、330、15000 厘米吸力下的体积含水率。
训练数据的引用是 Batjes 等的 WoSIS 快照论文,2024 年那篇对应 2023 快照,DOI 10.5194/essd-16-4735-2024。
如果只引一条,引方法论文;如果用到含水率,加引 Turek;如果讨论数据来源与许可限制,加引 Batjes。
§7 阅读本节前:三种评价错位
§7.0 先摆正评价框架
SoilGrids 最常被批评的三件事,恰恰是它设计上就放弃了的三件事。在拿任何标准去评价它之前,得先确认那个标准是不是用对了地方。
§7.1 错位一:拿点观测去验证栅格
一个常见的验证流程是:找几十个有化验数据的样点,取对应像元的预测值,算 RMSE,然后宣布「误差很大」。
这个流程的问题在支撑尺度。一个样点代表几十立方厘米的土,一个像元代表 6.25 公顷、深 5 厘米、约 3,000 立方米的土体。前者是后者的十亿分之一。用前者去否定后者,等于用一根体温计去质疑一张气候图。
正确的验证设计是:在像元尺度上取多个样点混合成一个复合样,或者用块克里金把点数据升尺度到像元,再比较。这样得到的误差才是模型误差,而不是尺度失配误差。
§7.2 错位二:拿分类精度评价连续属性
SoilGrids 的属性层是连续量,评价指标应该是偏差、均方根误差、区间覆盖率(真实值落在 90% 区间内的比例)。
用总体精度、Kappa 系数去评价它,是把回归当分类。唯一适合用分类指标的是 wrb 层,而 wrb 层给的是概率,正确的评价是 Brier 分数或对数损失,不是混淆矩阵。
区间覆盖率这个指标值得单独说。它问的不是「预测准不准」,而是「你给的区间诚实不诚实」:如果官方说 Q0.05–Q0.95 覆盖九成真值,那么在一个足够大的独立样本上,落在区间外的比例应该接近 10%。偏低说明区间太宽(保守但浪费信息),偏高说明区间太窄(自信过头,下游会误判风险)。这个指标的好处是它不需要你重新训练模型,只需要一批像元尺度的独立真值,就能对产品的「硬度」下判断。
§1.5 的案例在这一步遇到了实际困难:两百个样点里真正能当像元尺度真值用的不到三十个(其余是单点土钻,尺度太细)。三十个点算覆盖率,置信区间宽到没有结论。他们的处理是把覆盖率检验改成「分区检验」——按地貌单元分三组,每组各自算覆盖率,看是否有系统性偏离。这不能替代全量检验,但能回答「这套产品在我们县是不是明显偏乐观」这个更粗但更有用的问题。
§7.3 错位三:要求一个 2020 年的产品回答 2025 年的问题
土壤是慢变量,十年尺度的变化在多数地区小于模型误差,所以「2020 年的图能不能代表现在」这个问题,在自然土壤上答案通常是能;在集约农区、复垦区、城市扩张边缘,答案是可能不能。
判断标准不是年份,是土地利用是否发生了变化。有变化的地方,土壤剖面在几年内就能被翻转、压实、掺混。这类区域用 SoilGrids 要先用地类变化数据做掩膜。
另一个常被忽略的错位是空间错位:产品用的是等积投影的 250 米格网,而研究区常用的行政边界、流域边界、田块边界与这个格网毫无关系。直接按行政单元做分区统计,等于把每个像元按「中心点落在哪个县」整块分配,边界上会有系统性偏斜。正确做法是按面积加权做面域统计,而不是按像元中心点归属。这一步在县级尺度上误差通常不到 1%,但在乡镇、村级尺度上能到 5% 以上,足以改变分档结果。
§7.4 DAIMS 简表
| 维度 | 情况 | 说明 |
|---|---|---|
| 数据来源可溯 | 强 | 上游 WoSIS 逐条记录带提供方与许可 |
| 方法透明 | 强 | 论文给了模型、协变量、验证与不确定度方法 |
| 版本可辨 | 中 | latest 别名长期有效,但版本号只写在 VRT 元数据里 |
| 更新节奏 | 弱 | 2020 年产出后无整版重跑,无 changelog |
| 不确定度 | 强 | 分位数层与相对不确定度层同时提供 |
| 空间完整度 | 中 | 全球陆地,但新西兰、西伯利亚有缺口 |
| 时间信息 | 不适用 | 静态属性图,无时间维 |
| 许可清晰度 | 强 | CC-BY 4.0,介绍页与 FAQ 均写明 |
| 访问稳定性 | 中 | 文件接口稳定,REST API 停服 |
| 文档完备度 | 中 | 论文详尽,但目录结构、缩放因子分散在多个页面 |
§8 常见误读与避坑清单
| 常见说法 | 实际情况 | 证据 |
|---|---|---|
| 「13 个属性目录就是 13 个属性」 | 13 个目录里只有 11 个是连续属性,landmask 是掩膜,wrb 是分类概率 | data/ 根目录清单 |
| 「官方说有 14 个属性,下载下来少三个」 | 缺的三个 wv0010、wv0033、wv1500 只在 data_aggregated/ 的 1 km 与 5 km 版里 |
两个聚合版目录各有 14 个子目录 |
| 「每个深度 4 个产品」 | 是 5 个:mean、Q0.05、Q0.5、Q0.95、uncertainty | 任一属性子目录列出 30 项(6×5) |
| 「分位数目录叫 Q05」 | 叫 Q0.05,点号是名字的一部分 |
clay/clay_0-5cm_Q0.05/ 返回 200,Q05 返回 404 |
| 「ocs 也有 6 个深度」 | ocs 只有 0-30cm 一个深度,共 5 个产品 |
ocs/ 目录只有 5 项 |
| 「wrb 也是分层栅格」 | wrb 没有 VRT、没有深度维,每类由 0.tif–99.tif 拼成,另有一份 .geotiff 重复 |
wrb/Ferralsols/ 目录内容 |
| 「训练样本 23 万条」 | 这一版用的是约 24 万条剖面、逾 92 万个土层;23 万是 WoSIS 2023 快照的剖面数,不是训练集 | Poggio 2021 摘要;Batjes 2024 §4.1 |
| 「uncertainty 是标准差」 | 是四分位距与中位数之比,无量纲,中位数趋零时发散 | 官方图层说明;uncertainty 层为 UInt16 |
| 「栅格是经纬度网格,可以直接按经纬度算行列号」 | 是 Interrupted Goode Homolosine 等积投影,必须先做坐标变换 | VRT 的 SRS 与 GeoTransform |
| 「值就是物理量,直接进模型」 | 多数属性按 10 倍整数存储,clay 的 658 对应 65.8% | VRT 头 STATISTICS_MAXIMUM |
| 「latest 就是最新一版,2026 年下的就是 2026 年的数据」 | 瓦片是 2020 年产出,聚合版 2022 年重算,清单 2023 年重签 | 各目录 Last modified |
| 「WebDAV 是只读的」 | 匿名用户权限为 read-write,协议层没拦写入 | 目录页 access: read-write |
| 「用 REST API 查点最方便」 | 官方公告已暂停该服务且无恢复时间表 | ISRIC 介绍页顶部公告 |
这张表里最贵的一条,是 §1.5 那个县真正踩到的那条。
§1.5 的案例最后算了一笔账:两百个采样点,若按常规「用采样值校正栅格残差」的做法,每个点能校正的影响半径大致是 1 公里量级——因为 250 米栅格的误差在空间上是高度自相关的,相邻像元往往是同一批训练剖面外推出来的,误差不独立。两百个点摊到 1,800 平方公里,覆盖率不足 11%。也就是说,那笔采样费买回的是「局部校正」,不是「全县标定」。他们最终把方案改成两段:用 SoilGrids 直接出全县处方图的相对分级(分五档,只保证档间有序),用两百个点做分档阈值的本地校准。不动绝对值,只动分界线——这才是预算和精度能对上的做法。
这也解释了为什么本文反复强调「先看它是什么,再看它准不准」。栅格产品的合理用法,往往不是把它当数值,而是把它当排序。
| 「分辨率 250 米意味着定位精度 250 米」 | 250 米是像元边长,不是位置精度;投影断口附近平面邻接不等于地理邻接 | IGH 投影的分瓣特性 |
§9 它在本库里的位置
§9.1 与 ERA5、GHCNd 的分工
ERA5 单层再分析给的是大气状态,GHCNd 给的是站点观测,SoilGrids 给的是地表以下的介质属性。三者叠起来,才凑成一个完整的地表系统描述:气候驱动、观测约束、下垫面参数。
它们的时间性质完全不同。ERA5 是逐小时的,GHCNd 是逐日的,SoilGrids 没有时间维。做陆面模型时,前两者是输入序列,后者是静态参数表。混用时最容易犯的错是把 SoilGrids 也当成可以逐月更新的变量。
§9.2 与 EuroSAT 的分工
两者都是栅格,都是全球或大洲尺度,但一个是分类任务,一个是回归任务。
EuroSAT 的瓦片是影像,任务是从像素判类别;SoilGrids 的像元是属性值,任务是把值放进模型。前者关心空间泄漏,后者关心尺度失配。
一个有意思的连接是:做土地利用分类时,SoilGrids 的质地层可以作为后验约束——某种作物不会长在某种质地上。这种用法在本库里是跨条目的,需要在流水线里自己接。
§9.3 与 GBIF、世界银行数据的连接
GBIF 的物种出现记录带经纬度,落到 SoilGrids 的像元上,就能给每条记录附一组土壤属性。这是生态位建模里最常见的用法之一:把土壤作为环境变量,解释物种分布。
世界银行的国别指标里有一批与农业、土地退化相关的量,SoilGrids 可以作为这些指标的物理基础层——例如用 ocs 层算一个国家的土壤碳储量,与世行的农业增加值放在一起看。
§9.4 检索路径
要找「全球尺度的自然地理底图」,本库里目前只有这一条。要找「气象驱动」,去 ERA5;要找「地面观测」,去 GHCNd;要找「地表覆盖分类基准」,去 EuroSAT。
土壤这个方向在库内是空白,SoilGrids 是第一块砖。后续可以补的方向有:WoSIS 点数据(上游)、HWSD(同类对照)、SoilGrids 的 30 弧秒镜像(第三方重采样)。
§10 为什么它能持续,以及 AI 使用声明
§10.1 生存逻辑
SoilGrids 能活下来,靠的不是精度,是三件事。
第一是可引用。它有一篇发在 SOIL 上的方法论文,有 DOI,有明确的作者列表,有可复现的方法描述。这让它在学术引用体系里是一个合法节点。
第二是可下载。它没有登录墙、没有申请表、没有使用协议弹窗。WebDAV 匿名读,一个 URL 就能拿到全球数据。这在土壤数据领域是罕见的——同领域的很多产品要么要邮件申请,要么明确禁止再分发。
第三是可组合。305 个产品目录按属性、深度、统计量三维正交拆分,任何子集都能单独下载、单独引用、单独校验。想只用 pH 的 0–5 cm 均值,就只下那一个 VRT 和它引用的瓦片,不需要碰其他 304 个。
§10.2 它撑不住的地方
REST API 的停服说明了一件事:服务式接口的可持续性远低于文件式接口。一个团队三个人维护的 API,一次故障就能停几个月;而一个静态文件目录,只要磁盘在、域名在,就能一直读。
更新节奏是另一个软肋。整版重跑需要重算全球 305 个产品、每个几 GB,算力与人力成本都不低。这决定了它不可能像气象再分析那样每年更新。
§10.3 用它的三条纪律
第一,存档 VRT。VRT 是这份数据的最小可复现单元,1.7 MB 买一个版本锁定,值得。
第二,先查 dtype 与缩放。每个属性读进来先看 src.dtypes、src.nodata、src.statistics(),再决定除以几。别信记忆。
第三,把不确定度一起带走。只下 mean 层等于扔掉了这份数据一半的价值。至少把 uncertainty 层一起下,做敏感性分析时它是现成的扰动源。
§10.4 AI 使用声明
本文的文本由 AI 辅助撰写,事实核验基于 ISRIC 官方介绍页、SoilGrids FAQ、WebDAV 目录清单、VRT 文件头元数据、Poggio 等 2021 年方法论文摘要与 Batjes 等 2024 年 WoSIS 论文。文中所有目录名、文件数、行列数、dtype、无效值、时间戳均来自文件系统与文件头的直接读取;属性数量、剖面数量、协变量数量来自官方页面与论文。未做全量下载,未做逐像元统计,未对预测精度做独立复算。
附录 A 属性速查
| 目录名 | 中文 | 每深度产品数 | 深度数 | 量纲要点 |
|---|---|---|---|---|
| bdod | 容重 | 5 | 6 | 按 cg/cm³ 存储,需换算 |
| cec | 阳离子交换量 | 5 | 6 | 按 mmol©/kg 存储 |
| cfvo | 粗碎屑体积占比 | 5 | 6 | 体积百分比 |
| clay | 黏粒含量 | 5 | 6 | 按 10 倍存储,658 即 65.8% |
| sand | 砂粒含量 | 5 | 6 | 按 10 倍存储 |
| silt | 粉粒含量 | 5 | 6 | 按 10 倍存储 |
| nitrogen | 全氮 | 5 | 6 | 按 cg/kg 存储 |
| soc | 有机碳含量 | 5 | 6 | 按 dg/kg 存储 |
| ocd | 有机碳密度 | 5 | 6 | 按 hg/m³ 存储 |
| ocs | 有机碳储量 | 5 | 1(0–30 cm) | 吨/公顷 |
| phh2o | 水浸 pH | 5 | 6 | 按 10 倍存储 |
| wrb | 土壤类型概率 | 100 个 tif/类 | 无 | 30 类加 MostProbable |
| landmask | 陆表掩膜 | 1 个文件 | 无 | 单幅 COG,约 684 MB |
附录 B 术语表
| 术语 | 含义 |
|---|---|
| WoSIS | ISRIC 维护的全球土壤剖面数据库,SoilGrids 的训练数据来源 |
| GlobalSoilMap | 国际土壤学联合会下的工作组,制定了六个标准深度的规范 |
| 分位数回归森林 | 随机森林的变体,能预测条件分布的多个分位数而非仅均值 |
| Q0.05 / Q0.95 | 5% 与 95% 分位数,构成 90% 预测区间的上下界 |
| 不确定度层 | 四分位距与中位数之比,无量纲的相对离散度 |
| Interrupted Goode Homolosine | 等积伪圆柱投影,分瓣以保持大陆连续 |
| VRT | GDAL 虚拟栅格,用 XML 把多个瓦片拼成一幅逻辑上的整图 |
| 瓦片(tile) | 本数据中为 450×450 像素的 GeoTIFF 子文件 |
| alr | 加性对数比变换,处理成分数据(粒径三组分)的标准方法 |
| 成分数据 | 各分量和为定值的数据,粒径百分比是典型例子 |
| 支撑尺度 | 一个观测或预测所代表的体积或面积,比较不同数据前必须先对齐 |
| 预测区间 | 描述单次预测不确定性的区间,与参数的置信区间不同 |
| WRB | 世界土壤资源参比基础,国际通用的土壤分类系统 |
| COG | Cloud Optimized GeoTIFF,支持分块与概览的远程读取格式 |
| 断口(interruption) | 分瓣投影中人为切开的经线,两侧平面相邻但地理不相邻 |
附录 C 常见误读 FAQ
问:为什么不直接给 GeoTIFF 整图,非要搞 VRT 加瓦片?
因为整幅图在 250 米下是 GB 量级,而绝大多数用户只需要一个县、一个流域。VRT 让「按需取块」成为默认行为,瓦片是它的实现方式。
问:mean 和 Q0.5 有什么区别,不是差不多吗?
在对称分布下接近,在偏态分布下差得远。土壤属性普遍右偏,均值会被高值尾部拉高,中位数更稳。要保守估计用 Q0.05,要期望用 mean,要稳健中心用 Q0.5。
问:能不能把六个深度加起来算整剖面储量?
不能直接加。每层给的是该层的含量或密度,算储量要乘层厚再乘容重,而容重本身也有误差。产品里已经给了 ocs,那是官方算好的 0–30 cm 储量,直接用比自算可靠。
问:新西兰为什么没有数据?
VRT 元数据自述 NZ and Siberia gaps。这两个区域剖面稀少,模型只能靠协变量外推,官方选择留空而不是给一个不可信的值。
问:能不能拿它做 30 米分辨率的图?
不能。降尺度需要额外的局部数据与模型,SoilGrids 没有提供降尺度产品。用双线性插值把 250 米插成 30 米,只是把同样的信息画得更细,不增加任何空间细节。
问:uncertainty 层的数值为什么有的特别大?
因为它是比值。中位数接近 0 的格子上,分母趋零,比值发散。看到上万的值先看对应的 mean 层是不是接近 0,而不是怀疑数据坏了。
问:wrb 的 .tif 和 .geotiff 有什么区别?
体积一致,内容一致,只是扩展名不同。挑一种用即可,不要两个都下载。
问:REST API 停了,还有没有官方的点查询服务?
介绍页建议改用其他访问方式。WCS 仍在,可以按范围取子集;点查询需要自己按经纬度投影后读像元。
编辑说明
核验时间 2026-10-29。方法:逐个打开 ISRIC 官方介绍页、SoilGrids FAQ、WebDAV 各层目录索引(data/ 根、13 个属性目录、clay 的 30 个子产品、单个 tileSG-* 目录、wrb/ 与 wrb/Ferralsols/、landmask/、docs/、legends/、data_aggregated/1000m 与 5000m),读取 clay_0-5cm_mean.vrt 与 clay_0-5cm_uncertainty.vrt 的头部元数据,下载并计数一个完整 VRT 的源文件条目;交叉核实 Poggio 等 2021 与 Batjes 等 2024 两篇论文摘要与相关段落。未下载栅格数据本体,未做逐像元统计与精度复算。
与常见转述不一致处已在正文逐条更正,主要有四处:官方「14 个属性」只在聚合版成立,250 米版是 11 个;每个深度的产品数是 5 个而非 4 个,目录名写 Q0.05 而非 Q05;训练样本是约 24 万条剖面、92 万个土层,不是 23 万;REST API 已由官方公告暂停,不能作为可用入口描述。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- nasa-exoplanet-archive — 共享标签:多模态 / 评测基准 / 图像分类
- randolph-glacier-inventory — 共享标签:多模态 / 评测基准 / 图像分类
- gaia-dr3 — 共享标签:多模态 / 评测基准 / 图像分类
- cern-cms-opendata — 共享标签:多模态 / 评测基准 / 图像分类
- sdss-dr20 — 共享标签:多模态 / 评测基准 / 图像分类
- esa-worldcover — 共享标签:多模态 / 评测基准 / 图像分类
- opentme — 共享标签:多模态 / 评测基准 / 图像分类
- biomedica — 共享标签:多模态 / 评测基准 / 图像分类
- qmugs — 共享标签:多模态 / 评测基准
- nejm-bench — 共享标签:多模态 / 评测基准 / 图像分类
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
