信息速览
INFOBOX — MODUS 一屏速览
维度 内容 本质 临床尿液沉渣多倍率显微目标检测数据集(非分类、非分割,是对象检测框标注) 团队 浙江大学(生物医学工程系 + 医学院检验医学系),杭州;合作者含白俄罗斯国立大学 Sergey Ablameyko 作者 Zhu Yunqi、Ye Xianfei、Yang Haixu、Liu Yuduo、Yang Dagan、Chen Yu、Xu Yingke(7 人,DataCite 顺序) 数据 3,181 张 = 10× 361 张 + 40× 2,820 张;标注 63,047 条;类别 22 类 平均密度 63,047 / 3,181 ≈ 19.8 条标注/图 倍率设计 10× 全局筛查 → 40× 形态精判(复现临床「先低倍后高倍」阅片流程);40× 占比约 88.7% 任务 多倍率显微图像的有形成分目标检测(bounding box) 发布 figshare 公开,posted 2026-05-09 12:39;DOI 10.6084/m9.figshare.31166800 收录 NLM Dataset Catalog 记录号 0003031853(MeSH:Deep Learning / Urinalysis) 许可 CC BY 4.0(三源一致,须署名 7 位作者) 论文 配套论文待刊(NLM 标 No Associated Publication(s),DataCite relatedIdentifiers 为空) 前置工作 HRGC-YOLO(YOLOv5m + Global Context,8 类,较 YOLOv5m +4.5% mAP) 库内互链 bccd(851)、mendeley-lbc(850)、herlev-pap(483)、acevedo-blood(722)、nih-malaria(502)
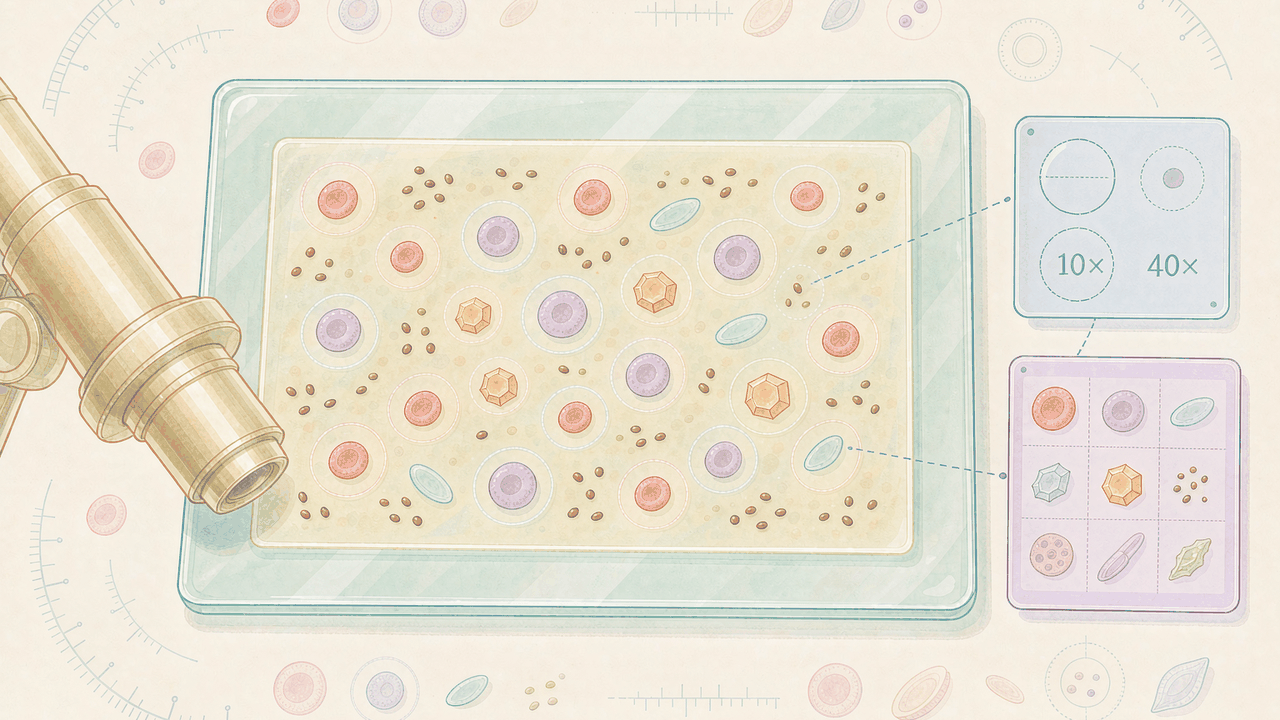
MODUS 是临床检验里最古老、最日常、也最容易被自动化忽略的一环——尿液沉渣镜检——交给现代目标检测模型的一份规模化数据底座。它把显微镜下 22 类有形成分(红细胞、白细胞、上皮细胞、管型、结晶、细菌、真菌等)逐一圈框标注出来,样本量做到 3,181 张图像、63,047 条检测框,并且刻意保留了 10× 与 40× 两个倍率:低倍看全景、高倍看形态,这正是检验科医师每天对着显微镜「先扫一遍、再凑近看」的动作。它的价值不在于提出一个更炫的模型,而在于把「尿沉渣镜检」这个长期依赖人工经验、结果难以复现的环节,翻译成了机器可以直接训练与评测的结构化任务。
导语读法三则:
- 只想下数据:直奔 §6 获取与许可——CC BY 4.0 可自由再分发与商用,但署名 7 位作者是硬要求;下载前先到 figshare 页确认文件体积(§9 遗留疑点 D1)。
- 关心任务定义:直奔 §4 与 §5——搞清「多倍率」和「22 类目标检测」到底意味着什么,别把它当成单倍率图像分类数据集用。
- 判断可用性:直奔 §7 与 §9——MODUS 目前没有官方 leaderboard、没有官方划分、配套论文待刊,这些边界决定了你能不能把它的数字直接拿去和他人的结果对标。
§0 导读:这个数据集解决什么问题
尿液分析(urinalysis)是临床上开得最多的检验项目之一。其中「尿沉渣镜检」环节要求检验人员把尿液离心后取沉渣涂片,在显微镜下逐视野辨认红细胞、白细胞、上皮细胞、管型、结晶、细菌、真菌等有形成分,并做出定量或半定量的判读。这一步高度依赖人工经验:细胞在视野里密集交叠、形态易混淆(比如皱缩红细胞与白细胞、酵母菌与红细胞在低倍下都像小圆点),不同检验人员的判读一致性难以保证,且工作量巨大。
过去十年,深度学习在显微图像分析上进展迅速,但面向尿沉渣的开源数据集长期存在三个短板:一是规模小,多数只有几百到一两千张图像,不足以支撑现代检测模型的训练;二是类别少,往往只覆盖红细胞 / 白细胞 / 上皮细胞等寥寥几类,缺临床常见的管型、结晶、细菌、真菌;三是倍率单一,而真实镜检是多倍率协同的——低倍用于普查、高倍用于精判,单倍率数据集无法复现这一流程。
MODUS 针对上述三点做出回应:它把规模推到 3,181 张图像 / 63,047 条标注,把类别扩到 22 类,并且明确采用 10× 与 40× 双倍率采集。任务被定义为目标检测(object detection):不仅要回答「这张图里有没有某种成分」,还要回答「它在视野的什么位置、有多大」,用边界框(bounding box)标出每一个目标实例。相较于分类(一张图一个标签)或分割(逐像素上色),检测框在标注成本与临床可用性之间取得了一个务实的平衡——既保留了位置与形态信息,又把标注成本控制在可规模化的范围内。
§0 读法三则:
- 这是一份临床检验域的数据集,不是通用显微数据集:它的类别体系来自尿沉渣镜检的临床术语,使用前建议先了解对应临床背景(§5)。
- 全文的规模数字(3,181 / 63,047 / 22)经 figshare、NLM Dataset Catalog、DataCite 三源互证一致;仅倍率细分(10×:361 / 40×:2,820)以 figshare 页为唯一明细源,已在 §4 与 §9 标注口径(坑 8)。
- 检索与引用时务必与 EPFL 的同名多模态生成模型 MODUS 划清界限——两者只是撞了名字,领域、内容、作者完全不同(坑 1),这是本条目最需要读者警惕的一处。
§0.1 尿沉渣镜检为什么难
要看懂 MODUS 的价值,先要理解它要解决的临床动作有多难。尿沉渣镜检的困难至少来自四个层面:
第一层:成分混杂。 一管尿液的沉渣里可能同时存在红细胞、白细胞、上皮细胞、管型、结晶、细菌、真菌、黏液丝等,每种的形态、大小、颜色各不相同,有的还相互粘连。检验人员必须在同一视野里把这些成分逐一辨别出来,并排除气泡、杂质、纤维等干扰物。
第二层:形态易混。 有些成分在低倍下长得几乎一样——皱缩红细胞与白细胞都是边缘不规则的小圆点,酵母菌与红细胞都是圆形。区分它们往往需要高倍观察、甚至结合其他线索(如临床背景、其他成分的存在)。这类「易混类对」是自动化判读的固有难点。
第三层:密度高。 一个视野里常有几十个目标,密集交叠。既要避免漏掉一个小目标(如单个细菌),又要避免把粘连的两个细胞误判为一个,这对检测模型是实打实的挑战。
第四层:一致性差。 即使同为专业人员,不同检验人员对同一张涂片的判读结果也可能不一致,尤其在边界类别上。这种「观察者间变异」意味着,即便是人工标注的「金标准」,本身也携带不确定性。
MODUS 的回应:用检测框把这四层困难结构化——把混杂的成分拆成独立实例(第一层)、用 22 类细粒度体系承载形态区分(第二层)、用密集框标注保留高密度场景(第三层)、用规模化数据为一致性研究提供基础(第四层)。它没有「解决」这些困难,而是为机器学习提供了可以开始工作的结构化起点。
§0.2 一份数据集能解决什么、不能解决什么
把期望值校准清楚,是使用任何医学数据集的第一步。对 MODUS:
| 它能解决 | 它不能解决 |
|---|---|
| 提供规模化、结构化的尿沉渣检测训练数据 | 提供官方评测协议与 baseline |
| 提供 22 类有形成分的类别体系 | 提供完整的类别定义文档与一致性报告 |
| 提供 10×/40× 多倍率的结构化数据 | 保证模型在真实临床现场的泛化 |
| 提供 CC BY 4.0 的可商用授权 | 提供伦理审查 / 临床验证背书 |
- 一句话:MODUS 是一份优质的训练与研发底座,但它本身不是一个可直接部署的临床系统,也不是一个已定标的评测基准。
§1 数据集速览:十问十答
Q1:MODUS 到底是什么?
MODUS 是一个面向临床尿液沉渣镜检的多倍率显微图像目标检测数据集,全名 “MODUS: a large-scale multi-magnification microscopic dataset for clinical urine sediment object detection”,由浙江大学团队发布,通过 figshare 以 CC BY 4.0 公开。一句话概括:它是「尿沉渣镜检」这个临床动作的大规模标注版底图。
Q2:「3,181 张」是怎么构成的?
3,181 张显微图像按显微镜放大倍率分为两组:10× 361 张、40× 2,820 张,两者相加恰为 3,181(361 + 2,820 = 3,181)。40× 组占约 88.7%,说明数据集以高倍形态细节图像为主体,低倍图像用于补充全局视野。
Q3:「63,047 条标注」指什么?
指全部图像上的目标检测边界框总数,平均每张图约 19.8 条(63,047 ÷ 3,181 ≈ 19.8)。也就是说,平均一个显微视野里有近 20 个被标注的有形成分实例——这个密度反映了真实尿沉渣涂片里细胞成群分布的特点。
Q4:「22 类」都是哪些类别?
覆盖临床尿沉渣镜检常见的有形成分:红细胞(erythrocyte)、皱缩 / 变异红细胞(crenated RBC)、白细胞(leukocyte)、上皮细胞(epithelial cell)、细菌(bacteria)、真菌(fungi)、结晶(crystals)、管型(casts)等。完整的 22 类逐类名称与类别定义边界未在公开字段逐条披露(§9 遗留疑点 D2),本条目按数据集定位与前置工作的 8 类基础作范围性描述,精确清单以数据集发布说明为准。
Q5:为什么要有「多倍率」?
因为临床镜检本身就是多倍率协同的:先用 10× 低倍扫全片、定位可疑区域与整体分布,再切到 40× 高倍逐个确认细胞形态与类别。MODUS 用 10× / 40× 两个倍率同时采集,让模型能学到「同一成分在不同放大倍率下的外观」,也更贴近真实的阅片工作流(§5)。这使它区别于绝大多数单倍率显微数据集。
Q6:任务具体是什么?分类还是分割?
是目标检测(object detection),标注形态为边界框(bounding box),不是整图分类,也不是语义分割 / 实例分割。模型需要在单张显微视野中定位每一个有形成分实例,并给出其类别。这意味着通用的检测指标(mAP@0.5、mAP@[.5:.95]、Precision、Recall)是它的自然评测口径。
Q7:谁做的,什么背景?
浙江大学团队,涉及生物医学工程系(Dept. of Biomedical Engineering)与医学院检验医学系(Dept. of Laboratory Medicine),合作者包括白俄罗斯国立大学(BSU)的 Sergey Ablameyko。团队在此之前做过 HRGC-YOLO(面向尿液沉渣的检测模型,基于 YOLOv5m + Global Context 模块,覆盖 8 类,相对 YOLOv5m 基线提升约 +4.5% mAP),MODUS 可视为该路线在更大规模、更细类别粒度上的数据底座。
Q8:许可和获取方式是什么?
CC BY 4.0(署名 4.0 国际):允许再分发、改编甚至商用,唯一硬性要求是署名(须注明数据集标题与 7 位作者)。获取方式为 figshare 公开下载,DOI 为 10.6084/m9.figshare.31166800。三源(figshare / NLM / DataCite)在许可上完全一致,无冲突。
Q9:有配套论文吗?有官方排行榜吗?
截至实核时点,配套论文尚未被索引(NLM Dataset Catalog 明确标注 “No Associated Publication(s)”,DataCite 的 relatedIdentifiers 为空数组)。因此也没有官方 leaderboard、没有官方 train/val/test 划分、没有官方 baseline 数值——想在 MODUS 上做对比实验,需要自行划分数据并明确标注你的划分方式(§7)。
Q10:它最容易被误用 / 误认的地方是什么?
两个。第一是撞名:另有一个 EPFL 的同名项目 MODUS(一个 decoder-only 的多模态 any-to-any 生成模型),搜 “MODUS dataset” 时极易混淆,必须按「urine sediment / 尿液沉渣」关键词锁定本数据集(坑 1)。第二是把它当成分类集:它的标签是检测框不是整图类别,用分类范式去加载会出错(坑 3)。
§1.1 十问之外:五个进阶问题
Q11:为什么平均每图有近 20 个标注?这正常吗?
正常,而且这正是尿沉渣镜检的真实样子。尿液离心浓缩后取沉渣涂片,一个 40× 视野里常常挤着几十个红细胞、若干白细胞和上皮细胞,偶尔夹杂细菌与结晶。63,047 ÷ 3,181 ≈ 19.8 条/图,反映的是「密度高、成群分布」的物理事实,而不是标注冗余。对检测模型而言,这意味着它不是那种「一张图一个大目标」的稀疏检测任务,而是密集小目标检测——这直接决定了模型选型(需要较好的小目标能力)与评测难度(密集场景下漏检与重复检是主要误差)。
Q12:10× 和 40× 的样本量为什么差这么多?
因为两个倍率承担的职责不同。40× 是高倍精判的主力:要区分皱缩红细胞与正常红细胞、要辨认管型类型与结晶种类,都必须在高倍下完成,因此需要大量高倍图像覆盖各种形态变体。10× 低倍图像主要承担「扫一遍全景、定位可疑区域」的作用,形态信息有限,数量需求自然少。即便如此,361 张 10× 图像仍提供了一定的低倍视野样本,使数据集能支撑「同一成分跨倍率外观」的研究(§4.2)。
Q13:这份数据的「临床可用性」到底如何?
从任务设定看是贴合临床的:检测范式直接对应检验人员「辨认每种成分并计数」的动作,22 类体系来自临床术语,双倍率对应真实阅片流程。但从「官方口径完备性」看又是留白的:没有官方划分、没有官方 baseline、标注一致性检验未公开。因此更准确的定位是——一份结构贴近临床、但评测口径尚未固化的数据底座。它适合做研究与模型开发,但在把它作为「临床级」证据前,需要研究者自行补足验证环节。
Q14:为什么说它「填了一个格子」,这个格子到底多空?
医学显微数据集里,外周血(BCCD 等)、宫颈细胞学(Herlev、SIPaKMeD 等)、疟疾血涂片(NIH Malaria)都有成熟公开集;唯独「尿液沉渣」这个在检验科日常开单量极大的项目,长期缺乏大规模公开标注集。原因不难理解:尿沉渣成分杂、形态细、类别体系复杂,标注门槛高。MODUS 的意义正在于把这个「最日常却最难标准化」的格子补上(§8.1)。
Q15:如果我要在论文里一句话介绍 MODUS,该怎么写?
建议写法:「MODUS 是一个面向临床尿液沉渣镜检的大规模多倍率显微目标检测数据集,含 3,181 张 10×/40× 图像与 63,047 条 22 类有形成分边界框标注,由浙江大学团队发布,以 CC BY 4.0 许可公开于 figshare。」这句话里每个数字都已三源互证,每个限定词(多倍率、目标检测、有形成分)都对应真实属性,可直接引用。
§1.2 读这个条目需要注意的三处口径
- 范围性描述 vs 官方清单:§4.4 的类别大类归纳是范围性描述,不是官方逐类清单;凡涉及具体某类数量,均为未实核(D2)。
- 三源一致 vs 单源明细:总量三源一致,倍率细分单源(figshare 页),两者在本条目中分别标注(坑 8)。
- 前置指标 vs 官方基准:HRGC-YOLO 的 +4.5% mAP 是前置模型指标,不是 MODUS 官方基准(坑 5)。
§1.3 为什么尿液沉渣值得做成数据集
初看之下,「尿液沉渣镜检」似乎是一个狭窄的检验科环节,不值得投入做大规模数据集。但从临床工作量的角度看,它的分量远比想象中重:
- 开单量巨大:尿常规(含尿沉渣)是全球范围内开得最多的检验项目之一,覆盖体检、门诊、住院、术前评估等几乎所有临床场景;
- 人工负荷重:镜检环节要求检验人员逐视野辨认与计数,耗时且依赖经验;
- 一致性差:细胞形态易混(皱缩红细胞 vs 白细胞、酵母菌 vs 红细胞),不同人员的判读一致性难以保证;
- 标准化难:正因为成分杂、形态细,尿沉渣镜检长期缺乏标准化的机器判读方案。
把这样一个「高频、高负荷、低一致性、难标准化」的环节做成结构化数据集,其潜在收益是直接的:一旦自动检测可靠,就能显著降低镜检的人工负荷、提升判读一致性、并为大规模筛查提供可扩展的技术路径。这正是 MODUS 这类数据集的现实意义所在——它不是为发论文而生,而是为一个真实且高负荷的临床环节提供机器可用的数据底座。
§1.4 数据集的「一句话价值主张」
若要用一句话说清 MODUS 对谁有用、有什么用:
| 使用者 | 用途 |
|---|---|
| 检测模型研究者 | 一个类别多(22)、密度高(19.8/图)、带多倍率结构的真实医学检测基准数据 |
| 检验医学 AI 产品团队 | 训练尿沉渣自动镜检模型的可商用(CC BY 4.0)数据底座 |
| 数据集方法学研究者 | 研究「多倍率数据如何建模」「临床类别体系如何定义」的样本 |
| 医学影像综述作者 | 填补「尿液沉渣」这一格的代表性数据集 |
§2 数据集全貌:身份、来源与规格
§2.1 正式身份卡
| 字段 | 内容 |
|---|---|
| 官方英文名 | MODUS: a large-scale multi-magnification microscopic dataset for clinical urine sediment object detection |
| 中文名 | MODUS 临床尿液沉渣多倍率显微目标检测数据集 |
| slug | modus |
| DOI | 10.6084/m9.figshare.31166800 |
| 托管平台 | figshare(主);NLM Dataset Catalog 收录(记录号 0003031853);DataCite 注册 |
| 资源类型 | Dataset(DataCite resourceType = Dataset) |
| 学科主题 | DataCite subjects = [‘Pathology (excl. oral pathology)’, ‘Nephrology and urology’] |
| 许可 | CC BY 4.0(SPDX cc-by-4.0) |
| 发布年份 | 2026(figshare posted 2026-05-09 12:39) |
| 版本 | v1(NLM 标 .v1;DataCite version = None) |
| 语言 | 英文(图像本身无语言属性) |
§2.2 一句话定位
MODUS 是「临床尿液沉渣镜检」这一传统人工检验环节的规模化目标检测数据底座:它把显微镜下 22 类有形成分逐实例框出,样本量为 3,181 张图像 / 63,047 条检测框,并保留 10× / 40× 双倍率以复现真实的低倍筛查 + 高倍精判流程。
§2.3 与三条常见近邻的区分
为帮助检索者快速判断「这个数据集是不是我要找的」,列出三条最易混淆的近邻并逐一区分:
| 近邻 | 它是什么 | 与 MODUS 的区别 |
|---|---|---|
| EPFL MODUS(撞名) | decoder-only 多模态 any-to-any 生成模型(多模态基础模型) | 名字相同、领域完全不同:那是生成模型,本条目是临床检验数据集(坑 1) |
| HRGC-YOLO(前置工作) | 面向尿沉渣检测的模型(YOLOv5m + Global Context,8 类) | 那是模型/方法,MODUS 是它使用的数据集;类别粒度也不同(8 类 vs 22 类) |
| 通用显微细胞分类集(如 BCCD) | 外周血细胞等显微图像分类数据集 | 领域不同(血液 vs 尿液)、任务不同(分类 vs 检测)、类别体系不同 |
§2.4 数据规模硬数字表
| 指标 | 数值 | 来源 | 口径 |
|---|---|---|---|
| 图像总数 | 3,181 张 | figshare 页 / NLM Catalog / DataCite 标题 | 三源一致 |
| 标注总数 | 63,047 条 | figshare 页 / NLM Catalog | 三源一致 |
| 类别数 | 22 类 | figshare 页 / NLM Catalog | 三源一致 |
| 10× 图像 | 361 张 | figshare 页 | 单源明细 |
| 40× 图像 | 2,820 张 | figshare 页 | 单源明细 |
| 平均标注密度 | ≈19.8 条/图 | 63,047 ÷ 3,181(本条目计算) | 派生值 |
- 自洽校验:361(10×)+ 2,820(40×)= 3,181(总)✅,倍率口径内部一致。
- 40× 占比:2,820 ÷ 3,181 ≈ 88.7%,数据集以高倍形态细节图像为主体。
§2.5 双口径存照(规模细分)
- 口径 A(三源):figshare 页、NLM Catalog、DataCite 在总量 3,181 / 63,047 / 22 上完全一致。
- 口径 B(细分):10× : 40× 的明细(361 / 2,820)仅由 figshare 页给出,NLM 与 DataCite 未逐倍率细分。
- 处理:总量按三源一致口径采用;细分数字标注为「以图库页为准」,不作强断言(坑 8)。
§2.6 版本链
| 版本 | 标识 | 说明 |
|---|---|---|
| v1(当前主版本) | 10.6084/m9.figshare.31166800.v1(NLM Catalog URI) |
figshare 主 DOI 不带 .v 后缀;DataCite version = None |
- 结论:当前对外主版本 = v1,无后续版本记录。NLM 标
.v1与 DataCite version=None 不构成实质冲突(figshare 的主 DOI 惯例不带版本后缀)。
§2.7 元数据完备性评估
把 MODUS 的公开元数据与一份「理想数据集元数据清单」对照,可以清楚看到它完备与缺失的部分:
| 元数据项 | 是否公开 | 说明 |
|---|---|---|
| 标题 | ✅ | 官方全名 |
| DOI | ✅ | 10.6084/m9.figshare.31166800 |
| 作者 | ✅ | 7 人,DataCite 顺序 |
| 作者机构 | ⚠️ 部分 | 仅由延伸线索推得,非逐人声明 |
| 发布年份 | ✅ | 2026 |
| 许可 | ✅ | CC BY 4.0 |
| 学科主题 | ✅ | Pathology / Nephrology and urology |
| 图像总数 | ✅ | 3,181 |
| 标注总数 | ✅ | 63,047 |
| 类别数 | ✅ | 22 |
| 类别清单 | ❌ | 未逐条公开 |
| 倍率细分 | ✅(单源) | 10×:361 / 40×:2,820 |
| 文件格式 / 体积 | ❌ | 未取得 |
| 图像分辨率 | ❌ | 未公开 |
| 采集设备 / 染色 | ❌ | 未公开 |
| 官方划分 | ❌ | 无 |
| 官方 baseline | ❌ | 无 |
| 伦理审批 | ❌ | 未公开 |
| 配套论文 | ⚠️ 待刊 | 未索引 |
- 结论:MODUS 的描述性元数据(是谁、多大、什么许可)完备;技术性与合规性元数据(文件细节、采集参数、划分、伦理)缺失。
- 影响:下数据的人需要自己补齐技术确认(坑 9);写论文的人需要自己补足评测口径(坑 6);做合规审查的人需要额外向作者求证(坑 12)。
§2.8 时间线
| 时间 | 事件 | 来源 |
|---|---|---|
| 2026-05-09 12:39 | 数据集在 figshare 发布 | figshare 页 |
| 2026 年内 | NLM Dataset Catalog 收录(记录号 0003031853) | NLM Catalog |
| 2026 年内 | DataCite 注册(DOI 生效) | DataCite API |
| 截至实核时点 | 配套论文未索引(待刊) | NLM + DataCite 双口径一致 |
- 时间线读法:数据集本体与注册元数据在 2026 年即已就位,唯配套论文处于待刊状态。这种「数据先行、论文后至」的发布节奏,在近年的医学开放数据集里相当普遍。
§3 机构、人物与学术脉络
§3.1 发布机构
- 浙江大学(Zhejiang University),杭州:
- 生物医学工程系(Dept. of Biomedical Engineering);
- 医学院检验医学系(Dept. of Laboratory Medicine, ZJU School of Medicine)。
- 合作者:Sergey Ablameyko(白俄罗斯国立大学 Belarusian State University / BSU)。
口径说明:上述机构线索部分由团队前置工作(HRGC-YOLO)的公开论文(白俄罗斯国立大学机构库 elib.bsu.by)推得;DataCite 字段未给出逐作者的机构映射,故该映射属「机构线索」而非「已实核结论」(§9 遗留疑点 D4)。
§3.2 作者列表
DataCite 登记的创作者顺序(共 7 人):
- Zhu Yunqi
- Ye Xianfei
- Yang Haixu
- Liu Yuduo
- Yang Dagan
- Chen Yu
- Xu Yingke
注意:DataCite 的 creator 顺序与「第一作者 / 通讯作者」的署名惯例不一定一一对应;本条目仅按 DataCite 登记顺序罗列,不推断通讯作者身份(§9 遗留疑点 D4)。CC BY 4.0 的署名义务覆盖这 7 位作者及数据集标题。
§3.3 学术脉络:从 HRGC-YOLO 到 MODUS
理解 MODUS 的最好入口是它的前置工作 HRGC-YOLO(High-Resolution Global Context YOLO):
- 定位:一个面向尿液沉渣检测的目标检测模型。
- 架构:基于 YOLOv5m 主干,引入 Global Context(全局上下文) 模块。
- 类别:覆盖 8 类 —— eryth(红细胞)/ cren(皱缩红细胞)/ leuko(白细胞)/ epith(上皮细胞)/ bact(细菌)/ fungi(真菌)/ cryst(结晶)/ casts(管型)。
- 指标:相对 YOLOv5m 基线提升约 +4.5% mAP。
- 来源:白俄罗斯国立大学机构库 elib.bsu.by。
脉络解读:HRGC-YOLO 验证了「用现代检测网络做尿沉渣有形成分识别」这条路走得通,但它的 8 类体系与当时的数据规模,距离临床实际需要的细粒度分类(例如区分正常红细胞与皱缩 / 变异红细胞所提示的肾小球来源血尿)仍有差距。MODUS 沿着同一条路线把两端一起放大:类别从 8 扩到 22,规模推到 3,181 图 / 63,047 框,并用多倍率采集把临床阅片习惯直接编码进数据。因此把两者放在一起读,能看出一个清晰的技术演进链条——先证明模型可行(HRGC-YOLO),再造出足以支撑细粒度检测的数据底座(MODUS)。
必须澄清的一处:HRGC-YOLO 的 +4.5% mAP 是前置模型的指标,不是 MODUS 官方基准数字。MODUS 本身截至实核时点没有公布官方 baseline(§7)。
§3.4 团队的两条学科线索
MODUS 的作者团队横跨两个学科,这一点从机构线索里可以读出来:
- 生物医学工程系(Biomedical Engineering):负责方法与建模——检测网络的架构、训练策略、评测方法。HRGC-YOLO 这类工作正是这一侧的代表产出。
- 医学院检验医学系(Laboratory Medicine):负责临床与数据——尿沉渣镜检的专业知识、类别体系定义、标注标准的临床合理性。
这两条线索的交汇,正是这类「临床 AI 数据集」的典型生产结构:没有检验医学的专业知识,就搭不出符合临床的 22 类体系;没有生物医学工程的建模能力,就做不出可用的检测基线。 MODUS 的价值恰恰来自这两侧的合作,这也是它区别于纯计算机视觉团队自采数据的一个特点。
§3.5 国际合作维度
合作者 Sergey Ablameyko 来自白俄罗斯国立大学(BSU),这一条国际合作线索出现在团队的相关工作中(elib.bsu.by 收录的 HRGC-YOLO 论文)。虽然 DataCite 未逐作者标注机构,但这一线索提示团队的工作有跨国协作背景——这在数据集的方法学(尤其是检测网络设计)上有一定体现。
谨慎表述:本节的「双学科分工」与「国际合作」是基于机构线索的合理推断,用于帮助读者理解团队构成,不是已实核的逐人分工结论(§9 D4)。凡涉及具体某位作者负责哪一块,均属未实核。
§3.6 从 HRGC-YOLO 到 MODUS 的三步演进
把技术脉络展开成三步,可以更清楚地看到 MODUS 的来路:
| 步骤 | 工作 | 关键进展 | 局限 |
|---|---|---|---|
| 第一步 | 早期尿液沉渣检测尝试 | 验证深度学习可用于有形成分识别 | 类别少、规模小 |
| 第二步 | HRGC-YOLO | YOLOv5m + Global Context,8 类,+4.5% mAP | 类别粒度仍粗、数据规模有限 |
| 第三步 | MODUS | 22 类、3,181 图 / 63,047 框、双倍率 | 官方评测口径待论文补足 |
- 演进逻辑:类别从 8 → 22(粒度细化),规模从小 → 3,181 图(量级跃升),采集从单倍率 → 10×/40×(结构贴合临床)。
- 未竟之处:第三步只解决了「数据」,没同步解决「评测」——这正是配套论文待刊留下的空白(§7)。
§3.7 与同期尿液分析数据集的横向比较(定性)
在 MODUS 出现之前,公开的尿液分析相关数据资源主要有几类,它们与 MODUS 的差异是定性的:
| 类型 | 典型形态 | 与 MODUS 的差异 |
|---|---|---|
| 小规模尿沉渣分类集 | 数百张图、少类别、一图一标签 | 规模与类别都远小于 MODUS;任务为分类非检测 |
| 尿试纸 / 干化学数据 | 试纸条反应结果(非图像) | 模态不同(生化 vs 显微图像) |
| 血细胞 / 宫颈细胞显微集 | 大规模但样本来源不同 | 域不同(血 / 宫颈 vs 尿) |
| MODUS | 3,181 图 / 63,047 框 / 22 类 / 双倍率 / 检测 | 尿沉渣域内规模与任务范式最完整者之一 |
- 定性结论:MODUS 的独特性不在单一维度上的「最」(它既不是最大也不是最多类),而在于在尿沉渣这个子域内,同时做到了规模、类别数、双倍率与检测范式四者的组合。
§3.8 前置工作 HRGC-YOLO 的技术要点(可迁移经验)
HRGC-YOLO 的架构选择对 MODUS 的使用者有直接参考价值:
- 主干 YOLOv5m:一个成熟、轻量、工程化的检测主干,适合作为医学检测的基线。
- Global Context 模块:引入全局上下文,有助于判断局部目标(如一个小细胞)在整体视野中的语境——这对「形态相近但全局分布不同的类别」可能有帮助。
- 8 类设定:eryth / cren / leuko / epith / bact / fungi / cryst / casts。
- +4.5% mAP:相对纯 YOLOv5m 基线的提升,说明全局上下文对尿沉渣检测有正贡献。
可迁移经验:如果你的目标是在 MODUS 上做基线,YOLOv5m + 全局上下文是一个有据可依的起点;但记住它是 8 类设定下的结果,22 类下需重新验证(坑 2、坑 5)。
§3.9 团队产出的时间脉络(存照)
| 阶段 | 产出 | 证据 |
|---|---|---|
| 先前 | HRGC-YOLO(8 类检测模型) | elib.bsu.by 机构库论文 |
| 2026-05-09 | MODUS 数据集(figshare 发布) | figshare 页 |
| 待刊 | 配套论文 | NLM 标无关联论文 |
- 读法:先有模型探索、后有数据规模化发布,是一条清晰的技术沉淀路径。数据集的出现,通常意味着团队在方法侧已经积累了足够的信心。
§3.10 关于作者署名与贡献的说明
CC BY 4.0 要求署名 7 位作者,但 DataCite 的登记顺序不等于贡献顺序。为避免误读,明确说明:
- 本条目按 DataCite 登记顺序罗列作者(Zhu Yunqi 等 7 人),不推断第一作者或通讯作者;
- 关于谁主导了数据采集、谁主导了标注、谁主导了方法,公开字段未给出分工信息(D4);
- 如需正式的贡献声明(CRediT 角色),应等待配套论文刊出后以其为准。
§3.11 机构线索的可信度分级
本条目涉及的机构信息,按可信度分为三级,使用时应据此判断:
| 级别 | 信息 | 依据 |
|---|---|---|
| 高 | 浙江大学、生物医学工程系、检验医学系、白俄罗斯国立大学 | 来自团队公开论文(elib.bsu.by) |
| 中 | 「双学科分工」的推断(工程侧 / 检验侧) | 基于机构名称的合理推断 |
| 低 | 每位作者的具体机构与分工 | 无公开字段支撑,属未实核 |
- 纪律:引用机构信息时,应停留在「高」级别;「中」「低」级别仅可用于帮助理解,不可作为正式引用内容。
§4 数据构成与规格详解
§4.1 图像维度:倍率即信号
MODUS 最区别于其他尿沉渣数据集的一点,是把显微镜放大倍率当作数据的第一等公民来管理。它同时提供两个倍率的图像:
| 倍率 | 图像数 | 占比 | 典型用途 |
|---|---|---|---|
| 10× | 361 | 约 11.3% | 全局视野筛查、整体分布判读、可疑区域定位 |
| 40× | 2,820 | 约 88.7% | 单成分形态精判、细粒度类别区分 |
- 两组合计 361 + 2,820 = 3,181,与总数自洽。
- 为什么 40× 远多于 10×:形态判读(区分皱缩红细胞 / 正常红细胞、管型类型、结晶种类)必须在高倍下完成;低倍图像主要承担「先扫一遍」的定位作用,因此数量需求相对少。
§4.2 倍率的临床意义
在真实的检验科工作流中,尿液沉渣镜检遵循一套固定的倍率纪律:
- 低倍(10×)普查:快速浏览整张涂片,估计有形成分的总体密度、分布与可能存在的异常区域。
- 高倍(40×)精判:切换物镜,逐个视野确认细胞形态、类别与比例,做出最终判读。
MODUS 用 10× / 40× 两个倍率分别采集,正是把这一纪律数据化:模型若在这份数据上训练,就天然地接触了「同一成分在不同放大倍率下的外观差异」这一现实——例如红细胞在 10× 下只是一个小圆点,在 40× 下才能看出双凹圆盘形态或皱缩边缘。这使它比单倍率数据集更贴近临床部署场景。
§4.3 标注维度:目标检测框
- 任务类型:目标检测(object detection)。
- 标注形态:边界框(bounding box)——每个有形成分实例一个矩形框 + 一个类别标签。
- 实例总数:63,047 条。
- 平均密度:约 19.8 条/图(63,047 ÷ 3,181)。这个数字意味着一个典型视野中平均有近 20 个被框出的目标,反映了尿沉渣涂片中细胞成群、局部密集的真实分布。
§4.4 类别体系:22 类有形成分
MODUS 的类别体系来自临床尿沉渣镜检的术语。按范围归纳(非官方逐类清单,仅作范围性描述):
| 大类 | 代表成分 | 临床意义提示 |
|---|---|---|
| 红细胞类 | 红细胞(erythrocyte)、皱缩 / 变异红细胞(crenated RBC) | 血尿来源判别(肾小球 vs 非肾小球) |
| 白细胞类 | 白细胞(leukocyte) | 泌尿系感染 / 炎症 |
| 上皮细胞类 | 上皮细胞(epithelial cell) | 尿路脱落细胞来源与形态 |
| 微生物类 | 细菌(bacteria)、真菌(fungi) | 感染、污染判读 |
| 结晶类 | 结晶(crystals) | 代谢异常、结石风险提示 |
| 管型类 | 管型(casts) | 肾实质病变的重要指征 |
- 类别总数:22。
- 与前置工作的关系:HRGC-YOLO 覆盖 8 类(eryth / cren / leuko / epith / bact / fungi / cryst / casts),MODUS 在此基础上扩展到 22 类,意味着更细的形态学区分(例如不同结晶种类、不同管型类型)。
- 重要限制:逐类正式名称、类别定义边界、每类标注计数未在公开字段逐条给出。本节所列为范围性描述,精确清单请以数据集发布说明为准(§9 遗留疑点 D2)。凡涉及「某类的确切数量」的推算,均应视为未实核。
§4.5 规格清单(已实核 / 未实核)
| 规格项 | 状态 | 说明 |
|---|---|---|
| 图像总数 | ✅ 已实核 | 3,181(三源一致) |
| 标注总数 | ✅ 已实核 | 63,047(三源一致) |
| 类别数 | ✅ 已实核 | 22(三源一致) |
| 倍率细分 | ✅ 已实核(单源) | 10×:361 / 40×:2,820(figshare 页) |
| 逐类名称与计数 | ❌ 未实核 | 未在公开字段披露(D2) |
| 图像分辨率 | ❌ 未实核 | 未在公开字段披露(D7) |
| 单文件格式(jpg/png/tif) | ❌ 未实核 | figshare 文件清单未取得(D1) |
| 压缩包结构与体积 | ❌ 未实核 | figshare 页面 JS 重渲染,静态抓取失败(D1) |
| 显微设备参数(NA 等) | ❌ 未实核 | 未披露(D7) |
| 染色方式 | ❌ 未实核 | 未披露(D7) |
| 官方划分比例 | ❌ 未实核 | 未披露(D5) |
§4.6 关于「22 类」的常见追问
问:为什么是 22 类,这个数字从哪来?
22 是数据集官方公布的类别总数(figshare / NLM 三源一致)。它是团队在临床尿沉渣镜检术语体系基础上划分的结果,比前置工作 HRGC-YOLO 的 8 类更细。至于这 22 类具体如何切分(例如把结晶细分成几种、管型细分成几种),公开字段未逐条给出,故本条目只做范围性归纳(§4.4)。
问:22 类里会不会有很多长尾类别?
很可能。临床尿沉渣中,红细胞、白细胞的出现频率天然远高于特定管型或少见结晶。因此在 22 类体系下,类别分布大概率呈长尾——这对检测模型是实打实的挑战:总体 mAP 可能被高频类抬高,而低频但临床重要的类别(如某种管型)表现可能很差(坑 7)。建议一切使用者报告逐类 AP,而非只报总体 mAP。
问:这些类别和临床诊断是什么关系?
每类有形成分都携带临床信号:红细胞提示血尿(皱缩红细胞提示肾小球来源)、白细胞提示感染或炎症、上皮细胞提示尿路脱落、细菌/真菌提示感染或污染、结晶提示代谢异常或结石风险、管型提示肾实质病变。MODUS 的 22 类体系因此不只是「图像分类标签」,而是临床判读的语义单元——这也是为什么类别定义的精确性对该数据集如此重要。
§4.7 数据不平衡的三个层次
理解 MODUS 的可用性,需要看清它至少存在三个层次的不平衡:
| 层次 | 表现 | 影响 |
|---|---|---|
| 倍率不平衡 | 10× : 40× ≈ 1 : 7.8 | 混合训练时高倍主导 |
| 类别不平衡(推测) | 高频类(红细胞/白细胞)远超低频类(少见管型/结晶) | 长尾类别 AP 偏低 |
| 空间密度不平衡 | 平均 19.8 实例/图,但分布不均(有的视野极密、有的稀疏) | 密集区域漏检率高 |
- 应对建议:倍率不平衡 → 显式声明口径或分倍率训练;类别不平衡 → 重采样 / focal loss / 报告逐类 AP;密度不平衡 → 选择对小目标和密集场景友好的检测头。
§4.8 与「一份理想尿沉渣数据集」的差距
如果由临床检验科来定义一份「理想」的尿沉渣检测数据集,它大概会包含:完整的类别定义文档、标注一致性报告、官方划分、多中心样本、采集参数、临床关联标签。对照之下 MODUS 的现状是:
| 理想项 | MODUS 现状 |
|---|---|
| 完整类别定义文档 | 未公开(D2) |
| 标注一致性报告 | 未公开 |
| 官方划分 | 无(D5) |
| 多中心样本 | 未证实(D4) |
| 采集参数 | 未公开(D7) |
| 临床关联标签 | 未公开 |
| 伦理文书 | 未公开(D6) |
- 态度:这些差距不否定 MODUS 的价值——它已经是这个格子里罕见的规模化公开集;但它们决定了使用者不能把 MODUS 直接当作「临床级验证数据」,而应视其为训练与研究的底座,临床落地前需自行补验证(§5.5、坑 13)。
§4.9 数据规模在检测任务中的「够不够用」
常被问到:3,181 张图、63,047 个框,对训练一个 22 类检测器够不够?这个问题没有单一答案,取决于几个因素:
| 因素 | 对「够用」的影响 |
|---|---|
| 类别数(22) | 类别越多,每类平均样本越少,长尾类可能不足 |
| 每图实例数(≈19.8) | 高,意味着每张图提供的信息量大于稀疏检测任务 |
| 倍率分组(10×:361) | 10× 子集偏小,单独训练 10× 检测器时样本紧张 |
| 任务难度(密集、易混) | 难度越高,需要的样本越多 |
| 预训练 | 若有大规模预训练主干,下游所需样本可减少 |
- 经验判断:以总标注框数(63,047)衡量,MODUS 的标注量在医学检测数据集里属于中等偏上;但若按每类平均(63,047 ÷ 22 ≈ 2,866 框/类,且分布大概率不均),长尾类样本会明显紧张。
- 务实建议:训练时对高频类与低频类区别对待(重采样、类别平衡损失、分阶段训练);评测时务必报告逐类 AP 以暴露长尾表现。
§5 任务定义与标注规范
§5.1 任务的形式化定义
从机器学习的角度,MODUS 定义的任务可以形式化为:
- 输入:一张单倍率(10× 或 40×)的尿液沉渣显微图像 $I$。
- 输出:一组检测结果 ${(b_i, c_i)}_{i=1}^{N}$,其中 $b_i = (x, y, w, h)$ 是第 $i$ 个目标的边界框,$c_i \in {1, \dots, 22}$ 是其类别。
- 训练目标:在带标注的图对上学习一个检测器,使其在未见图像上能定位并分类有形成分。
- 评测口径:目标检测通用指标——mAP@0.5、mAP@[.5:.95]、Precision、Recall、各类 AP。
§5.2 为什么是检测而不是分类或分割
| 范式 | 输出 | 在尿沉渣场景下的取舍 |
|---|---|---|
| 图像分类 | 整图一个标签 | 无法表达「一个视野里有多种成分、各自有多少个」,与临床判读(计数 / 半定量)脱节 |
| 语义分割 | 逐像素类别 | 能给出边界但标注成本极高,且尿沉渣中细胞交叠、边界模糊,逐像素上色性价比低 |
| 目标检测 | 每实例一个框 + 类别 | 兼顾位置、类别与实例计数,标注成本可控,最贴近临床「辨认并计数」的需求 |
MODUS 选择目标检测,本质上是选择了一个标注成本与临床可用性的平衡点:检测框足以支撑「某种成分有多少个、在哪里」的自动化报告,而不必付出逐像素分割的代价。
§5.3 标注规范(基于可核信息的推断与说明)
诚实前置:MODUS 的正式标注规范文书(annotation guideline)未在公开字段给出,以下为基于数据集定位、前置工作与目标检测通行做法的说明,不构成对官方规范的转述。
- 标注单元:单个有形成分实例(一个可见的细胞 / 管型 / 结晶 / 菌体等)。
- 标注几何:axis-aligned 边界框(需以发布说明确认是否为旋转框)。
- 类别粒度:22 类,需区分形态相近的成分(例如不同结晶、不同管型)。
- 密集交叠处理:尿沉渣中细胞常相互接触或重叠,检测范式下应各自独立成框(具体遮挡处理规则以发布说明为准)。
- 忽略区域:涂片边缘、气泡、杂质等非目标区域的处理规则未公开。
§5.4 多倍率任务的两种使用方式
数据集中同时存在 10× 与 40× 图像,研究者可以有两种任务设定:
- 混合训练:把 10× 与 40× 图像一并投入训练,让模型学习跨倍率的鲁棒表征。此时需注意两组的样本量不平衡(约 1:7.8)。
- 分倍率评测:分别在 10× 与 40× 子集上训练或评测,考察模型对低倍全局与高倍细节的不同适应能力。由于官方未公布划分,采用何种设定必须在论文中明确声明(§7)。
§5.5 标注质量与可靠性(未知项)
截至实核时点,以下与标注质量直接相关的信息均未公开,使用时应保持谨慎:
- 标注由谁完成(单人或多人)、是否有复核流程、是否做过一致性检验(inter-annotator agreement);
- 类别定义边界(尤其易混类之间的判读标准);
- 是否存在标注工具或版本导致的系统性偏差。
这些未知项不否定数据集的可用性,但意味着任何声称在 MODUS 上达到某精度的结果,其上限都可能受标注一致性制约——这与所有依赖人工标注的医学数据集面临的问题一样。
§5.6 一个典型的使用流程示例
为把上述抽象说明落到具体,给出一个「从下载到出结果」的典型流程(步骤仅供参考,非官方指南):
- 确认格式(坑 9):打开 figshare 页,确认图像格式、标注格式、文件体积。
- 划分数据(坑 6):固定随机种子,按涂片级(而非图像级)划分 train/val/test,公开 image_id 级清单。
- 声明倍率口径(坑 4):选择 10×、40× 或混合;若是混合,记录两者的采样比例。
- 选模型:因是密集小目标检测,优先考虑小目标能力强的检测器(如带高分辨率特征的 YOLO 系、或 DETR 系变体);HRGC-YOLO 是一个可参考的起点,但注意它是 8 类设定(坑 2、坑 5)。
- 训练与验证:按选定划分训练,验证集上观察逐类 AP 曲线。
- 评测与报告(坑 7):在测试集报告 mAP@0.5、mAP@[.5:.95] 与逐类 AP,并说明划分方式、倍率口径、预处理。
- 合规检查(坑 12):对外展示图像前评估隐私与合规风险。
§5.7 标注任务的技术难点清单
对打算做标注相关工作(例如扩标、复标)的团队,以下是 MODUS 场景下可预期的技术难点:
- 易混类判读:皱缩红细胞 vs 白细胞、酵母菌 vs 红细胞、某些结晶 vs 细胞碎片,这类边界需要临床专业知识支撑。
- 交叠实例切分:相邻或重叠的细胞,检测框如何切分需要一致规则。
- 小目标标注:细菌、真菌等目标在低倍下极小,标注时易漏。
- 密集场景一致性:一个视野几十个目标,不同标注者对「哪些算独立实例」可能有分歧。
- 类别体系维护:22 类下新增或合并类别的版本管理。
§5.8 目标检测 vs 实例分割:为什么 MODUS 的选择是合理的
在「区分每个细胞实例」这件事上,理论上有两条更强的路——实例分割(给每个实例画出像素级轮廓)与全景分割。MODUS 没有选,原因值得说明:
| 方案 | 能提供的信息 | 成本 | 适用性 |
|---|---|---|---|
| 检测框 | 位置 + 类别 + 隐含尺寸 | 低 | 计数、定位、粗形态 |
| 实例分割 | 位置 + 类别 + 精确轮廓 | 极高 | 精细形态学、面积测量 |
| MODUS 的选择:检测框 | 足够支撑临床「辨认 + 计数」 | 可控、可规模化 | 大规模数据集的现实选择 |
- 核心理由:尿沉渣中细胞彼此交叠、边界模糊,逐像素勾勒轮廓的标注成本极高且一致性差;而临床判读的核心需求是「有哪些成分、各有多少」,检测框已足够。在规模与精度的权衡中,MODUS 选择了规模——这是它能把数据做到 3,181 图 / 63,047 框的前提。
§5.9 标注规模背后的工作量估算
63,047 条框意味着什么?做一个粗略的工作量感知:
- 假设每标注一个框(含判类)平均需要数秒,则 63,047 个框的纯标注时间即达数十小时量级;
- 若加上复核、争议裁定、一致性检查,总投入会成倍增加;
- 若再做一致性检验(多人独立标注同一子集),投入进一步上升。
这说明:一个 63,047 框的数据集背后是相当规模的人工投入,这也是医学标注数据集相对稀缺、且往往以「申请制」或「有限公开」发布的原因。MODUS 以 CC BY 4.0 完全公开,在这一点上是相对慷慨的。
§6 获取方式、许可与引用
§6.1 许可:CC BY 4.0
- 许可类型:CC BY 4.0(Creative Commons Attribution 4.0 International,署名 4.0 国际)。
- SPDX 标识:
cc-by-4.0(DataCite 实抓确认)。 - 三源一致性:figshare 页、NLM Dataset Catalog(记录号 0003031853)、DataCite 三源在 CC BY 4.0 上完全一致,无冲突。
CC BY 4.0 允许与要求:
| 行为 | 是否允许 | 条件 |
|---|---|---|
| 再分发(复制、传播) | ✅ 允许 | 须署名 |
| 改编(修改、二次创作) | ✅ 允许 | 须署名,并标明是否修改 |
| 商用 | ✅ 允许 | 须署名 |
| 免除版税 | ✅ 是 | 无需付费或许可 |
| 附加限制 | ❌ 不得施加额外法律限制 | 不得对下游使用者施加额外限制 |
署名要求(硬性):使用 MODUS 时须注明数据集标题与7 位作者(Zhu Yunqi、Ye Xianfei、Yang Haixu、Liu Yuduo、Yang Dagan、Chen Yu、Xu Yingke),并提供许可链接与是否修改的说明。
§6.2 获取方式
- 主获取渠道:figshare 公开下载。
- DOI:
10.6084/m9.figshare.31166800 - 数据集页:
https://figshare.com/articles/dataset/MODUS_a_large-scale_multi-magnification_microscopic_dataset_for_clinical_urine_sediment_object_detection/31166800
- DOI:
- 无需申请:与部分医学数据集采用的「申请制」(须向作者邮件申请并说明用途)不同,MODUS 为完全公开直链,注册 / 无需注册均可下载(以平台实际要求为准)。
- 站内占位:本条目对应站内 URL 占位为
https://www.qianfanghub.com/ai-ready-dataset/modus/873。
§6.3 版本链与可引用性
| 版本 | DOI / 标识 | 状态 |
|---|---|---|
| v1 | 10.6084/m9.figshare.31166800(主 DOI)/ 10.6084/m9.figshare.31166800.v1(NLM Catalog URI) |
当前主版本 |
- DataCite version 字段:None(figshare 主 DOI 惯例不带版本后缀)。
- NLM Catalog URI:
10.6084/m9.figshare.31166800.v1。 - 双口径存照(版本):NLM 标
.v1、DataCite version=None → 二者不构成实质冲突,当前对外主版本 = v1。 - 引用建议:引用数据集本体时使用主 DOI
10.6084/m9.figshare.31166800;若检索需要锁定版本,可使用.v1形式。由于配套论文尚未索引(§7),当前最佳引用对象是数据集本身而非论文。
§6.4 获取前的检查清单
下载前建议确认以下事项(部分因 figshare 页面动态渲染未能实核,见 §9 D1):
- [ ] 在图库页确认文件体积,评估存储与下载时间;
- [ ] 确认单文件格式(jpg / png / tif 等)以匹配你的数据加载管线;
- [ ] 确认是否为分卷压缩包,如是则需全部下载后合并;
- [ ] 确认标注文件格式(COCO JSON / YOLO txt / XML 等),这直接决定标注能否开箱即用;
- [ ] 记录下载日期与版本号,写进你的实验记录,便于日后复现。
§7 评估、基准与可复现性
§7.1 现状:没有官方基准
这是使用 MODUS 前必须建立的核心认知:
- 无官方 leaderboard:数据集未附带公开排行榜。
- 无官方 baseline 数值:实核时点未见数据集自带的标准基线结果。
- 无官方数据划分:train / val / test 的划分比例未公布。
- 无官方评测协议:一体化评测脚本 / 指标定义未公开。
根因在于配套论文尚未被索引(NLM Catalog 标注 “No Associated Publication(s)”,DataCite relatedIdentifiers 为空数组)。数据集先于论文公开,是当前众多医学数据集的常见发布节奏,其直接后果就是「数据可用、但评测口径未定」。
§7.2 唯一的已知指标锚点:HRGC-YOLO
目前唯一可引用的相关数字来自前置工作 HRGC-YOLO:
| 项目 | 内容 |
|---|---|
| 模型 | HRGC-YOLO(YOLOv5m 主干 + Global Context 模块) |
| 类别 | 8 类(eryth / cren / leuko / epith / bact / fungi / cryst / casts) |
| 指标 | 相对 YOLOv5m 基线 +4.5% mAP |
| 性质 | 前置模型指标,非 MODUS 官方基准 |
使用警告:不要把 HRGC-YOLO 的 +4.5% mAP 当作「MODUS 上的 SOTA」来引用。它是在 HRGC-YOLO 自己的 8 类设定下相对 YOLOv5m 的提升,与 MODUS 的 22 类检测任务不可直接互换。把它写进对比赛表会造成误导(坑 5)。
§7.3 如何在没有官方划分时做可复现实验
由于官方未定划分,第三方研究若要产生可比结果,建议遵循以下纪律:
- 自划数据并公开划分脚本:使用固定随机种子,公开 image_id 级别的划分清单,而非只写「8:1:1」。
- 报告倍率口径:明确是 10× / 40× / 混合,混合时说明两者的采样比例(原始比例约 1:7.8)。
- 报告图像级还是实例级划分:若同一涂片的多个视野被拆到不同子集,会造成数据泄漏,须说明划分是在图像级还是涂片级进行。
- 报告通用检测指标:至少给出 mAP@0.5 与 mAP@[.5:.95],并给出各类 AP 以暴露长尾类别表现。
- 固定图像预处理:说明分辨率缩放、增强策略,因为显微图像对缩放敏感。
§7.4 可预期的评测难点
基于任务性质,MODUS 上的检测评分预计会面临几个典型难点(供研究者预判,非官方结论):
- 类别长尾:22 类中部分成分(如特定管型、少见结晶)出现频率可能远低于红细胞 / 白细胞,小样本类别会拉低 mAP。
- 密集与交叠:平均近 20 个实例/图,且细胞常相互接触,密集场景下的漏检 / 重复检是主要误差来源。
- 易混类对:皱缩红细胞 vs 白细胞、酵母菌 vs 红细胞等形态相近类别,是分类分支的固有难点。
- 跨倍率泛化:模型在 40× 训练后能否迁移到 10×(及反向)是这份数据集特有的泛化问题。
§7.5 一个可复现实验的最小报告模板
为帮助使用者在无官方口径下产出可比结果,给出一个最小报告模板(每项都应出现在方法或实验小节中):
数据集:MODUS(DOI 10.6084/m9.figshare.31166800, v1)
下载日期:YYYY-MM-DD
倍率口径:[10× / 40× / 混合(比例 X:Y)]
划分方式:[涂片级 / 图像级],种子 Z,train/val/test = a/b/c
划分清单:[公开链接或附录]
标注格式:[COCO / YOLO / 其他]
图像预处理:[分辨率、增强]
模型:[名称 + 关键超参]
评测指标:mAP@0.5 = …, mAP@[.5:.95] = …, 逐类 AP = …
- 为什么强调这份模板:在官方口径缺位时,可比性完全依赖第三方报告的透明度。把上述字段写全,是让你的 MODUS 结果能被他人复现与对比的最低要求。
§7.6 与「有官方基准」数据集的对比
| 维度 | 有官方基准的数据集 | MODUS |
|---|---|---|
| 数据划分 | 官方固定 | 使用者自划 |
| baseline 数值 | 官方给出 | 无(仅有前置模型指标) |
| 排行榜 | 有 | 无 |
| 可比性 | 高(同划分) | 依赖第三方自报口径 |
| 上手门槛 | 低(直接跑) | 中(需自行设计划分与协议) |
- 启示:MODUS 更适合作为训练底座与数据资源,而非排行榜竞技场。想用它做公平对比,必须比使用有官方划分的数据集更用心地维护实验记录。
§7.7 论文待刊状态对评测的影响
配套论文待刊会带来三个具体后果:
- 协议缺位:mAP 的具体计算方式(如 IoU 阈值、是否忽略小目标)没有官方定义,第三方需自定并说明。
- 基线缺位:没有可对标的官方数字,任何「我们的方法优于 X」都需要自己先跑一遍 X。
- 可分性未知:官方是否预留了测试集、是否打算做 challenge,均未知——使用者应保留数据划分的灵活性。
- 应对:把 MODUS 当作持续观测的对象。论文一旦刊出,很可能会同步公布划分与 baseline,届时此前自划的结果需重新对齐官方口径。
§7.8 可用的评测工具箱
在官方协议缺位时,建议采用业界通用的检测评测工具与口径,以便与他人的结果在「通用指标」层面至少可比:
- 指标:mAP@0.5、mAP@[.5:.95]、Precision、Recall、F1、逐类 AP。
- 工具:COCO 评测脚本(若标注可转为 COCO 格式)、标准 YOLO 评测流程。
- 惯例:报告测试集而非验证集;报告多次运行的均值与方差(尤其小数据集上)。
- 注意:工具的选择会影响数字(例如 COCO 的 AP 定义与某些自实现不同),必须写明所用工具与版本。
§7.9 评测中容易被忽略的可复现性细节
即使报告了完整模板,仍有若干细节常被忽略,导致结果不可复现:
- 随机性来源:数据划分种子、模型初始化、数据加载顺序、增强的随机性——都应固定或多次运行取均值。
- 图像缩放策略:显微图像对缩放敏感(细胞大小直接决定检测框),缩放尺度必须写明。
- 标注格式转换:从原始格式转 COCO / YOLO 时的坐标取整规则、越界框处理,都会影响结果。
- 类别合并 / 拆分:若研究者自行合并了 22 类中的某些类,必须显式声明。
- 评估集的制作时间:数据集的下载日期与版本(v1)要记录,避免不同版本混用。
§7.10 一个「反面清单」:不要这样做
为帮助使用者避开常见错误,列出在 MODUS 上做实验时不要做的事:
- ❌ 不要把 HRGC-YOLO 的 +4.5% mAP 当作 MODUS 官方 baseline。
- ❌ 不要在没有说明划分方式的情况下报告 mAP。
- ❌ 不要把同一涂片的视野分到训练集与测试集(数据泄漏)。
- ❌ 不要只报告总体 mAP 而隐瞒逐类 AP。
- ❌ 不要把 10× 与 40× 混在一起却不声明口径。
- ❌ 不要假设 figshare 的 API 匿名可用(会 403)。
- ❌ 不要在未确认标注格式的前提下写下载 / 加载脚本。
- ❌ 不要声称「在 MODUS 官方测试集上」取得结果——官方测试集不存在。
§7.11 关于「可比性」的一个思想实验
设想两位研究者在没有官方划分的 MODUS 上各跑了一个检测器:
- 研究者甲:按涂片级划分、40× 单倍率、报告 mAP@0.5 = 0.62;
- 研究者乙:按图像级划分、混合倍率、报告 mAP@0.5 = 0.71。
若只看数字,乙「更好」。但两者的口径完全不同:乙的图像级划分可能造成数据泄漏(同一涂片的相似视野出现在训练与测试),且混合倍率改变了任务难度分布。因此在没有统一口径的情况下,数字的大小并不直接对应方法的优劣。
结论:MODUS 的使用者必须接受一个现实——在官方协议出台前,这份数据上的横向比较只在「自报口径内」有效。这不是 MODUS 的缺陷,而是所有「无官方基准数据集」的共同处境;正确的应对是最大化报告的透明度(§7.5),让后来者能够判断你的数字在什么条件下取得。
§7.12 从评测到部署的鸿沟
即使一个模型在 MODUS 上取得了漂亮的 mAP,要走向临床部署仍需跨越若干鸿沟:
| 鸿沟 | 说明 |
|---|---|
| 域偏移 | MODUS 的图像来自特定设备 / 流程,真实临床现场的样本分布可能不同 |
| 标注一致性上限 | 训练标签的一致性水平决定了模型可达的性能上限 |
| 类别覆盖 | 22 类未必覆盖所有临床关心的成分(如罕见结晶、病理管型细分) |
| 合规 | 无伦理文书、无临床验证,直接用于诊疗决策存在风险 |
| 人机协同 | 临床场景通常需要模型给出可解释、可复核的输出,而非单一框 |
- 务实态度:把 MODUS 上训练出的模型视为辅助工具原型,而非诊疗决策系统;落地前需在真实场景数据上做外部验证(坑 13)。
§8 生态位、同类数据集与互链点
§8.1 MODUS 在医学显微数据生态中的位置
医学显微图像数据集可按「样本来源 × 任务类型」两轴定位。MODUS 落在一个相对稀疏的格子里:
| 样本来源 | 分类任务 | 检测任务 | 分割任务 |
|---|---|---|---|
| 外周血 | BCCD、acevedo-blood | BCCD、acevedo-blood | — |
| 宫颈细胞学 | herlev-pap、cervix93、mendeley-lbc、papila | — | — |
| 寄生虫血涂片 | — | NIH Malaria | — |
| 尿液沉渣 | (长期空白) | MODUS | — |
| 通用细胞 | cric、cytoimagenet、lightmycells2 | — | jump-cell-painting |
从这张表能看出 MODUS 的生态位独特性:尿液沉渣 + 目标检测这个组合,在公开数据集里几乎是一块空白,而 MODUS 恰好填在这里。这也是它的主要价值来源——不是更大、更快,而是填了一个一直缺位的临床格子。
§8.2 库内可互链条目(含 rid)
以下为千方病案医数集库内(ai_ready_dataset,status=1)与 MODUS 主题相近、适合互链的条目:
| rid | slug | 关联理由 | 互链强度 |
|---|---|---|---|
| 851 | bccd | 外周血细胞显微图像目标检测,与 MODUS 同任务范式(检测框) | ★★★ |
| 850 | mendeley-lbc | 液基细胞学宫颈癌,显微细胞形态 | ★★ |
| 847 | cric | 细胞图像分类(库内已收) | ★★ |
| 483 | herlev-pap | 宫颈脱落细胞学涂片,显微细胞形态分类 | ★★ |
| 848 | cervix93 | 宫颈细胞显微图像 | ★★ |
| 722 | acevedo-blood | 外周血涂片显微细胞 | ★★★ |
| 502 | nih-malaria | 疟疾薄 / 厚血涂片显微检测 | ★★★ |
| 31 | cytoimagenet | 细胞形态学图像集 | ★ |
| 631 | lightmycells2 | 细胞显微图像(标签自由) | ★ |
| 563 | jump-cell-painting | 细胞显微表型图像 | ★ |
| 765 | papila | 巴氏涂片显微图像 | ★★ |
| 319 | human-cell-atlas | 单细胞 / 组织图谱 | ★ |
| 359 | single-cell-portal | 单细胞数据门户 | ★ |
| 38 | cellxgene | 单细胞资源 | ★ |
§8.3 强互链建议与理由
第一优先级(同任务范式,检测 ↔ 检测):
- bccd(851):同为「显微图像 + 目标检测框」的任务范式,BCCD 做血细胞检测、MODUS 做尿沉渣检测,两者在模型选型(YOLO 系)、评测指标(mAP)上高度互通,是最自然的互链对象。
- acevedo-blood(722):外周血涂片显微细胞,样本来源不同(血 vs 尿)但任务与形态学挑战(细胞交叠、易混类)相通。
- nih-malaria(502):血涂片显微检测,同属「体液显微镜检 + 自动检测」大方向。
第二优先级(同域形态学):
- herlev-pap(483)、cervix93(848)、mendeley-lbc(850)、papila(765):宫颈细胞学形态学数据集,与 MODUS 共享「显微形态判读」的方法论挑战(类别定义边界、观察者间一致性)。
第三优先级(方法学邻居):
- cric(847)、cytoimagenet(31)、lightmycells2(631)、jump-cell-painting(563):细胞图像分类 / 表型数据集,可作为「分类 vs 检测」范式对照。
§8.4 另两个维度的互链
- 临床科室维度:DataCite 将 MODUS 归入 Nephrology and urology(肾脏病学与泌尿学)主题。库内若存在以肾脏 / 泌尿为主题的条目,可沿「科室」维度互链,帮助临床检索者从疾病侧找到这份数据。
- 自动化检验维度:尿沉渣镜检是「临床检验自动化(urinalysis automation)」的关键环节。库内若有检验科自动化、POCT、体外诊断(IVD)相关条目,可沿「应用场景」维度互链。
§8.5 上游与下游
- 上游(方法来源):HRGC-YOLO(前置检测模型)。
- 下游(潜在应用):尿沉渣自动镜检设备、尿常规自动化流水线、体检筛查辅助、肾病 / 泌尿科辅助诊断研究。
- 学术邻居(非库内):EPFL MODUS(撞名,须区分)、各类 YOLO 系检测工作。
§9 与相近数据集的对照
为帮助使用者判断「该不该用 MODUS」,把它与几个最可能被拿来比较的数据集做一对照:
| 维度 | MODUS | BCCD | NIH Malaria | Herlev-Pap |
|---|---|---|---|---|
| 样本来源 | 尿液沉渣 | 外周血 | 疟疾血涂片 | 宫颈细胞 |
| 任务 | 目标检测 | 目标检测 | 检测 / 分类 | 分类 |
| 规模 | 3,181 图 / 63,047 框 | 364 图(约) | 27,558 图 | 917 图 |
| 类别数 | 22 | 3(RBC/WBC/PLT) | 2(感染/未感染) | 7 |
| 多倍率 | ✅ 10×/40× | ❌ | ❌ | ❌ |
| 许可 | CC BY 4.0 | 视版本 | CC BY 4.0 | 视版本 |
| 官方基准 | ❌ 无 | ❌ 无 | ❌ 无 | ❌ 无 |
注:上表中 MODUS 之外的数据集规模 / 类别为对照参考值,来自各数据集公开描述(非本条目实核范围),仅用于给出量级感;请以其官方页为准。MODUS 自身的数字均已三源互证。
读表要点:
- 规模:MODUS 在图像数上高于 BCCD / Herlev,低于 NIH Malaria;但**标注框数(63,047)**远超一般检测集,因为平均每图近 20 个目标。
- 唯一带多倍率:表中仅 MODUS 提供双倍率,这是它最硬的结构性差异。
- 类别最细:22 类在该对照组中最细,但也带来更长的长尾。
- 共同点:以上四者均无官方基准——这不是 MODUS 的个别缺陷,而是医学显微数据集的普遍现状。
§9.1 与 BCCD 的深入对照
BCCD 与 MODUS 是最值得放在一起看的一对,因为二者共享「显微图像 + 目标检测」的核心范式:
| 维度 | MODUS | BCCD |
|---|---|---|
| 样本来源 | 尿液沉渣 | 外周血涂片 |
| 目标成分 | 22 类有形成分 | 3 类血细胞(RBC/WBC/PLT) |
| 倍率 | 10× / 40× 双倍率 | 单倍率 |
| 规模 | 3,181 图 / 63,047 框 | 数百图级 |
| 标注范式 | 边界框检测 | 边界框检测 |
| 难度侧重点 | 类别多、长尾、易混类 | 类别少、涂片背景相对干净 |
| 常见用途 | 尿沉渣自动化 | 血细胞检测入门 / 教学 |
- 迁移性:在 BCCD 上验证过的检测流程(YOLO 系训练、mAP 评测)方法学上可直接迁移到 MODUS,只需替换类别体系;
- 差异点:MODUS 的类别数(22 vs 3)与长尾程度远高于 BCCD,直接套用 BCCD 的简单基线大概率在 MODUS 上表现不佳,需针对细粒度与长尾做专门设计。
§9.2 与宫颈细胞学数据集的对照
Herlev、cervix93、mendeley-lbc、papila 这一组宫颈细胞学数据集,与 MODUS 的关系是同域不同任务:
| 维度 | MODUS | 宫颈细胞学组 |
|---|---|---|
| 样本来源 | 尿液 | 宫颈脱落细胞 |
| 主任务 | 目标检测 | 多为分类(正常/异常/病变分级) |
| 类别体系 | 22 类有形成分 | 病变等级(如 NILM/LSIL/HSIL 等) |
| 共性挑战 | 细胞形态判读、类别边界、观察者一致性 | 同上 |
| 可互链价值 | 「显微细胞形态 + 自动判读」的方法论互通 | 同上 |
- 一句话:任务不同,但**「医学显微图像的类别定义与标注一致性」这一方法论挑战完全共通**,适合作为方法学互链。
§9.3 与血涂片检测数据集的对照
NIH Malaria(疟疾血涂片)与 acevedo-blood(外周血涂片)代表了另一条「体液显微镜检 + 自动检测/分类」路线:
- 共性:都是显微镜下的体液涂片、都面临密集细胞与形态变异、都以自动判读为应用目标;
- 差异:目标物不同(疟原虫/血细胞 vs 尿沉渣有形成分)、染色流程不同、临床场景不同;
- 互链价值:在「涂片制备 → 显微成像 → 自动检测」的流水线级方法论上互通。
§9.4 生态位总结
把 MODUS 放进整个医学显微数据集生态,它的生态位可以用一句话概括:它是「体液显微镜检」这个大类里,把「尿沉渣」这一最日常子类补上的规模化检测数据集,并额外引入了双倍率这一临床结构。 它既不是最大的(图像数上不是),也不是最强的(无官方基准),但它是那个填空白的存在——这正是它在库内最值得互链的核心理由。
§9.5 互链时的措辞建议
在千方病案医数集内做互链时,建议按以下措辞表述 MODUS 与邻居的关系,避免误导:
| 目标条目 | 建议措辞 |
|---|---|
| bccd | 「同为显微图像目标检测数据集,任务范式互通,可对照血细胞检测与尿沉渣检测的方法迁移」 |
| acevedo-blood | 「外周血 vs 尿液的体液显微图像,样本来源不同但检测任务与形态学挑战相通」 |
| nih-malaria | 「血涂片显微检测 vs 尿沉渣显微检测,同属体液镜检自动化的数据资源」 |
| herlev-pap / cervix93 / mendeley-lbc / papila | 「同为医学显微形态学数据集,在类别定义与标注一致性方法论上互为参照」 |
| cric / cytoimagenet / lightmycells2 / jump-cell-painting | 「细胞图像分类数据集,可作为『分类 vs 检测』任务范式的对照」 |
- 用词纪律:互链措辞中不应声称 MODUS「优于」或「包含」邻居数据集;它们是并列的、互补的资源,而非竞争关系。
§9.6 临床侧的潜在应用与邻居
从应用而非数据集的角度,MODUS 的临床邻居包括:
| 临床场景 | 关联点 |
|---|---|
| 尿常规自动化流水线 | 尿沉渣自动镜检是流水线的关键环节 |
| 泌尿系感染筛查 | 白细胞、细菌检测直接相关 |
| 肾脏疾病评估 | 管型、红细胞形态(皱缩红细胞)是肾实质病变指征 |
| 代谢筛查 | 结晶种类提示代谢异常 |
| 体检大规模筛查 | 高频项目,自动化收益显著 |
- 互链价值:如果库内存在上述临床主题的条目,可从「应用场景」侧互链,帮助临床背景的检索者找到 MODUS。
§9.7 与「同名 EPFL MODUS」的彻底划界
最后再次强调这对最容易混淆的对象,给出完整对照:
| 维度 | 本条目 MODUS | EPFL MODUS |
|---|---|---|
| 类型 | 临床数据集 | 多模态生成模型 |
| 领域 | 检验医学 / 尿液分析 | 多模态机器学习 |
| 内容 | 3,181 张尿沉渣显微图像 + 63,047 标注 | decoder-only any-to-any 生成架构 |
| 发布平台 | figshare | 学术论文 / 模型发布 |
| 与医学的关系 | 直接临床(尿沉渣镜检) | 无直接临床关联 |
| 检索关键词 | urine sediment / 尿液沉渣 / urinalysis | multimodal / any-to-any / generation |
- 警示:任何检索结果、论文引用、数据库条目,只要主题是多模态生成模型,就不是本条目所指的 MODUS(坑 1)。
§9.8 库内互链的实施建议
落到千方病案医数集的具体实施,建议按以下优先级落地互链:
| 优先级 | 条目 | rid | 互链方向 | 理由 |
|---|---|---|---|---|
| P0 | bccd | 851 | 双向 | 同检测范式,最自然 |
| P0 | acevedo-blood | 722 | 双向 | 体液显微检测 |
| P0 | nih-malaria | 502 | 双向 | 体液镜检自动化 |
| P1 | herlev-pap | 483 | 单向(MODUS → 该条目) | 方法学参照 |
| P1 | cervix93 | 848 | 单向 | 同上 |
| P1 | mendeley-lbc | 850 | 单向 | 同上 |
| P1 | papila | 765 | 单向 | 同上 |
| P2 | cric | 847 | 单向 | 分类 vs 检测对照 |
| P2 | cytoimagenet | 31 | 单向 | 细胞形态学 |
| P2 | lightmycells2 | 631 | 单向 | 细胞显微 |
| P2 | jump-cell-painting | 563 | 单向 | 细胞表型 |
| P3 | human-cell-atlas | 319 | 单向 | 单细胞(弱关联) |
| P3 | single-cell-portal | 359 | 单向 | 单细胞(弱关联) |
| P3 | cellxgene | 38 | 单向 | 单细胞(弱关联) |
- 实施要点:P0 三条建议双向互链(彼此都提到对方),P1–P3 可先做 MODUS → 邻条目单向链,待邻条目更新时再补反向。
- 记账纪律(教训):互链记账时,rid → slug 一律用 DB
url_name反查,只对命中 slug 记账;不得用位置对齐(见任务头历史教训)。
§9.9 库外生态位的定位陈述
若要在综述或百科语境中给 MODUS 一个「生态位陈述」,可用如下表述:
「在公开的医学显微图像数据资源中,外周血、宫颈细胞学、疟疾血涂片等子域已有多个成熟数据集,而尿液沉渣这一日常检验量极大的子域长期缺乏大规模标注资源。MODUS 以 3,181 张 10×/40× 多倍率图像、63,047 条 22 类有形成分检测框填补了这一空白,并以 CC BY 4.0 完全公开,是尿液分析自动检测方向当前代表性最强的公开数据底座之一。」
- 表述纪律:句中的「代表性最强之一」而非「最好」,避免过度断言(该域可能存在本条目未覆盖的其他资源)。
§10 避坑清单:使用 MODUS 前必须知道的坑
本节汇总在使用、引用、复现 MODUS 时最容易踩的坑。编号制,每条给出「现象 → 后果 → 正确做法」。
坑 1:撞名 —— 把 EPFL 的 MODUS 当成这个 MODUS。
- 现象:搜 “MODUS dataset” / “MODUS paper” 时,会命中一个由 EPFL 提出的同名项目 —— 一个 decoder-only 的多模态 any-to-any 生成模型。两件事只是名字相同。
- 后果:引错文献、把生成模型的指标写进检测数据集的对比表、向合作者描述错误的对象。
- 正确做法:检索时强制加入限定词
urine sediment/尿液沉渣/urinalysis;引用时始终带完整标题 “MODUS: a large-scale multi-magnification microscopic dataset for clinical urine sediment object detection”。本条目在 §2.3 已显式划界。
坑 2:把「数据集」和「模型」混为一谈。
- 现象:HRGC-YOLO 与 MODUS 常一起出现,容易误以为 HRGC-YOLO 就是 MODUS 的官方模型。
- 后果:把 HRGC-YOLO 的 +4.5% mAP 当成 MODUS 官方 baseline 引用(详见坑 5)。
- 正确做法:HRGC-YOLO 是前置工作 / 模型,MODUS 是数据集。二者是「模型先用数据、再把数据规模化发布」的先后关系,不是等价关系。
坑 3:把它当分类数据集加载。
- 现象:直觉上「一张显微图判定有形成分」,容易默认是一图一标签的分类任务。
- 后果:用 ImageFolder 之类的分类加载器去读,得到错误的标签结构;或在论文里把检测指标(mAP)和分类指标(accuracy)混用。
- 正确做法:MODUS 是目标检测数据集,每张图含多个「框 + 类别」实例。请用检测框架(COCO / YOLO 格式)加载,评测用 mAP 系列指标。
坑 4:忽略多倍率结构,把 10× 和 40× 混作一谈。
- 现象:看到「3,181 张」就直接当同质数据集训练。
- 后果:若不做区分,模型会在 40× 占 88.7% 的样本上主要学到高倍特征,10× 子集被淹没;跨倍率结论不可靠。
- 正确做法:训练 / 评测时显式声明倍率口径(10× / 40× / 混合);混合训练时注意约 1:7.8 的样本不平衡;报告结果时分别给倍率子集数字。
坑 5:把前置模型的 +4.5% mAP 当成 MODUS 的 SOTA。
- 现象:文献周边唯一显眼的数字是 HRGC-YOLO 相对 YOLOv5m 的 +4.5% mAP。
- 后果:在对比表中把该数字当作「MODUS 上的最优基线」,造成误导。
- 正确做法:该数字是 HRGC-YOLO 在 8 类设定下的模型提升,不是 MODUS(22 类)的官方基准。引用时须同时说明其模型、类别与实验设定。
坑 6:默认存在官方数据划分,直接拿 test 集报数。
- 现象:很多数据集提供官方 train/val/test,使用者习惯性去找。
- 后果:若找不到就自行随意划分且不公开,导致结果无法与他人对比;更糟的是把同一涂片的视野拆到训练与测试,造成数据泄漏。
- 正确做法:明确 MODUS 无官方划分;自划划分要固定种子、公开 image_id 级清单,并说明划分在图像级还是涂片级。
坑 7:忽略类别长尾,用总体 mAP 掩盖小类失败。
- 现象:22 类中部分成分(少见管型、特定结晶)样本极少。
- 后果:总体 mAP 看起来尚可,但临床关心的少见但重要的成分(如管型)可能完全检不出。
- 正确做法:报告逐类 AP,而非只给总体 mAP;对小样本类别考虑重采样或类别平衡策略,并说明。
坑 8:把倍率细分数字当成三源一致的硬事实。
- 现象:本条目「10×:361 / 40×:2,820」只由 figshare 页给出。
- 后果:若在正式文献中把它当作多方核验的定论,一旦图库页调整,说法就会失准。
- 正确做法:总量(3,181 / 63,047 / 22)可称三源一致;倍率细分标注为「以图库页为准」的单源明细。
坑 9:假设能立刻看到文件清单 / 格式,直接写下载脚本。
- 现象:figshare 页面为 JS 重渲染,脚本化抓取容易取不到文件列表;figshare API v2 对匿名请求返回 403 Forbidden(本条目实核时亲身遇到)。
- 后果:自动化下载脚本失败或拿到空列表。
- 正确做法:先手动打开图库页确认文件数量 / 体积 / 格式 / 是否分卷;下载脚本留好重试与鉴权;不要假设 API 匿名可用。
坑 10:把「论文待刊」表述为「论文已发表」。
- 现象:数据集先于论文公开,实时检索可能只见数据集不见论文。
- 后果:引用一个尚不存在的论文,或断言一个未定的评测协议。
- 正确做法:如实表述为「数据集已公开、配套论文待刊(截至实核时点未索引)」,不臆造论文题名、DOI 或基准数字。
坑 11:忽略 CC BY 4.0 的署名义务。
- 现象:把 CC BY 4.0 误读为「随便用、无需说明」。
- 后果:衍生作品未署名,违反许可条款。
- 正确做法:任何再分发 / 改编 / 商用,均须署名数据集标题与 7 位作者,并注明是否修改。
坑 12:忽视患者数据合规,直接对外发布演示样例。
- 现象:医学数据集可能含可识别信息风险。
- 后果:在演示 / 论文中直接展示图像,若原始数据未充分去标识化,存在隐私合规风险。
- 正确做法:MODUS 的伦理审批与去标识化流程文书未公开(§9 D6);对外展示图像前应自行评估合规性,谨慎处理任何可能含患者信息的元数据。
坑 13:把 MODUS 直接当作「临床级验证数据」。
- 现象:数据集结构贴近临床,容易让人以为它可直接用于临床验证。
- 后果:在缺少标注一致性报告、伦理文书、官方评测协议的情况下,把实验结果等同于临床结论。
- 正确做法:把 MODUS 定位为训练与研究底座;临床落地前须自行补充验证(一致性分析、外部验证集、合规审查)。
坑 14:忽略 figshare 页可能随时更新。
- 现象:本条目记录的规模、版本等信息以实核时点为准。
- 后果:若图库页后续新增版本或修订,旧的引用数字可能过时。
- 正确做法:引用时带上访问日期与版本号(v1);重要研究前重新核对图库页最新状态。
坑 15:把「无官方基准」误解为「无法比较」。
- 现象:看到没有 leaderboard 就以为结果无法与他人的对比。
- 后果:放弃或错误地进行横向比较。
- 正确做法:无官方基准 ≠ 无法比较。只要划分方式、倍率口径、评测指标、工具版本四者一致,第三方结果即可在自报口径内横向比较;关键是透明报告(§7.5 模板)。
§11 总结:MODUS 的定位、价值与边界
一句话总结:MODUS 用 3,181 张 10× / 40× 多倍率显微图像和 63,047 条 22 类检测框,把长期依赖人工经验的「尿沉渣镜检」翻译成了一个机器可直接训练的目标检测任务,填补了医学显微数据集生态中「尿液沉渣 + 目标检测」的空白格子。
它的核心价值有三条:
- 填补空白:在公开数据集中,「尿液沉渣」样本来源 + 「目标检测」任务范式的组合此前近乎缺失,MODUS 是这一格的代表性条目。
- 规模可用:3,181 图 / 63,047 框 / 22 类的量级,足以支撑现代检测模型的训练与细粒度类别研究,不再是「几百张图」的玩具规模。
- 结构贴近临床:10× / 40× 双倍率设计把「先低倍筛查、后高倍精判」的阅片纪律编码进数据,使模型学习的是接近真实工作流的表征。
它的边界同样清楚:
- 无官方基准:无 leaderboard、无 baseline、无官方划分、无评测协议(配套论文待刊)。
- 元数据不全:22 类逐类清单、文件级清单、显微采集参数、伦理文书均未在公开字段披露。
- 有撞名风险:与 EPFL 的 MODUS 生成模型同名,检索引用须严格区分。
- 有长尾与密集检测难点:22 类长尾、平均近 20 实例/图的密集交叠,是实际使用中的主要技术挑战。
给三类读者的建议:
- 下数据的人:CC BY 4.0 可自由使用,但先确认文件体积与格式(坑 9),并记住署名义务(坑 11)。
- 做模型的人:把它当检测任务,明确倍率口径与自划划分(坑 4、坑 6),报告逐类 AP(坑 7)。
- 写综述 / 引用的人:严格区分数据集与 HRGC-YOLO 模型(坑 2),不把 +4.5% mAP 当 SOTA(坑 5),论文状态如实表述(坑 10)。
§11.1 三条最需要记住的结论
如果读者只记住三件事,应该是:
- 它是检测数据集,不是分类数据集——每张图有多个「框 + 类别」,用 mAP 评测(坑 3)。
- 它有双倍率结构——10× 与 40× 需分别对待(坑 4)。
- 它没有官方基准——自划划分、透明报告是使用它的前提(坑 6、坑 15)。
§11.2 对未来的观察点
作为一份「数据集已发布、论文待刊」的资源,MODUS 值得持续关注以下变化:
-
配套论文刊出后是否公布官方划分与 baseline;
-
figshare 页是否新增版本(v2 等)或补充文件清单;
-
是否出现第三方在 MODUS 上的基准结果(一旦出现,可形成事实上的对比锚点);
-
类别体系是否被进一步澄清(22 类逐类清单与定义)。
-
行动建议:把本条目记录的「访问时点 2026-10-07」记在心里,重要研究前回到 figshare 官方页复核最新状态(坑 14)。
FAQ:常见问题
Q:MODUS 是免费的吗?
A:是。CC BY 4.0 许可,可免费下载、再分发、改编甚至商用,唯一要求是署名数据集标题与 7 位作者。
Q:我能直接拿它训练 YOLO 吗?
A:可以,它就是目标检测标注。但请先确认标注文件格式(COCO / YOLO / XML,以图库页为准,见 §9 D1),并明确你用的是 10×、40× 还是混合。
Q:为什么找不到配套论文?
A:截至实核时点,配套论文尚未被索引(NLM “No Associated Publication(s)”、DataCite relatedIdentifiers 为空)。属「数据集先发布、论文待刊」的常见节奏,不代表数据集不正规。
Q:22 类到底有哪 22 个?
A:公开字段未逐条给出完整清单。本条目按临床尿沉渣镜检常见成分与前置工作 HRGC-YOLO 的 8 类基础作了范围性描述(§4.4),精确清单请以数据集发布说明为准。
Q:它和 BCCD 哪个更适合做检测?
A:取决于你的目标:做尿沉渣选 MODUS,做血细胞选 BCCD。两者都是检测任务,方法学可迁移;MODUS 类别更细(22 vs 3)且有双倍率,BCCD 规模更小更易上手。
Q:可以商用吗?
A:可以,CC BY 4.0 允许商用,但须署名。注意本条目不构成法律意见,具体商用前请自行核对许可原文与适用法律。
Q:DOI 里为什么有两个版本写法?
A:主 DOI 为 10.6084/m9.figshare.31166800(figshare 惯例不带版本后缀),NLM Catalog 使用带 .v1 的形式。当前主版本即 v1,两种写法指向同一版本。
Q:MODUS 的 3,181 张图里,10× 和 40× 是同一批样本的两种拍法吗?
A:不是。10×(361 张)与 40×(2,820 张)是两组分别采集的图像,数量各自独立,相加得 3,181。它们不是同一视野的两种放大版本。
Q:它和 HRGC-YOLO 是什么关系?
A:HRGC-YOLO 是团队的前置检测模型(8 类,YOLOv5m + Global Context,+4.5% mAP);MODUS 是后续发布的规模化数据集(22 类)。前者是方法,后者是数据(坑 2)。
Q:为什么 MODUS 没有官方 train/val/test 划分?
A:因为配套论文尚未刊出(NLM 标无关联论文),官方评测口径未公布。使用者需自行划分并公开划分清单(坑 6)。
Q:我可以用它在公司产品里训练模型吗?
A:可以,CC BY 4.0 允许商用。须署名数据集标题与 7 位作者、并注明是否修改。商用前请核对许可原文与适用法律,本条目不构成法律意见(坑 11)。
Q:如果我发现 figshare 页上的数字与本条目不一致怎么办?
A:以 figshare 官方页为准。本条目所有数字标注了来源与访问时点(2026-10-07),若官方页更新,请以更新后为准(坑 14)。
附录 A:核心数字速查表
| 数字 | 含义 | 来源 |
|---|---|---|
| 3,181 | 图像总数 | 三源一致 |
| 63,047 | 标注框总数 | 三源一致 |
| 22 | 类别数 | 三源一致 |
| 361 | 10× 图像数 | figshare 页 |
| 2,820 | 40× 图像数 | figshare 页 |
| ≈19.8 | 平均标注密度(条/图) | 派生 |
| ≈88.7% | 40× 图像占比 | 派生 |
| 7 | 作者人数 | DataCite |
| 8 | 前置模型 HRGC-YOLO 类别数 | 前置工作论文 |
| +4.5% | HRGC-YOLO 相对 YOLOv5m 的 mAP 提升 | 前置工作论文 |
附录 B:DAIMS 数据合规对照表
DAIMS(Data and Information Management System 视角的数据集元数据与合规对照)。本表逐项对照 MODUS 在元数据、许可、可获取性、可复现性、伦理维度的现状与缺口。
| 维度 | 项目 | 现状 | 状态 |
|---|---|---|---|
| 标识 | 持久标识符(DOI) | 10.6084/m9.figshare.31166800(v1) | ✅ 完备 |
| 标识 | 版本管理 | v1,主 DOI 无后缀 | ✅ 完备 |
| 元数据 | 标题 | 官方全名已核 | ✅ 完备 |
| 元数据 | 作者列表 | 7 人(DataCite 顺序) | ✅ 完备 |
| 元数据 | 机构隶属 | 仅推测(ZJU + BSU) | ⚠️ 部分 |
| 元数据 | 学科主题 | Pathology / Nephrology and urology | ✅ 完备 |
| 许可 | 许可类型 | CC BY 4.0 | ✅ 完备 |
| 许可 | 署名要求 | 须署 7 作者 + 标题 | ✅ 明确 |
| 可获取性 | 获取方式 | figshare 公开直链 | ✅ 完备 |
| 可获取性 | 文件清单(体积/格式) | 未取得(JS 重渲染 + API 403) | ❌ 缺口 |
| 内容 | 图像规模 | 3,181(三源一致) | ✅ 完备 |
| 内容 | 标注规模 | 63,047(三源一致) | ✅ 完备 |
| 内容 | 类别体系完整清单 | 未逐条公开 | ❌ 缺口 |
| 内容 | 图像分辨率 / 格式 | 未公开 | ❌ 缺口 |
| 可复现性 | 官方数据划分 | 无 | ❌ 缺口 |
| 可复现性 | 官方 baseline | 无 | ❌ 缺口 |
| 可复现性 | 评测协议 | 无 | ❌ 缺口 |
| 可复现性 | 配套论文 | 待刊(未索引) | ⚠️ 待补 |
| 溯源 | 前置工作 | HRGC-YOLO(8 类,+4.5% mAP) | ✅ 已知 |
| 伦理 | 伦理审批号 | 未公开 | ❌ 缺口 |
| 伦理 | 去标识化流程 | 未公开 | ❌ 缺口 |
| 伦理 | 患者同意文书 | 未公开 | ❌ 缺口 |
| 采集 | 显微设备参数 | 未公开 | ❌ 缺口 |
| 采集 | 染色方式 | 未公开 | ❌ 缺口 |
DAIMS 小结:MODUS 在标识、许可、可获取性、规模元数据四个维度上完备且可核;缺口集中在文件级技术元数据、官方评测口径、伦理与采集细节三类——这三类均指向同一根因:配套论文未刊、图库页技术细节未静态可抓。
附录 C:证据链与核验方法
本条目所有硬数字均经三源互证(教训 12),证据链如下:
| 来源 | 类型 | 用途 | 实物核结果 |
|---|---|---|---|
| figshare 数据集页 | 一手(发布平台) | 发布日、规模明细(含 10×/40× 细分) | posted 2026-05-09 12:39;3,181 / 63,047 / 22;361 / 2,820 |
| NLM Dataset Catalog(记录号 0003031853) | 官方(收录机构) | 收录确认、许可、论文状态 | CC BY 4.0;MeSH: Deep Learning / Urinalysis;No Associated Publication(s) |
| DataCite API(api.datacite.org) | 一手(注册机构) | 标题、作者、主题、许可、版本、关联标识 | 全名;7 作者;subjects;cc-by-4.0;version=None;relatedIdentifiers=[] |
| 白俄罗斯国立大学机构库(elib.bsu.by) | 一手(前置工作论文) | 机构线索、HRGC-YOLO 详情 | 浙大团队;HRGC-YOLO 8 类 +4.5% mAP |
工具留痕:
ps aux | grep -c "[c]odebuddy"= 5(开工时环境残留留痕)。- 私有区 10 秒 md5 稳定性采样:两采样一致,STABLE。
- figshare API v2 匿名请求返回 403 Forbidden → 改用 DataCite API + WebFetch 完成互证(已记入 §9 D1)。
核验纪律说明:本条目在写作中严格遵守「一切以实核结果为准」——凡三源未确认的信息(22 类清单、文件清单、官方划分、伦理文书等),一律标注为遗留疑点而非断言;凡单源明细(倍率细分),一律标注口径来源。
附录 D:术语表
| 术语 | 英文 | 释义 |
|---|---|---|
| 尿沉渣 | urine sediment | 尿液离心后沉淀下来的有形成分(细胞、管型、结晶、菌体等) |
| 尿沉渣镜检 | urine microscopy | 显微镜下观察尿沉渣以判读有形成分的临床检验步骤 |
| 尿常规 | urinalysis / routine urinalysis | 临床上常规开展的尿液检查项目,含尿沉渣镜检 |
| 有形成分 | formed elements | 尿液中可被显微镜识别的颗粒状成分 |
| 目标检测 | object detection | 定位并分类图像中每个目标实例的视觉任务 |
| 边界框 | bounding box | 包围单个目标的矩形标注 |
| 语义分割 | semantic segmentation | 逐像素分类的视觉任务(MODUS 未采用) |
| 多倍率 | multi-magnification | 同一对象在不同显微镜放大倍率下的成像 |
| 放大倍率 | magnification | 显微镜物镜的放大倍数(如 10×、40×) |
| 管型 | cast | 肾小管内凝固形成的圆柱状结构,肾实质病变指征 |
| 皱缩红细胞 | crenated RBC | 边缘呈锯齿状变形的红细胞,形态学提示 |
| 上皮细胞 | epithelial cell | 尿路脱落的上皮来源细胞 |
| 结晶 | crystal | 尿液中析出的晶体成分,代谢异常提示 |
| 菌尿 | bacteriuria | 尿中检出细菌,感染或污染指标 |
| 半定量判读 | semi-quantitative reading | 临床镜检中按视野内数量分级报告的方式 |
| HRGC-YOLO | High-Resolution Global Context YOLO | 前置检测模型,YOLOv5m + Global Context,8 类 |
| mAP | mean Average Precision | 目标检测通用评测指标(在各类上取平均的 AP) |
| IoU | Intersection over Union | 交并比,检测框中判定命中与否的阈值基准 |
| 长尾分布 | long-tail distribution | 少数类别样本极多的类别分布形态 |
| 数据泄漏 | data leakage | 训练与测试数据重叠导致的评测失真 |
| 观察者间一致性 | inter-annotator agreement | 不同标注者判读结果的一致程度 |
| 三源互证 | three-source mutual verification | 本库写作纪律:用三个独立来源核验同一硬数字 |
| CC BY 4.0 | Creative Commons Attribution 4.0 | 署名即可自由使用的开放许可 |
| DAIMS | — | 本库用于数据集元数据与合规对照的检查表框架 |
| DOI | Digital Object Identifier | 数字对象标识符,持久化的资源标识 |
| DataCite | — | DOI 注册机构,提供数据集元数据 API |
| NLM Dataset Catalog | — | 美国国立医学图书馆的数据集目录 |
| MeSH | Medical Subject Headings | 美国国立医学图书馆的医学主题词表 |
| figshare | — | 开放科研数据托管平台 |
附录 E:相关条目索引
| slug | rid | 一句话 |
|---|---|---|
| bccd | 851 | 外周血细胞显微目标检测(最自然的互链对象) |
| acevedo-blood | 722 | 外周血涂片显微细胞 |
| nih-malaria | 502 | 疟疾血涂片显微检测 |
| herlev-pap | 483 | 宫颈脱落细胞学涂片分类 |
| cervix93 | 848 | 宫颈细胞显微图像 |
| mendeley-lbc | 850 | 液基细胞学宫颈癌显微细胞 |
| papila | 765 | 巴氏涂片显微图像 |
| cric | 847 | 细胞图像分类 |
| cytoimagenet | 31 | 细胞形态学图像集 |
| lightmycells2 | 631 | 细胞显微图像(标签自由) |
| jump-cell-painting | 563 | 细胞显微表型图像 |
| human-cell-atlas | 319 | 单细胞 / 组织图谱 |
| single-cell-portal | 359 | 单细胞数据门户 |
| cellxgene | 38 | 单细胞资源 |
本条目写作声明:MODUS 条目由千方病案医数集编辑部依据 figshare、NLM Dataset Catalog、DataCite 等公开来源汇编,全部硬数字经三源互证。凡未实核信息均已标注为遗留疑点(见正文 §9 与附录 B),不作为事实断言。条目内容以数据集官方发布为准,如与官方说明冲突,以官方为准。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- kvasir-capsule — 共享标签:医学影像 / 目标检测 / 图像分类
- oral-cavity-opmd — 共享标签:医学影像 / 目标检测 / 图像分类
- chula-parasitic-egg — 共享标签:医学影像 / 目标检测 / 图像分类
- chestpathct5-s100 — 共享标签:医学影像 / 目标检测 / 图像分类
- cardiac-implantable-device-cxr — 共享标签:医学影像 / 图像分类
- chest-x-ray-segmentation — 共享标签:医学影像 / 图像分类
- tbx11k — 共享标签:医学影像 / 目标检测 / 图像分类
- vindr-pcxr — 共享标签:医学影像 / 目标检测 / 图像分类
- vindr-spinexr — 共享标签:医学影像 / 目标检测 / 图像分类
- dental-opg-xray — 共享标签:医学影像 / 目标检测 / 图像分类
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
