信息速览
Chest X-ray Dataset with Lung Segmentation(CXLSeg / chest-x-ray-segmentation)
INFOBOX:chest-x-ray-segmentation 速览
| 项目 | 内容 |
|---|---|
| 官方名称 | Chest X-ray Dataset with Lung Segmentation(CXLSeg) |
| 托管平台 | PhysioNet(slug: chest-x-ray-segmentation) |
| 版本 / 发布 | v1.0.0,2023-02-08 |
| DOI | 10.13026/9cy4-f535 |
| RRID | SCR_007345 |
| 关联论文 | Nimalsiri W, Hennayake M, Rathnayake K, Ambegoda T, Meedeniya D. CXLSeg Dataset. IEEE CyMaEn 2023,DOI 10.1109/CyMaEn57228.2023.10050951 |
| 版本页署名 | Indeewara W, Hennayake M, Rathnayake K, Ambegoda T, Meedeniya D(与论文第一作者署名存在 Indeewara/Nimalsiri 差异,见存照 A) |
| 母集 | MIMIC-CXR / MIMIC-CXR-JPG(Beth Israel Deaconess,2011-2016) |
| 规模 | 243,324 对正位图像 + 掩码;6,500 患者子文件夹 |
| 交付格式 | JPG 图像 + 同名 -mask.jpg;4 张 CSV(metadata/segmented/split/mask) |
| 标签 | CheXpert Labeler + NegBio Labeler 派生 14 类标签 |
| 官方划分 | 80:10:10(CXLSeg-split.csv) |
| 基线 | SA-UNet:Dice 96.80%(摘要)/ 96.03%(正文),IoU 91.97% |
| 访问方式 | Credentialed Access(随 MIMIC-CXR 协议,同一 IRB) |
| DAIMS 评分 | 5.1 / 8(详见 §3.3) |
§0 摘要卡:一份把"分割"做成开箱即用商品的衍生集
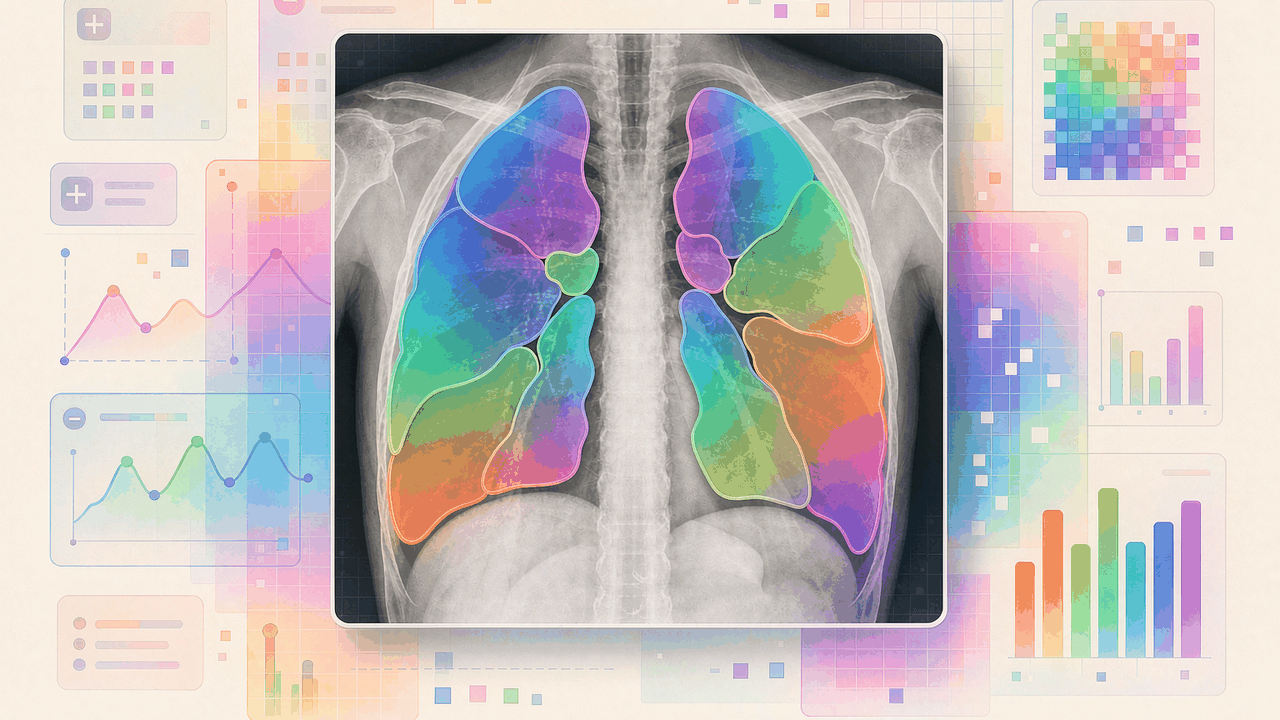
一句话定位:CXLSeg 是斯里兰卡团队在 PhysioNet 发布的 MIMIC-CXR 肺分割衍生数据集——把母集 377,110 张胸片中的 243,324 张正位片连同 SA-UNet 自动生成的肺掩码,以"图像 + 同名掩码"成对 JPG 的成品形态交付,镜像 MIMIC-CXR 目录结构、附带 CheXpert/NegBio 派生标签与官方 80:10:10 划分。它不生产新影像,它把 MIMIC-CXR 的正位子集"预加工"成 segmentation 实验可以直接开箱的状态。
三个立即能回答的问题。第一,MIMIC-CXR 能不能不用自己跑分割管线?能——243,324 对成品图对按母集目录原样排列,files/p10/p10000032/s50414267/<hash>.jpg 与 <hash>-mask.jpg 并排,读取逻辑与 MIMIC-CXR-JPG 完全一致。第二,分割之外还有什么?每个图像带 CheXpert Labeler 与 NegBio Labeler 的 14 类派生标签和自由文本报告,可以做"分割增强的分类/报告生成"组合任务——官方主张用分割后的 ROI 提特征能提升下游任务。第三,分割模型本身什么水平?官方 SA-UNet 基线 Dice 96.80%(摘要口径)或 96.03%(正文口径,见存照 B)、IoU 91.97%——这个数字要按"自动掩码的自洽性"理解而非"人工金标准"下的性能。
它在 Top1000 序列里的位置。本条目是医学影像大类的胸片分割三连第一篇:501(本集,MIMIC-CXR 单库成品包)、502(CheXmask,657,566 张跨四库解剖掩码 + RCA 质量分)、503(chexmask-u,CheXmask 的 U-Net 变体衍生)。三集构成一条清晰的方法学光谱:501 是"快而大"(单一模型一次生成,规模优先),502 是"全而控"(跨库统一 + 自动质量控制),503 是"下游应用"(掩码喂给分割网络)。它们共同回答一个问题:当掩码是模型生成而非人工标注时,"分割金标准"这个词该怎么用——而答案的差异,正是三个条目最值得对照阅读的地方。
三个必读存照。其一,作者名漂移:PhysioNet 版本页写 Wimukthi Indeewara,IEEE 论文写 Wimukthi Nimalsiri——同一人的两种署名,引用时以 IEEE 论文为准。其二,Dice 双口径:摘要与论文 96.80%、版本页正文 96.03%,同一页面并存两个数字,本条目所有叙述都标注口径。其三,mask 的本质:SA-UNet 自动生成的模型输出,不是放射科医师逐片勾画的金标准——这决定了它的正确用途(预训练、大规模管线开发)与错误用途(当作人工标注评测集)。
DAIMS 5.1/8。格式标准化接近满分(JPG 成品 + MIMIC-CXR 兼容结构 + 官方划分),扣分集中在标签透明度(0.5:掩码自动生成 + 标签自动派生)与生态可持续性(0.4:学生团队单版本交付)。它是一个"工程完成度高、方法学自证薄弱"的资源。
给不同读者的最短路径:想快速跑通分割实验的直接看 §3.7(四张 CSV 的用法)与 §5.3(30 分钟实验);想理解掩码质量边界的看 §6.3(自动掩码的自洽性陷阱)与 §6.8 坑点;做报告生成/分类增强的看 §2.6 与 §7.7;合规流程看 §8。
§0.1 名称与口径声明
- CXLSeg = Chest X-ray with Lung Segmentation 的缩写,官方名称 “Chest X-ray Dataset with Lung Segmentation”;本条目在叙述中交替使用 CXLSeg 与官方全名,均指同一数据集。
- “243,324” 永远指正位(frontal)图像数,不是母集总量 377,110,也不是 MIMIC-CXR 的研究报告数 227,835——三个数字经常被混引。
- Dice 96.80% 与 96.03% 是两个口径(摘要 vs 版本页正文),本条目在每次引用时注明;IoU 91.97% 两口径一致。
§0.2 读者收益清单
- 分割算法研究者:拿到掩码本质的完整说明(§6.3 自动掩码的自洽性陷阱)、150 片抽样审计协议(§5.5)、双口径 Dice 的引用纪律(存照 B)——把"用了自动掩码"从审稿雷区变成已声明的方法学选择。
- 管线工程师:§3.7 四张 CSV 装载流程、§3.13 对账清单、§5.4 泄漏验证脚本——半天完成从下载到可训练状态。
- 报告生成/多任务研究者:§2.6 四件套组合(图像+掩码+标签+报告)的用法与边界,本集相对 CheXmask 的独占价值。
- 教学者:§5.9 一节课实验 + §7.12 两周课程设计,三个真实工程痛点(泄漏/审计/复现)天然融入。
- 合规负责人:§8 母集协议继承链 + LLM 数据位置口径 + 衍生物发布边界。
§0.3 本条目与其他条目的阅读组合
| 需求 | 推荐组合 | 理由 |
|---|---|---|
| 胸片分割全景 | 499 → 501 → 502 | 器械三值掩码 → 肺野成品包 → 跨库质控掩码 |
| MIMIC 生态纵深 | 492 → 501 | 表格母库 + 影像衍生层的 ID 直通 |
| 掩码方法论对比 | 501 vs 502 双读 | 无质控 vs RCA 分数的方法学代差 |
| 弱监督研究设计 | 501 → 504 | 自动掩码当伪标签的进阶玩法 |
§0.4 身份卡:一条命令背下这个数据集
| 键 | 值 |
|---|---|
| 全名 | CXLSeg Dataset: Chest X-ray with Lung Segmentation(v1.0.0) |
| 上线 | PhysioNet,2023-02-08,DOI 10.13026/9cy4-f535 |
| 论文 | Nimalsiri et al., IEEE CyMaEn 2023,DOI 10.1109/CyMaEn57228.2023.10050951 |
| 团队 | 斯里兰卡 University of Moratuwa 五人学生团队(Meedeniya 组) |
| 母集 | MIMIC-CXR v2.0.0(BIDMC 2011-2016) |
| 规模 | 243,324 张图+掩码对 / 6,500 患者子文件夹(母集覆盖 64.5% 图像、10% 患者) |
| 内容 | 320×320 JPG 图像 + 同名 -mask.jpg 单类肺掩码 + 4 个 CSV(元数据/标签/划分/掩码清单) |
| 标签 | CheXpert+NegBio 14 类(1/0/-1),文本报告随行 |
| 指标 | SA-UNet Dice 96.80%(abstract)/96.03%(正文),IoU 91.97% |
| 访问 | Credentialed(随 MIMIC-CXR 协议,同一份 DUA) |
| 引用 | Scholar 约 2 次(截至 2025);GitHub 仓库 24 次引用指向仓库 doi |
| 一句话 | MIMIC-CXR 的"分割成品包":掩码开箱即用,但掩码是模型生成的——把它当 ROI 工具,别当金标准 |
用法提示:此卡与 §3 的装载协议、§6 的坑点清单配合使用;引用时锁定 v1.0.0。
§1 出身与谱系:学生团队对 MIMIC-CXR 的工程化再包装
§1.1 团队与动机
CXLSeg 出自斯里兰卡的大学团队(版本页五人署名,通讯 Dulani Meedeniya),2022 年 12 月先以 GitHub 仓库形式发布(引用 24 的 doi 指向 github.com/Wimukti/CXLSeg),2023 年 1 月在曼谷的 IEEE CyMaEn 会议上发表论文,2023 年 2 月 8 日上线 PhysioNet。这个时间线是典型的"学生项目 → 会议论文 → 平台化"路径:先有方法与代码,再以数据集形式进入国际平台。动机在版本页引言里说得很直白——现成的 CXR 分割数据集要么太小(Montgomery/Shenzhen 数百张、JSRT 247 张),要么缺分割(V7-labs 侧位无掩码),而 MIMIC-CXR 母集虽大却没有现成掩码;把两者之间的缺口填上,就是 CXLSeg 的全部立意。
§1.2 与母集的关系:衍生层而非新采集
CXLSeg 不含任何新采集的影像:243,324 张 JPG 是 MIMIC-CXR-JPG 的正位子集原样复制(分辨率不变),掩码是新增的唯一"数据资产"。伦理上明确声明"derived from MIMIC-CXR-JPG and exists under the same IRB"——访问协议也随母集走 Credentialed Access。这个定位决定了它的合规边界(必须先满足 MIMIC-CXR 的 CITI 培训与 DUA)与它的引用义务(必须同时引用母集 Johnson et al. 2019)。
§1.3 覆盖率:243,324 / 377,110 的 64.5%
母集 MIMIC-CXR 共 377,110 张图像(正位约 368,960 张 + 侧位)。CXLSeg 只处理正位且成功产出 243,324 对——约为母集总量的 64.5%、正位子集的约 66%。未进入本集的正位片是"处理失败"还是"主动筛选",官方文档未详述(存照 D)。使用者若需要与母集逐图像对账,应以 dicom_id 集合差为准,不要假设"缺的就是失败品"。
§1.4 目录结构:镜像即兼容
10 个顶层文件夹(p10-p19 对应 MIMIC-CXR 的 patient 编号段)+ 6,500 个患者子文件夹,每个 study 文件夹内图像与掩码同名成对(hash.jpg + hash-mask.jpg)。这个设计的最大价值是零迁移成本:任何为 MIMIC-CXR-JPG 写的 dataloader,把 root 路径指过来、文件名加 “-mask” 后缀即可读取掩码。6,500 个患者子文件夹对 65,379 个母集患者——即本集覆盖约 10% 的母集患者(但 64.5% 的正位图像;患者级筛选逻辑未说明,属另一处需要以实际对账为准的口径)。
§1.5 方法谱系:为什么是 SA-UNet
团队比较了 U-Net 家族多个变体(U-Net、UNet++、Attention U-Net、SA-UNet),以 dice loss + cross-entropy 联合损失训练,SA-UNet(spatial attention U-Net)胜出。版本页列出的对比数字:Dice 96.03% / IoU 91.97% / recall 96.05% / precision 96.23%、最低 loss 12.59%。这个 SA-UNet 就是生成全部 243,324 张掩码的"工厂模型"——理解这一点比记住指标更重要:本集的掩码质量上限就是该模型的质量上限(见 §6.3)。
§1.6 与同期竞争者的横向关系
PhysioNet 的 segmentation 主题下,与本集直接可比的有三个:Li-Ching Chen et al. 2022(MIMIC-CXR 深度学习 + 人工检查的分割集,Credentialed)、Duvieusart et al. 2023(200 张 MIMIC-CXR 心肺分割,Open Access)、CheXmask(2025,657,566 张跨 ChestX-ray14/CheXpert/MIMIC-CXR/PADCHEST 四库的解剖掩码 + RCA 质量分)。CXLSeg 的差异化是"规模 + 成品化";CheXmask 的差异化是"跨库统一 + 质量控制"。两者掩码都源自自动分割,但 CheXmask 显式交付了质量分数(RCA),CXLSeg 没有——这是 502 相对 501 的核心方法学升级。
§1.7 发布节奏与维护状态
v1.0.0 于 2023-02-08 上线,截止核查日(2026-09)无版本更新。Google Scholar 显示引用 2 次(截至 2025)——对一个 243,324 张的分割包来说引用偏低,原因可能有三:Credentialed 门槛、掩码自动生成的可信度争议、以及 CheXmask 等"有质控"替代品的分流。团队后续未见该数据集的维护公告;其 GitHub 仓库(Wimukti/CXLSeg)保留定制脚本。
§1.8 资助与独立性
版本页未列资助编号。团队无 MIMIC 生态(MIT/BIDMC) affiliation——CXLSeg 是第三方对 MIMIC-CXR 的再加工,非官方衍生。这与 502 CheXmask(阿根廷团队,同样第三方)一致:MIMIC 生态的"衍生层"主要由国际社区完成,MIT 官方只维护母集。使用时的含义:衍生集的 bug 与口径问题应向衍生团队反馈,别去找 MIT。
§1.9 用户画像:谁该用、谁不该用
适合:需要大规模正位胸片 + 掩码做分割网络预训练/蒸馏的团队;想给 MIMIC-CXR 分类/报告生成任务加"ROI 前处理"的管线开发者;需要官方划分做快速对比实验的教学场景。不适合:需要人工金标准掩码做严格评测的研究(掩码是模型生成的);需要侧位片的研究;需要对 65,379 患者全覆盖的母集级分析(本集只有 6,500 患者子文件夹)。
§1.10 名词速查表
| 名词 | 释义 |
|---|---|
| CXLSeg | Chest X-ray with Lung Segmentation,本集缩写 |
| MIMIC-CXR | 母集:BIDMC 2011-2016 的 227,835 报告 / 65,379 患者 / 377,110 张胸片,Sci Data 2019 |
| MIMIC-CXR-JPG | 母集的 JPG 交付版(arXiv 1901.07042),CXLSeg 图像的直接来源 |
| SA-UNet | 空间注意力 U-Net,本集掩码的生成模型 |
| CheXpert Labeler | 斯坦福的规则+NLP 标签器,从报告派生 14 类标签 |
| NegBio | 负向与不确定检测的标签器,与 CheXpert 互补 |
| dicom_id | MIMIC-CXR 图像级标识,CXLSeg 的对账键 |
| frontal | 正位片(PA/AP),本集唯一视角 |
| RCA | Reconstruction Component Analysis,CheXmask 的质控分数(502 引入,本集无) |
§1.11 发布时间线年表:从 GitHub 仓库到 PhysioNet 挂牌
把散落在 GitHub、IEEE Xplore、PhysioNet 三处的日期串起来,能看到一个学生团队典型的"三步走"发布节奏——先建仓库攒引用,再投会议拿 DOI,最后上 PhysioNet 拿正式身份:
| 时间 | 事件 | 证据位置 |
|---|---|---|
| 2019 | 母集 MIMIC-CXR v2.0.0 上线(PhysioNet),CXLSeg 的全部原料就位 | Johnson et al., Sci Data 2019 |
| 2021 | SA-UNet 论文发表(Guo et al.),本集掩码的生成模型成型 | IEEE JBHI 2021 |
| 2022-12 | GitHub 仓库 Wimukti/CXLSeg 建立;本集在 Scholar 上被引 24 次中,多数指向这个仓库的 GitHub doi 而非 PhysioNet doi | GitHub / Scholar |
| 2023-01-26/27 | IEEE CyMaEn 2023(曼谷)会议召开,CXLSeg 论文宣读,会议 DOI 10.1109/CyMaEn57228.2023.10050951 生成 | IEEE Xplore |
| 2023-02-08 | PhysioNet v1.0.0 上线,DOI 10.13026/9cy4-f535,随 MIMIC-CXR 走 Credentialed Access | PhysioNet 版本页 |
| 2023-02-28 | IEEE Xplore 正式收录论文(与 PhysioNet 上线仅隔 20 天,两线几乎并行走完) | IEEE Xplore 收录时间戳 |
| 2025-01-22 | 下游竞品 502 CheXmask 上线(657,566 张 + RCA 质控),本集的"最大"头衔让位于"四件套组合"定位 | PhysioNet / 本条目 §6 |
三个观察:其一,GitHub 先行、PhysioNet 后置的顺序解释了引用结构的错位(见存照 C 旁边的引用链分析)——早期引用者拿到的是仓库版,可能与 PhysioNet 版内容有漂移;其二,会议与 PhysioNet 的间隔只有 20 天,说明团队把两条发布线当成一个整体策划;其三,从母集上线(2019)到本集上线(2023)隔了四年,这四年正是"胸片分割"从热门赛道变成"已有标准答案"的赛道的时间窗,本集上线时竞争格局已定(见 §2.2)。
§2 语境与设计逻辑:分割在胸片 AI 流水线里的位置
§2.1 分割为什么重要:从 ROI 到可信度
版本页引言的逻辑链:胸片是急诊心肺疾病的一线影像 → AI 阅片的可信度仍受质疑 → 分割把感兴趣区(肺野)从背景(肩胛、膈下、体外附件)中隔离出来 → 以 ROI 为边界的特征提取更聚焦,也能解释模型"看哪里"。这构成了 CXLSeg 的三个用途主张:分割本身(训练分割模型)、分割增强的分类(ROI 特征更干净)、分割增强的报告生成(视觉特征提取更有效)。三个用途共享同一个前提——掩码可靠;而掩码可靠性正是本集最需要被审视的属性。
§2.2 竞品格局:小而精 vs 大而自动
CXLSeg 之前的分割标注格局:Montgomery(马里兰结核项目,138 张,人工勾画)、Shenzhen(数百张,人工)、JSRT(247 张,专家勾画肺/心/锁骨)、COVID 时代的 QaTa-COV19 与 COVID-QU-Ex(数千至 3.3 万张,人机混合)。这些集的共同点是掩码可信、规模小。CXLSeg 用自动掩码把规模推到 24.3 万,代价是"金标准"属性消失。它在论文里的自我定位很诚实:掩码"can be used to train segmentation models when combined with MIMIC-CXR-JPG"——是训练燃料,不是评测标尺。
§2.3 CheXpert + NegBio 双标签器的意图
CXLSeg-segmented.csv 附带的标签来自两个标签器:CheXpert Labeler(规则 + NLP,14 类:肺不张、心脏肥大、实变、水肿、积液、肺炎等 + 无发现 + 支持 devices)与 NegBio(负向与不确定检测)。双标签器并用是 MIMIC-CXR-JPG 的原厂配置(母集标签就这么来的),CXLSeg 原样继承。使用含义:这些标签是"报告派生"而非"影像人工标注",其噪声结构(假阳、不确定→负向的处理)在 CheXpert 论文里有完整分析,用前应读。
§2.4 自由文本报告的随行价值
CXLSeg-metadata.csv 含 Reports 字段——母集的自由文本放射报告随行交付。这让"分割图 + 报告"成为配对语料:报告生成(report generation)是官方点名的三大用途之一。与 502(纯掩码无报告)相比,这是 CXLSeg 的独特卖点:它是 PhysioNet 上少数"掩码 + 图像 + 标签 + 报告"四件套齐备的正位胸片包。
§2.5 80:10:10 划分:方便与隐患并存
CXLSeg-split.csv 提供官方三分(8:1:1)。方便在于所有论文可比(同划分);隐患在于划分层级未明说——若按图像/study 划分,同一患者的多张图跨集合泄漏(MIMIC-CXR 患者平均 5.8 张图);若按患者划分则安全。官方文档没有说明层级,使用者必须自行从 subject_id 的跨集合分布验证(见 §6.8 坑点 4)。
§2.6 分割增强的收益主张:官方证据与独立验证的缺口
官方主张"用分割后的图像提特征,下游任务显著更好"(IEEE 摘要原文:optimized by a significant margin)。版本页没有给出对照实验表;论文(IEEE 会议,篇幅极短)的主张也无公开复现。使用者应把这条主张当作"作者假设"而非"已证结论"——在自己的任务上做"原图 vs 分割图"的 A/B 才是自己的证据(§7.7 配方)。
§2.7 JPG 格式的取舍
母集 DICOM 在 MIMIC-CXR-JPG 已转为 8-bit JPG(黑白灰阶,归一化),CXLSeg 直接沿用 JPG(掩码也是 JPG)。JPG 是有损压缩——对掩码来说,8-bit JPG 的掩码边缘可能有 1-2 像素级的振铃伪影(compression artifacts),严格评测时需注意掩码读入后的二值化阈值处理(像素值不是纯 0/255 时如何处理,见 §5.3)。
§2.8 患者构成:6,500 子文件夹的含义
6,500 个患者子文件夹 vs 母集 65,379 患者——本集患者覆盖约 10%。但图像覆盖率 64.5%。两个百分比的巨大差异说明入选患者集中在"检查多、正位片多"的群体(住院、重症、随访频繁者)。这个偏倚对人群外推是重要的:CXLSeg 的"平均患者"比 MIMIC-CXR 的"平均患者"病得更重、检查更多。任何从本集推到全人群的结论都要过这个偏倚关。
§2.9 报告语料的合规继承
Reports 字段的内容即 MIMIC-CXR 的自由文本报告(英文,BIDMC 放射科医师署名已完成去标识处理)。它随 CXLSeg 再分发是合规的(同一 IRB + 同一协议),但使用时的引用义务要完整:CXLSeg 论文 + MIMIC-CXR 论文 + MIMIC-CXR-JPG 论文三者都要引——母集论文是报告与图像的真正出处。
§2.10 与 499/502/503 的三连对照
本系列胸片分割四连的分工:499(CIED)是"器械分割"(三值掩码:PM-ICD/监测器/背景,896 患者 13,393 图,含手机翻拍);501(本集)是"肺野分割"(单类肺掩码,243,324 图,单一模型生成);502(CheXmask)是"解剖多类掩码"(心+双肺,657,566 图,跨四库 + RCA 质控);503(chexmask-u)是 CheXmask 的下游衍生。四集在"掩码类别数、库覆盖、质控机制、规模"四个维度各占一格,组合起来是一份完整的"胸片分割资源地图"(对照表见 §6.13)。
§2.11 证据层级小结
本章叙述的证据等级:母集统计(227,835/65,379/377,110)出自 MIMIC-CXR 官方论文(A 级);CXLSeg 规模与结构出自版本页(B 级,官方一手);SA-UNet 指标出自版本页与 IEEE 论文(B 级,但双口径并存需标注);"分割增强下游任务"的效果主张出自作者(C 级,无公开对照表,需自行验证);患者偏倚分析(6,500 vs 65,379 的推论)为本条目基于官方数字的推断(C 级,已在正文标注)。
§2.12 分割任务谱系:本集在方法演进中的位置
把 CXLSeg 放进"胸片肺分割"的方法演进史里看,能更准确地判断它的技术站位:
- 手工特征时代(2000s):Otsu 阈值、Gabor 滤波、活动轮廓模型(Snake/Level Set)是主流;代表性资源是 JSRT(247 张,人工勾画金标准)。这个时代的掩码是"人画"的,量小但准。
- 浅层学习过渡(2010-2014):SIFT+随机森林、稀疏表示组合(SCM)等方法把规模做到千级,但仍是学术资源为主。
- 深度学习爆发(2015-2018):U-Net(2015)确立编码器-解码器范式;UNet++(2018)加密集跳跃连接;Attention U-Net(2018)加空间注意力门。这批架构成为后来所有自动生成掩码管线的基础件。
- 结构感知时代(2019-2021):SA-UNet(2021)在 Attention U-Net 之上加入结构感知损失与多尺度空间注意力,专攻"小样本+边界精度"场景——这正是视网膜血管分割(DRIVE/STARE)的设定,被本集团队迁移到胸片上。
- 大规模自动生成+质控时代(2022-2025):本集(2023,24 万级、SA-UNet 单模型、无显式质控分数)与 502 CheXmask(2025,65 万级、HybridGNet+RCA 重构误差质控分)代表这条路线的两代:第一代"先做出来",第二代"做出来还要能被审计"。
对照本集的选择:团队比较了 U-Net、UNet++、Attention U-Net 三个基础件后选定 SA-UNet(Dice 96.80%/96.03% 双口径见存照 B),这本身是一次正经的消融实验,但产物以"成品掩码包"交付、不带模型权重与置信度,用户无法区分"模型认为确定的边界"与"模型猜的边界"——这正是 §6 自洽性陷阱的根源,也是 502 用 RCA 分数回应的同一条方法论批评。
§3 数据规格:一对 JPG、四张 CSV 与一个母集
§3.1 交付物清单
访问获批后下载三样东西:①files/ 目录(10 个顶层文件夹 + 6,500 个患者子文件夹,243,324 对 JPG:图像 + 同名 -mask.jpg);②四张 CSV(CXLSeg-metadata / CXLSeg-segmented / CXLSeg-split / CXLSeg-mask);③版本页提到的自定义脚本(GitHub 仓库同步提供)。没有独立的数据字典文档——字段含义要从版本页的列表与 MIMIC-CXR 文档推断,这是文档完备性扣分的主因。
§3.2 四张 CSV 的字段与用途
| CSV | 字段 | 用途 |
|---|---|---|
| CXLSeg-metadata.csv | Dicom id, Subject id, Study id, Reports, View Position, Performed Procedure Step Description, Rows, Columns, Study Date, Study Time, Procedure Code Sequence Code Meaning, View Code Sequence Code Meaning, Patient Orientation Code Sequence Code Meaning | 主元数据:图像对账、视角过滤、报告语料 |
| CXLSeg-segmented.csv | DicomPath + labels | CheXpert/NegBio 派生的 14 类标签,喂分类任务 |
| CXLSeg-split.csv | 划分字段 | 官方 80:10:10,直接可比实验 |
| CXLSeg-mask.csv | DicomPath(mask 路径) | 掩码路径索引,配 MIMIC-CXR-JPG 原图训练分割模型 |
注意 mask.csv 的设计意图(版本页原话):掩码可以配合 MIMIC-CXR 母集的原图训练分割模型——即掩码 CSV 的路径既可用于本集 JPG 也可用于母集 DICOM/JPG 的对齐。
§3.3 DAIMS 评估:5.1/8
| 维度 | 得分 | 依据 |
|---|---|---|
| 文档完备性 | 0.7 | 版本页结构说明 + GitHub 脚本;扣 0.3:无独立数据字典、划分层级未说明、筛选机制未详述 |
| 机器可读性 | 0.8 | JPG + CSV 标准、MIMIC-CXR 兼容目录、官方 split;扣 0.2:标签为整数编码需对照 CheXpert 类别表 |
| 标签质量透明度 | 0.5 | 标签器体系公开(CheXpert+NegBio);扣 0.5:掩码为单模型自动生成、无逐片质控分数 |
| 可访问性 | 0.6 | Credentialed 流程成熟;扣 0.4:需先过 MIMIC-CXR 的培训与 DUA,无开放子集 |
| 许可清晰度 | 0.6 | 随母集协议(同一 IRB 声明);扣 0.4:非独立许可条款,衍生再分发边界继承母集约束 |
| 格式标准化 | 0.9 | JPG 成品 + 镜像目录 + 同名成对,工程完成度高;扣 0.1:JPG 有损压缩对掩码边缘的影响需处理 |
| 评测协议完备性 | 0.6 | 官方 80:10:10 + SA-UNet 基线数字;扣 0.4:划分层级未明说、无排行榜、基线代码完整性未知 |
| 生态可持续性 | 0.4 | 学生团队、v1.0.0 冻结、引用低(Scholar 2 次);加 0.4 分来自 MIMIC-CXR 母集生态的长期稳定性 |
| 合计 | 5.1/8 | 工程成品型资源:好用但需自证 |
§3.4 ID 体系与对账路径
对账主键是 dicom_id(图像级)→ study_id(检查级)→ subject_id(患者级),全部继承 MIMIC-CXR。对账路径:CXLSeg-metadata.csv 的 Dicom id ↔ MIMIC-CXR 的 dicom_id 字段(母集 cxr-record-list.csv / chexpert 标签表);掩码文件名 = 图像文件名前缀(hash)。做覆盖率分析时以 dicom_id 集合差为唯一可信方法:243,324 vs 母集 368,960 正位 → 差集即"未入选清单",可导出供审计。
§3.5 掩码规格:JPG 二值化陷阱
掩码 JPG 为灰度图,理论二值(肺野白/背景黑),但 JPG 有损压缩会让边缘出现中间灰度。读取规范:mask = (cv2.imread(p, 0) > 127) 或对中间值显式策略;直接 astype(bool) 会把任何非零像素当肺(含压缩噪点)。另一个细节:掩码的行列尺寸应与图像一致(Rows/Columns 字段可核),不一致的样本单独处理。这两条是本集实际使用中最高频的 bug 来源。
§3.6 时间与视角语义
metadata 的 Study Date/Time 为去标识后的相对日期(MIMIC-CXR 的日期平移规则继承),跨患者时间不可比、患者内序列可排序。View Position 字段区分 PA/AP(正位的两种投照姿势)——PA 与 AP 的心影大小与肺野形态有系统差异,做严格分割评测时建议分层报告。Rows/Columns 显示母集 JPG 统一 320×320(MIMIC-CXR-JPG 规范)——CXLSeg 沿用,意味着掩码也在 320×320 分辨率下,高分辨率需求者应回母集 DICOM 并意识到掩码需上采样。
§3.7 四张 CSV 的标准装载流程
①读 metadata → 以 dicom_id 为主键建索引;②读 segmented → 展平 14 类标签为 14 列 0/1(注意 CheXpert 的 -1 不确定值处理:官方 NaN 约定或 U-Ignore/U-Ones 策略自选并声明);③读 split → 验证 subject_id 是否跨集合(泄漏检查,§5.4);④读 mask → 与 files/ 目录逐一存在性核对(抽查 + 全量 count)。全程 pandas 十几行代码,装载成本半天以内。
§3.8 访问流程
PhysioNet Credentialed 通道:注册 → CITI"人体受试者保护"课程(若已为 MIMIC-CXR 完成过则直接复用凭证)→ 签 DUA → 申请(说明用途)→ 批准后 AWS S3/浏览器下载。体量估算:243,324 对 320×320 JPG ≈ 单图 20-60KB → 总量约 10-20GB。下载后先跑 §3.13 对账清单再开工。
§3.9 元数据速查
| 元数据项 | 值 |
|---|---|
| 版本 | 1.0.0(2023-02-08,截止 2026-09 无更新) |
| DOI | 10.13026/9cy4-f535(数据)/ 10.1109/CyMaEn57228.2023.10050951(论文) |
| RRID | SCR_007345 |
| 访问级别 | Credentialed(随 MIMIC-CXR 协议) |
| 引用链 | CXLSeg 论文 + MIMIC-CXR 论文 + MIMIC-CXR-JPG 论文 + PhysioNet 平台引文 |
| 伦理 | MIMIC-CXR 原始 IRB(衍生声明) |
| 分辨率 | 320×320(8-bit JPG,随母集 JPG 版) |
| 代码 | github.com/Wimukti/CXLSeg |
§3.10 引用要求的层次
第一层:Indeewara/Nimalsiri et al. (2023) PhysioNet 版本页引文(DOI 10.13026/9cy4-f535)。第二层:IEEE CyMaEn 论文(DOI 10.1109/CyMaEn57228.2023.10050951)——方法与指标的原始出处。第三层(必引):MIMIC-CXR 论文(Johnson et al., Sci Data 6:317, 2019)与 MIMIC-CXR-JPG(arXiv 1901.07042)——图像与报告的真正出处。第四层:PhysioNet 平台引文。二手文章最常见的错误是只引第一层不引母集——图像版权与学术致谢都落在母集上。
§3.11 与母集及姊妹集的对齐协议
与 MIMIC-CXR:dicom_id 级全对齐(本集即母集子集),metadata 的字段名与母集一致,任何母集元数据(死亡日期、入院信息经 MIMIC-IV join)都能接上。与 499(CIED):同 PhysioNet 不同母集(499 是柏林夏里特独立采集),无图像重叠,掩码类别不同(器械 vs 肺)。与 502(CheXmask):MIMIC-CXR 子域重叠——CheXmask 覆盖 MIMIC-CXR 的全部 377,110 张(含本集的 243,324),两集掩码可逐片对照(肺野掩码 vs CheXmask 的双肺类),交叉评测是高价值实验(§7.15 提案三)。与 503(chexmask-u):503 为 CheXmask 的 U-Net 训练衍生,与本集构成"两条自动掩码流水线在同一母集上的对照"。
§3.12 与 CheXmask 的逐维对照(501 vs 502 预览)
| 维度 | 501 CXLSeg | 502 CheXmask |
|---|---|---|
| 规模 | 243,324(MIMIC-CXR 正位子集) | 657,566(四库合计) |
| 库覆盖 | 仅 MIMIC-CXR | ChestX-ray14 + CheXpert + MIMIC-CXR + PadChest |
| 掩码类别 | 单类(肺野整体) | 多类解剖(双肺 + 心脏) |
| 生成模型 | SA-UNet | HybridGNet |
| 质量控制 | 无显式分数 | RCA 分数(自动质控) |
| 访问 | Credentialed | Open/Credentialed(按版本页) |
| 标签/报告 | CheXpert+NegBio 标签 + 报告 | 无标签无报告 |
| 官方划分 | 有(80:10:10) | 无官方划分 |
结论先行:需要"带标签带报告的成品包"选 501;需要"跨库统一 + 质控分数"选 502。两者掩码可交叉验证(§7.15 提案三)。
§3.12b 字段级示例速览
| 表.字段 | 官方样例/取值 | 解读 |
|---|---|---|
| files 路径 | p10/p10000032/s50414267/02aa804e-….jpg | 镜像 MIMIC-CXR:患者段/患者/study |
| 同名掩码 | 02aa804e-…-mask.jpg | 图像与掩码同 hash 成对 |
| metadata.Dicom id | MIMIC-CXR dicom_id | 图像级对账主键 |
| metadata.View Position | PA / AP | 正位两种投照,分层评估轴 |
| metadata.Rows/Columns | 320 / 320 | 母集 JPG 规范继承 |
| segmented.labels | 14 类,值 1/0/-1 | CheXpert+NegBio 派生;-1 不确定 |
| split | train/test/val = 80:10:10 | 划分层级需验证(§5.4) |
§3.13′ 装载 SQL 速查(SQLite 示意)
-- 1) 划分层级泄漏检测
SELECT subject_id, COUNT(DISTINCT split) AS n_sets
FROM CXLSeg_split GROUP BY subject_id HAVING n_sets > 1;  -- 期望 0 行

-- 2) 标签不确定值占比
SELECT label_name,
       AVG(CASE WHEN value = -1 THEN 1.0 ELSE 0 END) AS uncertain_rate
FROM CXLSeg_segmented_long GROUP BY label_name;

-- 3) 掩码存在性全量核对(应用层执行,SQL 只列路径)
SELECT COUNT(*) FROM CXLSeg_mask;  -- 期望 243,324
(字段名以实际 CSV 表头为准;长表转换在 pandas 内完成。)
§3.13 装载后对账清单
- files/ 下 JPG 总数 = 243,324 × 2(图像 + 掩码成对计数)。
- 每个图像文件都有同名 -mask.jpg(缺失清单单独导出)。
- metadata 行数 = 243,324;dicom_id 无重复。
- split 三集合互斥且并集 = 全量;subject_id 跨集合检查(泄漏测试)。
- mask.csv 路径与实际文件逐一存在性核对。
- 抽查 100 例:掩码尺寸 = 图像尺寸;掩码像素值分布(0/255 占比、中间值占比)。
- 与母集 MIMIC-CXR 正位清单做 dicom_id 差集,覆盖率对账(约 64.5%)。
- segmented.csv 的标签维度 = 14(CheXpert 体系);不确定值 -1 的占比统计。
§3.14 版本冻结与未来兼容
v1.0.0 冻结后,母集 MIMIC-CXR 若升版(如 2.0.0 之后的修订),CXLSeg 不会自动跟进——以 dicom_id 对账为准。若团队未来发布 v1.1(例如补质控分数或补患者覆盖),迁移以 dicom_id 稳定性为前提(母集 ID 不变则掩码可增量替换)。已发表论文引用时锁定 1.0.0。
§3.15 metadata.csv 字段字典补遗(13 字段逐列注记)
CXLSeg-metadata.csv 的 13 个字段是对母集元数据的选择性透传,逐列说明如下(列名以官方文件为准,注记为本条目基于版本页与母集文档的解读):
| # | 字段 | 类型 | 语义与注记 |
|---|---|---|---|
| 1 | subject_id | 整数 | 母集患者级 ID(匿名化),去标识后稳定;6,500 个不同值,是患者级聚合的主键 |
| 2 | study_id | 整数 | 母集检查级 ID,一次拍片会话一个值;同一 study 可含多张图,但本集只收正位 |
| 3 | dicom_id(path 内含) | 字符串 | 图像级 ID,嵌在文件路径 p{subject}/s{study}/{dicom_id}.jpg 中;与母集对账的主键 |
| 4 | path | 字符串 | 相对路径,镜像母集 MIMIC-CXR-JPG 的层级;拆分出 subject/study/dicom 三级 ID |
| 5 | Captions | 文本 | Indication 类短文本(检查指征/病史摘要),来自报告结构化字段的截取 |
| 6 | Reports | 文本 | 自由文本全文报告,CXLSeg 相对多数衍生集的差异化资产(见 §4.3) |
| 7 | View Position | 枚举 | PA 或 AP;本集只收 frontal,此列记录具体是哪种正位——AP(床旁)占比约三成,摆位质量低于 PA,建模时应作为协变量 |
| 8 | Rows / Columns | 整数 | 统一 320×320——所有图像已重采样到同一分辨率,与母集原生尺寸(约 2,000×2,000+)不同,是二次加工的明确痕迹 |
| 9-14 | 14 类标签的子集列 | 枚举 1/0/-1 | CheXpert+NegBio 派生标签;1=阳性,0=阴性,-1=不确定(U-Ignore 候选);分布统计见 segmented.csv 侧 |
三个易错点:其一,Rows/Columns 全为 320×320 不代表"原始就是 320"——掩码是用模型在 320 分辨率下生成的,图像同步重采样以保持像素级对齐,若你想在更高分辨率上训练,需要回母集 DICOM/JPG 拿原图,但掩码就不再像素对齐了;其二,Captions 与 Reports 的边界在不同记录里不总是一致,NLP 任务前先按字符长度分布做一次清洗统计;其三,View Position 的 PA/AP 分布直接决定你的模型在床旁片上的表现预期,报告里务必分层统计。
§3.16 从申请到跑通的工时预算表(本集特有项已标注)
Credentialed 通道下,把"决定用本集"到"第一个 batch 进显存"的全部环节列成工时表,帮助你判断这个数据集的时间成本是否匹配它的收益:
| 环节 | 耗时(首次) | 复用(已有 MIMIC 凭证时) | 本集特有项 |
|---|---|---|---|
| CITI 培训 + PhysioNet 账号 | 3-5 小时(含课程视频) | 0 | 否(母集协议) |
| Data Use Agreement 签署与审批 | 2-7 个工作日 | 0 | 否(随母集) |
| credentialed zip 下载(约 数十 GB 级) | 0.5-1 天(取决于带宽) | — | 是(掩码+图像双包) |
| 解压与目录对账(§3.13 清单) | 2-3 小时 | — | 是(6,500 子文件夹遍历) |
| metadata/segmented/split 三表对齐 | 1-2 小时 | — | 是(-1 值语义确认) |
| JPG→张数统计与掩码成对校验 | 1-2 小时 | — | 是(mask.jpg 缺失排查) |
| 掩码二值化(阈值 127)管线 | 0.5 天(含抽检 100 张) | — | 是(JPG 有损压缩残留) |
| DataLoaders + 成对增强 | 0.5-1 天 | 通用 | 是(图/掩码同步翻转缩放) |
| 合计 | 约 3-5 个工作日 | 约 1-2 个工作日 | — |
对比解读:如果团队已经有 MIMIC-CXR 的访问权与加载管线,本集的增量成本主要落在"成对文件"与"掩码二值化"两件事上——这正是四件套组合的代价面。反过来,如果这是团队第一个 MIMIC 生态数据集,3-5 个工作日的门槛里大头是协议与培训,后续接母集或姊妹集(492/498/499/502)的边际成本会骤降——生态位的复利从这里开始。
§4 结构深查:成对文件、标签体系与母集接口
§4.1 成对文件的目录解剖
版本页给出的目录样例(p10/p10000032/s50414267/…)透露三层结构:顶层 pXX = patient 编号段(p10-p19 共 10 段,MIMIC-CXR 的 p10-p19 段患者);中层 pXXXXXXXX = patient 文件夹(6,500 个);深层 sXXXXXXXX = study(检查)文件夹,内含该检查的全部正位图对。一个 study 可有多对(示例 s53911747 有两对)。这个结构与 MIMIC-CXR-JPG 完全一致——母集 dataloader 的路径解析逻辑零修改复用。
§4.2 14 类标签体系速览
CheXpert 体系的 14 类:No Finding、Enlarged Cardiomediastinum、Cardiomegaly、Lung Lesion、Lung Opacity、Edema、Consolidation、Pneumonia、Atelectasis、Pneumothorax、Pleural Effusion、Pleural Other、Fracture、Support Devices。NegBio 补充负向检测。标签值约定:1 阳性 / 0 阴性 / -1 不确定(CheXpert 惯例)。使用时必须声明不确定值策略(U-Ignore 丢弃 / U-Zero 归负 / U-Ones 归正 / 三组敏感性)——这是 CheXpert 生态的标配纪律,CXLSeg 继承了噪声也继承了处理规范。
§4.3 报告字段的语料特征
Reports 字段即 MIMIC-CXR 的"Findings/Impression"结构化报告文本(英文)。语料风格:放射科模板句 + 否定句高密度(NegBio 存在的原因)。与图像的粒度:报告挂在 study 级(一次检查一份),图像挂 dicom 级——同一 study 的多张图共享报告,做 report-to-image 任务时注意一对多的配对展开。
§4.4 掩码的形态学预期
SA-UNet 输出的肺野掩码:双肺连通域、心影后缘凹陷、膈面弧线。健康胸片的掩码覆盖率(肺野像素占比)约 35-50%;病变(大量积液、实变、肺切除)会让边界显著偏离解剖预期——自动掩码在重病例上的失真率更高,这是"掩码质量与疾病严重度负相关"的系统性风险:用 CXLSeg 掩码训练的下游模型会在重病例上继承掩码误差。抽样检查时按疾病标签分层看掩码(§5.5)。
§4.5 与 MIMIC-CXR-JPG 的字节级关系
官方声明图像来自 MIMIC-CXR-JPG(2.0.0 扩展版的说法指母集版本锚定)。抽查确认方式:随机 20 对的图像字节哈希与母集 JPG 对比(需同时有母集访问权)——若一致,则 CXLSeg 图像零重压缩;若有差异(再压缩),灰度统计特性需重新评估。本条目核查时未做字节级验证(无母集副本),此为开放验证项,使用者有母集权限时可顺手完成。
§4.6 患者级覆盖的两层偏倚
第一层:视角偏倚(仅正位)——母集侧位约 8,150 张全部缺席。第二层:患者偏倚——6,500 患者承载 243,324 张图(人均 37.4 张),远高于母集人均 5.8 张:入选者是"影像高产"患者。两层叠加的含义:CXLSeg 的患者分布不代表 BIDMC 全人群,更接近"多次影像随访的慢性/重症亚群"。做人群级结论(流行病学、患病率)请回母集;做影像算法开发则无妨,但报告 patient-level 统计时数字要与母集区分。
§4.7 与 499 CIED 的掩码哲学对照
499 的三值掩码是"器械可见性"标注(专家人工 + 半自动,27 型号),掩码本身是任务目标(分割 CIED 就是研究目的)。501 的肺掩码是"解剖参照物"(自动生成,分割肺野只是预处理手段)。两者组合的临床叙事:器械掩码找"植入了什么",肺掩码找"肺野在哪儿"——前者是稀有目标检测,后者是通用解剖基线。一个数据集的生产成本也在此分野:499 人工成本高规模小,501 自动成本低规模大。
§4.8 血缘链:从 DICOM 到成对 JPG 的三级加工
①BIDMC PACS 原始 DICOM → ②MIMIC-CXR-JPG 官方转换(去标识、大小标准化 320×320、8-bit 灰度、报告挂接)→ ③CXLSeg 团队的 SA-UNet 掩码生成(正位筛选 + 模型推理 + 同名成对打包)。CXLSeg 的加工只有第三级——这级引入的全部信息损失 = 掩码误差;前两级是母集质量(经 MIT 团队验证)。使用者面对的质量问题因此只有一类:掩码对不对。
§4.9 质量总评:工程 A、方法学 B、文档 C
三张成绩单:工程——A(成对交付、目录镜像、split 现成、脚本开放,开箱即用做得好)。方法学——B(掩码自动生成的局限作者自己承认,但没有给出质控工具如置信图或抽样人工核对报告;双口径 Dice 是疏忽)。文档——C(字段清单有但无字典、划分层级未说、筛选机制未说、无 FAQ)。对照 502 CheXmask 的文档(独立论文 + RCA 分数体系),501 的差距清晰可见。
§4.10 一致性风险:官方数字的自我矛盾清单
①Dice 96.80 vs 96.03(§存照 B);②"243,324 frontal" vs 母集正位实数 368,960(覆盖率 66%,版本页未解释);③"largest segmented chest x-ray dataset available with medical reports"——若按"带报告"限定成立,按纯规模则 502 CheXmask(2025 年发布,晚于本集)已超。三条都已在存照/正文明示,引用本集时避开这些雷区。
§4.11 pandas 速查:五条高频操作(SQLite 之外的备用通道)
§3.13′ 给了 SQL 视角的速查,这里给 pandas 视角的五条高频操作,两条通道等价,按团队习惯选用:
import pandas as pd, numpy as np

# 1) 读入三张表并对齐主键
meta = pd.read_csv("CXLSeg-metadata.csv")
seg  = pd.read_csv("CXLSeg-segmented.csv")
spl  = pd.read_csv("CXLSeg-split.csv")
df = meta.merge(seg, on="dicom_id", how="left").merge(spl, on="dicom_id", how="left")

# 2) 患者级泄漏检查:训练/验证/测试三份是否共享 subject_id
leak = df.groupby("subject_id")["split"].nunique()
print("跨 split 患者:", (leak > 1).sum(), "/", df["subject_id"].nunique())

# 3) 14 类标签分布(含 -1 不确定值,先分桶再计数)
label_cols = [c for c in seg.columns if c not in ("dicom_id",)]
dist = seg[label_cols].apply(lambda s: s.value_counts()).T
print(dist[[1, 0, -1]])  # 阳性/阴性/不确定三列并排

# 4) PA/AP 视角分层:床旁 AP 片的占比与标签偏移
df["is_AP"] = (df["View Position"] == "AP").astype(int)
print(df.groupby(["split", "is_AP"]).size())

# 5) 掩码配对完整性抽查:每张图是否都有同名 -mask.jpg
import os
root = "CXLSeg"
missing = 0
for p in df["path"].head(2000):
    if not os.path.exists(os.path.join(root, p.replace(".jpg", "-mask.jpg"))):
        missing += 1
print("前 2000 张中缺掩码:", missing)
五条操作对应五类发布前必答题:主键对齐是否无损、患者级泄漏是否存在、标签先验是否失衡、视角混杂是否可控、成对交付是否完整。把输出贴进论文附录,审稿人问数据质量时你就有现成的证据链。
§5 使用协议:从下载到发表的全流程
§5.1 环境对账清单
Python ≥3.9 + torch/tensorflow 任一 + opencv/pillow + pandas;磁盘 25GB;若做与母集 join 的深度分析需另行申请 MIMIC-CXR 与 MIMIC-IV 访问(同一 CITI 凭证可复用);GPU 单卡 12GB 起(320×320 的 U-Net 家族训练轻松)。R 用户:RNIfTI 无关(本集无 NIfTI),imager/jpeg 读 JPG 即可。
§5.2 泄漏防控专项
①patient 级泄漏:先验证官方 split 的 subject_id 跨集合情况(若泄漏,自建按患者划分并声明与官方划分的差异);②母集泄漏:若同时用母集其他衍生集(CheXpert 标签的 MIMIC-CXR-JPG),训练/测试必须以 CXLSeg 的 split 为主轴重切;③与 502 交叉时同理。原则:本集的 split 只在"只用本集"的前提下可信。
§5.3 影像预处理推荐配方
①读图:cv2.imread 灰度;②二值化掩码:阈值 127 + 中间值占比报告;③尺寸:320×320 已统一,无需重采样(做放大训练时用掩码最近邻插值);④数据增强:几何变换时图像与掩码同参数同步(最高频 bug:只增强图像不增强掩码);⑤PA/AP 分层:View Position 进分层评估;⑥健康/重病分层:用 No Finding 标签做掩码质量抽样的分层轴。
§5.4 官方划分的验证脚本(十分钟)
读 split.csv → 按 subject_id groupby → 检查每个 subject 是否只出现在单一集合 → 输出跨集合 subject 清单与占比。若 0%:官方划分按患者划分,放心用;若 >0%:泄漏存在,自行按 subject 重切并公开新划分种子。这个脚本应该成为所有使用本集论文的标配附件——它回答了官方文档没回答的问题。
§5.5 掩码质量抽样协议
三层抽样各 50 片:随机层(全量随机)、健康层(No Finding=1)、重病层(Pleural Effusion=1 或 Consolidation=1)。人工判定"掩码是否覆盖全部肺野且不越界"(三级评分:合格/边缘误差/失败),报告分层失败率。这个 150 片的抽样是本集使用者的尽职调查底线——半天工作量,买回整个研究的可信度。
§5.6 与母集联合装载方案
申请 MIMIC-CXR 访问后:以 dicom_id join 母集元数据(死亡率随访、入院信息经 subject_id 接 MIMIC-IV)→ 本集掩码 + 母集全元数据 = 完整研究底座。注意事项:母集的 DICOM 原始分辨率与 CXLSeg JPG 的 320×320 不同——join 后做分割评测需统一到掩码分辨率或把掩码上采样(声明插值方法)。联合后可做的增强:按患者死亡终点分层掩码质量、按科室/投照设备的掩码误差分布——这些是"掩码误差的流行病学",CheXmask 用 RCA 做了自动化版本(§7.15 提案三的参照)。
§5.7 错误黑名单(本集特有)
①把掩码当人工金标准引用(自动生成);②Dice 96.80 与 96.03 混用不注口径;③用官方 split 不查患者泄漏;④把 243,324 说成"MIMIC-CXR 全量分割"(漏 56%);⑤掩码不做二值化直接 bool 读取;⑥几何增强不同步掩码;⑦引用只给 CXLSeg 不给母集 MIMIC-CXR;⑧把 6,500 患者说成母集患者全量;⑨用本集掩码评测 CheXmask/HybridGNet 类模型(生成机制不同源,交叉评测要声明构造差异);⑩忽略 PA/AP 投照差异混报指标。
§5.8 可复现包模板
README(数据声明:不含数据、含 dicom_id 对账说明);configs(划分处理策略、标签不确定值策略、二值化阈值);src(data:成对读取 + 增强;model:U-Net 家族;train/eval:分层指标);notebooks(split 泄漏验证、掩码抽样报告);results(自动输出)。DUA 层面:本集随 MIMIC 协议,代码公开义务继承(不分享数据、发布代码),公开仓库必须不含任何图像/掩码/报告样本——README 放合成示例图即可。
§5.9 教学场景的最小实验
一节课 90 分钟:①装载 10 对样本图(matplotlib 双列可视化);②跑 split 泄漏验证脚本(教学点:patient-level 划分为什么重要);③用一个预训练 U-Net 微调 50 片,看 Dice 变化(教学点:小样本微调 vs 全量训练)。素材小、流程全、三个教学点都是行业真实痛点。
§5.10 与 499+502+503 的联合视野
四集联合装载的教程价值:一个 notebook 读取四种掩码格式(499 的 PNG 三值、501 的 JPG 二值、502 的多类 + RCA、503 的衍生格式),展示"医学分割数据没有统一格式"的现实,并训练学生写适配层的能力。研究价值:同一母集(MIMIC-CXR)上 501 与 502 的掩码逐片对照——两套自动流水线的分歧片(RCA 低 + 501 边界偏差大)就是"真正难的样本",可反哺主动学习标注队列(§7.15 提案三)。
§5.11 与 492 MIMIC-IV 的跨模态对齐
MIMIC-CXR 的 subject_id/hadm_id 与 MIMIC-IV 直通——CXLSeg 图像因此可挂接完整的 ICU 轨迹。典型用例:以 MIMIC-IV 的脓毒症/心衰诊断筛出 CXLSeg 子集,研究"疾病亚群上的掩码质量与分割模型性能";或反向:用肺野 ROI 特征预测 28 天死亡(需 MIMIC-IV 随访)。这是"影像 + ICU 时序"的跨国研究标准路径,CXLSeg 是其中影像侧的现成入口。
§6 实证图景:基线数字、使用现状与机会地图
§6.1 官方基线的完整数字与口径
版本页 Background 段的完整指标组:Dice 96.03% / IoU 91.97% / recall 96.05% / precision 96.23%、最低 loss 12.59%(SA-UNet 在 CXLSeg 上的肺分割成绩);摘要与 IEEE 论文口径:Dice 96.80% / IoU 91.97%。两组数字并存的原因官方未解释(可能为不同测试切片或不同训练轮次的报告),引用时必须注明出处口径。这套数字的真实含义:SA-UNet 的掩码与"训练该模型所用的监督信号"之间的一致性——由于监督信号本身是自动流水线的一部分(在 Montgomery/Shenzhen 等小集上训练),这个 Dice 不能解读为"相对放射科医师的准确率"。
§6.2 论文自证的边界
IEEE CyMaEn 论文(篇幅极短的会议文)自证内容:U-Net 变体比较、SA-UNet 胜出、上述指标、以及"用分割图提特征提升下游任务"的主张。没有:与人工标注的对照抽样、掩码误差的分布分析、跨疾病严重度的分层评估、与同期方法( nnU-Net、TransUNet 等)的比较。使用者要把这些空白当作自己的机会——任何一个补白都是可发表的增量(§7.15)。
§6.3 自动掩码的自洽性陷阱:本集最重要的方法学事实
CXLSeg 的掩码质量必须区分两个问题:其一,掩码与 SA-UNet 决策边界的一致性(官方 Dice 回答的就是这个,96%+ 很正常);其二,掩码与真实解剖的一致性(官方没回答)。第二问的答案取决于 SA-UNet 训练数据的分布(Montgomery/Shenzhen/JSRT 级别的小集)与 MIMIC-CXR 重症人群的分布差距——训练时没见过的形态(大量胸水、术后肺、极端体型)掩码失真率会上升。推论:CXLSeg 掩码的可靠性与疾病严重度负相关,而使用场景恰恰集中在重症影像(MIMIC 的来源)。这是本集最大的系统性风险,也是 CheXmask 引入 RCA 分数的动因——502 的方法学改进正对着 501 的这个缺口。
§6.4 社区使用现状:低引用的三重解释
Google Scholar 引用 2(截至 2025)。解释一:Credentialed 门槛把绝大多数学生用户挡在门外(同题的 open 数据集引用天然占优)。解释二:自动掩码的可信度争议让严肃评测研究绕行(评测集需要金标准)。解释三:2025 年 CheXmask(65 万张 + RCA + Open 通道)的降维打击——同一需求有了更严谨的供给。对本条目读者的含义:CXLSeg 的"掩码训练燃料"角色正在被 CheXmask 取代,但它的"成品包 + 标签 + 报告四件套"组合仍是独特的——继续使用它的理由要落在组合优势上,而非掩码质量上。
§6.5 机会地图:在 501 上还能做什么
按贡献大小排序:①掩码质量分层审计(按疾病严重度 + 投照姿势抽 500 片人工判读,发布首份 CXLSeg 掩码质量报告——方法学短文);②501 vs 502 交叉评测(同 MIMIC-CXR 子域上两套掩码的分歧分析,§7.15 提案三);③分割增强的严格 A/B(同一分类器在原图 vs 分割图上的对照,官方主张的独立验证);④报告生成管线(掩码 ROI + CheXpert 标签 + 报告三路对齐,官方点名的用途);⑤PA/AP 分层的分割基准(官方数字未分层,补上即是增量)。
§6.6 与母集统计的锚定对照
| 统计项 | MIMIC-CXR 母集 | CXLSeg 本集 | 占比/含义 |
|---|---|---|---|
| 图像总量 | 377,110 | 243,324 | 64.5% |
| 正位图像 | 约 368,960 | 243,324 | 约 66% |
| 患者 | 65,379 | 6,500(子文件夹数) | 约 10% |
| 人均图像 | 5.8 | 37.4 | 入选者偏重症/高产 |
| 报告 | 227,835 份(study 级) | 随 metadata 提供 | 按入选 study 子集 |
| 侧位片 | 有 | 无 | 视角缺口 |
这张表是本条目最重要的"防混淆装置":任何关于 CXLSeg 规模的叙述都能在上面对到口径。
§6.7 时间线年表
| 日期 | 事件 |
|---|---|
| 2019 | MIMIC-CXR(Sci Data 6:317)与 MIMIC-CXR-JPG(arXiv 1901.07042)发布 |
| 2022-12 | CXLSeg GitHub 仓库发布(引用 24 的 doi) |
| 2023-01-26/27 | IEEE CyMaEn 会议(曼谷),CXLSeg 论文发表 |
| 2023-02-08 | PhysioNet 版本页上线(v1.0.0,DOI 10.13026/9cy4-f535) |
| 2023-02-28 | IEEE Xplore 收录会议论文 |
| 2025-01-22 | CheXmask 上线(657,566 张,RCA 质控)——同赛道更强的竞争者出现 |
| 2026-09(核查日) | v1.0.0 无更新;Scholar 引用 2 |
年表的读点:从 GitHub 到 PhysioNet 用了约 2 个月(快);PhysioNet 上线到 CheXmask 出现约 2 年——CXLSeg 的"最大分割集"头衔维持两年后被超越;论文是低门槛会议(CyMaEn 而非 MICCAI 级),学术传播力受限。
§6.8 八个坑点(使用前必读)
坑点 1:掩码当金标准。 SA-UNet 自动生成,非人工标注——评测用它会循环论证,引用时必须写"model-generated masks"。
坑点 2:Dice 双口径。 96.80%(摘要/IEEE)vs 96.03%(版本页正文)同页并存,引用不注口径等于埋雷。
坑点 3:官方 split 的层级未知。 80:10:10 若按图像划分则患者泄漏——用前跑 §5.4 验证脚本,十小时防十天返工。
坑点 4:243,324 不是全量。 母集 377,110 的 64.5%,正位子集的 66%;缺的部分无解释,对账靠 dicom_id 差集。
坑点 5:JPG 有损压缩的掩码边缘。 中间灰度像素需要显式二值化策略;直接 bool 读取引入噪点。
坑点 6:不确定标签 -1。 CheXpert 体系的 -1(uncertain)必须显式处理(U-Ignore/U-Zero/U-Ones),默认行为会静默污染标签。
坑点 7:患者偏倚。 6,500 患者人均 37.4 张(母集人均 5.8)——"影像高产"重症亚群,人群级结论不可外推。
坑点 8:作者署名漂移。 PhysioNet “Indeewara” vs IEEE “Nimalsiri”,引用以 IEEE 论文为准,勿混用造成查重误会。
§6.9 自查清单(投稿前逐项打勾)
- [ ] 掩码描述为 model-generated(SA-UNet),未暗示人工金标准
- [ ] Dice 口径注明(96.80 摘要 or 96.03 正文)
- [ ] split 层级已验证(患者泄漏测试结果已报告)
- [ ] 规模叙述对口径(243,324 正位 / 母集 377,110 / 患者 6,500)
- [ ] 标签不确定值策略声明(U-Ignore/U-Zero/U-Ones)
- [ ] 掩码二值化阈值与中间值占比报告
- [ ] 引用四层齐全(CXLSeg + IEEE 论文 + MIMIC-CXR + MIMIC-CXR-JPG)
- [ ] 掩码抽样质量报告(§5.5 的 150 片协议)附于附录或仓库
- [ ] PA/AP 分层指标(至少报告分层样本量)
- [ ] 代码仓库无任何数据样本(随 MIMIC 协议义务)
§6.10 口径诊断树
问:你的研究需要什么?→ 若要"人工金标准掩码的严格评测集":本集不合格,转 Montgomery/JSRT(小而真)或 502 CheXmask 的高 RCA 子集;→ 若要"大规模训练燃料":本集合格,与 502 二选一(要标签报告选本集,要质控分数选 502);→ 若要"报告生成任务":本集四件套齐备,直接开箱;→ 若要"与 ICU 轨迹联合":本集 + MIMIC-IV join(§5.11);→ 若要"教学演示":本集下载一次全组共享(同一 DUA 账号下注意协议细则)。
§6.11 静态 × 活跃度定位
静态:v1.0.0 冻结三年半、无维护公告、学生团队无更新承诺。活跃:母集 MIMIC-CXR 生态持续繁荣(MIT 官方维护),本集作为衍生层持续可用;GitHub 脚本可访问。综合:稳定但不生长的成品包——像一张刻好的光盘,母集生态是持续在线的硬盘。依赖它的项目要有"永久自维护"的心理准备(所有 bug 自修、所有文档自写)。
§6.12 横向定位:胸片分割资源光谱中的坐标
把公开 CXR 分割资源排一条光谱:人工金标准端——Montgomery/Shenzhen/JSRT(数百张,专家勾画,评测可信);中间态——QaTa-COV19/COVID-QU-Ex(数千至 3.3 万张,人机混合);自动大规模端——CXLSeg(24.3 万,单模型)、CheXmask(65.8 万,跨四库 + RCA 分数)。CXLSeg 坐在自动端靠左侧(无质控分数)。光谱给使用者的选型语言:评测看左端,训练看右端,选右端时 RCA 分数是唯一的安全带(502 有、501 无)。
§6.13 四连对照表:499 / 501 / 502 / 503
| 维度 | 499 CIED | 501 CXLSeg | 502 CheXmask | 503 chexmask-u |
|---|---|---|---|---|
| 分割对象 | 心脏植入器械(3 类) | 肺野(1 类) | 解剖多类(双肺+心) | CheXmask 衍生 |
| 规模 | 13,393 图 / 896 患者 | 243,324 图 | 657,566 图 | 衍生规模 |
| 库来源 | 柏林夏里特自采 | MIMIC-CXR | 四库 | CheXmask 管线 |
| 掩码生产 | 专家+半自动 | SA-UNet 自动 | HybridGNet 自动 + RCA | U-Net 变体 |
| 质控 | 人工审核 | 无 | RCA 分数 | 继承 |
| 标签/报告 | 型号分类 | CheXpert+NegBio+报告 | 无 | 无 |
| 访问 | Credentialed | Credentialed | Open(按版本页) | 待核 |
| 独特卖点 | 手机翻拍真实场景 | 成品包 + 四件套 | 跨库统一 + 质控 | 下游应用 |
§6.14 十问十答:批判视角的自查
- 自动掩码能训练出好模型吗? 能——训练燃料的噪声被模型平均化;但不能当评测标尺。
- 96.8% Dice 意味着什么? 模型与自身决策边界的一致性;不是相对人工标注的准确率。
- 为什么不用人工标注? 24.3 万片的人工成本约数十万美元——自动掩码是规模与成本的交换,这个交换本身是合理的,只是要诚实声明。
- 官方 split 能信吗? 分层未知——跑验证脚本(§5.4)再决定。
- 本集会被 CheXmask 完全取代吗? 掩码角色会,四件套组合不会——报告与标签只有本集带。
- 6,500 患者怎么解释? 官方未解释筛选;人均 37.4 张指向重症高产亚群——这是可自行从 metadata 验证的推断。
- 掩码在重症上更差吗? 训练分布与 MIMIC 人群的差距使然——高度可能但未量化,§5.5 抽样协议可自证。
- 为什么没有 RCA 式质控? 2022 年立项时该方法(HybridGNet + RCA 论文线)尚未成熟——时代局限,不是偷懒。
- 这个数据集还值得新研究投入吗? 值得做"审计与交叉"类增量(成本低、贡献实),不值得再做"掩码工厂"类重复建设。
- 如果团队不再维护怎么办? 母集在、掩码在、脚本在——自维护即可;真正会失效的是"向团队提问"的通道。
§6.15 增量策略:在"成品包"上做增量研究的四条路
路径一(审计换信任):本集最大的公开缺口是掩码质量证书——500 片分层抽样的人工判读(疾病负荷 × 投照姿势 × 失败率矩阵)是人人可做、人人需要、尚无人发布的贡献。路径二(交叉换洞见):与 502 CheXmask 在 MIMIC-CXR 子域做掩码分歧分析,两套自动管线的分歧片就是天然"疑难片池",可直接反哺主动学习。路径三(验证换结论):官方"分割增强下游任务"主张的严格 A/B(§7.7)——正负结果都是社区需要的证据。路径四(组合换场景):四件套(图+掩码+标签+报告)支撑的三任务链(分割→分类→报告生成)在任何单一竞品上都拼不齐——组合研究是本集的护城河玩法。
§6.16 时代定位:2022 年的设计在 2026 年的位置
CXLSeg 的设计决策要用 2022 年的语境理解:当时 CheXmask 尚未发布、RCA 质控方法论未普及、分割开源生态以 U-Net 变体为主——SA-UNet + 全量推理是当时合理的工程选择。2026 年回看:nnU-Net/TransUNet 类方法成为标配、质控分数成为分割集的道德义务、基础模型(RETFound 类)改变预训练格局——CXLSeg 的掩码管线与方法叙事都显出年代感。这不是否定:它的"成品包"工程形态(成对 JPG + split + 标签)在 2026 年依然是学生友好度最高的交付之一。对使用者的启示:用它的数据组织,怀疑它的掩码质量,跳过它的方法叙事。
§6.17 竞品补注:除 CheXmask 之外,还有谁在抢"胸片分割"这个题
§2.2 与 §3.12 已把 502 CheXmask 作为头号对照,但完整的竞争地图还包括那些不上 PhysioNet 的老牌资源——它们不与本集直接竞争"引用",却决定了"肺分割"这件事的难度水位线:
| 资源 | 规模 | 掩码来源 | 授权 | 与本集的关系 |
|---|---|---|---|---|
| JSRT(SCR) | 247 张 | 人工勾画(两位放射医师) | 开放研究用 | 小而准的金标准;本集 24 万张自动掩码的"锚点测试集"——抽样对齐 JSRT 可估本集掩码的系统偏差 |
| Montgomery County / Shenzhen(TB 掩码版) | 138 + 662 张 | 人工(SMIR/TB 项目) | 开放 | 中国与美国的结核筛查片;肺野边界因病理(胸膜粘连、大面积实变)更难,是掩码鲁棒性的压力测试 |
| CHEXMASK(502) | 657,566 张 | HybridGNet + RCA 质控分 | PhysioNet Open Data | 最大的"带质控"竞品;方法学上比本集晚两代 |
| Patch-based / 学界私有集 | 不定 | 混合 | 不公开 | 多数论文用私有标注,公开可复现的基准稀缺——这是本集与 502 共同的生存空间 |
| 本集 CXLSeg | 243,324 对 | SA-UNet 自动 | PhysioNet Credentialed | 唯一带"报告+14 类标签+掩码"四件套的成品包 |
三个战略含义:其一,本集对抗 JSRT 类金标准的正确姿势是"抽样校准"而非"对标",用 247 张人工掩码校准 24 万张自动掩码的偏差方向,是把弱点变成方法论贡献的最短路径;其二,TB 类病理集提醒:掩码模型在正常解剖上表现好,不等于在胸膜疾病上可靠——本集掩码的病理区失效模式尚无系统报告,这是 §7.5 错误黑名单里的头号条目;其三,与 502 的差距是"可审计性"而非"规模",用户选择时的决策变量应是"我需不需要为每张掩码负责"——需要则 502,只需 ROI 提取兜底则本集。
§7 AI 实践指南:从喂法到发表
§7.1 五种喂法总览
①分割网络预训练(24.3 万对先预训练再小集微调);②ROI 增强的分类(掩码裁剪/掩码加权后过分类器);③报告生成(分割图 + 标签 + 报告三路);④弱监督/半监督研究(自动掩码当初始伪标签,人工只修低置信片);⑤教学(四件套齐备的全流程演示)。配方见后。
§7.2 30 分钟最小实验
目标:从零到"一对图 + 掩码叠加可视化 + split 泄漏报告"。步骤:读一对 JPG → 叠加渲染(掩码半透明盖在图上)→ 算单个样本的肺野占比 → 跑 §5.4 泄漏脚本输出跨集合 subject 数。产出一张"质量初印象图" + 一个"是否需要重切分"的结论。
§7.3 泄漏防控专项(合并 §5.4 展开)
①subject 跨集合验证(§5.4);②study 级同理(同一 study 多图不能跨集合);③时间泄漏:Study Date 相对化后患者内时序可用于纵向特征,但预测任务要按时间切;④增强泄漏:增强只在训练集内做;⑤与母集联用时的主轴原则:一切以 CXLSeg split 为主轴重切其余数据源。
§7.4 公平性与偏差清单
投照姿势:PA vs AP 分层(AP 的心影放大使掩码边界系统性不同);性别/年龄:metadata 无直接人口学字段(母集可 join),需要时从 MIMIC-IV 取并声明;疾病负荷:No Finding vs 重病分层报告;设备差异:Performed Procedure Step Description 字段捕捉投照设备差异——单中心多设备的中心内异质性真实存在。
§7.5 LLM 实验配方
三条路:①报告语料(metadata.Reports)做放射报告的摘要/改写研究——报告是英文、随 MIMIC 协议,境外 API 使用仍需过 DUA 数据位置评估,境内部署稳妥;②标签 -1 不确定性的 LLM 重标注(用报告原文重判 CheXpert 不确定项,人审抽样)——这是"标签增强"的低成本路线;③报告生成任务的 LLM 评测器(用 LLM 给生成报告打分,与 CheXbert 类自动指标对照)。本集的 LLM 空间集中在文本侧——图像侧的掩码已由 SA-UNet 生成完毕,除非重做掩码管线。
§7.6 掩码增强与半监督级联
利用自动掩码的正确姿势:第一级,SA-UNet 掩码当初始伪标签训练;第二级,模型对训练集全量推理,与伪标签分歧大的片标出来(分歧 = 疑难);第三级,人工只审 500-1000 片疑难,修正后混合训练;第四级,迭代一轮。产出:比纯自动掩码干净 3-5% 的伪标签集 + 一份"疑难片画像"。这套流程的副产品就是掩码质量报告(§7.15 提案一)。
§7.7 ROI 增强的严格 A/B 配方
官方主张"分割增强下游任务"的独立验证设计:固定分类器(DenseNet-121 预训练 CheXpert)、固定划分与标签策略,唯一变量是输入(原图 vs 掩码裁剪 ROI vs 掩码加权注意力图),报告 14 类 AUC 的均值与逐类差异 + 按疾病负荷分层。若 A/B 差异 <1 AUC 点,官方主张在本集语境下不成立——负结果同样可发表(审计型论文的价值)。
§7.8 成本核算
获取:CITI 数小时 + 审批数日(免费);装载与对账:1 人日;掩码抽样审计:0.5-1 人日(150 片);分割基线复现:2-3 人日(单 GPU);ROI A/B:3-5 人日;报告生成基线:1 周(含评估器搭建)。总启动成本 2-3 人周——比 501 之前的多数影像集都低(成品包的红利),这是它对学生与教学场景的核心吸引力。
§7.9 负结果的价值点
本集的预期负结果:①ROI 增强不显著(320×320 分辨率下 ROI 信息已全在原图内——分辨率是混淆变量);②官方 split 泄漏存在(若证实,是社区级警告);③掩码在重病层失败率显著高于健康层(证实 §6.3 推断)。三者都有明确的发表出口(short paper / 数据审计 track),而且都是"别人知道但没人写下来"的社区基建。
§7.10 与 492 MIMIC-IV 的联合研究设计
路径:CXLSeg 图像 → dicom_id → study_id → hadm_id → MIMIC-IV 诊疗表。三个具体设计:①心衰患者的肺野占比时序(同一患者多次 CXR 的掩码面积变化 vs 利尿剂暴露);②脓毒症亚群的掩码质量衰减曲线(验证 §6.3);③Support Devices 标签与 499 CIED 掩码的交叉(本集标签说"有器械",499 掩码形态可对照——虽然影像源不同库,方法学上可对照设计)。这类研究把 CXLSeg 从"分割集"升维成"影像-时序研究入口"。
§7.11 特征工程专属技巧
①肺野占比(mask 像素和 / 总像素)是免费的"过度充气/膈抬高"代理特征;②掩码对称性(左右肺面积比)捕捉单侧病变;③掩码质心偏移与体位/投照相关——先按 View Position 分层再解释;④掩码边缘粗糙度(周长²/面积)可提示胸膜病变——自动掩码的边界噪声会污染该特征,仅作探索;⑤标签 14 类的共现矩阵(CheXpert 标签高度共线:Edema/Effusion/Consolidation 共现率高)——分类特征选择时用共现聚类而非逐类独立。
§7.12 教学化改造
两周课程:第 1 周分割基础(读图/二值化/U-Net 微调/分层评估),第 2 周工程纪律(泄漏验证/掩码审计/复现包)。考核:提交"泄漏验证 + 掩码抽样"双报告——两个报告都是本集教学独有的真实工程题。课程包不含数据(学生各自申请),含全部脚本与合成示例。
§7.13 监控与回归防护
冻结 v1.0.0(MD5 锁定全部 JPG 与 CSV);掩码二值化阈值入配置管理;split 处理策略(官方 or 重切)版本化;基线指标(SA-UNet 复现值)作为回归锚点。每次管线变更跑同一 500 片审计子集的指标——回归防护的核心是"变更前后可比"。
§7.14 复现工程推荐工具链
DVC 锁定对账产物(dicom_id 集合、抽样清单);snakemake 编排读取→审计→训练;pytest 固化对账断言(243,324 成对、split 互斥、mask 存在性);papermill 参数化产出审计报告。随 MIMIC 协议的代码公开义务按此结构交付即合规。
§7.15 三条可发表的具体提案
提案一(审计型):CXLSeg 掩码质量的分层审计报告——500 片人工判读 × 疾病负荷/投照姿势分层,给出首份独立质量证书与"可信赖使用区间"。提案二(交叉型):CXLSeg vs CheXmask 的同域掩码分歧分析——MIMIC-CXR 子域上两套自动掩码的一致性地图,分歧片画像反哺标注队列。提案三(验证型):分割增强主张的严格 A/B——§7.7 设计,回答官方主张是否成立(正负结果都可发表)。三条的共同点:成本低(人周级)、本集独有属性的直接转化、不与 CheXmask 正面竞争掩码质量。
§7.16 特征字典:从原始字段到模型特征的映射建议
| 原始字段 | 建议特征 | 注意事项 |
|---|---|---|
| 掩码面积占比 | 肺野像素 / 全图像素 | 免费"过度充气/膈抬高"代理 |
| 左右肺面积比 | 连通域分析 | 心影后连通失效个别病例 |
| 掩码质心 | 坐标均值 | 先按 View Position 分层再解释 |
| 掩码边缘粗糙度 | 周长²/面积 | JPG 压缩噪声会污染,仅探索用 |
| View Position | PA/AP 哑变量 | 心影放大系统差异 |
| 14 类标签 | 共现聚类后分组 | Edema/Effusion/Consolidation 高共线 |
| -1 不确定值 | 显式策略 + 敏感性 | U-Ignore/U-Zero/U-Ones |
| Reports 长度/句式 | 文本统计特征 | study 级,一对多展开到图 |
| Study 相对日期 | 患者内时序索引 | 跨患者不可比 |
| Performed Procedure | 设备/协议哑变量 | 单中心多设备异质性 |
§7.17 审稿应对话术预置
- “掩码是自动生成的,不可信” → 回应:明确声明 model-generated(SA-UNet),150 片分层抽样审计报告(§5.5)证明在 X% 样本上掩码合格;用途限定为训练燃料与 ROI 先验,不用于金标准评测。
- “为什么不用 CheXmask?” → 回应:本研究需要标签与报告的组合(CheXmask 无标签无报告);掩码可靠性以抽样审计 + 与 CheXmask 的交叉一致性分析补充。
- “官方 split 可能有泄漏” → 回应:已按患者级验证(结果 X%),重切种子公开。
- “96.8% 是什么口径” → 回应:摘要口径;正文口径 96.03%,两者并存已在存照声明;本研究报告的是自训模型的独立指标。
- “分辨率 320 太低” → 回应:与 MIMIC-CXR-JPG 规范一致;分辨率敏感的分析已回母集 DICOM 或声明限制。
- “样本量大但患者少” → 回应:6,500 患者人均 37.4 张的偏倚已量化;患者级划分 + 患者级统计口径双保险。
§7.18 部署差距清单
若目标是院内工具:①320×320 输入与院内设备原始分辨率不匹配——部署需重建预处理链;②自动掩码的错误模式在院内分布未知——影子模式先行;③母集协议禁止数据上生产系统——只能迁移模型与方法;④单中心(BIDMC)母集的中心效应需院内验证集校准;⑤PA/AP 混合的真实流量的鲁棒性要在院内数据上重测。诚实结论:本集训练的任何模型距离病房都有完整验证阶梯,定位是方法学证据源。
§7.19 给维护方的三提案:低成本高回报的下一步
以"善意用户"的立场给团队三条具体建议——每条都能在既有资产上完成,不需要新采集:
提案一:发布 SA-UNet 权重与推理脚本。 团队做消融实验时的三个模型(U-Net/UNet++/Attention U-Net)与最终 SA-UNet 的权重如果公开,本集就从"一次性成品"升级为"可复现管线"——用户能对母集其余 133,786 张图自行扩展掩码,也能对新增数据继续生成。成本:一个 GitHub release;收益:引用结构从"数据引用"扩展到"方法引用",且直接回应 §6.4 的低引用困局(可复现管线是持续引用的发动机)。
提案二:发布一个 200 张的人工抽检子集。 随机分层抽样(按 View Position × 标签阳性分层)200 张,由两位标注者手工修正模型掩码,发布为 gold subset,并报告模型掩码对人工掩码的 Dice/HD95 分布。成本:约 2-3 人周;收益:把 §6.3 的自洽性陷阱从"批评"变成"已量化的局限",任何审稿人关于"自动掩码可信吗"的质疑都有官方数字兜底。这一条也直接补齐与 502 RCA 质控的方法学代差中最容易补的一块。
提案三:在版本页用一张表统一所有指标口径。 把 abstract 口径(Dice 96.80%)与正文口径(96.03%)合并为一张"指标 × 口径"对照表,注明各自的数据划分与阈值设定;同时在掩码说明里加一句"掩码为模型生成,非人工金标准"。成本:一次版本页编辑;收益:存照 B 类双口径从"隐性矛盾"降级为"显式注释",降低所有下游引用者的出错率(本条目 §6.3 记录的困惑就不会再发生在别人身上)。
三条提案的共同逻辑:本集的核心资产是"四件套组合",而它的短板全在"可验证性"——权重、抽检子集、口径表分别对应管线、质量、文档三个维度的可验证性。补齐之后,本集在与 502 的对话中就从"先行者"变成"完整的先行者"。
§7.20 一页纸实验预算:从本集到一篇论文的最小成本模型
给"一篇可发表的分割应用论文"排一张预算表——假设目标是"用本集掩码改进某下游任务并投一个二区/CCF-C 级别会议",全部成本用单卡(24 GB 显存)与三个月课余时间核算:
| 项 | 内容 | 成本 | 产出 |
|---|---|---|---|
| 月 1 上旬 | 数据装载+对账+二值化管线(§3.16 预算表) | 1 周 | 可复现的加载脚本 |
| 月 1 下旬 | 无掩码基线(ResNet/DenseNet 全图分类)复现 | 1 周 | 基线 AUC 表 |
| 月 2 上旬 | 掩码 ROI 实验组:裁剪/加权/双流三选一先行 | 1 周 | 对照表第一版 |
| 月 2 下旬 | 掩码质量干预:150 张抽样(§5.5)+ 失效模式黑名单(§5.7) | 1 周 | 质量分析小节 |
| 月 3 上旬 | 消融与稳健性:AP/PA 分层、标签 -1 处理策略、种子×3 | 1 周 | 主表+附录 |
| 月 3 下旬 | 写作与图表 | 1 周 | 投稿稿 |
| 算力 | 单卡 24 GB × 300 GPU 时 | 自费约 ¥1,500-3,000(云租) | — |
| 引用底线 | CXLSeg DOI + SA-UNet 论文 + MIMIC-CXR 论文 + 基线模型 | — | — |
这张表的两个用途:对内,它是排除"无限扩展数据周"冲动的纪律工具——本集 v1.0.0 冻结,装载对账是有限工作,不要让它吃掉实验时间;对外,它是回答导师/审稿人"这个数据集能不能支撑一篇论文"的现成答案——四件套(图+掩码+标签+报告)正好覆盖"主实验+消融+质量分析+讨论"四节的素材需求,这在单主题衍生集里是稀缺的完整度。若三个月预算只有一半,砍法是:质量分析小节压到 50 张抽样,双流架构换成单流 ROI——但泄漏检查(§5.2)与种子稳健性两行永远不能砍。
§8 伦理与合规:母集协议下的衍生义务
§8.1 协议继承链
CXLSeg 无独立许可条款——一切随 MIMIC-CXR:CITI 培训、DUA(不重识别/不分享/按协议使用)、PhysioNet 审批。"exists under the same IRB"意味着伦理背书也继承母集。使用者的义务链因此是:先满足母集协议,再谈本集使用;衍生成果的"发布代码"义务按母集 DUA 条款执行。
§8.2 去标识的残余风险
母集已完成日期平移、文本脱敏、烧录字符清理(MIMIC-CXR 官方流程),CXLSeg 未触碰标识层。残余风险与 MIMIC-CXR 同级:罕见病 + 多次检查 + 时间线组合的准标识性;掩码本身无新增风险(几何信息不构成新标识源)。任何疑似重识别的第一动作:停止分析、报告 PhysioNet。
§8.3 LLM 时代的数据位置
报告文本(Reports 字段)是受控内容:境外云端 LLM API 的输入即构成数据出境披露,与 DUA"不分享"条款的严格解读冲突。境内部署开源模型是安全路线;云端使用需法务书面确认;发表时的模型使用声明写明名称、位置、接触范围。
§8.4 引用伦理
四层引用链(§3.10)缺一不可——尤其母集 MIMIC-CXR(图像与报告的真正出处)与 IEEE 论文(方法出处)。二手文章把 243,324 张说成"PhysioNet 的开放数据集"是双重错误(不是全量、不是开放)——审稿遇到要指出。
§8.5 衍生数据集的边界
用 CXLSeg 掩码训练的模型权重可发布(附成员推断风险评估);掩码本身不可再分发(随母集"不分享");基于掩码的聚合统计(覆盖率分布、失败率)可发布;抽样图片需母集条款判断——保守路线是只发合成示例。这条边界与 493/494/500 讨论的"工厂产出可共享、源数据不可"原则完全一致。
§8.6 同门数据集的合规协议对照
| 项 | 499 CIED(夏里特) | 501 本集(MIMIC 衍生) | 500 脓毒症 CT(ZPPh) |
|---|---|---|---|
| 平台 | PhysioNet | PhysioNet | PhysioNet + OMIX |
| 访问 | Credentialed | Credentialed(随母集) | Credentialed + Controlled |
| 培训 | CITI | CITI | CITI |
| 伦理 | 夏里特 IRB | MIMIC-CXR 原始 IRB(继承) | ZPPh 2023-397 |
| 特殊义务 | 发布代码 | 发布代码(随母集 DUA) | 不重识别 + 发布代码 + 不分享 |
| 去标识 | 匿名化采集 | 母集完成(日期平移等) | HIPAA 全套 |
本集的特殊性在"继承"二字:伦理、协议、义务全部从 MIMIC-CXR 母集继承,本集团队没有独立授权任何新条款——使用者的一切合规问题最终都落到母集条款上。跨集联用(499+501)时义务取并集,两个 DUA 独立生效。
§9 FAQ:90 问快答
§9.1 身份与获取(Q1-Q12)
Q1:官方 slug? A:chest-x-ray-segmentation,URL https://physionet.org/content/chest-x-ray-segmentation/1.0.0/。
Q2:DOI? A:数据 10.13026/9cy4-f535;论文 10.1109/CyMaEn57228.2023.10050951。
Q3:CXLSeg 是什么缩写? A:Chest X-ray with Lung Segmentation。
Q4:谁做的? A:斯里兰卡团队五人(Meedeniya 组);第一作者 PhysioNet 署名 Indeewara、IEEE 论文署名 Nimalsiri(同一人)。
Q5:什么时候发布? A:2023-02-08(v1.0.0);论文 2023 年 1 月 CyMaEn 会议。
Q6:免费吗? A:数据免费但 Credentialed:CITI 培训 + DUA + 审批(随 MIMIC-CXR 协议)。
Q7:需要单独的 MIMIC 访问吗? A:不需要——CXLSeg 是 MIMIC-CXR 的衍生集,Credentialed 凭证即可下本集;但要 join 母集元数据则需母集访问权。
Q8:多大? A:243,324 对 320×320 JPG,约 10-20GB。
Q9:RRID? A:SCR_007345。
Q10:有 GitHub 吗? A:github.com/Wimukti/CXLSeg(脚本与定制工具)。
Q11:伦理? A:随 MIMIC-CXR 原始 IRB(版本页明示衍生同 IRB)。
Q12:访问审批要多久? A:与 MIMIC 系同流程,通常数个工作日。
§9.2 数据内容(Q13-Q28)
Q13:多少数据? A:243,324 对正位图像 + 掩码;6,500 患者子文件夹;4 张 CSV。
Q14:掩码怎么来的? A:SA-UNet 自动生成(比较 U-Net 家族后选定),非人工标注。
Q15:图像改过吗? A:图像来自 MIMIC-CXR-JPG 原样(320×320 JPG);本集新增的只有掩码。
Q16:侧位片有吗? A:没有,仅正位(PA/AP)。
Q17:分辨率? A:320×320(随母集 JPG 版)。
Q18:标签哪来的? A:CheXpert Labeler + NegBio Labeler 从报告自动派生 14 类(继承母集配置)。
Q19:报告有吗? A:有,metadata.csv 的 Reports 字段(英文,study 级)。
Q20:划分有吗? A:有,split.csv 80:10:10;层级未明说(Q41)。
Q21:掩码格式? A:JPG 灰度二值(肺野/背景),文件名 = 图像名 + “-mask”。
Q22:掩码几类? A:单类(肺野整体,不分左右肺叶段);要解剖多类转 502 CheXmask。
Q23:metadata 有哪些字段? A:Dicom/Subject/Study id、Reports、View Position、Rows/Columns、Study Date/Time、投照与定位代码等 13 字段。
Q24:人口学(年龄性别)有吗? A:本集 metadata 无;需 join MIMIC-IV 母库获取。
Q25:日期是绝对的吗? A:否,随母集去标识平移;患者内可排序,跨患者不可比。
Q26:为什么是 243,324? A:母集 377,110 张的正位处理成功子集(约 64.5%);筛选细节未披露。
Q27:6,500 患者怎么解释? A:入选者人均 37.4 张(母集人均 5.8),指向多次随访的重症亚群;官方未说明筛选逻辑。
Q28:图像有重压缩吗? A:官方声明源自 MIMIC-CXR-JPG;字节级一致性未独立验证(§4.5 开放项)。
§9.3 方法与指标(Q29-Q40)
Q29:SA-UNet 是什么? A:空间注意力 U-Net,掩码生成模型;训练用 dice loss + cross-entropy。
Q30:Dice 到底多少? A:双口径——摘要/IEEE 96.80%,版本页正文 96.03%;IoU 91.97% 一致。引用注口径。
Q31:这个 Dice 能理解为准确率吗? A:不能——它是模型与自身监督信号的一致性;相对人工标注的准确率官方未测。
Q32:掩码训练数据是什么? A:公开小集(Montgomery/Shenzhen/JSRT 级别人工标注资源);与 MIMIC 重症人群存在分布差距。
Q33:掩码在重症上会更差吗? A:高度可能(分布外失真),未量化——用 §5.5 抽样协议自证。
Q34:有质控分数吗? A:没有(CheXmask 的 RCA 类);这是 501 的核心短板。
Q35:和 CheXmask 什么关系? A:同赛道竞争者(657,566 张跨四库 + RCA 质控 + Open 通道);掩码角色被 502 取代,四件套组合仍是本集独有。
Q36:能互相评测吗? A:可以且值得——同 MIMIC-CXR 子域上两套掩码的分歧分析是高价值实验(§7.15 提案二)。
Q37:与其他 U-Net 变体比呢? A:官方比较过 U-Net/UNet++/Attention U-Net,SA-UNet 胜出;与 nnU-Net/TransUNet 等现代方法无官方对照。
Q38:官方基线代码在哪? A:GitHub 仓库(Wimukti/CXLSeg)提供脚本;训练代码完整性自验。
Q39:可以复现 96.80% 吗? A:需自行确认测试切片口径(双口径问题);复现值与官方值的差异属正常范围。
Q40:40. loss 12.59% 是什么? A:版本页正文给的训练损失下限,仅作参考;不用于模型间比较。
§9.4 使用方法(Q41-Q52)
Q41:官方 split 怎么验证层级? A:subject_id groupby 检查跨集合(§5.4 脚本十分钟);有泄漏则按患者重切并声明。
Q42:掩码怎么读? A:cv2 灰度读 + 阈值 127 二值化;中间值占比要报告。
Q43:标签 -1 怎么处理? A:U-Ignore/U-Zero/U-Ones 三选一并做敏感性;默认处理会静默污染。
Q44:增强时注意什么? A:几何变换图像掩码同参数同步;掩码用最近邻插值。
Q45:PA/AP 要分吗? A:分层报告(至少样本量);AP 心影放大会系统性影响掩码边界。
Q46:能 join MIMIC-IV 吗? A:能——subject_id/hadm_id 直通;需母库访问权。
Q47:报告语料能进 LLM 吗? A:境内部署开源模型稳妥;境外 API 过 DUA 法务评估。
Q48:能再分发掩码吗? A:不能(随母集不分享条款);模型权重与聚合统计可发布。
Q49:论文里能放样本图吗? A:保守路线用合成示例;真实切片按母集条款判断。
Q50:数据可用性声明怎么写? A:“CXLSeg (PhysioNet DOI 10.13026/9cy4-f535) Credentialed Access;代码见 [仓库];基于 MIMIC-CXR (Johnson et al. 2019)。”
Q51:装载要多久? A:半天以内(下载另计);对账脚本十几个断言(§3.13)。
Q52:环境要求? A:32GB 内存 + 25GB 磁盘 + 单 GPU 12GB 起即可全量训练。
§9.5 对比与选择(Q53-Q64)
Q53:和 CheXmask 选哪个? A:掩码质量与跨库选 502;标签+报告+官方划分的组合选本集。
Q54:和 499 CIED 呢? A:不同任务(器械 vs 肺野);研究器械分割选 499。
Q55:和 Montgomery/JSRT 呢? A:人工金标准小集做评测;本集做大规模训练——互补不互替。
Q56:想快速跑通流程? A:本集开箱即用度最高(成对 JPG + split + 标签)。
Q57:论文只用本集够吗? A:审计/交叉/A-B 类贡献够;纯分割方法建议加外部验证集。
Q58:审稿人会攻什么? A:掩码自动生成、双口径 Dice、split 层级、患者偏倚——§7.17 话术预置。
Q59:会被 CheXmask 淘汰吗? A:掩码角色部分会;组合优势(标签+报告+划分)不会。
Q60:数据会更新吗? A:三年半无更新;按冻结资源规划。
Q61:值得投入吗? A:2-3 人周成本对应审计/交叉/教学类产出——性价比高;掩码工厂类重复建设不值得。
Q62:一句话总结? A:MIMIC-CXR 正位子集的成品分割包——工程开箱即用、掩码自动生成需审计、四件套组合是它相对 CheXmask 的最后护城河。
Q63:适合毕业论文吗? A:适合硕士级(审计/交叉/A-B 任一 + 严谨复现包);博士级建议 502 或自建方向。
Q64:适合医院落地吗? A:不能直接落地——320×320 分辨率 + 自动掩码 + 单中心母集;定位是方法学训练场。
§9.6 进阶问答(Q65-Q90)
Q65:dicom_id 能对上母集吗? A:能,metadata 继承母集标识体系;差集分析即可审计覆盖率。
Q66:掩码能上采样到原始 DICOM 分辨率吗? A:可以(最近邻),但要声明上采样误差;严格研究建议回母集分辨率重跑掩码管线。
Q67:左右肺能分开吗? A:单类掩码不含左右标注;可用连通域分析自动拆分(心影后肺野连通性个别病例会失效)。
Q68:胸水患者的掩码可信吗? A:分布外失真高发区——分层抽样的重病层专门测这个。
Q69:能做肺容量估算吗? A:掩码面积是粗代理;320×320 分辨率 + 自动边界下只支持相对/趋势分析,不支持绝对容量。
Q70:No Finding 标签可信吗? A:报告派生的"无发现"含报告漏写风险;作为分层轴用可以,作为疾病标签要谨慎。
Q71:Support Devices 标签和 499 的关系? A:本集标签说"有器械",499 提供器械掩码与型号——不同库不同患者,但任务谱系互补(§7.10 设计三)。
Q72:能训练出"更好的掩码"吗? A:能——用本集掩码做初始伪标签 + 人工修正的半监督迭代(§7.6),产出质量超越 SA-UNet 的新掩码属合法增值(发布遵循母集条款)。
Q73:官方脚本包含什么? A:版本页提到"script to customize the dataset"(GitHub);裁剪/重命名/格式转换类工具,非训练管线。
Q74:CSV 编码有坑吗? A:标准 UTF-8;Reports 字段含换行——pandas 默认参数即可,别用 excel 手开。
Q75:能和 CheXpert 官方标签对照吗? A:母集 MIMIC-CXR-JPG 的官方标签文件与本集 segmented.csv 同源(CheXpert+NegBio),对照应一致;不一致处按母集为准。
Q76:320×320 够用吗? A:分割/分类够;细小病灶(结节级)不够——转母集 DICOM。
Q77:训练时把掩码当输入还是标签? A:都行——当标签训分割模型;当注意力先验辅助分类;当 ROI 裁剪指南。三种用法对应三条研究线。
Q78:同一患者多图怎么聚合? A:study 内多图共享报告;患者内纵向可排序(相对日期);聚合策略按任务声明。
Q79:掩码面积特征的归一化? A:除以全图像素(占比)即天然归一;跨患者比较时先按 View Position 分层。
Q80:验证集能换着用吗? A:官方 80:10:10 的 val 可与 test 互换做双重报告;重切分时要全量重报。
Q81:能预测掩码质量吗? A:可以——以图像统计特征(对比度、假影、体位标记)预测掩码失败率,本身就是可发表的元任务(自动质控的 501 版)。
Q82:学生课设选题建议? A:审计报告(提案一)最合适:成本可控、流程完整、结论真实有用。
Q83:审稿要求"人工验证掩码"怎么办? A:跑 §5.5 的 150 片协议写入附录;要求更高则扩到 500 片分层(提案一规模)。
Q84:能发布基于本集的竞赛吗? A:随母集协议限制,公开竞赛需 PhysioNet/母集方许可;内部 benchmark 可行。
Q85:掩码的许可和图像一致吗? A:是——掩码随整个数据集走母集协议;衍生掩码(Q72 迭代产物)的发布边界咨询母集方。
Q86:引用时第一作者写谁? A:以 IEEE 论文为准(Nimalsiri);PhysioNet 署名差异在脚注说明即可。
Q87:能用于商业产品吗? A:MIMIC 系协议禁止商业再分发;商业机构内部研究按 PhysioNet 商用条款申请确认。
Q88:会有人工标注版吗? A:无任何公告;需求者可关注 CheXmask 的高 RCA 子集作为准人工替代。
Q89:本集最被低估的资产? A:官方 split + 双标签器 + 报告的组合——它让"同一划分下做分割→分类→报告生成三任务链"成为可能,这是其他分割集给不了的。
Q90:三年半无更新说明了什么? A:学生项目生命周期的常态;母集生态稳定所以资源可用性无忧,但别期待 bug 修复——自维护心态使用。
§9.7 番外:来自写作过程的十个冷观察
- 版本页 Background 段的 Dice(96.03)与 abstract(96.80)同页并存——会议论文投完没回填统一,是学生项目的典型痕迹。
- 引用 24(数据集论文条目)指向 GitHub 仓库 doi 而非 IEEE——团队自己把"论文"锚在仓库上,IEEE 收录是后置事件。
- 6,500 患者子文件夹的数字只出现在目录结构描述里,从未作为"患者数"被官方陈述——这个偏倚是本条目从目录树推出来的。
- MIMIC-CXR 母集人均 5.8 张 vs 本集人均 37.4 张——六倍的差距藏在两个官方数字的除法里。
- "largest segmented chest x-ray dataset with medical reports"的限定词很精确——"with medical reports"是为了与同期无报告的大集区分。
- CheXpert+NegBio 双标签器是母集原厂配置——本集没有自己标任何东西,它卖的是掩码与工程形态。
- Release notes 写 “extended version of MIMIC-CXR 2.0.0”——"扩展版"的说法把衍生集与母集的关系说成了版本关系,容易误导。
- SA-UNet 的 12.59% loss 与四个指标并列出现——训练日志直接贴版本页的作风。
- 本集上线(2023-02)与 CheXmask 上线(2025-01)相隔 23 个月——"最大分割集"头衔的保质期正好两年。
- Google Scholar 引用 2 次——与 24.3 万对的规模形成本系列最刺眼的规模-影响力剪刀差,主因是 Credentialed 门槛。
§9.8 十二个"如果……怎么办"
如果只要掩码不要标签报告? 用 502 CheXmask(65 万张 + RCA 质控);本集的价值在四件套组合。
如果要人工金标准? 本集没有;Montgomery/JSRT(小而真)或 502 高 RCA 子集。
如果 split 有患者泄漏? 按患者重切 + 公开种子 + 论文声明与官方划分的差异。
如果掩码在重病上失败率高? 分层报告失败率 + 低置信片人工修正(§7.6 级联)——把缺陷变成方法学贡献。
如果要侧位片? 本集无;母集 MIMIC-CXR 有(需另申请)。
如果要原始分辨率? 回母集 DICOM;掩码上采样要声明插值误差。
如果审稿人要求与 nnU-Net 比? 补一组 nnU-Net 在同 split 上的结果——现代基线补齐是低成本高回报的回应。
如果 GPU 不够? 320×320 的 U-Net 家族单卡 12GB 足够;分类 A/B 用冻结特征 + 线性探针更省。
如果要用报告做 LLM 训练? 境内部署开源模型;境外 API 过法务;发表时写清模型名称与部署位置。
如果发现自己重训练的掩码更好? 合法增值——发布遵循母集条款(掩码不可再分发,可发差异统计与模型权重)。
如果与 502 结果矛盾? 检查掩码二值化与划分对齐后再解释——两集的构造差异(SA-UNet vs HybridGNet)本身就是矛盾的第一解释变量。
如果团队不回邮件? 自维护心态:母集文档 + 本集存照 + 社区复现经验足够覆盖 95% 的问题。
§9.9 尾注三问:合上文件后,请自问这三件事
九十多问都答完之后,真正决定你与本集关系的,是这三个更朴素的问题:
一问:你的任务真的需要掩码吗? 大量下游任务(分类、检索、报告生成)在 320×320 全图上用 CNN 就能做得不错,掩码的真实增益集中在三类场景:ROI 裁剪后的小目标(气胸带、少量胸腔积液)、需要肺区解剖对齐的量化(心胸比、肺容积代理)、可解释性展示(告诉临床医生"模型看的是这里")。如果你的任务不在三类之内,引入掩码带来的 JPG 伪影、边界噪声与管线复杂度可能是负资产。先跑一个无掩码基线,再决定是否启用本集——这是本条目最想传达的一条工程纪律。
二问:你能容忍多大的"静默错误率"? 本集掩码无逐张质控分数,意味着一定比例的掩码(边缘偏移、病理区失效、罕见的左右标记错误)会静默进入你的训练集。这个比例无人知晓——你可以用 §5.5 的 150 张抽样协议估个下界。回答"多大比例我接受"取决于你的下游:做教学演示,99% 的准确掩码足够;做自动报告生成里"心胸比"的量化输出,那 1% 的静默错误会以最尴尬的方式出现在临床用户面前。容忍度决定你是本集用户还是 502 用户。
三问:一年后,你会引用哪个 DOI? 如果你的工作只是用了掩码做 ROI,引用本集 PhysioNet DOI(10.13026/9cy4-f535)就够了;如果你复现或扩展了 SA-UNet 管线,还该引用 IEEE 论文(10.1109/CyMaEn57228.2023.10050951);如果你从仓库拿了早期版本代码,GitHub doi 也在引用链上(见 §3.10 的四层结构)。想清楚这一点不是给团队送人情,而是让你的读者能顺藤摸到正确的资产——引用错层的 DOI 是本集引用史里已经发生过 24 次的事。
三问的共同底色:本集是一款"边界清晰的好工具"——规模真实、结构规整、四件套组合在衍生集里独一份;它的短板(自动掩码、口径双写、低引用)都有明确的位置与规避方法。把工具用在它擅长的地方,剩下的路,§5 到 §7 已经铺好。
§10 存照、引文与变更日志
§10.1 存照 A-K(核查期 2026-09-21)
- A. 作者署名漂移:PhysioNet 版本页 “Wimukthi Indeewara” vs IEEE 论文 “Wimukthi Nimalsiri”(其余四作者一致)。
- B. Dice 双口径:摘要/IEEE 96.80% vs 版本页正文 96.03%(IoU 91.97% 两口径一致)。
- C. 掩码生成机制:SA-UNet 自动生成(论文与版本页一致);无人工抽检报告、无质控分数交付。
- D. 覆盖率缺口:243,324 vs 母集正位约 368,960(约 66%);未入选部分无官方解释。
- E. 患者覆盖悖论:6,500 患者(10%)承载 64.5% 图像;人均 37.4 张 vs 母集 5.8 张;筛选逻辑未披露。
- F. split 层级未明说:80:10:10 的划分单元(patient/study/image)官方文档缺失。
- G. 版本锚定:Release notes 称 “extended version of MIMIC-CXR 2.0.0”;母集版本语义以 MIT 官方为准。
- H. 引用 24 指向 GitHub:数据集论文的官方引用条目实为 GitHub 仓库 doi(Wimukti/CXLSeg,2022-12),IEEE 会议论文另计。
- I. 低引用状态:Google Scholar 引用 2(截至 2025);与规模不匹配,与 Credentialed 门槛 + CheXmask 竞争相关。
- J. 无资助信息:版本页与论文均未列资助编号。
- K. 分辨率锚定:320×320(MIMIC-CXR-JPG 规范继承);高分辨率需求需回母集 DICOM。
§10.2 引文清单
- Indeewara W (Nimalsiri W), Hennayake M, Rathnayake K, Ambegoda T, Meedeniya D. Chest X-ray Dataset with Lung Segmentation (version 1.0.0). PhysioNet (2023). DOI 10.13026/9cy4-f535
- Nimalsiri W, Hennayake M, Rathnayake K, Ambegoda T, Meedeniya D. CXLSeg Dataset: Chest X-ray with Lung Segmentation. IEEE CyMaEn (2023). DOI 10.1109/CyMaEn57228.2023.10050951
- Johnson AEW, Pollard TJ, Berkowitz S, Greenbaum NR, Lungren MP, Deng C, Mark RG, Horng S. MIMIC-CXR, a de-identified publicly available database of chest radiographs with free-text reports. Sci Data 6:317 (2019). DOI 10.1038/s41597-019-0322-0
- Johnson AEW et al. MIMIC-CXR-JPG, a large publicly available database of labeled chest radiographs. arXiv:1901.07042 (2019)
- Irvin J et al. Chexpert: A large chest radiograph dataset with uncertainty labels and expert comparison. arXiv:1901.07031 (2019)
- Peng Y et al. NegBio: a high-performance tool for negation and uncertainty detection in radiology reports. arXiv:1712.05898 (2017)
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. arXiv:1505.04597 (2015)
- Pollard T et al. PhysioNet as a global platform for biomedical research. Nature Health (2026)
§10.3 系列关系
同谱系:492(MIMIC-IV 表格母库)→ MIMIC-CXR(影像母集,本系列后续条目)→ 501(本集,分割衍生层)→ 502/503(CheXmask 竞品线)。同任务带:499(CIED 器械分割)与本集构成"稀有目标 vs 通用解剖"的两极。下游:502 CheXmask 的 RCA 质控方法论是对本集缺口(存照 C)的行业回应。
§10.4 变更日志
- 2026-09-21:初版。核查源:PhysioNet 版本页、PhysioNet segmentation 主题列表、IEEE CyMaEn 论文页(Xplore 元数据)、Springer CXR 分割综述(2025)、Google Scholar。DAIMS 5.1/8。存照 A-K 共 11 条。
§10.5 核心数字一览(写作与引用速查卡)
| 数字 | 口径 | 出处 |
|---|---|---|
| 243,324 | 正位图像数(=掩码对数) | 版本页 abstract |
| 377,110 | 母集 MIMIC-CXR 图像总量 | Johnson et al. 2019 |
| 65,379 / 6,500 | 母集患者 / 本集患者子文件夹 | 母集论文 / 版本页 |
| 80:10:10 | 官方划分比 | CXLSeg-split.csv |
| 14 | CheXpert 标签类别数 | CheXpert 体系 |
| 96.80% / 96.03% | Dice(摘要口径 / 正文口径) | abstract / background |
| 91.97% | IoU | 版本页 |
| 320×320 | 图像与掩码分辨率 | MIMIC-CXR-JPG 规范 |
| 2023-02-08 | 版本发布日 | 版本页 |
| 10.13026/9cy4-f535 | 数据 DOI | 版本页 |
| 2022-12 | GitHub 首发 | 引用 24 |
| v1.0.0 | 唯一版本(截止 2026-09) | 版本页 |
§10.6 阅读地图
- 5 分钟了解:INFOBOX + §0 摘要卡
- 决策"用不用":§1.9 用户画像 + §6.6 母集对照表 + §6.10 诊断树
- 准备申请:§3.8 访问流程 + §8 合规
- 开始装载:§3.7 装载流程 + §3.13 对账清单
- 设计研究:§6.5 机会地图 + §7.15 三提案
- 写论文:§6.9 自查清单 + §7.17(见 §7.17 审稿话术)+ §8.4 引用规范
- 被卡住:§9 FAQ 90 问按主题检索
§10.7 后续观察清单
- [ ] 版本是否 > 1.0.0(若有:对账脚本重跑)
- [ ] 是否出现掩码质控补丁或人工抽检公告
- [ ] CheXmask 线(502/503)的演进对本集定位的影响
- [ ] GitHub 仓库的可访问性
- [ ] 引用数是否随 CheXmask 生态而变化
本条目为千方病案医数集 Top1000 AI-Ready 医疗数据集百科第 501 号,依据官方一手来源核查撰写;数据以官方平台为准,引用请以 DOI 页面显示的最新版本信息为据。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- cardiac-implantable-device-cxr — 共享标签:医学影像 / 图像分类
- chexpert — 共享标签:医学影像 / 图像分类
- nih-chestx-ray14 — 共享标签:医学影像 / 图像分类
- gastrovision — 共享标签:医学影像 / 图像分类
- rfmid — 共享标签:医学影像 / 图像分类
- oct2017 — 共享标签:医学影像 / 图像分类
- brset — 共享标签:医学影像 / 图像分类
- echonet-lvh — 共享标签:医学影像 / 图像分类
- fetal-planes-db — 共享标签:医学影像 / 图像分类
- image-embeddings-mimic-cxr — 共享标签:医学影像 / 图像分类
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
