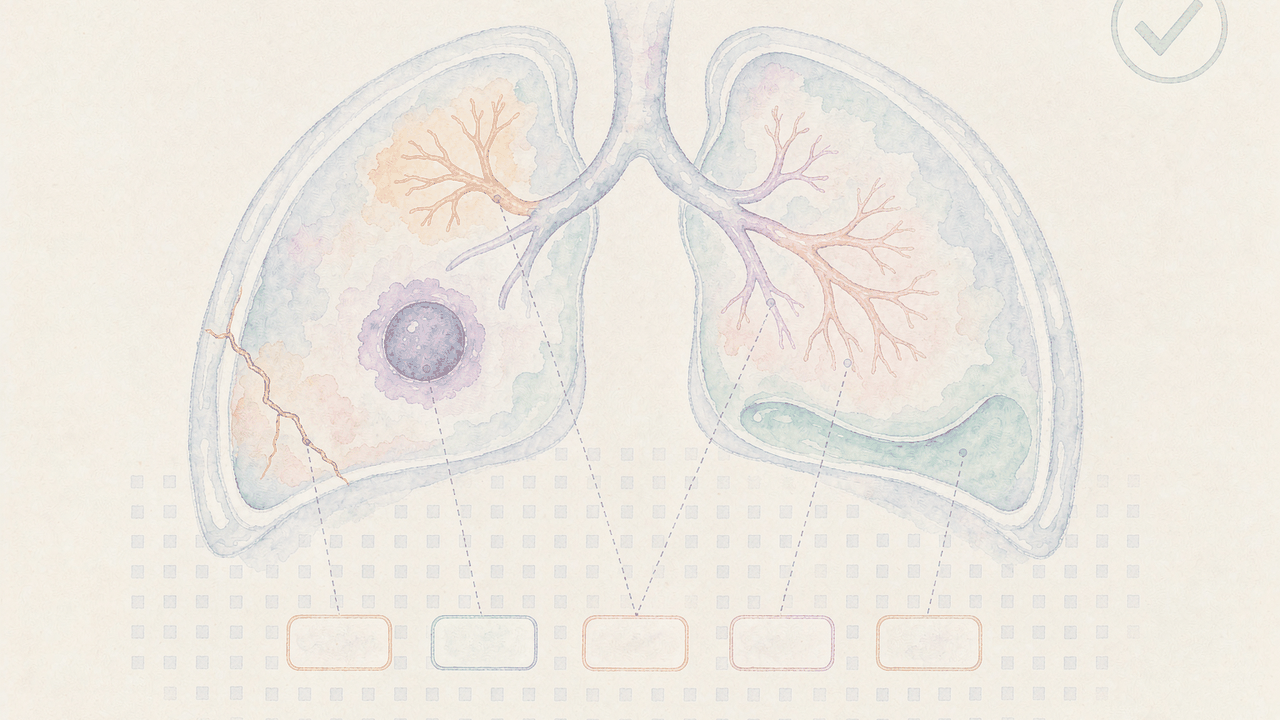
信息速览
INFOBOX — ChestPathCT5-S100 一屏速览
维度 内容 本质 真实世界胸部 CT 小样本高质量数据集(87 例),非常规意义的大规模训练库 团队 瑞士洛桑大学医院(CHUV)诊断与介入放射科;通讯 Guillaume Fahrni 论文 GigaByte 2026, article 184(DOI 10.46471/gigabyte.184;PMID 42245226;PMC13231509) 发布节奏 Zenodo v1.0 先行(2026-02-20)→ 论文在线(2026-05-25) 样本 87 例检查 = 初始 100 例 − 排除 13 例(拒绝同意 / 图像质量不足) 五类 肺栓塞 PE 20|气胸 20|肺肿块 Mass 17|胸腔积液 Fluid 16|肋骨骨折 RF 14 人群 男 49 / 女 38;年龄中位 64 岁 [IQR 46–76];队列窗口 2015-01 至 2025-12 期相 动脉期 CTA 52(60%)|非增强 25(29%)|静脉期 10(11%) 采集 单厂商 GE Healthcare;128–256 层;层厚 0.60–2 mm;矩阵 512×512 体积 9.4 GB(Zenodo 文件清单)/约 10 GB(论文口径);五个类别 zip 格式 NIfTI .nii.gz,每例一个体积标注 单标签主类别 + 87×5 二值共现矩阵(Table 2) 验证 两名放射科医师核对类别归属、图像完整性、主病变可见性 许可 数据 CC0 1.0(免署名、可商用);论文 CC BY 4.0 获取 Zenodo 直接下载,无申请、无 DUA、无账号门槛 库内互链 RibFrac(rid 451)、SIIM-ACR Pneumothorax(rid 737)、chest-ct-sepsis-er(rid 600)、rad-chestct(rid 819)
ChestPathCT5-S100 是一份"反潮流"的医学影像数据集。当同领域的公开数据集动辄以万例、十万例计数时,它只交出 87 例——但这 87 例不是从单一干净队列里挑出来的理想样本,而是从一家瑞士大学医院十年(2015–2025)的常规临床影像档案里,按五类最常见胸部病变一类一类手工筛出来的"典型病例"。它的设计目标不是"大",而是"像临床":能增强的做增强,需要动脉期的做动脉期,创伤病人送来时是什么协议就保留什么协议。作者把这个选择明确写在标题里——heterogeneous acquisition conditions,采集异质性不是缺陷,是被刻意保护的特征。
理解这一点,就理解了这份数据的正确用法。它不适合当预训练语料"堆量",而适合回答另一类问题:一个在三甲医院干净动脉期数据上训练到 0.95 AUC 的模型,喂进一例平扫、层厚 1 mm、切片数只有 264 的急诊创伤 CT 时会掉到多少?跨期相、跨层厚、跨扫描协议的性能衰减曲线长什么样?这类"离群压力测试"需要的不是更多数据,而是受控的异质性——每个类别里都同时存在动脉期、静脉期和平扫,且每一种都能查到具体是哪一例。
名中的"S100"常被误读为"每类 100 例"。实际是初始获批队列的规模:一百例,五类各二十例,最终有十三例因为病人拒绝研究用途授权或图像质量不达标而被剔除,剩下 87 例。所以文件名里的病例号不连续——这不是数据打包出错,而是筛选过程的化石痕迹。
导语读法三则:
- 只想下数据跑基线:直接跳 §6 获取与许可。CC0 1.0,Zenodo 点开即下,9.4 GB 五个 zip,不需要任何申请表。
- 评估模型鲁棒性:重点读 §4 的期相分布表和 §8 的坑点 4(期相与类别强相关,不是随机分布)。这决定了你能不能把"性能下降"归因于期相本身。
- 把它和同类数据集比:读 §7 的对照表。它和 RibFrac、SIIM-ACR Pneumothorax 不是竞争关系,而是位于"挑战赛大数据集"与"临床小样本"之间的一个中间点位。
§0 导读:这个数据集解决什么问题
0.1 医学影像 AI 的"干净数据幻觉"
过去十年,公开胸部影像数据集形成了一条隐含的"标准配方":从单中心、单设备、单协议的档案里抽出一批满足特定条件的检查,人工剔除伪影和边缘案例,然后规模越大越好。这条配方产出了极有价值的资源,但也制造了一个共同的偏差——模型在训练分布内表现优异,一旦进入真实临床环境就系统性掉点。原因不在模型容量,而在训练数据从未包含真实环境里的"脏":不同期相、不同层厚、不同重建核、不同体位、不同病人状态。
ChestPathCT5-S100 的出发点正是这个偏差。作者在论文中把"intentionally preserving acquisition heterogeneity and concomitant findings"写成方法论宣言:他们不是"没能做成干净数据",而是"选择不做"。这一句话决定了整份数据的所有其他特征——小样本(因为要逐例人工核对)、多期相(因为真实临床就多期相)、附带共现矩阵(因为真实病例很少只有一种病)。
0.2 三个具体的问题意识
第一,期相异质性的系统性缺失。 肺栓塞必须做 CTA 动脉期才能诊断,肋骨骨折在创伤平扫里就能看,肺肿块常在肿瘤随访的静脉期增强里被发现。这意味着如果按病变类型分包,期相天然就会与类别相关。大多数公开数据集在预处理阶段会把期相"洗掉"——只保留一种,或者转成统一的 HU 窗。ChestPathCT5-S100 反过来保留了三种期相的完整分布,并在论文中逐条报告每类的期相构成。这既创造了研究价值,也埋下了分析陷阱(见 §8 坑点 4)。
第二,共现发现在单标签范式下被丢弃。 一例肺栓塞的 CT 上同时有胸腔积液,这在临床上是最普通的事。但传统分类数据集只给一个主标签,模型于是学到"有积液 = 积液类",而这个判断在真实病例上必然出错。作者的做法是附带一张 87×5 的二值共现矩阵,让研究者可以在训练时就把"这例 PE 同时有积液"作为多标签监督信号使用,而不是把共现当成噪声。
第三,验证与标注的分离。 这份数据没有分割掩码,也没有定量测量。两名放射科医师做的是"技术验证"——确认类别归属对不对、图像有没有坏、主病变看不看得清——而不是"标注"。这个区分看似琐碎,实际上定义了数据的适用边界:它可以支持分类、检测(弱监督)、多任务,但不支持监督分割(见 §8 坑点 3)。
0.3 一个"小而完整"的样本
在数据集生态里,87 例是一个尴尬的数字:训练深度学习模型偏少,做统计推断又偏多。但对特定研究目的,这个规模恰好足够。弱监督与少样本学习、跨域泛化评测、类别不平衡处理、多标签共现建模——这些方向需要的是"结构清晰的受控样本",而非海量数据。作者在论文中列出的适用场景(classification、detection、weakly supervised learning、multi-task learning)正是这个定位。
值得强调的另一点是文档完整度与数据规模的比值。论文用一整篇 Data Release 描述 87 例数据,逐类报告期相构成、逐例给出共现标记、逐项说明排除理由、逐条交代匿名化流程。这种"小数据 + 厚文档"的组合,在数据集复现性上反而比"大数据 + 薄文档"更可靠——你可以真正把这 87 例逐一核对回论文表格。
0.4 阅读本文的定位
本文不是论文的翻译,而是一份面向数据使用者的工程手册。所有硬数字都标注了来源(论文正文 / 表格 / Zenodo 文件清单),凡三源口径不一致处一律在 §10 存照,不做"取平均"式的调和。凡论文未披露的信息(例如每例的具体期相标签是否随数据发布),明确标为"未获证实",绝不填补。
§1 数据集速览:十四问十四答
Q1:ChestPathCT5-S100 到底是 87 例还是 100 例?
87 例。100 是初始获批队列规模(五类各 20 例),最终排除 13 例——因病人未同意研究用途或图像质量不达标——剩下 87 例进入公开发布。名称中的"S100"记录的是起点,不是终点。Zenodo 文件清单中的五个 zip 加起来正好是 87 例的体积。
Q2:五类各有多少例?加起来对吗?
肺栓塞 20、气胸 20、肺肿块 17、胸腔积液 16、肋骨骨折 14,合计 87。论文与 Zenodo 描述两处数字完全一致,这是本文中核对成本最低的一组数字。
Q3:一人一例还是有多例来自同一病人?
一例对应一名患者的一次 CT 检查,无患者重复入组。这一条作者在论文中明确写出,因此 87 例 = 87 名患者,不存在"病人级泄漏"风险——这一点在小数据集里尤其重要,很多数据集因为同一病人多次扫描而需要按病人切分训练/验证集。
Q4:图像是什么格式,怎么组织?
NIfTI 格式的 .nii.gz 压缩体积,按病理类别分包成五个 zip:Med3DVlM_Fluid.zip、Med3DVlM_Mass.zip、Med3DVlM_PE.zip、Med3DVlM_Pneumothorax.zip、Med3DVlM_RF.zip。每个 zip 内是若干 .nii.gz,一例一个文件。
Q5:为什么 zip 名字里是 Med3DVlM,而不是论文写的 ChestPathCT5-S100?
这是本文发现的第一处文档不一致,且论文未作解释。论文正文给的命名规则是 ChestPathCT5-S100_FC_XXX(FC 为类别代码,XXX 为病例号),而 Zenodo 上实际下载到的五个 zip 前缀全是 Med3DVlM。合理解释是该项目早期内部代号(Med3D + VLM,暗示曾考虑视觉语言模型方向)在打包时未统一替换。使用者在写脚本时必须按实际文件名匹配,不能按论文命名规则硬编码——否则批量读取会全部落空。相关处置见 §8 坑点 2。
Q6:一共多大?
Zenodo 文件清单显示五个 zip 合计 9.4 GB:Fluid 1.8 GB、Mass 1.8 GB、PE 1.4 GB、Pneumothorax 2.6 GB、RF 1.8 GB。论文正文写"约 10 GB"。两者相差约 6%,属于四舍五入与压缩率差异的正常范围,本文两处口径均保留,不做统一(见 §10 存证 3)。
Q7:图像参数大概是什么水平?
单一厂商 GE Healthcare 设备,128–256 层配置,层厚 0.60–2 mm,重建矩阵 512×512。论文报告的整体统计:层厚中位数 0.62 mm,四分位距 0.62–1.25 mm;层数中位数 481 层,四分位距 264–521 层。这两个中位数背后的四分位距才是关键——它告诉你数据里既有一叠 62 层的薄层,也有一叠 26 层左右的厚层。
Q8:对比剂期相怎么分布?
动脉期 CTA 52 例(60%)、非增强 25 例(29%)、静脉期 10 例(11%)。喷射时序:动脉期约 40 秒,静脉期约 90 秒;肺栓塞检查采用团注跟踪(SmartPrep),待肺动脉对比剂到达后触发。
Q9:为什么只用一个厂商的设备?
作者明确说明是为限制硬件相关变异。这是一个刻意的取舍:在"保留临床异质性"和"控制硬件变量"之间,他们只放开了前者。结果是采集异质性主要体现在期相与协议上,而不是在设备谱系上。这对研究设计有直接影响——你没法用这份数据研究跨厂商泛化。
Q10:标注是什么粒度?
单标签:每例一个主类别,由两名放射科医师验证归属正确。外加一张 87×5 的二值共现矩阵,标记每例除主类别之外还同时存在哪几类发现。没有边界框、没有分割掩码、没有定量分级。
Q11:两名放射科医师具体做了什么?
核对四件事:①病理类别归属是否正确;②DICOM 转 NIfTI 后图像是否完整、体积覆盖是否齐全;③是否存在损坏文件;④主病变在体积上是否清晰无歧义可见。此外还额外筛查了每例的合并发现,形成共现矩阵。病例由两名读者分配审阅,而非双人独立双阅。
Q12:数据里有没有病人信息?
没有。匿名化流程分三步:移除 DICOM 元数据 → 转 NIfTI → 复查并清除 NIfTI 头文件与关联 JSON 里的残留元数据。图像体积只保留胸部范围,不包含可能致再识别的面部结构。伦理定性上,CHUV 法务确认项目 Hors-LHR-BPR1546 不在瑞士《人类研究法》(HRA, SR 810.30)管辖范围内,因此无需伦理委员会批准——这是瑞士法律对"完全匿名化"数据的一类豁免路径,不是"绕过伦理审查"。
Q13:许可真的一点门槛都没有?
数据是 CC0 1.0 Universal,公共领域贡献,允许不受限制地使用、再分发与改编,甚至不要求署名(当然学术惯例上仍应引用)。论文本身是 CC BY 4.0,与数据许可不同,引用论文时需按 CC BY 保留署名。很多人把这两者混为一谈,这里必须分开理解。
Q14:能用它做什么,不能做什么?
能:五类单标签分类、多标签/共现建模、弱监督检测、多任务学习、跨期相与跨协议鲁棒性评测、放射科教学与病例展示、预处理流程基准测试。
不能:监督语义分割(无掩码)、预后建模(无随访与临床变量)、跨厂商泛化研究(单厂商)、大样本预训练(87 例不够)、任何临床决策支持系统的直接验证(作者明确声明未针对临床决策验证)。
§2 论文、机构与时间线
2.1 论文身份卡
| 项目 | 内容 |
|---|---|
| 标题 | ChestPathCT5-S100: an open real-world chest CT dataset of five common thoracic pathologies with heterogeneous acquisition conditions |
| 文章类型 | Data Release(数据发布) |
| 期刊 | GigaByte(GigaScience Press 出版,香港沙田) |
| 文章号 | gigabyte.184(该刊不设传统卷期,以文章号标识) |
| ISSN | 2709-4715 |
| DOI | 10.46471/gigabyte.184 |
| PMID / PMCID | 42245226 / PMC13231509 |
| 投稿 | 2026-02-23 |
| 接收 | 2026-05-18 |
| 在线 | 2026-05-25 |
| 预印本 | 10.20944/preprints202605.1079.v1(论文页自述,未独立核验) |
| 论文许可 | CC BY 4.0 |
GigaByte 是 GigaScience Press 旗下的开放获取数据期刊,专收"数据发布"类文章——它的定位是让数据集本身成为可引用的学术产出,而不是论文的附属材料。这意味着 ChestPathCT5-S100 有两个正式引用对象:论文(DOI 10.46471/gigabyte.184)与数据(Zenodo DOI)。引用规范上两者都应列出,只引数据不引论文会丢失方法学依据,只引论文不引数据则不符合数据可复现的惯例。
2.2 时间线:数据先于论文
这条时间线值得单独说,因为它与大多数数据发布文章的节奏相反:
2025-12   队列窗口结束(十年窗口 2015-01 至 2025-12)
   │
2026-02-20  Zenodo v1.0 发布(数据集先公开,DOI 10.5281/zenodo.18256797)
   │
2026-02-23  论文投稿
   │
2026-05-18  论文接收
   │
2026-05-25  论文在线(GigaByte article 184)
先发数据、后发论文的顺序有一个实际后果:数据本身不会因为论文修订而变化。Zenodo v1.0 在 2026 年 2 月 20 日就冻结了,论文 5 月上线时描述的就是已发布的这一版。这对复现性是好消息——不会出现"论文说 87 例、实际下载到 85 例"的经典错配。但也意味着如果数据在打包时存在命名瑕疵(例如 §1 Q5 提到的 Med3DVlM 前缀),论文阶段已经无法回头修正,只能靠文档记录。
论文中"follows a versioned release structure to support reproducibility and future updates"这句表明作者预留了后续版本的空间。截至目前(2026-10),Zenodo 仅显示 v1.0 一个版本,没有 v1.1 或 v2.0。使用者在论文中引用时应写明版本号(v1.0)而不是只写 concept DOI,否则当未来出现新版本时,你的复现结果会指向一个不同内容的数据集。
2.3 机构:一家医院的放射科
全部四位作者隶属同一个单位:
Department of Diagnostic and Interventional Radiology, Lausanne University Hospital and University of Lausanne, Rue du Bugnon 46, CH-1011, Lausanne, Switzerland
(瑞士洛桑大学医院与洛桑大学 诊断与介入放射科)
洛桑大学医院(Centre Hospitalier Universitaire Vaudois,CHUV)是瑞士五家大学医院之一,位于沃州洛桑,服务法语区约百万人口。它是瑞士西部最大的医疗中心。Zenodo 元数据中记录了两个 ROR 标识(05a353079 对应 CHUV),而论文页标注的机构 ROR 为 0190whta54,两者指向同一机构的系统内部不同注册层,不属于实体分歧。
单机构、单科室的作者构成有一个直接推论:这份数据的全部价值与全部局限都系于一家医院的临床习惯。期相选择、层厚偏好、扫描协议,反映的是 CHUV 放射科在这十年间的实践,不是"瑞士标准",更不是"国际标准"。这一点在使用数据做跨域评测时必须清楚——你测到的是"在 CHUV 协议下训练的模型迁移到别的医院时掉多少",而不是"在普遍真实世界条件下掉多少"。
2.4 作者与分工
| 作者 | 论文角色(CRediT) | Zenodo 角色 | ORCID |
|---|---|---|---|
| Filip Jesionowski | 概念构思(支持)、初稿撰写(主导)、数据管理(主导)、形式分析(主导) | Data collector | 0000-0003-2219-294X |
| David C. Rotzinger | 可视化、调查、方法学、审阅编辑(均为支持) | Project manager | 0000-0002-6321-3180 |
| Adrien Jayet | 数据管理、调查、审阅编辑(均为支持) | Data curator | 0009-0000-5211-7006 |
| Guillaume Fahrni(通讯) | 概念构思(主导)、方法学(主导)、验证(主导)、审阅编辑(主导) | Project leader | 0000-0003-1583-9602 |
两点值得注意。第一,论文与 Zenodo 的角色标签并不一致(例如 Rotzinger 在论文里承担可视化与调查,在 Zenodo 里是 project manager),这在数据集发布中很常见——两个系统各有自己的角色词表,不必强行对齐。第二,两名"放射科医师"审阅者没有在作者列表中具名,也没有单列致谢中的具名信息。这些人是否是作者本身、还是科室其他医师,论文正文未明确交代,属于本文的遗留疑点之一(§10)。
2.5 与同团队其他工作的关系
通讯作者 Guillaume Fahrni 与第一作者 Filip Jesionowski 所在的团队,同期还在推进另一份胸部/血管方向的 3D 医学影像数据发布(与本条目同批进入研究视野的 aortaseg-60 即出自同一团队、同一期刊、同一 Zenodo CC0 许可框架)。两者是完全不同的数据集:本条目是 87 例胸部 CT 的五类病变分类数据,aortaseg-60 是主动脉分割数据。它们共享的只是"同一家医院、同一种数据发布方法论、同一个期刊渠道"这三层外围共性。
对使用者的实际影响:在文献检索时如果把"Fahrni"或"CHUV"当作唯一检索词,会同时命中多份数据集,必须核对 DOI 才能避免张冠李戴。本文 §7.4 给出了明确的区分对照。
§3 数据结构与文件组织
3.1 顶层结构
ChestPathCT5-S100 v1.0(Zenodo record 18256797)
├── Med3DVlM_Fluid.zip          1.8 GB   胸腔积液 16 例
├── Med3DVlM_Mass.zip           1.8 GB   肺肿块 17 例
├── Med3DVlM_PE.zip             1.4 GB   肺栓塞 20 例
├── Med3DVlM_Pneumothorax.zip   2.6 GB   气胸 20 例
└── Med3DVlM_RF.zip             1.8 GB   肋骨骨折 14 例
                                合计 9.4 GB / 87 例
五个 zip 之间没有交叉引用文件,也没有全局索引表。也就是说,类别信息完全编码在 zip 名里,解压后每个 .nii.gz 文件本身不携带类别元数据字段。这是一个重要的工程事实:如果你的流程是"全部解压到一个目录再随机划分",类别标签会在这一步永久丢失。稳妥做法是解压时保留目录层级,或解压后立即生成一张 filename → label 的映射表落盘。
3.2 文件名与病例号
论文给出的命名规则是 ChestPathCT5-S100_FC_XXX,其中 FC 为病理类别缩写、XXX 为病例号。作者特别提示:病例号不连续,反映筛选排除情况。例如胸腔积液类的文件可能编号为 003、007、012……中间缺失的号正是那 13 例被排除的检查留下的空洞。
但正如 §1 Q5 所述,Zenodo 实际交付的 zip 使用的是 Med3DVlM_ 前缀。这意味着在撰写解析脚本时有两个层次的未知需要处理:
- 前缀层:不能假设前缀是
ChestPathCT5-S100。建议用正则.*_(Fluid|Mass|PE|Pneumothorax|RF)_.*\.nii\.gz匹配。 - 分隔符层:论文用下划线分段(
RF_XXX),实际文件是否为同样分隔符未经独立核验,因为本文未下载完整压缩包。建议解析时容忍_与-两种分隔符。
"病例号不连续"这件事本身也是信息:它是排除过程的记录。如果你在做数据完整性核查时发现某类只有 14 个文件而不是 20 个,那不是下载不全,而是符合预期的。唯一可信的核查方式是数量比对——每类文件数应分别为 16 / 17 / 20 / 20 / 14。
3.3 NIfTI 体积的具体形态
每例是一个三维体积(外加可能存在的第四维,NIfTI 规范允许 4D)。论文报告的采集参数:
| 参数 | 数值 |
|---|---|
| 厂商 | GE Healthcare(单一厂商) |
| 层配置 | 128–256 层扫描仪 |
| 重建矩阵 | 512 × 512 |
| 层厚范围 | 0.60 – 2 mm |
| 层厚中位数 | 0.62 mm [IQR 0.62–1.25] |
| 层面数中位数 | 481 [IQR 264–521] |
这里有一个容易混淆的概念必须澄清:"128–256 层配置"指的是扫描仪的探测器排数,不是图像的层面数。层面数是重建后的轴位切片数量,中位数 481,四分位距 264–521。一台 256 排扫描仪可以重建出 500 多层,也可以只保留 200 层;两者不是同一回事。把"256 层 CT"误读为"256 张切片"是新手最常见的错误之一。
层厚中位数 0.62 mm 与四分位距上界 1.25 mm 之间相差一倍,说明数据里同时存在亚毫米薄层重建和 1.25 mm 的常规重建。这个差异对 3D 卷积网络的输入归一化有直接影响:如果把每个体积都直接 resize 到固定的 128×128×128,薄层体积被"压缩"得更厉害,厚层体积被"拉伸",两者的物理分辨率差异会被抹平——而这恰是作者希望保留的信号之一。
3.4 共现矩阵(Table 2)
共现矩阵是 87 行 × 5 列的二值表,行是病例,列是五类病变,单元格 1/0 表示该例是否存在该病变。每行的主类别列必然为 1,其余四列标记合并发现。
这个矩阵的几个结构性事实:
- 它不是独立标签集,是主类别标签的补充。 主类别信息在 zip 名里,共现矩阵提供的是额外四列。
- 对角线恒为 1。 如果你的分析代码把对角线也当成"发现"来统计,会得到 87 个虚假共现。
- 矩阵是 87×5 而不是 87×4。 多出来的那一列正是"主类别本身",它的存在是为了让矩阵自洽(每行至少有一个 1),而不是冗余设计。
- 它没有给出共现的严重程度。 只是二值(有/无),不是分级(少量/中量/大量)。所以不能用于研究"积液量对 PE 检出率的影响"这类问题。
论文明确说明共现矩阵的用途:识别适合多标签研究的病例。这句话的潜台词是——并不是所有 87 例都适合多标签训练,有些例只有单一发现,有些例有多重发现,研究者需要自己按共现矩阵分组。
3.5 数据里"没有"什么
这份清单比"有什么"更重要,因为它直接划定了任务边界:
| 缺项 | 后果 |
|---|---|
| 分割掩码 | 不能做监督分割;做弱监督定位只能用类激活图(CAM)这类间接方法 |
| 病灶边界框 | 不能做标准检测任务(mAP 评测);可用 MIL(多示例学习)做图像级弱监督 |
| 定量测量(体积、直径、密度) | 不能研究病灶大小与预后的关联 |
| 临床变量(年龄外的病史、实验室) | 不能做影像-临床多模态融合;不能做亚组公平性分析(除性别与年龄) |
| 放射报告全文 | 不能做报告生成或影像-文本对齐研究 |
| 随访影像 | 不能做纵向变化分析或预后建模 |
| 期相标签文件 | 期相信息只在论文表格中按类汇总,未见到逐例标签文件——这一点未经独立核验,属遗留疑点 |
| DICOM 原始文件 | 只有 NIfTI。若研究需要 DICOM 头里的采集时间、剂量信息,无法从这份数据获得 |
关于最后一条需要展开:NIfTI 是分析友好的格式,但它丢弃了 DICOM 里的大量元数据(kVp、mAs、CTDIvol、重建核、窗宽窗位预设)。这份数据为了彻底匿名化,主动做了 DICOM 元数据清除,所以剂量相关的研究(例如低剂量 CT 优化)无法在此数据集上进行。这不是缺陷,是匿名化的代价,使用者应事先知道。
§4 五类病变与队列构成
4.1 类别分布总表
| 类别 | 代码 | 例数 | 占比 | 典型场景 | 典型期相 |
|---|---|---|---|---|---|
| 肺栓塞 | PE | 20 | 23.0% | 急诊(急性胸痛、呼吸困难) | CTA 动脉期(团注跟踪) |
| 气胸 | Pneumothorax | 20 | 23.0% | 急诊 / 创伤 | 平扫为主 |
| 肺肿块 | Mass | 17 | 19.5% | 肿瘤随访 | 静脉期增强 |
| 胸腔积液 | Fluid | 16 | 18.4% | 内科 / 肿瘤 | 静脉期或平扫 |
| 肋骨骨折 | RF | 14 | 16.1% | 创伤 | 平扫(骨窗) |
| 合计 | — | 87 | 100% | — | — |
占比按 87 为分母计算。作者在论文中报告的是整数百分比(23% / 23% / 20% / 18% / 16%),两者并不冲突,只是四舍五入精度不同。
类别不平衡是轻度而非重度:最大类(20 例)与最小类(14 例)之比约 1.43:1。这个比例对分类任务来说是友好的——不需要复杂的重采样策略,按类加权交叉熵或简单地用 macro-average 指标即可。真正的问题不是不平衡,而是每类的绝对数量太少:14 例意味着如果用 5 折交叉验证,每折测试集只有 2–3 例骨折,单个样本判断错误就会让该类召回率抖动 30 个百分点以上。这是小数据集评测固有的高方差问题(详见 §8 坑点 7)。
4.2 为什么是这五类
这五类不是随机挑选。论文称其为"five of the most common CT thoracic pathologies"(胸部 CT 最常见的五种病变之一组)。从临床工作量分布看,这个选择有明确的内在逻辑:
- 肺栓塞:CT 肺动脉造影(CTPA)是诊断金标准,急诊胸痛三联征排查的核心。
- 气胸:急诊与创伤场景的关键发现,决定是否需要立即胸腔闭式引流。
- 肺肿块:肿瘤筛查与随访的主要对象,涉及良恶性鉴别。
- 胸腔积液:跨科室的通用发现,心衰、感染、肿瘤、创伤都能引起。
- 肋骨骨折:创伤影像的基本任务,且在高龄人群中有法医学意义。
这五类在诊疗链条上恰好覆盖了**急(PE、气胸、骨折)- 缓(肿块、积液)两端,在影像特征上覆盖了血管(PE)- 胸膜腔(气胸、积液)- 肺实质(肿块)- 骨性胸廓(骨折)**四个解剖分区。这种设计让数据集可以支撑"多解剖区域同时判别"的多任务研究,而不只是单一器官的病灶检测。
4.3 队列人口学
| 指标 | 数值 |
|---|---|
| 总例数 | 87 |
| 男性 | 49(56%) |
| 女性 | 38(44%) |
| 年龄中位数 | 64 岁 |
| 年龄四分位距 | 46 – 76 岁 |
| 队列窗口 | 2015-01 至 2025-12 |
| 患者重复入组 | 无(一例 = 一名患者一次检查) |
年龄中位 64 岁、IQR 46–76 的信息量比表面看起来更大。四分位距跨度 30 年,说明队列里既有 40 多岁的创伤/急性病人,也有 70 多岁的肿瘤随访病人,这是"真实世界"在人口学上的体现。但也要注意中位数的局限:它掩盖了类别之间的人口学差异。例如肋骨骨折类很可能集中在两个年龄段(年轻人的高能量创伤、老年人的低能量跌倒),而肺肿块类几乎必然集中在高龄段。论文没有给出按类别分列的人口学表,这是本文识别的信息缺口之一(§10)。
4.4 采集异质性:期相分布
这是本数据集最核心的设计特征,值得单独展开。
| 期相 | 例数 | 占比 | 论文给出的典型时序 |
|---|---|---|---|
| 动脉期 CTA | 52 | 59.8% | 约 40 秒;PE 病例用团注跟踪(SmartPrep) |
| 非增强 | 25 | 28.7% | — |
| 静脉期 | 10 | 11.5% | 约 90 秒 |
三种期相的比例 60:29:11 并不均衡,但这不是设计失误。动脉期占多数,是因为肺栓塞(20 例)全部需要 CTA,且部分肿块与积液病例也采用了动脉期协议。这个分布反映的是 CHUV 放射科在这十年间的实际协议使用习惯。
期相与类别的关联是本数据集最重要的分析陷阱。从临床逻辑推断,期相分布极可能是这样的:
| 类别 | 期相倾向(依临床常识推断,非论文分列数据) |
|---|---|
| PE | 几乎全部动脉期 CTA(诊断必需) |
| 肺肿块 | 以静脉期为主 |
| 肋骨骨折 | 几乎全部平扫(创伤协议,无需增强) |
| 气胸 | 以平扫为主 |
| 胸腔积液 | 混合(静脉期 + 平扫) |
如果这个推断成立,那么期相本身就是类别的强预测因子:一个只学会"动脉期 → PE、平扫 → 骨折"的捷径分类器,即使完全不看肺实质,也能拿到不错的准确率。这是数据集层面必须警惕的泄漏形式(详见 §8 坑点 4)。
需要强调的是:上表是根据各病变的标准临床协议做的合理推断,不是论文给出的分类别期相数据。论文只报告了全队列的期相分布(52/25/10),没有逐类拆解。这个推断虽然证据不足,但足以构成"使用前必须自行核查"的理由。
4.5 共现:为什么需要一张矩阵
在 87 例真实临床病例中,"只有一种病"是少数情况。一例肺栓塞的病人可能因为右心衰而有胸腔积液;一例肋骨骨折的创伤病人常有气胸;一例肺肿块的病人可能因胸膜转移而产生积液。
共现矩阵的价值在于把这些"顺便发现"变成可用的监督信号。举一个具体的用法:假设训练一个五类单标签分类器,一例"PE 且有积液"的病例被标为 PE,模型输出在积液维度上被判错。若用共现矩阵改为多标签 BCE 损失,同一例的积液维度就是正确的正样本,梯度方向随之改变。
但共现也有反面用法,需要留意两点:
- 不要用共现推断因果。 “PE 病例 40% 有积液"不等于"积液增加 PE 风险”,这是病例选择偏差的产物(PE 病人本来就更容易做 CT,也就更容易被发现积液)。
- 共现矩阵没有严重度。 二值标记无法区分"少量积液"和"大量积液",因此不能用于研究共现发现对主病变检出性能的影响梯度。
4.6 排除的 13 例说明了什么
初始 100 例(每类 20)中排除 13 例,两类理由:病人拒绝研究用途授权,或图像质量不足。
这个信息有两个层面的含义。方法论层面:作者选择"宁缺毋滥",即宁可接受类别不平衡(14 / 16 / 17 / 20 / 20)也要剔除不合格样本,而不是为了凑数保留问题病例。这与"保留采集异质性"的原则并不矛盾——异质性指"临床协议的自然多样",而非"图像质量的缺陷"。使用层面:13/100 = 13% 的排除率意味着这份数据是"真实世界中的合格子集",不是"真实世界的随机抽样"。任何声称"该数据集代表真实世界分布"的说法都需要加上"在质量可接受的前提下"这个限定。
反过来说,被排除的 13 例恰恰是模型在临床中最容易碰到的困难样本——运动伪影、金属植入物、对比剂外渗、扫描不全。所以用这份数据评测出的性能,很可能优于模型在真实临床流水线上的实际表现。这是"质量筛选"不可避免的乐观偏差,使用者应在论文的 Limitations 部分写明。
§5 构建流程:从档案到 9.4 GB
5.1 五步流水线
论文 Figure 1 给出的构建流程可以拆成五个阶段:
① 档案抽取         单中心档案(2015–2025)按五类检索,每类取 20 例,合计 100 例
      ↓
② 类别归属         按主要病变分入 RF / Fluid / Mass / PE / Pneumothorax 五组
      ↓
③ 完全匿名化       清 DICOM 元数据 → 转 NIfTI → 复查清除 NIfTI 头与 JSON 残留
      ↓
④ 格式转换         统一转 NIfTI(.nii.gz),裁剪至胸部范围
      ↓
⑤ 技术验证         两名放射科医师核对类别 / 完整性 / 覆盖 / 损坏 / 可见性
      ↓
   87 例最终数据集 → Zenodo CC0 1.0
这条流水线的设计选择值得逐条审视。
5.2 从 100 到 87:排除发生在哪一步
排除的 13 例中,"拒绝研究用途授权"必然发生在早期(一旦确认不同意,后续处理全部作废),"图像质量不足"发生在哪一步则需判断。从逻辑上看,质量判断有两种可能节点:一是抽取阶段由操作者快速目测筛掉明显不合格的;二是技术验证阶段(第⑤步)由放射科医师正式判定。
论文没有明确说明 13 例各自在哪一步被排除,也没有给出"拒绝授权"与"质量不足"各占多少。这是本文识别的又一处信息缺口(§10)。对使用者的实际影响有限——无论在哪一步排除,最终交付的都是 87 例——但对"数据集筛选偏差有多大"的评估有影响:如果是质量筛掉的多,说明原始档案的影像质量分布较差;如果是拒绝授权的多,说明该院的研究授权覆盖率是主要瓶颈。
5.3 匿名化三步与它的代价
| 步骤 | 操作 | 遗留风险 |
|---|---|---|
| 1 | 移除 DICOM 元数据(患者姓名、ID、检查号、设备序列号、日期时间) | 元数据清除不彻底会残留机构名或技师名 |
| 2 | DICOM → NIfTI 转换 | 转换工具可能在 NIfTI 头写入原始文件名或路径 |
| 3 | 复查并清除 NIfTI 头文件及关联 JSON 中的残留元数据 | 依赖人工复查,一致性取决于执行者 |
作者主动做了第 3 步,这一点比很多数据集做得好——大量 NIfTI 数据集在网页上声明"已匿名化",实际 descrip 字段里还留着原始 PACS 路径。但论文没有披露第 3 步的具体核查清单,也没有说明是否使用了自动化工具扫描。建议使用者在下载后自行跑一次 nibabel 头字段审计:
import nibabel as nib, glob
for f in glob.glob('**/*.nii.gz', recursive=True):
    h = nib.load(f).header
    for k in ('descrip', 'aux_file', 'intent_name', 'db_name'):
        v = h[k].tobytes().decode('latin1').strip('\x00').strip()
        if v:
            print(f, k, repr(v))
这段代码只查四个最常被写脏的字段,耗时不到一秒每例,跑 87 例完全可行。它不能替代正式的去标识审查,但能快速发现"明显没清干净"的情况。
几何信息的取舍:NIfTI 保留了体素间距(pixdim)与方向矩阵(sform/qform),这是做空间分析必需的。但如果原始 DICOM 的 ImagePositionPatient 泄露了扫描床位置,理论上可能与重建几何共同构成重新定位的信息。彻底匿名化的数据集通常会重置原点(origin),代价是不同病例之间的空间对齐失效。论文未说明是否重置了 origin。若要跨病例做配准,建议先检查 sform 的原点分布:如果所有病例原点都在 (0,0,0) 附近,说明已被重置。
5.4 为什么选 NIfTI 而不是 DICOM 或 NRRD
| 格式 | 优点 | 缺点 | 本研究的选择理由(推断) |
|---|---|---|---|
| DICOM | 临床标准,元数据完整 | 一例数百个文件,匿名化面广;元数据多 | 排除——匿名化负担过重 |
| NIfTI | 单文件、分析生态成熟(nibabel、MONAI、nnU-Net) | 丢失 DICOM 元数据 | 选中 |
| NRRD | 单文件、支持多通道 | 生态不如 NIfTI 广泛 | 未选 |
论文未明确解释格式选择的理由,但从"anonymisation 是三步流程的核心"这一事实可以合理推断:单文件格式让"清除元数据"这件事的搜索面从数百个 DICOM 文件缩小到一个 .nii.gz 头,工程上可控得多。代价是剂量、重建核、kVp 这些临床参数一起丢失了(见 §3.5)。
5.5 打包策略:为什么按类别而不是按病例
数据集按病理类别分包而非按病例或随机切分,这个选择有三层考虑:
- 下载按需。研究者如果只做肋骨骨折检测,只需下 1.8 GB 的 RF 包,不必拉全套 9.4 GB。
- 类别即标签。zip 名承担了标签的职责,不需要额外的 CSV 映射表——虽然这也带来了 §3.2 的工程隐患。
- 便于人工核查。按类打包让"每类是不是 14/16/17/20/20 例"这件事可以通过清点 zip 内容直接验证。
但按类打包也带来一个问题:类别信息与目录结构强耦合。任何"全部解压平铺"的操作都会永久损失标签。这不是数据集的错,而是使用时需要知道的约束。
5.6 验证环节的边界
技术验证做的五件事里,有四件是"技术性"的(类别、完整性、覆盖、损坏),只有一件涉及医学判断(主病变可见性)。这个分布说明验证的目标是"数据可用",不是"标注质量"。
特别值得注意的是**"主病变无歧义可见"这一条。它看起来像标注质量保证,实则是一条纳入标准**:如果一例的主病变在图像上有歧义(例如一个 5 mm 的疑似肿块边界不清),它就不应进入数据集。这条标准确保了 87 例都是"教科书级别清晰"的阳性病例——也就是说,这份数据里的阳性样本比真实临床里的阳性样本更典型。
这直接决定了模型评测的口径:在这份数据上测得的敏感度,会系统性地高于在真实临床流水线上的敏感度。反过来说,如果模型在这份"清晰阳性"数据上都表现不佳,那么它在真实场景中的表现只会更差——这正是"小而干净"数据集的价值所在:它提供了一个性能上限的参考点。
§6 获取、许可与使用
6.1 获取路径
| 步骤 | 操作 | 说明 |
|---|---|---|
| 1 | 打开 Zenodo 记录页 https://zenodo.org/records/18256796 |
concept DOI;页面会导向 v1.0 |
| 2 | 在 Files 区选择需要的类别 zip | 五个 zip 可单独下载 |
| 3 | 直接点 Download | 无需注册、无申请、无 DUA、无 gated access 审核 |
| 4 | 校验 md5 | Zenodo 页面为每个文件提供 md5(见下表) |
这是本数据集在使用体验上最大的优势:CC0 许可 + Zenodo 直下,意味着从"发现它"到"跑起第一个基线"之间,没有任何行政流程。对比同类胸部影像数据集——很多需要 PhysioNet 的 credentialed access 认证、DUA 签署、机构审核——这份数据的门槛几乎是零。
6.2 文件清单与校验值
| 文件 | 体积 | 内容 | md5(Zenodo 页面公布) |
|---|---|---|---|
| Med3DVlM_Fluid.zip | 1.8 GB | 胸腔积液 16 例 | 01bf90cf70d955263f4b10468937698b |
| Med3DVlM_Mass.zip | 1.8 GB | 肺肿块 17 例 | 80788b093c400683ab51a40ab090c110 |
| Med3DVlM_PE.zip | 1.4 GB | 肺栓塞 20 例 | 33e4374b0bdd6638c1287ae651ac63e2 |
| Med3DVlM_Pneumothorax.zip | 2.6 GB | 气胸 20 例 | be3900c88d1287baff5f8af2ed34d6ac |
| Med3DVlM_RF.zip | 1.8 GB | 肋骨骨折 14 例 | 1977ad2c299d0049bc492d024a0f4c47 |
| 合计 | 9.4 GB | 87 例 | — |
把 md5 抄进你的下载脚本而不是手动比对,是最省事的做法:
# 下载后校验(示例:胸腔积液包)
md5sum Med3DVlM_Fluid.zip
# 期望:01bf90cf70d955263f4b10468937698b
注意 Zenodo 在大文件下载时偶尔会因会话过期返回一个 HTML 页面而非 zip。如果 md5 不匹配且文件体积明显小于标称值,先检查是不是下到了错误页,而不是怀疑数据损坏。
6.3 双重许可:数据 CC0,论文 CC BY
这是必须分清的两种许可:
| 对象 | 许可 | 义务 | 典型场景 |
|---|---|---|---|
| 数据集本体(zip 内的 NIfTI) | CC0 1.0 Universal | 无。公共领域贡献,可商用、可再分发、可改编,法律上无需署名 | 训练模型、做产品、二次发布衍生数据 |
| 论文(GigaByte 全文、图表) | CC BY 4.0 | 必须署名(作者、标题、来源、许可链接),标明是否修改 | 引用图表、翻译正文、制作教材 |
实践建议:即使数据是 CC0,在论文的 Data Availability 中引用数据集与论文仍是学术规范要求(不引用会在同行评议中被质疑,也违反多数期刊的引用政策)。CC0 免除的是"版权意义上的署名义务",不免除"学术共同体的引用惯例"。
需要提醒的一个细节:CC0 对美国之外某些司法辖区的数据库特殊权利(sui generis database right)覆盖程度存在不确定性。对于 87 例的数据集,这个风险在实践中几乎不存在,但如果你的用途是"把这份数据并入一个商业训练语料并对外销售",建议做一个简单的法律确认。
6.4 推荐引用格式
论文表述为:Jesionowski F, Rotzinger DC, Jayet A. ChestPathCT5-S100. Zenodo, 2026.
建议的完整引用(含四位作者与两个 DOI):
Jesionowski F, Rotzinger DC, Jayet A, Fahrni G. ChestPathCT5-S100: an open real-world chest CT dataset of five common thoracic pathologies with heterogeneous acquisition conditions. GigaByte. 2026; article 184. doi:10.46471/gigabyte.184. Data: doi:10.5281/zenodo.18256796 (v1.0).
注意 Zenodo 元数据作者数为四人,而论文 Data availability 段落列的是三位(无 Fahrni)。引用时以 Zenodo 元数据为准(四作者),并在正文里说明这一点(§10 存证 6)。
6.5 最小可用示例:从 zip 到 DataLoader
以下代码演示"下载 → 解压 → 建索引 → 4D 张量"的最短路径(按实际文件名匹配,规避 §3.2 的前缀陷阱):
import glob, os, re
import numpy as np
import nibabel as nib

CATS = {'Fluid': 'Fluid', 'Mass': 'Mass', 'PE': 'PE',
        'Pneumothorax': 'Pneumothorax', 'RF': 'RF'}
ROOT = 'ChestPathCT5-S100'   # 解压后的根目录,保留各类子目录

def build_index(root=ROOT):
    idx = []
    for f in glob.glob(os.path.join(root, '**', '*.nii.gz'), recursive=True):
        # 类别从路径名提取,兼容 Med3DVlM_ / ChestPathCT5-S100_ 两种前缀
        m = re.search(r'(Fluid|Mass|PE|Pneumothorax|RF)', f)
        if not m:
            continue
        idx.append({'path': f, 'label': m.group(1)})
    return idx

def load_volume(path, win=(-1000, 400), out=(128, 128, 128)):
    img = nib.as_closest_canonical(nib.load(path))     # 统一 RAS 方向
    arr = np.asanyarray(img.dataobj, dtype=np.float32)
    if arr.ndim == 4:                                   # 4D 取首帧
        arr = arr[..., 0]
    arr = np.clip(arr, win[0], win[1])                  # 肺窗/纵隔窗合并窗
    arr = (arr - win[0]) / (win[1] - win[0])            # 归一化到 [0,1]
    # 三线性重采样到固定尺寸(生产环境建议用 scipy.ndimage.zoom 或 MONAI)
    from scipy.ndimage import zoom
    factors = [o / s for o, s in zip(out, arr.shape)]
    return zoom(arr, factors, order=1).astype(np.float32)
三点工程提示:
nib.as_closest_canonical不可省略。不同病例的 NIfTI 方向矩阵可能不同(有的是 LPS,有的是 RAS),不统一方向会导致左右翻转,进而让"左侧胸腔积液"变成"右侧"。- 窗宽窗位单一化是有损的。上例把肺窗(-1000~400)合并成一个窗,对骨折(需要骨窗 300~2000)并不友好。更稳妥的做法是按类别使用不同窗,或直接输入原始 HU 值让网络学归一化。
- resize 到 128³ 会抹平层厚差异。若研究目标就是"层厚异质性",应保留原始体素间距,用 patch-based 采样而不是整体缩放。
6.6 训练/验证切分建议
小数据集最忌讳的是"随机切分后报告一个高方差指标"。三条建议:
- 分层 + 重复交叉验证。按类别分层做 5 折,重复 5 次不同随机种子,报告均值 ± 标准差。单次 5 折的结果不足以下结论。
- 按期相分层是更严格的做法。如果你关心跨期相泛化,可以做 leave-one-phase-out:用动脉期训练、平扫测试。但要先知道每例的期相,而这恰恰是数据的缺口(§3.5)。
- 不要在同一病人上跨折。这份数据已经保证一人一例,所以这条自然满足——这是它比很多大得多的数据集更省心的地方。
6.7 数据使用前的五项核查清单
拿到数据后,在跑任何模型之前先做这五件事:
| # | 核查项 | 通过标准 |
|---|---|---|
| 1 | 文件数量 | 五类分别 16 / 17 / 20 / 20 / 14,合计 87 |
| 2 | md5 | 与 §6.2 表一致 |
| 3 | 头字段干净度 | 无原始患者名、机构名、PACS 路径残留 |
| 4 | 方向一致性 | 全部经 as_closest_canonical 处理后方向统一 |
| 5 | 几何合理性 | 体素间距在 0.6–2 mm 层厚对应范围内,无异常缩放 |
第 5 项常常被忽略。NIfTI 转换时如果缩放因子(scl_slope/scl_inter)处理错误,HU 值会整体偏移——一个 -1000 的肺内空气会变成 0 或 -2000。快速自查法:取每例体积 1% 分位数,健康的胸部 CT 应该接近 -1000 HU(肺内气体),若明显偏离则说明缩放有问题。
§7 生态定位与横向对照
7.1 在胸部 CT 数据集谱系中的位置
公开胸部 CT 数据集大致可以按两个轴排列:规模(例数)与任务类型(分类 / 检测 / 分割)。ChestPathCT5-S100 的位置很特殊——规模极小,任务类型偏分类与检测,且刻意保留采集异质性。
规模  大
  │   LIDC-IDRI(千级,结节,多阅片者标注)
  │   DeepLesion(万级,全身病灶框)
  │   NSCLC-Radiomics(数百级,放疗计划 CT)
  │   ★ ChestPathCT5-S100(87 例,五类,异质采集)
  │   RibFrac(数百例,肋骨骨折分割)
  │   SIIM-ACR(万级胸片,气胸分割)
  │   ChestX-ray14(十万级胸片,分类)
  └─────────────────────────────────── 任务粒度  细
它的独特价值不在于覆盖某个空白,而在于同时做到了"临床真实的采集多样性"和"逐例可核对的文档厚度"。大规模数据集(LIDC、DeepLesion)通常无法给出每一例的期相与协议细节;而小众的临床研究数据集往往只覆盖一种病。87 例五病种 + 三种期相 + 一张共现矩阵,这个组合在现有生态里不多见。
7.2 与库内条目的横向对照
| 条目 | rid | 规模 | 模态 | 核心任务 | 与本数据集的关系 |
|---|---|---|---|---|---|
| RibFrac | 451 | 数百例 | 胸部 CT | 肋骨骨折检测与分割(MICCAI 2020 挑战赛) | RF 类的直接上游/下游:RibFrac 提供分割金标准,本数据集只给图像级标签。可用 RibFrac 训练分割、用本数据集测跨中心泛化 |
| SIIM-ACR Pneumothorax | 737 | 万级 | 胸片(X-ray) | 气胸分割 | 同为气胸,但模态不同(胸片 vs CT)、维度不同(2D vs 3D)。二者互补而非替代 |
| chest-ct-sepsis-er | 600 | 836 次 CT | 胸部 CT + 临床表 | 脓毒症影像-临床多模态 | 同为急诊胸部 CT,但本数据集无临床变量;可作为"有临床数据 vs 无临床数据"的对照设计 |
| rad-chestct | 819 | 见条目 | 胸部 CT | 通用胸部 CT 影像库 | 通用影像库 vs 五病种精选,用途不同 |
| patchchestct | 925 | 见条目 | 胸部 CT patch | 胸部 CT 补丁级任务 | 若做 patch 级弱监督,可从本数据集切 patch 后与其对照 |
| covid-ct-lung | 1041 | 见条目 | 胸部 CT | 肺实质与感染区分割 | 若需从本数据集的 87 例中派生肺分割,可借其模型做迁移 |
| rider-lung-ct | 267 | 见条目 | 胸部 CT | 肺癌重复扫描一致性 | 研究扫描间变异;本数据集提供的是采集协议变异,两者可组合成"时间变异 + 协议变异"双轴研究 |
| lung-pet-ct-dx | 475 | 见条目 | PET/CT | 肺癌诊断 | Mass 类的邻近任务,但模态不同 |
| hnscc-ct-atlas | 1051 | 见条目 | 头颈 CT | 头颈癌放疗图谱 | 解剖部位不同,方法学可借鉴 |
| ct-lesion-foundation-model | 963 | 见条目 | 多种 CT | 病灶基础模型 | 可用其预训练权重在本数据集上做线性探测,检验小样本迁移 |
| aortaseg-60 | 同批 | 见条目 | 胸部/主动脉 CT | 主动脉分割 | 不是同一数据集:同团队、同刊、同许可框架,但数据内容与任务完全不同(见 §7.4) |
7.3 与外部经典数据集的对照
| 数据集 | 规模 | 病种覆盖 | 期相多样性 | 分割掩码 | 许可 | 与本条目的定位差异 |
|---|---|---|---|---|---|---|
| ChestPathCT5-S100 | 87 | 5 类 | 3 种(刻意保留) | 无 | CC0 | 小样本、高异质性、零门槛 |
| LIDC-IDRI | 千级 | 肺结节单类 | 多为平扫 | 有(4 位阅片者) | 开放 | 大样本、单病种、标注精 |
| RibFrac | 数百 | 肋骨骨折单类 | 以创伤平扫为主 | 有 | 申请制 | 单病种深标注 |
| RSNA Pneumonia(胸片) | 万级 | 肺炎 | N/A(2D) | 有(框) | 开放 | 大样本、2D |
| MIMIC-CXR(胸片) | 数十万 | 多病种 | N/A(2D) | 无 | DUA 认证 | 海量但为 2D,且获取门槛高 |
一句话概括:ChestPathCT5-S100 在"病种广度"上不如 MIMIC 系,在"标注深度"上不如 LIDC/RibFrac,在"规模"上不如任何一个大库,但在"采集异质性的受控保留 + 零许可门槛"这个组合上,它是少有的。
7.4 与 aortaseg-60 的明确区分(易混淆提示)
同批进入本库视野的 aortaseg-60 与本条目有多处表面相似,检索者极容易混淆。逐项对照如下:
| 维度 | ChestPathCT5-S100(本条目) | aortaseg-60 |
|---|---|---|
| 数据内容 | 胸部 CT,五类病变分类 | 主动脉区域分割数据 |
| 任务类型 | 分类 / 检测 / 多标签 | 语义分割 |
| 团队 | Fahrni 团队(CHUV,洛桑) | 同为 Fahrni 团队(CHUV,洛桑) |
| 期刊 | GigaByte 2026, article 184 | GigaByte 2026(另一文章号) |
| 许可 | CC0 1.0(Zenodo) | CC0 1.0(Zenodo) |
| 核心贡献 | 采集异质性 + 共现矩阵 | 分割标注 |
两者的共性只有"同团队、同刊、同许可框架、同存储平台"这四层外围特征——这四条恰恰是文献检索最容易命中的字段。唯一可靠的区分依据是 DOI:本条目为 10.46471/gigabyte.184 / 10.5281/zenodo.18256796,aortaseg-60 的 DOI 不同。引用、链接、合并数据时务必以 DOI 为准,不可按"Fahrni 团队那篇 GigaByte 2026"来指代。
库内做互链时也应把两者作为不同条目并列,而不是作为同一资源的不同版本——后者会被误判为重复条目(这是本库查重机制明确区分的两类情况)。
§8 使用坑点八则
以下八条均为具体、可复现的工程或方法学坑点,按"现象 → 根因 → 处置"的格式展开。
坑点 1:把 S100 理解成"每类 100 例"
现象:检索者看到名字里的 S100,预期下载到约 500 例数据,实际只有 87 例,怀疑下载不全或数据被截断。
根因:S100 指初始获批队列 100 例(五类各 20),不是"每类 100"也不是"总数 100"。最终 87 例是排除 13 例后的结果。
处置:把 87 当作基准数,任何数量评估都以此为准。若需要更大规模,应另选数据集,不要指望本数据集有"完整版"。
坑点 2:按论文命名规则硬编码文件名,批量读取全部落空
现象:按论文写的 ChestPathCT5-S100_RF_XXX.nii.gz 写 glob,返回 0 个文件。
根因:Zenodo 实际交付的五个 zip 名为 Med3DVlM_Fluid/Mass/PE/Pneumothorax/RF.zip,前缀与论文命名规则不一致(疑为内部项目代号残留,论文未解释)。
处置:用正则匹配类别代码而非固定前缀:re.search(r'(Fluid|Mass|PE|Pneumothorax|RF)', path)。注意 PE 是短词,若用子串匹配可能误命中其他词,建议加词边界或用 _(PE)_ 形态匹配。
坑点 3:把"技术验证"当成"标注",误用于分割任务
现象:试图用这份数据训练 U-Net 做病灶分割,发现没有任何掩码可用,只能自己标。
根因:两名放射科医师做的是技术验证(类别归属、图像完整性、主病变可见性),不是逐像素标注。论文明确写了"未进行病理结构分割,未进行定量标注验证"。
处置:明确任务边界。若要做分割,只能走弱监督路径(类激活图、CAM 引导),或者选 RibFrac 这类有掩码的数据集。不要试图用共现矩阵伪装成分割标签。
坑点 4:期相与类别强相关,模型学到的是"捷径"而非病变
现象:五类分类器在交叉验证中准确率很高(例如 >90%),但换到外部数据上崩塌。可视化发现模型主要关注的是"有没有增强对比剂",而不是病灶本身。
根因:临床协议决定期相——PE 几乎必须做 CTA 动脉期,肋骨骨折几乎都是创伤平扫。期相因此成为类别的强代理变量。见 §4.4 的推断表。
处置:三条对策。①做期相分层评测:同类内分期相比较性能,看模型是否只在某一期相上强;②做期相消融:用期相分类器(只用"有没有增强"这一特征)测一下能达到多少准确率,作为捷径基线;③做病灶区域裁剪:只输入肺野/胸膜腔/骨性胸廓的局部 patch,强迫模型看解剖结构而非常整体对比度。
这条坑点是本数据集使用中最容易踩且后果最严重的,因为它在交叉验证阶段完全不会暴露。
坑点 5:共现矩阵的对角线被当成额外发现
现象:统计"每类平均并发发现数"时得到奇怪的数值,或者共现热力图对角线一片红。
根因:87×5 矩阵的对角线(每例的主类别列)恒为 1,是设计上的自洽字段,不是"共现"。
处置:任何共现统计前先置对角线为 0 或排除。计算"每例平均并发病种数"时应先减去 1(主类别本身)。
坑点 6:压缩包文件名含大写与下划线组合,跨平台解压出错
现象:在 Windows 上解压后文件名大小写被改写,或者 zip 内含的目录层级与预期不符,导致 glob 匹配失败。
根因:Med3DVlM 中的大写字母在大小写不敏感的文件系统上可能被保留或改写,且 zip 内部结构未经完整核验(本文未下载全部压缩包,属遗留疑点)。
处置:解压后用 find 或 glob 列出实际文件树,与 §3.1 的预期结构比对,而不是假设目录层级。生产流程中建议解压后立即生成一份文件清单(ls -R > manifest.txt)随数据一起归档。
坑点 7:单次 5 折交叉验证的指标波动被当成"模型好坏"
现象:换个随机种子,同一模型的 macro-F1 从 0.78 跳到 0.84,误以为是超参数调整的成果。
根因:每类只有 14–20 例,5 折时测试折每类 3–4 例,单个样本翻转就带来 25%–33% 的类内召回率变动。
处置:至少做 5×5 重复交叉验证,报告均值与标准差,并给出置信区间。做模型对比时用配对检验,而不是比较单次运行的数值。在论文中写明"n=87,结论受样本量限制"。
坑点 8:把"88 例""100 例"等二手数字当作本数据集的规模
现象:在综述或方法章节中写「该数据集包含 100 例」或「88 例」,与原始论文的 87 例不符。
根因:二手引用(部分综述、博客、榜单)可能引用预印本口径、初始队列规模,或干脆抄错。
处置:一切数量以 GigaByte 论文正文与 Zenodo 文件清单为准:87 例。若必须引用二手来源,先在正文中说明"初筛 100 例,最终 87 例"以消除歧义。
§9 质量控制、伦理与合规
9.1 两层质量闸门
这份数据的质量保证由两道独立闸门构成,理解它们的分工有助于判断数据的可信边界。
第一层:纳入/排除闸门(100 → 87)。 排除 13 例,理由是病人未同意研究用途或图像质量不足。这一层解决的是"该不该进数据集"。
第二层:技术验证闸门(87 → 87)。 两名放射科医师逐例核对五项内容。这一层解决的是"进了数据集的有没有问题"。
值得注意的是,第二层没有淘汰任何一例——论文的表述是"confirmed correct pathology category assignment, image integrity, and unambiguous visibility",即全部通过。这说明第一层的排除已经足够严格,第二层起到的是确认与背书作用。对使用者的意义:87 例是一个经过双重筛选的集合,其"干净程度"高于任何未经验证的公开数据集,但也因此带有双重筛选的乐观偏差(见 §4.6 末段)。
9.2 技术验证的具体内容与形式
| 验证项 | 检查什么 | 判据 |
|---|---|---|
| 类别归属 | 该例的主要病变是否与所在类别一致 | 与报告/影像判断一致 |
| 图像完整性 | DICOM→NIfTI 转换后是否有截断、丢帧 | 体积连续、无零值断层 |
| 体积覆盖 | 胸部解剖是否完整包含 | 肺尖至膈下范围完整 |
| 文件损坏 | 是否能正常读取 | 无解压/读取错误 |
| 主病变可见性 | 目标病变是否清晰无歧义 | 两名医师均能定位 |
验证形式的两个关键细节:① 病例在两名读者间分配,而非双人独立双阅。 这意味着没有一个病例被两个人同时独立判读,因此无法计算观察者间一致性(kappa)。论文也没有报告 kappa。如果你的研究需要"标注可靠性"指标,这份数据提供不了,只能引用"两名医师确认"这一事实层面的背书。
② 技术验证不等于诊断金标准。 类别归属的依据是既有影像与临床判断,而不是病理或随访确认。例如"肺肿块"类的病例并未经病理证实为恶性,只是"影像上表现为肿块"。所以标签的语义是影像学描述(radiological finding),不是疾病诊断(diagnosis)。这一点在论文标题里已经体现——它用的是 pathology(病变)而不是 disease(疾病)。
9.3 匿名化与再识别风险
三层匿名化(清 DICOM 元数据 → 转 NIfTI → 复查清头文件)覆盖了绝大多数直接标识符。残留风险主要在三个方向:
① 面部结构。 作者明确说明图像体积仅限胸部范围,不含可能致再识别的面部结构。这是针对胸部 CT 的一个经典风险点——上胸部 CT 的上缘常常包含下颌与部分面部,可从 CT 重建出可识别的人脸。作者主动裁剪掉,是负责任的做法。但如果裁剪不完整(例如保留了上纵隔上缘的颈部层面),理论上仍有部分面部轮廓。使用前可用 §5.3 的脚本抽查几个体积的顶部层面。
② 罕见病变 + 小地域。 87 例来自瑞士法语区的一家医院。如果某例同时具有多种罕见特征(例如特定部位的肿块 + 特殊骨折模式),在洛桑本地的小范围人群中,理论上可能被熟悉该病例的医护人员识别。这是所有小样本医疗数据集的固有风险,无法通过技术手段完全消除。
③ 设备指纹。 单一厂商 GE Healthcare,若保留了设备型号或序列号信息(NIfTI 头一般不保留),可缩小到特定扫描仪。作者清除了 DICOM 元数据,此项风险低。
综合评估:再识别风险低于多数公开医学影像数据集,但仍不是零。如果研究涉及公开发表逐例图像,仍建议按常规做法做二次审查。
9.4 伦理定性的准确表述
论文写明:CHUV 法务部门确认项目(编号 Hors-LHR-BPR1546)不在瑞士《人类研究法》(Human Research Act, HRA, SR 810.30)管辖范围内,因此无需伦理委员会批准。
这段话常被误读为"作者绕过了伦理审查"。准确的解读是:瑞士 HRA 的适用范围是"涉及人类的研究",而完全匿名化、不可回溯到个人的数据在 HRA 的框架下不被认定为"涉及人类的研究",属于法定豁免范畴。这是一个前置的法律定性,不是事后补的说明。判断由医院法务部门做出,而不是研究者自行决定。
需要提醒的是:这个定性只对瑞士司法辖区有效。如果你在其他国家使用这份数据,当地的伦理要求可能不同(例如某些国家对"即使是公开匿名数据"的二次使用也要求伦理备案)。使用前应查询所在机构的政策。
9.5 与"公平性"相关的合规盲点
数据集的合规性不等于公平性。这份数据在公平性维度上有三个已知盲点:
- 人种/族裔未报告。 论文只报告了性别与年龄,没有人种构成。洛桑所在的沃州人口以欧洲裔为主,但数据集中是否有其他族裔病例无从得知。因此无法评估模型在不同族裔上的表现差异。
- 性别分布接近平衡(49:38),但未按类别分列。 如果某一类(例如肋骨骨折)高度偏向男性(年轻人的高能量创伤以男性居多),那么分类性能的性别差异可能被总体平衡掩盖。
- 年龄只有中位数与 IQR。 无法做年龄分层分析,也就无法回答"这个模型在 80 岁以上人群中是否同样可靠"。
这不是这份数据的独有缺陷——绝大多数医学影像数据集都有类似盲点。但对于声称"真实世界"的数据集,人口学代表性不足是"真实世界"这个标签下最需要警惕的反例:真实世界的影像采集是多样的,但真实世界的人群构成在单中心数据里必然是局部的。
9.6 复现性检查清单
如果要在论文中声称"我们在 ChestPathCT5-S100 上复现了 X",至少应记录以下内容:
| 项目 | 记录要求 |
|---|---|
| 数据版本 | v1.0(DOI 10.5281/zenodo.18256796) |
| 下载日期 | 具体日期(Zenodo 可能更新) |
| md5 校验 | 五个文件的实际 md5 |
| 预处理 | 方向统一方法、重采样尺寸、窗宽窗位、是否保留原始间距 |
| 切分 | 随机种子、分层方式、折数、重复次数 |
| 指标 | 每类 precision/recall/F1 + macro/micro 平均 + 置信区间 |
| 代码 | 可执行的预处理与训练脚本(建议随论文发布) |
§10 存证、遗留疑点与互链建议
10.1 三源互证记录
本文所有硬数字均由三个来源交叉核对:GigaByte 论文全文(DOI 10.46471/gigabyte.184)、PubMed 摘要页(PMID 42245226 / PMC13231509)、Zenodo 记录页(DOI 10.5281/zenodo.18256796 → 18256797)。以下为逐项对照:
| 事实项 | GigaByte 论文 | PubMed 摘要 | Zenodo 页面 | 结论 |
|---|---|---|---|---|
| 总例数 | 87 | 87 | 87(五类相加) | 一致 |
| 五类例数 | 14/16/17/20/20 | 未列 | 14/16/17/20/20 | 一致 |
| 队列窗口 | 2015–2025(十年) | “ten-year period” | 未提 | 一致 |
| 期相 | 动脉 52 / 静脉 10 / 平扫 25 | 仅述"含增强与非增强" | 仅述"含增强与非增强" | 论文独有细粒度 |
| 格式 | NIfTI | NIfTI | NIfTI (.nii.gz) | 一致 |
| 许可 | CC0 1.0 | CC0 1.0 | CC0 1.0(icon) | 一致 |
| 两名放射科医师验证 | 有 | 有 | 未提 | 论文/PubMed 一致 |
| 体积 | 约 10 GB | 未提 | Files (9.4 GB) | 双口径,存照 |
| 数据集 DOI | 10.5281/zenodo.18256796 | 未提 | 记录页 v1.0 为 18256797 | 双口径,存照 |
10.2 双口径存照(逐条)
存照 1:Zenodo DOI 的 concept / version 双号
- 论文 Data availability 引用:10.5281/zenodo.18256796
- Zenodo 记录页 v1.0 显示:10.5281/zenodo.18256797
- 判断:18256796 为 concept DOI(指向"始终最新版本"),18256797 为 v1.0 的 version DOI(指向冻结快照)。两者都有效,指向同一份内容,因为目前只有 v1.0 一个版本。
- 用于复现时应引用 version DOI;用于"长期引用这个数据集"可引用 concept DOI。本条目在 schema_org 中并列两个号,正文以 concept DOI 为主。
存照 2:zip 文件名前缀与论文命名规则不一致
- 论文命名规则:
ChestPathCT5-S100_FC_XXX - Zenodo 实际:
Med3DVlM_Fluid.zip/_Mass/_PE/_Pneumothorax/_RF.zip - 判断:论文未解释。合理推测为项目内部代号(Med3D + VLM)残留。不影响数据内容,只影响脚本的匹配逻辑(见 §8 坑点 2)。
存照 3:体积 10 GB vs 9.4 GB
- 论文:约 10 GB
- Zenodo:Files (9.4 GB),五个 zip 分别 1.8 / 1.8 / 1.4 / 2.6 / 1.8 GB
- 判断:差异约 6%,可能来自十进制/二进制换算(GB vs GiB)或压缩率假设。本文两处口径均保留,不做统一。
存照 4:作者人数的三处不一致
- 论文署名:四位(Jesionowski / Rotzinger / Jayet / Fahrni)
- 论文 Data availability 引用:三位(Jesionowski / Rotzinger / Jayet)
- Zenodo 元数据:四位
- 判断:Data availability 段可能只列了"数据处理相关的作者",属书写不一致,不是内容分歧。引用时以 Zenodo 与论文署名(四位)为准。
10.3 遗留疑点
以下是本文未能核实、需要后续补充的信息。列出而非填补,是本库的硬性纪律——宁可留白,不可编造。
| # | 疑点 | 影响 | 建议核实方式 |
|---|---|---|---|
| 1 | 预印本 10.20944/preprints202605.1079.v1 的实际内容与差异 | 低(预印本通常与终稿接近) | 访问 Preprints.org 对应 DOI |
| 2 | 五类各自的期相构成(论文未分列) | 高(直接决定坑点 4 的严重程度) | 下载数据后用 DICOM/NIfTI 特征(是否增强、强化程度)逐例判定 |
| 3 | 每例的期相标签是否随数据发布(是否有额外 CSV) | 高 | 解压全部五个 zip 检查根目录 |
| 4 | zip 内部目录结构(是否按病例分子目录) | 中 | 解压后 unzip -l 查看 |
| 5 | 两名审阅放射科医师的身份与是否为作者 | 低 | 查看论文致谢段与作者贡献声明 |
| 6 | 13 例排除中"拒绝授权"与"质量不足"各占多少 | 中 | 论文正文若有补充材料,查 Supplementary |
| 7 | 是否重置了 NIfTI 的 origin(影响跨病例配准) | 中 | 下载后检查 sform 原点分布 |
| 8 | 共现矩阵是否以独立文件形式提供 | 中 | 检查 zip 内是否有 CSV/TSV |
| 9 | 各病例的具体层厚与层数是否可从 NIfTI 头获取 | 低 | nibabel 读取 pixdim 即可 |
| 10 | 论文引用编号 [16] 指向的 Zenodo 条目是否为同一 DOI | 低 | 查参考文献表 |
10.4 库内建议互链点
以下为本文识别的、与 ChestPathCT5-S100 存在明确语义关联的库内条目,供发布后建立互链时使用。所有链接 URL 均使用 /<slug>/0 占位形式,实际 rid 由主会话在入库后统一回填(遵守 R018,禁止写手猜测 rid)。
| slug | 已知 rid | 关联理由 | 链接形式 |
|---|---|---|---|
| ribfrac | 451 | 肋骨骨折 CT 检测分割(RF 类的唯一直接可比条目) | /ribfrac/0 |
| siim-acr-pneumothorax | 737 | 气胸影像基准(胸片口径,2D) | /siim-acr-pneumothorax/0 |
| chest-ct-sepsis-er | 600 | 急诊胸部 CT 队列,临床表格配对的互补设计 | /chest-ct-sepsis-er/0 |
| rad-chestct | 819 | 通用胸部 CT 影像库 | /rad-chestct/0 |
| patchchestct | 925 | 胸部 CT patch 级任务 | /patchchestct/0 |
| covid-ct-lung | 1041 | 胸部 CT 肺实质分割 | /covid-ct-lung/0 |
| rider-lung-ct | 267 | 肺癌 CT 重复扫描一致性 | /rider-lung-ct/0 |
| lung-pet-ct-dx | 475 | 肺癌 PET/CT 诊断 | /lung-pet-ct-dx/0 |
| ct-lesion-foundation-model | 963 | 病灶基础模型(可用于小样本线性探测) | /ct-lesion-foundation-model/0 |
| aortaseg-60 | 同批待入库 | 同团队同刊不同数据集,仅供并列而非合并 | /aortaseg-60/0 |
互链边界提示:与 aortaseg-60 的互链必须写明"不同数据集,仅同团队/同刊",避免下游把两者当成同一资源的不同版本。与 ribfrac、siim-acr-pneumothorax 的互链应写明"病种相同但标注粒度/模态不同",避免读者误以为可以互相替代。
10.5 一句话总结
ChestPathCT5-S100 的价值不在规模,而在于它用 87 例证明了"小而真实"可以是一个明确的数据集设计目标:三种期相并存、五类常见病变同框、附一张共现矩阵、CC0 零门槛。它最适合的角色是跨域鲁棒性评测的参照点与多标签/弱监督方法的小样本试验田,而不是预训练语料或临床验证集。使用它的第一件事,是弄清期相与类别之间那条隐藏的捷径(坑点 4);第二件事,是接受 14 例一类的统计现实,用重复交叉验证而不是单次运行来下结论。
§11 一页速查卡与角色阅读路径
11.1 一页速查卡
| 你要做的事 | 最短路径 |
|---|---|
| 下载数据 | Zenodo 10.5281/zenodo.18256796 → 五个 zip → 校验 md5 |
| 核对数量 | 16 / 17 / 20 / 20 / 14 = 87 |
| 写解析脚本 | 正则匹配类别代码,不硬编码 ChestPathCT5-S100 前缀 |
| 建 DataLoader | as_closest_canonical 统一方向 → clip 窗 → resize 或 patch |
| 评估分类性能 | 5×5 重复分层交叉验证 + 每类 P/R/F1 + 置信区间 |
| 检查捷径 | 训练一个只用"是否增强"特征的分类器作为基线 |
| 做多标签 | 用共现矩阵,先置对角线为 0 |
| 引用 | 论文 DOI 10.46471/gigabyte.184 + 数据 DOI 10.5281/zenodo.18256797 (v1.0) |
| 判断能不能做分割 | 不能(无掩码),除非走弱监督 |
11.2 按角色的阅读路径
如果你是影像 AI 算法工程师:§1 Q14 → §3(结构)→ §6.5(示例代码)→ §8 坑点 2、4、7。跳过 §2、§9。
如果你是临床研究者:§2(论文与机构)→ §4(队列构成)→ §9(伦理与公平性)→ §10.3(遗留疑点)。重点关注 §4.4 的期相分布与 §9.5 的公平性盲点。
如果你是数据集评测/基准构建者:§7(生态对照)→ §8 坑点 4、7 → §10.4(互链)。重点是把这份数据放进"鲁棒性评测"而非"性能榜单"的语境。
如果你是学生或教学者:§0(导读)→ §5(构建流程,作为数据工程案例)→ §11.1(速查卡)。§5 的三步匿名化与五步流水线是很好的教学材料。
如果你只是想知道"能不能用":§6.1(获取)→ §6.3(许可)→ §1 Q14(能做/不能做)。三分钟可以决定。
§12 临床背景:五类病变为什么值得单独成集
这一节面向不熟悉胸部影像的读者,用临床语言解释五类病变各自在诊疗链条上的位置。理解这一点,才能判断模型输出在临床上意味着什么。
12.1 肺栓塞(PE):时间就是心肌
肺栓塞是肺动脉被血栓阻塞的急症,典型表现是突发呼吸困难、胸痛、低氧。诊断金标准是 CT 肺动脉造影(CTPA)——在动脉期、肺动脉对比剂充盈最浓的窗口内扫描,直接观察血管腔内是否有充盈缺损(filling defect)。这份数据的 20 例 PE 全部采用动脉期,且论文提到使用了 SmartPrep 团注跟踪技术:机器先监测肺动脉干内的 CT 值,一旦超过阈值就自动触发扫描,从而捕捉对比剂峰值。
对模型的意义:PE 检测的关键不是"血管整体亮不亮",而是血管内那一小块暗。这意味着输入窗宽必须包含高密度对比剂与低密度血栓的对比范围,且模型的感受野必须覆盖沿血管走行的狭长结构——这与检测肺实质内球形肿块是两种完全不同的几何问题。任何把 PE 当成"另一种肿块"处理的建模思路,通常会在小分支栓塞上失败。
12.2 气胸:一条黑边的判读
气胸是胸膜腔内积气,影像上表现为肺外带出现无肺纹理的透亮区(黑色),且脏层胸膜线可见。少量气胸可能只有几毫米宽的一条黑边,在层厚 2 mm 的重建上容易漏。张力性气胸则是急症,需要立即处理。
对模型的意义:气胸的视觉证据极其"薄"——它是一条线状边界而不是一个团块。3D 卷积在深层的下采样会把这条线抹掉,因此做气胸检测通常需要保留较高分辨率的分支(类似 nnU-Net 的全分辨率分支),或在 2D 轴位层面上先检出再跨层聚合。
12.3 肺肿块:大小与形态的双重判断
"肿块"在影像学上一般指直径大于 3 cm 的占位(小于 3 cm 称结节),但不同文献的阈值并不统一。本数据集的 Mass 类 17 例没有给出具体尺寸分布,因此模型学到的是"看起来像肿块"这一整体印象,而不是"直径 > 3 cm"这一可量化规则。
对模型的意义:肿块类的难点在于边界判定——毛刺、分叶、胸膜牵拉这些恶性征象需要高分辨率观察,而磨玻璃成分(ground-glass opacity)在肺窗下才能看清,在纵隔窗下几乎不可见。这意味着同一例在不同窗宽下可能给出相反的判断,预处理时的窗选择直接影响性能(见 §6.5 提示 2)。
12.4 胸腔积液:最常见的"顺便发现"
胸腔积液本身不是疾病,而是心衰、感染、肿瘤、创伤等多种疾病的共同表现。它的临床意义取决于量(少量 vs 大量)、密度(漏出液 vs 渗出液 vs 血性)与是否包裹。这份数据的 Fluid 类 16 例是"以积液为主要发现"的病例,不是所有带积液的病例。
对模型的意义:积液是最容易被"捷径"识别的病变——它表现为重力依赖区的均质高密度区,与肺实质对比强烈。一个只看图像下部的模型就能获得不错的积液检出率。这既是好消息(基线性能高)也是坏消息(性能高不代表模型理解了病变,见坑点 4)。
12.5 肋骨骨折:骨窗与三维重建的专属任务
肋骨骨折常见于钝性胸部创伤,老年人低能量跌倒也可造成。诊断的黄金组合是骨窗(窗宽约 2000 HU、窗位约 300–500 HU)加多平面重建(MPR),沿肋骨走行逐根追踪。在轴位图上,一条骨折线可能只出现在一两层中,极易漏诊。
对模型的意义:这是五类中对空间分辨率最敏感的一类。层厚 2 mm 的重建对无移位骨折几乎不可读;亚毫米薄层才是可靠的基础。这份数据层厚范围 0.60–2 mm,意味着部分病例的骨折检测难度天然高于其他病例——而这恰恰是"异质性"带来的研究价值:你可以研究"层厚如何影响骨折检出率"。
12.6 五类放在一起意味着什么
把上述五类放在同一个分类框架里,模型面临的不是"五种病变的判别",而是四种解剖分区(血管、胸膜腔、肺实质、骨性胸廓)、三种对比度条件、两种成像目的(急症排查 vs 肿瘤评估)的组合判别。这比"五种形状不同的东西"要困难得多,也更接近真实临床的决策形态。
这也解释了为什么这份数据的样本量虽小,但任务设计具有独特价值:它不是"五种病的图鉴",而是"一次扫描上同时判断四类解剖结构状态"的模拟。真实临床中,放射科医师看一例胸部 CT 就是这样读的——不是先选一个类别,而是逐区扫过、逐项记录。
§13 典型研究工作流
下面给出一条从零到可发表结果的完整工作流,供首次使用该数据集的研究者参考。每一步都标注了与本文相关章节的对应关系。
13.1 阶段一:数据准备(半天)
| 步骤 | 操作 | 检查点 |
|---|---|---|
| 1 | 按需下载五个 zip(或全部 9.4 GB) | md5 与 §6.2 一致 |
| 2 | 解压并保留类别目录层级 | 各类文件数 16/17/20/20/14 |
| 3 | 运行头字段审计脚本(§5.3) | 无原始元数据残留 |
| 4 | 生成 manifest.csv(路径、类别、层厚、层数、体素间距) |
87 行 |
| 5 | 记录数据版本与下载日期 | 写入实验日志 |
第三步的头字段审计常被跳过,但它是唯一能发现匿名化瑕疵的环节。花十分钟做,比事后在审稿人质疑时补做要划算。
13.2 阶段二:预处理(一天)
预处理的核心决策是"保留多少原始几何信息"。三种策略及其后果:
| 策略 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| A. 整体重采样 | 全部 resize 到 128³ 或 256³ | 实现简单、批处理方便 | 抹平层厚差异,丢失各向异性信息 |
| B. 各向同性重采样 | 统一重采样到 1 mm 等距体素 | 保留物理尺度、可比性强 | 大体积病例内存占用高 |
| C. Patch 采样 | 保持原始间距,随机裁 3D patch | 保留原貌、适合大体积 | 需处理 patch 级标签聚合 |
建议:如果研究主题与"采集异质性"相关,用 B 或 C;如果只是做一个基线分类,A 足够。论文若声称"我们的方法对期相鲁棒",用 A 做的实验说服力较弱——因为重采样本身就在抹平差异。
窗宽窗位的选择同样关键。三类常用窗:
| 窗 | 窗宽 | 窗位 | 适用 |
|---|---|---|---|
| 肺窗 | 1500 | -600 | 肺实质、气胸、磨玻璃 |
| 纵隔窗 | 350 | 40 | 纵隔、积液、血管、肿块 |
| 骨窗 | 2000 | 400 | 肋骨骨折 |
单窗输入会丢掉重要信息。可行的折中:输入三通道(三个窗各一路),或输入原始 HU 并在网络首层做可学习的窗归一化。
13.3 阶段三:建模与评测(数天到数周)
基线设计的三条原则:
- 一定要有"捷径基线"。训练一个只输入"是否有对比增强"这一个特征(或直接看图像整体亮度均值)的分类器。如果它的准确率超过 50%,说明期相泄漏显著,必须处理(坑点 4)。
- 一定要有 2D 基线。逐层 2D CNN 取最大池化,常常能与 3D 网络打平。若 3D 网络大幅领先,才值得继续投入 3D。
- 一定要有重复实验。5×5 重复交叉验证是底线,单次 5 折的数字不能进论文(坑点 7)。
报告指标的最小集:每类 precision / recall / F1、macro-F1、micro-F1、混淆矩阵、每类置信区间。如果做多标签,加 subset accuracy 与 per-label AUC。
13.4 阶段四:写作(数天)
在方法章节中必须写明的四件事:
- 数据版本(v1.0)与 DOI,以及实际下载日期。
- 预处理的具体参数(窗宽、重采样尺寸与方法、方向统一)。
- 切分的随机种子与重复次数。
- 是否观察到期相泄漏,如何处理的。
在局限章节中必须承认的三件事:
- n=87,每类 14–20 例,性能估计的高方差。
- 单中心单厂商,外部泛化未经检验。
- 标签是影像学描述而非病理诊断。
§14 常见误解澄清
误解 1:“87 例太少,没有研究价值”
事实:样本量与研究价值不是单调关系。87 例适合回答"方法在小样本下的行为"这类问题——少样本学习、迁移学习、数据增广策略、跨域泛化的样本效率。这类研究在小数据集上反而更可控:变量少、每例可逐一检查、结果可追溯到具体病例。真正不做不了的是"大样本统计推断",而不是"任何研究"。
误解 2:“CC0 许可意味着可以随便用,不用管别的”
事实:CC0 免除的是版权义务,不免除三类其他义务:①学术引用惯例(期刊政策要求引用);②各国关于医疗数据的其他法规(例如某些国家对公开医疗数据二次使用有备案要求);③如果你把数据并入产品,产品的合规责任仍在你身上。此外,论文本身是 CC BY 4.0,引用论文图表时必须署名。
误解 3:“有共现矩阵就等于有完整的多标签标注”
事实:共现矩阵只覆盖五类病变的存在与否(二值),不覆盖其他发现(肺气肿、结节、钙化、淋巴结肿大等)。而且它是由两名医师"额外筛查"得出的,未经独立复核,可靠性低于主类别标签。把它当作"完整多标签标注"会导致两个问题:误以为负样本真的没有该病变(实际上可能漏标);误以为标注质量与主类别相同。
误解 4:“两名放射科医师验证过,所以标签是金标准”
事实:技术验证确认的是"类别归属正确、图像完好、病变可见",不是"诊断正确"。标签的语义是影像学发现,不是病理诊断。“肺肿块"类的病例并未经组织学证实。而且病例在两名读者间分配而非双阅,无法计算观察者间一致性。因此这份数据适合做"方法评测”,不适合做"诊断准确性验证"。
误解 5:“既然刻意保留异质性,就可以直接用来证明模型鲁棒”
事实:异质性是必要不充分条件。要证明鲁棒,还需要:①按异质维度做分层评测(例如按期相分组比较);②证明性能下降不是由捷径特征导致的(坑点 4);③最好有外部数据做交叉验证。直接用这份数据训练+测试得到的高分,只能证明"在该数据集分布内有效",不能证明鲁棒。
误解 6:“Zenodo 上的 zip 名叫 Med3DVlM,说明这不是 ChestPathCT5-S100”
事实:文件前缀与数据集名称不一致是打包遗留问题,数据内容本身与论文描述一致(87 例、五类、NIfTI)。判断"是不是同一数据集"的依据是 DOI 与记录页元数据,不是 zip 的文件名。这一点在任何数据工程流程中都是通用原则:以元数据为准,以文件名为线索。
§15 DAIMS 数据资产成熟度评估
DAIMS(Data Asset Maturity)从五个维度评估数据资产的成熟度。以下为对本数据集的分项评分与依据,采用 1–5 分制(5 为最高)。
15.1 评分表
| 维度 | 评分 | 依据 |
|---|---|---|
| D1 可获得性(Accessibility) | 5 / 5 | CC0 1.0 + Zenodo 直下,无注册、无申请、无 DUA。五个 zip 可单独下载。文件 md5 公开可校验。这是满分项——同类数据集中极少有如此低的获取门槛 |
| D2 文档完备度(Documentation) | 4 / 5 | 一篇完整 Data Release 论文 + Zenodo 元数据 + 分项表格(类别、期相、采集参数、层厚层数分布)。扣分点:未分列各类的期相构成;未说明 13 例排除的细分;zip 命名与论文规则不一致且未解释;未见单独的 README/数据字典文件 |
| D3 标注质量(Annotation Quality) | 3 / 5 | 两名放射科医师技术验证类别归属与病变可见性,但未双阅、未报告一致性指标、未做病理确认。共现矩阵为额外筛查结果,未经独立复核。标签语义为影像学发现而非诊断 |
| D4 规模与代表性(Scale & Representativeness) | 2 / 5 | 87 例、单中心、单厂商、无人种信息、按类别分列的人口学缺失。作为"真实世界"数据,其真实性的体现主要在采集协议层面,而非人群层面 |
| D5 可复用性(Reusability) | 4 / 5 | NIfTI 格式生态成熟;体积按类别分包便于按需下载;共现矩阵支持多标签研究。扣分点:无分割掩码限制任务类型;无临床变量限制多模态;无逐例期相标签限制分层研究(须自行判定) |
| 综合 | 3.6 / 5 | 高可获得性 + 良好文档 + 中等标注 + 有限规模 + 良好可复用性 |
15.2 评分说明
为什么可获得性给满分:在医学影像数据领域,"能拿到"本身就是稀缺资源。大量高价值数据集需要机构认证、DUA 签署、数周审核。CC0 + Zenodo 的组合把这个过程压缩到零,这对方法学研究(需要反复实验、快速迭代)的价值难以低估。
为什么规模只给 2 分:不是因为 87 例"不好",而是因为"规模与代表性"作为一个维度,衡量的是能否支撑统计推断与群体层面的结论。87 例单中心数据在这两点上都受限。若单独看"作为方法学试验田的适用性",它会是高分;但 DAIMS 的 D4 维度问的是代表性,必须按此标准打分。
为什么标注质量给 3 分而非更高:技术验证是"确认"而非"标注"。它保证了数据没有明显错误,但没有提供标注的可靠性量化。对于分类任务,3 分是合理的——标签可用但不可深究;对于任何需要细粒度标注的任务(分割、定量),适用性更低。
为什么可复用性给 4 分而非 5 分:格式与结构都友好,但缺失的分割掩码、临床变量、逐例期相标签这三项,直接排除了三大类研究方向。若能补齐其中任一项(尤其是逐例期相标签,成本极低),可提到 4.5 分。
15.3 提升路径
如果作者发布 v1.1,以下四项改动的性价比最高(按投入产出比排序):
- 附一份逐例元数据 CSV(病例号、类别、期相、层厚、层数、共现标记)。成本:几小时。收益:消除本文列出的坑点 2、4 的主要根源,并使分层研究成为可能。这是最高优先级。
- 统一 zip 命名。成本:几分钟重命名 + 重新上传。收益:消除检索与脚本层面的混淆。
- 在论文补充材料中分列各类的期相构成。成本:一次表格整理。收益:让读者能准确评估期相泄漏的严重程度,而不必推测。
- 增加一名第三读者的双阅与 kappa 报告。成本:数十小时的医师时间。收益:把 D3 从 3 分提到 4 分以上,显著提升学术可信度。
前三项几乎零成本,第四项成本较高但对数据集的学术地位提升最明显。对使用者而言,前三项目前只能靠自己补(见 §13.1 的 manifest 生成与 §10.3 的疑点清单)。
15.4 与同类数据集的成熟度对照
| 数据集 | 可获得性 | 文档 | 标注 | 规模 | 可复用 | 综合(本方法粗估) |
|---|---|---|---|---|---|---|
| ChestPathCT5-S100 | 5 | 4 | 3 | 2 | 4 | 3.6 |
| LIDC-IDRI | 4 | 4 | 5 | 4 | 4 | 4.2 |
| RibFrac | 3 | 4 | 4 | 3 | 4 | 3.6 |
| chest-ct-sepsis-er(库内) | 2(credentialed) | 5 | 3 | 4 | 4 | 3.6 |
| SIIM-ACR Pneumothorax | 4 | 3 | 4 | 4 | 3 | 3.6 |
这张表的意义不在于排名,而在于说明:不同数据集在不同维度上各有取舍,综合分数相近不代表可以互相替代。选择数据集应看具体研究问题落在哪个维度上。若问题是"能不能快速开始做实验",可获得性权重最高,本数据集是首选;若问题是"标注是否可靠到可以发表诊断准确性研究",标注质量权重最高,本数据集不适合。
§16 结语与延伸阅读
16.1 三句话总结
- ChestPathCT5-S100 是 87 例来自洛桑大学医院十年档案的真实世界胸部 CT,覆盖五类常见病变与三种对比剂期相,CC0 1.0 在 Zenodo 零门槛公开。
- 它的设计核心是"刻意保留采集异质性 + 附共现矩阵",定位是跨域鲁棒性评测与方法学试验田,而非大规模预训练或临床验证。
- 使用前必须处理两个问题:期相与类别的强相关(捷径风险),以及每类 14–20 例带来的高方差(必须重复交叉验证)。
16.2 延伸阅读建议
- 原始论文:GigaByte 2026, article 184(DOI 10.46471/gigabyte.184)。重点读 Figure 1(构建流程)、Figure 2(五类代表性轴位层面)与 Table 2(共现矩阵)。
- 数据集:Zenodo DOI 10.5281/zenodo.18256796(concept)/ 10.5281/zenodo.18256797(v1.0)。
- 方法学背景:论文引用的 Tripathi et al.(J Am Coll Radiol 2023)关于影像 AI 数据集偏差与不平等的综述,是本数据集"为什么保留异质性"这一设计思路的直接理论来源。
- 库内对照:RibFrac(rid 451,肋骨骨折分割)、SIIM-ACR Pneumothorax(rid 737,气胸 2D 基准)、chest-ct-sepsis-er(rid 600,急诊胸部 CT + 临床数据)。
16.3 返工与更新提示
本文所有数字截至 2026-10-17 核验。若 Zenodo 发布 v1.1 或更新版本,以下内容需要复核:例数(87 是否变化)、体积(9.4 GB)、文件命名(是否统一为 ChestPathCT5-S100 前缀)、DOI(version DOI 会变,concept DOI 不变)、以及是否补充了逐例元数据 CSV(若补充,§10.3 的疑点 2、3、8 可结案)。
复核时的最快路径是:打开 Zenodo 记录页 → 看 Versions 区是否有新版本 → 对比 Files 区的文件名与体积 → 若一致,无需修改正文;若不一致,按 §10.2 的双口径存照格式记录新差异。
§17 工程实现细则:从 NIfTI 到可训练批次
§6.5 给了最短路径,这一节补工程细节,处理真实数据上会遇到的边界情况。
17.1 体素间距与各向异性
胸部 CT 的体素通常是各向异性的:轴位平面内分辨率约 0.6–0.8 mm(512×512 矩阵覆盖约 350 mm 视野),层厚却是 0.62–2 mm 且不同病例差异很大。这意味着"128×128×128 的立方体"在每个病例里对应的物理尺寸完全不同。
处理各向异性的三种主流做法:
| 做法 | 实现 | 后果 |
|---|---|---|
| 忽略 | 直接 resize 到固定网格 | 物理尺度被打乱,模型学到的是"相对比例"而非"绝对尺寸" |
| 重采样到等距 | scipy.ndimage.zoom 或 SimpleITK.Resample 到 1 mm 等距 |
物理尺度统一,但部分病例体积暴涨(481 层 × 0.62 mm → 若重采样到 1 mm,层数降到约 298) |
| 保持原间距 + 物理尺寸 patch | 按毫米定义 patch 尺寸(如 96 mm³),换算成体素后裁剪 | 最忠实,实现最复杂 |
第二条路最常用。实现要点:先读 pixdim,算出目标网格的物理尺寸,再按比例重采样。注意 MONAI 的 Spacingd 已经封装了这套逻辑,比手写 zoom 稳妥。
17.2 HU 值的边界处理
CT 的 HU 值理论上无上界(金属可达数万),下界约 -1024(空气)。原始数据里可能存在:
- 金属伪影造成的极端高值(支架、牙科修复体、体外导线)
- 裁剪或重建造成的负值溢出
- 小数精度损失
预处理时必须 clip。建议范围:肺窗分析用 [-1200, 600],骨窗分析用 [-200, 3000],全窗用 [-1024, 3071](对应 12 bit 存储上限)。不要用全局统一 clip 后归一化再喂给骨窗任务——软组织信息会被压成一片。
17.3 3D patch 采样的两个陷阱
陷阱一:全背景 patch。 随机裁剪 3D patch 时,胸部外围的 patch 可能全是空气或全是体表外区域。若按"是否有病灶"做正负样本平衡,全背景 patch 会被当作负样本,导致模型学到"看边缘"。
处置:计算 patch 内的组织比例(HU 在 [-200, 200] 范围内的体素占比),低于阈值(如 5%)的 patch 直接丢弃或降采样。
陷阱二:标签泄漏到相邻 patch。 肿瘤 patch 与肿瘤边缘 1 mm 外的 patch 几乎无法区分,但标签一个是正一个是负。若用滑动窗口推理,阳性区域会被预测成一片"晕染"。
处置:训练时用多示例学习(MIL)框架,把整例作为一个 bag、patch 作为 instance,只在 bag 级别监督;推理时用最大池化或注意力池化聚合。
17.4 内存与吞吐的现实估算
87 例、单例原始体积平均约 108 MB(9.4 GB / 87,含压缩),解压后按 512×512×481 × 2 字节约 252 MB。若全部载入内存约 22 GB——超出多数单卡工作站。
三种应对:
- 按需加载 + LRU 缓存:只缓存最近用过的 20–40 例,其余从磁盘读(
.nii.gz解压耗时约 1–3 秒/例)。 - 预转格式:把
.nii.gz转成npy(未压缩)或LMDB/HDF5容器,换取读取速度。87 例全转约 22 GB 磁盘,可接受。 - 预切 patch 落盘:离线切好 128³ patch(例如每例 16 个),训练时直接读 patch。磁盘占用与原始相近,但读取快 10 倍以上。
方案 3 在小数据集上最实用——87 例的数据量小到可以"预处理一次、反复训练",把 IO 从训练循环里彻底剥离。
17.5 交叉验证的实现细节
分层 5 折 + 5 次重复的实现:
from sklearn.model_selection import StratifiedKFold
import numpy as np

labels = np.array([c['label'] for c in index])      # 87 个类别字符串
seeds = [0, 1, 2, 3, 4]
all_scores = []

for seed in seeds:
    skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=seed)
    fold_scores = []
    for tr, te in skf.split(np.zeros(len(labels)), labels):
        model = build_model().fit(index[tr])
        fold_scores.append(evaluate(model, index[te]))
    all_scores.append(fold_scores)

all_scores = np.array(all_scores)                    # shape (5, 5)
print(f"macro-F1 = {all_scores.mean():.3f} ± {all_scores.std():.3f}")
注意 std 用的是 25 个折分数的标准差,这会把"折间方差"与"种子间方差"混在一起。更严谨的做法是分别报告:种子内 5 折的均值(作为该次重复的代表),再对 5 个代表值求均值与标准差。论文中应说明用的是哪一种。
17.6 与 MONAI / nnU-Net 生态的衔接
虽然本数据集没有分割掩码,但预处理与数据加载可以直接复用分割框架的组件:
monai.transforms.LoadImaged+Spacingd+Orientationd:三步解决方向与间距问题,比自己写稳。monai.data.Dataset+DataLoader:支持按需加载与多进程预取。- nnU-Net 的
plan_and_preprocess:即使不做分割,它的体素间距分析与重采样参数估计也很有参考价值——它会告诉你这批数据的间距分布是否足够一致。
若做分类,monai.networks.nets.DenseNet121 或 ResNet50 的 3D 版本可以直接用;若要更强的 3D 特征,SwinUNETR 的编码器(去掉解码器)是常见选择。小数据集上更推荐轻量模型 + 强增广,而不是大模型——87 例撑不起百万参数级模型的训练。
§18 与本库其他数据集的组合用法
单独用这份数据能做的事情有限;把它当作组件接入更大的流程,价值会显著提升。以下三种组合方案各有明确的研究问题。
18.1 方案 A:RibFrac 训练分割 → ChestPathCT5-S100 测分类泛化
研究问题:在公开挑战赛数据(RibFrac,数百例,含像素级骨折分割)上训练的分割模型,迁移到真实世界、异质性更强的 CHUV 数据上时,检出性能如何衰减?
流程:
- 用 RibFrac 训练一个 3D 骨折分割网络(如 nnU-Net)。
- 在 ChestPathCT5-S100 的 RF 类 14 例上做推理,把分割结果二值化后判断"是否检出骨折",与图像级标签比对。
- 按层厚分层(0.62 mm 组 vs 1.25 mm 组)报告检出率。
价值:这是"挑战赛数据 → 真实数据"的典型迁移评测,直接对应临床部署中最关心的问题。注意两边的标注粒度不同(像素级 vs 图像级),必须做粒度转换,不能直接算 Dice。
18.2 方案 B:ChestPathCT5-S100 训练 → 库内其他胸部 CT 测鲁棒性
研究问题:在这 87 例上训练的五类分类器,迁移到 rad-chestct(rid 819)或 chest-ct-sepsis-er(rid 600)等库内胸部 CT 数据上,还能不能工作?
流程:
- 按 §13 训练五类分类器。
- 在目标数据集上做零样本推理(不微调),观察精度衰减。
- 用少量目标域样本做微调(few-shot),观察恢复曲线。
价值:这条路径把"小数据集"的劣势转换为优势——87 例足够训练一个小模型,同时又足够"真实",是研究跨域迁移的理想源域。注意目标数据集的标签体系可能不同(例如 sepsis 队列没有五类标签),需要人工映射或只评测子集。
18.3 方案 C:与临床数据配对,做影像-临床多模态
研究问题:单独的影像分类与"影像 + 年龄 + 性别"的组合分类,性能差多少?
流程:
- 本数据集提供年龄中位数与性别分布,但逐例的年龄性别未随数据发布(这是 §10.3 疑点之一)。因此这条路径目前只能在"假设可得"的前提下设计,无法立即执行。
- 若未来补充了逐例人口学,可与 chest-ct-sepsis-er 的表格数据做方法学对照(后者有完整的临床表)。
价值:这条路径目前受阻于数据缺口,列在这里是为了说明"为什么逐例元数据 CSV 是最高优先级的改进项"(§15.3 第 1 条)。一个几小时的补充工作,可以解锁整类研究方向。
18.4 组合方案的共同注意点
三条方案都涉及"跨数据集",因此都必须处理三个技术问题:空间分辨率不一致(重采样到统一间距)、强度分布不一致(不同扫描仪的 HU 校准、不同重建核的噪声特性)、标签体系不一致(粒度、语义、阳性判据)。这三项在任何跨数据集研究中都是主要误差来源,而本数据集因为保留了原始采集异质性,恰好适合作为"检验这些误差影响"的实验材料。
§19 术语表
| 术语 | 英文 | 简明释义 |
|---|---|---|
| NIfTI | Neuroimaging Informatics Technology Initiative | 单文件医学影像格式,.nii 或 .nii.gz,含体素数据与几何头信息 |
| HU | Hounsfield Unit | CT 值的标准化单位,水为 0,空气约 -1000,骨为 +400 至 +3000 |
| 窗宽/窗位 | window width / window level | 把 HU 范围映射到显示灰阶的两个参数。肺窗 W1500/L-600,纵隔窗 W350/L40,骨窗 W2000/L400 |
| 期相 | phase | 对比剂在体内分布的时间阶段。动脉期约 40 秒、静脉期约 90 秒、平扫无对比剂 |
| CTA | CT Angiography | CT 血管造影,动脉期扫描,用于观察血管腔内充盈缺损 |
| SmartPrep | — | GE 的团注跟踪技术,监测靶血管 CT 值达到阈值后自动触发扫描 |
| 团注跟踪 | bolus tracking | 与 SmartPrep 同义的技术类别,各家厂商有不同商品名 |
| 充盈缺损 | filling defect | 血管腔内对比剂未充盈的暗区,肺栓塞的直接征象 |
| 共现 | co-occurrence | 同一例中同时存在多种病变的情况 |
| 多标签 | multi-label | 一个样本可同时属于多个类别的分类范式 |
| 弱监督 | weakly supervised | 只用图像级标签训练,目标是定位或分割,标注成本低于像素级 |
| MIL | Multiple Instance Learning | 多示例学习,把一例视为一个 bag、其中的 patch 视为 instance,只在 bag 级监督 |
| 捷径学习 | shortcut learning | 模型学到与标签相关但非因果的伪特征(如本数据集的期相) |
| 数据集偏移 | dataset shift | 训练与测试数据分布不一致 |
| 重复交叉验证 | repeated cross-validation | 用多个随机种子重复 K 折交叉验证,以估计指标方差 |
| 分层抽样 | stratified sampling | 按类别比例分配各折样本,保证每折类别分布一致 |
| 各向异性体素 | anisotropic voxel | 体素在三个方向上的物理尺寸不同(层厚通常大于面内分辨率) |
| DAIMS | Data Asset Maturity | 数据资产成熟度评估框架,本文用五维 1–5 分制 |
| CC0 | Creative Commons Zero | 公共领域贡献许可,放弃全部版权,无署名义务 |
§20 与论文原文的逐段对照
本节把论文的核心陈述逐条摘出,与本文的解读并列,便于读者判断哪些是原文事实、哪些是本文的推断。凡标「推断」的段落,均为本文依据临床常识或数据结构所作的合理推论,不可作为原始事实引用。
20.1 原文陈述与解读
| # | 论文陈述(英文原意) | 本文解读 | 性质 |
|---|---|---|---|
| 1 | 87 例真实世界胸部 CT,覆盖五类常见病变 | 87 为最终发布数,非初筛数 | 事实 |
| 2 | 来自十年期单中心回顾性队列 | 2015-01 至 2025-12,CHUV 一家 | 事实 |
| 3 | 刻意保留采集异质性与合并发现 | 异质性是设计目标,非缺陷;共现矩阵是其产物 | 事实 |
| 4 | 含增强(动脉期与静脉期)与非增强检查 | 动脉 52 / 静脉 10 / 平扫 25 | 事实 |
| 5 | 来自急诊、肿瘤、创伤场景 | 场景与类别大致对应:PE/气胸/骨折偏急诊与创伤,肿块偏肿瘤 | 事实 + 推断 |
| 6 | 全部以 NIfTI 提供 | .nii.gz,按类分包 |
事实 |
| 7 | 两名放射科医师技术验证 | 核对类别、完整性、可见性;非双阅、无 kappa | 事实 |
| 8 | 附共现发现二值矩阵支持多标签研究 | 87×5,逐例标记是否合并其他四类发现 | 事实 |
| 9 | CC0 1.0 公开,允许无限制使用与再分发 | Zenodo 直下,无门槛 | 事实 |
| 10 | 支持分类、检测、弱监督、多任务范式 | "检测"只能是弱监督级,无框无掩码 | 事实(需限定) |
20.2 论文未明确说明但可合理推断的项
以下五项论文正文未见明确表述,本文在相应章节标为推断,此处集中说明依据:
推断 1:五类各自的期相构成高度不均。 依据是临床协议强制性——PE 必须动脉期 CTA,骨折几乎都是创伤平扫。若此推断成立,期相即为类别的强代理变量(坑点 4 的理论基础)。验证方式:下载数据后逐例判断是否增强(例如看主动脉或心脏的 CT 值是否超过 200 HU),再与类别交叉列表。
推断 2:13 例排除中"拒绝授权"占比可能不低。 依据是瑞士的知情同意实践——回顾性研究一般需要广泛同意(broad consent)或至少不反对(non-objection)机制,能否取得同意受病人是否仍可联系、是否搬迁等现实因素影响。验证方式:查论文补充材料。
推断 3:技术验证阶段未淘汰任何一例。 依据是论文表述"confirmed …“(确认)而非"excluded …”(排除),且最终数仍是 87。验证方式:查论文正文验证段落的完整措辞。
推断 4:图像已裁剪至胸部范围,未保留颈部与面部结构。 依据是论文明确的匿名化陈述"不包含可能致患者再识别的面部结构"。验证方式:抽查体积顶部层面。
推断 5:NIfTI 的 origin(原点)可能已被重置。 依据是彻底匿名化的常规做法。验证方式:读 affine 检查平移分量分布。若全部接近 0,说明已重置;若分布各异,说明保留了原始定位。
20.3 本文刻意未做的推断
为避免过度解读,以下三项本文明确不做推断:
- 不推断各类的病变严重程度(例如"这 20 例 PE 中多少是中央型、多少是周围型")。数据没有给出,任何估计都是编造。
- 不推断各类的年龄性别构成。论文只有全队列的中位数与性别计数,按类别拆解会引入不可验证的假设。
- 不推断与 aortaseg-60 的作者贡献重叠细节。两者虽同团队,但作者列表与分工是否完全相同未经核对,本文只陈述"同团队、同刊、同许可框架"这三项已核实的事实。
§21 数据治理视角:小数据集的可持续性问题
21.1 小数据集的生命周期困境
公开数据集的价值往往随时间衰减,也有随时间增值的。ChestPathCT5-S100 属于后者,原因值得单独讨论。
规模型数据集(数十万例)的生命周期通常是:发布 → 被大量使用 → 被更大的数据集取代 → 逐渐退场。它们的价值在于"量",而量总会被超越。
标注型数据集(精标注、双阅、金标准)的生命周期更长:即使规模不大,只要标注质量足够高,就会被持续引用于标注方法研究。但它们依赖维护——标注标准的修订、错误标签的更正。
设计型数据集(如本条目)走的是第三条路:价值不在于量,也不完全在于标注质量,而在于特定的设计选择——保留采集异质性、提供共现结构、零门槛获取。这类数据集的生命周期取决于"这个设计选择是否持续被需要"。只要"跨期相鲁棒性"仍是被研究的问题,这份 87 例数据就仍有引用价值。
一个现实的风险:如果未来出现另一个保留异质性但规模更大的数据集(例如 500 例、五期相、多中心),本数据集的引用量会迅速下降。这不是它的失败,而是生态演进。数据集的价值往往与其"填补的空白"同寿。
21.2 Zenodo 的版本治理
Zenodo 提供 concept DOI 与 version DOI 双层结构,这对数据集的长期可用性是关键设计:
- concept DOI(18256796) 永远指向"最新版本",适合放在项目主页、论文引用中作为"这个数据集"的标识。
- version DOI(18256797) 永远指向 v1.0 快照,适合放在复现实验的脚本与实验日志中。
这个双层结构的隐含承诺是:旧版本永远可访问。即使作者发布 v2.0,v1.0 的 URL 仍然有效。但注意:如果作者删除整个记录(罕见但可能),两个 DOI 都会失效。数据集的长期可用性最终依赖机构仓库的承诺,而非 DOI 本身。
实用建议:在做长期项目时,除了记录 DOI,还应在本地留存一份校验清单(文件名 + md5 + 下载日期),这样即使 Zenodo 出现问题,也能证明你使用的是哪一份数据。
21.3 小数据集的引用经济学
医学影像领域长期存在"引用大库、忽略小库"的倾向:引用 LIDC-IDRI 显得扎实,引用 87 例的数据集显得单薄。这种倾向对小数据集不公平,也会误导研究方向。
更合理的引用逻辑是按研究问题引用:如果你研究的是"跨域鲁棒性",引一个十万例的单中心数据集反而不如引 87 例的多期相数据集贴切。数据集的规模应当与研究问题匹配,而不是与研究者的安全感匹配。
从这个角度看,ChestPathCT5-S100 的作者把"87 例"写进名字(虽然 S100 的本意不是 87),是一种有意识的自我定位:承认规模,强调设计。这种诚实,在小数据集里反而是稀缺品质。
21.4 使用者的责任
最后一点,也是本文最想强调的一点:小数据集对使用者提出了更高的责任要求。大库可以容忍粗放使用(随机切分、不查数据字典、不关心版本),因为统计平均会掩盖很多错误。87 例的数据集不容忍:
- 一个错误的切分会让某一类完全落在训练集里,导致测试指标虚高。
- 一个错误的窗宽选择会让模型在特定类上系统性失败。
- 一个未发现的期相泄漏会让整篇论文的结论失效。
这些错误在大数据集上也会发生,只是被平均掩盖了。小数据集把它们放大到无法忽视——这恰恰是它作为方法学训练场的额外价值:用它做实验,你会被迫养成严谨的习惯。而这些习惯在任何数据规模上都是需要的。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- deeplesion — 共享标签:医学影像 / CT / 目标检测
- fdtooth — 共享标签:医学影像 / CT / 目标检测
- rad-chestct — 共享标签:医学影像 / CT / 图像分类
- modus — 共享标签:医学影像 / 图像分类 / 目标检测
- kvasir-capsule — 共享标签:医学影像 / 图像分类 / 目标检测
- brax — 共享标签:医学影像 / CT / 图像分类
- luna16 — 共享标签:医学影像 / CT / 目标检测
- covid-ct — 共享标签:医学影像 / CT / 图像分类
- sar-covid — 共享标签:医学影像 / CT / 图像分类
- oral-cavity-opmd — 共享标签:医学影像 / 图像分类 / 目标检测
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
