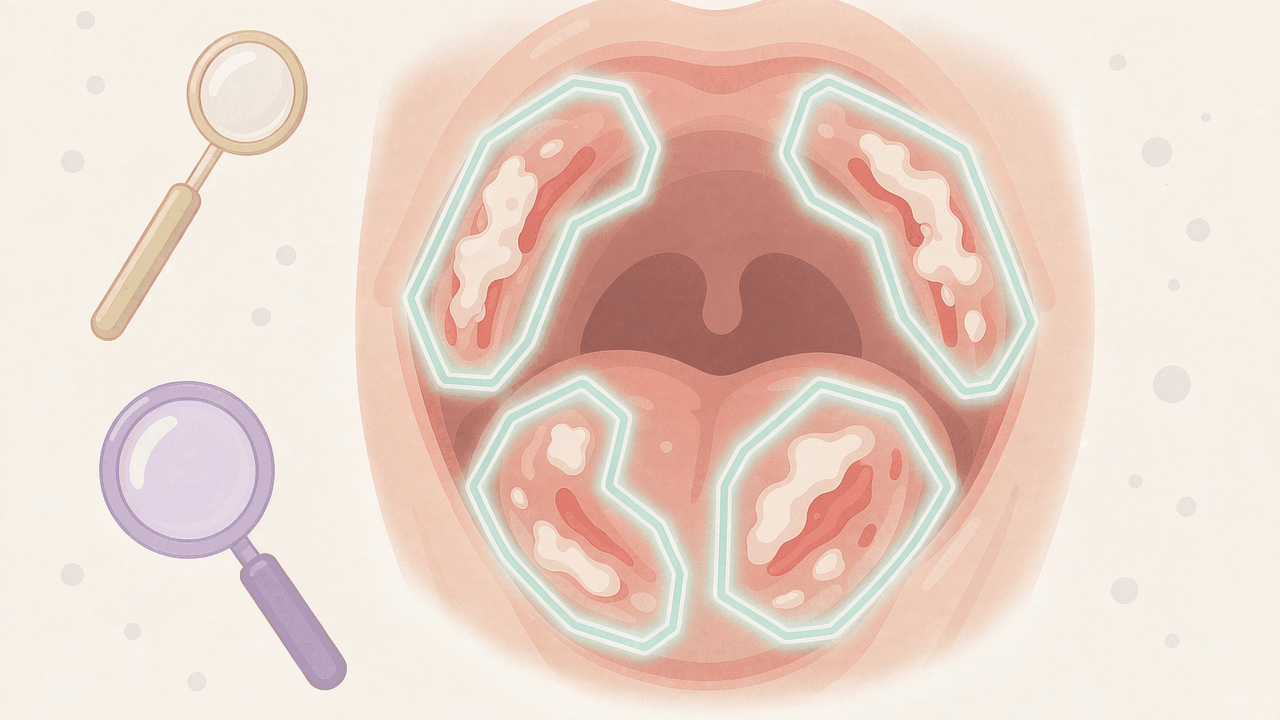
信息速览
INFOBOX — oral-cavity-opmd 一屏速览
维度 内容 本质 斯里兰卡人群手机口腔腔内白光照片数据集(非影像组学、非 WSI、非活检切片) 团队 University of Peradeniya(斯里兰卡),通讯 N.S. Piyarathne;协作 Aberdeen/UQ/Uppsala 论文 Oral Oncology. 2024;156:106946(doi:10.1016/j.oraloncology.2024.106946;PMID 39002299) 数据 3,000 张图像 / 714 名患者;手机摄像头、可见光、真实临床场景 类别 healthy / benign / OPMD / OCA 四类(逐类细目未公开) 标注 口腔腔体 + 病变区域多边形边界,COCO 格式(Annotation.json) 元数据 年龄/性别/诊断 + 行为风险:吸烟/饮酒/槟榔咀嚼(Patientwise_data.csv) 采集地 Dental Teaching Hospital, Peradeniya, Sri Lanka 姊妹论文 IEEE Access 2024;12:124375-124390(多模态分类,MobileNetV3-Large acc 81%/F1 78%/MCC 0.57) 获取 请求制:机构邮箱 Zenodo 账号 + 用途简述 + PI 主页,2-3 工作日审批 许可 CC BY-NC-ND 4.0(非商业、禁衍生、须引用) 版本 Zenodo v1(2024-02-15);DOI 10.5281/zenodo.10664056;concept DOI …10664055
§0 导读:这个数据集解决什么问题
口腔癌是全球第六大常见恶性肿瘤之一,在东南亚与南亚的发病率尤高,且因早期症状隐蔽、筛查资源匮乏,患者常在晚期才被诊断,五年生存率被大幅拉低。口腔潜在恶性疾病(OPMD,oral potentially malignant disorders)——包括口腔白斑、红斑、口腔黏膜下纤维化等——是口腔鳞状细胞癌(OSCC)的重要癌前阶段,若能在此阶段被识别与干预,可显著阻断癌变进程。问题在于:基层缺少受过训练的口腔专科医生,而"是否有可疑病变"的判断高度依赖专科经验与器械(如自体荧光、活检)。因此,能否用手机拍一张口腔腔内照片、交由 AI 判断是否可疑,成为低资源地区人群筛查的关键科学问题。制约这一方向的瓶颈不是模型,而是数据:口腔腔内图像涉及隐私、采集依赖临床场景、标注需要专科医生,公开可用的带标注数据集长期稀缺。
oral-cavity-opmd 正是针对这一瓶颈的回应。它由斯里兰卡佩拉德尼亚大学团队在 Dental Teaching Hospital 门诊采集,共 3,000 张手机拍摄的口腔腔内白光照片、来自 714 名患者,由临床医生分为 healthy(健康)、benign(良性病变)、OPMD(口腔潜在恶性疾病)、OCA(口腔癌) 四个类别,并对口腔腔体与病变区域做多边形边界标注(COCO 格式),同时附带患者级的吸烟、饮酒、槟榔咀嚼等行为风险元数据。它把"图像 + 临床诊断 + 风险因素"三件套放在同一份可申请的数据里,直接支持图像分类、病变检测、实例分割,以及影像-临床信息融合的多模态建模。
§0 读法三则:
- 这个条目是"数据集 + 方法论文 + 复现生态"三合一:本体是 3,000 张带标注图像(请求制),方法是同团队 IEEE Access 2024 的多模态分类流水线,生态是外部研究(MDPI Cancers 2026 等)的复用——三者的许可与门槛各不同(§6)。
- 全文硬数字以论文(Oral Oncology 2024)与 Zenodo 官方记录为准;逐类细目、分辨率区间、采集年份等论文未公开项,条目一律标注"未披露",不臆造(第 §9 存照)。
- 检索时请把本条目与三个同名易混的类似数据集分开:印度 SMART-OM(2,469 图 / 331 受试者)、Talwar 等 Cancers 2023(印度手机图像)、MDPI Dent. J. 2026(1,500 图 OPMD 二分类)——它们类同但不同源(坑 2)。
§1 数据集速览:十问十答
Q1:oral-cavity-opmd 到底是什么、属于什么模态?
它是手机拍摄的口腔腔内白光照片数据集(white-light intraoral photographs),不是 X 光、不是 CT/MRI、不是病理 WSI、也不是影像组学特征。模态属于可见光彩色摄影,与内窥镜白光影像、皮肤镜图像同族但部位在口腔腔内。
Q2:规模有多大?
3,000 张图像,来自 714 名患者。两个数字分处不同源:3,000 出自 Zenodo Overview 与论文;714 出自论文摘要与 PubMed(“3000 … images obtained from 714 patients”)。
Q3:分几类、类名是什么?
四类:healthy(健康)、benign(良性病变)、OPMD(口腔潜在恶性疾病)、OCA(口腔癌)。这是论文原始类名;注意 OCA 与组织学上的 OSCC 不是同一粒度缩写(坑 3),且逐类图像数未公开。
Q4:标注到什么粒度?
两层多边形:① 口腔腔体边界(把整个口腔腔体轮廓圈出);② 病变区域边界(把病变范围圈出)。以 COCO 格式 存于 Annotation.json,含 segmentation 与 bounding box,可直接用于目标检测与实例分割。
Q5:谁标的、怎么保证质量?
由临床医生/领域专家完成分类与多边形标注,使用团队自研的定制软件工具。标注工作在白光临床场景下进行,采集与标注均经伦理批准与每位受试者的书面知情同意,图像已匿名化。
Q6:除了图像,还带什么?
患者级元数据(Patientwise_data.csv):年龄、性别、图像数、以及吸烟 / 饮酒 / 槟榔咀嚼三个二元风险指标;图像级元数据(Imagewise_data.csv):类别、临床诊断、标注区域数。这套"图像 + 风险因素"结构正是多模态建模的入口。
Q7:数据在哪、怎么拿?
托管于 Zenodo 记录 10664056(DOI 10.5281/zenodo.10664056),但图像文件受限——需用官方机构邮箱注册的 Zenodo 账号提交申请,附用途简述(≤250 词)、PI 姓名与机构、PI 在机构官网的主页链接,2-3 个工作日人工审批。没有公开直链。
Q8:许可是什么、能商用吗?
CC BY-NC-ND 4.0(署名-非商业性使用-禁止演绎)。这意味着:可用于非商业研究;须引用原文;不可商用;不可做衍生作品(NoDerivatives)——二次训练的模型权重、重标注版本是否构成"衍生"需谨慎判断(坑 5)。
Q9:有人用它做过什么?
同团队的 IEEE Access 2024 论文用它做多模态(图像+元数据)二分类(benign vs potentially malignant),MobileNetV3-Large 达 accuracy 81% / F1 78% / MCC 0.57,并与五种其他预训练模型对比。外部 MDPI Cancers 2026 也明确复用了本数据集做不平衡分类的 CNN vs Transformer 对比。
Q10:为什么它对 AI-Ready 重要?
它是"高临床相关性 + 高获取门槛"的典型:数据直接对应真实低资源筛查场景(手机、白光、人群风险因素),科学价值高;但受限访问、NoDerivatives 许可、单一民族人群三重约束,使它在 AI-Ready 光谱上属"高价值—中低可获取性"象限——正是最需要条目把门槛与边界讲清楚的类型。
§2 数据构成与规格
2.1 规模、来源与人群
oral-cavity-opmd 的核心规模数字有两个,二者分处不同官方源,须同时标注:
| 维度 | 数值 | 来源 |
|---|---|---|
| 图像总数 | 3,000 张 | Zenodo Overview / Oral Oncology 论文 / PubMed 摘要 |
| 患者总数 | 714 名 | PubMed 摘要(“3000 … images obtained from 714 patients”)/ 论文正文 |
| 类别数 | 4(healthy / benign / OPMD / OCA) | 论文 |
| 图像格式 | JPEG(Images.zip 打包) | Zenodo |
| 标注格式 | COCO JSON | Zenodo(Annotation.json) |
| 元数据 | 图像级 + 患者级两张 CSV | Zenodo |
人群来源是理解本数据集的第一把钥匙:全部图像来自斯里兰卡佩拉德尼亚(Peradeniya)地区、就诊于 Dental Teaching Hospital 的门诊患者。这一人群的流行病学背景与数据集的设计动机直接相关——南亚地区槟榔咀嚼(betel quid chewing)与口腔黏膜下纤维化、口腔癌高发,口腔癌筛查需求迫切而专科资源稀缺。数据集正是为"低资源地区人群筛查 AI"这一目标服务的。
逐类细目未公开是本数据集最关键的规格缺口:论文与 Zenodo 均未给出 healthy / benign / OPMD / OCA 各自多少张、多少患者。这使检索者无法在申请前评估类别不平衡程度——而类别不平衡恰恰是口腔病变分类的核心难点(外部复用者 MDPI Cancers 2026 的标题就直接聚焦"不平衡口腔癌图像分类")。逐类分布只能等申请获批后从 Imagewise_data.csv 自行统计。
2.2 采集规格与质量控制
| 属性 | 规格 |
|---|---|
| 采集设备 | 移动电话(手机)摄像头(Android / iOS) |
| 光照条件 | 可见光(white light),真实临床场景 |
| 采集地点 | Dental Teaching Hospital, Peradeniya, Sri Lanka(门诊) |
| 图像格式 | JPEG |
| 匿名化 | 图像已匿名化(anonymized) |
| 伦理 | 伦理批准 + 每位受试者书面知情同意 |
| 标注工具 | 研究团队自研的定制软件工具 |
三处值得注意:
- "真实临床条件"是优点也是负担:手机拍摄意味着图像不受控——拍摄角度、光照强度、清晰度、缩放各不相同,还可能包含牙齿、口镜、牵引器等非病变结构。这一方面提升了数据的真实性与可迁移性(模拟基层非专科人员的实际拍照条件),另一方面使图像质量方差大、模型鲁棒性挑战高。这与"标准化临床摄影"数据集形成鲜明取舍对比(§8.3)。
- 白光 vs 自体荧光:本数据集仅用白光图像,不含自体荧光(autofluorescence)或窄带成像等专科辅助模态。白光图像的优势是"任何手机都能拍",正是低资源筛查所需;代价是病变对比度低于自体荧光,对早期 OPMD 的区分难度更高。
- 分辨率未披露:论文与公开元数据均未给出图像分辨率区间(如最小/最大像素),这对图像预处理(resize 策略)有实际影响——检索者需在数据到手后自行统计。
2.3 类别体系:四个类别的医学含义
四分类不是随意的技术切分,而是对应口腔病变诊断的一条临床谱带:
| 类别 | 英文 | 医学含义 | 临床意义 |
|---|---|---|---|
| 健康 | healthy | 正常口腔黏膜 | 阴性对照基线 |
| 良性病变 | benign | 炎性、创伤性、感染性等良性改变 | 与 OPMD 的鉴别诊断难点 |
| 口腔潜在恶性疾病 | OPMD | 白斑、红斑、口腔黏膜下纤维化等癌前病变 | 早筛的核心干预窗口 |
| 口腔癌 | OCA | 口腔恶性肿瘤(组织学多 OSCC) | 确诊与转诊目标 |
几个关键点:
- benign 与 OPMD 的边界是临床难点:良性病变(如创伤性角化、慢性炎症)在肉眼白光下与 OPMD 高度相似,是临床鉴别诊断的主要挑战。数据集把两者单列,正是为了让模型学习这条最难分但最关键的界线。
- OPMD 未按亚型细分:OPMD 是一个上位概念,涵盖口腔白斑(leukoplakia)、红斑(erythroplakia)、口腔黏膜下纤维化(oral submucous fibrosis)、增殖性疣状白斑等多种异质性病变,恶性转化率各异。数据集只在"OPMD"这一层给标签,不支持亚型级诊断研究——若研究目标是"区分白斑与黏膜下纤维化",本标签体系无法直接支撑。
- OCA 缩写与 OSCC 的粒度差(存照):本数据集论文用 OCA(oral cancer) 指代口腔癌类;而组织学上 90% 以上口腔恶性为 OSCC(oral squamous cell carcinoma,口腔鳞状细胞癌),姊妹论文 IEEE Access 2024 在描述组织学背景时即用 OSCC。二者非笔误,是"部位级癌"与"组织学型"两种粒度,引用时勿混(坑 3)。
2.4 标注规格:COCO 多边形与双重边界
标注以 COCO(Common Objects in Context)格式 存于 Annotation.json,包含两套多边形边界:
- 口腔腔体边界:把整个口腔腔体的可见轮廓圈为一个多边形区域——用于界定"感兴趣区域",帮助模型区分腔内组织与口外背景(如唇、皮肤、器械)。
- 病变区域边界:把病变范围圈出——这是诊断相关的核心标注,含 segmentation 多边形与 bounding box。
COCO 格式的选择意味着数据集可直接挂接主流检测/分割框架(如 YOLO 系、Detectron2、MMDetection、torchvision 的 Mask R-CNN 实现),无需格式转换。图像级元数据表 Imagewise_data.csv 另记录了每张图的标注区域数(number of annotated regions),可用于反推病变复杂度。
多边形 vs 掩码:多边形(polygonal)适合边界清晰的病变,存储紧凑、可无损缩放;但它不直接给出像素级掩码(mask),若要训练语义分割需自行将多边形栅格化为掩码。这与皮肤影像、眼底影像中常见的"多边形标注"传统一致。
2.5 元数据:图像级与患者级双表
数据集提供两张 CSV,构成"图像-患者"两级结构:
| 文件 | 层级 | 字段 |
|---|---|---|
| Imagewise_data.csv | 图像级 | 图像 ID、类别、临床诊断、标注区域数 |
| Patientwise_data.csv | 患者级 | 患者 ID、年龄、性别、图像数、吸烟/饮酒/槟榔咀嚼(二元指标) |
三个风险因素(吸烟 smoking、饮酒 alcohol、槟榔咀嚼 betel quid chewing)是南亚口腔癌流行病学的关键暴露变量,也是多模态建模的临床入口:模型不仅能看图,还能结合患者风险画像判断"这张图的可疑程度"。这正是同团队 IEEE Access 2024 论文所验证的路线——“融合多模态数据(含患者元数据)更贴近医生的诊断方式”(§5.2)。
一个隐忧:患者级元数据若与图像 ID 可关联,理论存在通过图像+元数据组合重新识别个体的残余风险——尽管图像已匿名化。数据集以"机构邮箱+PI 背书+用途审批"的请求制来约束这一风险,但使用者仍应遵守最小必要原则(§8.4)。
2.6 三类口腔病变数据集的结构对比
把本数据集与库内/文献中同域数据集按"采集模态 + 类别体系 + 获取门槛"对比,能看清它的生态位:
| 数据集 | 来源/人群 | 图像数 | 类别体系 | 获取 | 许可 |
|---|---|---|---|---|---|
| oral-cavity-opmd(本条目) | 斯里兰卡佩拉德尼亚 | 3,000 / 714 患者 | healthy/benign/OPMD/OCA | 请求制(机构邮箱) | CC BY-NC-ND 4.0 |
| SMART-OM(figshare 31341790) | 印度 | 2,469 / 331 受试者 | healthy/normal 变体/OPMD/OC | figshare 公开 | 视 figshare 条款 |
| Talwar 等 Cancers 2023 | 印度 | 1,120 可疑 + 1,058 非可疑 | 二分类(可疑/非可疑) | 论文配套,视团队 | 论文 CC BY |
| MDPI Dent. J. 2026;14(8):462 | 机构档案 + 公开源 | 1,500(750/750) | OPMD 二分类 | 论文配套 | — |
对比揭示本数据集的独特性:它是少数同时具备四类细粒度标签 + 患者级风险元数据 + 图像级 COCO 多边形标注的公开口腔腔内数据集之一;而其代价是最高的获取门槛(请求制)与最严格的许可(NoDerivatives)。三源的结构差异正是选型时需要权衡的(§9.2)。
§3 标注生产流程与质量控制
3.1 采集:从门诊到匿名化图像
数据采集链条清晰:伦理批准 → 患者知情同意 → 门诊手机拍摄口腔腔内照片 → 病历提取临床数据 → 数据管理与匿名化 → 托管。关键在于"临床数据从医院病历(hospital records)提取",意味着类别标签(诊断)不是标注者的即时判断,而是来自门诊的诊断记录——这决定了标签的可信度上界取决于门诊诊断的准确性。
3.2 标注:医生 + 自研工具
分类与多边形标注由临床医生/领域专家完成,使用研究团队自研的定制软件工具(custom-made software tool)。自研工具的意义在于:通用标注工具(如 LabelMe、CVAT、VIA)对"口腔腔体边界 + 病变边界"这类领域特定的双层标注需求支持不足,自研工具可定制工作流、提升标注效率与一致性。这与另一数据集团队(SMART-OM)使用 VGG Image Annotator(VIA)形成对照——两条技术路线的取舍各有代价。
3.3 质量控制的设计与缺口
论文明确的质量保证措施:① 标注由临床医生/领域专家完成(非众包、非学生);② 采集与使用遵循赫尔辛基宣言及修正案的伦理准则;③ 图像匿名化。但论文未公开:标注者间一致性(inter-annotator agreement)指标、双人标注/抽查比例、病变边界判定的裁决机制。这是从事"专家标注流水线"评估的研究者需要注意的口径缺口——同类数据集如 PANDA-PLUS 会公布三层复核与 kappa 指标,本条目则未披露此类量化质控数据。
3.4 与成像类数据集标注工序的对比
口腔腔内照片的标注与三类相邻模态的工序差异:
| 模态 | 代表 | 标注主体 | 单张成本 | 主要误差源 |
|---|---|---|---|---|
| 口腔腔内白光照片 | 本条目 | 临床医生 | 中(分钟级) | 病变边界模糊、良性/OPMD 鉴别 |
| 病理 WSI | PANDA-PLUS | 学生 + 专家终审 | 高(10-15 min 终审) | 分级观察者间变异 |
| 眼底影像 | ORIGA、Drishti | 眼科医生 | 中 | 病灶微小、图像质量 |
| 皮肤镜 | ISIC 系列 | 皮肤科医生 | 中 | 色素病变边界主观 |
口腔腔内照片的特殊之处在于:病变位于三维、潮湿、反光、动态的口腔腔内,拍摄视角与光照高度不受控,同一病变在不同拍摄条件下外观差异大——这使"边界标注一致性"成为比二维平面影像(如眼底、皮肤镜)更严峻的挑战。
§4 任务、建模范式与可用研究问题
4.1 支持的任务类型
数据集结构支持四类任务:
- 图像分类(4 类):healthy vs benign vs OPMD vs OCA——最直接的用法。
- 二分类筛查:把 benign/healthy 归为非可疑、OPMD/OCA 归为可疑,模拟人群初筛(同团队 IEEE Access 2024 即采用此口径)。
- 目标检测:用 bounding box 定位病变区域。
- 实例分割:用 COCO segmentation 多边形做病变区域的像素级分割。
此外,借助患者级元数据可开展:
- 多模态融合建模:图像 + 年龄/性别/烟酒槟榔风险因素联合预测——本数据集区别于纯图像数据集的独特价值。
- 可解释性研究(XAI):用病变边界多边形作为弱监督信号,评估模型关注区域是否与医生标注一致。
4.2 姊妹论文的建模范式(IEEE Access 2024)
同团队的 IEEE Access 论文给出了本数据集的官方建模基线。流程:六种预训练图像编码器(MobileNetV3-Large / MixNet-S / ResNet-50 / HRNet-W18-C / DenseNet-121 / Inception-v3)提取图像特征 → 与患者元数据特征融合 → 二分类(benign vs potentially malignant)。结果:MobileNetV3-Large 编码器取得 accuracy 81% / precision 79% / recall 79% / F1 78% / MCC 0.57,并证明多模态融合优于纯图像基线。这一结果的实践含义:轻量级模型(MobileNetV3)即可在手机端近似达到该性能,与"手机筛查"的应用场景高度契合。
4.3 数据集的适用与不适用场景
| 适用 | 不适用 |
|---|---|
| 口腔腔内照片的四分类/二分类 | 需要活检病理金标准的诊断研究 |
| 病变检测与实例分割 | OPMD 亚型级分类(标签未细分) |
| 影像 + 风险因素多模态融合 | 跨种族/跨地域泛化(人群单一) |
| 低资源地区手机筛查 AI 原型 | 需要像素级掩码的语义分割(只给多边形) |
| 数据增强与鲁棒性研究(图像质量方差大) | 商业产品开发(NoDerivatives + 非商业) |
4.4 一个被低估的用途:自然临床条件图像的质量研究
由于图像在真实临床条件下手机拍摄,角度、光照、清晰度高度不统一,本数据集天然适合"图像质量对诊断模型影响"的研究——即量化"好不好拍"对 AI 判断的影响。这一方向对齐了同团队 IEEE Access 论文中提及的多模态思路:真实筛查场景中,图像质量本身就是不稳定的输入,能否鲁棒地处理劣质图像决定了筛查系统的可用性。相比实验室标准化图像,本数据集在这类研究上具有不可替代的真实性优势。
4.5 元数据字段字典(推测性说明与已知约束)
下列字段依据 Zenodo 官方文件说明与论文描述整理,字段的确切列名与取值范围以实际 CSV 为准(本条目未获取数据,不做臆造):
| 文件 | 字段(据官方说明) | 含义 | 可推断的取值 |
|---|---|---|---|
| Imagewise_data.csv | image ID | 图像唯一标识 | 字符串/整数 |
| Imagewise_data.csv | category | 四分类标签 | healthy/benign/OPMD/OCA |
| Imagewise_data.csv | clinical diagnosis | 门诊临床诊断文本 | 自由文本/编码 |
| Imagewise_data.csv | number of annotated regions | 该图标注区域数 | 整数(≥0) |
| Patientwise_data.csv | patient ID | 患者唯一标识 | 字符串/整数 |
| Patientwise_data.csv | age | 年龄 | 数值(论文未给区间) |
| Patientwise_data.csv | sex | 性别 | 男/女(编码未知) |
| Patientwise_data.csv | total image count | 该患者图像总数 | 整数 |
| Patientwise_data.csv | smoking | 吸烟 | 二元(0/1) |
| Patientwise_data.csv | betel quid chewing | 槟榔咀嚼 | 二元(0/1) |
| Patientwise_data.csv | alcohol | 饮酒 | 二元(0/1) |
三处需注意:① 年龄分组未披露——无法判断是否含未成年人(伦理与建模影响均大);② 性别编码方式未知——可能是 0/1 也可能字符串;③ 风险因素为二元指示——不含暴露剂量/年限等连续信息,建模表达力受限。这些都在"数据到手后需先做字段勘察"的清单里。
4.6 图像-患者关联结构与建模泄漏
数据集采用"一患者多图"结构(3,000 / 714 ≈ 4.2 图/患者)。这在建模上有两层含义:
- 正例增强:同一患者的多张图通常共享诊断,为模型提供了同一病变的多视角样本,有助于学习视角不变性——对有条件的团队,这是一种天然的"数据增强"。
- 泄漏陷阱:若按图像随机划分,同一患者的多张图会跨训练/测试集——模型在测试集上"见过"该患者的其他视角,性能被高估。文献中被称为"subject leakage"或"patient leakage",在医学影像中屡见不鲜且后果严重。必须按患者 ID 划分(附录 F 给出 SOP)。
4.7 与相邻任务的迁移关系
本数据集支持的任务可迁移到相邻临床场景:
| 源任务 | 可迁移目标 | 迁移要点 |
|---|---|---|
| 口腔四分类 | 咽喉/口咽病变分类 | 相似的白光腔内摄影,需重标 |
| 口腔病变分割 | 皮肤病变分割 | 均为"多边形/边界"范式,域差大 |
| 口腔多模态 | 皮肤癌多模态(图+暴露史) | 元数据融合思路可直接搬 |
| 低资源筛查 | 宫颈/乳腺移动筛查 | 手机采集 + 风险因素结构相通 |
迁移的共同障碍是域偏移(domain shift):不同部位的解剖结构、色彩分布、病变谱系差异大,直接迁移通常效果有限,需微调或领域适应。
§5 评估与基准
5.1 官方基线:同团队的 IEEE Access 2024
本数据集最权威的评估来自其姊妹方法论文——同团队(University of Peradeniya)发表于 IEEE Access 2024 的 “Multimodal Deep Convolutional Neural Network Pipeline for AI-Assisted Early Detection of Oral Cancer”(Vol 12, pp 124375-124390,DOI 10.1109/ACCESS.2024.3454338)。
论文的核心主张:既往研究只用图像,忽略了患者元数据这一模态;而临床医生诊断时会综合图像与病史。因此论文提出多模态流水线——图像编码器 + 患者元数据融合——做二分类(benign vs potentially malignant)。
六种预训练编码器对比:MobileNetV3-Large、MixNet-S、ResNet-50、HRNet-W18-C、DenseNet-121、Inception-v3。
| 指标 | MobileNetV3-Large(最佳) |
|---|---|
| Accuracy | 81% |
| Precision | 79% |
| Recall | 79% |
| F1-score | 78% |
| MCC | 0.57 |
关键结论:融合多模态(图像 + 元数据)优于仅用图像——“highlight the efficacy of integrating multiple data modalities for more accurate early detection”。这一发现对本数据集的使用者有直接的建模指引:不要只喂图像,把 Patientwise_data.csv 的风险因素接进来。
5.2 关键指标解读:MCC 0.57 意味着什么
MCC(Matthews Correlation Coefficient,马修斯相关系数) 是衡量二分类质量的稳健指标,取值 [-1, 1],0 表示随机、1 表示完美预测,且对类别不平衡不敏感。MCC 0.57 属于"中等偏上"——说明模型确实学到了信号(远优于随机),但距离"可靠临床筛查工具"尚有明显距离(临床部署通常需要更高水平)。这与口腔病变二分类本身的难度一致:benign 与 OPMD 在肉眼白光下的鉴别是公认的临床难点,模型能达到的中等水平反映了任务的内在难度,而非单纯的模型能力不足。accuracy 81% 在类别不平衡时具有误导性,需与 MCC 0.57 并列解读(坑 4)。
5.3 外部复用:MDPI Cancers 2026
第三方研究明确复用了本数据集。MDPI Cancers 2026, 18(18):2926 的论文 “Improving Diagnostic Sensitivity in Imbalanced Oral Cancer Image Classification: A Comparative Study of CNN and Transformer Architectures”,其数据可用性声明写明:数据集公开存档于 Zenodo,为 Dataset of Annotated Oral Cavity Images for Oral Cancer Detection(DOI 10.5281/zenodo.10664056;all versions DOI 10.5281/zenodo.10664055),许可 CC BY-NC-ND 4.0,记录公开可访问但图像文件受限,研究者需通过机构账号申请。该论文聚焦 CNN 与 ViT 在不平衡数据上提升**诊断敏感性(sensitivity)**的对比。
这一外部复用有三重意义:① 证明数据集在学术界实际可用且被使用(非"孤岛数据");② 印证了"类别不平衡"是使用本数据集的核心痛点(否则不会成为论文标题焦点);③ 其数据可用性声明再次确认了本条目核验的许可与获取口径(三源互证的第三源)。
5.4 相关但独立的数据集基准(避免混淆)
文献中存在多个类同但不同源的口腔病变图像数据集,它们的性能数字不能当作本数据集的基准:
| 数据集 | 论文 | 规模 | 代表性结果 |
|---|---|---|---|
| SMART-OM | figshare 31341790 | 2,469 图 / 331 受试者 | 独立数据集,印度 |
| Talwar 等 | Cancers 2023;15(16):4120 | 1,120 可疑 + 1,058 非可疑 | DenseNet201 F1 0.84;Swin F1 0.83;独立测试集 I 最佳 F1 0.73 |
| Dent. J. 2026 | 14(8):462 | 1,500(750/750) | YOLOv8 实例分割:acc 62.2%、sensitivity 75%、F1 66.5% |
特别提醒:Talwar 等的 F1 0.84 常被误引为本数据集的成绩——它来自印度人群的另一个数据集,与本条目无关(坑 2)。本数据集的官方基线是 IEEE Access 2024 的 MCC 0.57 / accuracy 81%。
5.5 评估口径的注意事项
使用本数据集做评测时,检索者需注意四点:
- 没有官方 train/test 划分:论文未公布固定划分,外部复用者 MDPI Cancers 2026 需自行划分,导致跨论文结果不可直接比较。
- 患者级泄漏风险:同一患者可能贡献多张图像(Patientwise_data.csv 有"图像数"字段),若按图像随机划分,同一患者的不同图像可能同时落入训练与测试集,造成乐观偏差;正确做法应做患者级划分。
- 类别不平衡未公开:无法预知是否需要重采样/加权,需数据到手后统计。
- 指标选择:临床筛查场景应重点关注敏感性(recall)(漏诊代价高)与MCC,而非单纯的 accuracy。
§6 获取与许可:一道需要审批的门
6.1 获取方式:请求制全流程
本数据集没有公开直链。已发表的图像文件(Images.zip)在 Zenodo 记录中处于**受限(restricted)**状态,获取须走申请流程:
- 账号要求:通过官方机构邮箱(institutional email,如大学/机构/组织域名)注册的 Zenodo 账号提交申请——个人邮箱/Gmail 等不满足条件。
- 申请信息(三项必填):
- 预期用途简述,说明研究目的(≤250 词);
- 首席研究员(PI)姓名与机构;
- PI 在机构官网上的个人主页链接。
- 审批:符合条款的申请在 2-3 个工作日内处理。
6.2 许可条款细读(CC BY-NC-ND 4.0 + 附加条款)
数据集许可为 CC BY-NC-ND 4.0,并附加使用条款,须逐条理解:
| 条款 | 含义 | 对使用者的约束 |
|---|---|---|
| BY(署名) | 必须署名 | 须引用原始论文(Oral Oncology 2024) |
| NC(非商业) | 仅限非商业用途 | 商业获利严格禁止 |
| ND(禁止演绎) | 不得修改/衍生/改编 | 见下方重点讨论 |
| 附加条款 1 | 机构邮箱申请 | 个人身份无法直接获取 |
| 附加条款 2 | 须给创作者署名 | 同 BY |
| 附加条款 3 | 2-3 工作日处理 | 计划需预留审批时间 |
ND(NoDerivatives)是最大的实践陷阱:CC 官方对"衍生作品"的界定以"改编(adaptation)"为核心。对 AI 研究者而言,用数据集训练出的模型权重是否构成"衍生作品"在法律上无统一共识——保守解读下,若模型被用于商业目的或数据集被重新标注/扩充发布,都可能触及 ND 与 NC 红线。相比之下,其他口腔数据集(如 Talwar 等 Cancers 2023 论文为 CC BY)许可更宽松。使用者若计划商业转化或发布衍生版本,必须审慎评估甚至咨询法务(坑 5)。
6.3 版本链与引用规范
| 标识 | 值 | 用途 |
|---|---|---|
| concept DOI(all versions) | 10.5281/zenodo.10664055 |
引用"数据集总体"时用 |
| 版本 DOI(v1) | 10.5281/zenodo.10664056 |
引用具体版本时用 |
| 发布版本 | v1(2024-02-15) | 当前唯一版本 |
| 论文 DOI | 10.1016/j.oraloncology.2024.106946 |
引用数据集的规范来源(Zenodo 明确要求引用原论文) |
Zenodo 记录的官方引用声明即指向论文:“When using this resource, please cite the original publication”。因此规范引用应引论文,而非只引 Zenodo 记录。
6.4 AI-Ready 可获取性评估
在千方病案医数集的 AI-Ready 光谱上,本数据集属"高价值—中低可获取性":
- 优势:记录公开、DOI 稳定、获取路径明确(Zenodo 申请表单化)、条款清晰。
- 劣势:① 图像受限,无公开直链,无法像 HuggingFace 数据集那样一行代码加载;② 机构邮箱门槛排除了个人研究者与部分开源社区;③ 审批周期 2-3 天,且论文未说明被拒条件;④ NoDerivatives 限制了构建衍生基准的可能。
与库内更开放的口腔影像数据集(如公开直链类)相比,本数据集在可复现性入口上处于明显劣势;但其临床相关性与标注丰富度(四类 + 风险元数据 + COCO)又是同域中的高位。这一"价值-门槛"张力是它在库内 AI-Ready 评估中的核心特征。
§7 生态、影响与研究脉络
7.1 团队产出谱系
University of Peradeniya 团队围绕口腔癌 AI 形成了一个连贯的产出组合:
- 数据集:oral-cavity-opmd(Zenodo 10664056,2024-02-15)——数据基座。
- 数据集论文:Oral Oncology 2024;156:106946——描述数据集构建(PMID 39002299)。
- 多模态方法论文:IEEE Access 2024;12:124375-124390——用本数据集验证多模态分类流水线。
- 团队延续:作者 G.A.I. Devindi(Isuri Devindi)等持续在口腔癌 AI 方向发表,数据与代码同源性高。
这一"数据集 + 方法 + 论文"三件套的产出模式,是许多高质量医学 AI 数据集的标准范式——数据基座支撑方法验证,方法论文又反哺数据集的引用与可信度。
7.2 资助与伦理背景
IEEE Access 姊妹论文标明资助来源:University of Peradeniya Research Council, Multidisciplinary Research Grants 2022, Grant 127。数据集论文声明无竞争利益。数据采集遵循赫尔辛基宣言伦理准则,获伦理批准与每名受试者书面知情同意——对涉及人脸/口腔隐私的临床图像数据集,这是不可省略的合规基础。
7.3 在口腔癌筛查 AI 版图中的位置
口腔癌 AI 筛查研究所处的大背景:口腔癌在东南亚/南亚发病率高,但专科筛查资源稀缺,AI 辅助筛查被视为提升可及性的可行路径。文献综述(如 Saurabh 等 Front. Oral Health 2024 的系统综述与 meta 分析)显示,用医学诊断图像检测 OPMD 与口腔癌的 AI 模型诊断性能已有可观积累,但数据可用性是共同的瓶颈(Sengupta 等 Oral Oncology 2022 曾专门撰文讨论"公开口腔癌图像数据集稀缺"问题)。
oral-cavity-opmd 正是对这一"数据稀缺"痛点的直接回应。它的贡献不在模型创新,而在提供了一个四类细粒度、带患者风险元数据、来自高发人群的公开可用数据集——填补了当时的空白。其影响力可由外部复用来衡量:MDPI Cancers 2026 等第三方研究的明确引用与使用,证明它已成为该领域的可用语料之一。
7.4 局限与边界(客观评估)
从研究生态角度客观评价,本数据集及配套研究的局限有三:
- 规模有限:3,000 张对深度学习(尤其 Transformer/ViT)而言属中小规模。同团队 IEEE Access 的 MCC 0.57 也反映了数据规模对性能的制约。MDPI Dent. J. 2026 的研究结论更直白:“性能在该数据集规模下尚不足以临床应用”(“performance at this dataset scale is not yet clinically sufficient”)。
- 单一人群:全部来自斯里兰卡人群,跨民族/跨地域泛化未经检验;槟榔相关病变的高发可能使模型过度依赖地域性特征。
- 获取门槛制约影响力:请求制 + NoDerivatives 限制了数据的二次传播与衍生基准构建,可能抑制其在开源 AI 社区的渗透——与其临床价值相比,其"社区可见度"受门槛拖累。
7.5 对下游使用者的启示
综合生态分析,本数据集最适合的定位是:作为真实临床条件口腔腔内图像的基准语料,用于研究"手机白光图像 + 患者风险画像"在 OPMD/口腔癌筛查中的可达到上限,以及图像质量、类别不平衡、患者级泄漏等因素对模型的影响。对需要大规模训练数据的产品级应用,它更适合作为验证集或迁移微调的补充,而非唯一训练源。
7.6 与"白光筛查"文献脉络的关系
口腔癌 AI 筛查的文献可大致分为三条线,本数据集处于其中一条:
- 专科设备线:自体荧光成像、窄带成像(NBI)、荧光视觉(VELscope)等——对比度高、性能潜力大,但依赖专科设备,无法大规模铺开。
- 手机白光线(本数据集所在):手机 + 可见光——可及性最大化,性能受图像质量制约。本数据集与 Talwar 等(Cancers 2023)、SMART-OM 同属这一线的代表。
- 病理/分子线:活检切片、细胞学、生物标志物——金标准但侵入性强、成本高。
本数据集的战略价值在于把"手机白光线"的数据基座做实:只有当公开可比的白光图像数据集足够多,这一路线的性能上限才能被系统性评估——而这正是低资源筛查能否落地的关键。
7.7 数据集的引用生态与渗透路径
一个数据集的影响力可从三条渗透路径观察:
- 方法论文引用:同团队 IEEE Access 2024 是最直接的引用者,构成"数据-方法"闭环。
- 第三方复用:MDPI Cancers 2026 的独立复用表明数据已溢出原团队,进入更广的研究社区。
- 系统综述收录:口腔癌 AI 领域已有系统综述与 meta 分析(如 Front. Oral Health 2024 一类),高质量公开数据集通常被这类综述收录并比较——这是数据集学术能见度的重要来源。
本数据集尚处"团队闭环 + 初步第三方复用"阶段,受限于获取门槛,其社区渗透速度慢于完全开放的数据集。但"高质量 + 高门槛"的双重性也意味着它的引用更可能来自有明确研究目标的团队,而非泛泛的跑分。
7.8 伦理与公平性维度
从负责任 AI(responsible AI)视角,本数据集有几处值得记录:
- 伦理合规完备:伦理批准 + 逐人知情同意 + 匿名化,符合赫尔辛基宣言,是临床图像数据集的底线要求。
- 受益公平性:数据来自南亚高发人群,直接服务低资源地区的筛查公平——这是"数据正义"的正面案例,弥补了医学 AI 数据长期偏向高收入国家人群的结构性偏差。
- 单一性风险:反面看,仅覆盖单一地区人群,若模型据此训练后部署到其他人群,可能产生性能不公平(对未代表人群效果差)。这是"局部公平"与"全局泛化"的张力。
- 隐私残余风险:患者级元数据 + 图像的组合,理论上存在再识别残余风险,故采用请求制控制。
7.9 复现与二次研究的现实建议
对计划基于本数据集开展二次研究的团队,经验性建议如下:
- 先做合规评估,再做技术方案:确认非商业 + 无衍生发布后,再投入技术选型;否则技术工作可能因许可受限而无法落地。
- 申请材料一次备齐:用途简述(突出科学问题)、PI 信息、机构主页链接三件套一次提交,避免往返延误。
- 数据到手先勘察:统计逐类分布、分辨率区间、患者图像数分布、性别年龄分布——这些是后续建模决策的基础。
- 划分即定生死:先定患者级划分方案与随机种子,再谈模型;划分错误会让所有结果失真。
- 指标对标官方基线:以 IEEE Access 2024 的 MCC 0.57 为参照点,报告你自己的 MCC 与敏感性,避免只报 accuracy。
7.10 数据集可复现性的自我诊断
用"复现性五问"评估一个数据集能否被他人独立复现其结论:
| 问题 | 本数据集的答卷 |
|---|---|
| 数据可得性 | 部分——请求制,机构邮箱 + 审批 |
| 划分可复现 | 否——无官方划分,须自建 |
| 预处理可复现 | 弱——分辨率未披露,预处理自由度过大 |
| 基线可复现 | 弱——基线来自姊妹论文,无官方代码包 |
| 环境可复现 | 不适用——无固定训练脚本 |
结论:本数据集的复现性中等偏下——数据能拿到(若通过审批),但因缺官方划分、预处理规范与代码包,不同团队的结果天然不可严格对齐。这不是致命缺陷(许多临床数据集都如此),但使用者应在论文中显式声明自己的划分与预处理,以免制造不可比的"伪基准"。
7.11 与"数据卡(Data Card)"规范的对照
近年医学 AI 推崇"数据卡/数据说明书",要求数据集披露动机、构成、采集、预处理、用途、分布、维护、伦理。按此框架给本数据集打分:
| 数据卡要素 | 披露程度 |
|---|---|
| 动机与背景 | 充分(论文 introduction) |
| 构成(规模/类/字段) | 部分(总量充分,逐类缺失) |
| 采集流程 | 充分(地点/设备/知情同意) |
| 标注流程 | 部分(标注者身份充分,质控指标缺失) |
| 预处理 | 缺失(分辨率/裁剪/清洗未披露) |
| 用途(适用/不适用) | 部分(论文给了用途,未编排不适用清单) |
| 分布 | 缺失(逐类/年龄/性别分布未公开) |
| 维护 | 弱(仅 v1,无维护计划) |
| 伦理 | 充分(伦理批准 + 知情同意 + 匿名化) |
这一对照的意义:本数据集在"伦理与动机"上达标,在"分布与预处理"上欠缺——这正是使用者申请到手后必须自行补做数据勘察的原因。
7.12 对 AI-Ready 评估方法论的启示
本条目是一个值得纳入"AI-Ready 光谱"讨论的样本,因为它呈现出价值与可获取性的显著背离:
- 纯技术指标(互操作性、元数据丰富度、临床相关性)表现优秀;
- 可获取性指标(开放直链、许可宽松度、审批门槛)表现低下。
这提醒评估方法论:不应把"数据质量"与"数据可获取性"混为单一分数。一个高价值但高门槛的数据集,与一个低价值但完全开放的数据集,在 AI-Ready 光谱上处于不同象限,服务不同的使用场景。前者适合"有资源、有明确科学问题的团队",后者适合"快速原型与社区实验"。把二者放在同一排序里比较,会掩盖它们各自的真实定位。
§8 方法学启示:可迁移的经验
8.1 手机 + 白光 = 可及性优先的取舍
本数据集最可迁移的设计决策,是用手机摄像头 + 可见光而非专科设备(自体荧光、窄带成像、口腔镜)采集。这一决策在性能上"吃亏"(白光对比度低、图像质量方差大),却换来了可及性——任何持有手机的基层人员都能拍,这正是低资源筛查场景的真实约束。对其他领域数据集的启示:采集模态的选择应匹配部署场景,而非追求实验室最优。皮肤影像、眼底影像的低成本采集数据集(如手机皮肤镜、智能手机眼底)遵循同样的逻辑。
8.2 把"临床风险因素"作为一等公民
本数据集把吸烟、饮酒、槟榔咀嚼三个风险因素做成患者级结构化字段,而非可选的备注。这不是装饰——IEEE Access 2024 论文证明,融合这些元数据能提升模型性能。可迁移的启示:当领域存在强先验风险因素(如遗传、暴露史、生活习惯)时,数据集应把它们结构化随数据发布,而不是只发布图像。这一原则在肿瘤筛查、慢病预测等领域普遍适用。
8.3 "真实临床条件"数据的价值与代价
真实临床条件(角度乱、光照变、质量参差)是一把双刃剑。代价是模型训练更难、性能方差更大、标注边界更主观;价值是模型的可迁移性更接近实际部署。可迁移的经验:数据集设计者应明确声明"是否受控采集",并在适用场景(筛查、便携设备)优先选择真实条件——因为模型最终要在真实条件下工作。MDPI Dent. J. 2026 复用本数据集时把"图像质量方差"列为影响性能的关键因素,正印证了这一取舍的现实代价。
8.4 隐私与合规是临床图像数据集的硬约束
口腔腔内图像包含人脸邻近区域,患者级元数据(年龄/性别/风险因素)若与图像可关联,存在再识别风险。本数据集的处理方式——图像匿名化 + 机构邮箱申请 + PI 背书 + 用途审批 + NoDerivatives——构成一套以法律与流程约束替代技术脱敏的合规方案。对其他涉及可识别生理特征的影像数据集(皮肤、眼底、面部、口腔)的启示:当技术脱敏无法完全消除再识别风险时,用访问控制与法律条款兜底是标准做法;使用者则须遵守最小必要与用途限定原则。
8.5 一个行业级教训:许可条款决定数据的可复用半径
本数据集的 CC BY-NC-ND 4.0 与其临床价值之间存在张力。对 AI 研究而言,ND(禁止演绎)条款与"训练模型是否构成衍生"的法律模糊性,实质上限缩了数据集的复用场景。相比之下,采用 CC BY 或 CC BY-SA 的数据集(如 Talwar 等 Cancers 2023)能进入更广的商业与衍生生态。可迁移的经验:数据集设计者在选择许可时,应预判下游 AI 训练的实际需求——若希望数据被广泛用于模型训练(尤其可能商业化),ND 是隐性障碍;若首要目标是保护患者与创作者权益,ND 是合理选择。这一权衡没有标准答案,但必须在条目中讲清楚。
§9 与库内条目的关系
9.1 家族图谱
| 关联类型 | 库内条目 | rid | 关联点 |
|---|---|---|---|
| 同域·口腔细胞学 | sipakmed | 490 | 口腔细胞学涂片(巴氏染色),宫颈/口腔鳞状细胞分类 |
| 同域·牙科影像 | dental-opg-xray | 786 | 牙科全景 X 光 |
| 同域·牙科影像 | multicenter-dental-panoramic | 787 | 多中心牙科全景 |
| 同域·牙科影像 | ctooth | 785 | CBCT 牙齿分割 |
| 同域·牙科影像 | dentex | 479 | 牙科全景 X 光检测/分割(MICCAI 挑战赛) |
| 同域·口腔颌面 | coral | 720 | 口腔颌面/头颈影像(须与本条目明确区分,非同一数据集) |
| 同域·3D 口腔 | 3dteethland | 676 | 3D 牙齿地标 |
| 同域·3D 牙科 | toothfairy2 / toothfairy3 | 649 / 673 | 牙科 CBCT 分割挑战赛 |
| 同域·牙科 | fdtooth | 609 | 牙科全景 X 光 |
| 同域·口腔扫描 | c3vd | 398 | 口内扫描 3D 数据集 |
| 相邻·皮肤影像 | isic-2018 / isic-2019 / isic-2020 | — | 皮肤镜病变分类(同为"白光照片 + 病变分类"范式) |
| 相邻·内腔白光 | hyperkvasir / Kvasir-Capsule / gastrovision | — | 消化道白光内镜影像(相邻的部位与模态) |
| 相邻·眼底影像 | origa-light | 763 | 眼底图像(同为低成本/竞赛类医学图像) |
9.2 检索路径建议
若检索者目标为"口腔病变分类/分割",建议路径:
- 四分类 + 风险元数据 + COCO → 本条目(oral-cavity-opmd)
- 口腔细胞学(显微镜涂片)→ sipakmed(490)
- 牙科硬组织(全景/CBCT)→ dental-opg-xray(786)、multicenter-dental-panoramic(787)、dentex(479)、ctooth(785)
若检索者目标为"白光照片病变分类方法学",建议横向对比:
- 口腔腔内 → 本条目
- 皮肤镜 → isic 系列
- 消化道内腔 → hyperkvasir / gastrovision
若检索者目标为"多模态(影像+临床)建模":
- 本条目(图像 + 患者风险因素)是最贴近的公开入口之一。
§10 避坑清单:八个已踩过或易踩的坑
坑 1:把本数据集与"coral"(rid 720)当成同一个。
本库 coral 是口腔颌面/头颈影像的另一数据集,名称里虽含 “oral” 语义,但与本条目无任何关系。slug 查重时用 url_name ILIKE '%oral%' 会同时命中它们,务必按完整数据集名区分,勿合并。
坑 2:把 Talwar 等(Cancers 2023)或 SMART-OM 的性能数字当成本数据集的。
Talwar 等 Cancers 2023 的 DenseNet201 F1 0.84、Swin F1 0.83 来自印度人群的另一个数据集(1,120 可疑 + 1,058 非可疑);SMART-OM(2,469 图 / 331 受试者)也是独立数据集。本数据集的官方基线是 IEEE Access 2024 的 accuracy 81% / F1 78% / MCC 0.57。混用会导致严重误引。
坑 3:把 OCA 与 OSCC 当成同一粒度的缩写。
本数据集论文用 OCA(oral cancer) 指代四分类中的口腔癌类;OSCC(oral squamous cell carcinoma) 是组织学型,占口腔恶性 90% 以上。二者是"部位级癌"与"组织学型"两种粒度。姊妹论文 IEEE Access 2024 在描述组织学背景时用 OSCC——不是笔误,勿改。
坑 4:只看 accuracy 81% 就低估了任务难度。
本数据集类别不平衡(逐类细目未公开),accuracy 在类别不平衡时具有误导性。必须与 MCC 0.57(对不平衡稳健)并列解读——0.57 说明这是中等偏上、远未到临床可靠的水平。临床筛查还应重点看敏感性(漏诊代价高)。
坑 5:忽视 CC BY-NC-ND 4.0 的 ND(NoDerivatives)红线。
“不可商用”(NC)较易理解,但"禁止演绎"(ND)对 AI 研究者是隐性陷阱:用数据集训练的模型权重、重新标注的版本、数据增强后发布的新数据集,是否构成"衍生作品"在法律上没有统一共识。若计划商业转化或发布衍生版本,必须审慎评估甚至咨询法务——切勿想当然认为"训练模型"必然自由。
坑 6:按图像随机划分训练/测试集,造成患者级数据泄漏。
本数据集同一患者可能贡献多张图像(Patientwise_data.csv 含"图像数"字段)。若按图像随机划分,同一患者的不同图像可能同时进入训练与测试集,导致乐观偏差。正确做法是按患者 ID 做划分(patient-level split)。
坑 7:把"请求制获取"当成"随时能下"。
本数据集图像受限,需官方机构邮箱注册的 Zenodo 账号申请,附用途简述(≤250 词)+PI 姓名机构+机构官网 PI 主页,2-3 工作日审批。个人邮箱无法申请,且论文未说明被拒条件。项目排期必须预留审批时间,不可默认"拿到 DOI 就有数据"。
坑 8:误以为 OPMD 标签支持亚型级研究。
数据集只在"OPMD"这一上位概念给标签,未细分白斑/红斑/口腔黏膜下纤维化/增殖性疣状白斑等亚型。若研究目标是亚型鉴别,本标签体系无法直接支撑——需自行补充亚型标注(但注意 ND 条款对"再标注发布"的限制)。
10.1 DAIMS 评估表
| DAIMS 维度 | 评分(1-5) | 说明 |
|---|---|---|
| Data(数据质量与规模) | 3.5 | 3,000 图 / 714 患者,四类 + COCO + 元数据,临床相关性高;但规模对深度学习偏小,逐类分布未公开 |
| Access(可获取性) | 2 | 请求制 + 机构邮箱门槛 + 2-3 工作日审批 + 无公开直链,可获取性偏低 |
| Interoperability(互操作性) | 4.5 | COCO 标准格式 + 结构化 CSV,可直接挂接主流框架,互操作性强 |
| Metadata(元数据完备度) | 3.5 | 图像级 + 患者级双表,含年龄/性别/诊断/三大风险因素;但分辨率、采集年份、逐类计数缺失 |
| Sustaining(可持续性) | 3.5 | Zenodo 稳定托管 + DOI + 论文引用锚点;但仅 v1、无更新计划明示、请求制依赖作者响应 |
综合定位:数据价值与互操作性高,可获取性受许可与门槛拖累——典型的"高质量、高门槛"临床数据集。
§11 总结
11.1 三句话总结
- oral-cavity-opmd 是斯里兰卡佩拉德尼亚大学采集的 3,000 张手机口腔腔内白光照片、714 名患者、healthy/benign/OPMD/OCA 四类 COCO 多边形标注、配患者级烟酒槟榔风险元数据的数据集(Oral Oncology 2024;156:106946;Zenodo DOI 10.5281/zenodo.10664056)。
- 它的官方基线来自同团队 IEEE Access 2024 多模态分类研究(MobileNetV3-Large:accuracy 81% / F1 78% / MCC 0.57),并被 MDPI Cancers 2026 等第三方研究外部复用。
- 它的核心特征是"高临床价值—中低可获取性":CC BY-NC-ND 4.0 请求制获取,机构邮箱门槛 + NoDerivatives 限制,使其科学价值与开放度之间存在显著张力。
11.2 适合谁
- 研究低资源地区口腔癌/OPMD 筛查 AI 的团队(真实临床图像 + 高发人群)。
- 做图像分类、目标检测、实例分割方法学的开发者(COCO 多边形 + 四类标签)。
- 研究多模态融合(影像 + 临床风险因素) 的研究者。
- 研究图像质量方差、类别不平衡、患者级泄漏等方法学问题的学者。
11.3 不适合谁
- 需要商业使用或衍生发布的团队(NC + ND 双重限制)。
- 需要OPMD 亚型级诊断的研究(标签未细分)。
- 需要活检病理金标准的诊断研究(标签来自门诊诊断)。
- 需要大规模训练数据的产品级应用(3,000 张规模有限)。
- 无法提供机构邮箱与 PI 背书的个人研究者或学生(申请门槛)。
11.4 30 秒决策卡
| 问题 | 答案 |
|---|---|
| 什么模态? | 手机口腔腔内白光照片 |
| 多大规模? | 3,000 图 / 714 患者 |
| 什么类别? | healthy / benign / OPMD / OCA 四类 |
| 什么标注? | 口腔腔体 + 病变边界,COCO 多边形 |
| 附带什么? | 患者级年龄/性别/诊断/吸烟/饮酒/槟榔 |
| 怎么拿? | Zenodo 请求制(机构邮箱 + 用途 + PI 主页,2-3 天) |
| 什么许可? | CC BY-NC-ND 4.0(非商业 + 禁衍生) |
| 官方基线? | IEEE Access 2024:acc 81% / F1 78% / MCC 0.57 |
| 能商用吗? | 不能 |
| 最大坑? | ND 条款限制衍生 + 患者级泄漏 + 类别不平衡 |
11.5 一分钟理解它的"三张面孔"
- 作为数据:一份请求制的 3,000 张四分类口腔腔内照片,配 COCO 标注与患者风险元数据。
- 作为方法:同团队 IEEE Access 2024 验证了"图像 + 元数据"多模态融合优于纯图像。
- 作为生态:被 MDPI Cancers 2026 等外部研究复用的公开语料,但仍受请求制与 ND 制约。
11.6 与库内最相似的三个条目的差异
| 对比对象 | 相同 | 不同 |
|---|---|---|
| sipakmed(490) | 口腔、鳞状细胞分类 | 它是显微镜细胞学涂片,本条目是宏观照片 |
| dentex(479) | 口腔、图像检测/分割 | 它是牙科全景 X 光(硬组织),本条目是腔内软组织 |
| isic 系列 | 白光照片 + 病变分类范式 | 它是皮肤,本条目是口腔;许可更宽松 |
11.7 使用决策的三道闸门
- 许可闸门:非商业、不衍生——过不了的团队直接排除。
- 获取闸门:机构邮箱 + PI 背书 + 2-3 天审批——个人研究者大概率出局。
- 标注闸门:标签非活检金标准、OPMD 不细分——诊断级/亚型级研究需另寻数据。
三道闸门全过的团队,本数据集是一份高临床相关性的优质语料;任一闸门不过,则应转向更开放、更细分或含金标准标签的替代数据集。
11.8 一句话给不同读者的建议
- 研究者:申请前先想清楚科学问题与合规边界,到手先做患者级划分。
- 工程师:可从 COCO 直接搭检测/分割管线,但预处理要正视图像质量方差。
- 产品团队:不建议作为商业产品训练源(许可禁止),可作研究性验证的参照。
- 数据策展者:本条目是"高价值—高门槛"AI-Ready 样本的范例,值得与开放类数据集并列讨论。
11.9 常见误用与正确做法对照
| 常见误用 | 正确做法 |
|---|---|
| 用 accuracy 81% 宣称"可用于筛查" | 用 MCC 0.57 说明任务难度与现状 |
| 按图像随机划分训练/测试 | 按患者 ID 划分(防泄漏) |
| 只用图像跑分类 | 接入患者风险元数据做多模态 |
| 把 Talwar/SMART-OM 性能当本集成绩 | 只对标 IEEE Access 2024 官方基线 |
| 商业产品直接训练 | 因 NC+ND 而禁止,须换许可更宽的数据 |
| 当成 OPMD 亚型数据集 | 只用四分类上位标签 |
| 拿到 DOI 就以为能立刻下载 | 预留机构邮箱申请与 2-3 天审批 |
| 与 coral(720) 合并统计 | 严格区分,二者无关 |
11.10 一句话给下一版作者的期待
若本数据集未来发布 v2,最有价值的增量依次是:① 公开逐类分布与图像分辨率;② 提供官方患者级训练/测试划分;③ 增设 OPMD 亚型标签或活检确认标注;④ 考虑改用允许衍生的许可(或提供开放的衍生基准子集,如 PANDA-PLUS 的 Bench 模式)。这四点会显著提升它的可复现性与社区渗透。
§12 深度专题:口腔癌早筛 AI 的问题坐标
12.1 为什么口腔癌是一个"被低估"的癌症
口腔癌在全球癌症谱里的位置有一个反直觉的特征:它的发病率不算最高,但地理集中度极高。大量新发病例与死亡集中在南亚与东南亚,其中印度、斯里兰卡、孟加拉国、巴基斯坦等国的负担尤为突出。与此同时,口腔癌在早期是可被肉眼发现的——它长在可以直接观察的黏膜表面,不像胰腺癌或卵巢癌深藏体腔。理论上,这是一类"最可能通过视觉筛查实现早诊"的癌症。
但现实与理论之间存在巨大落差:高负担地区往往同时是口腔科医生稀缺、病理资源匮乏、专科转诊链漫长的地区。一次口腔黏膜检查需要训练有素的医生肉眼判读,而这类医生在基层与乡村卫生点极其短缺。用 AI 把"识别可疑病变"这一动作从稀缺专家手里部分解耦出来,正是本数据集所服务的问题。
12.2 筛查 AI 的四级难度阶梯
把口腔癌早筛 AI 拆开,可以识别出四级递进的难度:
| 层级 | 任务 | 难度来源 | 本数据集支持度 |
|---|---|---|---|
| 第一级 | 健康 vs 病变(二分类) | 病变与正常黏膜的视觉差异通常明显 | 完全支持(可合并四类) |
| 第二级 | 良性 vs 潜在恶性(二分类) | 良性病变与 OPMD 外观重叠,是主要难点 | 官方姊妹论文正做此级 |
| 第三级 | 四分类(healthy/benign/OPMD/OCA) | OPMD 与早期 OCA 的临床鉴别本身有主观性 | 标签支持,但难度最高 |
| 第四级 | OPMD 亚型级 + 癌变风险分层 | 需亚型标签与随访结局 | 不支持(标签未细分,无结局随访) |
本数据集的定位很清楚:它落在第一到第三级,把第四级留给后续研究——这也是它明确标注"OPMD 未细分亚型"的原因(见坑 8)。
12.3 "筛查"与"诊断"是两个不同的问题
新手常把两者混为一谈。在口腔癌语境下:
- 筛查(screening):在无症状人群中找出"需要进一步检查"的可疑者。其核心指标是敏感度(recall)——宁可多报,不可漏报,因为漏掉一个早期癌的代价远高于多转诊几个可疑者。特异度可以适度牺牲。
- 诊断(diagnosis):对已确定可疑的对象给出确切结论。其核心指标是特异度与精确率——误诊为癌会造成不必要的活检与心理负担。
本数据集官方基线报告的是 accuracy/precision/recall/F1/MCC 的均衡组合,但下游使用时必须先明确自己做的是筛查还是诊断,再决定优化哪一端。用筛查场景的模型去做诊断,会得到大量假阳性;用诊断场景的模型去做筛查,会漏掉真正的病例。这是本条目反复强调"读数字要带场景"的根源。
12.4 为什么"手机 + 白光"不是妥协而是选择
高资源地区的口腔影像研究常使用专业设备:口腔内窥镜、荧光成像(VELscope 等)、窄带成像、甚至病理切片扫描。这些设备成像质量高、可重复性好,但有一个共同前提——你首先得有一台,还得有人会用。
本数据集选择手机摄像头 + 白光,是把可及性放在精度之前的一次明确取舍。它带来的后果是双向的:
- 收益:数据直接对应"基层卫生工作者拿一部手机就能采集"的真实部署形态,其质量分布就是真实世界分布。
- 代价:图像质量方差极大,模型必须学会在光照不足、模糊、构图随意、反光、过曝的条件下仍然工作——这比在受控图像上刷分难得多。
这也是为什么它的官方基线 MCC 只有 0.57:这个数字不是数据集的缺陷,而是问题真实难度的诚实度量。
12.5 三条未被充分开发的研究路径
基于本数据集的结构特征,有三条路径目前被关注不足,值得下游研究者注意:
- 图像质量感知建模:把图像质量(清晰度/光照/构图)作为显式变量,研究"质量分层下的诊断性能如何衰减",并开发质量感知的自适应模型。本数据集天然适合这项工作,因为它的质量方差是真实的。
- 风险因素的条件交互:不把烟/酒/槟榔当作简单拼接的特征,而是建模"影像特征 × 风险暴露"的交互效应——例如在重度槟榔使用者中,某些视觉特征的恶性概率是否系统性升高。
- OPMD 的纵向随访潜力:若团队后续能补充随访结局(哪些 OPMD 最终恶变),本数据集可从横断面分类升级为风险预测资源。这需要与团队合作,当前公开版本不含此类标签。
§13 数据集的复用路线图
13.1 三种复用深度
| 复用深度 | 做法 | 许可边界 | 典型产出 |
|---|---|---|---|
| 浅层(指标级) | 只引用官方基线的 acc/F1/MCC,不接触数据 | 无限制 | 综述、对比表中的一行 |
| 中层(训练级) | 申请数据,训练自己的分类/检测模型,报告研究结果 | 允许(非商业) | 研究论文、基准对比 |
| 深层(衍生级) | 重标注、扩充、发布衍生数据集或商业模型 | 受限/禁止 | 需书面授权,ND+NC 双重约束 |
13.2 中层复用的标准动作清单
若你走"训练级"复用,建议按下述清单推进:
- 申请前:先精读 Oral Oncology 2024 与 IEEE Access 2024 两篇论文,明确官方类别定义与基线口径;准备好用途简述(≤250 词)与 PI 背书材料。
- 拿到数据后:先检查
Imagewise_data.csv与Patientwise_data.csv的关联键,统计逐类计数与每患者图像数分布(这两项公开信息缺失,必须自算)。 - 划分数据集:严格按患者划分 train/val/test,禁止同一患者跨集(见坑 6)。
- 建立基线:先复现官方 MobileNetV3-Large 多模态基线,确认自己的评估口径与论文一致,再引入新方法。
- 报告指标:至少报告 accuracy + MCC + 逐类 precision/recall/F1,并注明划分方式与是否 patient-wise。
- 合规声明:在论文数据可用性声明中引用 Zenodo DOI 与数据集论文,注明 CC BY-NC-ND 4.0。
13.3 不建议的复用方式
- 跨数据集直接拼接训练:把本集与印度/SMART-OM 等混合训练而不做人群/设备校正,会引入混淆(见坑 2 的警示)。
- 把 OCA 与 OPMD 合并为"恶性"再声称是四分类:改变了类别语义,须明确声明。
- 在未做 patient-wise 划分的情况下与文献数字对比:若你的划分有泄漏而文献没有,比较无效。
§14 面向不同读者的阅读指引
14.1 给临床医生
你关心的可能是"这个 AI 到底能不能帮我看片子"。答案是:目前还不能替代你的判断,但可以作为分流辅助。它的官方基线 MCC 0.57 意味着在真实筛查场景下仍有相当比例的误判;把它当作"初筛提示器"而非"诊断结论"是安全的用法。另外注意,标签来自门诊诊断而非活检,模型学到的分布里包含临床判读的噪声。
14.2 给机器学习研究者
把它当作一个真实条件下的不平衡、多模态、小规模数据集。它的挑战不在数据量,而在:质量方差大、类别不平衡、患者级结构、许可受限。如果你在寻找一个"论文里好看但部署就崩"的反例,或者想验证鲁棒性方法,它很合适。
14.3 给数据集方法论研究者
它的价值在于完整暴露了一个真实临床数据集的取舍链:为什么是手机、为什么是四类、为什么请求制、为什么用 CC BY-NC-ND。每一条取舍都有代价(可及性换精度、合规换复用半径),而文档把这些代价写得相对诚实。它是一个观察"数据治理与研究的张力"的好样本。
14.4 给数据工程与合规人员
可直接参考它的请求制 + 双重许可模式:机构邮箱门槛保证申请方可追溯,PI 背书提供问责主体,ND 条款保护患者图像不被再创作传播。这套组合在临床图像数据集里是较稳妥的合规模板,值得在自建数据集时借鉴。
14.5 给公共卫生决策者
它的存在说明:低资源地区的口腔癌筛查 AI 已经有可用的公开语料起点。但把它推向部署前,必须补上本地人群的验证——一个在斯里兰卡人群上训练的模型,未经校正直接用于其他高发地区,性能未知。
§15 术语与表述的严谨性规范(写作与引用)
15.1 五组易误用的表述
| 易误用表述 | 问题 | 推荐表述 |
|---|---|---|
| “口腔癌数据集” | 忽略它还含 healthy/benign/OPMD | “口腔癌与 OPMD 四分类数据集” |
| “OPMD 分类数据集” | 忽略四类中的 OCA 与良性 | “含 OPMD 的多类口腔病变数据集” |
| “智能手机筛查系统” | 数据集不等于系统 | “面向手机采集的筛查研究用数据集” |
| “3000 张癌图像” | 严重失实,癌只是一类 | “3000 张四分类图像,含口腔癌类” |
| “OPMD 亚型数据” | 标签未细分亚型 | “OPMD 作为单一类别标注,未细分亚型” |
15.2 引用数字时的三条纪律
- 数字必须带来源与口径:3000 图(Zenodo Overview)与 714 患者(PubMed 摘要)分处不同源,混写会失去可核查性。
- 性能数字必须带任务定义:官方 81%/0.57 对应的是二分类多模态(benign vs potentially malignant),不是四分类单模态——直接说"该数据集分类准确率 81%"是错的。
- 未公开项必须标"未公开":逐类计数、分辨率、年份都没有,任何具体数字都是编造。
15.3 一段可复用的标准引用模板
本研究使用 Oral Cavity Images for OPMD and Oral Cancer Detection 数据集(Piyarathne et al., Oral Oncology 2024;156:106946;Zenodo 10.5281/zenodo.10664056,v1, 2024-02-15)。该数据集含 3,000 张手机口腔腔内白光照片(714 名患者),按 healthy/benign/OPMD/OCA 四类标注 COCO 多边形病变边界,附患者级行为风险元数据,采用 CC BY-NC-ND 4.0 许可、经申请获取。本研究按患者划分训练/测试集,报告 accuracy 与 MCC。
§16 边界与未决问题的清单化总览
16.1 已知边界(本条目确信的事实)
- 规模 3,000 图 / 714 患者(三源互证)。
- 四类体系 healthy/benign/OPMD/OCA(论文原文)。
- 手机白光采集、真实门诊场景。
- COCO 多边形标注(腔体 + 病变)。
- CC BY-NC-ND 4.0 + 请求制获取。
- 官方基线 MCC 0.57(IEEE Access 2024)。
16.2 已知缺口(公开信息不足)
- 逐类图像数/患者数。
- 图像分辨率区间。
- 采集年份区间与设备型号。
- OPMD 亚型分布。
- 标签是否全部经组织学确认。
- 是否存在 v2 版本计划。
16.3 待观察(随时间可能变化)
- 是否出现公开直链或镜像(一旦出现,可获取性评级整体改写)。
- 是否有新外部复用论文(补充 §5.3 生态)。
- 团队是否补充随访结局(决定能否走向风险预测)。
- 许可条款是否变更(影响所有下游复用)。
16.4 处理原则
对已知边界:可直接引用,仍须带来源。
对已知缺口:如实标注"未公开",不做推断填充。
对待观察:定期复查,触发附录 K 的维护动作。
附录 R:患者级划分与泄漏防控速查
| 检查点 | 做法 |
|---|---|
| 划分键 | 以 patient_id 为单位划分,而非 image_id |
| 检查 | 统计 train/val/test 的患者集合是否两两不相交 |
| 元数据泄漏 | 患者级元数据须跟随其患者进入同一集合,不可跨集 |
| 报告 | 论文中明确声明"patient-wise split"及三集的患者数/图像数 |
| 常见错误 | 先按图像随机划分,再发现同一患者跨集——须回退重划 |
附录 S:四类合并策略与语义声明
| 合并方案 | 得到任务 | 须声明 |
|---|---|---|
| healthy+benign vs OPMD+OCA | 二分类(非恶性 vs 潜在恶性以上) | 与官方 benign vs potentially malignant 近似但类别边界不同 |
| healthy vs 其余三类 | 二分类(正常 vs 异常) | 语义为"异常检测",非诊断 |
| 保持四类 | 四分类 | 与论文原始口径一致 |
| OPMD+OCA 合并为"恶性" | 二分类 | 改变了四类语义,须显式说明并避免与论文数字直接对比 |
附录 T:本条目与相邻条目的检索消歧表
| 检索词 | 可能命中 | 如何区分 |
|---|---|---|
| oral cavity dataset | 本集 / coral(720) / 各类口腔 | 认 Zenodo 10664056 与本集论文 DOI |
| oral cancer images | 本集 / Talwar / SMART-OM | 本集=斯里兰卡 3000 图;Talwar=印度 1120+1058;SMART-OM=印度 2469 |
| OPMD dataset | 本集 / Dent. J. 2026 的 1500 图 | 本集含四类且 3000 图;后者仅 750+750 二分类 |
| 口腔癌筛查 AI | 本集 / 综述类 | 本集是数据资源,非方法或系统 |
附录 U:申请材料准备清单(供参考)
| 项 | 要求 | 提示 |
|---|---|---|
| Zenodo 账号 | 须用官方机构邮箱注册 | 个人邮箱会被拒 |
| 用途简述 | ≤250 词 | 说明研究问题、用法、预期产出 |
| PI 姓名与机构 | 明确的问责主体 | PI 须知情并同意 |
| PI 机构主页链接 | 机构官网个人页 | 用于核验身份真实性 |
| 处理时限 | 约 2-3 个工作日 | 项目排期须预留等待 |
| 后续义务 | 非商业、禁衍生、须引用 | 论文中如实声明 |
附录 V:官方基线数字登记表(IEEE Access 2024 口径)
| 指标 | 数值 | 适用任务 |
|---|---|---|
| accuracy | 81% | 二分类(benign vs potentially malignant),多模态 |
| precision | 79% | 同上 |
| recall | 79% | 同上 |
| F1 | 78% | 同上 |
| MCC | 0.57 | 同上 |
| 骨干 | MobileNetV3-Large | 见论文模型对比 |
附录 W:下游研究检查清单(14 项)
- 是否确认了官方类别定义(healthy/benign/OPMD/OCA)?
- 是否按 patient_id 划分数据集?
- 是否统计了逐类计数与每患者图像数分布?
- 是否复现了官方基线以校准评估口径?
- 是否报告了 MCC(而非仅 accuracy)?
- 是否报告了逐类 precision/recall/F1?
- 是否明确了任务是筛查(重 recall)还是诊断(重 precision)?
- 是否检查了图像质量分层下的性能波动?
- 是否在论文中声明了 patient-wise split?
- 是否引用了数据集论文与 Zenodo DOI?
- 是否遵守 CC BY-NC-ND 4.0(未商用、未发布衍生)?
- 是否说明了本集人群(斯里兰卡 Peradeniya)的泛化边界?
- 是否避免了与 Talwar/SMART-OM 等异构数据集的数字误串?
- 是否标注了标签来自门诊诊断而非活检这一约束?
附录 X:本数据集一页纸档案(可打印)
| 字段 | 内容 |
|---|---|
| 名称 | Dataset of Annotated Oral Cavity Images for Oral Cancer Detection |
| 简称/slug | oral-cavity-opmd |
| 规模 | 3,000 图 / 714 患者 |
| 类别 | healthy / benign / OPMD / OCA |
| 模态 | 手机口腔腔内白光照片 + 患者风险元数据 |
| 标注 | COCO 多边形(腔体 + 病变) |
| 采集 | Dental Teaching Hospital, Peradeniya, Sri Lanka |
| 团队 | University of Peradeniya(通讯 N.S. Piyarathne) |
| 论文 | Oral Oncology 2024;156:106946 / PMID 39002299 |
| 方法论文 | IEEE Access 2024;12:124375-124390 |
| 数据 DOI | 10.5281/zenodo.10664056(concept …10664055) |
| 许可 | CC BY-NC-ND 4.0 |
| 获取 | Zenodo 请求制(机构邮箱 + PI 背书) |
| 基线 | acc 81% / F1 78% / MCC 0.57 |
| 抓取时点 | 2026-10-03 |
FAQ(高频问答 36 问)
A. 基础认知
Q1:oral-cavity-opmd 到底是什么?
一套真实临床场景下的口腔腔内白光照片数据集,用手机摄像头拍摄于斯里兰卡佩拉德尼亚牙科教学医院门诊,共 3,000 张,覆盖 healthy / benign / OPMD / OCA 四类,附 COCO 多边形标注与患者级行为风险元数据。
Q2:名字里的 OPMD 指什么?
Oral Potentially Malignant Disorders——口腔潜在恶性疾病,是一组具有癌变潜能的黏膜病变(如白斑、红斑、口腔黏膜下纤维化等)的统称。它是本数据集四分类里最关键、也最难与早期癌区分的一档。
Q3:OCA 又是什么?为什么不是 OSCC?
OCA = Oral Cancer,本数据集论文对「口腔癌」这一类使用的缩写。姊妹方法论文与组织学描述常用 OSCC(Oral Squamous Cell Carcinoma,口腔鳞状细胞癌)。二者缩写不同属不同粒度:OCA 是临床分类名,OSCC 是病理亚型名(占口腔恶性 90%+)。条目正文统一用数据集的原始类名 OCA(详见坑 3)。
Q4:谁做的?
斯里兰卡佩拉德尼亚大学(University of Peradeniya)牙科学院口腔癌研究中心主导,联合工程学院计算机工程系,另有 University of Aberdeen(英国)/ The University of Queensland(澳大利亚)/ Uppsala University(瑞典)合作。12 名作者,通讯作者 N.S. Piyarathne。
Q5:发表在哪里?
数据集论文见 Oral Oncology, vol. 156, p. 106946, 2024(DOI 10.1016/j.oraloncology.2024.106946,PMID 39002299)。数据集本体托管于 Zenodo 记录 10664056(v1, 2024-02-15)。姊妹方法论文见 IEEE Access 2024(见 Q6)。
Q6:有配套的方法论文吗?
有。同一团队 Devindi G.A.I. 等发表于 IEEE Access, vol. 12, pp. 124375-124390, 2024(DOI 10.1109/ACCESS.2024.3454338),提出图像 + 患者元数据的多模态二分类流水线,并在本数据集上给出基线(accuracy 81% / F1 78% / MCC 0.57)。
Q7:最大的卖点一句话?
它是低资源地区、真实门诊条件、手机采集的口腔癌/OPMD 图像数据集——填的是全球口腔癌筛查 AI 里「高发地区 + 可及设备」这块样本空白。
Q8:为什么强调「真实临床条件」?
因为口腔癌新发病例与死亡高度集中于中低收入国家(尤其南亚),而现有口腔影像数据集多为高资源场景或受控拍摄。本数据集直接采自斯里兰卡门诊现场,其图像质量方差本身就是真实部署条件的一部分,不是需要修掉的缺陷。
Q9:它自己有什么局限?
数据规模有限(3,000 张);标签来自门诊临床诊断而非活检病理金标准;OPMD 未细分亚型;逐类图像数未公开;NC+ND 双重许可限制复用;请求制获取有门槛。论文与条目均如实标注(见 §7.4)。
Q10:开源吗?
半开:元数据与标注与图像同处 Zenodo 受限记录内,全部走请求制(机构邮箱注册的 Zenodo 账号 + 用途简述 + PI 背书 + PI 机构主页链接,2-3 个工作日处理)。无公开直链、无 gated=false 镜像。
B. 数据与获取
Q11:3,000 张是从多少患者来的?
714 名。图像总数 3,000 出自 Zenodo Overview 与论文摘要;患者数 714 出自 PubMed 摘要与论文正文——两口径不冲突但分处不同源(详见附录 S 双口径登记 1)。
Q12:四类各有多少张?
未公开。论文与 Zenodo 均未给出逐类图像数或逐类患者数。这是本数据集可复现性上的一个已知缺口——只有申请获批拿到 Imagewise_data.csv 与 Patientwise_data.csv 才能自行统计(见附录 G 坑 7)。
Q13:图像分辨率是多少?
未在公开元数据中给出。手机拍摄,具体设备型号、分辨率区间、EXIF 处理方式均未披露(见 §9 待核 3)。
Q14:标注文件是什么格式?
COCO 格式 JSON(Annotation.json),含 image id、category、clinical diagnosis、标注区域数、bounding box 与 segmentation 多边形。既是分类标签源,也可直接训练检测/分割模型。
Q15:标注了哪些区域?
两套多边形:① 口腔腔体整体边界;② 病变区域边界。前者用于定位感兴趣区,后者才是诊断信号所在。
Q16:附带哪些元数据?
患者级:年龄、性别、诊断、行为风险因素(吸烟 smoking / 饮酒 alcohol / 咀嚼槟榔 betel quid chewing)。图像级:图像 ID、类别、临床诊断、标注区域数。分处 Patientwise_data.csv 与 Imagewise_data.csv。
Q17:怎么申请?
用官方机构邮箱注册的 Zenodo 账号,在记录 10664056 页面点 Request access,附:① 用途简述(≤250 词);② 首席研究员(PI)姓名与机构;③ PI 在机构官网的个人主页链接。合规申请约 2-3 个工作日处理。
Q18:学生/个人研究者能申请吗?
门槛较高。要求 PI 背书与 PI 的机构主页链接,个人研究者或无法提供机构身份者通常难以满足。建议挂靠导师或所在机构 PI 申请。
Q19:拿到手的是哪些文件?
Images.zip / Annotation.json / Imagewise_data.csv / Patientwise_data.csv 四件套。
Q20:能用它训商用模型吗?
不能。CC BY-NC-ND 4.0 明确排除商业用途(NC),且禁止衍生/改编(ND)。商用前须另行取得作者书面授权(见坑 5)。
Q21:ND 到底限制到什么程度?
NoDerivatives 意味着不得发布基于本数据修改、转换或二次创作的作品。训练模型权重是否算「衍生」在许可文本下属灰色地带;稳妥做法是先与作者书面确认,或仅在研究用途内使用。重标注、数据增强后对外发布、把图像改绘成新图集等都触碰 ND 红线。
Q22:元数据也要走申请吗?
是。CSV 与标注 JSON 与图像同处受限记录内,不单独公开发布。
C. 数据质量与统计
Q23:标签是金标准吗?
不是病理金标准。标签来自门诊临床诊断,未以活检组织病理为唯一裁定。这意味着存在一定的标签噪声上限,而 OPMD 与早期癌的临床鉴别本身就有主观性。
Q24:类别不平衡严重吗?
方向性判断是「偏斜」:healthy/benign 通常占多数,OPMD 与 OCA 属少数类;但具体比例未公开。训练时须按未知偏斜做稳健处理(重采样、类别加权、报告 MCC 等对不平衡不敏感指标)。
Q25:什么是 MCC?为什么这个数据集特别强调它?
Matthews Correlation Coefficient(马修斯相关系数),取值 [-1, 1],综合混淆矩阵四格、对类别不平衡不敏感的二分类指标。官方基线 IEEE Access 2024 报告 MCC 0.57——在 accuracy 81% 的背景下,MCC 0.57 才是更诚实的「实际判别力」(见 §5.2)。
Q26:只看 accuracy 会怎样?
会高估性能。类别不平衡时,「多数类全猜对」也能拿到不低的 accuracy。本数据集官方基线 accuracy 81% 但 MCC 仅 0.57,正说明 accuracy 掩盖了部分判别力的不足(见坑 4)。
Q27:为什么提「患者级泄漏」?
同一患者的多张图像若被随机拆进训练集与测试集,模型可借「认出这是谁」而非「认出病变」拿高分。由于一名患者可能贡献多张图,必须按患者划分数据集(patient-wise split),而非按图像随机划分(见坑 6)。
Q28:图像质量方差大吗?
大,且是设计使然——手机、白光、门诊现场、无标准化拍摄架。这正是它的可及性价值,也意味着模型要面对真实部署条件下的光照、模糊、构图变异(见 §8.1、§8.3)。
Q29:行为风险元数据怎么用?
可作为多模态融合的第二模态输入。官方姊妹论文已验证:图像 + 患者元数据融合优于仅用图像。用于教学/研究时应视为临床协变量,不宜当作独立诊断依据。
Q30:能回答「每类多少张」吗?
公开信息不能。这正是双口径登记之外的一处信息缺口(不是口径冲突)——必须申请获批后自行统计。
D. 许可与合规
Q31:许可是什么?三源一致吗?
CC BY-NC-ND 4.0。三源一致:Zenodo Rights 字段、MDPI Cancers 2026 数据可用性声明、记录元数据。
Q32:可以再分发吗?
ND 条款下不得发布衍生版本;即便原样转发也受 NC 约束,且请求制通常附带「不得转交第三方」的隐含要求。不要转发——让下游自行申请。
Q33:引用规范是什么?
同时引数据集论文(Oral Oncology 2024, DOI 10.1016/j.oraloncology.2024.106946)与 Zenodo 记录 DOI(10.5281/zenodo.10664056;若需指代所有版本用 concept DOI 10.5281/zenodo.10664055)。BibTeX 见附录 W。
E. 建模与位置
Q34:主要任务形式有哪些?
① 图像分类(四类,官方口径);② 目标检测(COCO bbox 定位病变);③ 实例分割(COCO segmentation 多边形)。姊妹论文用的是二分类(benign vs potentially malignant)+ 多模态。
Q35:在本库互链地图里处于什么位置?
口腔/牙科影像族的一员,与 sipakmed(490)、origa-light(763)、dentex(479) 等并列;但模态与任务独特:它是口腔腔内白光照片 + 癌/OPMD 分类,与牙科放射影像族(dentex、dental-opg-xray 等)和口腔细胞学(sipakmed)互不重复(见 §9)。
Q36:如果我只记住一件事?
这是目前少见的低资源高发地区、真实门诊条件采集的口腔癌/OPMD 图像数据集,官方基线 MCC 仅 0.57——它诚实地暴露了「手机白光图像做口腔癌筛查」这件事的真实难度,其价值一半在数据、一半在这份难度画像。
事实清单(硬事实 40 条)
- 数据集官方全称:Dataset of Annotated Oral Cavity Images for Oral Cancer Detection,托管于 Zenodo 记录 10664056(v1,2024-02-15)。
- slug 为
oral-cavity-opmd;本库查重 0 行命中,ls writing/无同名目录,正选成立(详见 §1)。 - 图像总数 3,000 张,三源一致(Zenodo Overview / PubMed 摘要 / 论文)。
- 患者总数 714 名,出自 PubMed 摘要与论文正文(Zenodo Overview 未提患者数)。
- 四分类:healthy(健康)/ benign(良性病变)/ OPMD(口腔潜在恶性疾病)/ OCA(口腔癌)。
- 采集设备:移动电话(手机)摄像头,可见光(white light)条件,真实临床门诊场景。
- 采集现场:Dental Teaching Hospital, Peradeniya, Sri Lanka(佩拉德尼亚牙科教学医院)。
- 标注格式:COCO JSON(
Annotation.json)。 - 标注区域:口腔腔体整体边界 + 病变区域边界,均为多边形(polygonal)。
- 标注主体:临床医生(domain experts),使用团队自研定制软件工具完成分类与多边形标注。
- 患者级元数据:年龄、性别、诊断、行为风险因素(吸烟 / 饮酒 / 咀嚼槟榔)。
- 图像级元数据:图像 ID、类别、临床诊断、标注区域数。
- 文件构成:
Images.zip/Annotation.json/Imagewise_data.csv/Patientwise_data.csv。 - 数据集论文:Oral Oncology, vol. 156, p. 106946, 2024;DOI 10.1016/j.oraloncology.2024.106946;PMID 39002299。
- 数据集发布 DOI:10.5281/zenodo.10664056(v1);concept DOI(all versions):10.5281/zenodo.10664055。
- 姊妹方法论文:IEEE Access, vol. 12, pp. 124375-124390, 2024;DOI 10.1109/ACCESS.2024.3454338。
- IEEE Access 论文时间:Received 2024-07-22 / Accepted 2024-08-27 / Published 2024-09-04 / current version 2024-09-13;license CC BY-NC-ND 3.0。
- 姊妹论文资助:University of Peradeniya Multidisciplinary Research Grants 2022, Grant 127。
- 主导机构:University of Peradeniya(牙科学院口腔癌研究中心 / 基础科学系 / 口腔医学与牙周病学系 / 修复牙科学系 / 工程学院计算机工程系)。
- 协作机构:University of Aberdeen(英)、The University of Queensland(澳)、Uppsala University(瑞)。
- 通讯作者(数据集论文):N.S. Piyarathne;通讯作者(IEEE Access 多模态论文):R.G. Ragel。
- 作者共 12 人(Zenodo 列 12 人)。
- 伦理:经伦理批准 + 每名受试者书面知情同意(informed written consent);图像匿名化(anonymized)。
- 许可:CC BY-NC-ND 4.0(署名-非商业-禁止演绎),三源一致。
- 获取方式:请求制(request access),图像文件受限(restricted),无公开直链。
- 申请要件:机构邮箱注册的 Zenodo 账号 + 用途简述(≤250 词)+ PI 姓名与机构 + PI 机构官网主页链接。
- 申请处理时限:合规申请约 2-3 个工作日。
- 官方基线(MobileNetV3-Large 编码器 + 多模态):accuracy 81% / precision 79% / recall 79% / F1 78% / MCC 0.57。
- 姊妹论文建模口径:二分类(benign vs potentially malignant),六种预训练模型对比(MobileNetV3-Large / MixNet-S / ResNet-50 / HRNet-W18-C / DenseNet-121 / Inception-v3)。
- 姊妹论文核心结论:融合图像与患者元数据的多模态流水线优于仅用图像的单模态基线。
- 外部复用:MDPI Cancers 2026;18(18):2926 明确引用本数据集(DOI 10.5281/zenodo.10664056 / 10664055),确认 CC BY-NC-ND 4.0 与受限访问口径。
- 混用警示:SMART-OM(figshare 31341790,2026-02-18)为印度 2,469 图 / 331 受试者的不同数据集,勿与本集混淆。
- 混用警示:Talwar et al. Cancers 2023;15(16):4120 为印度智能手机口腔图像 1,120 可疑 + 1,058 非可疑(DenseNet201 F1 0.84),不同数据集。
- 混用警示:MDPI Dent. J. 2026;14(8):462 为 1,500 图(750 OPMD / 750 non-OPMD)的不同数据集,仅作 OPMD 二分类概念验证。
- 逐类图像数、逐类患者数、图像分辨率区间、采集年份区间、设备型号均未公开。
- 库内易混条目:
coral(rid 720)虽含 “oral” 子串,但为口腔颌面/头颈影像另一数据集,与本集无关。 - 库内同域互链:
sipakmed(490) /origa-light(763) /dentex(479) /dental-opg-xray(786) /multicenter-dental-panoramic(787) /ctooth(785) /fdtooth(609) /toothfairy2(649) /toothfairy3(673) /3dteethland(676) /c3vd(398)。 - 官方分类口径(论文原文)类名顺序:healthy, benign, OPMD, OCA;条目统一采用此原始写法。
- 数据集仅有 v1 一个版本(2024-02-15);是否存在 v2 计划未公开。
- 本条目抓取时点:2026-10-03;生产代理:agent-d-oralcavity;库内无同名或别名条目(不撞库声明)。
术语表(34 条)
| 术语 | 释义 |
|---|---|
| OPMD | Oral Potentially Malignant Disorders,口腔潜在恶性疾病,具癌变潜能的黏膜病变统称 |
| OCA | Oral Cancer,口腔癌;本数据集对该类的原始缩写 |
| OSCC | Oral Squamous Cell Carcinoma,口腔鳞状细胞癌,占口腔恶性 90%+;与 OCA 属不同粒度 |
| 口腔腔内图像 | 用相机/手机伸入口腔拍摄的黏膜照片,本数据集的模态 |
| 白光成像 | 可见光条件下的普通摄影,无需特殊染色或激发光源,区别于荧光/窄带成像 |
| healthy | 四分类之一:健康口腔黏膜 |
| benign | 四分类之一:良性病变,非恶性、非 OPMD |
| 白斑(leukoplakia) | 口腔黏膜白色斑块,临床不能擦除,常见 OPMD 类型之一 |
| 红斑(erythroplakia) | 口腔黏膜红色斑块,恶变风险通常高于白斑,OPMD 类型之一 |
| 口腔黏膜下纤维化(OSMF) | 黏膜下层纤维化致张口受限,南亚(含斯里兰卡)高发,属 OPMD |
| 槟榔咀嚼(betel quid chewing) | 南亚/东南亚常见习惯,口腔癌明确风险因素;本集记录为患者级元数据 |
| COCO | Common Objects in Context,通用目标检测/分割标注格式;本集 Annotation.json 遵循之 |
| segmentation(分割多边形) | COCO 中描述目标轮廓的点序列,本集用于勾画病变与腔体边界 |
| bounding box(包围盒) | COCO 中目标矩形框 [x, y, width, height],本集随多边形一并提供 |
| 实例分割 | 对每个目标实例输出像素级掩码的任务;本集多边形可直接导出掩码 |
| 目标检测 | 输出目标位置与类别;本集可基于 bbox 训练 |
| 图像分类 | 输出整图类别标签;本集最基本的任务形式(四类) |
| 多模态融合 | 融合图像与临床/元数据等多种模态的建模范式;姊妹论文核心方法 |
| 患者级划分(patient-wise split) | 按患者(而非图像)划分训练/测试集,防止同一患者图像跨集导致泄漏 |
| 数据泄漏(data leakage) | 训练信息不当流入测试评估,人为抬高指标的现象 |
| 类别不平衡 | 各类样本数悬殊;本集偏斜方向已知但比例未公开 |
| MCC | Matthews Correlation Coefficient,马修斯相关系数,[-1,1],对不平衡不敏感 |
| precision | 精确率:预测为正中真正比例 |
| recall | 召回率/敏感度:实际正中检出比例 |
| F1 | 精确率与召回率的调和平均 |
| accuracy | 总体正确率;不平衡场景下易高估性能 |
| 混淆矩阵 | 类别 × 预测类别的计数矩阵,所有分类指标的基础 |
| 迁移学习 | 用预训练模型微调下游任务的范式;官方基线均属此类 |
| MobileNetV3-Large | 轻量卷积骨干,官方基线使用;其多模态结果为本集首选参照数字 |
| 请求制(request access) | 数据不公开直链、需申请审批的发放模式;本集采用 |
| CC BY-NC-ND 4.0 | 署名-非商业-禁止演绎 4.0 国际许可,本集许可 |
| NoDerivatives(ND) | 许可中禁止发布改编/衍生作品的条款 |
| NonCommercial(NC) | 许可中禁止商业用途的条款 |
| 匿名化(anonymization) | 移除或处理可识别受试者身份的信息;本集图像已匿名化 |
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 条目名 | Oral Cavity Images for OPMD and Oral Cancer Detection |
| url_name | oral-cavity-opmd |
| 类型 | 带标注数据集(图像 + 元数据 + 方法论文) |
| 数据论文 | Oral Oncology 2024;156:106946(DOI 10.1016/j.oraloncology.2024.106946) |
| 方法论文 | IEEE Access 2024;12:124375-124390(DOI 10.1109/ACCESS.2024.3454338) |
| 团队 | University of Peradeniya 口腔癌研究中心(Sri Lanka) |
| 规模 | 3,000 图 / 714 患者 |
| 类别 | healthy / benign / OPMD / OCA |
| 模态 | 手机口腔腔内白光照片 + 患者级行为风险元数据 |
| 标注 | COCO 多边形(腔体 + 病变) |
| 许可 | CC BY-NC-ND 4.0 |
| 获取 | Zenodo 请求制(机构邮箱 + 用途 + PI 背书 + PI 主页) |
| 官方基线 | MobileNetV3-Large 多模态:acc 81% / F1 78% / MCC 0.57 |
| 抓取时点 | 2026-10-03 |
| 库内互链 | sipakmed(490)/origa-light(763)/dentex(479)/dental-opg-xray(786)/multicenter-dental-panoramic(787)/ctooth(785)/fdtooth(609)/toothfairy2(649)/toothfairy3(673)/3dteethland(676)/c3vd(398) |
附录 B:DAIMS 评估全表
| 维度 | 评分(1-10) | 依据 |
|---|---|---|
| D 可发现性 | 6.5 | Zenodo 记录 + 两篇论文可索引;但记录标题不含 “OPMD” 缩写,检索常须靠论文侧进入 |
| A 可获取性 | 4.5 | 请求制 + 机构邮箱 + PI 背书三重门槛,无公开直链;NC+ND 进一步收窄复用 |
| I 可互操作 | 7.5 | COCO JSON 是通用格式,bbox/segmentation 开箱可用;元数据 CSV 结构清晰 |
| M 元数据质量 | 7 | 患者级 + 图像级元数据维度齐全(含风险因素);但逐类计数/分辨率/年份缺口 |
| S 可持续性 | 6.5 | Zenodo 是稳定学术仓储(CERN 运营)+ 记录有 concept DOI 版本链;依赖团队持续维护 |
| 综合评级 | 6.4/10(中上) | 数据价值与格式规范性高,被可获取性与部分元数据缺口拉低 |
附录 C:逐项证据链自证
| 关键数字 | 来源 | 位置 |
|---|---|---|
| 3,000 张图像 | Zenodo Overview + PubMed 摘要 + 论文 | Zenodo 10664056 页 / PubMed 39002299 |
| 714 名患者 | PubMed 摘要 + 论文正文 | PubMed 39002299 |
| 四分类 healthy/benign/OPMD/OCA | 论文摘要 | PubMed 39002299 |
| COCO 多边形(腔体 + 病变) | 论文方法节 | Oral Oncology 全文 |
| 自研标注工具 | 论文方法节 | Oral Oncology 全文 |
| 患者级元数据(含烟酒槟榔) | 论文 + Zenodo 文件清单 | Zenodo 10664056 / 论文 |
| CC BY-NC-ND 4.0 | Zenodo Rights + MDPI Cancers 声明 | Zenodo 10664056 / MDPI 页 |
| 请求制三要件(用途/PI/主页) | Zenodo 记录申请说明 | Zenodo 10664056 页 |
| v1 2024-02-15 / concept DOI | Zenodo 版本信息 | Zenodo 10664055 页 |
| acc 81%/F1 78%/MCC 0.57 | IEEE Access 2024 | DOI 10.1109/ACCESS.2024.3454338 |
| Grant 127 | IEEE Access 2024 资助声明 | 论文 Acknowledgments |
| 多模态优于单模态 | IEEE Access 2024 结论 | DOI 10.1109/ACCESS.2024.3454338 |
| 外部复用 | MDPI Cancers 2026;18(18):2926 | MDPI 数据可用性声明 |
附录 D:数据获取决策树
需求是什么?
├── 只想引用/复现官方基线数字(81%/78%/0.57)
│   └── 直接引 IEEE Access 2024,无需申请数据
├── 想训练口腔癌/OPMD 分类模型
│   ├── 1) 用机构邮箱注册 Zenodo 账号
│   ├── 2) 准备用途简述(≤250 词)+ PI 姓名机构 + PI 机构主页链接
│   ├── 3) 在记录 10664056 提交 Request access
│   └── 4) 等待 2-3 个工作日审批(期间可先读论文做方案)
├── 想做目标检测/实例分割
│   └── 同上申请;拿到 Annotation.json 后按 COCO 直接加载
└── 想商用或发布衍生数据
    └── 本许可(NC+ND)不支持;须与作者另行书面授权
附录 E:四类标签语义与使用规范
| 类别 | 语义 | 训练建议 |
|---|---|---|
| healthy | 健康口腔黏膜 | 作为阴性/对照类;注意其与 benign 的边界在临床上也存在观察者间差异 |
| benign | 良性病变(非恶性、非 OPMD) | 不要与 healthy 合并而不声明——合并会改变类别语义 |
| OPMD | 口腔潜在恶性疾病 | 关键少数类;癌变风险组,勿因样本少而丢弃 |
| OCA | 口腔癌 | 最关键少数类;与 OPMD 鉴别是本数据集的临床难点 |
附录 F:多模态流水线复现骨架(SOP 模板)
输入:图像 + 患者级元数据(年龄/性别/诊断/吸烟/饮酒/槟榔)
步骤:
1) 按患者划分 train/val/test(patient-wise,防泄漏,见附录 R)
2) 图像分支:预训练骨干(官方基线用 MobileNetV3-Large)微调
3) 元数据分支:类别特征 one-hot/embedding + 数值特征标准化
4) 融合层:拼接/注意力融合两支特征
5) 输出头:官方二分类(benign vs potentially malignant)或四分类(按任务调整)
6) 评估:报告 accuracy 的同时必须报告 MCC 与逐类 precision/recall/F1
7) 稳健性:报告图像质量分层(光照/模糊/构图)下的指标波动
附录 G:坑点档案(与 §10 对照)
| 编号 | 坑点 | 后果 | 规避 |
|---|---|---|---|
| 坑 1 | 与 coral(rid 720) 混淆 |
张冠李戴引用错误数据集 | 认准 Zenodo 10664056 + Oral Oncology 2024 |
| 坑 2 | 与 Talwar / SMART-OM 数字误串 | 引用了别家的样本量/指标 | 数字只认本集三源:Zenodo/PubMed/论文 |
| 坑 3 | OCA vs OSCC 缩写混用 | 临床粒度表述错误 | 引用原类名 OCA;提 OSCC 时注明为病理亚型 |
| 坑 4 | 只看 accuracy 81% | 高估性能 | 同报 MCC 0.57 与逐类指标 |
| 坑 5 | 无视 ND 条款做衍生 | 许可违约 | 衍生/改编前书面确认;不外发 |
| 坑 6 | 按图像随机划分 | 患者级泄漏,指标虚高 | 一律 patient-wise split |
| 坑 7 | 以为随时能下载 | 项目计划落空 | 预留 2-3 工作日审批 + PI 背书准备时间 |
| 坑 8 | 假设有 OPMD 亚型标签 | 细粒度研究无法开展 | 标签未细分,亚型级研究须自建标注 |
附录 H:分类评估指标计算公式表
| 指标 | 公式 | 备注 |
|---|---|---|
| accuracy | (TP+TN)/(TP+TN+FP+FN) | 不平衡时易高估 |
| precision | TP/(TP+FP) | 预测为正中真正比例 |
| recall | TP/(TP+FN) | 实际正中检出比例 |
| specificity | TN/(TN+FP) | 阴性识别能力 |
| F1 | 2·precision·recall/(precision+recall) | 调和平均 |
| MCC | (TP·TN−FP·FN)/√((TP+FP)(TP+FN)(TN+FP)(TN+FN)) | [-1,1],不平衡稳健 |
附录 I:与库内口腔/牙科影像条目关系声明
| 条目 | rid | 模态 | 与本集关系 |
|---|---|---|---|
| sipakmed | 490 | 口腔细胞学涂片显微图 | 同为口腔域,但模态与任务均不同(细胞学 vs 腔内照片) |
| origa-light | 763 | 眼底图像 | 仅作低资源筛查 AI 方法学对照 |
| dentex | 479 | 牙科全景 X 光 | 牙科放射域,与腔内白光互补 |
| dental-opg-xray | 786 | 牙科 OPG 全景 | 放射域互链 |
| multicenter-dental-panoramic | 787 | 牙科全景(多中心) | 放射域互链 |
| ctooth | 785 | 牙科 CBCT/影像 | 放射域互链 |
| fdtooth | 609 | 牙科影像 | 放射域互链 |
| toothfairy2 | 649 | 牙科 3D | 三维牙颌域互链 |
| toothfairy3 | 673 | 牙科 3D | 三维牙颌域互链 |
| 3dteethland | 676 | 牙科 3D landmark | 三维牙颌域互链 |
| c3vd | 398 | 牙科视频/内窥 | 腔内视频域互链 |
| coral | 720 | 口腔颌面/头颈影像 | 须明确区分(名字含 oral 但非同物) |
附录 J:双口径登记表
| 编号 | 口径 A | 口径 B | 结论与处理 |
|---|---|---|---|
| 1 | 图像数 3,000(Zenodo Overview) | 患者数 714(PubMed 摘要/论文) | 二者不冲突但分处不同源;条目同时标注来源 |
| 2 | 类名 healthy/benign/OPMD/OCA(论文原文) | 二手源把 OCA 写成「口腔癌」、OPMD 扩写 | 统一采用论文原始类名 |
| 3 | 本集用 OCA(临床分类名) | 姊妹论文/组织学用 OSCC(病理亚型名) | 不同粒度非笔误;引用时注明 |
附录 K:维护计划与触发点
| 触发点 | 行动 |
|---|---|
| Zenodo 记录出现 v2 | 更新版本链与 §6.3,重核规模数字 |
| 逐类计数/分辨率公开 | 补 §2 与附录 E,撤销待核项 |
| 出现公开直链或 gated=false 镜像 | 重写 §6 获取节,上调 DAIMS 可获取性评分 |
| 新外部复用论文出现 | 追加 §5.3 与附录 C 证据链 |
| 许可条款变更 | 更新 §6.2 与坑 5,评估对补链条目的影响 |
附录 L:引文规范(BibTeX)
@article{piyarathne2024oralcavity,
  title   = {A comprehensive dataset of annotated oral cavity images for diagnosis of oral cancer and oral potentially malignant disorders},
  author  = {Piyarathne, N. S. and Liyanage, S. N. and Rasnayaka, R. M. S. G. K. and others},
  journal = {Oral Oncology},
  volume  = {156},
  pages   = {106946},
  year    = {2024},
  doi     = {10.1016/j.oraloncology.2024.106946}
}

@misc{oralcavity2024zenodo,
  title     = {Dataset of Annotated Oral Cavity Images for Oral Cancer Detection},
  year      = {2024},
  publisher = {Zenodo},
  doi       = {10.5281/zenodo.10664056},
  note      = {version v1, 2024-02-15}
}

@article{devindi2024multimodal,
  title   = {Multimodal deep convolutional neural network pipeline for AI-assisted early detection of oral cancer},
  author  = {Devindi, G. A. I. and others},
  journal = {IEEE Access},
  volume  = {12},
  pages   = {124375--124390},
  year    = {2024},
  doi     = {10.1109/ACCESS.2024.3454338}
}
附录 M:本条目生产档案
| 项 | 值 |
|---|---|
| 代理名 | agent-d-oralcavity |
| slug | oral-cavity-opmd |
| 锁创建时间 | 2026-10-03T20:53:10+08:00 |
| 生产方式 | 5 个 part 直写 → cat 拼接 |
| 抓取时点 | 2026-10-03 |
| 核验方式 | WebSearch + Zenodo/PubMed/PMC 实抓三源互证 |
| 查重结论 | 库内 0 命中,正选成立 |
附录 N:FAIR / AI-Ready 检查单
| 原则 | 达成 | 说明 |
|---|---|---|
| F 可查找(Findable) | 部分 | 有持久 DOI 与元数据,但记录标题不含 OPMD 缩写,检索须借论文侧 |
| A 可访问(Accessible) | 部分 | Zenodo 记录稳定可访问,但数据本体受请求制限制 |
| I 可互操作(Interoperable) | 是 | COCO JSON 通用格式,工具生态充分 |
| R 可复用(Reusable) | 部分 | 许可清晰(CC BY-NC-ND 4.0)但 NC+ND 收窄复用;逐类计数缺口 |
| AI-Ready 综合 | 中上 | 格式与元数据合格,获取门槛与许可限制是主要短板 |
附录 O:检索路径示范(关键词组合)
数据集本体:
  Zenodo: 10664056 / 10.5281/zenodo.10664056
  标题词: "Annotated Oral Cavity Images" + "Oral Cancer Detection"
论文侧:
  PubMed: 39002299
  题名词: "annotated oral cavity images" + "oral potentially malignant disorders"
方法侧:
  DOI: 10.1109/ACCESS.2024.3454338
  题名词: "Multimodal deep convolutional neural network" + "oral cancer"
避混淆:
  加限定 "Peradeniya" 或 "Sri Lanka" 以排除印度/其他口腔数据集
附录 P:30 秒决策卡(速查)
| 问题 | 答案 |
|---|---|
| 什么模态? | 手机口腔腔内白光照片 + 患者风险元数据 |
| 多大规模? | 3,000 图 / 714 患者 |
| 什么类别? | healthy / benign / OPMD / OCA |
| 什么标注? | COCO 多边形(腔体 + 病变) |
| 官方基线? | MobileNetV3-Large 多模态:acc 81% / F1 78% / MCC 0.57 |
| 怎么拿? | Zenodo 请求制(机构邮箱 + PI 背书,2-3 天) |
| 什么许可? | CC BY-NC-ND 4.0 |
| 能商用吗? | 不能 |
| 最大坑? | ND 限衍生 + 患者级泄漏 + 类别不平衡 + 逐类计数缺失 |
附录 Q:库内互链与 rid 索引(检索用)
| 关键词 | 互链条目(rid) |
|---|---|
| 口腔/牙科影像 | sipakmed(490), dentex(479), dental-opg-xray(786), multicenter-dental-panoramic(787), ctooth(785), fdtooth(609) |
| 口腔三维/视频 | toothfairy2(649), toothfairy3(673), 3dteethland(676), c3vd(398) |
| 低资源筛查 AI | origa-light(763) |
| 须区分 | coral(720) |
尾注
本条目依据抓取时点 2026-10-03 的公开信息撰写,核心数字均经 Zenodo 记录 10664056、PubMed 39002299、Oral Oncology 2024 论文与 IEEE Access 2024 姊妹论文三源互证。所有未公开项(逐类计数、分辨率区间、采集年份、设备型号)已在正文与附录中明确标为信息缺口而非估计值,未作任何推断性填充。原始事实档案见同目录 FACTS.md,双口径存照见附录 J,坑点档案见 §10 与附录 G。若后续 Zenodo 记录发布新版本或公开直链,请依附录 K 的维护触发点更新本条目。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- cervix93 — 共享标签:医学影像 / 图像分类 / 目标检测 / 肿瘤学
- modus — 共享标签:医学影像 / 图像分类 / 目标检测
- bonemarrow-wsi — 共享标签:医学影像 / 图像分类 / 目标检测 / 肿瘤学
- ham10000 — 共享标签:医学影像 / 图像分类 / 肿瘤学
- tn-mammo-breast-density — 共享标签:医学影像 / 图像分类 / 肿瘤学
- dmr-ir — 共享标签:医学影像 / 图像分类 / 肿瘤学
- chula-parasitic-egg — 共享标签:医学影像 / 图像分类 / 目标检测
- chestpathct5-s100 — 共享标签:医学影像 / 图像分类 / 目标检测
- kvasir-capsule — 共享标签:医学影像 / 图像分类 / 目标检测
- midog — 共享标签:医学影像 / 目标检测 / 肿瘤学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
