用于结核病状态分类的标准血液转录组数据集(ATB、LTB、CON、OD)
该数据集收录了用于结核病状态分类的标准化血液转录组数据及源文件,支撑跨队列的机器学习分类器与已发表结核病基因面板基准评测
基本信息
资源简介
用于结核病状态分类的标准血液转录组数据集(ATB、LTB、CON、OD)
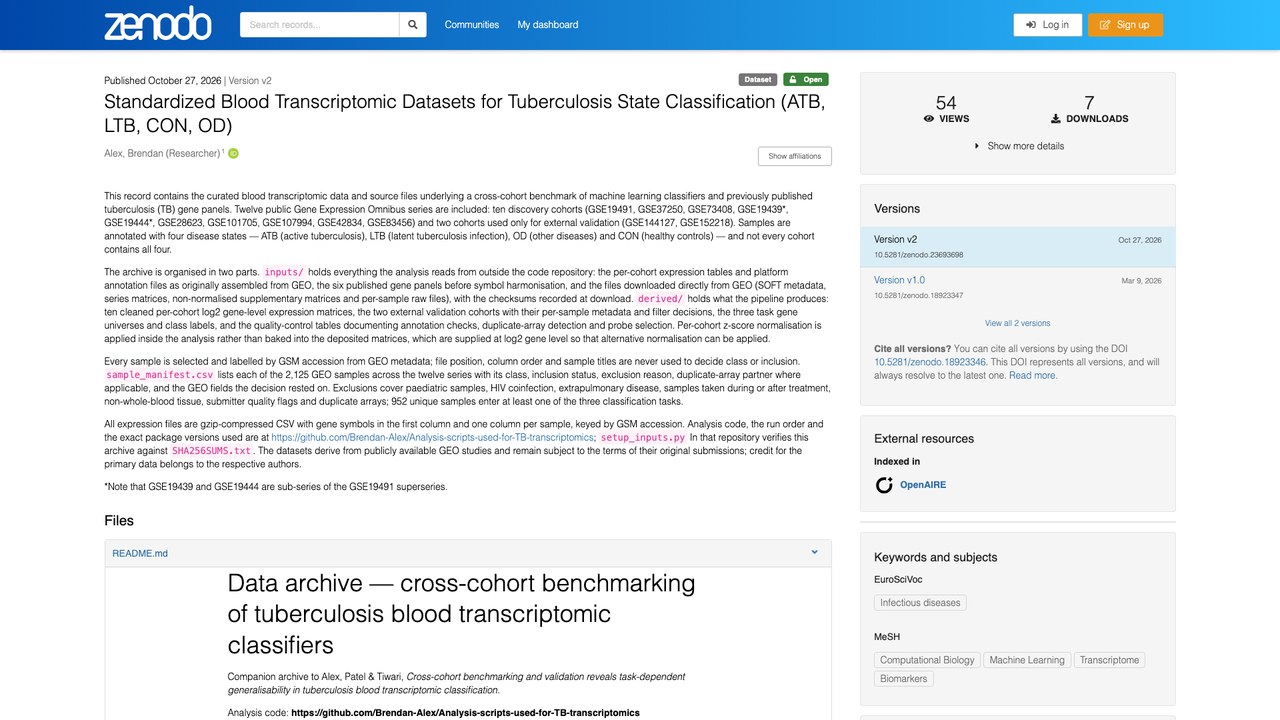
Standardized Blood Transcriptomic Datasets for Tuberculosis State Classification (ATB, LTB, CON, OD)
该数据集收录了用于结核病状态分类的标准化血液转录组数据及源文件,支撑跨队列的机器学习分类器与已发表结核病基因面板基准评测。数据涵盖12个公共Gene Expression Omnibus系列,其中10个为发现队列、2个仅用于外部验证,样本按ATB、LTB、OD、CON四种疾病状态注释,并非每个队列都包含全部四类。数据可用于训练和评估结核病状态分类模型、比较基因面板表现及开展跨队列验证研究(来源 DOI 解析,Creative Commons Attribution 4.0 International 许可)。
【数据集背景】
源站首次发布:2026。
【数据内容】
源站描述(机器翻译,仅供参考):该记录包含经过整理的血液转录组数据及源文件,这些数据支撑了一项针对机器学习分类器和既往已发表结核病(TB)基因面板的跨队列基准评测。记录纳入12个公共Gene Expression Omnibus系列:10个发现队列(GSE19491、GSE37250、GSE73408、GSE19439、GSE19444、GSE28623、GSE101705、GSE107994、GSE42834、GSE83456)和2个仅用于外部验证的队列(GSE144127、GSE152218)。样本按四种疾病状态注释——ATB(活动性结核)、LTB(潜伏性结核感染)、OD(其他疾病)和CON(健康对照)——并非每个队列都包含全部四种状态。该存档分为两部分。inputs/ 存放分析从代码仓库之外读取的所有内容:按队列整理的表达表,以及最初从GEO汇编的平台注释文件,六个已发表的基因p
【主题与分类】
主题标签:Computational Biology、Infectious diseases、Machine Learning、Transcriptome、Biomarkers。本站分类:呼吸系统疾病/肺结核。
【获取与许可】
源站页面:https://zenodo.org/doi/10.5281/zenodo.18923346
使用许可:Creative Commons Attribution 4.0 International。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://doi.org/10.5281/zenodo.18923346
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据集大小约 1.15 GB。
数据说明
本记录包含经过整理的血转录组数据及源文件,这些数据支撑了机器学习分类器与先前发表的结核病(TB)基因面板的跨队列基准测试。其中包括十二个公开的基因表达综合数据库系列:十个发现队列(GSE19491、GSE37250、GSE73408、GSE19439*、GSE19444*、GSE28623、GSE101705、GSE107994、GSE42834、GSE83456)以及仅用于外部验证的两个队列(GSE144127、GSE152218)。样本标注了四种疾病状态——ATB(活动性结核)、LTB(潜伏性结核感染)、OD(其他疾病)和CON(健康对照)——并非每个队列都包含所有四种状态。档案分为两部分。inputs/ 存放分析从代码仓库外部读取的所有内容:最初从GEO汇编的各队列表达表与平台注释文件、符号统一前的六个已发表基因面板,以及直接从GEO下载的文件(SOFT元数据、系列矩阵、非标准化补充矩阵及每样本原始文件),并记录了下载时的校验和。
derived/ 目录存放流水线生成的内容:十份经清洗的各队列 log2 基因水平表达矩阵、两个外部验证队列及其每样本元数据和过滤决策、三个任务基因全集与类别标签,以及记录注释检查、重复芯片检测和探针选择的质量控制表。各队列的 z-score 标准化在分析内部应用,而非固化到存档矩阵中;存档矩阵以 log2 基因水平提供,以便应用其他标准化方法。每个样本均依据 GEO 元数据中的 GSM 登录号进行选择和标注;文件位置、列顺序和样本标题从不用于决定类别或纳入。sample_manifest.csv 列出了十二个系列中全部 2,125 个 GEO 样本及其类别、纳入状态、排除原因、重复芯片配对(如适用)
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。