肿瘤生物信息学中公共数据集复用可识别性:复现包
该复现包是一项元研究(meta-research)的完整复现材料,研究论文的书目元数据能携带多少关于其分析数据的信息。研究以 Europe PMC 为抽样框,纳入 2024 年 MEDLINE 收录、标题或摘要提及癌症术语及公共数据库(TCGA、GEO、GSE)的原创研究,共 5,744 条记录;固
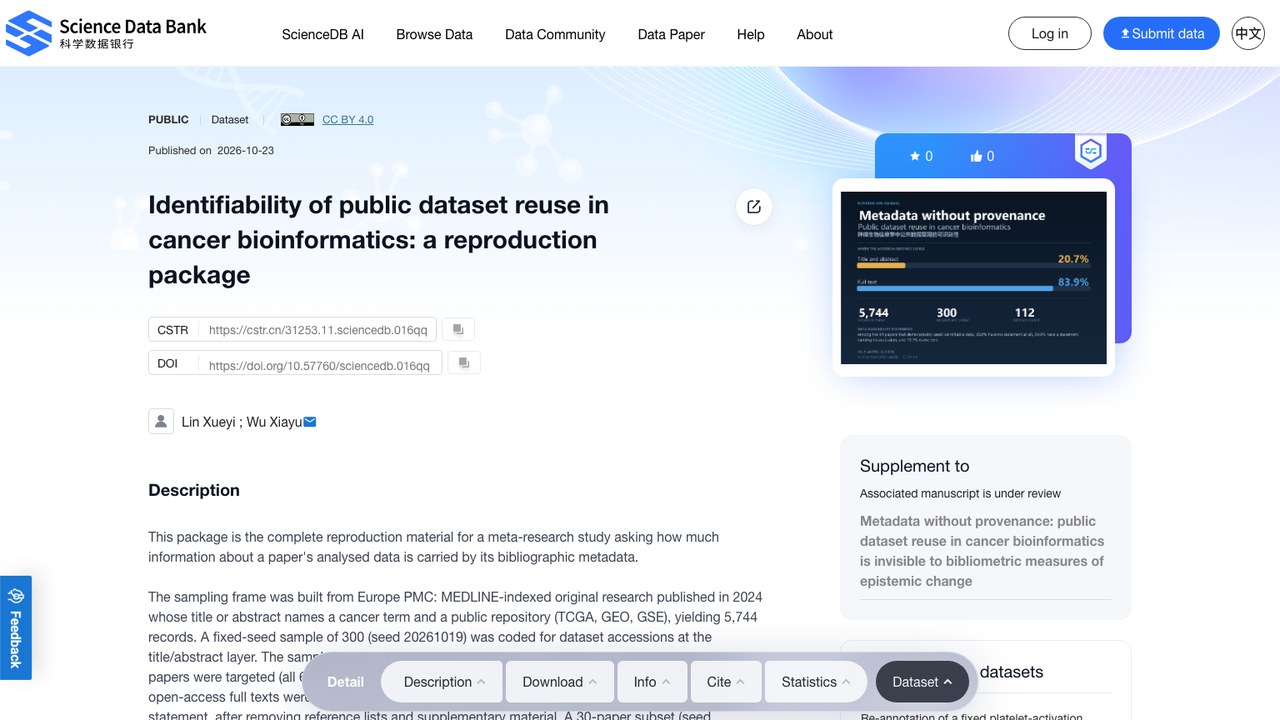
基本信息
资源简介
肿瘤生物信息学中公共数据集复用可识别性:复现包
Identifiability of public dataset reuse in cancer bioinformatics: a reproduction package
该复现包是一项元研究(meta-research)的完整复现材料,研究论文的书目元数据能携带多少关于其分析数据的信息。研究以 Europe PMC 为抽样框,纳入 2024 年 MEDLINE 收录、标题或摘要提及癌症术语及公共数据库(TCGA、GEO、GSE)的原创研究,共 5,744 条记录;固定种子抽取 300 篇在标题/摘要层编码数据集登录号,再按是否报告登录号分层,目标 162 篇(全部 62 篇报告者加 100 篇随机非报告者),获取 112 篇开放获取全文并编码正文与数据可用性声明中的登录号,另对 30 篇子集进行语义阅读。可用于研究数据复用可识别性与可复现性(来源 DOI 解析,Creative Commons At。
【数据集背景】
源站首次发布:2026。
【数据内容】
源站描述(机器翻译,仅供参考):该包是一项元研究的完整复现材料,该研究探讨论文的书目元数据能携带多少关于其分析数据的信息。抽样框基于 Europe PMC 构建:2024 年发表的 MEDLINE 收录原创研究,其标题或摘要提及癌症术语和公共存储库(TCGA、GEO、GSE),共获得 5,744 条记录。以固定种子抽取 300 篇样本(种子 20261019),在标题/摘要层面对数据集登录号进行编码。随后按是否报告登录号对样本分层,目标为 162 篇论文(全部 62 篇报告者加 100 篇随机抽取的非报告者,种子 20261020);检索到 112 篇开放获取全文,在去除参考文献列表和补充材料后,对正文和数据可用性声明中的登录号进行编码。一个 30 篇论文的子集(种子 20261021)被语义阅读以进行验证。
【主题与分类】
主题标签:Library, information and philology、data availability statement、data provenance、bibliographic metadata、reproducibility、meta-research、cancer bioinformatics、Gene Expression Omnibus、TCGA。本站分类:肿瘤。
【获取与许可】
源站页面:https://www.scidb.cn/detail?dataSetId=5b62afe194124b6daf1ac869d3b88d40
使用许可:Creative Commons Attribution 4.0 International。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://doi.org/10.57760/sciencedb.016qq
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
本包是一项元研究研究的完整复现材料,该研究旨在探究一篇论文的书目元数据能携带多少关于其分析数据的信息。抽样框基于Europe PMC构建:纳入2024年发表的、被MEDLINE索引的原创研究,其标题或摘要中提及癌症术语及公共数据仓库(TCGA、GEO、GSE),共获得5,744条记录。以固定种子抽取300篇样本(种子20261019),在标题/摘要层面编码数据集登录号。随后根据是否报告登录号对样本进行分层,锁定162篇论文(全部62篇报告者加上100篇随机抽取的非报告者,种子20261020);在剔除参考文献列表和补充材料后,获取112篇开放获取全文,并对其正文及数据可用性声明中的登录号进行编码。另以30篇论文子集(种子20261021)进行语义阅读,以验证自动化编码。主要发现:在元数据层面,仅20.7%(62/300)报告了可识别的登录号;全文层面达到83.9%(94/112),且72.3%(47/65)的摘要层面非报告者在正文中提供了登录号。
在94篇可明确证明使用了可识别数据的论文中,30.9%没有数据可用性声明,50.0%的声明未指明任何数据集,仅有19.1%的声明指明了一个数据集。包内容:帧标识符列表、含编码的300篇论文样本、含检索结果的分层子样本、112篇全文的权威逐篇编码、30篇论文的人工判定、所有提取与分析脚本、定义每个变量的代码本、SHA-256清单、许可证,以及三个独立的审计脚本,用JavaScript重新推导所有报告的统计量和置信区间。出于版权原因,出版商全文不再分发;其PMCID记录在out/fulltext_verification.csv中,cache_xml.ps1会从Europe PMC重新检索每一篇。从第3阶段起的所有分析均可完全离线复现。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托三甲直采网络,提供合规、去标识化、支持注册级质控的专病数据集交易服务。


