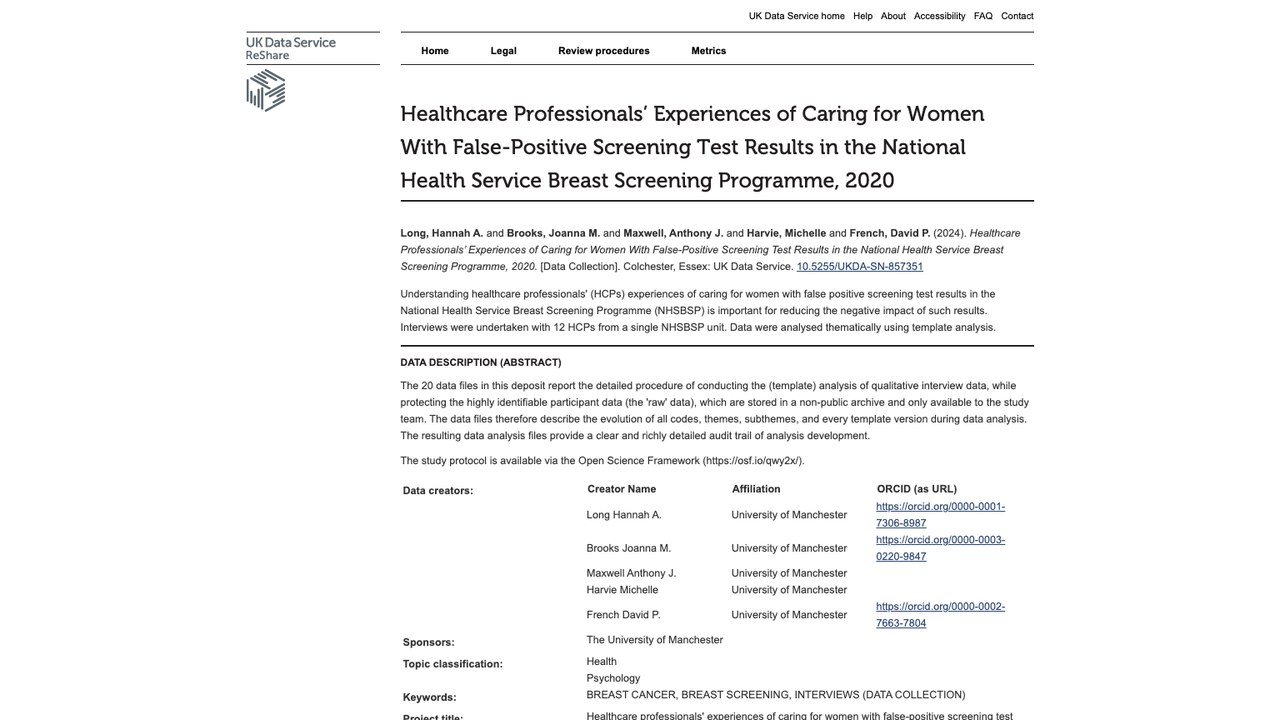
2020年NHS乳腺筛查项目中医疗专业人员护理假阳性筛查结果女性的经验
本数据集包含20个数据文件,记录了对医疗专业人员护理NHS乳腺筛查假阳性结果女性经验的定性访谈数据进行模板分析的过程,涵盖编码和主题演变。
基本信息
资源简介
2020年NHS乳腺筛查项目中医疗专业人员护理假阳性筛查结果女性的经验
【一句话概览】
本数据集是 LSHTM Data Compass 公开的文本数据集,主题涵盖 BREAST CANCER、BREAST SCREENING、INTERVIEWS (DATA COLLECTION),可用于医学自然语言处理(实体识别、信息抽取等)。
【数据集背景】
本数据集源站标题为《Healthcare Professionals’ Experiences of Caring for Women With False-Positive Screening Test Results in the National Health Service Breast Screening Programme, 2020》。
【数据内容】
源站原始描述:The 20 data files in this deposit report the detailed procedure of conducting the (template) analysis of qualitative interview data, while protecting the highly identifiable participant data (the ''raw'' data), which are stored in a non-public archive and only available to the study team. The data files therefore describe the evolution of all codes, themes, subthemes, and every template version during data analysis. The resulting data analysis files provide a clear and richly detailed audit trail…
中文译文(机器翻译,仅供快速理解,请以原文为准):本存储中的20个数据文件报告了对定性访谈数据进行(模板)分析的详细过程,同时保护了高度可识别的参与者数据(“原始”数据),这些数据存储在一个非公开档案库中,仅供研究团队使用。因此,这些数据文件描述了数据分析过程中所有编码、主题、子主题以及每个模板版本的演变。由此生成的数据分析文件提供了清晰且详尽的分析发展审计轨迹。研究方案可通过开放科学框架(Open Science Framework,https://osf.io/qwy2x/)获取。
【主题与分类】
主题标签:BREAST CANCER、BREAST SCREENING、INTERVIEWS (DATA COLLECTION)。
【适用方向】
文本类数据可用于医学自然语言处理,如命名实体识别、信息抽取与文本分类。
【获取与许可】
源站页面:https://reshare.ukdataservice.ac.uk/id/eprint/857351/
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
暂未开放当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:http://reshare.ukdataservice.ac.uk/id/eprint/857351
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据加载示例(表格/文本类)
import pandas as pd, glob, os

files = (glob.glob(os.path.join(path, "**", "*.csv"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tsv"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.xlsx"), recursive=True))
print("数据文件:", files)
df = pd.read_csv(files[0])
print(df.shape); print(df.columns.tolist()); print(df.head(3))
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。