帕金森病生物标志物计划数据管理资源(PDBP DMR)存档库
本数据集为神经系统疾病领域的其他公开数据集,来源:google_dataset。
基本信息
资源简介
帕金森病生物标志物计划数据管理资源(PDBP DMR)存档库
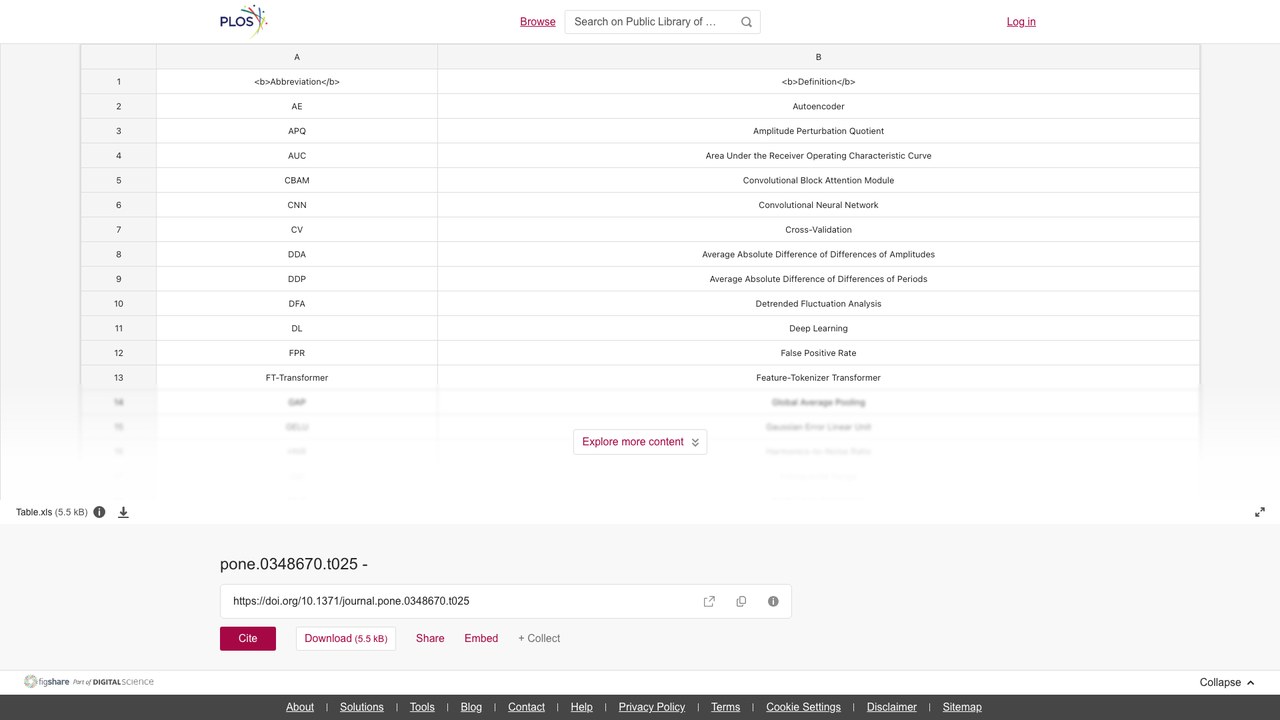
pone.0348670.t025 -
该数据集来自 plos.figshare.com,标题为 pone.0348670.t025,属于神经系统疾病中的帕金森病分类,包含 1 个 Table.xls 文件。源站描述指出,该研究提出一个统一且感知数据集的深度学习框架,采用模块化架构,依据特征维度、样本量和类别不平衡等数据集特征选择合适模型,集成 MLP、一维 CNN、FT-Transformer、基于自编码器的分类器及集成策略,并结合稳健预处理、折安全特征选择与嵌套交叉验证,用于跨多种临床数据集的准确且可解释的疾病预测(来源 figshare,CC BY 4.0 许可)。
【数据集背景】
源站首次发布:2026-05-08。
【数据内容】
源站描述(机器翻译,仅供参考):使用临床数据集进行准确的疾病预测对于改善早期诊断和临床决策支持系统至关重要;然而,许多现有的深度学习方法针对特定疾病、计算量大,且难以在异构生物医学数据集之间泛化。本研究通过提出一个统一且感知数据集的深度学习框架来应对这一挑战,该框架能够在多样化的临床数据集上实现准确且可解释的疾病预测。该框架采用模块化架构,根据特征维度、样本量和类别不平衡等数据集特征选择合适的模型。它集成了多种深度学习架构,包括 MLP、一维 CNN、FT-Transformer、基于自编码器的分类器以及集成策略。稳健的预处理、折安全特征选择和嵌套交叉验证
【数据结构与技术规格】
文件数 1 个,合计 5.63 KB。数据集 DOI:10.1371/journal.pone.0348670.t025。
【主题与分类】
源站学科分类:Space Science、Biological Sciences not elsewhere classified、Information Systems not elsewhere classified、Cancer。主题标签:parkinson &# 8217、improving early diagnosis、8980 (&# 177、8451 (&# 177、safe feature selection、classical baselines across、autoencoder ensemble obtained、heart disease prediction、autoencoder ensemble achieved、disease voice dataset。本站分类:神经系统疾病/帕金森病。
【适用方向】
源站学科分类标注为 Space Science、Biological Sciences not elsewhere classified、Information Systems not elsewhere classified、Cancer。
【获取与许可】
源站页面:https://plos.figshare.com/articles/dataset/pone_0348670_t025_-_p_p_/32222958
使用许可:CC BY 4.0(https://creativecommons.org/licenses/by/4.0/)。
规范引用:Rathod, Vijay U.; Amrutkar, Siddhesh Sanjay; Patil, Kirti A.; Londhe, Aoudumber D.; Bobade, Sandip Y.; Dhotre, Virendrakumar A.; et al. (2026). pone.0348670.t025 - . PLOS ONE. Dataset
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
暂未开放当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取(Figshare)
- 源站标题:pone.0348670.t025 - <p> </p>
- DOI:10.1371/journal.pone.0348670.t025
- 发布日期:2026-05-08
- 文件数:1 个
- 文件总体积:5.63 KB
- 源站页面:https://plos.figshare.com/articles/dataset/pone_0348670_t025_-_p_p_/32222958
命令行下载
curl -L -o "Table.xls" "https://ndownloader.figshare.com/files/64382808"
文件清单
Table.xls(5.63 KB)
文件总体积 5.63 KB(源站 API 实测)。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
数据说明
利用临床数据集进行准确的疾病预测对于改进早期诊断和临床决策支持系统至关重要;然而,许多现有的深度学习方法针对特定疾病、计算密集,且难以在异构生物医学数据集之间泛化。本研究通过提出一个统一且具备数据集感知能力的深度学习框架来应对这一挑战,该框架能够在多样化的临床数据集上实现准确且可解释的疾病预测。该框架采用模块化架构,根据特征维度、样本量和类别不平衡等数据集特征选择合适的模型。它集成了多种深度学习架构,包括MLP、一维CNN、FT-Transformer、基于自编码器的分类器以及集成策略。框架还纳入了稳健的预处理、折内安全特征选择和嵌套交叉验证,以确保可靠的性能评估。
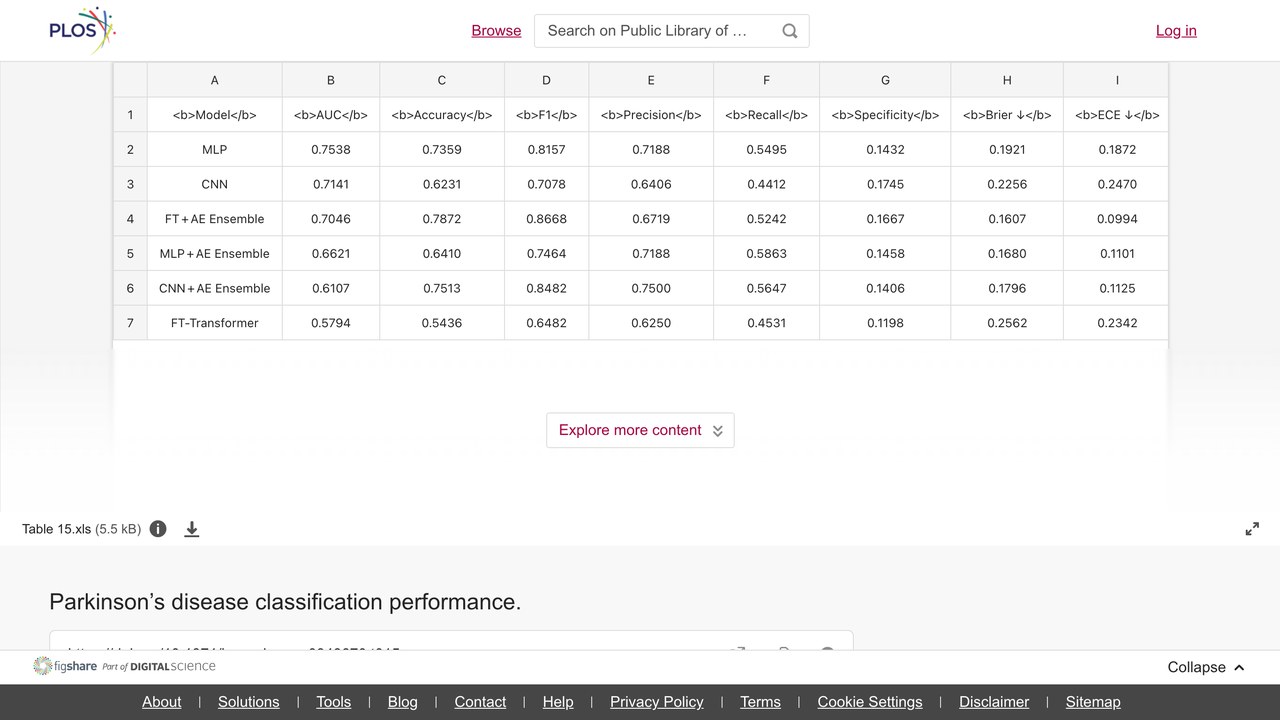
该框架在三个异构基准数据集上进行了评估:UCI心脏病数据集(303个样本,13个临床特征)、PIMA印第安人糖尿病数据集(768个样本,8个代谢特征)以及帕金森病语音数据集(195条记录,22个声学特征)。实验结果表明,在多样化任务中,该框架相较于经典基线模型展现出具有竞争力的预测性能。FT-Transformer + 自编码器集成模型在心脏病预测中取得了0.8980(±0.0483)的AUC值,而CNN + 自编码器集成模型在糖尿病分类中获得了0.8451(±0.0270)的AUC值。在帕金森病检测方面,MLP取得了0.7538的AUC值,且特异性达到完美水平。总体而言,所有模型的AUC值均与机器学习基线相当。本研究贡献了一个可扩展且可解释的深度学习框架,提升了真实医疗环境中多疾病预测的可靠性、泛化能力和实际适用性。
许可
CC BY 4.0
引用
学术使用请引用 DOI 10.1371/journal.pone.0348670.t025(source: https://plos.figshare.com/articles/dataset/pone_0348670_t025_-_p_p_/32222958)。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。