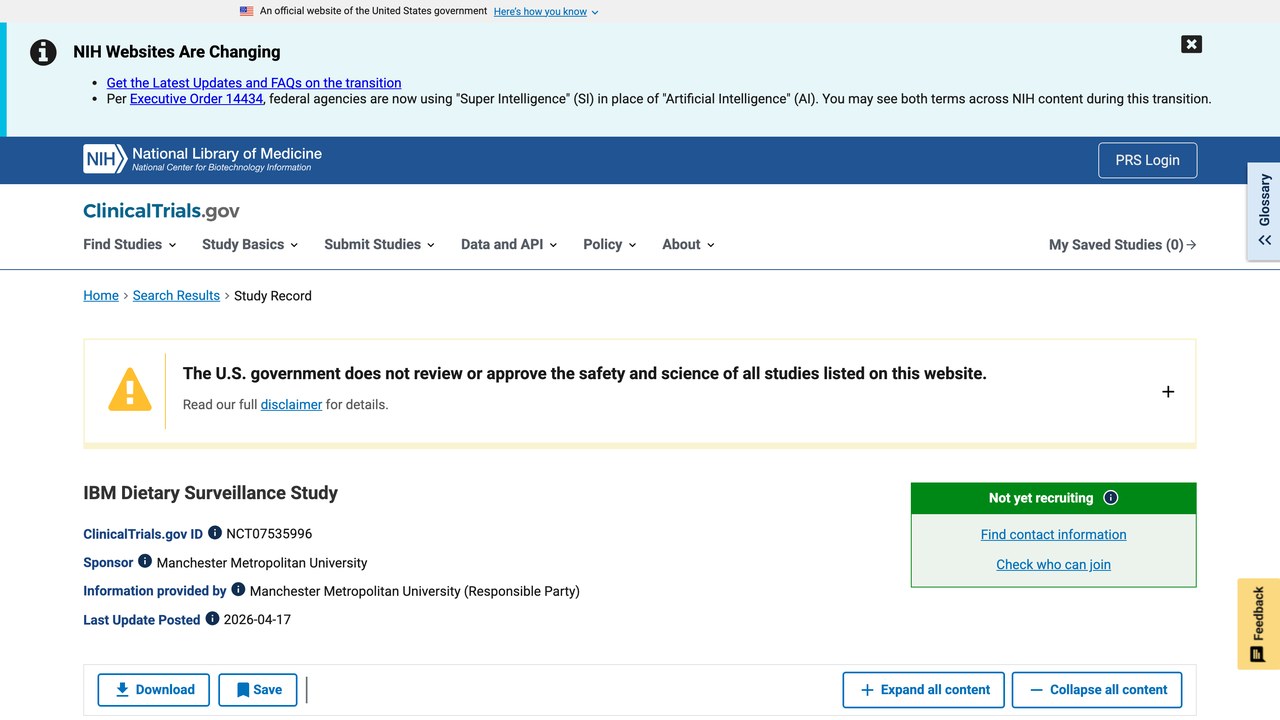
IBM饮食监测研究
研究计划招募32名IBM患者和15名年龄及活动量匹配的对照参与者,基于功效计算检测饮食蛋白质实践与肌肉质量及功能相关结局指标之间的强关联(r = ±0.5)
基本信息
资源简介
IBM饮食监测研究
是一项来自clinicaltrials.gov的观察性病例对照研究,聚焦于Inclusion Body Myositis(IBM)患者。研究计划招募32名IBM患者和15名年龄及活动量匹配的对照参与者,基于功效计算检测饮食蛋白质实践与肌肉质量及功能相关结局指标之间的强关联(r = ±0.5)。该数据可用于分析饮食蛋白质与IBM患者肌肉相关结局的关系,并支持病例对照比较(来源 clinicaltrials.gov)。
【数据内容】
源站描述(机器翻译,仅供参考):条件:Inclusion Body Myositis。本研究将采用观察性病例对照设计。基于旨在检测饮食蛋白质实践与肌肉质量和功能相关各项结局指标之间强关联(r = ±0.5)的功效计算,已确定纳入32名Inclusion Body Myositis(IBM)参与者的样本量。使用双尾检验,α水平为0.05,功效为80%(β = 0.2),分析表明所需样本量为29名参与者。所用样本量方程适用于Pearson相关性分析。为考虑估计的10%脱落率,最终目标招募人数为32。此外,将招募15名年龄和活动量匹配的对照参与者。IBM组与对照组之间比较的功效计算返回了较低的样本量要求,反映了较低的变异性。
【主题与分类】
主题标签:Inclusion Body Myositis。本站分类:神经系统疾病。
【获取与许可】
源站页面:https://clinicaltrials.gov/study/NCT07535996
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录有偿下载
公开数据集受托下载与技术交付服务。
提供高速下载与技术交付服务(收技术服务费,非数据销售)
暂未开放当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://clinicaltrials.gov/study/NCT07535996
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
条件:包涵体肌炎。本研究将采用观察性病例对照设计。基于旨在检测膳食蛋白质实践与肌肉质量和功能相关各项结局指标之间强关联(r = ±0.5)的效力计算,已确定32名包涵体肌炎(IBM)参与者的样本量。采用双侧检验,α水平为0.05,效力为80%(β = 0.2),分析表明所需样本量为29名参与者。所使用的样本量公式适用于Pearson相关分析。考虑到估计10%的脱落率,最终目标招募人数为32人。此外,将招募15名年龄和活动量匹配的对照参与者。IBM组与对照组之间比较的效力计算显示所需样本量较低,反映了健康人群中通常观察到的较低变异性。IBM参与者的识别将在索尔福德皇家医院(英国曼彻斯特)三级神经肌肉服务中心和神经肌肉中心(英国柴郡温斯福德)进行。
符合条件者将在诊所或通过电子邮件收到参与者信息表、研究海报和联系同意书。填写完整的联系同意书将使曼彻斯特城市大学(ManMet)研究团队能够通过电话或电子邮件跟进,邀请其参加在曼彻斯特城市大学体育研究所(IoS)进行的筛选访视。对照参与者将从当地社区招募。若同意,将通过电话安排筛选和入组访视。前往IoS的筛选访视将持续最多1.5小时,但若发现参与者不符合条件,可能会提前结束。访视期间,参与者将与研究人员会面,研究人员将详细解释研究内容,包括时间投入、风险和参与者权利。随后将获取知情同意。之后,参与者将完成四份问卷
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
数据缺失?
依托陕西、四川两大基地,我们与超过十家三甲医院建立直接合作关系,覆盖合规授权、采集治理、专业标注、数据交付的全流程,为AI医疗团队提供即拿即用的高质量临床数据。
⚡️ 需要数据支持或标注服务?立即联系我们获取专业方案。


