癌症数据集
本数据集为肿瘤领域的表格公开数据集,来源:kaggle。
基本信息
资源简介
癌症数据集
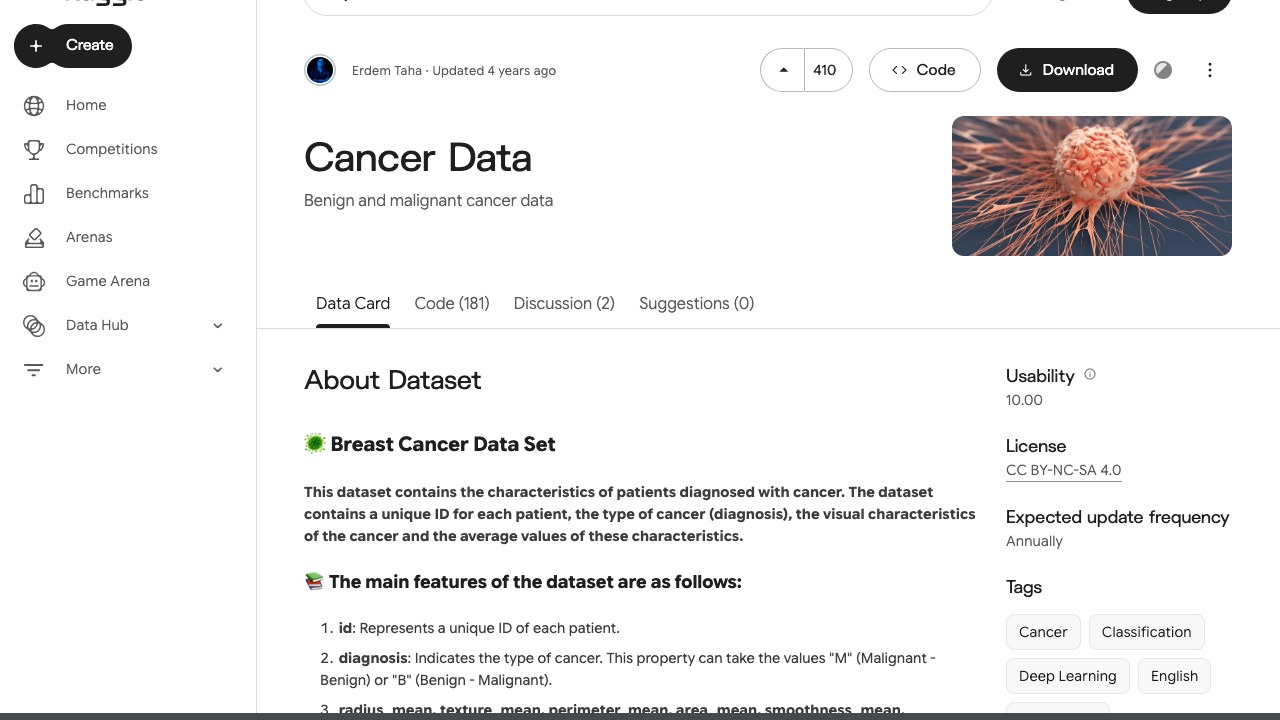
Cancer Data
该数据集来自 Kaggle,包含癌症患者特征,每条记录有唯一患者 ID、癌症诊断类型(M 或 B)以及癌症视觉特征的均值,如 radius_mean、texture_mean、perimeter_mean、area_mean、smoothness_mean、compactness_mean、concavity_mean、concave points_mean 等,另含若干以数值标注的类别特征。数据可用于癌症分类任务,适合机器学习与深度学习建模研究(来源 Kaggle,CC BY-NC-SA 4.0 许可)。
【数据集背景】
源站首次发布:2023-03-22。
【数据内容】
源站描述(机器翻译,仅供参考):🦠 乳腺癌数据集 该数据集包含被诊断患有癌症的患者的特征。数据集包含每位患者的唯一 ID、癌症类型(诊断)、癌症的视觉特征以及这些特征的平均值。 📚 数据集的主要特征如下: 1. id:表示每位患者的唯一 ID。 2. diagnosis:表示癌症类型。该属性可取值为“M”(恶性 - 良性)或“B”(良性 - 恶性)。 3. radius_mean、texture_mean、perimeter_mean、area_mean、smoothness_mean、compactness_mean、concavity_mean、concave points_mean:表示癌症视觉特征的平均值。还有一些类别特征,数据集中患者被标注为数值。你可以在图表区域查看它们。其他特征包含
【数据结构与技术规格】
文件数 1 个,合计 125.20 KB。
【主题与分类】
主题标签:cancer、classification、deep learning、english、categorical。本站分类:肿瘤/癌症(总论)。
【获取与许可】
源站页面:https://www.kaggle.com/datasets/erdemtaha/cancer-data
使用许可:CC BY-NC-SA 4.0。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
暂未开放当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://kaggle.com/datasets/erdemtaha/cancer-data
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
Cancer Data Erdem Taha · Updated 4 years ago Usability 10.0 · 1 File (CSV) · 50 kB · 51.9K downloads · 181 notebooks arrow_drop_up 408 Silver more_horiz
数据加载示例(表格/文本类)
import pandas as pd, glob, os

files = (glob.glob(os.path.join(path, "**", "*.csv"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tsv"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.xlsx"), recursive=True))
print("数据文件:", files)
df = pd.read_csv(files[0])
print(df.shape); print(df.columns.tolist()); print(df.head(3))
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。