MDA-MB-231细胞Aurora-A激酶亚细胞定位可变的高通量测序数据集
该数据集来自NCBI GEO,包含MDA-MB-231三阴性乳腺癌细胞系在Aurora-A激酶不同亚细胞定位(野生型、无定位信号、细胞质NES、细胞核NLS)下的高通量RNA测序表达谱
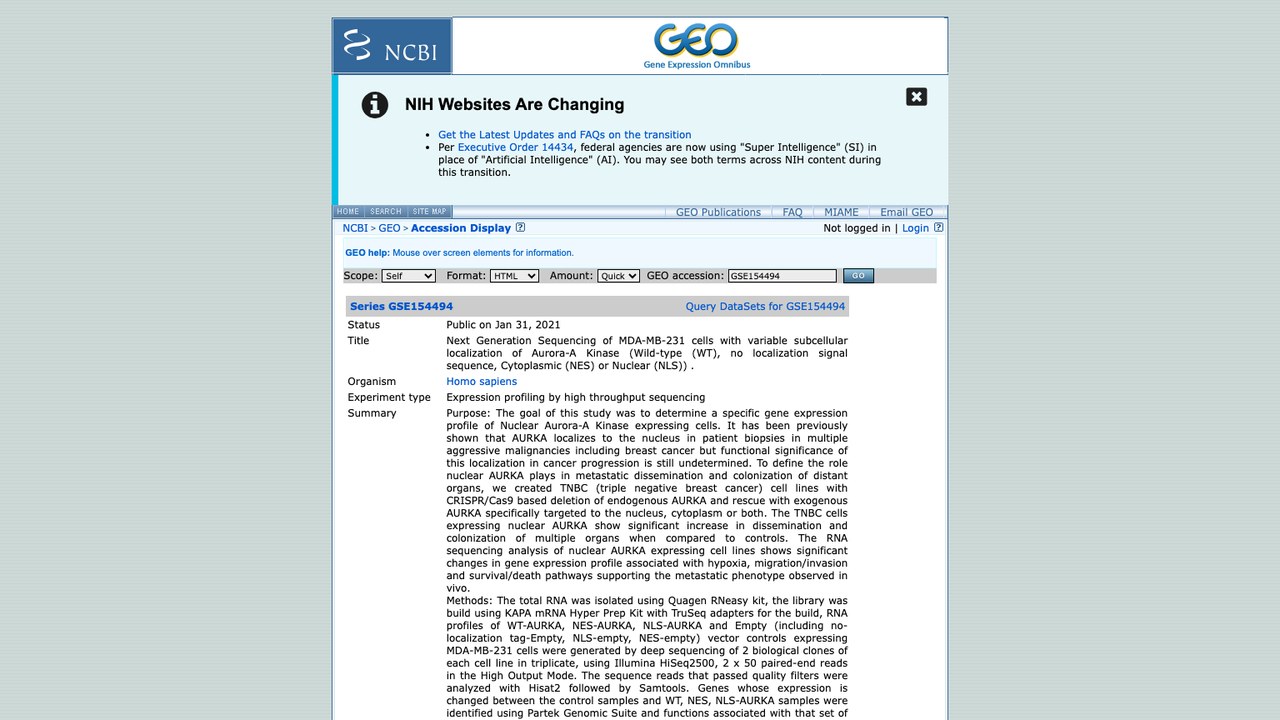
基本信息
资源简介
MDA-MB-231细胞Aurora-A激酶亚细胞定位可变的高通量测序数据集
Next Generation Sequencing of MDA-MB-231 cells with variable subcellular localization of Aurora-A Kinase (Wild-type (WT), no localization signal sequence, Cytoplasmic (NES) or Nuclear (NLS)) .
该数据集来自NCBI GEO,包含MDA-MB-231三阴性乳腺癌细胞系在Aurora-A激酶不同亚细胞定位(野生型、无定位信号、细胞质NES、细胞核NLS)下的高通量RNA测序表达谱。研究通过CRISPR/Cas9敲除内源AURKA并回补靶向不同亚细胞区室的外源AURKA,比较核定位AURKA表达细胞的基因表达特征。数据可用于分析核AURKA在肿瘤转移和定植中的功能作用,识别核AURKA相关基因表达谱,支持乳腺癌侵袭转移机制研究(来源 NCBI)。
【数据集背景】
源站首次发布:Jul 15 202。
【数据内容】
源站描述(机器翻译,仅供参考):目的:本研究的目的是确定表达核Aurora-A激酶的细胞的特异性基因表达谱。此前已有研究表明,AURKA在多种侵袭性恶性肿瘤(包括乳腺癌)的患者活检组织中定位于细胞核,但这种定位在癌症进展中的功能意义仍未确定。为了明确核AURKA在转移播散和远处器官定植中的作用,我们创建了三阴性乳腺癌(TNBC)细胞系,通过基于CRISPR/Cas9的方法删除内源性AURKA,并回补特异性靶向细胞核、细胞质或两者的外源性AURKA。与对照相比,表达核AURKA的TNBC细胞在多个器官的播散和定植中显示出显著增加。对表达核AURKA的细胞系进行的RNA测序分析显示显著
【数据结构与技术规格】
文件数 1 个,合计 0 B。
【主题与分类】
主题标签:GPL16791、9606。本站分类:肿瘤/乳腺癌。
【获取与许可】
源站页面:https://ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE154494
【使用注意】
· 源站最后修改于 Oct 26 202,引用时请注意版本时效。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE154494
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
目的:本研究的目的是确定表达核Aurora-A激酶的细胞的特异性基因表达谱。此前已有研究表明,AURKA在包括乳腺癌在内的多种侵袭性恶性肿瘤患者活检组织中定位于细胞核,但该定位在癌症进展中的功能意义仍未确定。为明确核AURKA在转移播散及远处器官定植中的作用,我们构建了三阴性乳腺癌(TNBC)细胞系,采用CRISPR/Cas9技术敲除内源性AURKA,并分别以外源性AURKA特异性回补至细胞核、细胞质或两者。与对照组相比,表达核AURKA的TNBC细胞在多种器官中的播散和定植显著增加。对表达核AURKA的细胞系进行RNA测序分析显示,与缺氧、迁移/侵袭及生存/死亡通路相关的基因表达谱发生显著变化,支持了体内观察到的转移表型。
方法:使用Quagen RNeasy试剂盒提取总RNA,使用KAPA mRNA Hyper Prep Kit及TruSeq接头构建文库。对表达WT-AURKA、NES-AURKA、NLS-AURKA及Empty(包括无定位标签Empty、NLS-empty、NES-empty)载体对照的MDA-MB-231细胞,每种细胞系取2个生物学克隆、每个克隆设3个重复,采用Illumina HiSeq2500高通量模式2×50双端测序进行深度测序,生成RNA表达谱。通过质量过滤的序列reads使用Hisat2分析,随后使用Samtools处理。使用Partek Genomic Suite鉴定对照样本与WT、NES、NLS-AURKA样本之间表达发生变化的基因,并使用Ingenuity Pathway Analysis对与该基因集相关的功能进行映射。使用TaqMan和SYBR Green assay进行qRT–PCR验证。结果:使用优化的数据分析流程,我们鉴定出33,563
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。


