CMMD 乳腺钼靶图像分类数据集
数据可用于训练和评估结合图像与表格特征的多模态分类模型,服务于乳腺癌相关研究(来源 Hugging Face)。文件数 4 个,合计 1.60 GB
基本信息
资源简介
CMMD 乳腺钼靶图像分类数据集
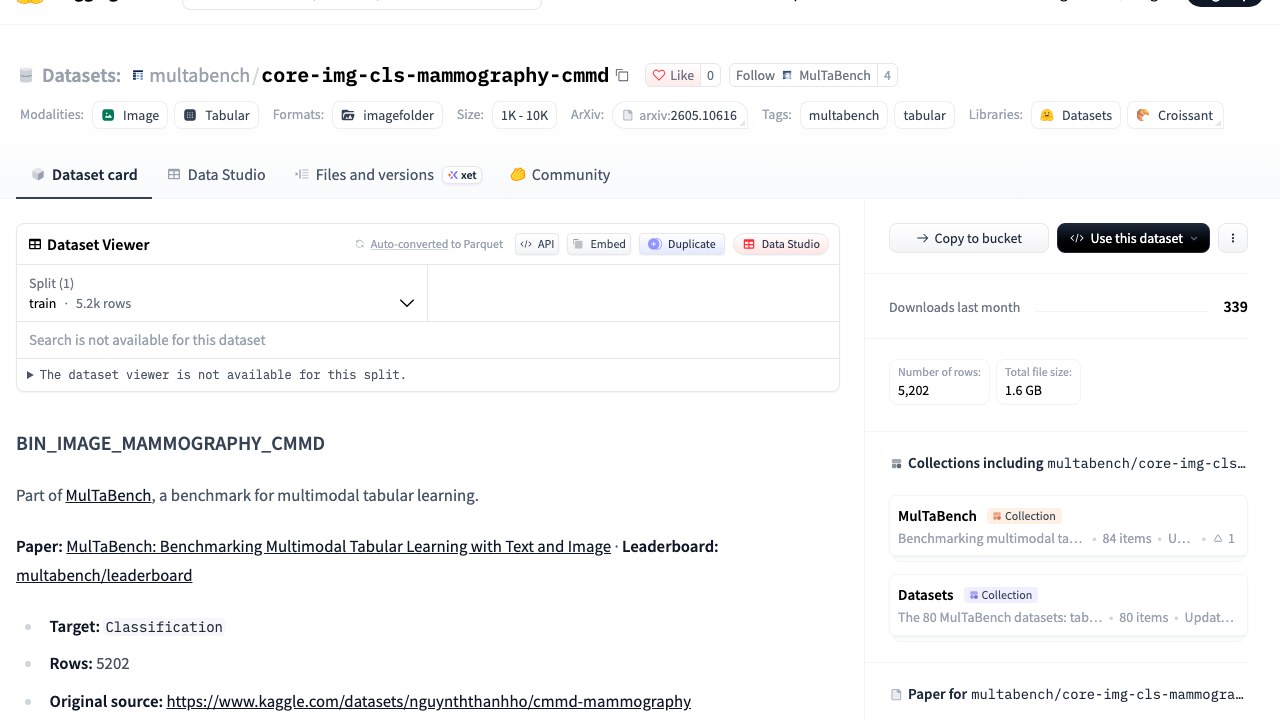
core-img-cls-mammography-cmmd 是一个面向乳腺影像分类的多模态数据集,来源于 Hugging Face 平台,标题为 multabench/core-img-cls-mammography-cmmd,在本站归类于肿瘤 / 乳腺癌方向。该数据集属于 MulTaBench 基准体系的一部分,后者是面向多模态表格学习的评测基准,配套有论文与排行榜。数据集的目标任务为分类,共包含 5202 行样本,文件数量为 4 个,合计约 1.60 GB,发布时间为 2026-10-01。数据同时提供图像与表格两类模态,可用于训练和评估结合图像与表格特征的多模态分类模型,服务于乳腺癌相关研究。
【数据集背景】
该数据集是 MulTaBench 基准的组成部分。MulTaBench 是一个面向多模态表格学习的基准,强调将文本、图像等非结构化模态与表格数据结合进行建模。相关论文为《MulTaBench: Benchmarking Multimodal Tabular Learning with Text and Image》,论文编号为 arXiv:2605.10616,并设有公开排行榜 multabench/leaderboard。该数据集在基准中的标识为 BIN_IMAGE_MAMMOGRAPHY_CMMD,任务类型为分类(Classification)。
【数据内容】
数据集共 5202 行,包含表格字段与图像文件两部分。表格部分以 Parquet 列式格式存储于 data.parquet 中,字段包括:左右侧别(分类型)、年龄(整数型)、异常情况(分类型)、图像路径(指向 images-*.zip 压缩包内部的路径)、裁剪方法(分类型)以及分类标签(字符串型)。图像数据分布在 images-00000.zip 与 images-00001.zip 两个压缩包中,表格中的图像路径字段用于定位包内对应图像。此外还包含 metadata.json 用于元数据描述。整体文件规模约 1.60 GB,样本量处于 1K 至 10K 区间。
【采集与来源】
该数据集的原始来源为 Kaggle 平台上的 cmmd-mammography 数据集(链接为 kaggle.com/datasets/nguynththanhho/cmmd-mammography),经 MulTaBench 整理后发布于 Hugging Face。数据集主题标签涵盖图像模态、表格模态、imagefolder 格式、datasets 与 mlcroissant 库,以及 multabench、tabular 等标识,地区标记为 us。
【适用场景】
依据其模态构成与任务设定,该数据可用于训练和评估融合图像与表格特征的多模态分类模型,典型应用方向为乳腺癌相关的影像分类研究。由于同时提供影像与年龄、侧别、异常情况、裁剪方法等表格信息,适合开展多模态表格学习方法的对比实验,也可作为 MulTaBench 基准评测中的标准数据划分使用。
【使用方法】
可通过 MulTaBench 提供的接口加载基准划分,调用方式为 multabench.load_split(“BIN_IMAGE_MAMMOGRAPHY_CMMD”, fold=0)。使用前需下载全部 4 个数据文件,按格式分别读取:Parquet 采用列式存储读取,图像位于 ZIP 压缩包内需解压或按路径索引,JSON 文件用于读取元数据。建议先在小样本上核对字段与编码,确认无误后再批量接入完整数据。
【质量与限制】
源站未提供关于数据质量、标注一致性、类别分布或缺失情况的具体说明。需注意图像以压缩包形式分发,读取时依赖表格中的路径字段与包内目录结构保持一致;样本量为 5202 行,属于中等规模。其他质量相关指标源站未提供。
【引用与许可】
引用信息为 MulTaBench 论文,bibtex 条目作者为 arazi 等,年份 2026,标题为《MulTaBench: Benchmarking Multimodal Tabular Learning with Text and Image》。许可证信息源站未提供。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取与加载(Hugging Face datasets)
# 前置依赖: pip install datasets
from datasets import load_dataset

ds = load_dataset("multabench/core-img-cls-mammography-cmmd")
print(ds)  # 查看 splits 与字段结构
# 国内网络可先设镜像: import os; os.environ["HF_ENDPOINT"]="https://hf-mirror.com"
git lfs install && git clone https://hf-mirror.com/datasets/multabench/core-img-cls-mammography-cmmd
数据集大小约 1.61 GB。
仓库文件结构
.gitattributesREADME.mddata.parquetimages-00000.zipimages-00001.zipmetadata.json
数据说明
MulTaBench (2026). core-img-cls-mammography-cmmd [Dataset]. https://huggingface.co/datasets/multabench/core-img-cls-mammography-cmmd
完整数据卡:huggingface.co/datasets/multabench/core-img-cls-mammography-cmmd
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。