1型糖尿病与非糖尿病青少年尿液肽组学数据集
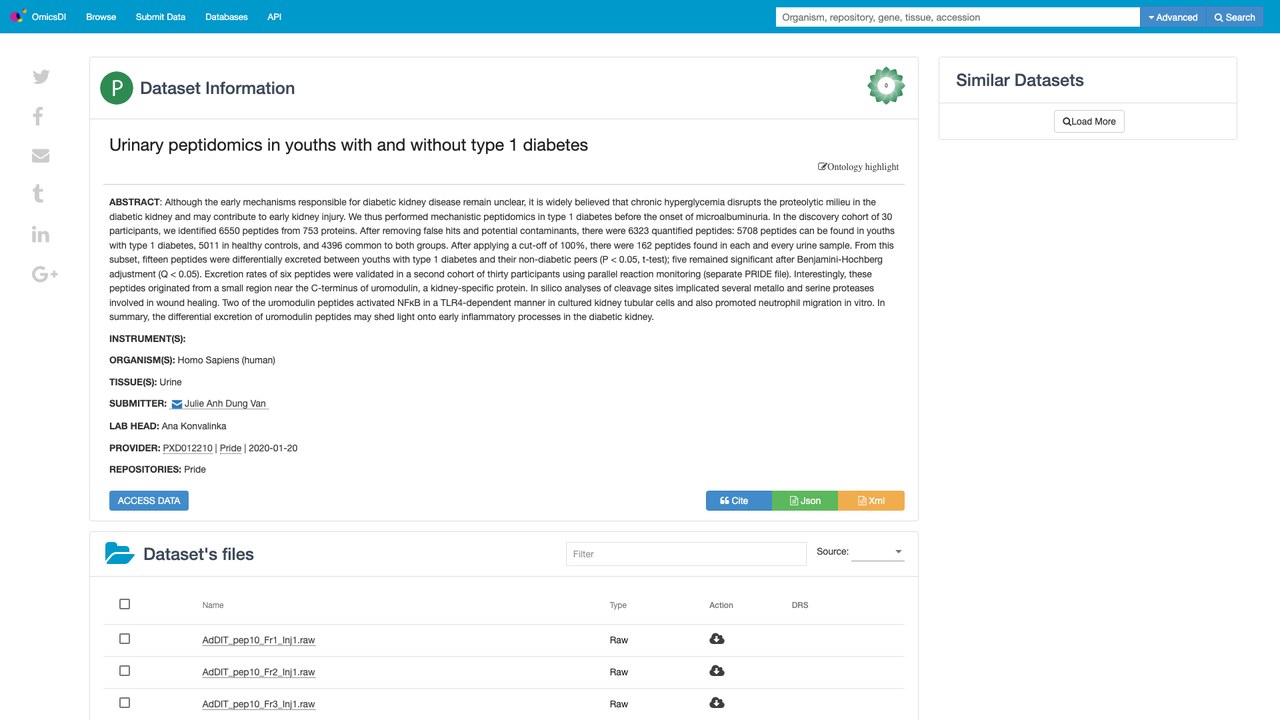
该数据集来源于omicsdi.org,聚焦1型糖尿病青少年与健康对照的尿液肽组学。研究在微量白蛋白尿出现前开展机制性肽组学分析,发现队列纳入30名参与者,从753种蛋白质中鉴定出6550个肽段,经质控后获得6323个定量肽段,并比较两组肽段检出与排泄差异
基本信息
资源简介
1型糖尿病与非糖尿病青少年尿液肽组学数据集
该数据集来源于omicsdi.org,聚焦1型糖尿病青少年与健康对照的尿液肽组学。研究在微量白蛋白尿出现前开展机制性肽组学分析,发现队列纳入30名参与者,从753种蛋白质中鉴定出6550个肽段,经质控后获得6323个定量肽段,并比较两组肽段检出与排泄差异。数据可用于探索糖尿病肾病早期尿液肽段标志物及高血糖相关蛋白水解改变(来源 omicsdi.org)。
【数据内容】
源站描述(机器翻译,仅供参考):尽管糖尿病肾病的早期机制仍不清楚,但普遍认为慢性高血糖会破坏糖尿病肾脏中的蛋白水解环境,并可能促成早期肾损伤。因此,我们在微量白蛋白尿出现之前对1型糖尿病进行了机制性肽组学分析。在由30名参与者组成的发现队列中,我们从753种蛋白质中鉴定出6550个肽段。在去除假阳性结果和潜在污染物后,共有6323个定量肽段:5708个肽段可见于1型糖尿病青少年,5011个可见于健康对照,4396个为两组共有。应用100%的截断值后,有162个肽段在每一份尿液样本中均被发现。从该子集中,有15个肽段在1型糖尿病青少年与其非糖尿病同龄人之间的排泄存在差异(P < 0.05,t检验);其中5个仍具有显著性
【主题与分类】
主题标签:Human、Peptidomics、Urine、Type 1 diabetes、Lc-ms/ms。本站分类:内分泌、营养和代谢疾病/糖尿病。
【获取与许可】
源站页面:https://omicsdi.org/dataset/pride/PXD012210
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://omicsdi.org/dataset/pride/PXD012210
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
尽管糖尿病肾病的早期机制尚不清楚,但普遍认为慢性高血糖会破坏糖尿病肾脏中的蛋白水解环境,并可能促成早期肾损伤。因此,我们在微量白蛋白尿出现之前对1型糖尿病进行了机制性肽组学研究。在由30名参与者组成的发现队列中,我们从753种蛋白质中鉴定出6550个肽段。在去除假阳性结果和潜在污染物后,共有6323个定量肽段:其中5708个肽段可见于1型糖尿病青少年,5011个见于健康对照,4396个为两组共有。应用100%的截断标准后,有162个肽段在每一份尿液样本中均被发现。从该子集中,有15个肽段在1型糖尿病青少年与其非糖尿病同龄人之间的排泄存在差异(P < 0.05,t检验);经Benjamini-Hochberg校正后,有5个仍具有显著性(Q < 0.05)。使用平行反应监测(单独的PRIDE文件)在第二个由30名参与者组成的队列中验证了6个肽段的排泄率。
有趣的是,这些肽来源于尿调节素C末端附近的一个小区域,尿调节素是一种肾脏特异性蛋白。对切割位点的计算机分析表明,多种参与伤口愈合的金属蛋白酶和丝氨酸蛋白酶可能参与其中。其中两种尿调节素肽在培养的肾小管细胞中以TLR4依赖的方式激活NFκB,并在体外促进中性粒细胞迁移。总之,尿调节素肽的差异性排泄可能有助于揭示糖尿病肾脏早期炎症过程。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。