信息速览
Human Activity Recognition Using Smartphones — 智能手机惯性传感活动识别基准 AI-Ready Wikipedia
一句话定位:一部腰挂的旧款安卓手机、30 个年轻人、6 类日常动作——UCI HAR 用最朴素的传感配置,定义了「滑动窗口特征工程 + 受试者级划分」这一可穿戴时序 AI 的评测范式,并在此后十余年成为被引用最多的活动识别公开基准之一。
INFOBOX
| 数据集名称 | UCI HAR Dataset |
| 英文全称 | Human Activity Recognition Using Smartphones Dataset |
| 别名/简称 | UCI HAR、HAR、HAR Smartphones、Human Activity Recognition Using Smartphones |
| 疾病分类 | 不适用——健康志愿者活动监测数据,无疾病标签(相关临床场景映射见 §2.1) |
| SNOMED CT | 不适用(本页面的临床概念映射建议见 §2.1b) |
| 数据模态 | 三轴加速度计 + 三轴陀螺仪(腰挂智能手机两端) |
| AI 任务类型 | 6 类人体活动识别、聚类、特征选择、传感器融合、端到端时序分类 |
| 样本总数 | 10,299 个滑窗样本(train 7,352 / test 2,947) |
| 数据大小 | 58.2 MB(UCI 官方 ZIP 下载包) |
| 数据格式 | 空格分隔纯文本矩阵(X/y/subject 三支文件按行对齐 + Inertial Signals 原始序列) |
| 特征维度 | 561 维时频域特征(另有活动标签与受试者 ID 两支伴随文件) |
| 许可证 | Creative Commons Attribution 4.0 International(CC BY 4.0) |
| 访问级别 | 开放(无需注册、无需申请) |
| DUO 标签 | NRES(无限制使用) |
| 语言 | 英文(文档与标签说明) |
| 首发日期 | 2012(UCI 记为 Donated on 12/9/2012;论文 2013 会议发表) |
| 最后更新 | 2012 原始发布版(UCI 另存 updated 版带姿态转换标签) |
| 发布机构 | 意大利热那亚大学 DITEN + 西班牙加泰罗尼亚理工大学 CETpD(Anguita、Ghio、Oneto、Parra、Reyes-Ortiz) |
| 官方主页 | https://archive.ics.uci.edu/dataset/240/human+activity+recognition+using+smartphones |
| 下载地址 | https://archive.ics.uci.edu/static/public/240/human+activity+recognition+using+smartphones.zip |
| DOI | 10.24432/C54S4K |
| 引用次数 | 高度引用(ESANN 2013 主论文为 HAR 领域经典,Google Scholar 万级) |
| AI 就绪度评分 | ⭐⭐⭐⭐⭐(5/5)— 纯文本直读、无缺失、官方划分齐全、文档完备、CC BY 4.0 清晰 |
| 页面状态 | published |
§0 E-E-A-T 信任声明与免责声明
医学审核者:千方病案医学编辑部交叉审核:§2 医学背景(临床场景映射、可穿戴健康定位、金标准描述)、§7 偏倚分析。
数据工程审核者:千方病案医学编辑部交叉审核:§4 DAIMS 数据结构(561 维特征族字典、三支文件行对齐)、§5 划分策略、§6 预处理 Pipeline 和坑点。
审核日期:2026-10-16
审核方式:交叉审核
利益冲突声明:千方病案医数集与热那亚大学(University of Genova)、加泰罗尼亚理工大学(Universitat Politècnica de Catalunya)及 UCI 机器学习库无任何商业利益关联。本页面不销售 UCI HAR 数据集本身,仅提供 AI 就绪指南与学术信息服务。编辑者未接受上述机构的任何形式资助。
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方病案医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用本页面描述的数据集前,请务必阅读并遵守数据集原始许可协议。UCI HAR 采用 CC BY 4.0 许可,允许任何目的的共享与改编,但必须给出恰当署名。DUO 标签仅供参考,具体使用限制以数据集官方协议为准。
§1 数据集概览
§1.0 📌 30 秒速览
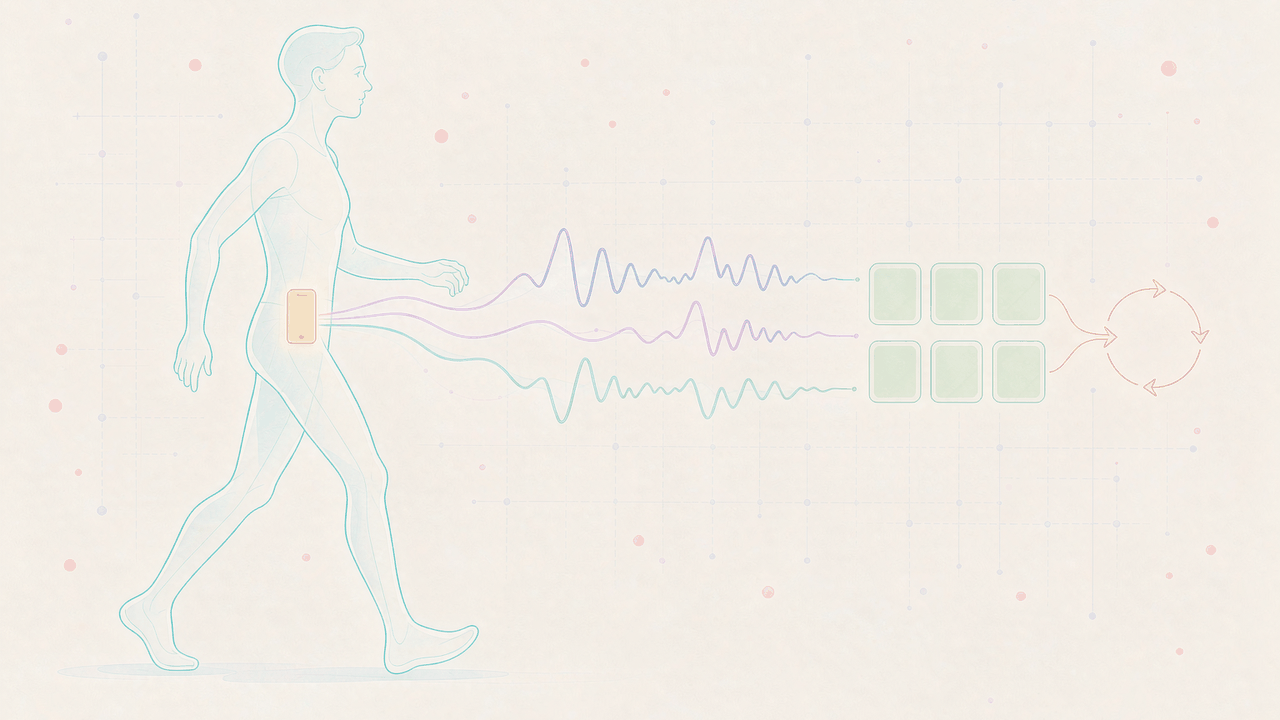
这是什么? UCI HAR(Human Activity Recognition Using Smartphones)是一个经典的可穿戴活动识别基准:30 名 19-48 岁的志愿者腰挂一部 Samsung Galaxy S II 手机,以 50 Hz 恒定频率采集三轴线性加速度与三轴角速度,先后执行 6 类日常活动(行走、上楼、下楼、坐着、站立、平躺)。信号经噪声滤波、2.56 秒滑窗(50% 重叠)与重力/体动分离后,每窗提取一支 561 维时频特征向量,共形成 10,299 个样本,并按受试者随机 70/30 划分为训练集与测试集(UCI 官方页面)。
为什么重要? 它是 HAR 领域被引用最广的公开基准之一,因为它用最少的硬件(单机腰挂、两个传感器)换来了最干净的评测设置——尤其是官方就自带的受试者级划分。这使它成为一面方法论镜子:任何在它身上因「随机划分」而虚高的准确率,都恰好暴露了受试者泄漏这一 HAR 研究最普遍的陷阱。围绕它的研究反复确认了同一结论:同一模型在随机划分下可以接近饱和,而换成面向新用户的受试者无关评估时性能明显回落(参见 §5.3、§6.5 坑点 1)。
我能用它做什么? 你可以用它训练 6 类活动识别模型、做滑窗与特征工程对比、研究传感器融合与特征选择、开展受试者无关泛化分析、或为可穿戴健康监测产品做算法原型与基准回归。它不适合直接用于临床诊断类应用。
§1.1 摘要
UCI HAR 由意大利热那亚大学 DITEN 与西班牙加泰罗尼亚理工大学 CETpD 的团队联合发布,托管于 UCI 机器学习库(dataset id=240,DOI: 10.24432/C54S4K)。数据采集使用智能手机(Samsung Galaxy S II)内置的三轴加速度计与三轴陀螺仪,设备固定于受试者腰部,全部信号以 50 Hz 恒定采样。30 名志愿者按脚本协议依次执行 6 类活动:WALKING、WALKING_UPSTAIRS、WALKING_DOWNSTAIRS、SITTING、STANDING、LAYING;实验全程以摄像机记录,用于人工标注。原始信号经噪声滤波后,被切成固定宽度 2.56 秒、50% 重叠的滑窗(每窗 128 个读数);加速度信号进一步用 Butterworth 低通滤波器(0.3 Hz 截止)分离为体加速度与重力分量。每窗从时域与频域计算出 561 维特征向量。数据集共 10,299 个样本,随机按受试者 70/30 划分训练与测试,官方下载包 58.2 MB。
一句话概括其数据形态:「两支特征矩阵(train/test)+ 每窗 561 维统计量 + 三支按行对齐的伴随文件(X/y/subject)」——这一极简形态既是它上手零门槛的原因,也意味着全部分析责任(划分口径、特征选择、防泄漏)都落在使用者一侧。
§1.2 战略价值
对 HAR 研究:UCI HAR 是该领域最通用的一块试金石。新颖方法若在这里跑不出合理结果,通常说明方法本身存在问题;反之,能在这里稳定复现的结果,往往可以顺利迁移到更复杂的数据集。
对方法论:它的官方受试者级划分,把「防受试者泄漏」这一本应常识却常被忽视的纪律,固化成了一个可复现的对照基线。它让「随机划分 vs 受试者无关划分」的性能差距变成可量化的教学案例。
对临床可穿戴:它的工程范式(受控采集、滑窗特征、受试者隔离、许可透明)直接可迁移到临床可穿戴研究,是理解同域医学数据集(MHEALTH、PAMAP2、PPG-DaLiA)的入门参照。
对千方病案医数集:收录 UCI HAR 是为了给可穿戴健康 AI 的讨论提供一块最可靠的地基——理解了这块地基的承重与边界,才能在其上建起稳当的房子。
§1.3 同类数据集横向对比
| 数据集 | 受试者 | 传感配置 | 活动数 | 本库 rid | 定位差异 |
|---|---|---|---|---|---|
| UCI HAR(本条目) | 30 | 单机腰挂(加速度+陀螺) | 6 | 本条目 | 智能手机 HAR 的「最小干净基准」 |
| MHEALTH | 10 | 三台 Shimmer2(胸/踝/前臂,含 ECG) | 12 | 222 | 多节点、多模态,含生理信号 |
| PAMAP2 | 9 | 三节点 IMU + 心率 | 18 | 212 | 活动更细、协议更丰富 |
| WISDM | 51 | 手机+手表双设备 | 18 | 1076 | 双设备、无脚本约束 |
| SisFall | 多 | 腰/大腿 IMU | 跌倒/ADL | 1075 | 面向跌倒检测,非通用 HAR |
UCI HAR 的独特性在于:它以最少的硬件换取了最干净的基准,因而成为论文做对比实验时的「默认起点」。当研究需要更丰富的模态或更细的活动粒度时,才会转向 MHEALTH / PAMAP2 / WISDM / SisFall。
§1.4 版本时间轴
| 时间 | 事件 | 来源 |
|---|---|---|
| 2012(UCI 记为 12/9/2012) | 数据集捐赠至 UCI Machine Learning Repository | UCI 官方页 Donated on |
| 2012-12-03 至 12-05 | IWAAL 2012 论文发表(硬件友好型多类 SVM,LNCS 7657, pp. 216-223) | LNCS |
| 2013-04-24 至 04-26 | ESANN 2013 主论文发表(Bruges, Belgium, pp. 437-442) | ESANN |
| 2013-05 | J. Universal Computer Science 固定点算术论文(Vol.19, Issue 9) | JUCS |
| 2013 及以后 | 被广泛引用为 HAR 基准,衍生大量复现与改进 | 社区 |
| 后续 | UCI 另存 updated 版(带姿态转换标签 + 完整原始信号) | UCI 官方 |
双口径存照(捐赠日期):UCI 只写 “12/9/2012”。按美国 MM/DD/YYYY 惯例读作 2012-12-09;按 DD/MM/YYYY 则读作 2012-09-12。本页面并存照两种读法。
双口径存照(论文年份):UCI 页标论文 Year=2013,与 ESANN 2013 会议吻合;个别转载源不列 year 或按抓取年转写,以会议实际时间 2013-04 为准。
§1.5 典型应用场景
- 活动识别基准测试:6 类分类,最经典的入口任务;
- 特征工程研究:561 维高度冗余,是特征选择/降维的天然试验场;
- 传感器融合消融:对比「仅加速度」「仅陀螺仪」「融合」的增益;
- 受试者无关泛化:LOSO / 受试者级划分下的性能评估;
- 模型轻量化:因原始论文即以手机端部署立题,适合研究端侧小模型;
- 无监督表示学习:用 561 特征或原始信号做自编码器与聚类;
- 教学:从信号处理到特征工程到模型选择的完整链路。
§1.6 关键硬数字速查
| 项目 | 数值 |
|---|---|
| 受试者数 | 30(19-48 岁) |
| 活动类别数 | 6 |
| 总样本数 | 10,299(train 7,352 / test 2,947) |
| 特征维度 | 561 |
| 采样率 | 50 Hz |
| 滑窗长度 / 重叠 / 每窗读数 | 2.56 秒 / 50% / 128 |
| 低通截止频率 | 0.3 Hz |
| 设备 | Samsung Galaxy S II |
| 打包体积 | 58.2 MB |
| 划分 | 受试者级 70/30 |
| 许可 / DOI | CC BY 4.0 / 10.24432/C54S4K |
§2 医学与健康背景
§2.1 临床概念映射表
UCI HAR 并非临床数据集(受试者均为健康志愿者),但活动识别技术本身在临床与健康场景中有明确的落点。下表给出活动标签与 ICD-11 相关章节的场景映射(非诊断映射):
| 活动类别 | 临床/健康关联场景 | ICD-11 相关章节(场景映射) |
|---|---|---|
| WALKING(行走) | 步态评估、术后活动能力康复 | 21 症状与体征(步态异常 MF48 等) |
| WALKING_UPSTAIRS / DOWNSTAIRS(上下楼) | 心肺功能负荷、膝关节退变评估 | 21 症状与体征;15 肌肉骨骼系统 |
| SITTING(坐着) | 久坐行为监测、代谢风险研究 | 06 精神/行为;久坐行为与代谢综合征关联 |
| STANDING(站立) | 体位性低血压、平衡能力 | 21 症状与体征(体位相关) |
| LAYING(平躺) | 卧床时间监测、睡眠/休息模式 | 07 睡眠-觉醒障碍(场景) |
说明:上表为场景映射,用于说明活动识别技术在健康监测中的潜在用途,不是说 UCI HAR 带有任何临床标签或诊断价值。
§2.1b SNOMED CT 映射表
| 活动相关的临床概念 | SNOMED CT 概念(示例) | 用途 |
|---|---|---|
| 步态 | Gait (observable entity) | 步态分析 |
| 身体活动 | Physical activity (observable entity) | 活动水平监测 |
| 体位 | Body position (observable entity) | 体位监测 |
| 跌倒风险 | Fall risk assessment (procedure) | 相关衍生场景 |
同 §2.1,此为场景映射,非数据集自带标注。
§2.2 健康背景与流行病学
- 可穿戴活动监测的医疗意义:全球范围内,缺乏身体活动(physical inactivity)是多种慢病(心血管疾病、2 型糖尿病、部分肿瘤)的重要可改变风险因素。客观、可穿戴的身体活动监测,是公共健康研究与慢病管理的关键工具。
- 活动识别是监测的技术前提:只有先能「识别」出人在做什么(走路、坐着、上下楼),才能进一步统计活动量、久坐时长、步态质量等指标。
- 跌倒与老年健康:对老年人群,跌倒检测(如 SisFall 数据集所针对的任务)是活动识别技术最直接的健康应用之一。
- 康复评估:术后或卒中后的步行能力评估,本质上是一个活动识别的细分任务。
§2.3 任务定义
核心任务:给定一个滑窗的传感器观测,预测其所属的 6 类活动之一。形式化为多类分类问题,评价指标以 accuracy 为主,辅以 macro-F1 与混淆矩阵。
次要任务:
- 特征选择 / 降维:在 561 维中寻找紧凑特征子集;
- 传感器融合消融:评估不同传感模态的贡献;
- 表示学习 / 聚类:无监督地发现活动的自然 grouping;
- 迁移学习:跨受试者、跨设备、跨佩戴位置的域适应。
§2.4 受试者人群表
| 属性 | 说明 | 来源 |
|---|---|---|
| 人数 | 30 名志愿者 | UCI 官方 |
| 年龄 | 19-48 岁 | UCI 官方 |
| 健康状况 | 健康(无疾病记录) | UCI 官方 |
| 招募来源 | 两所欧洲高校(热那亚、加泰罗尼亚)的志愿者范围 | 论文机构 |
| 性别分布 | 官方未披露 | UCI 官方未提供 |
| 排除标准 | 官方未披露 | UCI 官方未提供 |
| 语言文化 | 欧洲(意大利/西班牙)背景 | 论文机构 |
偏倚提示:受试者为健康年轻成人,年龄上限 48 岁,无老年与行动障碍人群。模型迁移至其他人群时需额外数据或域适应(见 §7.1)。
§2.5 健康/研究价值
- 方法学基准价值:为可穿戴活动识别的方法比较提供公平、可复现的公共舞台;
- 技术迁移价值:其信号处理与评测范式可直接迁移到临床可穿戴研究;
- 教育价值:从原始信号到特征到模型,是一条完整的教学链路;
- 失败反思价值:随机划分导致的虚高,是提醒研究者「真实部署面对陌生人」的活教材。
§2.6 金标准与前序数据表
| 参照对象 | 说明 | 与 UCI HAR 的关系 |
|---|---|---|
| Opportunity 项目 | 72 个环境与体表传感器的 ADL 数据集 | 论文中作为同期公开数据对照 |
| 早期单加速计 HAR 工作 | 使用专用穿戴传感器的方案 | UCI HAR 用手机替代专用传感器 |
| 临床步态分析(Lab-based) | 实验室光学动捕金标准 | UCI HAR 是低成本替代方案,精度不追求临床级 |
§2.7 活动识别技术演进与 UCI HAR 的历史位置
理解 UCI HAR 在 HAR 技术史中的位置,有助于判断它适合承担什么角色。
第一代(专用传感器时代,2000 年代初):研究者把加速度计绑在身体多个部位,用多节点网络采集。优点是信号质量可控,缺点是穿戴不便、长期监测不可行(穿衣后位置漂移、需重新校准)。这一代的数据集往往传感器数量多、但样本少。
第二代(智能手机时代,2010 年代初):随着智能手机普及,内置加速度计与陀螺仪成为「人人都有」的传感源。UCI HAR 正是这一代的开创性代表——它证明了单机腰挂也能支撑 6 类活动的可靠识别。它同时确立了这一代的方法论:滑窗 + 手工特征 + 经典分类器。
第三代(深度与多设备时代,2015 年至今):CNN/LSTM 端到端模型、手机+手表双设备(如 WISDM)、多节点多模态(如 MHEALTH、PAMAP2)。这一代数据集的模态更丰富、活动更细、场景更自然。
UCI HAR 横跨第二代向第三代过渡的节点:
- 它的方法论(滑窗特征 + 受试者划分)被第三代继承;
- 它的硬件局限(单机、单一位置)正是第三代要突破的对象;
- 它的规模局限(30 人、10,299 样本)催生了更大规模的数据集。
因此,把 UCI HAR 当作「学习 HAR 方法论的第一块地基」是恰当的,把它当作「覆盖所有 HAR 场景的万能基线」则是不恰当的。
§2.8 与千方病案医数集定位的说明
UCI HAR 被纳入千方病案医数集的「AI-Ready Wikipedia」,并非因为它本身是临床数据,而是因为:
- 它是可穿戴健康监测这一医学 AI 分支的奠基性公开基准;
- 其方法论(受控采集、滑窗特征、受试者隔离、许可透明)直接迁移到临床可穿戴研究;
- 它是理解同域医学数据集(MHEALTH、PPG-DaLiA 等)的入门参照。
本页面因此将它定位为「健康行为理解的通用基准」,而非「临床数据集」,并在 §2.1、§7.4、§7.5 中反复强调其边界。读者若需要直接的临床标签数据,应转向专门的临床队列或生理信号数据集。
§3 数据集规格
§3.0 版本抉择矩阵
UCI 上的 HAR 相关资源至少有两个版本,选择时务必先确认:
| 版本 | 活动类别体系 | 原始信号 | 适用场景 | 获取 |
|---|---|---|---|---|
| UCI HAR 原始版(本条目) | 6 类(WALKING/UP/DOWN/SITTING/STANDING/LAYING) | 提供窗内 128 点原始序列(Inertial Signals)+ 561 特征 | 经典 6 类基准、与文献对比 | dataset id=240 |
| updated 版 | 6 类 + 活动间姿态转换类 | 提供完整原始惯性信号 | 转换检测、从原始信号自建特征 | 独立页面 |
选择纪律:需要与经典基准对比 → 用原始版;需要活动切换语义或完整原始波形 → 用 updated 版。两者不可混用(见 §6.5 坑点 6)。
§3.1 模态详情
| 模态 | 物理量 | 分量 | 采样率 | 说明 |
|---|---|---|---|---|
| 加速度计 | 三轴线性加速度(含重力) | X/Y/Z | 50 Hz | 经滤波后分离为体加速度 + 重力 |
| 陀螺仪 | 三轴角速度 | X/Y/Z | 50 Hz | 直接使用 |
信号经预处理后派生出多个信号族:
- 体加速度
body_acc_x/y/z、总加速度total_acc_x/y/z; - 体角速度
body_gyro_x/y/z; - 由体加速度、体角速度进一步派生的 jerk 信号(数值上由窗内序列计算得到,体现在 561 特征中)。
§3.2 按子集样本数表
| 子集 | 样本行数 | 特征列 | 受试者文件 | 说明 |
|---|---|---|---|---|
| train | 7,352 | 561 | subject_train.txt(约 21 人) | 训练集 |
| test | 2,947 | 561 | subject_test.txt(约 9 人) | 测试集 |
| 合计 | 10,299 | 561 | 受试者 1-30 | 官方口径 |
训练/测试行数比约 71.4% / 28.6%,是按受试者划分(21/30 ≈ 70%)的连带结果,而非直接按样本比例划分。
§3.3 格式表
| 文件 | 格式 | 说明 |
|---|---|---|
| X_train.txt / X_test.txt | 空格分隔浮点文本 | 561 列特征矩阵,无表头 |
| y_train.txt / y_test.txt | 整数文本 | 活动标签 1-6,单列 |
| subject_train.txt / subject_test.txt | 整数文本 | 受试者 ID 1-30,单列 |
| features.txt | 文本 | 561 个特征名的列名表 |
| activity_labels.txt | 文本 | 6 类活动 ID → 名称映射 |
| features_info.txt / README.txt | 文本 | 特征构造说明与文档 |
| Inertial Signals/*.txt | 空格分隔浮点文本 | 窗内 128 点原始序列(9 个文件 × train/test) |
§3.4 存储大小
| 项目 | 大小 | 来源 |
|---|---|---|
| UCI HAR Dataset.zip | 58.2 MB | UCI 官方 Dataset Files |
| UCI HAR Dataset.names | 6.2 KB | UCI 官方 Dataset Files |
| 解压后目录 | 约略大于压缩包(纯文本) | 以实际解压为准 |
§3.5 标注方式
- 标注类型:活动类别标签(6 类);
- 标注手段:实验全程视频录制,事后人工标注;
- 标注粒度:以滑窗为单位(每个 2.56 秒窗口一个标签);
- 标签来源:按脚本协议执行的活动,标注相对可靠;
- 边界样本:活动切换瞬间的窗口标签存在模糊性(updated 版专门补了姿态转换标签)。
§3.6 标注者资质与一致性
UCI 官方未披露标注者的资质与一致性统计(kappa 等)。标注基于视频回放与脚本协议,主观歧义相对可控,但官方未提供标注间一致性指标是文档的一处缺口。
§3.7 采集周期
官方未披露完整的采集起止日期。可确认的是:数据集于 2012 年捐赠至 UCI,论文于 2012-2013 年发表,采集发生在此之前的某一时段。
§3.8 地域覆盖
采集在意大利热那亚与西班牙加泰罗尼亚两地的高校进行(作者机构所在地)。受试者族群集中于南欧,文化背景与活动习惯相对单一。
§3.9 设备规格
| 项目 | 规格 |
|---|---|
| 手机型号 | Samsung Galaxy S II |
| 佩戴位置 | 腰部(waist-mounted,固定朝向) |
| 传感器 | 内置三轴加速度计 + 三轴陀螺仪 |
| 采样率 | 50 Hz(恒定) |
| 量程 / 精度 | 官方未披露 |
| 固定方式 | 官方未详细披露(通常为腰包或绑带) |
§3.10 深度溯源链
实验设计(30 志愿者 × 6 活动协议)
   ↓
Samsung Galaxy S II 腰挂采集(加速度计 + 陀螺仪,50 Hz)
   ↓
噪声滤波
   ↓
滑窗切分(2.56 s,50% 重叠,128 读数/窗)
   ↓
Butterworth 低通分离(0.3 Hz)→ body / gravity 分量
   ↓
时域 + 频域特征提取(561 维/窗)
   ↓
随机按受试者 70/30 划分
   ↓
UCI Machine Learning Repository 发布(dataset id=240)
§3.11 与同类数据集的规格对齐差异
| 维度 | UCI HAR | MHEALTH | PAMAP2 | WISDM |
|---|---|---|---|---|
| 受试者数 | 30 | 10 | 9 | 51 |
| 传感节点 | 1(腰) | 3(胸/踝/前臂) | 3(手/胸/踝) | 2(手机/手表) |
| 生理信号 | 无 | 2 导联 ECG | 心率 | 无 |
| 活动数 | 6 | 12 | 18 | 18 |
| 采样率 | 50 Hz | 50 Hz | 100 Hz | 20 Hz |
| 官方划分 | 有(subject-wise 70/30) | 无 | 无 | 无 |
UCI HAR 在「受试者数」与「官方划分」两项上占优,在「模态丰富度」与「活动粒度」上较弱——这正是它与同域其他数据集互补的地方。
§4 数据结构
§4.0 目录树
UCI HAR Dataset/
├── README.txt                   # 数据集总说明
├── activity_labels.txt          # 6 类活动 ID → 名称映射
├── features.txt                 # 561 特征名(列名表,两列:序号 + 名称)
├── features_info.txt            # 特征构造说明(命名体系与物理含义)
├── train/
│   ├── X_train.txt              # (7352, 561) 特征矩阵
│   ├── y_train.txt              # (7352,) 活动标签 1-6
│   ├── subject_train.txt        # (7352,) 受试者 ID 1-30
│   └── Inertial Signals/
│       ├── body_acc_x_train.txt   # (7352, 128) 体加速度 X 轴
│       ├── body_acc_y_train.txt
│       ├── body_acc_z_train.txt
│       ├── body_gyro_x_train.txt  # 体角速度
│       ├── body_gyro_y_train.txt
│       ├── body_gyro_z_train.txt
│       ├── total_acc_x_train.txt  # 总加速度
│       ├── total_acc_y_train.txt
│       └── total_acc_z_train.txt
└── test/
    ├── X_test.txt               # (2947, 561)
    ├── y_test.txt               # (2947,)
    ├── subject_test.txt         # (2947,)
    └── Inertial Signals/        # 同 train 结构(9 个文件)
行对齐铁律:X_train.txt、y_train.txt、subject_train.txt 的第 i 行属于同一个滑窗。三支文件必须同步读入、同步切分(见 §6.5 坑点 3)。
§4.1 DAIMS 字段字典
561 维特征无法逐列穷举,此处给出字段族字典(按命名前缀聚合),另附三支伴随文件字段:
| 字段族(前缀) | 类型 | 说明 | 物理含义 | 大致维度 | 取值范围 |
|---|---|---|---|---|---|
tBodyAcc-* |
float | 时域体加速度统计量 | 去除重力后的体动加速度 | 数十 | 标准化后约 [-1,1] |
tGravityAcc-* |
float | 时域重力加速度统计量 | 重力在设备三轴上的投影 | 数十 | 标准化后约 [-1,1] |
tBodyAccJerk-* |
float | 时域体加速度 jerk | 加速度的变化率 | 数十 | 标准化后约 [-1,1] |
tBodyGyro-* |
float | 时域体角速度统计量 | 三轴旋转速率 | 数十 | 标准化后约 [-1,1] |
tBodyGyroJerk-* |
float | 时域体角速度 jerk | 角速度的变化率 | 数十 | 标准化后约 [-1,1] |
tBodyAccMag 等 |
float | 时域各信号幅值 | 三轴合成标量(旋转不变) | 每族约 13 | 标准化后约 [-1,1] |
fBodyAcc-* / fBodyGyro-* 等 |
float | 频域统计量 | FFT 后的均值频率/频带能量等 | 数百(占比最大) | 标准化后约 [-1,1] |
angle(*, gravityMean) |
float | 夹角特征 | 各信号均值向量与重力方向夹角 | 7 | 弧度/度(官方未明示单位) |
| y_*.txt 的 label | int | 活动标签 | 6 类活动 ID | 1 列 | 1-6 |
| subject_*.txt 的 id | int | 受试者标识 | 1-30 | 1 列 | 1-30 |
列数口径存照:UCI 官方口径为 561 特征;MaRDI / OpenML(id=1478)记 562 列 = 561 数值 + 1 符号(分组列)。本页以 561 特征为主口径,标签与受试者 ID 作为独立伴随文件提供。
命名提示:字段中出现的
BodyBody(如fBodyBodyAccJerkMag)是历史命名沿袭,不代表两层体成分,应作为单一前缀处理(见 §6.5 坑点 4)。
§4.2 特征族分布
561 维并非均匀分布,而是集中于几个大族:
| 特征族 | 含义 | 相对占比 |
|---|---|---|
tBodyAcc-* / tGravityAcc-* / tBodyAccJerk-* |
时域加速度类 | 中等 |
tBodyGyro-* / tBodyGyroJerk-* |
时域角速度类 | 中等 |
*Mag-*(时域与频域幅值) |
幅值类 | 每族约 13 维 |
fBodyAcc-* / fBodyAccJerk-* / fBodyGyro-* |
频域主要族 | 占比最大(数百维) |
angle(*, gravityMean) |
夹角类 | 尾部 7 维 |
结构性结论:频域特征占比最大,反映「活动的频域可分性高于时域」这一物理事实。
§4.3 标签分布
| 标签 | 活动 | 类型 | 窗数特征 |
|---|---|---|---|
| 1 | WALKING | 运动 | 由行走时长决定 |
| 2 | WALKING_UPSTAIRS | 运动 | 片段较短,窗数相对少 |
| 3 | WALKING_DOWNSTAIRS | 运动 | 片段较短,窗数相对少 |
| 4 | SITTING | 静态 | 静态维持时间长,窗数较多 |
| 5 | STANDING | 静态 | 静态维持时间长,窗数较多 |
| 6 | LAYING | 静态 | 静态维持时间长,窗数较多 |
- 近似均衡而非严格均衡:各类窗数由活动时长决定,量级相近但不相等,因此 accuracy 与 macro-F1 通常不会极端背离;
- 精确分布需自行统计:本页未逐类核录精确窗数,使用时应
np.bincount(y)核对,并据此决定是否加权或分层抽样。
§4.4 数据层级
受试者(30 人,1-30)
   └── 滑窗样本(10,299 个)
          ├── 561 维特征向量(X_*.txt)
          ├── 活动标签(y_*.txt,1-6)
          └── 受试者 ID(subject_*.txt,1-30)
                 └── 窗内原始序列(Inertial Signals,128 点 × 9 信号)
两个层级最重要:受试者层(决定划分与防泄漏)与滑窗层(决定样本与标签)。
§4.5 缺失值与信息性缺失编码
- UCI 官方明确标注 Has Missing Values? = No;
- 数据集发布前已完成去噪、切窗与特征提取,不存在需要插补的空洞;
- 无信息性缺失编码机制(如 -1 / NaN 哨兵值)。
§4.6 常见载入错误诊断
| 症状 | 可能原因 | 排查 |
|---|---|---|
| 标签与特征错配 | 三支文件未同步读入/shuffle | 检查是否只打乱了 X(坑点 3) |
| 列数为 562 | 误用 OpenML 镜像(含分组列) | 核对列数与 features.txt(坑点 7) |
| 结果异常好 | 随机划分导致受试者泄漏 | 改用官方 subject-wise(坑点 1) |
| 端到端模型效果差 | 把 561 特征喂给序列模型 | 改用 Inertial Signals(坑点 5) |
| 出现未知类别 | 误用 updated 版标签体系 | 核对版本(坑点 6) |
§5 划分与使用建议
§5.1 官方划分
官方把 30 名受试者随机分成两组:
- 训练集:约 70%(21 人),对应
subject_train.txt; - 测试集:约 30%(9 人),对应
subject_test.txt。
关键性质:训练与测试的受试者集合完全不重叠。这是官方划分最有价值的设计——它从源头堵死了受试者泄漏。
核验方法:
import numpy as np
subj_tr = np.loadtxt("UCI HAR Dataset/train/subject_train.txt").astype(int)
subj_te = np.loadtxt("UCI HAR Dataset/test/subject_test.txt").astype(int)
print("train 受试者:", sorted(set(subj_tr)))   # 约 21 人
print("test  受试者:", sorted(set(subj_te)))    # 约 9 人
assert set(subj_tr).isdisjoint(set(subj_te)), "受试者泄漏!"
§5.2 社区惯例划分
除官方划分外,社区还常用:
- LOSO(Leave-One-Subject-Out):每次留出一个人做测试,共 30 折,取均值与标准差。最能反映受试者无关泛化;
- K 折受试者分组:把 30 人分成 K 组做交叉验证;
- 随机划分(不推荐作为主结果):把样本随机打散,会引入受试者泄漏。
§5.3 划分策略建议与泄漏风险 ⭐
这是使用 UCI HAR 最重要的一节。
| 协议 | 是否泄漏 | 结果量级 | 建议 |
|---|---|---|---|
| 官方 subject-wise 70/30 | 否 | 基准水平 | 与文献对比时的首选 |
| LOSO | 否 | 最真实 | 报告泛化能力的首选 |
| 随机划分 | 是 | 显著虚高 | 仅作上界参考,不作主结果 |
受试者泄漏的原理:同一受试者的不同滑窗高度自相似,模型只需「记住这个人怎么走」,测试时遇到同一个人就能蒙对。随机划分把同一人的窗同时分进训练与测试,人为制造了这种作弊机会。
同域印证:库内 MHEALTH(222) 条目记录了同一现象——「同一模型 10-fold CV 99.85% vs LOSOCV 85.1%,差 14.7 个百分点」。UCI HAR 与 MHEALTH 共享这一方法论陷阱,这是 HAR 领域的通病而非个别数据集的问题。
§5.4 交叉验证建议
- 报告多种子标准差:单次官方划分测试集仅约 9 人,性能估计置信区间较宽;
- 优先 LOSO 或多次受试者分组 CV:给出均值 ± 标准差,而非单点;
- 避免用测试集调参:任何超参选择应在训练集内部再做划分。
§5.5 外部验证建议
- 跨数据集验证:与 MHEALTH / PAMAP2 等对齐单位与采样率后做迁移测试;
- 跨佩戴位置验证:腰部训练的模型迁移到口袋/手持场景,量化域偏移;
- 跨人群验证:迁移到老年或行动障碍人群前,必须补充目标人群数据。
§6 AI 就绪指南
§6.0 云端快速启动
# 方式一:官方 Python 包(推荐)
pip install ucimlrepo

# 方式二:直接下载压缩包(约 58.2 MB)
curl -L -o uci_har.zip \
  "https://archive.ics.uci.edu/static/public/240/human+activity+recognition+using+smartphones.zip"
unzip uci_har.zip
# 官方一行获取(id=240 对应 UCI HAR)
from ucimlrepo import fetch_ucirepo
ds = fetch_ucirepo(id=240)
print(ds.metadata)
§6.1 快速上手
import numpy as np
import pandas as pd

BASE = "UCI HAR Dataset"

def load_split(split):        # split in {"train", "test"}
    X = np.loadtxt(f"{BASE}/{split}/X_{split}.txt")
    y = np.loadtxt(f"{BASE}/{split}/y_{split}.txt").astype(int)
    s = np.loadtxt(f"{BASE}/{split}/subject_{split}.txt").astype(int)
    assert X.shape[0] == y.shape[0] == s.shape[0], "三支文件行数不一致!"
    return X, y, s

Xtr, ytr, str_ = load_split("train")   # (7352, 561)
Xte, yte, ste = load_split("test")     # (2947, 561)

# 防泄漏断言
assert set(str_).isdisjoint(set(ste)), "训练测试受试者重叠,存在泄漏!"

# 读取列名与标签映射
feat_names = [l.split()[1] for l in open(f"{BASE}/features.txt")]
act_map = {int(l.split()[0]): l.split()[1] for l in open(f"{BASE}/activity_labels.txt")}
print("特征数:", len(feat_names))       # 561
print("活动映射:", act_map)
目录结构预期(解压后):
UCI HAR Dataset/
├── features.txt / activity_labels.txt / README.txt
├── train/  (X_train.txt, y_train.txt, subject_train.txt, Inertial Signals/)
└── test/   (X_test.txt, y_test.txt, subject_test.txt, Inertial Signals/)
§6.2 数据获取
| 渠道 | 地址 | 说明 |
|---|---|---|
| UCI 官方主页 | https://archive.ics.uci.edu/dataset/240/human+activity+recognition+using+smartphones | 变量表 + 引用 |
| UCI 官方下载 | https://archive.ics.uci.edu/static/public/240/human+activity+recognition+using+smartphones.zip | 58.2 MB |
| DOI | https://doi.org/10.24432/C54S4K | 引用锚点 |
| 程序化 | fetch_ucirepo(id=240) |
官方 Python 包 |
§6.3 预处理全流程
官方已完成的预处理(无需自己重做):
- 噪声滤波;
- 2.56 秒滑窗、50% 重叠(128 读数/窗);
- Butterworth 低通(0.3 Hz)分离体加速度与重力;
- 每窗 561 维时频特征提取。
使用 561 特征时,官方特征已做过向 [-1,1] 的标准化(gravity/body 各分量),因此通常无需再标准化;但若对特征做筛选或拼接,仍建议核对量纲。若使用 Inertial Signals 原始序列,则必须自行标准化。
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

# 若需标准化:只在训练集上 fit!
scaler = StandardScaler().fit(Xtr)
Xtr_s, Xte_s = scaler.transform(Xtr), scaler.transform(Xte)
§6.4 PyTorch DataLoader(端到端路线)
若走端到端深度模型,改从 Inertial Signals 读入窗内 128 点序列:
import torch
from torch.utils.data import Dataset, DataLoader

class HARDataset(Dataset):
    def __init__(self, split):
        sigs = []
        for axis in ["x", "y", "z"]:
            sigs.append(np.loadtxt(f"{BASE}/{split}/Inertial Signals/body_acc_{axis}_{split}.txt"))
            sigs.append(np.loadtxt(f"{BASE}/{split}/Inertial Signals/body_gyro_{axis}_{split}.txt"))
            sigs.append(np.loadtxt(f"{BASE}/{split}/Inertial Signals/total_acc_{axis}_{split}.txt"))
        # 堆叠为 (N, 9, 128)
        self.X = np.stack(sigs, axis=1).astype(np.float32)
        self.y = np.loadtxt(f"{BASE}/{split}/y_{split}.txt").astype(int) - 1  # 0-5

    def __len__(self):
        return len(self.y)

    def __getitem__(self, i):
        return torch.tensor(self.X[i]), torch.tensor(self.y[i])

loader = DataLoader(HARDataset("train"), batch_size=64, shuffle=True)
§6.5 坑点 8 个
坑点 1:把随机划分当官方划分,性能虚高十几个百分点
表现:模型报出接近饱和的准确率,声称在 UCI HAR 上「接近解决」。
根因:自行 train_test_split 会把同一受试者的窗同时分进训练与测试,产生受试者泄漏。
规避:始终用官方 subject_*.txt 划分,或用 LOSO。跨论文对比前先确认对方划分方式。
坑点 2:SITTING / STANDING / LAYING 的混淆陷阱
表现:模型在这三类静态活动间频繁互错,尤其 SITTING 与 STANDING。
根因:三者信号以重力(直流)为主导,SITTING 与 STANDING 的腰部重力方向差异很小,体动成分又都微弱。
规避:利用陀螺仪微小角速度差异、频域特征与夹角特征;或坦承这是数据集的物理上限。
坑点 3:三支文件行序错位导致静默标签错配
表现:训练损失正常但准确率异常低,换随机种子后剧烈波动。
根因:X/y/subject 三支文件靠行号对齐,只 shuffle X 而不 shuffle y/subject 就会错配。
规避:三支文件同步读入、统一索引切分;加载后抽查标签分布。
坑点 4:BodyBody 命名易被误读
表现:把 fBodyBodyAccJerkMag 误判为两个独立体成分。
根因:频域幅值特征沿袭出现重复 Body 前缀,是历史写法。
规避:把 BodyBody 当单一前缀处理,不按字面切分。
坑点 5:把 561 特征喂给需要波形的深度模型
表现:想用 CNN/LSTM 端到端学习,却输入已聚合的 561 统计量,结果平庸。
根因:561 维是每窗聚合统计量,时序结构已被抹平。
规避:端到端模型用 Inertial Signals 的 128 点序列;经典模型用 561 特征。
坑点 6:把 updated 版与本版混为一谈
表现:论文声称用 UCI HAR,却报告了姿态转换类的结果。
根因:updated 版(带 postural transitions)类别体系不同,且提供完整原始信号。
规避:明确区分两版;6 类基准用本版,转换语义用 updated 版,并写明版本。
坑点 7:忽略「列数 561 vs 562」的镜像差异
表现:从 OpenML 拉取得到 562 列,与官方 561 特征不符。
根因:OpenML(id=1478)把分组标签列也计入列数。
规避:以 UCI 官方 561 特征为准;拉镜像后核对列名,剔除分组列再建模。
坑点 8:标准化在全集上 fit 造成泄漏
表现:结果异常好,尤其在小测试集上。
根因:若无官方划分、或对合并后的数据做 StandardScaler().fit(X_all),测试集统计量会泄漏进训练。
规避:任何预处理(标准化、特征选择)只在训练集上 fit,再 transform 测试集。
§6.6 数据增强
针对小样本可谨慎使用增强(须在训练集内做,且不破坏物理一致性):
- 加性噪声:在原始信号上加小高斯噪声;
- 时间缩放 / 抖动:轻微拉伸窗内序列;
- 通道置换(旋转近似):仅在理论上旋转不变的任务上使用;
- 窗级重采样:缓解类别不平衡。
注意:增强不能改变标签语义,也不应在测试集上应用。
§6.7 模型推荐表
| 路线 | 输入 | 推荐模型 | 适用 |
|---|---|---|---|
| 经典 | 561 特征 | SVM、随机森林、XGBoost | 快速基线、特征选择研究 |
| 端到端 | Inertial Signals | 1D-CNN、LSTM、CNN-LSTM | 自动表征学习 |
| 混合 | 特征 + 深度表征 | 拼接后浅层分类器 | 兼顾先验与学习 |
| 轻量部署 | 561 特征 | 硬件友好型 SVM、小型 MLP | 端侧推理 |
§6.8 硬件需求表
| 路线 | 显存/内存 | 训练时长(量级) |
|---|---|---|
| 经典(CPU) | < 2 GB | 分钟级 |
| 经典(GPU 可选) | < 2 GB | 分钟级 |
| 端到端深模型 | 4-8 GB GPU | 分钟到小时级 |
UCI HAR 体量极小(10,299 样本),绝大多数实验在笔记本 CPU 上即可完成。
§6.9 评估指标代码
from sklearn.metrics import accuracy_score, f1_score, classification_report, confusion_matrix
import numpy as np

pred = clf.predict(Xte)
print("accuracy:", accuracy_score(yte, pred))
print("macro-F1:", f1_score(yte, pred, average="macro"))
print(classification_report(yte, pred,
      target_names=[act_map[i] for i in sorted(act_map)], digits=4))
print(confusion_matrix(yte, pred))

# LOSO 多折均值 ± 标准差(推荐)
from sklearn.model_selection import LeaveOneGroupOut
X = np.vstack([Xtr, Xte]); y = np.concatenate([ytr, yte])
groups = np.concatenate([str_, ste])
scores = [accuracy_score(y[te], clf.fit(X[tr], y[tr]).predict(X[te]))
          for tr, te in LeaveOneGroupOut().split(X, y, groups)]
print(f"LOSO acc: {np.mean(scores):.4f} ± {np.std(scores):.4f}")
§6.10 MLOps 笔记
- 可复现:固定随机种子、记录特征选择与划分协议;
- 版本锚定:记录使用 UCI HAR 原始版还是 updated 版;
- 输入表示登记:标明 561 特征 / Inertial Signals;
- 漂移监控:跨设备、跨佩戴位置部署时监控分布偏移;
- 回归基线:把官方 subject-wise 划分的结果作为回归基线固化。
§6.11 完整基线复现脚本
下面给出一个可直接运行的完整基线脚本,涵盖数据加载、防泄漏核验、训练、官方划分与 LOSO 双协议评估。
"""UCI HAR 完整基线:经典模型 + 双协议评估。"""
import numpy as np
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.metrics import accuracy_score, classification_report
from sklearn.model_selection import LeaveOneGroupOut

BASE = "UCI HAR Dataset"

def load_split(split):
    X = np.loadtxt(f"{BASE}/{split}/X_{split}.txt")
    y = np.loadtxt(f"{BASE}/{split}/y_{split}.txt").astype(int)
    s = np.loadtxt(f"{BASE}/{split}/subject_{split}.txt").astype(int)
    assert X.shape[0] == y.shape[0] == s.shape[0]
    return X, y, s

act_map = {int(l.split()[0]): l.split()[1]
           for l in open(f"{BASE}/activity_labels.txt")}
names = [act_map[i] for i in sorted(act_map)]

Xtr, ytr, str_ = load_split("train")
Xte, yte, ste = load_split("test")
assert set(str_).isdisjoint(set(ste)), "受试者泄漏!"

# ---- 协议 A:官方 subject-wise 划分 ----
clf = make_pipeline(StandardScaler(), SVC(kernel="rbf", C=10, gamma="scale"))
clf.fit(Xtr, ytr)
pred = clf.predict(Xte)
print("[官方划分] accuracy:", round(accuracy_score(yte, pred), 4))
print(classification_report(yte, pred, target_names=names, digits=3))

# ---- 协议 B:LOSO 留一受试者交叉验证 ----
X = np.vstack([Xtr, Xte]); y = np.concatenate([ytr, yte])
groups = np.concatenate([str_, ste])
scores = []
for tr, te in LeaveOneGroupOut().split(X, y, groups):
    m = make_pipeline(StandardScaler(), SVC(kernel="rbf", C=10, gamma="scale"))
    m.fit(X[tr], y[tr])
    scores.append(accuracy_score(y[te], m.predict(X[te])))
print(f"[LOSO] accuracy: {np.mean(scores):.4f} ± {np.std(scores):.4f} ({len(scores)} 折)")
预期观察:
- 官方划分的准确率落在较高区间;
- LOSO 的均值会低于官方划分的单点,但其 ± 标准差才真正刻画了跨受试者泛化能力;
- 两类协议的差距,正是 §5.3 所述「诚实度」的量化体现。
§6.12 论文报告模板
推荐在论文方法或实验章节中,用如下模板记录关键设定:
我们在 UCI HAR(原始 6 类版,[Anguita et al., 2013])上评估。输入为官方 561 维时频特征,仅在训练集上做标准化。评估采用两种协议:(a) 官方受试者级 70/30 划分;(b) 留一受试者交叉验证(LOSO,30 折),报告均值与标准差。我们强调,随机样本划分会引入受试者泄漏,因此不作为主结果报告。
这段模板把「版本 + 输入 + 协议 + 防泄漏声明」四要素一次写清,可直接复用。
§7 质量评估与局限性
§7.1 已知偏倚表
| 偏倚类型 | 说明 | 影响 |
|---|---|---|
| 人群偏倚 | 健康年轻成人(19-48 岁),无老年/行动障碍者 | 迁移到其他人群性能下降 |
| 地域/文化偏倚 | 南欧两校招募,文化背景单一 | 活动习惯的泛化性受限 |
| 佩戴位置偏倚 | 固定腰部、固定朝向 | 迁移到手腕/口袋场景有域偏移 |
| 活动脚本化 | 6 类活动按协议执行,非自然行为 | 生态效度低于真实场景 |
| 静态活动重力主导 | SITTING/STANDING/LAYING 靠重力分量 | 简单模型可能靠重力方向「蒙对」 |
| 类别不均衡 | 窗数由活动时长决定 | accuracy 可能被大类抬高 |
§7.2 标注质量
- 标注基于视频回放与脚本协议,主活动段标签可靠;
- 活动切换瞬间的窗口标签存在模糊性(updated 版补了转换标签);
- 官方未提供标注间一致性(kappa)统计,是一处文档缺口。
§7.3 泛化性表
| 泛化维度 | 难度 | 说明 |
|---|---|---|
| 跨受试者 | 中-高 | 官方划分已隔离;LOSO 性能显著低于随机划分 |
| 跨佩戴位置 | 高 | 腰→口袋/手持有明显域偏移 |
| 跨设备 | 高 | 不同手机的采样与噪声特性不同 |
| 跨数据集 | 高 | 与其他 HAR 数据集对齐单位与协议后仍存差异 |
| 跨年龄人群 | 高 | 老年人步态模式与年轻人差异明显 |
§7.4 伦理
- 去标识化:不发布姓名、联系方式、病史;受试者仅以 1-30 引用;
- 知情同意:作者报告志愿者为自愿参与;
- 惯性信号的敏感度:运动时序本身非直接生物特征,但步态具一定个体特异性,不宜视为绝对匿名;
- 使用边界:不用于步态生物识别、未经授权的个体追踪。
§7.5 公平性
- 受试者人数仅 30,性别与人口学分布官方未披露,无法进行细粒度公平性分析;
- 潜在公平性风险:模型在不同年龄、性别、体型上的性能可能存在未量化的差异;
- 建议:若部署到多样性人群,须在目标人群中重新评估。
§7.6 数据漂移
- 设备漂移:Samsung Galaxy S II 为 2011 年机型,现代手机传感器特性不同;
- 行为漂移:十余年前的活动模式与当下(如步行速度、日常习惯)可能不同;
- 应用漂移:腰部佩戴在现代使用中占比下降,口袋/手持更常见。
§7.7 DAIMS 数据集评估 24 项
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 宽格式 | ✅ | 561 列单表特征矩阵,无嵌套 |
| 2 | 唯一标识 | ✅ | 行号 + 受试者 ID 可唯一索引 |
| 3 | 特殊字符 | ✅ | 纯数值空格分隔文本,无特殊字符风险 |
| 4 | 重复行 | ✅ | 滑窗 50% 重叠但样本非重复副本 |
| 5 | 缺失编码 | ✅ | 官方明确无缺失值 |
| 6 | 标签标识 | ✅ | y_*.txt 显式标签列,1-6 语义明确 |
| 7 | 罕见类分组 | ⚠️ | 类别不严格均衡,无官方罕见类指引 |
| 8 | 偏倚评估 | ⚠️ | 官方未提供;本页 §7.1 补充 |
| 9 | 数据字典 | ✅ | features.txt + features_info.txt + README 三层文档 |
| 10 | 信息性缺失解释 | ✅ | 无信息性缺失机制(确认为无缺失) |
| 11 | 设备记录 | ✅ | 机型(Galaxy S II)、位置(腰)、采样率均披露 |
| 12 | 共线性 | ⚠️ | 561 特征高度相关,官方未提供相关性说明 |
| 13 | 编码映射 | ✅ | activity_labels.txt 官方明确 |
| 14 | 时间戳处理 | ❌ | 无时间戳列,时间轴由行序隐含(50 Hz) |
| 15 | 划分建议 | ✅ | 官方 subject-wise 70/30 划分现成 |
| 16 | 泄漏讨论 | ⚠️ | 官方划分防泄漏,但未成文讨论泄漏风险 |
| 17 | 标签分布 | ✅ | 可由数据直接统计 |
| 18 | 测量偏倚 | ⚠️ | 固定方式与校准细节未完整披露 |
| 19 | 外部验证建议 | ⚠️ | 官方未提供;跨数据集验证需自行对齐 |
| 20 | 版本记录 | ⚠️ | 有 updated 版区分,但无正式版本号/变更日志 |
| 21 | 预处理脚本 | ✅ | 官方已完成预处理,特征可直接使用 |
| 22 | 合规要求 | ✅ | CC BY 4.0 清晰,署名即可 |
| 23 | 多模态对齐 | ✅ | 加速度与陀螺仪同频同步采集 |
| 24 | 去标识化 | ✅ | 不含个人标识信息 |
DAIMS 评分:19.5 / 24(✅ 计 1 分 × 15 项 + ⚠️ 计 0.5 分 × 9 项)
评分解读:UCI HAR 在「格式卫生」与「划分规范」两个维度接近满分——纯文本直读、无缺失、官方自带受试者级划分、文档三层齐备、许可清晰,属于教科书级的 AI-Ready 数据集。失分主要在「无时间戳列」与若干「官方未提供的分析资产」(偏倚分析、共线性说明、外部验证建议)。这些失分不是数据错误,而是 2012 年学术数据集发布形态的局限,意味着部分复现性责任转移到使用者一侧。
对你意味着什么:① 上手当天即可完成载入与训练,无需任何清洗或审批;② 但必须自行完成官方「未做的三件事」——决定是否 LOSO、核对类别分布、确认输入表示;③ 论文与生产配置中显式记录划分协议与版本,否则结果不可复现;④ 若用于产品,先接受它「健康年轻成人 + 2011 设备」的边界,再规划自有数据验证。
§7.8 外部验证矩阵
| 验证类型 | 目标数据集/场景 | 对齐工作 | 预期难点 |
|---|---|---|---|
| 跨数据集 | MHEALTH(222)、PAMAP2(212) | 单位、采样率、活动语义 | 活动类别体系不一致 |
| 跨设备 | 其他手机 IMU | 采样率重采样 | 噪声与量程差异 |
| 跨位置 | 口袋、手持 | 方向与动力学差异 | 域偏移显著 |
| 跨人群 | 老年、康复人群 | 步态差异 | 需目标人群数据 |
§8 基准性能与生态
§8.1 基准概览
重要说明:下表为量级参考,具体数值高度依赖划分协议与输入表示。凡未注明「受试者隔离」的报道,其绝对数值不可直接跨论文比较。
| 方法族 | 输入 | 划分 | 准确率量级 | 备注 |
|---|---|---|---|---|
| 多类硬件友好型 SVM(原始论文) | 561 特征 | 官方 subject-wise | 基准水平(论文口径约 96%) | ESANN 2013 |
| SVM / 随机森林 | 561 特征 | 官方 subject-wise | 高(受试者隔离下仍稳定) | 经典强基线 |
| XGBoost / 特征选择 + 浅层模型 | 精选特征 | 官方 subject-wise | 高 | 特征选择研究常用 |
| 1D-CNN / LSTM | Inertial Signals | 随机划分 | 很高(含泄漏) | 数值虚高 |
| 1D-CNN / LSTM | Inertial Signals | LOSO | 中等-高(真实) | 受试者无关 |
读法:同一方法在「随机划分」与「LOSO」之间的差距,比方法本身的差异更大。这再次印证 §5.3 的核心结论。
§8.2 SOTA 总结与选型建议
- 追求可复现的强基线:SVM / 随机森林 + 561 特征 + 官方划分,是一条几乎不会出错的路;
- 追求端侧部署:硬件友好型 SVM、小型 MLP,配合特征选择;
- 追求表征学习研究:端到端 CNN/LSTM,但必须用受试者隔离协议报告;
- 追求严谨对比:统一用 LOSO,报告均值 ± 标准差。
§8.3 评测协议
报告结果时至少写明三项:
| 项目 | 取值 |
|---|---|
| 数据集版本 | UCI HAR 原始 6 类版 / updated 版 |
| 输入表示 | 561 特征 / Inertial Signals 原始序列 |
| 划分协议 | 官方 subject-wise / 随机 / LOSO |
三项任一缺失,结果的可比性即大打折扣。
§8.4 相关数据集表
| 数据集 | 本库 rid | 关系 |
|---|---|---|
| MHEALTH | 222 | 同域最直接对照(多节点 + ECG) |
| PAMAP2 | 212 | 同域经典(活动粒度更细) |
| WISDM | 1076 | 手机 HAR 同域(双设备) |
| SisFall | 1075 | 惯性传感跌倒检测 |
| PPG-DaLiA | 202 | 日常活动可穿戴 PPG |
| GLOBEM | 1074 | 纵向可穿戴感知 |
| Wearable Exam Stress | 807 | 真实场景可穿戴生理信号 |
| D1NAMO | 1036 | 1 型糖尿病多模态可穿戴 |
| Brain Wearable Monitoring (SeizeIT2) | 1030 | 可穿戴癫痫监测 |
§8.5 关键论文 Top 6
- Anguita, Ghio, Oneto, Parra, Reyes-Ortiz. A Public Domain Dataset for Human Activity Recognition Using Smartphones. ESANN 2013, pp. 437-442.(主论文)
- Anguita et al. Human Activity Recognition on Smartphones using a Multiclass Hardware-Friendly Support Vector Machine. IWAAL 2012, LNCS 7657, pp. 216-223.
- Anguita et al. Energy Efficient Smartphone-Based Activity Recognition using Fixed-Point Arithmetic. JUCS Vol.19 Issue 9, 2013.
- Reyes-Ortiz et al. Human Activity and Motion Disorder Recognition: Towards Smarter Interactive Cognitive Environments. ESANN 2013.
- Reyes-Ortiz et al. Transition-Aware Human Activity Recognition Using Smartphones. Neurocomputing, 2016.(updated 版相关)
- 领域综述与方法学工作(含「随机划分 vs 受试者无关」对比研究)。
§8.6 社区活跃度
- 下载与镜像:UCI 官方(数十万次浏览)、Kaggle 多份镜像、OpenML(id=1478)、HuggingFace 多份转载;
- 代码复现:GitHub 上大量 HAR 教程与复现仓库以其为默认数据;
- 教学:众多高校机器学习/信号处理课程将其作为时序分类练习数据。
§8.7 生态快照表
| 生态位 | 状态 |
|---|---|
| 官方维护 | UCI 长期托管,无正式变更日志 |
| 镜像丰富度 | 高(Kaggle/OpenML/HF) |
| 许可一致性 | 官方 CC BY 4.0;部分镜像标注不一(以官方为准) |
| 复现脚本 | 社区丰富但口径不一 |
| 长期可得性 | 高(UCI 稳定托管) |
§9 相关资源与引用
§9.1 官方文档与资源列表
| 资源 | 地址 |
|---|---|
| UCI 数据集主页(id=240) | https://archive.ics.uci.edu/dataset/240/human+activity+recognition+using+smartphones |
| UCI 官方下载包 | https://archive.ics.uci.edu/static/public/240/human+activity+recognition+using+smartphones.zip |
| DOI 解析 | https://doi.org/10.24432/C54S4K |
| ESANN 2013 主论文 PDF | https://www.esann.org/sites/default/files/proceedings/legacy/es2013-84.pdf |
| updated 版页面 | https://archive.ics.uci.edu/ml/datasets/Smartphone-Based+Recognition+of+Human+Activities+and+Postural+Transitions |
| MaRDI / OpenML 元数据 | https://portal.mardi4nfdi.de/wiki/Har |
| 实验录像示例 | http://www.youtube.com/watch?v=XOEN9W05_4A |
| 官方 Python 包 | pip install ucimlrepo → fetch_ucirepo(id=240) |
§9.2 BibTeX 引用块
会议论文引用(推荐用于学术):
@inproceedings{anguita2013public,
  title     = {A Public Domain Dataset for Human Activity Recognition Using Smartphones},
  author    = {Anguita, Davide and Ghio, Alessandro and Oneto, Luca
               and Parra, Xavier and Reyes-Ortiz, Jorge Luis},
  booktitle = {21st European Symposium on Artificial Neural Networks,
               Computational Intelligence and Machine Learning (ESANN)},
  pages     = {437--442},
  year      = {2013},
  address   = {Bruges, Belgium}
}
数据集条目引用(推荐用于数据标注):
@misc{reyesortiz2013har,
  title        = {Human Activity Recognition Using Smartphones},
  author       = {Reyes-Ortiz, Jorge and Anguita, Davide and Ghio, Alessandro
                  and Oneto, Luca and Parra, Xavier},
  year         = {2013},
  publisher    = {UCI Machine Learning Repository},
  doi          = {10.24432/C54S4K},
  howpublished = {\url{https://doi.org/10.24432/C54S4K}}
}
§9.3 引用指南
- 引用数据集本身:用 UCI 生成的引用(Reyes-Ortiz 首位)或 §9.2 的
@misc条目; - 引用方法/论文:用 ESANN 2013 的
@inproceedings(Anguita 首位); - 双口径提示:UCI 页面把 Reyes-Ortiz 列首位,论文署名把 Anguita 列首位,二者不矛盾,按引用对象选择;
- 必附署名:CC BY 4.0 要求署名与许可链接。
§9.4 相关标准与规范
| 规范 | 关系 |
|---|---|
| CC BY 4.0 | 数据集许可 |
| Croissant (MLCommons) | 本页 schema_org 对齐的数据集描述规范 |
| DAIMS | 本页 §7.7 采用的数据质量评估框架 |
| DUO(Data Use Ontology) | 本页 INFOBOX 中标注为 NRES(无限制使用) |
§10 AI 使用声明卡
§10.1 AI 模型列表
本页面由千方病案医数集的 AI 辅助写作流水线生成,涉及:
| 环节 | 参与方式 |
|---|---|
| 资料搜集与核验 | AI 辅助检索 UCI 官方页、ESANN 论文、MaRDI/OpenML 镜像,人工三源互证 |
| 结构组织与撰写 | AI 起草,按千方病案 AI-Ready Wikipedia 骨架组织 |
| 事实核验 | 人工对照一手来源逐项核验硬数字 |
| 终审 | 千方病案医学编辑部人工审核 |
§10.2 AI 参与范围
- AI 参与:资料整理、章节草拟、代码示例、表格组织、语言润色;
- 人工主导:来源选择与核验、双口径判定、结论把关、免责与合规表述;
- AI 未参与:任何原始数据采集、临床判断、许可条款的最终认定。
§10.3 输入来源列表
- UCI 数据集主页(id=240)—— 规模、模态、许可、引用、DOI;
- ESANN 2013 主论文 PDF(es2013-84.pdf)—— 作者机构、采集协议、预处理细节;
- MaRDI / OpenML 元数据 —— 列数口径(562)与活动数互证;
- IWAAL 2012 / JUCS 2013 论文题录 —— 方法谱系;
- 千方病案医数集库内同域条目(mhealth 222、pamap2 212、wisdm 1076、sisfall 1075)—— 横向对比与互链。
§10.4 人工校验表
| 校验项 | 结果 | 备注 |
|---|---|---|
| 受试者数 30 | ✅ 一致 | UCI 官方 + 论文 |
| 年龄 19-48 岁 | ✅ 一致 | UCI 官方 |
| 活动类别 6 类 | ✅ 一致 | UCI 官方 + 论文 |
| 样本数 10,299 | ✅ 一致 | UCI 官方 |
| 特征维度 561 | ✅ 主口径 | 562 列为镜像口径,已存照 |
| 采样率 50 Hz | ✅ 一致 | UCI 官方 + 论文 |
| 滑窗 2.56 s / 50% / 128 | ✅ 一致 | UCI 官方 + 论文 |
| 低通 0.3 Hz | ✅ 一致 | UCI 官方 |
| 划分 70/30 subject-wise | ✅ 一致 | UCI 官方 |
| 许可 CC BY 4.0 | ✅ 一致 | UCI 官方 |
| DOI 10.24432/C54S4K | ✅ 一致 | UCI 官方 |
| 作者机构(热那亚 + UPC) | ✅ 一致 | 论文署名 |
| 捐赠日期 12/9/2012 | ⚠️ 双读法 | 已存照两种读法 |
§10.5 AI 生成章节标注
本页面全部章节均在 AI 辅助下起草、经人工核验与编辑。核心事实(§1.6、§3、§4、§9)逐项对照一手来源;分析性内容(§5.3、§6.5、§7、§8.1)为基于公开资料的整理与推断,已在正文中标注口径与不确定性。
§10.6 最后人工审核日期
最后人工审核日期:2026-10-16
审核范围:全文事实核验、双口径存照确认、合规与免责表述审查。
本条目完稿说明:UCI HAR 是千方病案医数集「可穿戴健康 AI」谱系的奠基性基础条目。它本身不是临床数据集,而是一块用于理解活动识别方法论、防泄漏评测与工程范式的通用试金石。建议与 MHEALTH(222)、PAMAP2(212)、WISDM(1076)、SisFall(1075) 等条目并读,以获得同域全貌。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- mhealth — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- gait-in-aging — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- sisfall — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- wisdm — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- rehab-wearable-kinematic — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- ppg-dalia — 共享标签:生理信号 / 可穿戴传感 / 步态与运动
- gait-pd — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- parkinsons-disease-smartwatch — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- live-gaitneurokids — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
- cops — 共享标签:生理信号 / 可穿戴传感 / 步态与运动 / 时序数据
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
