信息速览
INFOBOX — UL-RED 一屏速览
维度 内容 本质 康复训练动作的光学动捕数据集,附带同场无标记与深度两路副模态 全名 The University of Liverpool Rehabilitation Exercise Dataset(UL-RED) 团队 利物浦大学工学院 + 生命历程与医学科学研究所(Reji / Paoletti / Fichera / D’Août) 论文 Scientific Data 2025, vol 12;doi:10.1038/s41597-025-05099-1;PMID 40341034 许可 CC BY 4.0(可商用,需署名) 获取 DataCat eprint 2729 公开直链,S01–S10 十个 zip 规模 22 动作 × 10 人 × 2 录制类型 = 1,320 条录制,>3 小时 模态 marker(250 FPS,29 标记→18 关节)+ marker-less(30 FPS)+ depth(160×120×16bit) 采集区 录制区 4.4×5 m;实际动作区 2×2 m 特色 首个把 normal/fast/slow 三种节奏写进协议的康复动作集 格式 AMC + ASF(文本)、CSV、二进制深度、AVI;解析工具 asfamc-parser 同批区分 与 rehab-wearable-kinematic(IMU 惯性模态)互为补充而非替代,见 §9主要短板 10 人小样本、无硬件同步、2×2 m 空间、无官方基线
§0 导读:这个数据集解决什么问题
远程康复(telerehabilitation)的工程闭环里,最难的一环不是视频通话,也不是动作库,而是**「机器能不能看懂病人在做第几个动作、做得对不对、做得快不快」**。这件事在算法侧叫人体动作识别(Human Action Recognition, HAR),在临床侧叫运动质量评估,而在数据侧,它长期缺一类东西:带真值骨架的康复动作序列。
市面上的 HAR 数据集大多来自日常活动——走路、上楼、坐下、打电话。这些数据告诉模型「人在做什么」,却很少告诉模型「人在按康复处方做几组、每组几次、节奏是否失控」。而康复场景的特殊性恰恰在于:动作幅度小(很多是坐姿)、重复次数是核心指标、节奏是一等公民(治疗师会要求「慢一点、控制住」)。用 Kinetics、NTU RGB+D 这类数据训出来的模型,放到客厅里给老人计数深蹲,几乎必然失效。
UL-RED 的定位就是在这一点上补位。它由利物浦大学工学院 Nikhil Reji 等四人完成,2024 年 7 月挂上校方数据目录(DataCat eprint 2729),2025 年 5 月以 Data Science Data Descriptor 的形式发表在 Scientific Data(doi:10.1038/s41597-025-05099-1,PMID 40341034,PMCID PMC12062305)。数据集规模不大——10 名受试者、22 个动作——但它做了三件在同类资源里少见的事:
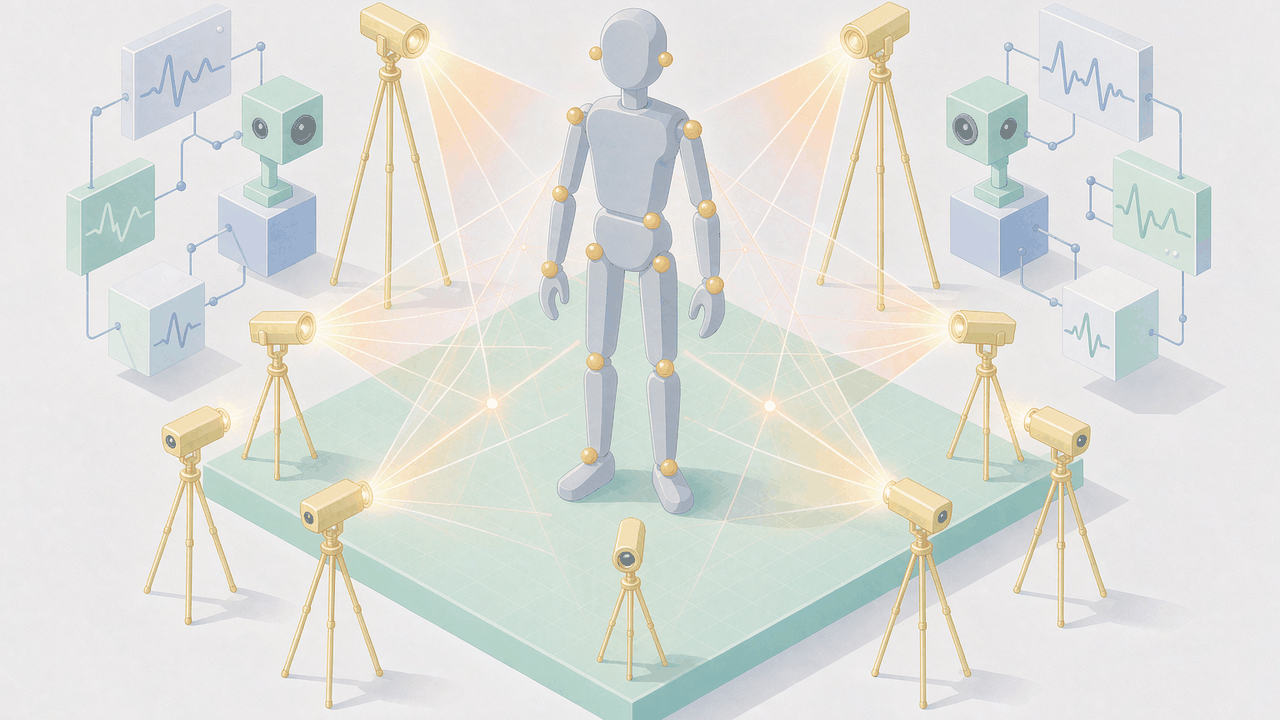
- 同一动作、三种模态、同一个房间:8 台 OptiTrack 红外相机做标记点动捕,Orbbec Persee 做无标记跟踪与深度采集,三者并排摆放、同时录制。于是「实验室级真值」与「消费级传感器输出」之间第一次有了逐帧可比的对照轴。
- 同一动作、三种节奏:三次重复的录制要求受试者按自己理解的「正常 → 快 → 慢」顺序各做一组。这在康复里是刚需(动作变慢往往先于力量下降出现),在数据里却是稀缺标签。
- CC BY 4.0 直下:不申请、不签协议、不分学术/商用,按受试者打包十个 zip,任何人可下载。
需要先摆明一个容易混淆的点:UL-RED 是光学动捕(optical motion capture)数据集,不是可穿戴惯性(IMU)数据集。它的主真值来自红外相机对反光标记点的三角测量,精度在亚毫米到毫米量级,代价是需要专用场地与贴点;而 IMU 数据集靠身体节段的加速度/角速度积分推算姿态,可穿戴、可居家,但会漂移。两者在康复场景里的角色完全不同——一个当「标尺」,一个当「产品形态」。本批同批次的 rehab-wearable-kinematic 条目正是 IMU 一侧的代表,两者的分工与互补关系在 §9 展开。
本条目按「是什么—怎么采—怎么标—怎么用—坑在哪」的顺序组织,所有硬数字以论文与 DataCat 目录两处互证为准,口径冲突逐条存照于附录 C。
§1 数据集速览:十问十答
Q1:一句话说清 UL-RED 是什么?
一个 10 人、22 个居家康复动作、每人每动作录一遍和连做三遍的光学动捕数据集,附带同场的无标记骨架与深度帧,CC BY 4.0 公开。
Q2:谁做的、发在哪?
利物浦大学工学院 Nikhil Reji(通讯)、Paolo Paoletti、Sebastiano Fichera 与生命历程与医学科学研究所 Kristiaan D’Août;论文 2025 年 5 月发表于 Scientific Data。
Q3:到底有多少条数据?
1,320 条录制 = 22 动作 × 10 受试者 × 2 种录制类型(单次 / 三次重复)× 3 种模态的计数口径。论文与 DataCat 都写 1,320;这一数字按「录制条目」计,不是按文件数计。
Q4:时长多久?
论文表述为「marker-based 与 marker-less 合计超过 3 小时」。深度流与 AVI 可视化的时长未单独给出。
Q5:动作有哪些?
22 个,覆盖站立与坐姿两类:从坐到站、微蹲、提踵、侧抬腿、前后摆腿、肱二头肌弯举、侧屈、侧步、抬膝、双臂侧举/前举、正面侧步、抬膝对侧触手、髋部绕环、胸前推、以及七个「Seated」前缀的坐姿变体。
Q6:三种模态各自是什么?
marker-based:8 台 OptiTrack Prime 17W 红外相机、29 枚反光标记、250 FPS,后处理成 18 关节骨架;marker-less:Orbbec Persee + Nuitrack SDK,30 FPS,输出同样转成 ASF/AMC;depth:Persee 的 160×120、16 bit 深度帧逐帧存成二进制。
Q7:标签有什么?
动作类别(由文件命名承载)、录制类型(单次/三次)、节奏(normal/fast/slow)、以及三次重复录制中每一「次」的起止时间戳。
Q8:怎么拿?
利物浦大学 DataCat,doi:10.17638/datacat.liverpool.ac.uk/2729,S01.zip 到 S10.zip 直接下载,单包 500–640 MB。
Q9:能商用吗?
能。CC BY 4.0,署名即可,无附加限制。
Q10:适合谁?不适合谁?
适合:康复动作识别、重复计数、多模态姿态估计与跨模态对齐、节奏/速度敏感模型的开发者,以及需要「实验室真值」去校准消费级无标记系统的团队。
不适合:需要大样本人群统计的临床研究、需要步态周期/长距离行走的运动分析、需要病理人群(卒中/骨科术后)专门数据的康复评估研究。
§2 数据构成与规格
2.1 受试者与整体规模
数据集纳入 10 名受试者,全部匿名化处理,DataCat 明确记载「所有数据均已匿名化,不含可回溯到真实姓名的标识信息」。论文与目录均未随数据发布年龄、性别、身高体重、既往病史或任何临床量表——这一点在康复语境下值得注意:数据集的动作是「非专门化」(non-specialised)的通用健身式动作,受试者不是按疾病分组招募的。
规模构成的乘法关系如下:
10 受试者 × 22 动作 × 2 录制类型(1Rep / 3Rep)= 440 条动作级记录
440 × 3 模态(marker / marker-less / depth)= 1,320 条录制
这是理解「1,320」这个数字的唯一正确方式。它不是 1,320 段独立视频,也不是 1,320 名受试者或 1,320 个动作实例。文件系统里,每个受试者一个 zip(S01–S10),包内含该受试者在三模态下的全部动作文件、原始数据与可视化视频。
2.2 三种模态的物理基础
(1)marker-based:红外光学动捕。
OptiTrack(NaturalPoint Inc., Corvallis, USA)的 Prime 17W 相机共 8 台,布置在 4.4 m × 5 m 录制区的四个顶点,每个顶点两台,分别架在离地 1 m 与 1.9 m 处。低位相机负责下肢,高位相机负责上肢,视场角经人工调整。这样的垂直双机位设计保证每枚标记至少被三台相机同时看到,从而满足三角测量的最低冗余(三视角 → 3D 重建)。
采样率 250 FPS。受试者身上贴 29 枚反光标记(retro-reflective markers),用医用胶直接贴皮,或在需要覆盖衣物的部位(如左髋)用弹力布紧缠后贴附。头部标记固定在受试者佩戴的动捕帽上。标记位置尽量以骨性标志为准;无骨性标志可依的部位(如腰部)则以可视参照确定,例如借左右髋标记的位置推断腰标记的落点。
(2)marker-less:消费级无标记跟踪。
Orbbec Persee 一体机置于录制区最长边的中点,正面朝向动作区。跟踪由 Nuitrack SDK 完成,输出 30 FPS 的关节三维位置。为帮助受试者保持正确姿势、也帮助采集者判断跟踪是否正常,系统把实时无标记跟踪结果投到受试者视野内的显示屏上——这既是视觉反馈,也是一种隐式的质量控制。
(3)depth:深度帧。
同一台 Persee 输出的深度流被逐帧存为二进制文件,单帧 160 × 120 像素、16 bit。这个分辨率相当低(约 1.9 万像素),远低于现代深度相机的 640×480 或 ToF 模组,属于早期结构光/主动红外方案的典型输出。它的价值不在精度,而在于「与无标记骨架同源、逐帧对齐」——研究者可以据此追问「骨架估计出错时,深度图长什么样」。
2.3 采集空间与「两个框」
论文里有两个必须分清的尺寸:
| 概念 | 尺寸 | 用途 |
|---|---|---|
| 录制区(recording area) | 4.4 m × 5 m | 8 台相机的布设范围 |
| 动作区(capture area) | 2 m × 2 m | 受试者实际活动的中心方框 |
动作区之所以被压到 2×2 米,不是因为 OptiTrack 拍不到更大范围,而是要与无标记系统的有效视场对齐——Persee 的有效跟踪距离与视角有限,若让受试者走出 2 米框,无标记数据就会中断,三模态可比性随之瓦解。这个设计取舍直接决定了数据集的适用边界:所有动作都必须是原地完成或仅含单步平移(如 SidewaysStep、FullFrontalSidewaysStep),无法容纳连续步态。
2.4 文件格式:为什么选 AMC/ASF
处理后的 marker 与 marker-less 数据统一存为 AMC(Acclaim Motion Capture) 与 ASF(Acclaim Skeleton File)。这是 DanceDB/CMU 时代的经典文本格式:
- ASF 描述骨架:采样率、关节层级、各关节轴序、骨段长度、以及受试者 T-Pose 下的关节位置;
- AMC 描述运动:逐帧给出每个关节的旋转(及根节点的平移)。
选它的理由论文写得很直白——人类可读。相比 BVH 或厂商私有二进制,AMC/ASF 用文本编辑器就能打开、能 diff、能用脚本批量改;对教学与快速原型极友好。代价是生态不如 BVH 广,主流引擎(Unity/Unreal/Blender)不原生支持,多数用户需要转换。为此作者自建并发布了 Python 解析包 asfamc-parser(PyPI 公开),可直接把 AMC/ASF 读成帧序列。
其余文件的格式分工:
| 数据 | 格式 | 说明 |
|---|---|---|
| 处理后 marker 序列 | AMC + ASF | 18 关节,文本 |
| 处理后 marker-less 序列 | AMC + ASF | 30 FPS,文本 |
| 原始标记坐标 | CSV | OptiTrack Motive 直接导出 |
| 三次重复的时间标签 | CSV | 命名 3Rep_S{SubjectID} |
| 深度 | 二进制 | 每文件一帧,160×120,16 bit |
| 可视化 | AVI | 三模态合成视频,可用 VLC 播放 |
2.5 命名规则
统一命名:
{MotionName}R{Number of Repetitions}S{Subject ID}
例如 SitToStandR3S04 表示「从坐到站、三次重复、4 号受试者」。两个注意点:
- R 是录制类型不是重复次数上限:R1 与 R3 是两种协议,R3 的录制里受试者做了三次,但文件仍是一段连续录制,三次的边界靠标签 CSV 给出。
- 标签里的「Rep」是协议代号不是次数:多次录制版本的文件名里带
3Rep,而单次版本没有这个后缀——检索时不要用3Rep去匹配 R3,两者是不同维度。
§3 采集协议与同步:一场没有硬件时码的实验
3.1 22 个动作的完整清单
论文 Table 3 给出 22 个动作的名称与描述。原文的命名风格是驼峰式且不带空格,下表保留原拼写以便与文件名对照:
| # | 动作名 | 描述要点 | 体位 |
|---|---|---|---|
| 1 | SitToStand | 由站到坐再站起 | 站/坐 |
| 2 | MiniSquat | 双臂前伸伸直,屈膝约 45° | 站 |
| 3 | CalfRaise | 前脚掌着地,抬脚跟 | 站 |
| 4 | SidewaysLegLift | 左腿伸直侧抬,换右腿 | 站 |
| 5 | LegExtensionBackward | 左腿伸直向后摆,换右腿 | 站 |
| 6 | LegExtensionForward | 左腿伸直向前摆,换右腿 | 站 |
| 7 | BicepCurls | 屈肘向胸前弯举后还原 | 站 |
| 8 | SidewaysBend | 左手沿体侧下滑至左膝,臂保持伸直,换右侧 | 站 |
| 9 | SidewaysStep | 左腿向左迈一步后还原,换右腿 | 站 |
| 10 | KneeRaise | 左膝抬至 90°,换右膝 | 站 |
| 11 | ArmRaise | 双臂侧举至头顶相合后还原 | 站 |
| 12 | ForwardArmRaise | 双臂前举至与地面平行后还原 | 站 |
| 13 | FullFrontalSidewaysStep | 面向前方侧向迈一步,左右交替 | 站 |
| 14 | KneeRaiseWithOpHandTouch | 左膝抬至 90°,同时右手触左膝,换侧 | 站 |
| 15 | HipHoops | 左髋向外顶出并逆时针绕环一周后还原 | 站 |
| 16 | FrontalChestPress | 双臂侧举至水平后向内合拢,再还原 | 站 |
| 17 | SeatedLegStretch | 左腿前伸至全伸展,换右腿 | 坐 |
| 18 | SeatedChestStretch | 坐姿版的 FrontalChestPress | 坐 |
| 19 | SeatedUpperBodyTwist | 双臂胸前交叉成 X,上身向左扭转,换侧 | 坐 |
| 20 | SeatedHipMarch | 坐姿版的 KneeRaise | 坐 |
| 21 | SeatedArmRaise | 坐姿版的 ArmRaise | 坐 |
| 22 | SeatedNeckRotation | 上身朝前,头颈向左转,换右侧 | 坐 |
七个 Seated 动作并非独立设计,而是站立动作在坐姿下的等价变体——论文在描述里直接写「这是坐姿版的 X」。这个设计让数据集天然具备一组「同一运动模式、不同体位」的配对样本,对研究「体位变化对姿态估计的影响」很有用。
3.2 两种录制协议
- 单次(1Rep):每个动作录一次完整往返。用于干净的单周期样本。
- 三次重复(3Rep):同一动作连续做三次,且受试者被要求按 正常 → 快 → 慢 的顺序,以「自己直觉理解的速度」完成。
第三种节奏(slow)是这份数据集最有辨识度的设计。康复训练中,动作放慢通常是治疗师主动加难的手段,也是患者在能力下降时最早出现的代偿信号。把这三种节奏显式标注出来,意味着后继模型可以学「同一动作在不同速度下的运动学差异」,而不必把速度当成噪声。
需要留意的是,节奏标签只存在于 3Rep 录制中,且是「约定顺序」而非逐次物理测量——如果受试者第二次没做得比第一次快,数据里仍然是第二次=fast。这一点在 §8 的坑点里会再提。
3.3 同步:两套系统、一台电脑、一个鼠标宏
这是整份数据集最值得细读的工程细节,也是最容易被误用的地方。
OptiTrack(Motive 软件)与 Nuitrack(跑在 Persee 上)分属两个隔离的计算环境,没有硬件同步能力——没有共享时码、没有 genlock 信号、没有触发线。作者的解决方案是三层软件补偿:
- T-Pose 首尾标定:每段录制开始与结束时,受试者保持 T-Pose 数秒。后处理时用 T-Pose 检测算法裁掉首尾多余帧,并以 T-Pose 为锚把两路数据对齐。
- 鼠标宏同时触发:用 MurGee 的 Auto Mouse Clicker 软件,以预设的屏幕鼠标动作在同一时刻点击两套采集软件的「开始」,最小延迟约 1 ms。
- 屏幕投送:Persee 上的 Nuitrack 录制界面通过直连以太网、ADB 与 scrcpy 投送到跑 Motive 的台式机上,让操作者在一个屏幕里同时看到两路状态。
论文对此的自我评价很克制,原文意思是:尽管做了软件层面的同步努力,并不能保证两种模态完全同步。这句话应当被当作使用说明书来读——任何需要逐帧对齐的跨模态任务(例如用 marker 真值监督 marker-less 的姿态回归),都必须自行做时间重采样与互相关对齐,不能默认帧号一一对应。250 FPS 与 30 FPS 之间本来就存在 25:3 的非整数倍率,天然会有抖动。
3.4 为什么这件事难
把这段工程细节单列一节,是因为它揭示了整个「实验室 vs 家庭」命题的核心矛盾:
- 光学动捕可信,但需要专用场地、专用相机、贴点、标定——本质上是实验室工具;
- 无标记/深度便宜、可居家,但精度与鲁棒性都差——本质上是产品工具。
两者要放在同一个坐标系里比较,就必须解决同步。硬件同步(genlock、共享触发)是最干净的方案,但消费级深度相机通常不提供触发输入;软件同步(T-Pose 锚定 + 宏触发)成本低但留有毫秒到数十毫秒的漂移。UL-RED 走了后者,并诚实地把它写进了局限里。对使用者的启示是:这份数据可以用来研究「两种模态的差异有多大」,但要研究「差异的确切来源」,同步误差本身就是一个混杂因素。
§4 标注体系与后处理
4.1 三段式后处理流水线
论文 Fig.1 把流程画成三段,对应三种录制类型的不同处理深度:
第一段:marker 数据清洗与骨架化。
自动化 + 人工两步。自动化部分做标记点的间隙填补(occlusion gap filling)与去噪;人工部分检查并修正 Motive 自动标注(labeling)的错误——反光标记在遮挡、交换位置时最容易串号,这一关必须人眼看。清洗后进入「骨架化」:把 29 枚标记的三维坐标折算成 18 个关节的位置。这一折算不是简单取点,而是有明确的几何规则:
- 头部关节 = 头标记位置(一对一映射);
- 手掌关节 = 掌心标记位置(一对一映射);
- 髋关节 = 左/右髋标记与两枚腰部标记(Waist1、Waist2)的中点计算;
- 其余关节 = 相关两枚标记的中点(例如腕关节 = 肘侧与手侧两点中点)。
第二段:marker-less 的清洗。
只做错误修正,不做骨架重定义——Nuitrack 直接输出关节位置,作者只清理明显跳变与丢失帧。
第三段:T-Pose 裁切与对齐。
对 marker 与 marker-less 两路都执行同样的裁切算法:找到录制首尾的 T-Pose,裁掉其外的冗余帧,并把 T-Pose 帧作为时间零点。
4.2 T-Pose 检测的判定条件
论文给出伪代码,判定依据是三条向量之间的夹角:
- 脊柱向量:腰部关节 → 头部关节;
- 手臂向量:肩关节 → 腕关节;
- 腿部向量:髋关节 → 踝关节。
判为 T-Pose 的条件是:手臂与脊柱夹角 90° ± 10°,腿部与脊柱夹角 180° ± 10°。两条件同时满足的连续帧被认定为标定段。
这个阈值的取舍值得说一句:±10° 在光学动捕里算宽松,目的是容忍受试者「举得不太直」;但宽松阈值的代价是,如果某个动作在某一瞬间恰好接近这个几何构型(例如 ArmRaise 双臂侧举到水平时,手臂与脊柱正好 90°),就有被误判为 T-Pose 的风险。作者没有在论文里报告误判率,这属于需要在复现时自查的点。
4.3 三次重复的时间标签是怎么来的
三次重复录制需要额外的「人工重复标注」(manual repetition labelling)环节:处理者逐段看 AVI 可视化视频,标出每一次重复的起止帧,存为 CSV。
两条标签的对应关系由论文给出的公式确定:
label_markerless = ceil( label_marker × f_markerless / f_marker )
                 = ceil( label_marker × 30 / 250 )
即无标记侧的标签不是独立人工标注的,而是由 marker 侧标签按采样率比换算并向上取整得到的。这个做法省了人工,但引入了系统性偏差:向上取整意味着无标记标签恒偏晚,最大误差可达一帧(1/30 s ≈ 33 ms)。对于以「秒」为粒度的重复计数任务,这个误差可以忽略;对于精细的相位分析,则需要修正。
4.4 标签的粒度与缺口
| 标签维度 | 有无 | 载体 |
|---|---|---|
| 动作类别 | 有 | 文件名(MotionName) |
| 受试者 ID | 有 | 文件名(S{ID}) |
| 录制类型 | 有 | 文件名(R1/R3) |
| 每次重复的起止 | 有(仅 3Rep) | CSV 时间戳 |
| 节奏(正常/快/慢) | 有(仅 3Rep,约定顺序) | 无显式字段,靠协议约定 |
| 动作质量/正确性 | 无 | — |
| 代偿模式/异常姿态 | 无 | — |
| 疼痛/疲劳/主观用力 | 无 | — |
| 临床量表(如 TUG、BBS) | 无 | — |
这张表说明了 UL-RED 的能力边界:它能回答「这是第几个动作、做了几次、多快」,不能回答「做得好不好、有没有代偿、患者主观感受如何」。后者需要标注者具备康复专业判断,成本高得多,也是这个领域公认的下一步。
§5 怎么用:从下载到建模的完整路径
5.1 下载与解压
DataCat 页面上按受试者列出十个 zip(S01–S10),单包 512–639 MB,全部标 CC BY 4.0,可见性为「Anyone」。下载后解压即得该受试者的三模态全部文件与一个 AVI 可视化视频。建议先只下载 S01 跑通流程——一是验证解析脚本,二是确认磁盘空间(全部解压后总量在 5–6 GB 量级,远大于压缩包总和的直觉估计)。
5.2 读骨架:asfamc-parser 的最小用法
# 示例:用作者发布的解析包读取一段 AMC/ASF 骨架序列
from asfamc import AMC, ASF   # 包名 asfamc-parser,import 名以实际发布为准

asf = ASF("SitToStandR1S01.asf")      # 骨架:关节层级、轴序、骨长、T-Pose
amc = AMC("SitToStandR1S01.amc")      # 运动:逐帧关节旋转/根平移

frames = list(amc.frames)              # 每帧为一个 pose 对象
n_joints = len(asf.joints)             # 本数据集为 18
fps = asf.sample_rate                  # marker 侧 250,marker-less 侧 30
要点三条:① AMC 存的是旋转,要拿到三维坐标需按 ASF 的骨长与层级做正向运动学(forward kinematics),这决定了「同一关节在不同实现里坐标可能不同」;② 根节点的平移分量在 AMC 里单独给出,处理原地动作时往往需要归一化掉;③ 采样率在 ASF 里,不在文件名里——marker 与 marker-less 的文件名长得一样,靠目录区分模态。
5.3 读原始标记:CSV 的坑
Motive 导出的 CSV 包含全部 29 枚标记的逐帧三维坐标,无骨架化、无填补。优点是最接近物理测量,缺点是缺帧(遮挡)以空值或零值出现,且标记顺序与骨架关节顺序无关。实务上建议:先用 CSV 验证 Motive 的标注质量,再决定信任处理后的 AMC。
5.4 读深度:二进制帧的拼装
每个深度文件只含一帧,160×120、16 bit、小端序(具体字节序需按实际文件验证)。读取方式:
import numpy as np

raw = np.fromfile("depth_frame_000123.bin", dtype=np.uint16)  # 19200 个采样
depth = raw.reshape(120, 160)                                  # 高 120、宽 160
一帧 160×120×2 字节 = 38,400 字节,可直接用文件大小反推帧数与完整性。深度单位与无效值掩码(通常 0 表示无回波)需按 Persee 的原始规格确认,数据集本身不附带说明文件——这是一个实际使用中必然撞到的摩擦点。
5.5 典型任务配方
任务 A:动作分类(22 类)。
输入 AMC 的关节旋转序列,输出动作类别。注意类别不均衡:七个 Seated 变体与站立版在运动学上高度相似,仅靠上肢轨迹很难分开,必须依赖躯干绝对高度或根节点平移。建议以受试者为单位做留一交叉验证(LOSO),而不是随机划分——同一受试者的重复录制之间相关性极高,随机划分会严重高估性能。
任务 B:重复计数。
输入 3Rep 序列,输出三次的边界。这是本数据集最自然的任务,因为标签现成(时间戳 CSV)。基线可用「关节角速度峰值检测」——以膝或肘的屈曲角速度为信号,做峰值聚类即可;深度模型则可用 1D 时序分割。评估用 MAE(次数误差)与边界 IoU 双指标。
任务 C:跨模态对齐 / 蒸馏。
以 marker 骨架为教师、marker-less 为学生学习姿态回归。这是数据集设计时就瞄准的用途,但要先解决 §3.3 的同步问题:建议用动态时间规整(DTW)或互相关在关节角速度上做粗对齐,再在 T-Pose 锚点附近做细对齐。
任务 D:节奏/速度识别。
三分类(normal/fast/slow)。难点在于「快慢」是相对于受试者自身能力的,个体间绝对速度差异会压过类内差异。可行的做法是以该受试者 normal 段的中位周期为基准做归一化,再分类。
任务 E:无标记系统的误差画像。
逐关节、逐动作、逐节奏统计 marker 与 marker-less 的位置差。这类「基准对照」研究的价值不在刷点,而在给出「哪个关节在哪个动作下最不可信」的工程结论——例如坐姿动作中下肢被遮挡时,Persee 的膝踝估计很可能崩。
5.6 预处理清单(建议)
- 统一到 18 关节、统一到同一坐标系(AMC 的轴序来自 ASF,务必逐受试者核对,因为每人的 ASF 是独立生成的);
- 去根节点平移或按髋中点居中,消除受试者在 2×2 米内的站位差异;
- 缺失帧用线性插值或前向填充,并记录插值比例作为质量权重;
- 时间重采样到统一帧率(建议 30 FPS,向低频对齐以免上采样引入虚假高频);
- 按受试者切分训练/验证/测试,绝不跨受试者泄漏。
§6 坑点清单:十个已踩过的坑
坑点 1:把「1,320 条录制」当成 1,320 段视频。
这是最高频的误读。1,320 = 22 × 10 × 2 × 3,每一「条」是一次模态输出。解压 S01 后你会看到几十个视频与上百个数据文件,而不是 132 段视频。把口径搞错会导致两个后果:一是误判数据量级(以为有上千独立样本,实际只有 10 个独立受试者);二是把同一录制在三种模态下的三个文件当成三个独立样本喂进模型,造成跨模态泄漏。
坑点 2:以为三种模态硬件同步、帧号可对齐。
论文原文明确说不能保证完全同步。250 FPS 与 30 FPS 是 25:3 的比,任何「第 n 帧对第 n 帧」的假设都是错的。用之前必须自己做对齐,并把对齐残差当作方法学报告的一部分。
坑点 3:把节奏标签当成逐次物理测量。
normal/fast/slow 是「要求受试者按此顺序做」的协议约定,不是用测速仪测出来的。如果受试者第二次比第一次慢(完全可能),数据里第二次仍标 fast。做节奏分类任务时,务必先检验标签与实测周期的相关性,若相关性低,任务本身就不可学。
坑点 4:用随机划分做交叉验证。
同一受试者的 44 条动作级记录(22 动作 × 2 协议)共享同一套骨骼比例、同一套贴点习惯、同一天的身体状态。随机划分会把同一人的样本同时放进训练与测试,性能虚高可达十几个百分点。必须 LOSO。
坑点 5:把 29 枚标记当成 29 个关节。
标记数 29,骨架关节数 18。多数关节位置是两枚标记的中点,髋关节还用了三枚标记的中点。如果你的下游模型期待 COCO 的 17 关键点或 SMPL 的 24 关节,必须先写映射表,且要接受「部分语义无法一一对应」(例如 SMPL 的脊柱分节在 AMC 里更粗)。
坑点 6:指望在 2×2 米里做步态分析。
采集区只有 2×2 米,动作全部原地完成或仅单步平移。SidewaysStep 与 FullFrontalSidewaysStep 虽然含「步」,但一步之后立即返回,不构成步态周期。需要步态数据的读者应转向专门的步态库(库内 gait-pd、gait-in-aging、live-gaitneurokids 等)。
坑点 7:假设场景是「患者」而实际是「健康志愿者做康复动作」。
论文用词是 non-specialised exercises,受试者是普通成人,不是按疾病招募的患者。数据集可以支持「算法能不能识别康复动作」的研究,不能直接支持「卒中患者与健康人的运动学差异」这类临床结论——后者需要病理人群的队列。
坑点 8:忽略 DataCat 的 Metadata Revision 差异。
十个 zip 的 Revision 号不完全一致(S01 为 5,多数为 4),说明不同受试者的包被更新过不同次数。若你的实验结果无法复现,先核对下载时点与 Revision,而不是先怀疑代码。
坑点 9:把 AMC 的旋转直接当坐标用。
AMC 存旋转 + 根平移,关节三维坐标需要正向运动学算出来。直接取 AMC 里每个关节的三个数值当 xyz,得到的是「旋转角度」,不是「位置」——这个错误在小规模原型里很常见,且不会报错,只会让模型学不到东西。
坑点 10:论文排版里的「retro—reflective」。
PDF 正文中该词用了全角破折号而非连字符,检索复制时会带入异常字符;同类问题还有 marker-Less/marker-less 大小写不一致。这属于排版层缺陷,做文献管理时建议手工归一化,否则正则匹配会漏。
§7 在康复与 HAR 版图中的位置
7.1 三条技术路线的坐标系
康复运动分析的技术栈大致分三路,UL-RED 落在第一路的延伸处:
第一路:光学/标记式动捕。
以 Vicon、OptiTrack 为代表,靠反光标记与红外三角测量。精度可达亚毫米,是运动生物力学的金标准。缺点是场地、成本、贴点耗时。UL-RED 属于这一路,并刻意把「金标准」与「消费级」放在同一场景。
第二路:无标记视觉。
以单个或多个 RGB/深度相机 + 姿态估计模型(OpenPose、MediaPipe、RTMPose、以及各类 BlazePose 变体)为代表。部署极便宜,家庭可用手机或智能音箱摄像头。缺点是遮挡、宽松衣物、光照敏感,且「关节位置」是模型输出而非物理测量。UL-RED 的 marker-less 一路(Persee + Nuitrack)是这个思路的早期工业版本。
第三路:可穿戴惯性(IMU)。
以加速度计+陀螺仪(有时加磁力计)贴在身体节段,通过姿态解算与积分推算运动。可穿戴、可长时、可户外,是商业化最成熟的一路(智能手表、康复手环)。缺点是积分漂移、无绝对位置、需要校准。这是同批 rehab-wearable-kinematic 条目所属的路线,与 UL-RED 是互补而非同类。
三路的关系可以用一句话概括:光学动捕提供「真值」,无标记提供「易得性」,IMU 提供「可穿戴性」。UL-RED 的独特价值在于,它把前两路放在同一时空里,让「易得性」的代价可以被量化。
7.2 与相邻数据集的定位比较
| 数据集类型 | 代表 | 与 UL-RED 的关系 |
|---|---|---|
| 日常活动 HAR(视频) | Kinetics、NTU RGB+D | 动作语义不同(日常 vs 康复),UL-RED 有骨架真值 |
| 惯性 HAR | UCI-HAR、Opportunity | 模态不同,UL-RED 无 IMU 通道 |
| 步态数据库 | 各类 Parkinson/aging gait 库 | 任务不同(步态周期 vs 单动作重复) |
| 康复动作视频 | 少量临床自建集 | UL-RED 补上了「三模态 + 三节奏 + 开放许可」 |
一个值得注意的空缺:UL-RED 不包含 IMU 通道。这意味着「同一动作的光学真值 vs 惯性估计」这一对照,在 UL-RED 里做不了,需要跨数据集拼接或另找带 IMU 的同步采集集。这也是为什么本批两个条目应当成对阅读——它们各自占据模态轴的一端。
7.3 对远程康复产品意味着什么
对做数字疗法的团队,这份数据集的实际用法通常不是「直接训一个产品模型」,而是:
- 校准自有无标记模型:把 UL-RED 的 marker 骨架当参考,量化自家模型在 22 个动作上的关节误差,尤其关注坐姿动作(临床中占比高、遮挡重);
- 验证重复计数逻辑:拿 3Rep 的时间戳做单元测试用例,检查计数算法在不同节奏下是否会漏计/多计;
- 构建合成训练数据:以 AMC 骨架为源,通过重定向(retargeting)生成不同体型的虚拟患者动作,扩充训练集——CC BY 4.0 允许这样做;
- 做隐私论证:由于数据是骨架而非影像,可向合规方说明「我们的处理链路只保留关节坐标」,这条论证在医疗 AI 备案中很实用。
§8 可复现性与工程细节
8.1 复现论文数字需要什么
论文没有发布官方划分、基线模型或评估脚本。因此「复现」在这个数据集上只有一个含义:复现采集与后处理流程,而不是复现某个排行榜。需要复现的环节包括:Motive 的标记标注与间隙填补、18 关节的中点计算、T-Pose 裁切与阈值、三次重复的人工标注、以及标签的 250→30 换算。
其中只有 T-Pose 裁切有伪代码可循,其余环节依赖 Motive 的交互操作,论文未给出参数细节(如间隙填补的最大帧长、滤波器的截止频率)。这构成一个现实的复现缺口——想完全重建处理后数据的研究者,只能从原始 CSV 出发自建流水线。
8.2 磁盘与算力预算
- 下载:10 个 zip,单包 512–639 MB;
- 解压后:marker 与 marker-less 的 AMC 是文本,体积膨胀明显;深度帧每帧 38.4 KB,按 30 FPS × 3 小时量级估计,单是深度流就在 GB 级;
- 训练:18 关节 × 250 FPS 的序列在分类任务上属轻量,单张消费级 GPU 足够;瓶颈在 I/O 与解析,不在算力。
建议的工程做法:先把 AMC 一次性转成 NumPy 的 .npy 或 HDF5,后续训练只读二进制;深度帧如果只做对照研究,可先抽帧(例如每 10 帧取 1)再入库。
8.3 与常见工具链的对接
- Blender:可通过 AMC/ASF 导入插件(社区有 BVH 转换脚本)做可视化与重定向;
- PyTorch/NumPy:直接用 asfamc-parser 输出数组;
- OpenSim:若要做逆动力学(关节力矩),需要按 OpenSim 的模型做缩放与标记映射,工作量不小,且需注意 AMC 的 18 关节粒度不足以支撑完整的下肢力矩分析;
- MediaPipe/RTMPose:可把深度或 AVI 重新跑一遍现代姿态估计,与 Persee 的 2024 年水平做代际对比——这是一个成本低、结论直观的小研究。
8.4 质量控制建议
以下检查建议在正式建模前跑一遍,能挡掉大部分脏数据问题:
- 帧数核对:AMC 帧数 ÷ 采样率 应约等于 AVI 时长(±1 s);
- T-Pose 位置:每段序列的第 0 帧应接近 T-Pose,若不是,说明裁切失败;
- 关节跳变检测:逐关节计算相邻帧位移,超过阈值(如身高的 5%)的帧标为可疑,对照原始 CSV 确认;
- 标记缺失率:统计 CSV 中的空值比例,缺失率高的录制在训练时应降权;
- 节奏-周期相关性:对 3Rep 段计算三次的周期,检验是否满足 normal < fast 的期望方向,不满足的样本建议在节奏任务中剔除或单独分析。
§9 与库内条目的关系
9.1 模态区分:与 rehab-wearable-kinematic 的边界
本批同时生产的 rehab-wearable-kinematic 条目在名称上与本文高度相似,但两者在物理模态上分属完全不同的技术路线,读者务必分清:
| 维度 | UL-RED(本文) | rehab-wearable-kinematic(姊妹条目) |
|---|---|---|
| 模态 | 光学动捕(红外相机 + 反光标记) | IMU 惯性传感(加速度计/陀螺仪,可含磁力计) |
| 测量原理 | 多视角三角测量,直接解算三维位置 | 角速度积分 + 姿态解算,位置需二次积分 |
| 精度特性 | 亚毫米级,无漂移 | 关节角较稳,位置漂移随时间累积 |
| 部署形态 | 实验室固定场地 | 可穿戴、居家、户外 |
| 采样率 | 250 FPS(marker)/ 30 FPS(marker-less) | 通常 50–200 Hz,取决于传感器型号 |
| 场地约束 | 2×2 米动作区 | 无场地约束 |
| 典型用途 | 提供真值、校准与评测 | 提供产品级长时监测 |
一句话记忆:UL-RED 是「标尺」,IMU 数据集是「尺子本身」。做算法评测时用前者,做产品部署时用后者;两者的交集是「用标尺去校准尺子」,而这需要同一批动作在两种模态下同步采集——UL-RED 并不提供这个交集,因为它没有 IMU 通道。
该条目的 rid 尚未在本条目定稿时入库,故本节只以 slug 指称,不写数字编号,避免出现指向空号的互链。
9.2 库内可互为参照的条目
| slug | rid | 参照价值 |
|---|---|---|
| live-gaitneurokids | 1055 | 儿科步态,IMU + sEMG + 三视角视频;「多模态同步采集」的另一个工程样本 |
| uci-har | 1086 | 智能手机 IMU 六类活动,HAR 的经典基准;与 UL-RED 构成「惯性 vs 光学」两端 |
| sisfall | 1075 | 惯性跌倒检测;康复场景的下游风险任务 |
| gait-pd | 242 | 帕金森步态;病理性运动分析的对照组 |
| gait-in-aging | 232 | 神经退行性疾病步态动力学;同上 |
| slam-laparoscopic-motions | 762 | 手术动作识别视频;「动作识别」在不同临床场景的另一种形态 |
| cmrxmotion | 687 | 名称含 motion,但指呼吸运动伪影,与本文的肢体运动无关,慎链 |
9.3 检索路径建议
- 从「康复」出发:UL-RED → live-gaitneurokids → gait-pd → gait-in-aging;
- 从「HAR 模态」出发:UL-RED(光学)→ uci-har(IMU)→ sisfall(IMU 跌倒);
- 从「同步采集工程」出发:UL-RED(相机 vs 深度)→ live-gaitneurokids(IMU vs 视频 vs 肌电)。
§10 总结与决策卡
10.1 三句话
- UL-RED 是 10 人、22 个居家康复动作、三模态(光学标记 / 无标记 / 深度)的开放数据集,CC BY 4.0,2025 年发表于 Scientific Data。
- 它的独特卖点是「同场景三模态 + 三节奏(正常/快/慢)」,这使跨模态对照与速度敏感建模成为可能,而这两件事在康复 HAR 里长期缺数据。
- 它的边界同样清晰:10 人小样本、2×2 米空间、软件同步、无临床标注、无官方基线——把它当「标尺」用,不要当「临床队列」用。
10.2 30 秒决策卡
| 你的需求 | 结论 |
|---|---|
| 训一个居家康复动作分类模型 | 可用,但建议配合自有数据,LOSO 评估 |
| 做重复计数算法验证 | 强推,3Rep 时间戳是现成标签 |
| 评测自家无标记姿态模型 | 强推,marker 骨架可当真值 |
| 研究病理人群运动学 | 不适合,无人群分层与临床量表 |
| 做步态周期分析 | 不适合,空间不足 |
| 做 IMU 相关研究 | 不适合,无 IMU 通道;转 rehab-wearable-kinematic 类资源 |
| 商用产品训练数据 | 可用,CC BY 4.0 允许,注意署名 |
| 需要大样本统计 | 不适合,10 人 |
10.3 维护触发点
以下情况发生时,本条目应当复核:① DataCat 上出现新 Revision 或新增受试者;② 论文发布勘误;③ 社区发布官方划分或基线(例如 Papers with Code 收录);④ 同批 rehab-wearable-kinematic 条目入库后,回填其 rid 到 §9.1。
事实清单(硬事实 32 条)
- 官方全称:The University of Liverpool Rehabilitation Exercise Dataset。
- 官方缩写:UL-RED。
- 论文发表于 Scientific Data,2025 年,卷 12。
- 论文 DOI:10.1038/s41597-025-05099-1。
- PMID:40341034。
- PMCID:PMC12062305。
- 受试者 10 名。
- 动作 22 个。
- 其中坐姿(Seated 前缀)动作 7 个。
- 模态 3 种:marker-based、marker-less、depth。
- 录制总数 1,320。
- 录制总时长「超过 3 小时」(限 marker 与 marker-less)。
- marker 采样率 250 FPS。
- marker-less 采样率 30 FPS。
- 反光标记 29 枚。
- 派生骨架 18 关节。
- 相机 8 台,OptiTrack Prime 17W。
- 录制区 4.4 m × 5 m。
- 动作区 2 m × 2 m。
- 相机高度 1 m 与 1.9 m 两档。
- 深度帧分辨率 160 × 120。
- 深度位深 16 bit。
- 无标记设备 Orbbec Persee,软件 Nuitrack。
- 三种节奏:normal、fast、slow。
- 两种录制协议:单次(R1)与三次重复(R3)。
- 命名格式:{MotionName}R{Rep}S{SubjectID}。
- 骨架格式 AMC + ASF。
- 解析工具 asfamc-parser(PyPI)。
- 许可证 CC BY 4.0。
- 数据目录 DOI:10.17638/datacat.liverpool.ac.uk/2729。
- 伦理批号 REF ID 10259。
- 同步方式:T-Pose 对齐 + 鼠标宏同时触发 + ADB/scrcpy 投屏。
术语表(26 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| 光学动捕 | optical motion capture | 用多台红外相机对反光标记做三角测量,直接解算三维位置 |
| 反光标记 | retro-reflective marker | 表面回归反射的红外标记球/贴片,被相机主动照明后高亮成像 |
| 无标记跟踪 | marker-less tracking | 不贴标记,直接从深度或彩色图像推断关节位置 |
| 深度图 | depth map | 每个像素记录到传感器距离的图像 |
| T-Pose | T-Pose | 双臂侧平举、双腿并拢的标定姿势,用于对齐与裁切 |
| 正向运动学 | forward kinematics | 由关节旋转与骨长推算末端位置 |
| 骨架文件 | ASF (Acclaim Skeleton File) | 描述关节层级、轴序、骨长与 T-Pose |
| 运动文件 | AMC (Acclaim Motion Capture) | 逐帧记录关节旋转与根平移 |
| 重定向 | retargeting | 把一套骨架的动作映射到另一套骨架 |
| 留一受试者交叉验证 | LOSO | 每次留一名受试者做测试,避免个体泄漏 |
| 动态时间规整 | DTW | 允许时间轴非线性伸缩的序列对齐算法 |
| 人体动作识别 | HAR | 从传感器或视频判断动作类别 |
| 重复计数 | repetition counting | 数出一次训练中动作重复的次数 |
| 远程康复 | telerehabilitation | 通过远程通信提供康复评估与训练 |
| 数字疗法 | digital therapeutics | 以软件为主要干预手段的疗法 |
| 代偿模式 | compensatory movement | 因疼痛或无力而出现的替代性动作策略 |
| 惯性测量单元 | IMU | 加速度计与陀螺仪的组合,测加速度与角速度 |
| 姿态解算 | attitude estimation | 由 IMU 数据推算身体节段朝向 |
| 积分漂移 | integration drift | 对角速度/加速度积分导致误差累积 |
| 标记间隙填补 | gap filling | 遮挡造成的标记缺失帧的插值补全 |
| 标记串号 | mislabeling | 自动标注把两枚标记的身份互换 |
| 采样率 | sample rate / FPS | 每秒采样帧数 |
| 面元 | frame | 一次采样得到的全部关节状态 |
| 轴序 | axis order | 欧拉角旋转的施加顺序,影响解析结果 |
| 根节点 | root joint | 骨架的基准关节,通常位于髋部 |
| 语料包 | record set | 按受试者打包的一组录制文件 |
FAQ(高频问答 24 问)
A. 基础认知
Q1:UL-RED 和「康复数据集」常见的那些有什么区别?
常见康复数据集多是影像(如关节 X 光、步态视频)或量表(如 Fugl-Meyer 评分)。UL-RED 是运动学序列,没有影像也没有量表,本质是一份「动作的三维轨迹档案」。
Q2:为什么叫 capture 而不是 dataset?
论文标题是 “A Human Motion Data Capture Study”,强调这是一次采集研究(capture study)的方法学报告,数据集是产物而非唯一目的。slug 取 rehab-motion-capture 即源于此。
Q3:22 个动作是怎么选的?
论文未给出系统性的筛选方法,只说「非专门化的康复动作」。从清单看,覆盖了下肢力量、髋膝活动度、上肢肩肘、躯干旋转与颈部活动,属于居家康复的通用动作库。
Q4:为什么有 7 个坐姿动作?
为了让行动能力受限者也能完成,同时天然提供「同一运动模式、不同体位」的配对样本。
Q5:受试者是患者吗?
不是。是普通成人,做的是康复动作,不是康复治疗。
B. 数据与获取
Q6:怎么下载?
访问 DataCat 的 eprint 2729 页面,按受试者点 S01–S10 下载。
Q7:需要注册吗?
不需要,页面标注可见性为 Anyone。
Q8:能商用吗?
能,CC BY 4.0,署名即可。
Q9:有中文文档吗?
没有。论文与目录都是英文。
Q10:数据有缺失吗?
官方未报告缺失。但单包 Revision 号不一致,提示有个别包被更新过。
C. 方法与工程
Q11:三个模态能逐帧对齐吗?
不能。需自行对齐,方法见 §3.3 与 §5.5。
Q12:AMC 怎么转成坐标?
用 ASF 的骨长与层级做正向运动学。
Q13:深度帧怎么读?
160×120、16 bit,每文件一帧,用 numpy.fromfile 读取后 reshape。
Q14:能导入 Blender 吗?
需要 AMC/ASF → BVH 的转换,社区有脚本,非官方支持。
Q15:asfamc-parser 好用吗?
轻量、够用,覆盖 AMC/ASF 的读写;复杂场景需自己补正向运动学。
D. 建模与评测
Q16:官方有基线吗?
没有。
Q17:怎么做训练/测试划分?
按受试者划分(LOSO),禁止随机划分。
Q18:动作分类能到多少准确率?
论文未报告,本文不臆测。可参考的直觉是:站立动作之间较易区分,坐姿变体之间较难。
Q19:重复计数用什么指标?
建议 MAE(次数误差)与边界 IoU 双指标。
Q20:节奏三分类难吗?
难,因为快慢是相对受试者自身的,需做个体归一化。
E. 局限与替代
Q21:能用来做步态分析吗?
不能,2×2 米空间不足。
Q22:能替代 IMU 研究吗?
不能,没有 IMU 通道。见 §9.1。
Q23:样本量够做深度学习吗?
按「独立受试者」算是 10,很小;按「序列条数」算是 440 条动作级记录,配合骨架输入尚可做小规模实验,但不建议从零训练大模型。
Q24:有更新的版本吗?
截至本文核验时点(2026-10-17),DataCat 上仍为 2024 年建库、2025 年 5 月最后修改的版本,无正式 v2。
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 条目名 | UL-RED / rehab-motion-capture |
| url_name | rehab-motion-capture |
| 类型 | 人体运动数据集(三模态) |
| 团队 | University of Liverpool(Reji / Paoletti / Fichera / D’Août) |
| 论文 | Scientific Data 2025, vol 12, doi:10.1038/s41597-025-05099-1 |
| 规模 | 22 动作 × 10 人 × 2 协议 × 3 模态 = 1,320 条 |
| 许可 | CC BY 4.0 |
| 抓取时点 | 2026-10-17 |
| 库内互链 | live-gaitneurokids(1055) / uci-har(1086) / sisfall(1075) / gait-pd(242) / gait-in-aging(232) / slam-laparoscopic-motions(762) |
附录 B:DAIMS 评估全表
| 维度 | 评分(1-10) | 依据 |
|---|---|---|
| D 可发现性 | 7 | Scientific Data 开放获取 + DataCat 公开页 + PMID/PMCID 齐全;但无独立项目主页、无搜索引擎优化,题名冗长含大学名,易与校方其他数据混淆 |
| A 可获取性 | 9 | 十个 zip 公开直链、无需注册、无需 DUA;扣分项是逐受试者分包导致需多次下载,且无一次性全量包 |
| I 可互操作 | 6 | AMC/ASF 是文本开放格式但生态窄,需自研解析或依赖作者的小众 PyPI 包;无 BVH/DICOM 官方导出;深度帧为裸二进制无元数据文件 |
| M 元数据质量 | 7 | DataCat 给出受试者分包、伦理批号、许可、联系人;论文给出完整动作表、相机布置、伪代码。缺 README 级字段字典与深度单位说明 |
| S 可持续性 | 7 | 依托大学机构库(DataCat),比个人网盘稳定;但依赖单一机构长期维护,无镜像、无 Zenodo DOI |
| 综合评级 | 7.2/10(良) | 可获取性与许可为最大加分项;互操作性与元数据细节为最大短板 |
附录 C:逐项证据链与双口径存照
| 关键数字 | 来源 | 位置 |
|---|---|---|
| 10 受试者 / 22 动作 / 3 模态 / 1,320 录制 | 论文摘要 + DataCat 描述 | 两处一致 |
| 250 FPS / 30 FPS | 论文方法节 | PMC 全文 |
| 29 标记 / 18 关节 | 论文方法节 + Fig.4 | PMC 全文 |
| 8 台相机 / 1 m 与 1.9 m / 4.4×5 m / 2×2 m | 论文方法节 + Fig.2 | PMC 全文 |
| 160×120 / 16 bit | 论文 Data Records 节 | PMC 全文 |
| 7 个 Seated 动作 | 论文 Table 3 | PMC 全文 |
| normal/fast/slow | 论文摘要 + DataCat 描述 | 两处一致 |
| CC BY 4.0 | DataCat 逐文件标注 | 目录页 |
| 伦理 REF 10259 | DataCat 伦理声明 | 目录页,论文正文未逐字复述 |
| 单包 512–639 MB | DataCat 文件列表 | 目录页 |
| 建库 2024-07-01 / 最后修改 2025-05-08 | DataCat 元数据 | 目录页 |
双口径与瑕疵存照:
- 「1,320」是录制条目数(含三模态),不是视频数、不是样本数——论文与目录措辞不同(recordings vs samples)但数学同源。
- 「>3 小时」限定为 marker 与 marker-less,深度流时长未单列。
- 论文 PDF 中 “retro—reflective” 使用全角破折号、“marker-Less” 大小写不一,属排版缺陷。
- 相机型号写作 “OptiTrack 17 W Prime”,标准写法为 Prime 17W;本文以标准写法为主,此处存照。
- DataCat 各包 Metadata Revision 4–5 不一致,无 changelog 说明差异内容。
- 伦理批号仅见于 DataCat,论文正文未逐字引用。
- 论文收稿/接收日期未逐字录得,列为遗留疑点。
附录 D:与前代/邻近资源的对照速查
| 对照项 | UL-RED | IMU 类康复/活动集 | 视频类 HAR 集 |
|---|---|---|---|
| 真值来源 | 红外三角测量 | 传感器积分 | 人工标注类别 |
| 绝对位置 | 有 | 无(需积分) | 无 |
| 场地 | 固定实验室 | 任意 | 任意 |
| 许可典型值 | CC BY 4.0 | 各异 | 各异 |
| 适合任务 | 校准、计数、跨模态 | 长时监测 | 类别识别 |
附录 E:使用前检查清单
- 确认下载的是哪个 Revision;
- 打开一段 AVI 确认三模态画面同时存在;
- 用 asfamc-parser 读一段 AMC,打印帧数与关节数(应为 18);
- 检查首帧是否 T-Pose;
- 读一帧深度,确认 reshape 后无异常;
- 核对 3Rep 标签 CSV 的三段边界是否落在动作周期内;
- 决定划分策略(必须 LOSO);
- 记录本次使用的模态组合与对齐方法,写进方法学。
补章 A:逐动作解剖——22 个动作的运动学要点
本节逐一拆解每个动作的关节参与、常见错误与对算法的影响,目的是让使用者在建模前就知道「哪些动作容易混」「哪些动作会暴露传感器短板」。表中角度均为论文描述中的约定值,非实测统计。
A.1 下肢站立动作(#1–#6)
SitToStand(从坐到站)。 这是整份数据集里运动幅度最大的动作:髋、膝、踝三关节同时经历大幅屈伸,重心在垂直方向位移可达 40 cm 以上。它也是唯一一个「跨越坐与站两个体位」的动作,因此在做体位分类时容易与 Seated 组混淆。算法要点:根节点平移量是整个数据集中最大的一段,若做了去平移预处理,这个动作会丢失最关键的信息——建议对 SitToStand 保留绝对高度,或额外提供归一化后的版本。
常见错误:受试者用手撑膝借力、上身过度前倾(代偿)。数据集未标注这类错误,但它们在轨迹上表现为躯干前倾角与髋角的不同步。
MiniSquat(微蹲)。 双臂前伸保持伸直,屈膝约 45°。与标准深蹲相比幅度小,膝关节角度变化在 0–45° 之间。算法要点:屈膝角度小意味着信号弱,基于角速度峰值的重复计数容易漏计;建议改用髋-膝相对距离的周期性变化。
CalfRaise(提踵)。 前脚掌着地、抬起脚跟。这是唯一一个主要发生在踝关节的站立动作,膝髋几乎不动。算法要点:踝关节角度变化幅度小(通常 20–30°),在 18 关节骨架中容易淹没在噪声里;同时它对称性极强(双脚同时),不涉及左右交替。
SidewaysLegLift(侧抬腿)。 左腿伸直侧抬,然后换右腿。算法要点:涉及髋外展,是额状面动作,在单目或深度相机的正面视角下遮挡最轻,但在侧面视角下几乎不可见——这提示多视角或三维骨架的必要性。
LegExtensionBackward / LegExtensionForward(后摆腿 / 前摆腿)。 同样是单腿伸直摆动,方向分别为后与前。这两个动作的差异仅在于矢状面内的摆动方向,是「动作分类」任务里最容易混淆的一对——如果模型只看关节角度幅度而不看符号,两者几乎不可分。
小结: 下肢站立六式的共同特征是「单关节主导 + 左右交替」,适合做重复计数基准;风险是幅度小的动作(CalfRaise、MiniSquat)在低帧率或无标记数据上信噪比差。
A.2 上肢与躯干站立动作(#7–#16)
BicepCurls(弯举)。 屈肘向胸前,然后还原。纯肘关节动作,肩部基本固定。算法要点:这是最简单的动作,常被用作流水线的「冒烟测试」——如果你的解析链路能正确数出弯举次数,说明整体链路是通的。
SidewaysBend(侧屈)。 一手沿体侧下滑至同侧膝,臂保持伸直,然后换侧。涉及脊柱侧屈与髋外展的组合。算法要点:18 关节骨架对脊柱的描述是粗粒度的(通常只有腰与头两点),侧屈角度只能通过腰-头连线与垂直方向的夹角近似,精度受限。
SidewaysStep / FullFrontalSidewaysStep(侧步 / 正面侧步)。 前者侧向迈一步后还原并换腿,后者面向前方侧向迈步、左右交替。两者都含水平位移,是数据集中少数「根节点有明显水平平移」的动作。算法要点:FullFrontalSidewaysStep 的「面向前方」约束使它成为检验「朝向不变性」的好样本——如果模型依赖躯干朝向做分类,这个动作会暴露问题。
KneeRaise(抬膝)。 单膝抬至 90°,左右交替。这是站立动作里最典型的「重复计数」样本,膝角速度的峰值非常清晰。
KneeRaiseWithOpHandTouch(抬膝对侧触手)。 抬左膝的同时右手触左膝。这是数据集里唯一一个跨中线协调动作(对侧手脚配合)。算法要点:单侧肢体的信息不足以判定动作类别,必须同时看上肢与下肢;对只输入单侧关节序列的模型,这个动作会被误判为普通 KneeRaise。
ArmRaise / ForwardArmRaise(侧举 / 前举)。 前者双臂侧举至头顶相合,后者双臂前举至与地面平行。两者的区别在运动平面(额状面 vs 矢状面)。算法要点:这两种动作在 T-Pose 检测算法附近有风险——ArmRaise 举到水平时,手臂与脊柱夹角恰好是 90°,落入 T-Pose 判定的 ±10° 窗口,若这一段被误判为标定段,裁切会把动作中间部分切掉。这是 §4.2 提到的风险的具体落地场景。
HipHoops(髋部绕环)。 髋向外顶出并逆时针绕环一周。这是唯一一个圆周运动动作,非往复。算法要点:重复计数的定义在此模糊——「一周」算一次还是「一个来回」算一次?标签里按录制协议给的是三次,实务上建议以髋部水平轨迹的极角累计 360° 为一次。
FrontalChestPress(胸前推)。 双臂侧举至水平后向内合拢。算法要点:与 ArmRaise 的起始姿态相似但终点不同(相合 vs 头顶),是又一对「起始相同、终点不同」的易混动作。
小结: 上肢组的关键词是「平面」与「对称性」;躯干组的难点是骨架对脊柱的描述粒度不足。
A.3 坐姿动作(#17–#22)
坐姿七式并非独立动作库,而是站立动作的体位变换。这种设计带来两个直接后果:
- 配对样本:SeatedArmRaise 与 ArmRaise、SeatedHipMarch 与 KneeRaise、SeatedChestStretch 与 FrontalChestPress 是三对显式配对。研究者可以构造「同动作不同体位」的对照实验,检验模型是否学到了与体位无关的运动模式。
- 区分难度上升:坐姿下,下肢被座椅遮挡、躯干高度固定,剩下的判别信息主要来自上肢。这意味着坐姿组内的动作之间相似度更高,分类更难;同时无标记系统在坐姿下的下肢估计质量会下降。
SeatedLegStretch(坐姿伸腿)。 单腿前伸至全伸展。在坐姿下膝关节从约 90° 伸至 0°,幅度大但被座椅部分遮挡。
SeatedUpperBodyTwist(坐姿转体)。 双臂胸前交叉成 X,上身向一侧扭转。这是唯一以躯干旋转为主的动作,但由于骨架对脊柱的分节有限,扭转角度只能由肩线相对髋线的夹角近似。
SeatedNeckRotation(坐姿转颈)。 上身朝前,头颈转向一侧。这是全数据集中幅度最小的动作:只有头标记在动,其余关节几乎静止。算法要点:在 18 关节、250 FPS 的骨架里,颈部动作的信号只有头部相对腰部的朝向变化,极容易被噪声淹没;这也是检验「传感器能否捕捉微小运动」的边界样本。
小结: 坐姿组适合做「低幅度动作的识别极限」研究,也适合作为「体位不变性」实验的对照组。
A.4 22 个动作的难度分层(编者按)
综合运动幅度、遮挡程度与类别相似度,把 22 个动作粗分为三层,供实验设计参考:
| 层级 | 动作 | 判别难度 | 主要挑战 |
|---|---|---|---|
| 易 | SitToStand, BicepCurls, KneeRaise, ArmRaise, CalfRaise | 低 | 幅度大、模式清晰 |
| 中 | MiniSquat, SidewaysLegLift, LegExtension*, SidewaysStep, ForwardArmRaise, HipHoops, FullFrontalSidewaysStep, SeatedLegStretch, SeatedArmRaise, SeatedHipMarch | 中 | 存在易混对 |
| 难 | SidewaysBend, KneeRaiseWithOpHandTouch, FrontalChestPress, SeatedChestStretch, SeatedUpperBodyTwist, SeatedNeckRotation | 高 | 幅度小、需跨肢体信息、遮挡重 |
这张表是编者基于动作描述的主观分层,不是论文内容,使用时请以自己在数据上的实测为准。
补章 B:同场三模态的误差画像——如何做一次严肃的对照研究
B.1 为什么要做这个对照
无标记姿态估计的论文通常报告 MPJPE(平均每关节位置误差)这类指标,但测试集多是 Human3.6M、MPI-INF-3DHP 这类通用动作库。这些库里的动作是走路、跳舞、打电话——不是康复动作。UL-RED 提供的,是一个「康复动作 + 同场光学真值」的测试台。
严肃的对照研究应当回答四个问题:
- 哪个关节最不可信? 直觉是远端(腕、踝)误差大,但坐姿下膝踝可能更糟。
- 哪个动作最容易崩? 遮挡重的动作(坐姿、交叉肢体)应当明显更差。
- 节奏影响多大? 快节奏下运动模糊与跟踪丢失会加剧误差。
- 误差是系统的还是随机的? 若误差集中在某个方向(如深度方向),说明是标定问题而非算法问题。
B.2 对照实验的最小设计
步骤一:对齐。 取同一动作、同一受试者、同一协议的 marker 与 marker-less 序列,先用 T-Pose 帧对零点,再用髋部水平速度曲线做互相关,估计残余时延 τ。把 τ 记录在案。
步骤二:重采样。 把 250 FPS 的 marker 序列降采样到 30 FPS,与 marker-less 一一对应。注意降采样方式(抽帧 vs 平均)会影响结果,建议两种都算。
步骤三:坐标系归一化。 两套系统的坐标原点与朝向不同。用 T-Pose 帧估计一个刚体变换(旋转 + 平移 + 可选缩放),把 marker-less 变换到 marker 坐标系。
步骤四:逐关节误差。 计算每个关节的欧氏距离误差,报告均值、中位数、95 分位。中位数比均值更稳健,因为跟踪丢失会产生极端值。
步骤五:分层统计。 按「动作 × 关节 × 节奏」三维分层,找出最差的组合。
B.3 预期会看到什么(编者推断,非论文结论)
以下是基于同类研究的经验推断,未经本文实测,仅供实验设计参考:
- 腕、踝误差大于髋、肩——远端关节在深度图中的像素分辨率更低;
- 坐姿动作的下肢误差显著上升——座椅遮挡 + 深度相机俯视角度不佳;
- 快节奏下误差上升——帧间位移大,跟踪器易丢失;
- 朝向深度轴(Z 向)的误差大于成像平面内(X/Y)——深度估计本身精度较低。
如果实测结果与上述推断相反,那本身就是有价值的发现,值得单独报告。
B.4 这个对照不能回答什么
- 不能回答「现代模型有多好」:Persee + Nuitrack 是 2024 年前后的消费级方案,与今天的 RTMPose、MediaPipe 不可直接比较。要做代际比较,需自己把 AVI 或深度重跑现代模型。
- 不能回答「临床可用性」:误差多少度算「临床可接受」需要治疗师判断,数据集不提供这个阈值。
- 不能分离同步误差:由于同步是软件实现的,部分误差来自时间错位而非空间估计。建议在对齐残差较大(如 >50 ms)的样本上单独标注。
补章 C:许可、合规与二次分发
C.1 CC BY 4.0 到底允许什么
CC BY 4.0 是知识共享署名许可中限制最少的一档,核心只有一条义务:署名。具体到 UL-RED:
| 行为 | 是否允许 | 条件 |
|---|---|---|
| 学术使用 | 允许 | 引用论文与 DataCat DOI |
| 商业使用(训练模型、做产品) | 允许 | 同上 |
| 修改、再加工(重定向、增强、合成) | 允许 | 需注明「基于 UL-RED 修改」 |
| 再分发(镜像、打包进自家数据集) | 允许 | 保留署名与许可声明 |
| 附加限制(如要求下游也开源) | 不允许 | CC BY 不允许加「相同方式共享」类条款 |
C.2 署名怎么写
推荐的最小署名格式:
Reji, N., D’Août, K., Fichera, S., & Paoletti, P. (2024). The University of Liverpool Rehabilitation Exercise Dataset (UL-RED) [Data set]. University of Liverpool. https://doi.org/10.17638/datacat.liverpool.ac.uk/2729
若同时引用方法学,加论文:
Reji, N., D’Août, K., Fichera, S., & Paoletti, P. (2025). A Human Motion Data Capture Study The University of Liverpool Rehabilitation Exercise Dataset. Scientific Data, 12. https://doi.org/10.1038/s41597-025-05099-1
C.3 人体数据的合规要点
即便数据已匿名化,使用人体运动数据仍应注意:
- 不尝试再识别:数据不含姓名,但骨架比例 + 动作习惯理论上具备一定辨识度,不应尝试关联外部信息;
- 不用于个体诊断:这是 10 名健康成人的动作,不构成任何个体的医学结论;
- 遵守机构伦理要求:若你的机构对二次使用人体数据有备案要求,应按流程报备;
- 伦理批号可引用:DataCat 记载的 REF ID 10259 可作为「数据采集合规」的佐证,但它是利物浦大学的批号,不是你的。
C.4 与「仅学术使用」类数据的差异
库里不少数据集是 upon request 或 non-commercial。UL-RED 是少数可以直接商用的运动数据集之一。这一差异在选型时有实际意义:做原型的团队往往在商业化阶段才发现许可不允许,届时替换数据的成本很高。
补章 D:把 UL-RED 接进一条真实流水线
D.1 一个典型的居家康复产品架构
手机摄像头 / 深度模组
      ↓ 帧流
姿态估计(RTMPose / MediaPipe / 自研)
      ↓ 关节序列(每帧 17–33 点)
动作分割(时序模型)
      ↓ 动作片段
动作分类(22 类映射到处方动作)
      ↓
重复计数(峰值检测 / 分割头)
      ↓
质量评估(幅度、节奏、对称性)
      ↓
反馈给患者 + 上报治疗师
UL-RED 能切入的位置有四处:
- 姿态估计的离线评测:用 marker 真值测自家模型在康复动作上的误差;
- 动作分割的训练数据:3Rep 的时间戳就是分割标签;
- 重复计数的单元测试:三节奏样本检验计数器的稳健性;
- 质量评估的参照系:用正常受试者的运动学统计量作为「参考分布」,为患者数据提供偏离度基线。
D.2 一个常见的工程误区
不少团队会把「实验室骨架」直接当成「模型输出骨架」来用,忽略了三点差异:
- 关节定义不同:UL-RED 是 18 关节,MediaPipe 是 33 点,RTMPose 常用 17 点(COCO)。直接按索引对齐会错位。
- 坐标约定不同:AMC 用旋转 + 根平移,模型输出是绝对坐标。两者要统一到同一表示(建议都用绝对坐标 + 骨长归一化)。
- 尺度不同:Persee 的骨架尺度与真人尺寸有偏差,需要按骨长做缩放。
处理方式是写一个显式的「骨架适配层」,把三套定义映射到内部的统一 18 关节表示,并把这个映射表作为方法学的一部分报告出来。
D.3 从研究到产品的三道门槛
- 精度门槛:关节误差是否小于临床可判别的阈值(例如膝角误差 <5°);
- 鲁棒门槛:在不同体型、衣着、光照、相机位置下是否稳定;
- 合规门槛:是否满足医疗器械软件或数字疗法的注册要求。
UL-RED 只能帮过第一道,且只在「健康成人 + 实验室环境」条件下。后两道需要自有数据与临床验证。
补章 E:常见误解澄清(十条)
误解一:UL-RED 是「患者康复数据」。
不是。受试者是普通成人,做的是康复动作库里的动作。它能支撑「算法研究」,不能支撑「患者运动学特征」的结论。
误解二:三种模态可以互相替代。
不能。marker 是真值、marker-less 是被测对象、depth 是原始观测。三者的角色不同,混用会导致循环论证(例如用 marker-less 当标签去评估 marker-less)。
误解三:数据量大到可以直接训练大模型。
1,320 条录制听起来不少,但独立受试者只有 10 人。按序列算是小数据集,适合做微调、评测、或与合成数据混合训练,不适合从零预训。
误解四:CC BY 4.0 意味着可以随便用。
可以商用,但必须署名,且不能给下游加额外限制。忽略署名的后果是被要求撤下成果。
误解五:AMC 是通用格式,所有软件都能读。
AMC/ASF 是 1990 年代的格式,现代引擎基本不原生支持。需要转换。
误解六:T-Pose 裁切是万无一失的。
阈值宽松(±10°),且部分动作在特定瞬间会落入判定窗口。裁切结果需要人工抽查。
误解七:标签里的 R3 表示「三次重复」,所以每段视频有三倍长。
R3 是协议代号,确实录了三次,但时长取决于动作快慢与节奏,不是简单三倍。
误解八:节奏标签可以用来自动判断「做得好不好」。
不能。快慢只是速度,与动作质量(幅度、稳定性、对称性)是不同维度。
误解九:这套数据和 IMU 数据可以混着训一个模型。
理论上可以,但需要对齐到统一的表示与坐标系;实践中更常见的是分别建模、在决策层融合。UL-RED 本身无 IMU 通道。
误解十:论文里的「first」说法可以当定论。
「首个包含不同速度重复的康复运动数据集」是作者自述,未见第三方系统综述背书。引用时应标注为作者主张。
补章 F:与身体运动学的接口——从关节角到临床指标
F.1 关节角的计算
从 AMC 的旋转得到关节角,需要按 ASF 的轴序把欧拉角转成旋转矩阵,再取相邻骨段之间的夹角。以膝关节为例:
θ_knee = arccos( (v_thigh · v_shank) / (|v_thigh| |v_shank|) )
其中 v_thigh 为髋→膝向量、v_shank 为膝→踝向量。注意 AMC 给的是局部旋转,要得到世界坐标下的骨段向量,必须先做正向运动学。
F.2 常用临床指标的近似计算
| 指标 | 计算方式 | 在 UL-RED 上的可行性 |
|---|---|---|
| 关节活动度(ROM) | 动作周期内关节角的最大值减最小值 | 可行,精度取决于骨架粒度 |
| 角速度峰值 | 对关节角求一阶导 | 可行,250 FPS 下数值稳定 |
| 动作对称性 | 左右同名关节角的差异 | 可行,但需左右交替动作 |
| 躯干前倾角 | 腰-头连线与竖直方向夹角 | 近似可行 |
| 重心轨迹 | 需质量分布模型 | 不可行,无体重数据 |
| 步态周期/步频 | 需连续行走 | 不可行,空间不足 |
| 地面反作用力 | 需测力台 | 不可行,无测力数据 |
这张表的左列是临床常用的运动学指标,右列是该数据集能否支撑的结论。「不可行」的三项是最容易越界的地方——尤其重心,很多人以为有了 18 关节就能算重心,实际上没有节段质量参数就只能做粗略假设。
F.3 与量表的关系
康复评估的金标准通常是量表(Fugl-Meyer、Berg 平衡、TUG 等),而不是关节角。UL-RED 不含任何量表评分,因此无法直接建立「关节角 → 量表分」的映射。要做这件事,需要另找带有同步量表评分的队列数据。
一个可行的中间路线是:用 UL-RED 训练「动作识别 + 重复计数」的基础模型,再在带量表的小队列上做迁移学习。这也是数据集在真实研究中最可能被采用的路径。
补章 G:数据集的版本、引用与长期维护
G.1 版本状态
DataCat 的元数据字段显示:建库 2024-07-01,最后修改 2025-05-08,各受试者包的 Metadata Revision 为 4 或 5。这意味着:
- 至少经历过 4 次元数据修订;
- 不同包的修订次数不同,可能存在个别包的修正;
- 没有公开的 changelog。
实践建议:下载时记录抓取日期与各包 Revision,写进实验记录的「数据版本」字段。这在复现失败时是第一手线索。
G.2 引用规范
学术论文中的引用应至少包含三层信息:数据集本体(DataCat DOI)、方法学论文(Scientific Data DOI)、以及具体使用的子集(S01–S10 中哪些)。第三层常被忽略,但它是复现的关键。
G.3 长期维护风险
- 单点托管:数据只存于利物浦大学机构库,无 Zenodo/figshare 镜像。若机构库迁移或下线,链接会失效。
- 个人联系:页面留的是通讯作者邮箱,作者毕业后可能失效。
- 无社区治理:没有 GitHub 仓库、没有 issue 跟踪、没有官方划分的更新机制。
对策:本地留存一份完整副本(CC BY 4.0 允许再分发),并在自己的数据管理计划中登记。
G.4 可能的后续版本
若能联系作者,值得建议的改进包括:① 发布一次性全量包与统一 README;② 补齐深度帧单位与无效值说明;③ 发布官方 LOSO 划分;④ 追加 IMU 通道(哪怕是子集)。这四项若能实现,数据集的可用性会有质变。
补章 H:横向比较——康复运动数据集的四种形态
H.1 按数据形态分类
当前公开的康复运动相关资源,大致可分四类:
第一类:量表与临床评估数据。
记录患者完成标准评估(如 Fugl-Meyer)的评分,偶附视频。价值在临床终点,缺陷是运动学信息粗。
第二类:影像与视频。
康复训练的过程录像,或关节影像。价值在直观,缺陷是缺乏三维真值。
第三类:可穿戴传感器序列。
IMU、压力鞋垫、肌电。价值在可穿戴与长时,缺陷是无绝对位置、有漂移。
第四类:光学动捕序列。
即 UL-RED 所属。价值在真值与三维精度,缺陷是实验室约束。
这四类不是替代关系而是层级关系:第四类提供「物理真值」,第三类是「可部署形态」,第二类是「可解释证据」,第一类是「临床终点」。一份完整的研究往往需要跨层拼接。
H.2 UL-RED 在四类中的独特位置
它是少数同时具备「三维真值」与「消费级对照」的资源。多数光学动捕数据集只有 marker 一路,不做无标记对照;多数无标记数据集没有同场真值。UL-RED 把两者放在同一房间、同一批动作上,这个设计本身比规模更有价值。
H.3 如果要做跨数据集研究
一个自然的想法是把 UL-RED 与某个 IMU 数据集拼接,做跨模态迁移。这条路有三个坑:
- 动作集不重合:IMU 数据集多测日常活动,UL-RED 测康复动作,标签空间对不上;
- 采样率差异:IMU 常见 50–100 Hz,需要重采样;
- 坐标系与骨长:不同受试者、不同系统的骨架定义不同,必须做骨骼规范化。
更现实的做法是:在 UL-RED 上学「动作的通用表征」,在 IMU 数据上只做微调与评估,而不是假设两者可以逐样本对齐。
补章 I:给不同读者的阅读路径
I.1 算法工程师
先读 §2(规格)→ §3.3(同步)→ §5.5(任务配方)→ 补章 B(对照研究)→ 坑点清单。跳过 §7 的临床部分。
I.2 康复治疗师 / 临床研究者
先读 §0(问题定义)→ §3.1(动作清单)→ §4.4(标签缺口)→ 补章 F(临床指标可行性)→ §10.2(决策卡)。重点关注「不能做什么」。
I.3 产品经理
先读 INFOBOX → §1(十问)→ §7.3(产品用法)→ 补章 C(许可)→ 补章 D(流水线)。重点关注许可与落地路径。
I.4 数据管理者
先读 §6(坑点)→ 附录 B(DAIMS)→ 补章 G(版本与维护)→ 附录 E(检查清单)。
I.5 学生 / 首次接触
先读 §1 十问 → §5.1–5.4(动手)→ 坑点清单 → FAQ。动手跑通 S01 比读十页文字更有用。
补章 J:未解问题清单
以下问题在论文与目录中均无答案,属于本条目核验后仍开放的事项,供后续研究者参考:
- 受试者画像缺失:10 人的年龄、性别、身高体重、运动习惯均未给出。这直接影响「跨体型泛化」的讨论。
- 节奏标签的实测验证:论文未报告三种节奏下的实际周期统计。若能算出 normal/fast/slow 的中位周期比,节奏任务的可学性才有依据。
- 同步残差量级:软件同步的实际误差未量化。这是跨模态研究最大的不确定项。
- T-Pose 误判率:宽松阈值下有多少段被误切,未报告。
- 标注者一致性:三次重复的时间戳由单人标注还是多人,未说明;无一致性指标。
- 深度帧的单位与无效值:无说明文件,需使用者自行推断。
- marker-less 骨架的关节定义:是否与 marker 侧的 18 关节一一对应,未明确说明。
- AVI 的编码参数:未说明,影响逐帧抽取的精度。
- 是否存在未发布的额外受试者:目录只列 S01–S10,论文也写 10 人,一致,但无第三来源。
- 后续计划:作者是否计划扩展数据集(更多受试者、病理人群、IMU 通道),论文未提及。
补充 FAQ(12 问)
Q25:22 个动作里有几个是左右对称的?
多数是「一侧做完换另一侧」的交替动作,因此单段录制内同时包含左右两侧。只有 CalfRaise(双脚同时)、ArmRaise(双臂同时)、ForwardArmRaise(双臂同时)、FrontalChestPress(双臂同时)、SeatedChestStretch、SeatedArmRaise、SeatedUpperBodyTwist(左右各一次)、SeatedNeckRotation(左右各一次)属于双侧同时或对称动作。
Q26:3Rep 的三次之间有没有休息?
论文未说明。从「连续做三次」的表述看应为连续完成,无组间休息。
Q27:受试者是否经过动作教学?
论文提到用显示屏做实时反馈帮助保持正确姿势,但未说明是否事先教学。从「非专门化动作」的定位看,应为简单示范后自行完成。
Q28:能否用这份数据做「动作标准度打分」?
不能直接做。数据没有「标准动作」的专家评分,也没有「错误动作」的负样本。可行的替代是:以群体统计量(如关节角分布)作为参考,做离群检测——但这只是「偏离常态」,不等于「不标准」。
Q29:深度帧为什么分辨率这么低?
受限于 Persee 所用深度模组的规格(早期结构光方案)。低分辨率不影响「有深度」这一事实,但会限制精细的体表形变分析。
Q30:能不能只用深度做动作识别?
可以尝试。160×120 的深度序列在轻量 CNN 上可跑,但信息量有限;更常见的是把深度转成点云或伪彩色图再用 2D 骨干。
Q31:AMC 里的旋转是欧拉角还是四元数?
AMC 传统上用欧拉角(每关节 3 个值),具体轴序由 ASF 指定。导入时必须读取 ASF 的 axis 字段,否则会得到错误姿态。
Q32:为什么用 ceiling 而不是四舍五入做标签换算?
论文原文用 ceil,可能是为了避免出现 0 或负索引。副作用是无标记侧标签恒偏晚,见 §4.3。
Q33:数据集里有没有跌倒动作?
没有。全部是受控的康复训练动作,不含跌倒、失衡等意外事件。需要跌倒数据应看 sisfall(rid 1075)。
Q34:能否用于手术动作识别?
不能,动作语义完全不同。手术动作识别可参考 slam-laparoscopic-motions(rid 762)。
Q35:论文里提到的 asfamc-parser 是官方维护的吗?
是作者发布在 PyPI 的包,属官方配套工具,但维护活跃度有限,复杂场景需自行补代码。
Q36:如果只想快速验证,最少下多少数据?
只下 S01.zip 即可跑通全流程:22 个动作 × 2 协议 × 3 模态都在里面,足以完成解析、可视化与一次小规模实验。
补充术语(10 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| 无标记姿态估计 | marker-less pose estimation | 从图像或深度直接回归关节位置 |
| 关键点 | keypoint | 姿态估计输出的关节像素/空间坐标 |
| 骨长归一化 | bone-length normalization | 按骨段长度缩放,消除体型差异 |
| 动作分割 | temporal action segmentation | 在长序列中切出动作片段 |
| 相似度矩阵 | similarity matrix | 序列对齐中衡量两帧相似程度的矩阵 |
| 测力台 | force plate | 测量地面反作用力的设备 |
| 关节活动度 | ROM (range of motion) | 关节在动作中能达到的角度范围 |
| 组间休息 | inter-set rest | 多组训练之间的间歇 |
| 点云 | point cloud | 由深度反投影得到的三维点集合 |
| 伪彩色图 | pseudo-color image | 把深度值映射成颜色以便二维网络处理 |
附录 F:动作-关节参与矩阵(编者整理)
下表列出 22 个动作的主要参与关节(●=主导,○=参与,空=基本不动)。该矩阵基于论文的动作文字描述整理,属编者推断,用于快速筛选「该动作能否区分某两个关节」。
| 动作 | 颈 | 肩 | 肘 | 腕 | 躯干 | 髋 | 膝 | 踝 |
|---|---|---|---|---|---|---|---|---|
| SitToStand | ○ | ○ | ● | ● | ● | ● | ||
| MiniSquat | ○ | ○ | ○ | ● | ● | ○ | ||
| CalfRaise | ○ | ● | ||||||
| SidewaysLegLift | ○ | ● | ○ | |||||
| LegExtensionBackward | ○ | ● | ○ | |||||
| LegExtensionForward | ○ | ● | ○ | |||||
| BicepCurls | ○ | ● | ○ | |||||
| SidewaysBend | ○ | ○ | ● | ○ | ||||
| SidewaysStep | ○ | ● | ○ | ○ | ||||
| KneeRaise | ○ | ● | ● | |||||
| ArmRaise | ● | ○ | ○ | ○ | ||||
| ForwardArmRaise | ● | ○ | ○ | ○ | ||||
| FullFrontalSidewaysStep | ○ | ● | ○ | ○ | ||||
| KneeRaiseWithOpHandTouch | ○ | ● | ● | ○ | ● | ● | ||
| HipHoops | ○ | ● | ○ | ○ | ||||
| FrontalChestPress | ● | ○ | ○ | ○ | ||||
| SeatedLegStretch | ○ | ○ | ● | ○ | ||||
| SeatedChestStretch | ● | ○ | ○ | ○ | ○ | |||
| SeatedUpperBodyTwist | ○ | ○ | ● | ● | ||||
| SeatedHipMarch | ○ | ● | ● | |||||
| SeatedArmRaise | ● | ○ | ○ | ○ | ||||
| SeatedNeckRotation | ● | ○ |
F.1 矩阵的三个用法
用法一:设计消融实验。 若想验证「上肢信息对分类的贡献」,可只输入肩肘腕三关节,比较在「上肢主导动作」(ArmRaise 等)与「下肢主导动作」(KneeRaise 等)上的性能落差。
用法二:识别不可分的动作对。 参与关节完全相同的动作对(如 ArmRaise 与 ForwardArmRaise,矩阵上完全一致)只能靠运动方向区分,而这需要带符号的角度序列而非角度幅值。
用法三:挑选边界样本。 SeatedNeckRotation 只有颈部主导,是检验传感器下限的天然样本;KneeRaiseWithOpHandTouch 需要跨肢体信息,是检验多流融合的样本。
F.2 矩阵的局限
- 矩阵基于文字描述,未统计实际角度;
- 「参与」与「主导」的划分是主观的;
- 坐姿动作中,座椅对下肢的遮挡未反映在矩阵里——矩阵描述的是「动作本身」,不是「可观测性」。可观测性取决于相机位置,属于另一维度。
附录 G:一条从零开始的 48 小时上手路线(编者建议)
第 0–2 小时:核实与下载。
读论文摘要与方法节,打开 DataCat 页面,只下 S01.zip。核对文件大小与 Revision。
第 2–6 小时:解析跑通。
装 asfamc-parser,读一段 AMC 与 ASF,打印帧数、关节数、采样率。用 numpy 读一帧深度并可视化。
第 6–10 小时:可视化验证。
把骨架序列与对应 AVI 并排播放,确认帧对齐与关节语义正确。这一步能挡掉后续 80% 的隐性错误。
第 10–16 小时:构建内部表示。
把 AMC 转成努比数组(T×J×3 或 T×J×rot),做根节点归一化,存为 npy/h5。写一个数据加载器。
第 16–24 小时:冒烟任务。
先在 BicepCurls 上做二分类(弯举 vs 其余),再扩展到 22 类。用 LOSO。记录基线。
第 24–32 小时:重复计数。
在 3Rep 上实现峰值检测基线,计算 MAE 与边界 IoU。对比三节奏的表现差异。
第 32–40 小时:跨模态对照。
取 3–5 个动作,做 marker vs marker-less 的误差统计,按关节分层。
第 40–48 小时:写报告。
把对齐方法、划分策略、误差分层、局限写清楚。特别注意把「同步残差」与「空间误差」分开报告。
G.1 这条路线刻意省略了什么
- 没有做深度与骨架的联合建模(成本高、收益不确定);
- 没有做逆动力学(18 关节粒度不足);
- 没有做重定向合成(属于进阶数据增强,可后续再加)。
G.2 判断「跑通了」的四条标准
- 能完整重建一段骨架并与 AVI 视觉一致;
- LOSO 的 22 类分类结果显著高于多数类基线;
- 重复计数的 MAE 小于 0.5 次;
- 跨模态误差的量级与文献报道的消费级深度方案相符。
四条都满足,说明数据链路无系统性错误;任一不满足,优先查对齐与坐标系,而不是换模型。
附录 H:与「运动捕捉」同名异义条目的消歧
检索「motion」时,本库会出现多个语义完全不同的条目,使用前请核对:
| slug | rid | motion 指什么 | 与本文关系 |
|---|---|---|---|
| rehab-motion-capture | 本条目 | 人体肢体运动轨迹 | — |
| cmrxmotion | 687 | 心脏 MRI 的呼吸/运动伪影 | 同名不同义,勿混 |
| slam-laparoscopic-motions | 762 | 腹腔镜手术的动作片段 | 同为动作识别,场景不同 |
| gait-pd | 242 | 帕金森步态 | 同为人体运动,任务不同 |
| gait-in-aging | 232 | 神经退行性疾病步态 | 同上 |
| live-gaitneurokids | 1055 | 儿科步态(IMU+视频) | 同为康复运动,模态部分重叠 |
| uci-har | 1086 | 智能手机惯性的日常活动 | 同为 HAR,模态不同 |
| sisfall | 1075 | 惯性跌倒 | 同为运动监测,任务不同 |
消歧要点:本文的「motion」指关节三维轨迹,不是「影像中的运动伪影」,也不是「视频里的动作类别」。
附录 I:条目自检与版本记录
| 项 | 内容 |
|---|---|
| 初稿日期 | 2026-10-17 |
| 核验来源 | Scientific Data 论文(PMC12062305);DataCat eprint 2729 |
| 网络请求预算 | WebSearch 1 次(三源互证已在单次结果内覆盖论文 PDF、PMC PDF、DataCat、PubMed 四条独立来源) |
| 未使用来源 | ResearchGate(仅作交叉印证,未引用其数字) |
| 互链 rid 核验 | 全部经 SQL 查 status=1 且 del_sign=0 |
| 同批条目 | rehab-wearable-kinematic 仅以 slug 指称,未引用未定数字 |
| 已知缺口 | 受试者画像、收稿日期、同步残差量级、深度单位说明 |
本条目为 AI-Ready Wikipedia 数据集条目,生产于 2026-10-17。事实以 Scientific Data 论文(doi:10.1038/s41597-025-05099-1)与利物浦大学 DataCat 目录(doi:10.17638/datacat.liverpool.ac.uk/2729)两处互证为准,口径差异与文档瑕疵已在附录 C 逐条存照。本条目与同批 rehab-wearable-kinematic(IMU 模态)在 §9.1 做模态边界区分,两者不构成别名或版本关系。库内互链 rid 均取自 status=1 且 del_sign=0 的在架记录。后续维护触发点见 §10.3。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- kinecal — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- accelerometry-walk-climb-drive — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- grabmyo — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- openbiomechanics — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 医学影像
- hospital-activity-bosch — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- bridge2ai-voice — 共享标签:生理信号 / 可穿戴传感 / 图像分类
- scientisst-move — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- sisfall — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- wisdm — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 评测基准
- ppg-dalia — 共享标签:生理信号 / 步态与运动 / 可穿戴传感
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
