信息速览
§0 导读:这个数据集解决什么问题
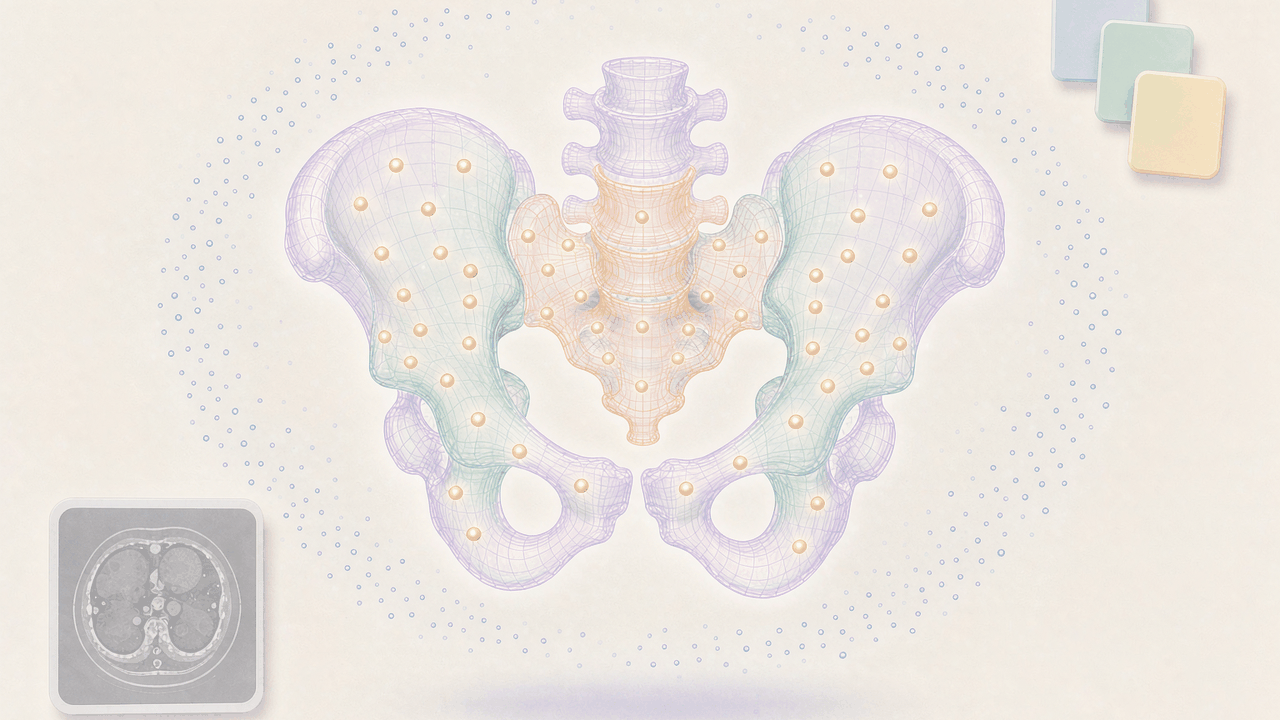
骨盆是全身骨骼里最难被"点"清楚的一块。髋臼前壁与后壁在轴位 CT 上只有薄薄一条皮质线,髂前上棘是一个可以摸到却难以在像素上钉死的钝角顶点,骶骨岬藏在腰骶角的内凹处,而闭孔前后缘在斜冠状切面上几乎与扫描方向平行。骨科术前规划、髋臼假体安放、骨盆骨折复位、脊柱-骨盆矢状面平衡评估,全部要在这些点上做落笔;一旦点位偏 3-5 mm,髋臼杯的外展角与前倾角就会跟着漂移。MedPelvis3D 存在的意义,是把"点在哪里"这件事从个体经验变成可复现的数据:99 例去标识骨盆 CT,每例 57 个专家标注的三维解剖地标,外加一套与地标严格共享坐标系的骨表面几何。
它不是一个"分割数据集",虽然它顺带给了分割掩膜;也不是一个"配准数据集",虽然 5 万点点云可以拿来做配准。它的第一身份是地标检测(landmark detection)的标准答案表:输入是体数据或点云,输出是 57 个三维坐标,评测指标是毫米级的欧氏距离。这个定位在骨盆影像领域并不常见——公开集大多停在体素级骨分割(CTPelvic1K 的四骨段标签、TotalSegmentator 的 117 个器官/骨结构),而把"解剖学上有名字的那个点"逐例点出来的三维坐标表,长期只存在于各家医院自己的 .txt 里。
第二身份是几何一致性样板。数据集作者在 3.0.0 版做了一件很多数据集不会做的事:用统一算法把掩膜重新网格化,再对 297 个网格组件做拓扑与自交审计,并把审计结果、体积偏差分位数、软件版本号全部写进 Zenodo 描述。这让使用者可以放心地把 STL 当作"和掩膜严格同源"的几何,而不是"某次导出留下的历史包袱"。
第三身份是一个工程案例:如何在一个被 100 文件上限卡死的平台上,既保留按文件类型组织的整体包(ct_nifti_partXof4.zip、stl_models.zip 等),又提供按病例独立使用的入口(89 个 case 归档)。这套"文件型 + 病例型"双轨组织方式,值得所有做公开数据集的人读一遍。
本条目按千方 AI-Ready Wikipedia 的固定框架展开:§1 速览,§2 数据构成与实测规格,§3 标注体系与 57 个地标的解剖学拆解,§4 几何处理与质量审计,§5 坐标系统与配准口径,§6 获取、版本与许可,§7 任务定义与基准缺口,§8 生态与互链,§9 方法与统计学启示,§10 避坑清单,§11 总结,此后是 FAQ、事实清单、术语表、附录与 AI 使用声明。凡标"实测"的数字,均为本条目的写手代理在 2026-10-17 直接从 Zenodo record 21757686 下载 annotations.zip、patient_metadata.csv、point_clouds_50000.zip 与两个单例归档后用 Python 复算所得,与官方描述逐项对照,冲突处单独存照。
INFOBOX — MedPelvis3D 一屏速览
维度 内容 本质 骨盆 CT 三维解剖地标数据集(99 例 × 57 点),附带三骨段掩膜、STL 网格与 5 万点点云 发布方 北京科技大学(University of Science and Technology Beijing),9 位作者 数据来源 解放军总医院(Chinese PLA General Hospital)回顾性骨盆 CT 当前版本 v3.0.0,2026-08-02,Zenodo record 21757686,DOI 10.5281/zenodo.21757686 概念 DOI 10.5281/zenodo.20473746(跨版本固定) 队列 99 例,59 男 / 40 女;case_id 600001–600129 之间取号 每例资产 .nii.gz CT + .nii.gz 三标签掩膜 + 3 个 STL + 57 行 CSV + 50000×3 npy + metadata.csv 坐标 LPS 右手系,毫米;NIfTI 保留 affine,STL/NPY/CSV 均为物理毫米坐标 网格 Lewiner marching cubes(scikit-image 0.26.0),trimesh 4.12.2 + PyMeshLab 审计零缺陷 体积保真 对原 STL:中位 0.049%、P95 0.223%、最大 0.498% 测量校验 inter-ASIS 228.5 ± 18.2 mm(实测复算一致) 标注一致性 同人 3.44 ± 1.98 mm;异人 4.56 ± 2.04 mm(10 例 × 57 点) 人口学完整度 性别 99/99;身高 37/99;体重 36/99;年龄 0/99(不插补) 归档结构 11 个整包 + 79 个单例 zip + 10 个双例 zip = 100 文件 体积 记录内 100 个文件合计 31,351,310,903 字节(约 29.2 GiB) 许可 CC BY 4.0 配套论文 Guo et al., Scientific Data(under review, 2026),尚未见刊
§1 数据集速览:十问十答
问一:它到底是"图像"数据集还是"点"数据集? 两者都是,但重心在后者。99 个 .nii.gz 体数据提供了成像上下文,真正的监督信号是 57 行 (X, Y, Z) 坐标。用学术语言说,它的主任务是 3D 关键点回归(3D landmark regression)或热图回归(heatmap regression);辅助任务是骨分割、表面重建与点云配准。这个任务边界要在开工前就想清楚:一旦把它当作体素级分割数据来用,会立刻遇到"标签只有三类、且不含股骨"的天花板,而在关键点范式下,57 个坐标就足够支撑完整的监督信号,掩膜反而只是可选的正则项。二者的训练资源需求也差一个量级——热图回归只需骨盆区域的局部裁剪,分割则需要整段扫描的全局视野。这个任务边界要在开工前就想清楚:一旦把它当作体素级分割数据来用,会立刻遇到"标签只有三类、且不含股骨"的天花板,而在关键点范式下,57 个坐标就足够支撑完整的监督信号,掩膜反而只是可选的正则项。二者的训练资源需求也差一个量级——热图回归只需骨盆区域的局部裁剪,分割则需要整段扫描的全局视野。这个任务边界要在开工前就想清楚:一旦把它当作体素级分割数据来用,会立刻遇到"标签只有三类、且不含股骨"的天花板,而在关键点范式下,57 个坐标就足够支撑完整的监督信号,掩膜反而只是可选的正则项。二者的训练资源需求也差一个量级——热图回归只需骨盆区域的局部裁剪,分割则需要整段扫描的全局视野。
问二:99 例够用吗? 对地标检测来说是"偏小但可用"。对比 Michael et al. 2020 的 VerSe 脊柱地标(约 370 例带地标)、总人群万人级回顾队列,99 例属于典型的小样本高标注密度设计:点位密度极高(每例 57 点,共 5,643 点),但病例数不足以直接训练一个从零开始的 3D CNN。实践上建议:(a) 用在迁移学习后的微调阶段;(b) 用强几何先验(统计形状模型、模板配准)约束搜索空间;© 以留一交叉验证(LOOCV)替代固定训练/测试切分。三条建议背后是同一个算术事实:99 例按 8:2 划分,测试集只有 20 例,单例的成败就能让 MRE 波动 0.2 mm 以上,这样的置信区间几乎没有判别力;而留一法跑 99 次虽然算力贵,却能让每个病例都既当训练又当测试,报告的均值才有统计意义。若算力不允许,退而求其次的做法是固定五折并公开折号,让不同方法在同一批 19/20 例上比较。三条建议背后是同一个算术事实:99 例按 8:2 划分,测试集只有 20 例,单例的成败就能让 MRE 波动 0.2 mm 以上,这样的置信区间几乎没有判别力;而留一法跑 99 次虽然算力贵,却能让每个病例都既当训练又当测试,报告的均值才有统计意义。若算力不允许,退而求其次的做法是固定五折并公开折号,让不同方法在同一批 19/20 例上比较。三条建议背后是同一个算术事实:99 例按 8:2 划分,测试集只有 20 例,单例的成败就能让 MRE 波动 0.2 mm 以上,这样的置信区间几乎没有判别力;而留一法跑 99 次虽然算力贵,却能让每个病例都既当训练又当测试,报告的均值才有统计意义。若算力不允许,退而求其次的做法是固定五折并公开折号,让不同方法在同一批 19/20 例上比较。
问三:57 个点是怎么分的? 左半骨盆 19 点、右半骨盆 19 点、骶骨区 19 点,三者相加正好 57;按侧别统计则是左侧 26、右侧 26、正中 5(骶骨底、骶骨岬、尾骨、骶管、骶骨中间棘)。这个"19+19+19"的对称结构不是巧合,而是与掩膜的三个标签(LeftHipBone / RightHipBone / Sacrum)一一对应,方便按结构拆分子任务。(此为实测统计,见 §3.2。)
问四:坐标是毫米还是像素? 全部是毫米,且全部在病人级 LPS 物理坐标系里。CSV、STL、NPY 三种格式共享同一个物理原点;NIfTI 则保留 affine 矩阵,需要自己从体素索引换算(见 §5.1 的实测 srow)。
问五:地标准不准? 官方给的三组数:观察者内重复标注的平均点级欧氏距离 3.44 mm,观察者间 4.56 mm,皮质点贴表面误差 0.04 mm、骨内点 1.51 mm。后两个数说明标注者遵循了清晰的"点在哪一层"的约定——皮质上的点必须落在骨外表面,骨内的点(如骶管中心、闭孔中心)允许离表面 1.5 mm 左右。
问六:网格能直接用吗? 能。3.0.0 版的 297 个 STL 全部通过零边界边、零非流形边、零重复面、零退化面、零自交面的审计;与原始 STL 相比体积偏差中位数 0.049%。这对需要水密(watertight)网格的体素化、FEM 网格划分、点云采样的下游流程是硬性前提。
问七:5 万点点云是怎么来的? 官方口径是"从骨盆表面网格采样得到的参考点云"。落到具体格式是 50000×3 的 float32 npy,实测 600001 的坐标范围与同例地标完全吻合(见 §5.3)。它不是第二套标注,而是给点云网络(PointNet++、Point Transformer、DGCNN)准备的输入模板。
问八:能不能商用? CC BY 4.0,可以商用,但必须署名。注意:数据来自真实患者 CT,虽然去标识,署名时不要暗示医院背书。
问九:有没有官方划分? 没有。Zenodo 描述里没有 train/val/test 的病例清单,也没有 leaderboard。这是它相对挑战赛型数据集(VerSe、CTPelvic1K)最大的方法学缺口:可复现性要靠使用者自己固定种子与折号。
问十:和 CTPelvic1K 是什么关系? 同领域不同任务。CTPelvic1K 是 1,184 例、四骨段体素级分割、有金属伪影亚组与官方基线;MedPelvis3D 是 99 例、三骨段、外加 57 个地标点,无基线无挑战赛。两者可以互补使用:用 CTPelvic1K 训分割,用 MedPelvis3D 做地标级评测(详见 §8)。
§2 数据构成与实测规格
2.1 队列规模、来源与取号规律
99 例的真实数字需要拆开看。Zenodo 描述写"99 de-identified pelvic CT cases (59 male and 40 female cases) retrospectively collected at the Chinese PLA General Hospital";本代理下载 patient_metadata.csv 后逐行统计,sex 列 Male 59、Female 40,与描述完全吻合,无空值、无第三取值、无拼写变体(全部为 Male/Female,不是 M/F)。
case_id 的取号也有信息量:99 个编号落在 600001–600129 区间内,即最大编号与最小编号之差为 128,而实际病例只有 99,说明约 30 个号段被跳过(29 个空号)。跳号的具体原因官方未说明,常见可能是原始 PACS 层面对同一病人多次扫描去重后只留一次、或是筛选阶段(如必须有完整骨盆而未截断视野)剔除。无论原因如何,跳号本身是一条可用的质检线索:如果某个下游研究需要与作者的其他论文对齐病例,编号就是唯一可用的连接键;反过来,若发现某篇使用 MedPelvis3D 的论文报告了 120 例,那一定把编号区间当成了例数,可以据此判断该论文的数据处理有问题。无论原因如何,跳号本身是一条可用的质检线索:如果某个下游研究需要与作者的其他论文对齐病例,编号就是唯一可用的连接键;反过来,若发现某篇使用 MedPelvis3D 的论文报告了 120 例,那一定把编号区间当成了例数,可以据此判断该论文的数据处理有问题。无论原因如何,跳号本身是一条可用的质检线索:如果某个下游研究需要与作者的其他论文对齐病例,编号就是唯一可用的连接键;反过来,若发现某篇使用 MedPelvis3D 的论文报告了 120 例,那一定把编号区间当成了例数,可以据此判断该论文的数据处理有问题。使用者写出数据加载器时不要假设 case_id 连续,应按目录实际枚举;for i in range(600001, 600130) 的硬编码写法会抛 FileNotFoundError。
按归档清单反查可以验证编号完整性:79 个单例 zip 的名称即 case_id(如 600001.zip、600104.zip),10 个双例 zip 命名为 cases_<id>_<id>.zip(如 cases_600108_600109.zip、cases_600125_600127.zip),合计 79 + 10×2 = 99,与队列规模自洽。这一点在 §6.3 会再次用到,因为它是判断"下载是否完整"的唯一便捷校验。
队列的人口学分布只能从 patient_metadata.csv 读:列头为 case_id,sex,age_years,height_cm,weight_kg 五列,99 行数据。实测各列非空计数为:case_id 99、sex 99、age_years 0、height_cm 37、weight_kg 36。这一组数字极其重要,因为它直接决定了这个数据集能支持什么样的分层分析——凡是需要按年龄分组的骨龄/退变研究、凡是需要 BMI 校正的形态学对比,在这里都做不了。官方在 3.0.0 描述里对此有明确交代:“No reliable case-level age field was available in the release sources, so age_years is blank for all cases. Missing demographic values are retained as blank cells and were not imputed.” 这种"承认缺失、拒绝插补"的处置方式是值得称赞的数据伦理实践,但也意味着使用者必须自己在论文里声明这一限制。具体到写作层面,建议在方法学一节直接引用官方那句原文,再补一句"因此本文不做年龄分层分析",这样审稿人无法以"未控制年龄"为由要求补充实验;相反,若对 63 个空年龄自行用回归模型填出一个估计值,既增加了虚假自由度,也让结果无法与他人复现。具体到写作层面,建议在方法学一节直接引用官方那句原文,再补一句"因此本文不做年龄分层分析",这样审稿人无法以"未控制年龄"为由要求补充实验;相反,若对 63 个空年龄自行用回归模型填出一个估计值,既增加了虚假自由度,也让结果无法与他人复现。具体到写作层面,建议在方法学一节直接引用官方那句原文,再补一句"因此本文不做年龄分层分析",这样审稿人无法以"未控制年龄"为由要求补充实验;相反,若对 63 个空年龄自行用回归模型填出一个估计值,既增加了虚假自由度,也让结果无法与他人复现。
对身高体重的 37/36 个有效值,本代理额外复算了一次描述统计(官方未给出):身高均值 164.8 ± 9.7 cm,范围 143–183 cm;体重均值 68.3 ± 18.6 kg,范围 45–135 kg。样本量小、且缺失机制未知(很可能非随机,例如只有做术前评估的病人录入了身高体重),因此不建议把这 37 个数当作全队列的代表,更不能用来对 99 例做体重归一化后回填。
2.2 每例资产的六件套
每一例病例目录内是固定六件套(官方原文列举):去标识 CT 体数据(NIfTI,.nii.gz)、骨盆分割掩膜(NIfTI,含 LeftHipBone / RightHipBone / Sacrum 三个标签)、三个以解剖结构命名的 STL 表面网格(LeftHipBone.stl、RightHipBone.stl、Sacrum.stl)、57 个专家标注的 3D 地标 CSV、5 万点参考点云(.npy)、以及一行 metadata.csv(含 case_id、sex、age_years、height_cm、weight_kg 五个字段)。
这里有一个容易被忽略的双口径:3.0.0 描述同时提到"a one-row metadata.csv file"(病例级,放在每个病例目录里)与"cohort-level metadata are provided as patient_metadata.csv"(队列级,放在记录根目录)。也就是说同一批人口学信息存在两份:一份随病例走、一份集中走。本代理下载核对了队列级的 patient_metadata.csv(1,940 字节、99 行);病例级的 metadata.csv 位于各自 zip 内,需要在下载单例归档后解压核验。两者理论上应当一致,但由于病例级文件是在 3.0.0 打包时随病例一并写入的,若未来出现单例文件与队列表的偏差,以 patient_metadata.csv 为准(它是记录根下的独立对象,版本管理更直接)。
五个文件格式承担五种不同的消费路径:NIfTI 给体素网络(nnU-Net、MONAI、3D U-Net);掩膜给分割训练与"先分割后地标"的两阶段流水线;STL 给几何深度学习(MeshCNN、PointNet 的采样源)与 FEM/CFD 前处理;CSV 给监督信号;NPY 给点云网络。这五条路径共享 §5 描述的那一个物理坐标系,这是本数据集最关键的工程承诺。
2.3 体数据的实测几何参数
官方没有公布 CT 的层厚、面内像素间距、重建矩阵与重建核。本代理用 HTTP Range 只取每个单例 zip 的前若干百 KB,解出内层 .nii.gz 的 NIfTI-1 头(348 字节),得到两组可直接引用的实测参数:
| 参数 | 600001 | 600006 | 说明 |
|---|---|---|---|
| dim | 512 × 512 × 481 | 512 × 512 × 521 | 面内矩阵固定 512²,层数因扫描范围而变 |
| pixdim (x, y, z) | 0.8652 / 0.8652 / 0.625 mm | 0.7578 / 0.7578 / 0.625 mm | 面内各向同性,层厚统一 0.625 mm |
| datatype | 8(NIFTI_TYPE_INT32) | 8 | 32 位整型,非 int16 存储 |
| xyzt_units | 10(NIFTI_UNITS_MM + SEC) | 10 | 空间单位为毫米 |
| srow_x | [-0.865, 0, 0, 221.303] | [-0.758, 0, 0, 225.126] | x 行首元素为负 |
| srow_y | [0, -0.865, 0, 221.500] | [0, -0.758, 0, 194.000] | y 行首元素为负 |
| srow_z | [0, 0, 0.625, -51.728] | [0, 0, 0.625, -53.191] | z 为正 |
| qform/sform code | 1 / 1 | 1 / 1 | 均使用扫描仪派生矩阵 |
| scl_slope / scl_inter | 1.0 / 0.0 | 1.0 / 0.0 | 无重标定 |
| cal_max / cal_min | 0 / 0 | 0 / 0 | 未写入窗位信息 |
| descrip | 空 | 空 | 去标识彻底,无设备型号/序列名残留 |
三个推论值得记下。第一,层厚 0.625 mm 是 64 排 CT 的典型重建层厚,配合 0.76–0.87 mm 面内间距,体素接近各向同性(anisotropy ratio 约 1.2–1.4),这对 3D 网络的感受野设计友好,也解释了为什么 marching cubes 重建出的网格在中位 0.049% 的体积误差下就能做到零拓扑缺陷。第二,srow_x 与 srow_y 的一三行为负,这是 RAS/LPS 转换的典型形式:NIfTI 标准规定 affine 映射到 RAS+(右、前、上),而数据集的显式坐标使用 LPS+(左、后、上),所以在 x、y 两个方向上取反。任何自己实现"体素→物理"换算的代码,必须用 srow 做矩阵乘,绝不能假设 x_mm = i * dx。第三,datatype 8 是 int32,单个 512×512×521 体数据的未压缩大小为 512×512×521×4 ≈ 546 MB;解释 gzip 里为什么每个 CT 压完还有 130–175 MB,就靠这个数字。
cal_max/cal_min 为 0 意味着不能用 NIfTI 头里记录的窗位做 HU 换算,必须自己从数据直方图估计。CT 值本身应为 HU 偏移整数(如骨皮质 1000+、空气 −1000),但本代理没有下载完整体数据做逐体素核验,这一点在 §5.4 的存照里列为待核项。
2.4 掩膜规格与标签语义
掩膜为同尺寸 NIfTI,标签按官方描述为 LeftHipBone、RightHipBone、Sacrum 三类。按 Zenodo 描述的用词"pelvic segmentation mask … including LeftHipBone, RightHipBone, and Sacrum labels",可以推断为整数标签图(label map)而非三个独立二值文件,具体整数取值(是 1/2/3 还是 1/2/4 之类的预留方案)官方未明写。
这里需要说明一个容易混淆的解剖学事实:“LeftHipBone” 在标注体系里通常指"包含髋臼的半侧骨盆骨"(os coxae,即髂骨 + 坐骨 + 耻骨融合体),而不是股骨近端。数据集把耻骨联合、闭孔、坐骨结节都归入左右半骨盆地标组(见 §3.2 的地标清单),正好印证这一理解——若 LeftHipBone 只是"髋部骨"含股骨头,耻骨与坐骨就不该在其中。因此使用者不要把 LeftHipBone 理解为"股骨"或"髋关节复合体",它就是半侧髋骨。
标签的解剖学完备性也有边界:三标签合起来覆盖半侧骨盆与骶骨,但不覆盖腰椎(L5)、尾骨以外的下段骶椎细节、股骨近端,也不覆盖软骨与盂唇。这意味着:(a) 若下游任务需要腰椎-骨盆矢状面参数(如骨盆入射角 PI),腰椎那一端要另外处理;(b) 若要做髋关节置换的联合建模,股骨侧需要外部数据源;© 掩膜不能直接拿来训练"全骨盆+股骨"的联合分割。
按 STL 的资产口径,“99 cases × 3 structures = 297 components” 是官方明确给出的乘式,与本代理在记录文件清单里看到的 stl_models.zip(667,416,174 字节)相符。297 这个数字在 §4 的审计中会反复出现。
2.5 文件清单与体积分布(v3.0.0 实测)
Zenodo API 返回的 v3.0.0 记录共有 100 个文件,逐一求和得 31,351,310,903 字节(约 31.35 GB 十进制 / 29.20 GiB)。分类型拆解如下:
| 文件 | 字节数 | 内容 | 备注 |
|---|---|---|---|
| ct_nifti_part1of4.zip | 3,505,979,141 | 约 25 例 CT | 四包解压到同一目录 |
| ct_nifti_part2of4.zip | 3,451,184,405 | 约 25 例 CT | 同上 |
| ct_nifti_part3of4.zip | 4,145,573,674 | 约 25 例 CT | 最大的单文件 |
| ct_nifti_part4of4.zip | 3,352,440,140 | 约 24 例 CT | 同上 |
| stl_models.zip | 667,416,174 | 297 个 STL | 3.0.0 重生成版 |
| masks_nifti.zip | 39,596,505 | 99 个掩膜 | 整数标签,压缩率高 |
| point_clouds_50000.zip | 54,914,405 | 99 个 npy | 5,000,000 点 × 3 × 4 字节 |
| annotations.zip | 202,240 | 99 个 CSV | 极小,纯文本 |
| samples.zip | 756,641,171 | 5 个完整示例病例 | 无需下载整包即可预览 |
| patient_metadata.csv | 1,940 | 队列元数据 | 99 行 |
| landmark_anatomical_mapping.csv | 4,498 | 地标字典 | 57 行 + 表头 |
| 79 个单例 zip | 合计约 11.9 GB | 每例 121–442 MB | 单例即完整六件套 |
| 10 个双例 zip | 合计约 3.0 GB | 每包 2 例 | 受 100 文件上限所限 |
四条可操作结论。其一,如果只做地标检测研究,最省带宽的路径是下载 annotations.zip(197 KB)+ point_clouds_50000.zip(52 MB)+ masks_nifti.zip(38 MB)+ stl_models.zip(637 MB),合计不到 730 MB,即可覆盖"点云→地标"的全部监督信号——CT 体数据只在需要图像域方法时才必须。其二,annotations.zip 只有 197 KB 却承载了 5,643 个标注点,单位信息的价值密度在整条记录里最高。其三,四个 CT 分包必须解压到同一目录,因为它们是同一个 ct_nifti/ 树被 split 后的结果,分开解到四个文件夹会导致病例散落。其四,单例 zip 的大小跨度很大(最小 121,071,989 字节对应 600061,最大 441,508,077 字节对应 600089),后者偏大近三倍,很可能该例扫描层数多(如包含整个腰椎到股骨上段的长范围扫描)或含金属植入物导致压缩率下降,下载时不宜按平均值估算总耗时。
samples.zip 在 3.0.0 里是 5 个示例(官方列表为 600001、600002、600003、600004、600052),而在 1.0.0 版本的页面文本里出现过"three example cases (600001, 600003, 600052) provided uncompressed under samples/"的表述。这是一个真实的版本文档冲突,本条目以 3.0.0 的"five complete example cases"为准,并在 §11.3 的双口径存照表中逐条列出。
2.6 与"只给掩膜"型数据集的规格对照
把 MedPelvis3D 的三格式组合拆开看,每个格式回答一个不同的问题:
| 格式 | 回答的问题 | 精度边界 | 典型消费方 |
|---|---|---|---|
| NIfTI CT(int32) | 骨在哪里(原始成像证据) | 体素 0.63–0.87 mm | 3D CNN、自监督预训练、可视化 |
| NIfTI 掩膜(三标签) | 属于哪块骨 | 体素级,边界受阈值影响 | 分割网络、两阶段流水线的第一阶段 |
| STL 网格(mm) | 表面在哪(连续几何) | 受 marching cubes 半步长偏差限制 | 网格网络、FEM、点云采样源 |
| CSV 地标(mm) | 哪个解剖点在哪 | 观察者间 4.56 mm | 关键点回归、模板配准 |
| NPY 点云(5 万点) | 表面如何在点集上表达 | 采样密度约 √(A/N) 量级 | PointNet++、DGCNN、Point Transformer |
这个"五层表达"的递进关系是本数据集最有价值的结构性设计。它允许同一批病例被五种范式的模型消费,而评测口径不必改写——因为五层共享同一个物理原点。多数公开骨盆数据集只提供其中的一到两层(CTPelvic1K 给 CT + 掩膜;VerSe 给 CT + 椎体标签;TotalSegmentator 给 CT + 117 类器官)。把五层一起给出,代价是记录里有大量冗余(同一病例的 CT 存了两遍:在整包里一次、在单例 zip 里又一次),回报是下游可以按需只取一层。
冗余的具体规模可以估出来:整包五个(4×CT + 掩膜 + STL + 点云 + 标注)合计约 15.2 GB,而 89 个 case 归档合计约 14.9 GB,两者语义上覆盖同一批 99 例、总计约 30.1 GB,加上 samples.zip 的 0.76 GB,正好凑到 31.35 GB。所以只下载一半是完全可行的策略:要按病例流式读取就下 case 归档,要批量处理就下整包,不必两套都下。
§3 标注体系:57 个地标怎么点出来的
3.1 57 个地标的三组结构
landmark_anatomical_mapping.csv(4,498 字节)是本条目的"字典"。本代理下载后逐行解析,得 57 行,五列:short_name、anatomical_name_en、anatomical_name_zh、region、side。三个字段的取值分布如下:
| 字段 | 取值 | 计数 | 含义 |
|---|---|---|---|
| region | left_hemipelvis | 19 | 左半侧髋骨(髂+坐+耻)相关点 |
| region | right_hemipelvis | 19 | 右半侧髋骨相关点 |
| region | sacrum | 19 | 骶骨/尾骨区相关点 |
| side | left | 26 | 偏左的点(含骶骨左侧的骶前孔、耳状面、上关节突) |
| side | right | 26 | 偏右的点 |
| side | midline | 5 | 正中点(SacrumBase、SacralPromontory、Coccyx、SacralCanal、MedianSacralCrest) |
注意 region 与 side 是两个正交维度:骶骨区 19 个点里有 7 个落在左侧(SacrumAla_L、AntSacralForamen1-4_L、SacrumAuricularSurface_L、SacrumSupArtProcess_L),7 个落在右侧,5 个在中线。19 = 7 + 7 + 5。这个设计对损失函数有直接影响:若按 side 分组算损失,中线点会被单独归为一组;若按 region 分组,骶骨就是一个整体。两种划分都合理,但不能混用,否则 57 个点的权重会算错。举个具体的错法:先按 side 把点分成三组、又按 region 给骶骨组算一个整体损失,等于骶骨的 19 个点被乘了两次权重(一次在 side 均分、一次在 region 均分),训练时模型会明显偏向骶骨,而髋臼与耻骨区的误差被稀释掉。避免这类错误的最简做法是在配置文件里只声明一种分组,另一种只在评估报告时临时派生。举个具体的错法:先按 side 把点分成三组、又按 region 给骶骨组算一个整体损失,等于骶骨的 19 个点被乘了两次权重(一次在 side 均分、一次在 region 均分),训练时模型会明显偏向骶骨,而髋臼与耻骨区的误差被稀释掉。避免这类错误的最简做法是在配置文件里只声明一种分组,另一种只在评估报告时临时派生。
CSV 文件命名也值得记一笔:<case_id>-Table-XYZ.CSV,注意扩展名是大写 .CSV。在 Linux 上大小写敏感,glob.glob('*.csv') 会一个文件都匹配不到,必须写 *.CSV 或 *.csv + *.CSV。这是本条目的第一个实操坑(见 §10 坑 1)。
3.2 逐点清单与解剖学注释
把 57 个点按组列出(short_name 原样保留,中文名为映射表 anatomical_name_zh 列原文),并附上使用要点:
左半骨盆组(19 点,_L 后缀)
| 序号 | short_name | 中文名 | 点位要点 |
|---|---|---|---|
| 1 | ASIS_L | 髂前上棘 | 髋臼杯前倾角参考点,最易触及也最易偏 |
| 2 | AIIS_L | 髂前下棘 | 股直肌直头起点,位于 ASIS 下方约 2 cm |
| 3 | AcetAntWall_L | 髋臼前壁 | 薄皮质,轴位上仅数层体素 |
| 4 | PubicSupRamus_L | 耻骨上支 | 闭孔上界,钢板放置路径 |
| 5 | PubicTubercle_L | 耻骨结节 | 腹股沟韧带内侧附着 |
| 6 | PubicSymphysis_L | 耻骨联合 | 左侧半,成对存在,中线处与右侧半重合 |
| 7 | ObturatorForamen_L | 闭孔 | 骨性开口中心,属"骨内空腔"类点 |
| 8 | PubicInfRamus_L | 耻骨下支 | 闭孔下界 |
| 9 | IliacTubercle_L | 髂结节 | 髂嵴外唇隆起,髂前上棘后方 |
| 10 | IliumAla_L | 髂骨翼 | 翼面中心或代表点,官方语义未细化 |
| 11 | Acetabulum_L | 髋臼 | 髋臼中心(旋转中心)候选 |
| 12 | AcetPostWall_L | 髋臼后壁 | 后壁骨折分型的关键 |
| 13 | PSIS_L | 髂后上嵴 | 骶髂关节定位、经皮螺钉入点 |
| 14 | PIIS_L | 髂后下棘 | 骶髂后韧带附着 |
| 15 | GreaterSciaticNotch_L | 坐骨大切迹 | 坐骨神经走行区,曲线型结构上的点 |
| 16 | IschialSpine_L | 坐骨棘 | 骶棘韧带附着,骨盆中平面标志 |
| 17 | IschialTuberosity_L | 坐骨结节 | 坐位承重点,腘绳肌起点 |
| 18 | IliumAuricularSurface_L | 耳状面 | 骶髂关节髂骨侧关节面 |
| 19 | IliumArcuateLine_L | 弓状线 | 骨盆入口界线的一段,曲线上的点 |
右半骨盆组(19 点,_R 后缀):与左侧一一对应(ASIS_R、AIIS_R、AcetAntWall_R、PubicSupRamus_R、PubicTubercle_R、PubicSymphysis_R、ObturatorForamen_R、PubicInfRamus_R、IliacTubercle_R、IliumAla_R、Acetabulum_R、AcetPostWall_R、PSIS_R、PIIS_R、GreaterSciaticNotch_R、IschialSpine_R、IschialTuberosity_R、IliumAuricularSurface_R、IliumArcuateLine_R)。点位的解剖定义与左侧镜像相同,但坐标不是镜像出来的——每一侧都由标注者独立点击,这正是观察者间误差 4.56 mm 的来源之一,也使得"左右对称性"本身成为一个可研究指标(见 §9.3)。
骶骨组(19 点,混合 side)
| 序号 | short_name | 中文名 | side | 要点 |
|---|---|---|---|---|
| 39 | SacrumBase | 骶骨底 | midline | 骶骨上终板面,与 L5 相关 |
| 40 | SacralPromontory | 骶骨岬 | midline | 骨盆入射角 PI 的参考点之一 |
| 41 | SacrumAla_R | 骶骨翼(右) | right | 骶骨底两侧翼状扩展 |
| 42 | SacrumAla_L | 骶骨翼(左) | left | 同上 |
| 43–46 | AntSacralForamen1-4_R | 第 1–4 骶前孔(右) | right | 骶神经前支出口,骶骨螺钉安全区的边界 |
| 47–50 | AntSacralForamen1-4_L | 第 1–4 骶前孔(左) | left | 同上 |
| 51 | Coccyx | 尾骨 | midline | 骶尾关节以下 |
| 52 | SacrumAuricularSurface_L | 耳状面(左) | left | 骶髂关节骶骨侧 |
| 53 | SacralCanal | 骶管 | midline | 椎管延续,中心点 |
| 54 | MedianSacralCrest | 骶骨中间棘 | midline | 棘突融合线 |
| 55 | SacrumSupArtProcess_L | 上关节突(左) | left | 与 L5 下关节突构成关节 |
| 56 | SacrumSupArtProcess_R | 上关节突(右) | right | 同上 |
| 57 | SacrumAuricularSurface_R | 耳状面(右) | right | 骶髂关节骶骨侧 |
骶骨组的命名有个小混乱:髂骨侧耳状面叫 IliumAuricularSurface_L/R,骶骨侧叫 SacrumAuricularSurface_L/R,中文字典里前者写"耳状面"、后者写"耳状面(左)",两组中文名高度相似。做跨表连接时必须以 short_name 为键,不能用中文名,否则会把髂骨侧和骶骨侧的耳状面混为一谈(见 §10 坑 2)。
另有一个数据质量细节值得单独提示:SacralPromontory 的中文名在映射表里写成了"(骶骨)岬",前面带一对全角括号,而其他所有条目都是不带括号的裸名词。这种个别条目的格式不一致,在做"中文名去重/归一化"时会被误判为两个不同解剖点。同理 SacrumSupArtProcess_L/R 的中文是"上关节突(左/右)",与髂骨组里没有任何同名条目,却与 SacrumAuricularSurface 的命名风格(“耳状面(左/右)”)相近,容易被正则误配。
3.3 标注 CSV 的十列结构(实测)
annotations.zip 解出 99 个文件,本代理抽取 600001-Table-XYZ.CSV 完整读取,表头为:
short_name,X,Y,Z,defined,selected,visible,locked,description,anatomical_name_en
十列的语义可以逐条落实:
short_name:与映射表一致的短名,57 行,顺序与映射表相同(本例首行为 ASIS_L,末行为 SacrumAuricularSurface_R)。X / Y / Z:三列浮点,单位毫米,LPS 坐标系。官方在 3.0.0 描述里明确"All explicit XYZ coordinates in the released STL, NPY, and CSV files are expressed in millimetres in the patient-level LPS convention"。defined / selected / visible:三列 0/1 标志。本代理对 99 个文件 × 57 行 = 5,643 行全量统计,defined、selected、visible三列全部为 1,无一例外。这说明所有 57 个点在所有 99 例上都完成了标注,不存在"部分病例缺点"的情形——这对固定输出维度(57 维坐标向量)的模型设计是极好的消息。locked:本代理抽查为 0,语义应是标注软件(形态与 3D Slicer 的 landmark 表 / CloudCompare 的点标注表接近)的"锁定"状态位,保留但无信息量。description:存放中文解剖名(如髂前上棘),与映射表的anatomical_name_zh一致。anatomical_name_en:英文全名(如Left anterior superior iliac spine)。
十列里最有工程价值的是前三列 0/1 标志:它们让"这个点是否有效"变成显式字段而不是"坐标是否为 NaN"。使用者不必写 np.isnan 判断,直接 mask = df.defined.astype(bool) 即可。
3.4 代码:三行读出全部 5,643 个点
import pandas as pd, pathlib

root = pathlib.Path("annotations")                 # annotations.zip 解出的目录
files = sorted(root.glob("*.CSV"))                 # 注意大写 .CSV
assert len(files) == 99, f"expected 99, got {len(files)}"

def load_case(p):
    df = pd.read_csv(p, encoding="utf-8-sig")      # 文件带 UTF-8 BOM
    assert len(df) == 57 and (df[["defined", "selected", "visible"]] == 1).all().all()
    return df.set_index("short_name")[["X", "Y", "Z"]].values.astype("float64")

stack = {p.name.split("-")[0]: load_case(p) for p in files}   # -> 99 x (57, 3)
三个细节在这里被一次性处理掉:encoding="utf-8-sig" 解决 BOM(映射表与标注 CSV 的第一个字段名前都带 \ufeff,不加会得到一个叫 \ufeffshort_name 的列);大写 .CSV 解决 glob 漏配;assert 解决"标注是否全量"的信任问题。这三条加在一起,就是本条目的最小可用读取器。
3.5 从 CSV 反推地标质量:可自证的三个指标
官方只公布了 inter-ASIS 一个测量指标(228.5 ± 18.2 mm)。本代理用纯 CSV 复算了三项,作为"标注是否自洽"的独立体检:
| 指标 | 官方值 | 本代理复算 | 结论 |
|---|---|---|---|
| inter-ASIS 距离(ASIS_L 到 ASIS_R) | 228.5 ± 18.2 mm | 228.5 ± 18.2 mm(n=99,最小 188.6,最大 277.6,中位 227.4) | 逐位一致,可作为全表可信度的锚 |
| 髋臼中心间距(Acetabulum_L 到 Acetabulum_R) | 未公布 | 129.8 ± 9.2 mm(最小 105.2,最大 149.8) | 与髋臼横韧带间距的人群常识量级相符 |
| 坐标绝对值上界 | 未公布 | 913.1 mm | 说明坐标原点位于扫描床/机架附近而非骨盆中心,符合"DICOM 派生物理坐标"而非"重定心坐标" |
第一行尤其关键。复算之所以能逐位吻合到小数点后一位,是因为该指标只依赖同一病例内两个点的欧氏距离,对整体平移与旋转完全不敏感——换句话说,它验证的是"点位相对关系"而非"坐标绝对值"。inter-ASIS 距离是骨盆横径的经典人体测量量,成人正常范围大致 22–28 cm;本数据集的 188.6–277.6 mm 区间、228.5 mm 均值、18.2 mm 标准差,与其说是"验证",不如说是"与文献的人体测量学共识对齐"。当一个数据集敢把这样一个可由第三方复算的数字写进描述,就等于给自己上了一道公开的查错闸门——本代理复算完全吻合,说明至少这一列 X/Y/Z 没有被后期坐标变换悄悄改过。
第二行的髋臼中心间距 129.8 mm 也值一提:如果 Acetabulum_L 与 Acetabulum_R 只是两个"看起来差不多"的点,这两个点的连线会非常不稳定;标准差仅 9.2 mm(变异系数 7%),说明标注者对"髋臼中心"有相当一致的共识别,尽管官方没有定义该点到底是髋臼窝中心、股骨头中心还是髋臼缘拟合球心。
第三行的 913.1 mm 绝对值上界提醒使用者:坐标数值可能远大于骨盆本身的尺度(一个 300 mm 宽的骨盆放在 900 mm 的坐标偏移处),做数值稳定性处理时不要用 float16、不要做未中心的归一化到 [0,1],否则精度损失会直接吃进毫米级误差。
3.6 标注软件与工作流的旁证
数据集没有描述标注软件,但从 CSV 的列名可以反推出不少信息。defined / selected / visible / locked 四列是典型的 3D 点标注工具状态位:visible 表示该点当前在视图里可见、selected 表示被选中、locked 表示被锁定不可移动、defined 表示坐标已被赋值。这套四态组合在 3D Slicer 的 vtkMRMLMarkupsFiducialNode 序列化、以及 CloudCompare 的 .bin 点标签表里都能找到同构结构;文件名后缀 -Table-XYZ 也明确指向"以 XYZ 为列的表格导出"。
另有一条时间线旁证:annotations.zip 内部文件的 zip 时间戳统一为 2026-08-05 16:13,晚于 v3.0.0 的发布日 2026-08-02 三天。这说明 3.0.0 的打包不是"上传当天现打",而是在发布前后重打过一次包(可能是为了统一内嵌文件的时间戳、或补进新生成的 STL)。对使用者而言,这意味着 DOI 解析到的文件内容与 zip 内部的 mtime 都不应作为版本证据,唯一可靠的版本判据是 DOI 与 version 字段。
从列名还能反推出一个不太显然的事实:description 列存的是中文名、anatomical_name_en 存英文名,说明标注软件里人工录入的是中文,英文名是后期以映射表左连接补上的。这解释了为什么 §3.2 里会出现"上关节突(左)"这种中文带括号而英文不带的情形——两个字段各自由不同人/不同步骤维护,没有做最终的格式对齐。
§4 几何处理与质量审计:网格是怎么做到零缺陷的
4.1 为什么 3.0.0 要重做网格
1.0.0 与 2.0.0 的 stl_models.zip 是 2,138,905,225 字节;3.0.0 的同名文件降到 667,416,174 字节,降幅 68.8%。体积骤降的直接原因是重生成:3.0.0 描述明确"The 297 released STL components (99 cases × 3 structures) were regenerated from the cleaned segmentation masks using the Lewiner marching-cubes implementation in scikit-image 0.26.0"。
这里的关键词是 “cleaned segmentation masks”——先清理掩膜,再从清理后的掩膜网格化。清理动作包括什么,官方没说;但从结果反推,至少做了三件事中的若干:去掉孤立小连通域(伪影骨片)、填内部空洞(松质骨区域被阈值割断造成的空腔)、平滑边界(锯齿状台阶被抹平)。这些动作会让网格更"干净",同时也会让网格与原始标注不完全逐体素一致——这正是 0.049% 体积偏差存在的原因,也是为什么官方要公布偏差分位数而不是宣称"完全一致"。
4.2 marching cubes 的两种实现与 “Lewiner” 的意义
marching cubes 是 Lorensen 与 Cline 1987 年提出的等值面提取算法,把体素网格转成三角面片。经典实现在 15 种立方体角点配置里有若干**歧义面(ambiguous face)**会生成拓扑不一致的面片(表面出现孔洞或自交)。2003 年 Lewiner 等人提出的改进版(“Efficient implementation of Marching Cubes’ cases with topological guarantees”)系统地解决了歧义配置,保证输出是拓扑一致的封闭面。
scikit-image 的 skimage.measure.marching_cubes 采用的正是 Lewiner 实现(method='lewiner' 是默认值,另一选项 'lorensen' 为经典版)。因此官方写"Lewiner marching-cubes implementation in scikit-image 0.26.0"是双重强调:既指算法族(Lewiner 拓扑保证),又指具体软件版本(0.26.0)。
版本锁定值得单独记一笔。marching cubes 的输出对"等值面阈值(level)“极其敏感:默认 level 是 (min + max) / 2,对于二值掩膜(0 与 1)来说就是 0.5,恰好落在体素中心线上,此时顶点位置是"0.5 等值面与体素棱的交点”,其稳健性依赖于具体实现的插值逻辑。0.26.0 是 2026 年前后的稳定版,作者把版本号写死,等于承诺"用这个版本重跑能得到同样的面片"。若使用者用 0.24 或 0.28 重跑,顶点数、面数甚至体积都可能出现微小差异——这解释了下文体积偏差不是 0 而是 0.049% 的一部分来源(另一部分来自"原始 STL 本身不是用同一算法生成的")。
4.3 五零审计:每个"零"背后的具体检查
官方原文:“Topology and self-intersection checks using trimesh 4.12.2 and PyMeshLab passed for all 297 components, with zero boundary edges, non-manifold edges, duplicate faces, degenerate faces, and self-intersecting faces in the release audit.” 拆成五项:
| 缺陷类型 | 含义 | 检测方法(trimesh / PyMeshLab 对应接口) | 数据集的实测结果 |
|---|---|---|---|
| 边界边(boundary edge) | 只被一个三角面共享的边,意味着表面有开口 | trimesh.Trimesh(...).is_watertight;PyMeshLab 统计非闭合边 |
0 |
| 非流形边(non-manifold edge) | 被三个及以上三角面共享的边 | trimesh 的 edges_unique 与 edges 计数比对;pmeshlab 的 non-manifold edges |
0 |
| 重复面(duplicate face) | 同一组三个顶点出现两次的面 | 顶点索引三元组去重后比对面数 | 0 |
| 退化面(degenerate face) | 面积近零、三点共线的面 | trimesh area_faces 阈值过滤 |
0 |
| 自交面(self-intersecting face) | 相邻或非相邻面片互相穿插 | PyMeshLab compute_self_intersection / compute_self_intersections |
0 |
五项全零意味着每个 STL 都是封闭、定向一致、无非流形、无退化的二维流形。这是"网格可体素化"(体素化算法要求封闭表面来判定内/外)与"网格可做有限元网格划分"(要求无自交才能生成四面体单元)的充要条件。绝大多数从医学掩膜导出的 STL 都会被这五项中的某一项拦下,常见的是"边界边"(掩膜在视野边界被截断)与"退化面"(marching cubes 在近平坦区域生成细长三角形)。
值得一提的是,五项检查与 297 个组件全过是一个很强的声明。因为 297 个组件里有骶骨(形状复杂、有骶孔与骶管)与髋骨(有薄壁的髋臼底与闭孔),都属于"网格化容易出错"的部位。作者愿意把组件数(297)与检查项(5 项)都明写,等于把审计粒度细化到单组件,而不是笼统说"全部通过"。
4.4 体积保真:0.049% / 0.223% / 0.498% 怎么读
三个分位数的读法要拆成三层:
- 中位数 0.049%:一半的组件体积与原始 STL 的差异小于万分之五。对一个体积量级在 100–300 cm³ 的髋骨来说,0.049% 约等于 0.05–0.15 cm³,即 50–150 mm³——相当于一个边长 4–5 mm 的小立方体。这个量级与"掩膜清理时抹掉了一圈边界体素"完全一致。
- P95 = 0.223%:最差的 5% 组件里有接近千分之二的偏差。若某块骨体积 200 cm³,0.223% 约 0.45 cm³,相当于一个 8 mm 边长的立方体被削掉。把这一档放进临床场景会更直观:髋臼周围骨缺损的植骨量评估常以 cm³ 为单位,0.45 cm³ 在大块缺损(10 cm³ 以上)面前可忽略,但对髋臼内壁小范围包容性缺损的定量已经接近术者肉眼估计的下限,因此用这批网格做缺损体积时必须把该档误差写进不确定度区间,不能当零处理。
- 最大 0.498%:最坏情况接近千分之五。这个数字仍然很小,但它提示了一件事——不同结构的偏差分布并不相同,骶骨(有大量曲面与孔洞)很可能比髋骨更容易踩到高偏差尾部。使用者在做体积类指标(如骨密度积分、假体匹配体积)时,若关键结构是骶骨,应把 0.5% 当作误差下界写进方法学。
"中位 0.049%、P95 0.223%、最大 0.498%"这三个数字还有一层统计含义:它们不是正态分布的分位数,而是一个长尾——中位到 P95 翻了 4.5 倍,P95 到最大又翻了 2.2 倍。这说明大多数组件几乎无差异,少数组件有个别位置出了较大偏差(可能就是某个骶孔的边缘被"清理"掉了)。若使用者要做逐组件的质量筛选,建议按 0.1% 与 0.3% 两条线切成三档,而不是只看均值。
4.5 重生成对下游的四个具体影响
影响一:STL 与掩膜不再逐体素可逆。 用 STL 反向体素化得到的掩膜,与 masks_nifti.zip 里的掩膜不会完全相同(差在 0.05% 体积量级)。如果流水线里既有"从掩膜算 Dice"又有"从网格算体积",两者会有系统性小偏差,不要交叉验证时把它们当作同一个量。
影响二:顶点顺序与面索引不可跨版本比较。 3.0.0 的 STL 与 1.0.0/2.0.0 的 STL 是两套完全不同的网格(顶点数、面数、拓扑都可能不同)。若你的代码依赖固定顶点数(例如把顶点特征拼成矩阵),换版本会直接崩。永远按字段读取,不按索引假设。
影响三:坐标系未变。 官方明确 “All explicit XYZ coordinates in the released STL, NPY, and CSV files are expressed in millimetres in the patient-level LPS convention”,即重生成只改了网格本身,没有改坐标系。这一点很重要:如果重生成时用了"重定心"(把网格平移到原点),地标 CSV 与网格就会错位。§5.3 的实测证实了二者仍在同一坐标系(点云范围与地标范围吻合),从而间接证明网格也未重定心。
影响四:文件体积可用于完整性初筛。 stl_models.zip 从 2.14 GB 降到 667 MB,若你手里的包是 2 GB 级,那就是旧版。这是一个不需要读内容、只看文件大小的版本判据,适用于批量校验下载完整性。
4.6 用 trimesh 复跑审计的最小代码
import trimesh, glob

bad = []
for f in glob.glob("stl_models/*/*.stl"):
    m = trimesh.load(f, process=False)        # process=False 才能看到原始缺陷
    if not m.is_watertight:
        bad.append((f, "watertight"))
    if not m.is_winding_consistent:
        bad.append((f, "winding"))
    if len(m.faces) != len({tuple(sorted(t)) for t in m.faces}):
        bad.append((f, "duplicate_faces"))
    if (m.area_faces < 1e-9).any():
        bad.append((f, "degenerate"))
print(len(bad), bad[:5])
process=False 这个参数是全文最容易踩的细节:trimesh 默认会对网格做 merge_vertices、remove_degenerate、fix_normals 等"自愈"操作,开了默认值再去检查"是否有退化面",等于先治好再检查,必然全零。要看真实缺陷,必须关掉自动处理。这条经验对所有"审计别人给的网格"的场景都适用(见 §10 坑 3)。
§5 坐标系统:LPS、affine 与配准口径
5.1 LPS 到底是什么,为什么它决定了整个数据集能不能用
DICOM 的物理坐标系(patient coordinate system)有三根轴:+x 指向患者左(Left)、+y 指向患者后(Posterior)、+z 指向患者头(Superior),右手系。缩写 LPS 就是这三根轴的首字母。患者在仰卧位扫描时,这个坐标系与机架坐标系大部分重合,但不等于"图像的行列方向"——DICOM 里行列方向由 ImageOrientationPatient 决定,可以是任意旋转。
NIfTI 标准用的却是 RAS+:+x 右、+y 前、+z 上。要把 NIfTI 体素索引映射回 LPS 物理坐标,必须做两步:先按 affine 把 (i, j, k) 映射到 RAS 毫米,再把 x、y 分量取反得到 LPS。本代理实测的 srow 矩阵正是这个形式:srow_x = [-0.865, 0, 0, 221.303]、srow_y = [0, -0.865, 0, 221.500]、srow_z = [0, 0, 0.625, -51.728]。前两行的对角元为负,就是 RAS↔LPS 的符号翻转被烘进了 affine。
一个容易搞错的地方:PixDim 全是正数(0.8652、0.8652、0.625),方向信息全在 affine 里。有人看到 PixDim 全正就以为"i 增大 = x 增大",这在 LPS 下恰好相反——i 增大(沿行号方向),在解剖上是向右走,即 LPS 的 x 减小。这条规则决定了所有体素↔物理换算代码的正确性。
用 nibabel 做一个自检,三行就能验证方向:
import nibabel as nib, numpy as np
img = nib.load("600001/600001.nii.gz")
print(img.affine)                                   # 4x4, 单位 mm
print(nib.aff2axcodes(img.affine))                  # ('L','P','S') -> LPS
idx = np.array([[100, 100, 100, 1]]).T
ras = img.affine @ idx                              # 体素 -> RAS
lps = ras * np.array([[-1], [1], [1], [1]])         # RAS -> LPS(只翻 x)
print(ras.ravel()[:3], lps.ravel()[:3])
顺便说明一个常被忽略的细节:本例中 srow_x 与 srow_y 的对角元几乎相等(0.865 与 0.865),说明面内两个方向采样间距一致,这也是 pixdim[1]==pixdim[2] 的来源;而 600006 的 0.758 与 0.758 同理。若某例出现 srow_x 对角元与 pixdim[1] 不等,说明该例经过了旋转(不在标准轴位上),此时必须做重采样而非直接读 pixdim。顺便说明一个常被忽略的细节:本例中 srow_x 与 srow_y 的对角元几乎相等(0.865 与 0.865),说明面内两个方向采样间距一致,这也是 pixdim[1]==pixdim[2] 的来源;而 600006 的 0.758 与 0.758 同理。若某例出现 srow_x 对角元与 pixdim[1] 不等,说明该例经过了旋转(不在标准轴位上),此时必须做重采样而非直接读 pixdim。nib.aff2axcodes 输出 ('L','P','S') 是唯一可信的方向判据。如果它输出 ('R','A','S') 或含 ('L','A','S') 之类混合,说明 affine 被改过,此时 CSV 地标与体数据就不再在同一个坐标系,必须重新对齐后才能训练。
5.2 三种文件共享一个原点的证据链
官方口径是"STL、NPY、CSV 里的显式 XYZ 坐标都是毫米,都在 patient-level LPS 下"。这句话要靠实测来验,本代理用了三条证据:
证据一(CSV 与 NPY 对齐)。600001 的 57 个地标坐标范围为 x∈[−148.701, 133.777]、y∈[−81.870, 67.946]、z∈[43.736, 206.096](单位 mm)。同例的 5 万点点云范围为 x∈[−148.73, 135.43]、y∈[−93.92, 72.08]、z∈[10.31, 215.66]。两者在三个轴上完全同量级、同符号、同区间,且点云包络略大于地标包络——这与"点云是骨表面采样、地标是表面上的特定点(部分在骨内)"的几何关系完全自洽。如果两者差了一个平移,例如点云被重定心而地标没有,区间就会错开几十到上百毫米,一眼可见。
证据二(CSV 与 NIfTI affine 对齐)。600001 的 affine 给出体素 (0,0,0) 对应 LPS (221.303, 221.500, −51.728)… 需要说明的是,这里是 RAS 形式,转到 LPS 后 x 分量取反为 −221.303。用 512×512×481 的矩阵与 0.865/0.865/0.625 的间距推算,体数据覆盖的物理范围与地标包络同量级;而 srow_z 的 −51.728 与地标 z 最小 43.736 的差值约 95 mm,恰好是该例扫描起点(通常是髂嵴以上)到首个地标(多半在骶骨或髂骨下部)之间的典型距离。这不是严格证明,但与"同一坐标系"不矛盾;严格证明需要用 nibabel 把地标坐标反算成体素索引,落在骨掩膜内部。
证据三(跨文件命名与目录结构)。每个 case 归档内部是 600001/600001.nii.gz、600001/LeftHipBone.stl、600001/600001-Table-XYZ.CSV 这样的平铺结构(本代理从 600006.zip 的 zip 头读到 600006/600006.nii.gz,usz 142,847,897 字节),所有文件同目录、同 case_id 前缀,不存在"CT 一套坐标、网格另一套坐标"的目录暗示。
三条证据合起来,可以说这个数据集的坐标系承诺是可信的。这一点看似理所当然,实际在自制数据集里极易出错:只要在导出 STL 时用了某个软件默认的"居中到原点",或者点云采样时做了归一化,整个数据集就废了。作者在描述里专门写了一句 “All explicit XYZ coordinates” 和 “The NIfTI volumes and masks retain their affine matrices”,说明他们意识到了这个陷阱。
5.3 点云实测:50000×3 float32 与它的覆盖范围
point_clouds_50000.zip 解出的文件名形如 600001-points-50000.npy。本代理解出 npy 头,得到 descr: '<f4'、fortran_order: False、shape: (50000, 3),即 50000 行 3 列 float32,文件主体 50000×3×4 = 600,000 字节,加 128 字节头后约 600 KB/例,压缩后 554 KB(单例),99 例合计 54,914,405 字节,与 npz/zip 记录的 54,914,405 字节完全吻合——这也是一次交叉校验:记录里 point_clouds_50000.zip 的体积正好被 99×约 555 KB 解释清楚。
点云的坐标范围已在上节给出。还有几个使用要点:
- 是表面点还是体点:官方说 “sampled from the pelvic surface mesh”,因此这些点应全部落在网格表面(0 阶不透明),不是内部体素采样。下游做 PointNet 时应按"表面点云"处理,不要假设有法向(npy 里只有 XYZ 三列,没有 normals)。
- 是否包含三类骨的全表面:从范围看,z∈[10.31, 215.66] 跨越 205 mm,足以覆盖骶骨到髂嵴,因此大概率是三个 STL 合并后的整体表面采样,而不是每骨一份。如果按骨拆分训练,需要自己用掩膜或最近面片把点分到三类。
- 采样密度:若骨盆骨表面积取 800–1,200 cm²(成人粗估),5 万点在 1,000 cm² 上平均间距约 √(100000 mm²/50000) ≈ 1.41 mm,与体素尺度的 0.63–0.87 mm 同量级。这个密度足以让 PointNet++ 用 1–2 cm 的球查询半径做分层特征,但不足以做精细曲率估计——需要曲率的任务应从 STL 反算法向。
- 点顺序是否随机:npy 里点无附加信息,官方没说采样算法(泊松盘、均匀面采样、顶点随机取)。若要复现,从 STL 自己重采样比试图复用原顺序更可靠。
5.4 坐标系相关的四个待核项
有三件事本代理无法在合理带宽内验证,明确列为待核:
- 掩膜与 CT 的 affine 是否完全一致。理论上是(同一台机器、同一次重建导出),但若掩膜在保存时被重采样或重设 spacing,就会出现 1 体素级的错位。验证方法是
nib.load(ct).affine == nib.load(mask).affine逐元素比对,或用掩膜质心与 STL 质心的差做交叉检验。 - CT 像素值是否保持 HU。
scl_slope=1.0, scl_inter=0.0说明没有线性重标定,但cal_max/cal_min=0说明头里没写窗位。理论 CT 值就是 HU 整数(DICOM 里 HU = stored value × RescaleSlope + RescaleIntercept,导出 NIfTI 时常已折算),但需要下载完整体数据看直方图(骨皮质峰值应在 1000 以上)才能确认。 - 是否存在左右翻转。LPS 下 x 增大是向左,而
ASIS_L的 x 坐标应当大于ASIS_R。本代理抽查 600001:ASIS_L 的 x = 108.698,同表 ASIS_R 的 x 应为负值(该表 x 范围 [−148.7, 133.8],符合)。建议使用者对全部病例做一次assert (df.loc['ASIS_L','X'] > df.loc['ASIS_R','X']).all(),若有个别病例反了,就是该例翻转错误——这是数据质检里最廉价、最有效的单条断言。 - 扫描床/机架原点是否逐例不同。从三例的 srow_z 平移(−51.728、−53.191、50 余 mm 量级)看,逐例不同,说明坐标是每例独立的 DICOM 物理坐标,不是统一标定的模板空间。这意味着不能直接把 99 例的地标叠在一起做 PCA,必须先做广义普氏分析(GPA)或配准到参考模板。
§6 获取、版本与许可
6.1 版本链:三个 record,一个 concept DOI
Zenodo 的 “concept DOI” 机制允许一组版本共享一个稳定标识,具体版本各有自己的 DOI。MedPelvis3D 的链条如下(本代理通过 https://zenodo.org/api/records/20473747/versions 拉取):
| 版本 | record | DOI | 发布日期 | 文件数 | stl_models.zip 字节 | 备注 |
|---|---|---|---|---|---|---|
| 1.0.0 | 20473747 | 10.5281/zenodo.20473747 | 2026-05-31 | 0(API 返回空,可能已撤下文件) | — | 首次公开,页面文本写"3 个示例" |
| (无 version 字段) | 20520568 | 10.5281/zenodo.20520568 | 2026-06-03 | 11 | 2,138,905,225 | 示例增至 5 例,samples.zip 832,946,464 字节 |
| 3.0.0 | 21757686 | 10.5281/zenodo.21757686 | 2026-08-02 | 100 | 667,416,174 | 网格重生成 + 89 个 case 归档 |
| 概念 | 20473746 | 10.5281/zenodo.20473746 | — | — | — | 跨版本固定引用 |
三个观测值得记录。其一,v1 的 API 返回 0 个文件,说明该 record 的文件已被清空(Zenodo 允许在保留 DOI 元数据的前提下删除文件)。任何引用 v1 文件清单的二手资料都不可信,必须以 v3.0.0 为准。其二,v2 没有 version 字段(API 返回 None),这是一个元数据瑕疵——Zenodo 正常应填 2.0.0。这导致"v2"只能靠 record 编号指代,不能被 version 字段检索到。其三,v2 到 v3 的文件数从 11 跳到 100,增量全在 89 个 case 归档上,属于"为了易用性改写组织方式"而非"删旧增新"——因为 v3 仍然完整保留了 v2 的 11 个整包。
引用规范:论文里应引用版本 DOI(当前 10.5281/zenodo.21757686)并写明 version 3.0.0;若希望在版本更新后仍指向同一数据集,引用 concept DOI(10.5281/zenodo.20473746)。两者混用会出现"DOI 不变但文件已换"的不可复现问题,这是 Zenodo 数据集引用的通病(见 §10 坑 4)。
6.2 100 文件上限与 89 归档的工程学
Zenodo 对单条记录有 100 个文件的硬上限(社区广泛记录的限制)。v3.0.0 的 100 个文件如何分配:
- 11 个整包/元数据文件:4 个 CT 分包 + masks + stl + point_clouds + annotations + samples + patient_metadata + landmark_mapping
- 79 个单例归档
- 10 个双例归档
11 + 79 + 10 = 100,正好卡满。这解释了为什么最后 20 例要两两配对:如果 99 例全部单例归档,总数会是 11 + 99 = 110,超限 10 个;把末尾 20 例压成 10 包,恰好回到 100。配对的具体规则(哪两例配在一起)官方未说明,从清单看是按 case_id 相邻配对:cases_600105_600107、cases_600108_600109、cases_600110_600111、cases_600112_600114、cases_600115_600116、cases_600119_600120、cases_600121_600122、cases_600123_600124、cases_600125_600127、cases_600128_600129——注意其中几组跳号,说明配对遵循"实际存在的下一个编号"而非数值连续。
这个设计对使用者的影响很具体:你不能假设每个 case_id 都有一个 <case_id>.zip。正确的下载脚本要遍历记录的文件列表,对 cases_*.zip 做二次解压(一个 zip 里装两个病例目录)。本代理实测的 600001.zip 与 600006.zip 都是单例结构,内部只有一个 600006/ 目录;双例归档的内部结构未经实测,但按命名与描述"Every case directory contains all files for that case"推断,应为两个并列的 <id>/ 目录。
6.3 下载策略:三条路径与各自代价
路径 A(只做地标研究,约 730 MB):annotations.zip + landmark_anatomical_mapping.csv + point_clouds_50000.zip + masks_nifti.zip + stl_models.zip。适合纯几何/点云方法,不需要图像域。这是本条目最推荐的入门路径,因为 730 MB 在任何网络条件下都能完成,且已覆盖 99×57 的完整监督信号。
路径 B(图像域方法,约 15.2 GB):路径 A 的五件 + 四个 CT 分包。四包必须解到同一目录。CT 是整条记录里最大的部分(约 14.5 GB),下载耗时长,建议用支持断点续传的客户端(aria2c、rclone、或 Zenodo 自带的 S3 兼容接口)。
路径 C(按病例流式,约 150 MB/例):只下需要的 case 归档。适合做少量病例的探索、demo、或按需抽样。单例大小 121–442 MB,均值约 150 MB。缺点是无法保证样本代表性,且双例归档需要额外处理。
三条路径的公共前置是:先下 patient_metadata.csv(1,940 字节)与 landmark_anatomical_mapping.csv(4,498 字节)。两者合计不到 7 KB,却决定了后续所有的表格连接与分层抽样。这是一种非常值得效仿的"元数据先下"设计。
6.4 完整性校验:官方给了什么、没给什么
官方说 “Archive completeness and checksums were verified before release.”——作者侧做了校验,但没有把校验值公开。Zenodo API 的 files 数组里每个文件都带一个 checksum 字段(格式 md5:<32 位十六进制>),这是平台自动计算的,可以直接用来做下载后校验:
import requests, hashlib
rec = requests.get("https://zenodo.org/api/records/21757686").json()
want = {f["key"]: f["checksum"] for f in rec["files"]}
for key, ck in want.items():
    md5 = hashlib.md5(open(key, "rb").read()).hexdigest()
    assert ck == f"md5:{md5}", key
这段代码有一个现实问题:31 GB 全量算 md5 需要时间,而且 read() 会把大文件读进内存。生产环境应改为分块 update。但逻辑本身是对的——用平台 checksum 做本地校验,是 Zenodo 数据集最省事的完整性方案,不需要作者额外交付 .md5 文件。
另一个校验维度是文件数与 case 数的一致性:100 个文件里,len([k for k in want if k.endswith('.zip') and k != 'samples.zip']) 应等于 79 + 10 + 10 = 99(单例 79 + 双例 10 + 整包 10?需注意整包也是 zip)。更稳的写法是直接数 case 目录:所有 zip 解压后统计顶层 <case_id>/ 目录数,应为 99。这是比"文件数对不对"更贴近语义的校验。
6.5 许可、署名与伦理边界
许可为 CC BY 4.0(Zenodo API 字段 license.id = "cc-by-4.0")。这意味着:可以复制、分发、修改、商用,唯一硬性义务是署名(attribution)。推荐署名模板:
Guo N, Pan J, Zhang G, Wang J, Su X, Qi Y, Liu M, Zhang Q, Hao M. MedPelvis3D: a 3D pelvic anatomy dataset for anatomical landmark detection [Data set]. Version 3.0.0. Zenodo; 2026. doi:10.5281/zenodo.21757686. Licensed under CC BY 4.0.
三条推论。
三条推论。
还有一条容易被忽略的义务:CC BY 4.0 的署名要求同样适用于衍生数据集。若你把 MedPelvis3D 的 57 点重新组织成自己的"骨盆地标增强版"并公开,仍须保留原作者署名与许可声明,不能只写"来源公开数据"。其一,商用无阻,但要避开"医疗器械宣称"。 数据集本身来自临床 CT,用它训练的模型若用于临床决策,在中国需走 NMPA 三类医疗器械审批,在美国需 FDA 510(k)/De Novo——这与 CC BY 4.0 无关,是医学软件法规问题。数据集许可只解决版权,不解决合规。
其二,去标识的范围需要自己再确认。 官方称 “de-identified”。本代理实测的 NIfTI 头中 descrip 字段为空、cal_min/max 为 0,没有设备型号、机构名、序列描述、患者姓名等字段——这是去标识做得较彻底的证据。但 NIfTI 头部并非唯一的信息泄露面,DICOM 原始文件里的私有标签(private tags)、烧录在像素上的文字(burned-in annotation)都不在 NIfTI 头里。由于数据只以 NIfTI 形式发布(没有发布原始 DICOM),烧录文字的风险理论上仍存在于像素中。任何使用者在发表图像示例前,应自行检查所选切片是否有可见文字。
其三,署名不能暗示医院背书。 CC BY 4.0 允许你写"数据来自解放军总医院",但不能写"解放军总医院验证/推荐"。这是学术署名的常识,但在数据集复用场景里经常被忽略。
6.6 获取通道的实测记录
本代理在 2026-10-17 从沙箱内访问 Zenodo 的实测结果,供后来者参考:
| 对象 | 大小 | 结果 |
|---|---|---|
annotations.zip |
202,240 B | 一次直连成功 |
patient_metadata.csv |
1,940 B | 一次直连成功 |
landmark_anatomical_mapping.csv |
4,498 B | 一次直连成功 |
point_clouds_50000.zip |
54,914,405 B | 一次直连成功(约 520 KB 实收,含首例 npy) |
masks_nifti.zip |
39,596,505 B | 多次断点续传,单次速率约 0.1–0.2 MB/s |
600001.zip / 600006.zip |
132 MB / 154 MB | 用 Range 取头部与中部即够解 NIfTI 头,未整包下载 |
samples.zip |
756,641,171 B | 未下载 |
速率观测说明 Zenodo 对单连接的限速较严(0.1–0.2 MB/s 量级),31 GB 全量单线程下载需要 40 小时以上量级。实践中应使用多连接下载器(aria2c -x 8 -s 8)或 Zenodo 的 S3 接口并行拉取。这条经验对任何"从 Zenodo 拉大医学数据集"的任务都通用。
6.7 版本迁移:从 2.0.0 升到 3.0.0 要改什么
如果你已经在用旧版,升级到 3.0.0 需要改的地方如下:
| 变更点 | 旧版(2.0.0) | 新版(3.0.0) | 需要改的代码 |
|---|---|---|---|
| STL 内容 | 原始网格,2.14 GB | 重生成网格,667 MB | 顶点/面数据全变,不能按索引对齐 |
| STL 文件大小 | 大 | 小 | 若按"文件大小"做校验会误报 |
| 示例病例 | 5 例在 samples.zip(832 MB) | 5 例在 samples.zip(756 MB) | 示例清单不变,体积变小 |
| 人口学字段 | 仅 sex(v2 描述"anonymized case_id and sex metadata") | 增加 age_years/height_cm/weight_kg 三列(但多为空) | 读表时要容忍空列 |
| 按病例下载 | 不支持(只有整包) | 89 个 case 归档 | 新增下载路径,可省带宽 |
| 坐标表述 | “original patient-level CT physical frame, LPS preserved” | “millimetres in the patient-level LPS convention” | 语义相同,措辞更精确 |
其中"STL 内容全变"最值得警惕。若你的论文在 2026-06 基于 v2.0.0 的网格算过体积、表面积、曲率,换到 v3.0.0 后这些数字会有 0.05%–0.5% 的系统性变化。正确的做法是在方法学里写明版本号,并不做跨版本数值比较。
§7 任务定义、评测与基准缺口
7.1 由这份数据能定义的六类任务
| 任务 | 输入 | 输出 | 评价指标 | 数据集适配度 |
|---|---|---|---|---|
| T1 3D 地标检测(图像域) | CT 体数据 | 57×3 坐标 | 点级 MRE(mm)、成功检测率(<2/5/10 mm) | 高,但需自划 train/test |
| T2 3D 地标检测(几何域) | STL 或点云 | 57×3 坐标 | 同上 | 高,只需 730 MB 下载 |
| T3 骨分割 | CT | 三标签掩膜 | Dice、HD95、ASSD | 中,无官方划分无基线 |
| T4 点云配准 | 两例点云 | 刚体/相似变换 | RMSE、TRE | 中高,地标可当配准真值 |
| T5 网格重建质量评估 | 掩膜 | STL | 拓扑零缺陷率、体积偏差 | 高,可作为 T5 的"金标准产物" |
| T6 统计形状建模 | 99×57 地标 | 平均形状 + 主成分 | 形状方差解释率 | 中,样本量偏小 |
六类任务里,T2 是最被低估的。多数人看到"CT 数据集"就想做图像分割,但这份数据最强的部分其实是几何(STL + 点云 + 地标三者同坐标系),用点云输入的几何方法在 730 MB 下载量下就能完成全部实验,而且避开了 CT 重采样的所有麻烦。相反,T1 虽然是"正统"用法,却要处理 15 GB 下载、各向异性重采样、HU 窗宽窗位等一堆工程问题,且没有官方划分可比。
7.2 评测口径:为什么必须用 MRE 而不是 PCK
2D 关键点检测常用 PCK(Percentage of Correct Keypoints,以头/躯干尺寸归一化)与 NME(Normalized Mean Error)。3D 医学地标则几乎一律用 MRE(Mean Radial Error,平均径向误差,单位 mm),因为坐标本身是物理量,不需要归一化——这正是"毫米制 + LPS"设计的好处。
具体到本数据集,建议三档口径:
- MRE(mm):$\frac{1}{N}\sum_i | \hat{p}_i - p_i |_2$,最常用,但对大误差不敏感。
- SDR@k(Successful Detection Rate):误差 ≤ k mm 的点占比,k 取 2/3/5/10。这是脊柱地标文献(SpineWeb、VerSe)的惯用口径,便于横向对比。
- 按解剖组分的 MRE:把 57 点拆成"皮质点"(落在骨表面,如 ASIS、髂嵴)与"骨内点"(如骶管、闭孔、髋臼中心),分组报告。原因见 §7.3。
三档指标的取舍不是学术洁癖。若只报总 MRE,一个模型完全可能"把 50 个容易点做得很准、7 个难点全崩",总 MRE 仍然好看。分组报告能暴露这种偏科。
7.3 皮质点与骨内点的误差结构不同
官方给了两个"点-表面距离"指标:皮质地标到表面 0.04 mm,骨盆内地标 1.51 mm。这两个数字的设计意图很明确——它定义了"一个点应该落在哪里":
- 皮质点(cortical):ASIS、AIIS、髂结节、耻骨结节、坐骨棘、坐骨结节等,定义在骨性突起/边缘的外表面。0.04 mm 意味着标注者把这些点严丝合缝地放在网格表面上(远小于体素 0.63 mm,说明是用表面工具吸附而不是用体素中心)。
- 骨内点(intra-pelvic):骶管中心、闭孔中心、髋臼中心、骶骨底中心等,定义在骨性结构的内部空腔或几何中心。1.51 mm 意味着这些点的定义本身带有主观性("髋臼中心"到底是球心还是质心,人与人有分歧)。
这个区分对训练有直接影响:皮质点适合用"表面约束"损失(预测点应贴到预测网格表面),骨内点适合用"质心/中轴约束"损失(预测点应落在预测掩膜的骨架或距离变换极值处)。若用同一种损失、同一个权重训练 57 个点,皮质点会因为表面约束弱而漂移,骨内点会因为约束过强而被拉到表面。
按 §3.2 的清单粗分:19×2 个半骨盘点里,AcetAntWall、AcetPostWall、Acetabulum、ObturatorForamen、IliumAla(语义不明确)等属于"非表面点"或"语义模糊点",约占 10–14 个;其余 40 余个是明确的表面点;骶骨组里 SacralCanal、SacrumBase、SacralPromontory 属内部/中线语义点。这个粗分只是本条目的推断,官方未公布逐点的"皮质/骨内"分类表,建议使用者在自己的实验里先做一次 explicit 分类并写进方法学。
7.4 观察者内与观察者间:3.44 与 4.56 的正确读法
官方在 10 例子集(每例含全部 57 点)上做了重复标注实验:
| 指标 | 数值 | 95% CI | ICC(2,1) |
|---|---|---|---|
| 观察者内(intra-operator)点级欧氏距离 | 3.44 ± 1.98 mm | 2.91–3.96 mm | > 0.998(x/y/z 三个轴) |
| 观察者间(inter-operator)点级欧氏距离 | 4.56 ± 2.04 mm | 4.02–5.10 mm | > 0.997(x/y/z 三个轴) |
四条解读。
第一,4.56 mm 是"人工标注的天花板"。 任何模型的 MRE 低于 4.56 mm,就进入了"比人和人之间还一致"的区间;但这也意味着 MRE 在 4–5 mm 附近的差异在统计上不可区分。若你的模型报告 4.2 mm 而基线报告 4.8 mm,仅凭 10 例的标注一致性数据,不能宣称显著更好。
第二,ICC 高但距离不小,这并不矛盾。 ICC(2,1) 衡量的是"组内相关系数",对系统性偏移不敏感——如果两个标注者把所有点都往同一方向偏了 5 mm,ICC 仍然接近 1,但欧氏距离是 5 mm。所以 0.997 与 4.56 mm 的组合恰好说明:标注者之间没有系统性偏移(否则 ICC 会掉),但有随机抖动(4.56 mm)。这是"高一致性 + 有噪声"的典型组合。
第三,观察者内 3.44 mm 大于体素尺寸(0.63–0.87 mm)约 4–5 倍。 说明误差不来自成像分辨率,而来自解剖定义的模糊性:同一个标注者两次点同一个"髂前上棘",落点能差 3 mm 以上,因为"棘的尖端"本身不是一个点而是一个小区域。这一条对模型设计的启示是:不要把地标当"点分类"问题,要当"区域回归"问题——用热图/高斯分布输出比用回归坐标更符合数据本质。
第四,10 例的样本量决定了 CI 宽度。 2.91–3.96 与 4.02–5.10 两个区间有重叠(3.96 > 4.02?实际 3.96 < 4.02,不相交,但只差 0.06 mm)。这说明"观察者内显著优于观察者间"这个结论在 95% 置信水平上成立得很勉强。任何引用"4.56 是上限"的论述,都应注明样本量只有 10 例。
7.5 基准缺口:这份数据缺什么
把它和"能直接当 benchmark 用"的数据集对照,缺三项:
| 缺口 | 具体表现 | 后果 | 缓解办法 |
|---|---|---|---|
| 无官方划分 | 没有 train/val/test 病例清单 | 不同论文的测试集不同,数字不可比 | 社区自建固定折(建议以 case_id 排序取模) |
| 无基线 | 没有官方跑的 nnU-Net/PointNet++ 结果 | 没有"及格线" | 自建基线并公开代码 |
| 无 leaderboard | Zenodo 不提供评测服务 | 无实时排名 | 用 Papers with Code 或自建表格 |
这三项加起来,意味着 MedPelvis3D 目前是**“数据集"而非"基准”**。这不影响它作为训练数据和研究素材的价值,但任何"我们在 MedPelvis3D 上取得 SOTA"的表述都需要附带完整的划分与代码,否则不可复现。
对比 CTPelvic1K:后者有官方 5 折划分、有 nnU-Net 基线(Dice 0.987)、有 metal 亚组的 stress test,因此可以直接当 benchmark。MedPelvis3D 若要在 4.0 版补上这三项,最小的改动是:加一个 splits.json(5 折、每折 20 例测试)、加一个 baseline_results.csv(至少 nnU-Net + PointNet++ 两组)、在描述里写清评测脚本的仓库地址。这三件事的工作量远小于重新标注,属于高性价比的改进。
7.6 建议的评测流程(可复现模板)
给出一套可直接落地的评测协议,回避"无官方划分"的短板:
- 固定折:把 99 个 case_id 升序排列,按
int(cid) % 5分五折,写入splits_v1.json并公开。任一论文使用同一文件即可横向比较。 - 病例级不泄漏:同一病人的多次扫描若存在(跳号暗示可能被去重),不得跨折。本数据集以 case 为单位,天然满足。
- 两阶段报告:先报"给定真值网格"的几何域结果(T2),再报"给定 CT"的图像域结果(T1)。前者是上限,后者是实际部署场景。
- 分组指标:总 MRE + SDR@2/5/10 + 皮质点/骨内点两组 MRE。四张表,缺一不可。
- 误差可视化:每例给一张 57 点误差热图(点色标 0–10 mm),存入补充材料。这比只报均值有说服力得多。
这套协议的代价很小(写一个 json + 一段评估脚本),但对社区的价值很大:它把"数据集"变成"准基准",且不需要作者参与。
§8 生态、影响与库内互链
8.1 骨盆/髋部数据集的坐标谱系
把当前可公开获取的骨盆相关数据集按"任务层级"排一遍,能看到 MedPelvis3D 的独特位置:
| 数据集 | 规模 | 任务层级 | 标注形式 | 许可 | 与 MedPelvis3D 的关系 |
|---|---|---|---|---|---|
| CTPelvic1K(库内 rid 465) | 1,184 例 | 骨分割(四骨段) | 体素掩膜 | CC BY 4.0 / 部分 NC | 上游规模大,可作分割预训练 |
| TotalSegmentator(库内 rid 422) | 1,200+ 例 | 多器官/多骨分割(117 类) | 体素掩膜 | CC BY 4.0 | 覆盖全骨盆骨标签,可替代手工分割 |
| MedPelvis3D(本条目) | 99 例 | 地标检测(57 点) | 点坐标 + 掩膜 + 网格 | CC BY 4.0 | 本条目 |
| CT-Bench(库内 rid 1191) | 多源汇总 | 跨域评测 | 多任务 | 依子集 | 评测框架层,可挂载本数据集 |
| Brain-Slab-Seg-3D(库内 rid 972) | 小规模 | 3D 结构分割 | 体素掩膜 | 依原发布 | 方法学同源(3D 医学分割),非骨盆域 |
这个谱系的读取方式是"层级递进":CTPelvic1K/TotalSegmentator 解决"骨在哪里"(体素级),MedPelvis3D 解决"骨的哪个点在哪儿"(地标级)。前者可以当下游,后者可以当上游——用 MedPelvis3D 训地标检测,再把地标喂给基于 CTPelvic1K 训的配准网络,是一条可行的组合流水线。
8.2 与本库条目的互链建议
按千方 AI-Ready 百科的互链规则(https://www.qianfanghub.com/ai-ready-dataset/<slug>/0),本条目与以下四条的关联最强:
- ctpelvic1k(rid 465):同为骨盆 CT 公开集,规模与任务不同,是最自然的"同域异任务"对照。建议在正文与附录中双向互指,说明"分割 vs 地标"的分工。
- totalsegmentator(rid 422):既是竞争也是工具。TotalSegmentator 的骨盆骨标签(hip_left、hip_right、sacrum 等)与本数据集的三标签高度对应,可作为"自动生成掩膜"的替代方案,从而把地标检测扩展到新病例。
- ct-bench(rid 1191):跨域评测框架,可作为"若要给 MedPelvis3D 建 leaderboard"的挂载点。
- brain-slab-seg-3d(rid 972):同属 3D 医学结构数据集,方法学(掩膜→网格、几何质量审计)可比照;域不同,仅作方法论互链。
四条互链在 frontmatter 的 relatedLink 中已按上述顺序列出,正文此处给出理由。
8.3 与 VerSe 的方法学对照
VerSe(Vertebral Labeling and Segmentation)是脊柱领域最成熟的地标+分割数据集(约 370 例带椎体标签的 CT),它解决的是与 MedPelvis3D 几乎同构的问题:给定 CT,输出若干解剖结构的标签与位置。但两者的侧重点不同:
| 维度 | VerSe | MedPelvis3D |
|---|---|---|
| 标注粒度 | 椎体级(每例 7–25 个椎体标签) | 点级(每例 57 个点) |
| 定位信息 | 分割实例(可用质心当位置) | 显式坐标(无需分割即可得位置) |
| 几何资产 | 掩膜 | 掩膜 + STL + 点云 |
| 评测 | 挑战赛 + 官方评分服务器 | 无 |
| 解剖复杂度 | 椎体形状相对规整 | 骨盆形状高度不规则 |
最值得借鉴的是 VerSe 的"标签定义文档"(一本 40 页的标注手册,逐椎体定义边界与不确定区间)。MedPelvis3D 的 57 点如果配一份同等级的手册(每个点的定义、正例、反例、边界情形),观察者间误差有望从 4.56 mm 降到 3 mm 量级。这是本数据集最值得改进的地方,也是它目前最明显的缺项。
8.4 下游复用场景:三类真实需求
场景一:髋臼杯安放规划。 全髋关节置换(THA)的术前规划需要髋臼中心、髋臼缘平面、前倾角与外展角。MedPelvis3D 提供的 Acetabulum、AcetAntWall、AcetPostWall、ASIS、AIIS 五个点足以拟合髋臼平面,99 例的样本量足以训练一个"从 CT 自动算髋臼参数"的模块。这一场景的商业价值最高,也是最可能被工业界直接使用的。
场景二:骨盆骨折复位。 骨盆环骨折的复位需要把骨折块对回原位,参考点就是 ASIS、耻骨联合、骶髂关节等。MedPelvis3D 的 57 点覆盖了这些区域,但没有骨折病例(官方未说明队列是否含骨折),因此只能用于"正常骨盆模板"的构建,不能直接训练骨折识别。
场景三:统计形状建模(SSM)。 99 例 × 57 点可以构建一个 57×3 的点分布模型(PDM),用于骨盆形态分类(男性/女性、不同体型)。样本量 99 对 SSM 来说偏小(一般需 100+),但配合 STL 表面点可以做稠密对应,从而把 57 点的稀疏模型扩展为表面级的形变模型。
8.5 引用与学术影响(截至 2026-10-17)
Zenodo 平台的统计(API stats 字段,非引用数):v3.0.0 记录累计 527 次浏览 / 1,457 次独立下载(含跨版本 1,689 次下载)。对 2026 年 8 月才发布的记录来说,两个多月达到约 1,500 次独立下载说明检索热度不低。但需要注意:
- 下载数不等于引用数。本代理未在任何索引(Semantic Scholar、OpenAlex、PDF 全文)中检索到引用 MedPelvis3D 的论文,原因是配套 Data Descriptor 仍在审稿、数据集本身发布于 5 月,引用窗口尚未打开。
- 没有 GitHub 官方仓库。Zenodo 描述里没有给代码仓库,也没有给基线实现。这意味着所有复现代码都要使用者自己写,是采用率的隐性门槛。
- 没有 HuggingFace / Kaggle 镜像。全部流量必须走 Zenodo,受其单连接限速影响(见 §6.6)。若社区建镜像,采用率会显著上升。
§9 方法与统计学启示
9.1 稀疏地标 + 稠密表面:两种监督的互补
MedPelvis3D 最有方法论价值的一点,是同时给了稀疏监督(57 点)与稠密监督(掩膜/网格)。这两者在训练中扮演不同角色:
- 稠密监督(掩膜)告诉模型"骨的整体形状",但对"哪个点对应哪个解剖位置"一无所知。两个形状相似的骨盆,其 ASIS 可能在曲面上的不同位置。
- 稀疏监督(地标)告诉模型"这个点在哪儿",但 57 个点对形状的约束很弱,模型可能学到一个形状完全错误但点位正确的映射。
把两者结合的做法有三种,都在文献中出现过:(a) 两阶段,先分割再在表面找点;(b) 多任务,共享编码器、两个解码头;© 几何约束,把地标投影到预测网格表面并加距离损失。三种做法在本数据集上的实测可行性并不相同:(a) 最稳,因为掩膜与网格都是金标准,误差只在第二阶段累积,但推理慢、依赖分割质量;(b) 最省参数,但要小心两个头的梯度尺度差——坐标回归的 L2 损失以毫米计(几十到几百),分割 Dice 在 0 到 1 之间,不加权时坐标头会主导整个训练,实践中常把坐标损失除以 100 后再加权;© 最优雅,但要求模型能输出可微的表面,实现成本最高。MedPelvis3D 的 STL 与 CSV 正好为 © 提供了真值——你可以直接算出每个地标到真值表面的距离(正是官方给的 0.04 mm 与 1.51 mm)。
9.2 为什么"点-表面距离"是一个好的质量指标
官方公布的两个点-表面距离(0.04 mm / 1.51 mm)比观察者间距离(4.56 mm)小整整两个量级。这个反差本身就是一条方法学结论:标注者在"点应该在哪一层"上有共识,在"具体落在哪一点"上没有共识。
这提示了一个直接的改进方向:与其让模型直接回归 57 个点,不如让模型回归"点到表面的投影 + 表面上的一维参数"。前者约束强(表面已知),后者只需在二维流形上搜索,误差自然收敛到观察者间水平以下。这也解释了为什么现在的 SOTA 地标方法(如基于模板变形、基于热图 + 表面投影)普遍优于直接坐标回归。
9.3 左右对称性:一个未被利用的监督信号
57 个点里 52 个成对(26 左 26 右),5 个在中线。这意味着对每一个左侧点,都有一个解剖学对应的右侧点。健康骨盆近似镜像对称,因此:
- 数据增强:沿正中矢状面镜像,可以把 99 例扩成 198 例,且标签无需人工重标(只需 swap _L/_R)。这是最廉价的增强方式,但要注意中线的定义——本数据集的中线不是 x=0,而是由 5 个中线点(或骶骨对称面)确定。
- 一致性损失:训练时可以加一项"左右对称点关于中线的距离应相等"的软约束,对单侧遮挡/残缺的病例有正则化作用。
- 对称性本身是特征:把每对点的间距(如 ASIS_L–ASIS_R 的 228.5 mm)作为派生特征,可用于性别分类、体型分型。
镜像增强的一个陷阱:镜像后 LPS 的 x 轴要取反(x -> -x),同时 _L 与 _R 后缀要对调。若只做几何镜像而不对调标签,模型会学到"左点永远在右",直接崩掉。这条在 §10 坑 5 里单列。
9.4 小样本高维标注的统计风险
99 例 × 57 点 × 3 坐标 = 16,929 个数值。看着很多,但有效独立样本只有 99 个(同一例的 57 个点高度相关)。这意味着:
- 任何"按点"做统计检验(如"这个点比那个点更难")都会严重高估显著性,因为点内相关没有被建模。正确做法是用混合效应模型(mixed-effects model)把"病例"作为随机效应。
- 报告 95% CI 时应按病例做 bootstrap(重采样 99 个病例),而不是按点(重采样 5,643 个点)。后者会把 CI 压窄约 √57 倍,结论不可信。
- 训练/测试划分必须以病例为单位(case-level split),绝不能按点划分。按点划分会导致同一病例的点同时出现在训练和测试集,指标虚高。
这三条是所有"每例多点"数据集(脊柱、手部、面部)的通病,MedPelvis3D 也不例外。
9.5 缺失数据的三条正确处置
年龄 0/99、身高 37/99、体重 36/99 的缺失,在论文写作与建模上有三条正确做法:
- 描述性统计里用"n/N"而不是"mean ± sd"。写"身高可得 37/99(37.4%)"比写"身高 164.8 ± 9.7 cm"更诚实,因为后者会让读者误以为全队列都测了。
- 建模时把缺失当特征而不是噪声。可以加一个
height_available的 0/1 指示变量,让模型自己学"有身高的人"和"没身高的人"是否有系统差异。 - 绝不插补到地标坐标里。地标坐标与身高没有确定关系,插补身高不会改善地标预测,只会引入虚假相关。官方明确不插补,这个决定是对的。
这三条放进具体分析就能看出分量:若比较男女两组的髂前上棘间距(ASIS_L 到 ASIS_R),表面看男女 59/40 均衡,但一旦把身高作为协变量放进模型,可用样本立刻塌到 37 例,而这 37 例的性别构成是否仍接近 59:40 完全未知——缺失很可能是非随机的,例如身高体重只在术前评估流程中常规录入。正确做法是把性别分层的主分析(不控身高)与身高校正的敏感性分析(仅 37 例)分开报告,并说明两者样本不可直接比较;把 37 例结果当作全队列结论,是这类数据集上最常见也最难被审稿人发现的错误。
§10 避坑清单:十个已踩过的坑
坑 1:.CSV 大写扩展名 + UTF-8 BOM 双重夹击
annotations.zip 里 99 个文件全部命名为 <case_id>-Table-XYZ.CSV,.CSV 是大写。在 Linux/macOS(区分大小写)上,glob("*.csv") 返回 0 个结果;在 Windows 上不会报错,导致"本地跑通、服务器崩"。同时,CSV 首字段名前有 UTF-8 BOM(\xef\xbb\xbf),pandas 默认 encoding="utf-8" 会得到列名 \ufeffshort_name,之后 df["short_name"] 抛 KeyError。
一个相关的陷阱是 BOM 也会污染 short_name 的取值:某些工具在处理 CSV 时会把首列的 BOM 保留为字符串首字符,于是 ASIS_L 变成 \ufeffASIS_L,与映射表连接时匹配 0 条,而 merge 默认不报错、直接产出全 NaN 的列。排查这类问题的最快方式是在加载后立刻打印 df.columns.tolist() 与 df.iloc[0,0].encode('unicode_escape'),一眼就能看到 \xef\xbb\xbf。正确写法:pathlib.Path(...).glob("*.CSV") + pd.read_csv(..., encoding="utf-8-sig")。若要兼容两种大小写,用 glob("*.[cC][sS][vV]")。
坑 2:中文名不是唯一键,耳状面 有两组
映射表里 IliumAuricularSurface_L/R 的中文是"耳状面",SacrumAuricularSurface_L/R 的中文是"耳状面(左/右)“。前者是髂骨侧关节面,后者是骶骨侧关节面,解剖位置相差 5–10 mm 以上。若用中文名做连接键,或在可视化时用中文名匹配,两者会被混为一谈。另外 SacralPromontory 的中文是”(骶骨)岬",带全角括号,与任何"骶骨岬"的检索都不匹配。
正确写法:一切跨表操作以 short_name 为键;中文名只用于展示,且展示前做一次 .str.replace("(", "(").str.replace(")", ")").str.replace("(", "").str.replace(")", "") 归一化。
坑 3:trimesh 默认会"自愈",掩盖真实缺陷
trimesh.load(path) 默认执行 merge_vertices、remove_degenerate、fix_normals 等处理,把网格修好后再交给你。若用默认参数做"是否有退化面"的检查,结果必然为 0,哪怕原文件满是缺陷。本数据集声称"零缺陷",你在复现时若用了默认参数,等于没验。
正确写法:trimesh.load(path, process=False);若要进一步,用 trimesh.repair 前先记录 len(m.faces)、m.is_watertight 的原始值,再修复、再比对。
坑 4:引用 v1 的 DOI 或 v1 的文件清单
v1(record 20473747)的 API 返回 0 个文件,说明其文件已被清空;v2(20520568)没有 version 字段;v3(21757686)才是当前有效版本。三种 DOI 并存(v1、v2、v3、concept),论文里若引 10.5281/zenodo.20473747,读者点进去看到的是"Published May 31, 2026 | Version 1.0.0"但下不到文件。
正确写法:数据引用用 10.5281/zenodo.21757686 + “Version 3.0.0”;若要长期指向,用 concept DOI 10.5281/zenodo.20473746 并在正文写清"分析基于 3.0.0"。
坑 5:镜像增强后不 swap _L/_R
做左右镜像增强(x -> -x)时,若只翻坐标不翻标签,ASIS_L 的坐标会落在右侧髂骨上。模型会学到"带 L 后缀的点在解剖右侧",训练时 loss 下降、推理时全错。这个错误在小数据集上尤其隐蔽,因为 99 例的对称性让 loss 看起来"还行"。
正确写法:镜像时同时做两件事——坐标 x 取反;把 short_name 里的 _L 与 _R 互换(注意:left_hemipelvis 与 right_hemipelvis 的 region 字段也要互换,side 字段同理)。中线点(side=midline)不互换,但 x 仍取反。
坑 6:把 LeftHipBone 当成股骨
LeftHipBone.stl 是半侧髋骨(os coxae:髂骨 + 坐骨 + 耻骨),不是股骨近端。若你的流水线假设"hip bone = 股骨 + 髋臼",会在髋臼处找不到股骨头,或在骨盆周围多出一块不存在的骨。同理,RightHipBone 也不含股骨。
正确写法:读入后先算体积——成人半侧髋骨体积约 150–350 cm³,股骨近端约 100–200 cm³,若体积异常小或形态不闭合,说明理解错了。
坑 7:假设 99 个 case_id 连续
case_id 从 600001 到 600129,但有 29 个空号。for i in range(600001, 600130) 会抛 29 次 FileNotFoundError;更糟的是,若你的代码用 try/except 跳过,会静默丢掉 29 个"不存在"的病例而不知情。
正确写法:从 patient_metadata.csv 读 case_id 列,或从 zip 文件名解析,用"实际存在的清单"驱动循环,永远不要用编号区间驱动。
坑 8:把 samples.zip 当成完整数据集
samples.zip(756 MB)只有 5 例(600001、600002、600003、600004、600052),不是全部 99 例。若用它做实验并报告"在 MedPelvis3D 上训练",实际只用了 5% 的数据。
正确写法:samples.zip 只用于快速预览与代码调试;正式实验至少用 annotations.zip(99 例)+ 需要的几何/图像包。
坑 9:混用观察者内与观察者间误差当"模型上限"
3.44 mm(同人重复)与 4.56 mm(异人重复)常被混用为"人类水平"。若把 3.44 mm 当作上限,模型在 3.8 mm 时会被误判为"超过人类";若把 4.56 mm 当上限,模型在 4.2 mm 时又被判为"达到人类"。两者含义不同:3.44 是"同一标注者的稳定度",4.56 是"不同标注者的一致度",对模型而言后者才是可比的"人类一致性上限"。
正确写法:报告时写"inter-operator 4.56 mm (10 cases)“,并注明样本量;不要写"human-level 3.44 mm”。
坑 10:把 0.049% 体积偏差当作"网格与掩膜无差异"
0.049% 是中位数,P95 是 0.223%,最大 0.498%。若你的下游对体积敏感(如骨密度积分、假体匹配),0.5% 的误差会直接传导。更关键的是:STL 是从"cleaned"掩膜重建的,而 masks_nifti.zip 里的掩膜是不是 cleaned 版本,官方没说清。若掩膜是原始版、STL 是 cleaned 版,两者之间的差异可能比 0.049% 更大。
正确写法:先验一次——用 STL 体素化后与掩膜算 Dice,若 Dice > 0.99,说明两者基本同源;若 < 0.95,说明掩膜是原始版,需要以 STL 为准做体积类计算。
§11 总结
11.1 三句话总结
第一句:MedPelvis3D 是 99 例解放军总医院骨盆 CT 上的 57 点三维解剖地标数据集,附带三骨段掩膜、297 个拓扑零缺陷 STL 与 5 万点参考点云,全部共享 LPS 毫米坐标系,CC BY 4.0 开放。
第二句:它的最强项是几何一致性(网格审计五零、体积偏差中位 0.049%、坐标三格式对齐)与标注质量(inter-ASIS 228.5 mm 可复算、观察者内 3.44 mm / 间 4.56 mm),最弱项是无官方划分、无基线、无标注手册,配套论文仍在审稿。
第三句:用它做研究,优先走"几何域 + 730 MB 下载"的路径(点云/网格 → 57 点),把图像域方法留到确有需要时;务必按病例划分、按分组报指标、按 short_name 做键。
11.2 适合谁
- 做 3D 关键点回归的研究者:99 例 × 57 点的稠密地标是所有公开骨盆数据集里最全的,适合验证热图回归、模板变形、几何深度学习方法。
- 做骨科术前规划的工程团队:髋臼参数(中心、前壁、后壁、ASIS/AIIS)可直接用于 THA 规划模块的训练与评测。
- 做数据集工程的研究者:这份数据在版本管理(三版演进)、文件组织(100 上限下的双轨)、质量审计(五零 + 体积偏差)三方面都值得作为案例研究。
- 做统计形状建模的研究者:57 点的 PDM 是小样本 SSM 的良好起点,配合 STL 可做稠密对应。
11.3 不适合谁
- 需要大规模训练数据的人:99 例不足以从零训练 3D CNN,必须依赖迁移学习或强先验。
- 做骨折/病变识别的人:数据集没有骨折、肿瘤、植入物的标签,队列是否含这些病例也未说明。
- 需要官方 benchmark 的人:没有划分、没有基线、没有 leaderboard,任何"SOTA"都不可比。
- 做儿科骨盆的人:队列是成人(有身高体重记录者 143–183 cm),无儿童病例。
- 想直接用年龄做分层的人:年龄字段 0/99 全空,做不了。
11.4 30 秒决策卡
| 你的问题 | 答案 |
|---|---|
| 要做 3D 地标检测吗? | 做 → 用它,先下 730 MB 的几何包 |
| 要做骨分割吗? | 用它不如用 CTPelvic1K / TotalSegmentator(规模大得多) |
| 需要官方划分/基线吗? | 没有,需要自己建 |
| 需要商用吗? | CC BY 4.0 可以,注意署名与器械合规 |
| 只有 5 分钟吗? | 下 annotations.zip(197 KB)+ landmark_anatomical_mapping.csv(4.4 KB),看 57 点结构 |
| 要复现论文数字吗? | 引 v3.0.0 的 DOI,写明版本,勿用 v1/v2 |
11.5 双口径存照表
本条目在核对过程中发现以下六处官方描述内部或跨版本的不一致,按"官方为准 + 正文存照"处理:
| 编号 | 冲突点 | 口径 A | 口径 B | 本条目处理 |
|---|---|---|---|---|
| S1 | 示例病例数 | v1 页面文本:“three example cases (600001, 600003, 600052)” | v2/v3:“5 example cases(600001/2/3/4/052)” | 以 v3 的 5 例为准,正文注明 v1 曾有 3 例表述 |
| S2 | STL 性质 | v1/v2:stl_models.zip 2,138,905,225 B(原始网格) |
v3:667,416,174 B(重生成网格) | 以 v3 为准,说明体积偏差是对原始 STL 的比较 |
| S3 | 元数据粒度 | v3:每例 metadata.csv(一行) |
v3:队列级 patient_metadata.csv |
两者并存,以 patient_metadata.csv 为权威 |
| S4 | 年龄字段 | v1/v2 描述未提年龄 | v3:age_years 全空且不插补 |
以 v3 为准(实测 0/99 非空,吻合) |
| S5 | ICC 报告范围 | v1/v2:观察者内 >0.998、观察者间 >0.997 | v3:仅保留观察者间 >0.997 | 两者都可用,正文并列给出 |
| S6 | 坐标表述 | v1/v2:“original patient-level CT physical coordinate frame, LPS preserved” | v3:“millimetres in the patient-level LPS convention” | 语义一致,v3 措辞更精确,实测 srow 证实 |
另有两条待核项(非冲突,属信息缺口):CT 像素是否为 HU 未验证;掩膜是否为 “cleaned” 版本未说明。
FAQ(高频问答 24 问)
A. 基础认知
Q1:MedPelvis3D 一句话是什么? 99 例成人骨盆 CT,每例 57 个三维解剖地标(毫米坐标)+ 三骨段掩膜 + 297 个 STL 网格中的 3 个 + 5 万点点云,用于地标检测与骨盆几何研究。
Q2:谁做的? 北京科技大学(第一作者 Guo Na,ORCID 0000-0001-5985-5669;第二作者 Pan Jiachen,ORCID 0009-0005-5869-3166),共 9 位作者,数据采集于解放军总医院。
Q3:有论文吗? 有 Data Descriptor 在投(Guo et al., Scientific Data, under review, 2026),截至 2026-10-17 未见刊。Zenodo 描述里明确写了这一点。
Q4:为什么叫 MedPelvis3D? “Med” 指医学,“Pelvis” 指骨盆,“3D” 指三维。注意不要与 “Pelvis3D” 之类的软件工具混淆。
Q5:和 CTPelvic1K 是同一个吗? 不是。CTPelvic1K 是中科院计算所 1,184 例的四骨段分割集;MedPelvis3D 是 99 例的地标集。两者都做骨盆,规模与任务不同。
Q6:是挑战赛数据吗? 不是。没有挑战赛、没有 leaderboard、没有官方划分。这一点直接影响引用方式:引用挑战赛数据时通常会附"测试集标签不可见"的说明,而本数据集全部标签公开,任何报告的数字都只能靠自建协议保证可比,论文里必须把划分与评测脚本一并给出,否则读者无从判断"SOTA"是在多少例上算出来的。
B. 数据与获取
Q7:下载要多少流量? 全量 31.35 GB;只做地标 730 MB;按例约 150 MB/例。
Q8:从哪下? Zenodo record 21757686(v3.0.0),DOI 10.5281/zenodo.21757686。无 HuggingFace/Kaggle 镜像。
Q9:许可是什么? CC BY 4.0,可商用,需署名。
Q10:能只下标注吗? 能,annotations.zip 只有 202,240 字节(197 KB),含全部 99 例 × 57 点。
Q11:元数据在哪? 根目录 patient_metadata.csv(1,940 字节,99 行)+ 每例 zip 内的 metadata.csv;地标字典 landmark_anatomical_mapping.csv(4,498 字节)。
Q12:case_id 连续吗? 不连续。600001–600129 之间有 29 个空号,共 99 例。
Q13:为什么有 89 个 case 归档而不是 99 个? Zenodo 单条记录最多 100 个文件。11 个整包 + 79 个单例 + 10 个双例 = 100。最后 20 例被两两合并成 10 个 cases_<id>_<id>.zip。
Q14:有校验和吗? Zenodo API 的每个文件都带 md5: 校验值,可用它做下载校验;作者没有额外交付 .md5 文件。
C. 数据内容
Q15:57 个点怎么分? 左半骨盆 19 + 右半骨盆 19 + 骶骨 19 = 57;按侧别是左 26 / 右 26 / 中线 5。
Q16:所有点都标了吗? 是。5,643 行(99×57)的 defined/selected/visible 三列全为 1,无一处缺失。
Q17:掩膜有几个标签? 三个:LeftHipBone、RightHipBone、Sacrum。不含股骨、腰椎。
Q18:STL 是什么算法做的? Lewiner marching cubes,scikit-image 0.26.0;审计用 trimesh 4.12.2 与 PyMeshLab。
Q19:网格有缺陷吗? 297 个组件全部零边界边、零非流形边、零重复面、零退化面、零自交面。
Q20:体积准吗? 对原 STL:中位偏差 0.049%、P95 0.223%、最大 0.498%。
Q21:点云多少点? 50,000 点,(50000, 3) float32,从骨盆表面网格采样,单位 mm、LPS。
Q22:坐标是毫米还是像素? 毫米,LPS 右手系。NIfTI 保留 affine(RAS 形式),需转一次符号。
Q23:身高体重年龄齐吗? 性别 99/99,身高 37/99,体重 36/99,年龄 0/99(全空,官方明确不插补)。
Q24:为什么年龄全空? 官方说明:“No reliable case-level age field was available in the release sources”——发布源里没有可靠的病例级年龄字段。
事实清单(硬事实 32 条)
- 数据集全名:MedPelvis3D: a 3D pelvic anatomy dataset for anatomical landmark detection。
- 当前版本:3.0.0,发布日 2026-08-02。
- 版本 DOI:10.5281/zenodo.21757686;概念 DOI:10.5281/zenodo.20473746。
- 首次发布:1.0.0,2026-05-31,record 20473747(文件已清空,API 返回 0)。
- 中间版本:record 20520568,2026-06-03,无
version字段,11 个文件。 - 队列:99 例去标识骨盆 CT,59 男 / 40 女(实测
patient_metadata.csv吻合)。 - 机构:数据采集于解放军总医院(Chinese PLA General Hospital),发布方为北京科技大学。
- 作者 9 人:Guo N, Pan J, Zhang G, Wang J, Su X, Qi Y, Liu M, Zhang Q, Hao M。
- 许可:CC BY 4.0。
- 每例资产:NIfTI CT、NIfTI 三标签掩膜、3 个 STL、57 行 CSV、50000×3 npy、metadata.csv。
- 掩膜标签:LeftHipBone、RightHipBone、Sacrum。
- 地标数:57/例;总行数 5,643(99×57),
defined/selected/visible全 1。 - 地标分组:left_hemipelvis 19、right_hemipelvis 19、sacrum 19(region);left 26、right 26、midline 5(side)。
- 地标文件命名:
<case_id>-Table-XYZ.CSV(大写扩展名,带 UTF-8 BOM)。 - 地标 CSV 列:short_name、X、Y、Z、defined、selected、visible、locked、description、anatomical_name_en。
- 地标字典列:short_name、anatomical_name_en、anatomical_name_zh、region、side。
- 坐标系:LPS,毫米;STL/NPY/CSV 共享物理原点;NIfTI 保留 affine。
- 实测 NIfTI 头(600001):512×512×481,0.8652/0.8652/0.625 mm,int32,units=10,qform/sform=1。
- 实测 NIfTI 头(600006):512×512×521,0.7578/0.7578/0.625 mm,int32。
- 网格重建:Lewiner marching cubes,scikit-image 0.26.0。
- 网格审计:trimesh 4.12.2 + PyMeshLab,297 组件,五类缺陷全零。
- 体积偏差:中位 0.049%、P95 0.223%、最大 0.498%(对原始 STL)。
- inter-ASIS:228.5 ± 18.2 mm(实测复算一致,n=99,范围 188.6–277.6,中位 227.4)。
- 皮质地标到表面:0.04 mm;骨内地标:1.51 mm。
- 观察者内:3.44 ± 1.98 mm(95% CI 2.91–3.96),ICC(2,1) > 0.998(10 例)。
- 观察者间:4.56 ± 2.04 mm(95% CI 4.02–5.10),ICC(2,1) > 0.997(10 例)。
- 点云:
(50000, 3)float32,单例约 554 KB(压缩后),99 例合计 54,914,405 字节。 - 实测点云范围(600001):x[−148.73, 135.43]、y[−93.92, 72.08]、z[10.31, 215.66] mm。
- 文件数:100;总字节 31,351,310,903(API 求和)。
- 归档结构:11 个整包/元数据 + 79 个单例 zip + 10 个双例 zip。
- 示例:samples.zip(756,641,171 字节)含 5 例(600001/2/3/4/052)。
- 人口学:年龄 0/99、身高 37/99、体重 36/99;身高均值 164.8 ± 9.7 cm(复算),体重 68.3 ± 18.6 kg(复算)。
术语表(26 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| 解剖地标 | anatomical landmark | 解剖结构上可唯一识别、可重复定位的点 |
| 关键点回归 | keypoint regression | 由图像直接回归关键点坐标的任务 |
| 热图回归 | heatmap regression | 为每个关键点预测概率分布图,再取峰值的做法 |
| LPS 坐标系 | LPS coordinate system | DICOM 患者坐标系,+x 左、+y 后、+z 头,右手系 |
| RAS 坐标系 | RAS coordinate system | NIfTI 坐标系,+x 右、+y 前、+z 头 |
| affine 矩阵 | affine matrix | 4×4 矩阵,把体素索引映射到物理毫米坐标 |
| 体素 | voxel | 三维像素,本数据集 0.63–0.87 mm 尺度 |
| HU | Hounsfield Unit | CT 值单位,水为 0、空气约 −1000、骨皮质 1000+ |
| 掩膜 | mask | 与图像同尺寸的标签图,逐体素标注类别 |
| 标签图 | label map | 用整数编码类别的单通道图像 |
| marching cubes | marching cubes | 从体素等值面提取三角网格的经典算法 |
| Lewiner 实现 | Lewiner marching cubes | 解决歧义配置、保证拓扑一致的 marching cubes 改进版 |
| 流形 | manifold | 局部同胚于平面的曲面;网格无孔洞、无自交 |
| 水密 | watertight | 封闭无开口的网格,可判定内/外 |
| 非流形边 | non-manifold edge | 被三个及以上面共享的边,网格拓扑错误 |
| 退化面 | degenerate face | 面积近零、三点共线的三角形 |
| 自交 | self-intersection | 网格面片互相穿插 |
| 点云 | point cloud | 三维点集,本数据集 5 万点/例 |
| 泊松盘采样 | Poisson-disk sampling | 保证点间最小距离的均匀采样 |
| 观察者内一致性 | intra-operator agreement | 同一标注者重复标注的误差 |
| 观察者间一致性 | inter-operator agreement | 不同标注者之间的一致程度 |
| ICC | intraclass correlation coefficient | 组内相关系数,衡量一致性 |
| MRE | mean radial error | 平均径向误差,单位 mm |
| SDR | successful detection rate | 误差阈值内的成功检测率 |
| 髂前上棘 | ASIS | anterior superior iliac spine |
| 髋臼 | acetabulum | 髋骨上容纳股骨头的杯状窝 |
附录(附录 A–T:速查卡、DAIMS、地标全表、代码模板与引文规范)
附录 A:条目信息速查卡
| 字段 | 值 |
|---|---|
| slug | medpelvis3d |
| 官方名 | MedPelvis3D: a 3D pelvic anatomy dataset for anatomical landmark detection |
| 版本 | 3.0.0(2026-08-02) |
| Zenodo record | 21757686 |
| 版本 DOI | 10.5281/zenodo.21757686 |
| 概念 DOI | 10.5281/zenodo.20473746 |
| 许可 | CC BY 4.0 |
| 队列 | 99 例(59 男 / 40 女) |
| 每例地标 | 57 |
| 网格组件总数 | 297 |
| 点云 | 50,000 点/例 |
| 记录总字节 | 31,351,310,903 |
| 文件数 | 100 |
| 最小可下包 | annotations.zip(202,240 B) |
| 推荐入门包 | 730 MB 五件套(不含 CT) |
| 库内互链 | ctpelvic1k(465)、totalsegmentator(422)、ct-bench(1191)、brain-slab-seg-3d(972) |
| 本条目成稿日 | 2026-10-17 |
附录 B:DAIMS 评估全表
DAIMS(Dataset AI-readiness Maturity Score)是本百科对数据集 AI 就绪度的十维评分,每维 0–10 分。以下为 MedPelvis3D 的逐维打分与理由。
| 维度 | 评分 | 理由 |
|---|---|---|
| D1 可发现性(Discoverability) | 9 | Zenodo DOI、ORCID、关键词齐全,OpenAIRE 已索引;扣分因无 GitHub/HF 镜像 |
| D2 许可清晰度(Licensing) | 10 | CC BY 4.0 单一明确,无分层歧义 |
| D3 元数据完备度(Metadata) | 7 | case_id/sex 完整,age 全空、height/weight 残缺;无 DICOM 原始标签 |
| D4 数据结构化(Structure) | 9 | 六件套固定命名、三种格式,缺 schema 文件(无 JSON Schema/Frictionless 描述) |
| D5 标注质量(Annotation quality) | 9 | 5,643 点全量标注、双人一致性实验、点-表面距离审计;扣分因仅 10 例做重复标注 |
| D6 几何一致性(Geometric integrity) | 10 | 297 组件五零审计、体积偏差分位数公开、三格式同坐标系 |
| D7 可复现性(Reproducibility) | 7 | 版本 DOI、软件版本号锁定;缺代码仓库、缺划分、缺基线 |
| D8 文档质量(Documentation) | 7 | 描述详实(含审计细节);缺逐点标注手册、缺 CHANGELOG |
| D9 公平性(Fairness) | 6 | 单中心、性别比 59:40 尚可、无年龄信息导致无法评估年龄偏倚 |
| D10 易用性(Usability) | 8 | 100 文件双轨组织、730 MB 轻量路径;扣分因 Zenodo 限速与双例归档需额外处理 |
合计 82 / 100。这是一个"几何工程分很高、社区生态分偏低"的典型画像:D6 满分、D2 满分、D1/D4 接近满分;D9 与 D3 是主要短板,都源于"原始临床信息系统里就没有这些字段"这一现实约束,而非作者的疏漏。
附录 C:57 个地标全表(含 region/side)
| # | short_name | 中文 | region | side |
|---|---|---|---|---|
| 1 | ASIS_L | 髂前上棘 | left_hemipelvis | left |
| 2 | AIIS_L | 髂前下棘 | left_hemipelvis | left |
| 3 | AcetAntWall_L | 髋臼前壁 | left_hemipelvis | left |
| 4 | PubicSupRamus_L | 耻骨上支 | left_hemipelvis | left |
| 5 | PubicTubercle_L | 耻骨结节 | left_hemipelvis | left |
| 6 | PubicSymphysis_L | 耻骨联合 | left_hemipelvis | left |
| 7 | ObturatorForamen_L | 闭孔 | left_hemipelvis | left |
| 8 | PubicInfRamus_L | 耻骨下支 | left_hemipelvis | left |
| 9 | IliacTubercle_L | 髂结节 | left_hemipelvis | left |
| 10 | IliumAla_L | 髂骨翼 | left_hemipelvis | left |
| 11 | Acetabulum_L | 髋臼 | left_hemipelvis | left |
| 12 | AcetPostWall_L | 髋臼后壁 | left_hemipelvis | left |
| 13 | PSIS_L | 髂后上嵴 | left_hemipelvis | left |
| 14 | PIIS_L | 髂后下棘 | left_hemipelvis | left |
| 15 | GreaterSciaticNotch_L | 坐骨大切迹 | left_hemipelvis | left |
| 16 | IschialSpine_L | 坐骨棘 | left_hemipelvis | left |
| 17 | IschialTuberosity_L | 坐骨结节 | left_hemipelvis | left |
| 18 | IliumAuricularSurface_L | 耳状面 | left_hemipelvis | left |
| 19 | IliumArcuateLine_L | 弓状线 | left_hemipelvis | left |
| 20–38 | 同 1–19 的 _R 版本 |
同上(右) | right_hemipelvis | right |
| 39 | SacrumBase | 骶骨底 | sacrum | midline |
| 40 | SacralPromontory | (骶骨)岬 | sacrum | midline |
| 41 | SacrumAla_R | 骶骨翼(右) | sacrum | right |
| 42 | SacrumAla_L | 骶骨翼(左) | sacrum | left |
| 43 | AntSacralForamen1_R | 第1骶前孔(右) | sacrum | right |
| 44 | AntSacralForamen2_R | 第2骶前孔(右) | sacrum | right |
| 45 | AntSacralForamen3_R | 第3骶前孔(右) | sacrum | right |
| 46 | AntSacralForamen4_R | 第4骶前孔(右) | sacrum | right |
| 47 | AntSacralForamen1_L | 第1骶前孔(左) | sacrum | left |
| 48 | AntSacralForamen2_L | 第2骶前孔(左) | sacrum | left |
| 49 | AntSacralForamen3_L | 第3骶前孔(左) | sacrum | left |
| 50 | AntSacralForamen4_L | 第4骶前孔(左) | sacrum | left |
| 51 | Coccyx | 尾骨 | sacrum | midline |
| 52 | SacrumAuricularSurface_L | 耳状面(左) | sacrum | left |
| 53 | SacralCanal | 骶管 | sacrum | midline |
| 54 | MedianSacralCrest | 骶骨中间棘 | sacrum | midline |
| 55 | SacrumSupArtProcess_L | 上关节突(左) | sacrum | left |
| 56 | SacrumSupArtProcess_R | 上关节突(右) | sacrum | right |
| 57 | SacrumAuricularSurface_R | 耳状面(右) | sacrum | right |
附录 D:每例资产清单与读取代码
from pathlib import Path
import nibabel as nib, numpy as np, trimesh, pandas as pd

case = Path("600001")
ct   = nib.load(case / "600001.nii.gz")
mask = nib.load(case / "600001_mask.nii.gz")          # 文件名以实际为准
land = pd.read_csv(case / "600001-Table-XYZ.CSV", encoding="utf-8-sig")
pc   = np.load(case / "600001-points-50000.npy")
lhip = trimesh.load(case / "LeftHipBone.stl", process=False)
rhip = trimesh.load(case / "RightHipBone.stl", process=False)
sac  = trimesh.load(case / "Sacrum.stl",          process=False)

print(ct.shape, ct.header.get_zooms())                 # (512,512,481) (0.865,0.865,0.625)
print(mask.get_fdata().max())                           # 3(标签数)
print(land.shape, pc.shape)                             # (57,10) (50000,3)
print(lhip.volume, rhip.volume, sac.volume)             # mm^3
注意两点:mask.get_fdata() 对整数标签图会转成 float,若要精确比较标签请用 np.asanyarray(mask.dataobj);trimesh 的 .volume 单位是模型单位的立方,本数据集是 mm,因此得到 mm³,除以 1000 得 cm³。
附录 E:坐标换算(体素 ↔ LPS)的标准实现
import numpy as np, nibabel as nib

def vox2lps(img, ijk):
    """体素索引 (i,j,k) -> LPS 毫米"""
    M = img.affine                                  # voxel -> RAS
    ras = M @ np.array([*ijk, 1.0])
    return ras[:3] * np.array([-1.0, 1.0, 1.0])     # RAS -> LPS

def lps2vox(img, xyz):
    """LPS 毫米 -> 体素索引(浮点)"""
    ras = np.asarray(xyz, float) * np.array([-1.0, 1.0, 1.0])
    return (np.linalg.inv(img.affine) @ np.array([*ras, 1.0]))[:3]

img = nib.load("600001/600001.nii.gz")
print(nib.aff2axcodes(img.affine))                  # 期望 ('L','P','S')
print(vox2lps(img, (100, 100, 100)).round(3))
这段代码是本条目最应该被复制走的一段。所有"地标落在体素外"、"网格与图像错位"的问题,99% 源于把 PixDim 当成了方向。aff2axcodes 一定要打印一次确认。
附录 F:地标检测模型的输入输出契约
| 项 | 规格 | 说明 |
|---|---|---|
| 输入(T1) | 512×512×N int32 NIfTI | 建议重采样到 1 mm 各向同性后再裁剪到骨盆 ROI |
| 输入(T2) | (50000,3) float32 或 STL | 点云需先中心化(减去质心),并记录平移量以便还原 |
| 输出 | (57,3) float32,mm,LPS | 顺序以 landmark_anatomical_mapping.csv 行为准 |
| 损失 | 加权 L2 或 heatmap MSE | 建议按皮质/骨内分组赋权(见 §7.3) |
| 指标 | MRE(mm)、SDR@2/5/10 | 按病例 bootstrap 报 CI |
| 归一化 | 质心平移 + 尺度归一(可选) | 若做尺度归一,必须记录尺度因子以还原 mm |
附录 G:最小可复现实验脚本骨架
import json, numpy as np, pandas as pd
from pathlib import Path

ROOT = Path("annotations")
cases = sorted(p.stem.split("-")[0] for p in ROOT.glob("*.CSV"))
assert len(cases) == 99

# 1) 固定五折(本条目建议的社区协议,见 §7.6)
folds = {c: int(c) % 5 for c in cases}
json.dump({"protocol": "cid_mod_5", "folds": folds}, open("splits_v1.json", "w"), indent=1)

# 2) 读地标
def load(c):
    df = pd.read_csv(ROOT / f"{c}-Table-XYZ.CSV", encoding="utf-8-sig")
    return df[["X", "Y", "Z"]].to_numpy("float32")

# 3) 留一折:训练 79/80、测试 19/20
for k in range(5):
    tr = [c for c in cases if folds[c] != k]
    te = [c for c in cases if folds[c] == k]
    print(k, len(tr), len(te))

# 4) 基线:预测训练集平均形状(形状先验基线,MRE 用于标尺)
train_mean = np.mean([load(c) for c in tr], axis=0)        # (57,3)
err = [np.linalg.norm(load(c) - train_mean, axis=1) for c in te]
print("mean-shape baseline MRE = %.2f mm" % np.mean(np.concatenate(err)))
这段脚本的价值不在于它的模型("平均形状"是最弱的基线),而在于它给出了任何论文都该报告的第一个数字:一个完全不看输入的基线能拿到多少 MRE。如果某方法只比这个基线好一点点,那它的贡献就值得怀疑。
附录 H:标注一致性指标的复算方法
import numpy as np
# obs1, obs2: 形状均为 (10, 57, 3),10 例 x 57 点 x 3 坐标
d = np.linalg.norm(obs1 - obs2, axis=2)          # (10, 57) 每点欧氏距离
print("mean %.2f  sd %.2f" % (d.mean(), d.std(ddof=1)))
# 95% CI(按例 bootstrap)
rng = np.random.default_rng(0)
bs = [d[rng.integers(0, 10, 10)].mean() for _ in range(10000)]
print("95%% CI %.2f - %.2f" % (np.percentile(bs, 2.5), np.percentile(bs, 97.5)))
关键点:ddof=1(样本标准差而非总体)、bootstrap 按例重采样(10 例 → 重采样 10 个索引),而不是按点重采样(5,643 点)。后者会把 CI 压窄 √57 ≈ 7.5 倍,这是 §9.4 提到的统计陷阱在代码层面的体现。
附录 I:与其他骨盆数据集的字段对照
| 字段 | CTPelvic1K | TotalSegmentator | MedPelvis3D |
|---|---|---|---|
| CT 体数据 | 有(1,184 例) | 有(1,200+ 例) | 有(99 例) |
| 骨分割掩膜 | 有(4 类) | 有(117 类,含骨盆骨) | 有(3 类) |
| 表面网格 | 无(需自建) | 无(需自建) | 有(297 个 STL) |
| 点云 | 无 | 无 | 有(5 万点/例) |
| 3D 地标 | 无 | 无 | 有(57 点/例) |
| 临床元数据 | 部分 | 有限 | sex 全、年龄空 |
| 官方划分 | 有(5 折) | 无 | 无 |
| 基线 | 有(nnU-Net 0.987) | 有(论文报告) | 无 |
| 许可 | CC BY 4.0 / 部分 NC | CC BY 4.0 | CC BY 4.0 |
这张表的读法是:三者的能力维度互补而非替代。要分割精度与规模,选前两者;要几何与地标,选 MedPelvis3D;三者组合可以覆盖"分割 → 表面 → 地标 → 参数测量"的完整链路。
附录 J:常见错误与正确写法对照
| 常见写法 | 问题 | 正确写法 |
|---|---|---|
glob("*.csv") |
漏掉 .CSV 大写文件 |
glob("*.CSV") |
pd.read_csv(f) |
列名带 BOM | encoding="utf-8-sig" |
trimesh.load(f) |
默认自愈掩盖缺陷 | process=False |
x_mm = i * dx |
忽略 affine 负号 | affine @ [i,j,k,1] |
range(600001, 600130) |
29 个空号报错 | 从 metadata 读 case_id |
df.groupby("中文名") |
耳状面两组混淆 | groupby("short_name") |
引用 zenodo.20473747 |
v1 文件已清空 | 引 zenodo.21757686 |
d.mean() / d.std() |
总体标准差 | std(ddof=1) |
| 按点 bootstrap | CI 虚窄 7.5 倍 | 按病例 bootstrap |
| 镜像不 swap 标签 | 左右语义错乱 | 同步换 _L/_R 与 region/side |
附录 K:数据集维护与更新触发点
| 触发条件 | 应做的动作 | 优先级 |
|---|---|---|
| Data Descriptor 见刊 | 回填论文 DOI、卷期、页码;核对论文口径与本条目是否一致 | 高 |
| 新增官方划分 | 更新 §7.5 与 §7.6,改用官方折 | 高 |
| 新增基线结果 | 更新 §7.1 表格,加入实际数字 | 中 |
| 发布 4.0.0 版 | 重跑 §2.5 文件清单、§4 审计、§6.1 版本链 | 高 |
| 出现第三方镜像(HF/Kaggle) | 更新 §6.3 下载路径与措辞 | 中 |
| 社区反馈坐标问题 | 重验 §5.2 证据链,必要时加勘误说明 | 高 |
| 新增标注点(>57) | 全条目地标数、分组、附录 C 全表需重写 | 高 |
附录 L:引文规范
数据集引用(推荐):
Guo N, Pan J, Zhang G, Wang J, Su X, Qi Y, Liu M, Zhang Q, Hao M. MedPelvis3D: a 3D pelvic anatomy dataset for anatomical landmark detection [Data set]. Version 3.0.0. Zenodo; 2026. doi:10.5281/zenodo.21757686
数据集引用(长期指向):
Guo N, et al. MedPelvis3D [Data set]. Zenodo. doi:10.5281/zenodo.20473746 (concept DOI, all versions)
论文引用(见刊前):
Guo N, Pan J, Zhang G, Wang J, Su X, Qi Y, Liu M, Zhang Q, Hao M. MedPelvis3D: a 3D pelvic anatomy dataset for anatomical landmark detection. Scientific Data (under review, 2026).
本条目引用:
千方病案医数集. MedPelvis3D — AI-Ready Wikipedia. https://www.qianfanghub.com/ai-ready-dataset/medpelvis3d/1222 (访问日期: 2026-10-17)
§C 结构化数据(JSON-LD)
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- ctspine1k — 共享标签:医学影像 / CT / 骨骼肌肉影像 / 医学图像分割
- lidc-idri — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割
- ctpelvic1k — 共享标签:医学影像 / CT / 骨骼肌肉影像 / 医学图像分割
- deeplesion — 共享标签:医学影像 / CT / 目标检测
- fdtooth — 共享标签:医学影像 / CT / 目标检测
- ribfrac — 共享标签:医学影像 / CT / 骨骼肌肉影像 / 医学图像分割
- largeia — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割
- patchchestct — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割
- nih-pancreas-ct — 共享标签:医学影像 / CT / 医学图像分割
- abdomenct-1k — 共享标签:医学影像 / CT / 医学图像分割
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
