信息速览
INFOBOX — Brain Slab Seg 3D 一屏速览
维度 内容 本质 尸检脑组织冠状切片(脑片)解剖照片的「脑片正面」二值分割数据集 + nnU-Net 自动分割工具 团队 MGH 阿尔茨海默病研究中心(MADRC)× 华盛顿大学检验医学与病理学系,通讯级 Juan E. Iglesias / Bradley T. Hyman / C. Dirk Keene 论文 PLOS ONE(doi:10.1371/journal.pone.0355740);arXiv:2508.09805(v1 2025-08-13,v2 2025-11-04) 数据 1,573 对照片+掩码(Zenodo/NLM 口径);训练 1,414 张 = MADRC 733 + UW-fresh 681;UW-fixed 218 仅测试 子集 MADRC 733 张(22 全脑+66 左+41 右半球,固定,74±14 岁)|UW-fixed 218 张(28 全脑,固定,67±23 岁)|UW-fresh 681 张(38 单半球,新鲜,48±17 岁) 切片参数 冠状切片厚 4 mm(改良肉切片机,藻酸盐包埋稳定);图像重采样至 0.1 mm;训练降采样 0.5 mm/px 任务 二值语义分割 —— 分割脑片正面,剔除背景/片外组织/皮质表面 模型 nnU-Net 自动适配 U-Net,7 stage(32-64-128-256-512-512-512),5 折 ×1000 epochs,RTX A6000 共 58.3 小时 核心结果 median Dice >0.98、平均表面距离 <0.4 mm、HD95 <1.60 mm,逼近人工 inter-/intra-rater 水平 泛化 UW-fixed 完全不参与训练,专测站点外泛化(Dice 0.981) 指标修正 仅在参考分割 10 mm 邻域内计分,远离目标的假阳性经 GUI 后处理剔除 获取 Zenodo record 20647553 公开直链(CC BY 4.0);工具集成 FreeSurfer PhotoTools 许可 CC BY 4.0(数据);论文 PLOS ONE 开放获取 库内互链 Allen Brain Atlas、ABIDE、ADHD-200、ABCD Study、ACDC(分割方法谱系)
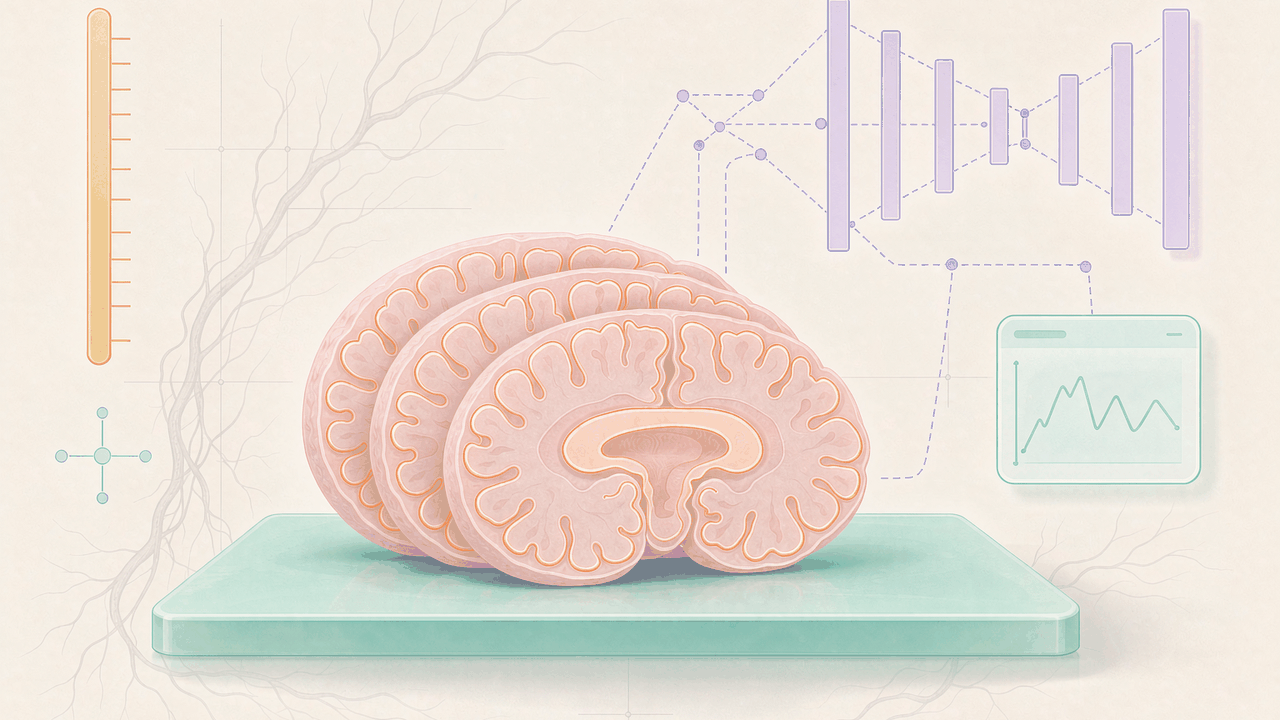
这是一篇关于「让机器替病理学家描边」的数据集条目:在脑库与神经病理实验室里,尸检脑组织会被切成一片片 4 毫米厚的冠状脑片(coronal slab),逐个拍照存档;这套照片配合图像配准与机器学习,可以做尸检脑组织的三维体积分析。但流程卡在一个环节上——每张照片里的脑片正面(slab face)都要人工描出边界,剔除背景、片外组织和皮质表面,这是个昂贵又枯燥的手工活。MGH 与华盛顿大学的团队把 1,573 对「照片+手工掩码」公开出来,训练了一个 nnU-Net 模型自动完成这一步,median Dice 超过 0.98,并把工具直接集成进 FreeSurfer 的 PhotoTools。它不引人注目,却是一个把「人工瓶颈」变成「公开工具」的典型样本。
导语读法三则:
- 只想下数据:直奔 §9 获取与许可——Zenodo 是公开直链、CC BY 4.0,无请求门槛,比多数医学数据集友好。
- 关心分割任务本身:直奔 §4 与 §5——先看清「脑片正面 versus 皮质表面」这个反直觉的标注约定,再看指标怎么被「10 mm 邻域」修正。
- 做方法学对照:直奔 §7 与 §8——nnU-Net 的泛化设计(UW-fixed 纯测试)和它在神经病理影像分割谱系里的位置。
§0 导读:这个数据集解决什么问题
0.1 一个被低估的瓶颈:尸检脑片的「描边」
现代神经病理学和脑库有一个稳定但费力的工作流:把尸检脑组织做成冠状切片、逐片拍照、再把照片堆叠重建为三维体积,从而对脑组织做定量形态分析。这套流程在图像配准和机器学习成熟之后变得可行,但它有一个前置条件——每张照片里的脑片必须先从背景中被分出来,得到一个干净的「脑片正面」掩码。这一步目前主要靠人手工描,是整个流程里最不容易扩展、最耗人力的一环。
0.2 这个数据集做了什么
团队做了一个深度学习的二值分割模型来自动完成这一步,并用一个跨站点、跨组织类型的手工标注数据集来训练与评估它:
- 训练数据:1,414 张手工分割图像(固定与新鲜组织混合,来自两个站点,诊断各异);
- 架构:基于 U-Net,由 nnU-Net 框架自动适配配置;
- 结果:在训练未见的照片上,median Dice 超过 0.98、平均表面距离低于 0.4 mm、95% Hausdorff 距离低于 1.60 mm,逼近人工标注者之间的 inter-/intra-rater 水平;
- 落地:工具公开集成于 FreeSurfer 的 PhotoTools。
0.3 为什么它值得进本站词条
它有三重价值:其一,填补库内空白——本站已有大量脑影像与分割条目,但「尸检脑片照片二值分割」这一神经病理细分方向此前缺失;其二,方法学范式清晰——任务定义、标注约定、指标修正、泛化设计四件套都写得克制而明确;其三,可获取性极优——数据 CC BY 4.0 公开直链,工具开源,是「高可复现、低门槛」的样本。
0.4 一条绕不开的标注约定
初学者最容易误判的一点:这里的「分割」不是把脑组织从图像里全部分出来,而是要排除皮质表面(cortical surface)。因为皮质表面不在脑片正面所在的平面内,对下游体积分析无意义。这个约定贯穿整个数据集——不理解它,就会觉得掩码「缺了一块」。
0.5 尸检脑组织为什么值得做成 3D
要理解这个数据集,先要理解它服务的科学问题。活体神经影像(MRI、CT)能看到脑的结构,但它无法提供细胞与分子层面的组织学信息。尸检脑组织则相反:它保留完整的组织形态,可以切片、染色、做转录组,是研究阿尔茨海默病、路易体痴呆、帕金森病等神经退行性疾病的「金标准」材料。脑库每年累积大量尸检脑,切成冠状脑片后逐片拍照存档。
问题在于,这些照片长期只是「档案」——要用于定量分析,必须把二维照片重建为三维体积。一旦重建成功,就能测量脑区体积、追踪萎缩模式、把组织学与生前 MRI 对齐(registration)。近年在图像配准与机器学习上的进展,让「从常规照片做体积分析」变成现实。而这条链路上第一个、也是最耗人的关卡,就是脑片正面分割。
0.6 「脑片正面」到底是什么
想象把一块脑组织切成 4 毫米厚的薄片,然后从正上方拍一张照片。照片里能看到这一片的切面(也就是「脑片正面」,slab face),周围的台面、标尺、以及因为组织变形而露出的部分皮质,都不属于脑片正面。对一个要重建体积的人来说,他关心的是这一片的切面面积——因为把逐片切面面积乘上厚度,才能估算体积。台面和露出的皮质必须被剔除,否则体积会被高估。
这就是任务的物理意义:输出等于「这一片切面上的组织面」,而非「照片里所有的脑组织」。理解了这一层,就能明白为什么皮质表面必须被剔除、为什么非目标脑片的假阳性可以不计、为什么指标要做 10 mm 邻域修正——它们全都服务于「准确测量切面面积」这个下游目标。
0.7 数据集的三个「反直觉」点
本数据集有三处设计会让初次接触者感到意外,提前点明:
- 训练集不是全集:UW-fixed 的 218 张照片被刻意排除在训练之外,只作测试,用于验证泛化。因此「数据集有多少」与「模型训练用了多少」不是同一个数。
- 掩码会主动「删掉」脑组织:皮质表面被剔除,掩码不是「所有脑组织」,而是「脑片正面」。
- Dice 不是全域计算的:只在参考分割 10 mm 邻域内计分,远场假阳性不计入精度——这与多数分割论文的口径不同。
0.8 本词条的阅读地图
- §2 数据构成:三个子集、两种组织、两个站点的交叉结构,附文件体积;
- §3 采集与标注:从尸检取材到 GIMP 描边的完整流水线,含那条约定的来龙去脉;
- §4 模型与规模:nnU-Net 配置的硬数字,以及三个数据规模口径为何不相等;
- §5 任务与评估:三项指标、10 mm 邻域修正、人工变异上界;
- §6 机构与人物:两端 PI 与 18 位作者,附作者误读提醒;
- §6.5 坑点清单:10 条使用前必读的陷阱;
- §7 DAIMS:八个维度的数据质量评估;
- §8 生态与影响:在神经病理影像谱系中的位置与可迁移经验;
- §9 获取与许可:CC BY 4.0 公开直链的进门方式;
- §10 互链与疑点:本站可互链条目与遗留待核事项。
0.9 术语小词典(初读者先扫一眼)
- 脑片(slab):把脑组织切成的一片较厚的组织块(本数据集为 4 mm 厚),是切片拍照的单位。
- 冠状切片(coronal section):沿大脑冠状面(类似「切面包」方向)切出的切片。冠状脑片是最常用于神经病理检查的切片方向之一。
- 脑片正面(slab face):脑片朝向相机的那一面切面,是分割任务要分出的前景。
- 皮质表面(cortical surface):大脑皮层的外表面,因组织变形可能在照片里露出,但它在脑片正面平面之外,须剔除。
- 片外组织(out-of-slice tissue):不属于当前脑片切面的组织,须剔除。
- nnU-Net:一个自动配置 U-Net 的医学分割框架(“no-new-Net”),2021 年发表于 Nature Methods。
- Dice:分割重叠度指标,取值 [0,1],越高越好。
- HD95:95% Hausdorff 距离,衡量两个分割表面最严重偏差的 95 分位,单位 mm。
- inter-/intra-rater variability:不同标注者之间 / 同一标注者先后两次的标注差异,是「人工水平」的性能上界。
- FreeSurfer PhotoTools:FreeSurfer 套件中面向尸检脑片照片处理的工具分支。
- fiducial marker:放在照片中、已知尺寸或位置的标记物,用于像素尺寸标定与透视校正。
- CC BY 4.0:知识共享署名 4.0 许可,允许自由使用、修改、分发、商业使用,仅需署名。
0.10 一句话给三类读者
- 给数据工程师:这是一个 CC BY 4.0、公开直链、任务明确的二值分割数据集,加载简单、配方完整,适合做 pipeline 验证。
- 给神经病理/脑库人:这是把你手上「拍了但没量化」的脑片照片接上 FreeSurfer 的工具,能省掉人工描边。
- 给方法学研究者:这是「跨站点纯测试 + 指标场景对齐 + 人工变异上界」三件套的干净范例,值得作为评估设计的参考。
§1 数据集速览:十问十答
Q1:它到底是什么?
一个公开数据集 + 一个自动分割工具:数据集是「脑片解剖照片 + 手工分割掩码」的配对集合,工具是基于 nnU-Net 的脑片正面自动分割模型,集成于 FreeSurfer PhotoTools。它不是一个新的成像模态、不是挑战赛,也不是诊断数据集,而是一个服务于「尸检脑组织 3D 体积分析」前置流程的工具型数据集。
Q2:官方名字叫什么?
数据集官方名是 Brain slab dissection photograph segmentation dataset(Zenodo 与 NLM Dataset Catalog 同名)。论文名有两份口径:arXiv 预印本为「Automated Segmentation of Coronal Brain Tissue Slabs for 3D Neuropathology」,PLOS ONE 正式刊名为「A public generalizable AI tool for automated segmentation of coronal brain tissue slabs for 3D neuropathology」。本站 slug 为 brain-slab-seg-3d(检索用,非官方名)。名字里的关键词是「dissection photograph(解剖照片)」与「slab(脑片)」——提醒这是摄影图像而非断层扫描。
Q3:有多少数据?
以 Zenodo/NLM 官方口径,数据集含 1,573 对照片与手工掩码。建模训练用 1,414 张手工分割图像(733 MADRC + 681 UW-fresh)。三分源照片求和为 1,632 张(另含仅用于测试的 UW-fixed 218 张)。三个口径并存,见 §4 与 §9。这是全篇最容易被误用的数字,务必读 §4.5 的三口径说明。
Q4:数据来自哪里?
两个站点:MGH 的阿尔茨海默病研究中心(MADRC)与华盛顿大学检验医学与病理学系。MADRC 提供固定组织(733 张),UW 提供固定(218 张)与新鲜(681 张)两种组织。
Q5:是什么任务?
二值语义分割——从照片中分割出脑片正面(slab face),排除背景、片外组织与皮质表面。类别只有两个值(前景/背景),没有多类标注。
Q6:模型是什么?
nnU-Net 框架自动配置的 U-Net,7 个 stage,特征通道 32-64-128-256-512-512-512,5 折交叉验证,每折 1000 epochs,NVIDIA RTX A6000 训练总计 58.3 小时。训练分辨率降采样至 0.5 mm/pixel。
Q7:效果好到什么程度?
median Dice > 0.98、平均表面距离 < 0.4 mm、HD95 < 1.60 mm,论文称「逼近 inter-/intra-rater 水平」。分源精确值(分布内 0.985/0.34/1.27,分布外 0.981/0.37/1.60)见 §5.4,注意口径修正。
Q8:怎么获取?
Zenodo record 20647553 公开直链下载(images.zip 753.3 MB + labels.zip 4.7 MB);工具在 FreeSurfer PhotoTools 页面公开。论文在 arXiv 与 PLOS ONE 均可开放获取。无请求门槛、无需注册,这是它相比多数医学数据集最突出的优势。
Q9:什么许可?
数据与论文均为 CC BY 4.0(Creative Commons Attribution 4.0 International)——允许自由使用、修改、分发、商业使用,仅需署名。
Q10:它能做什么、不能做什么?
能做:自动为尸检脑片照片生成脑片正面掩码,加速 3D 体积分析的前置流程;跨站点、跨组织类型泛化。不能做:不做多类解剖分割、不做病灶/肿瘤分割、不提供逐像素疾病标签、不做诊断。它是一个预处理工具,不是诊断模型。
1.1 一张表看懂它
| 维度 | 一句话 |
|---|---|
| 模态 | 尸检脑组织脑片的普通照片(非 CT/MRI) |
| 对象 | 人(尸检供体) |
| 任务 | 脑片正面二值分割 |
| 规模 | 1,573 对(成品)/ 1,414 张(训练) |
| 站点 | MGH-MADRC + UW |
| 模型 | nnU-Net(U-Net) |
| 结果 | Dice > 0.98 |
| 许可 | CC BY 4.0 |
| 门槛 | 无(公开直链) |
| 定位 | 工具型 / 预处理型数据集 |
1.2 补充三问
Q11:它和「脑图谱」(如 Allen Brain Atlas)有什么区别?
区别在任务与对象。脑图谱把脑划分为区域并给出参照系,用于定位;本数据集只做「脑片正面 vs 背景」的前景分割,服务于体积估算。一个是「参照系」,一个是「预处理」。二者可互补(先分割出脑片正面,再配准到图谱),但任务不同。
Q12:它是挑战赛(challenge)吗?
不是。它没有排行榜、没有提交机制、没有固定评测服务器。它就是一个公开数据集 + 开源工具,供任何人自由使用和复现。相比挑战赛,它更像「基础设施」。
Q13:数据里有没有患者隐私风险?
论文与数据集页面披露了合规的伦理审查与去标识化流程(MGH 经 IRB 审批与近亲知情同意;UW 使用去标识化标本)。且数据本身是脑组织切面照片,不含可识别个人的面部或身份信息。CC BY 4.0 的公开直链发布,也侧面印证了发布方评估过其隐私合规性。
Q14:我如果只用它的模型、不下数据,可以吗?
可以。模型集成在 FreeSurfer PhotoTools 中,你可以直接在 FreeSurfer 工作流里使用自动分割,而不必下载训练数据。数据与工具是解耦发布的两项资产。
Q15:这份数据「过时」吗?
数据集本身是静态存档,不会过时。但方法学有演进空间:nnU-Net 之后出现了更新的分割框架,未来若有团队在此基础上用更强的架构重训,可能进一步提升。不过就「脑片正面分割」这个任务而言,现有精度已逼近人工上界,提升空间有限。
§2 数据构成与规格
2.1 三个子集,两种组织,两个站点
这个数据集的骨架,是「两个站点 × 两种组织处理方式」的交叉。团队把它组织成三个子集:
| 子集 | 照片数 | 样本构成 | 平均死亡年龄 | 组织类型 | 站点 |
|---|---|---|---|---|---|
| MADRC | 733 | 22 全脑 + 66 左半球 + 41 右半球 | 74 ± 14 岁 | 固定(10% 中性福尔马林) | MGH |
| UW-fixed | 218 | 28 全脑(17 男 / 11 女) | 67 ± 23 岁 | 固定(10% 中性缓冲福尔马林) | UW |
| UW-fresh | 681 | 38 单半球(19 男 / 19 女) | 48 ± 17 岁 | 新鲜组织 | UW |
表格里的每一列都承载信息。照片数决定数据体量;样本构成(全脑、左/右半球、单半球)反映取材方式;平均死亡年龄 ± 标准差刻画队列;组织类型决定形变特性;站点决定采集设备与流程差异。五列交叉起来,就构成了数据集「跨站点、跨组织、跨年龄」的异构底色。
三个子集照片求和为 733 + 218 + 681 = 1,632 张。但真正进入训练的只有 MADRC 的 733 张与 UW-fresh 的 681 张,合计 1,414 张;UW-fixed 的 218 张被完全留作测试,用于检验模型对未见站点的泛化。这也是理解本数据集全部数字的第一把钥匙——1,414 是训练口径,1,632 是三分源照片口径,1,573 是数据集成品口径,三者刻意不重合。
2.1.1 为什么是「全脑 vs 半球 vs 单半球」
取材单位的差异不是随意的,它反映了不同脑库的常规做法:
- 全脑(whole brain):整脑固定后切成冠状片,能保留最完整的解剖结构与左右对称性,是神经病理的经典取材单位。MADRC(22 例)与 UW-fixed(28 例)都用全脑。
- 半球(hemisphere):只取一侧大脑半球做切片。MADRC 的 66 左半球 + 41 右半球即属此类,可能是出于左右半球分工(一侧做组织学、一侧做分子分析)的常规安排。左右数量不等(66 vs 41)说明并非每例都成对取材。
- 单半球(single hemisphere):UW-fresh 的 38 例均为单半球,之所以是单侧,很可能与新鲜组织的用途有关——新鲜半球的另一半可以保留做 RNA 测序等分子分析,而不是全部用于切片拍照。
这一层理解帮助使用者判断:不同子集在解剖完整性上并不等价,跨子集比较体积类下游结果时需谨慎。
2.1.2 队列性别与年龄的分布特征
三个子集披露的性别与年龄信息:
| 子集 | 性别构成 | 平均死亡年龄 |
|---|---|---|
| MADRC | 未逐一披露 | 74 ± 14 岁 |
| UW-fixed | 17 男 / 11 女 | 67 ± 23 岁 |
| UW-fresh | 19 男 / 19 女 | 48 ± 17 岁 |
两处值得注意:
- UW-fresh 性别完全平衡(19 男 / 19 女),这在神经退行性疾病队列里并不常见——它其实反映的是新鲜组织采集的选样特征(可能更偏向「适合做分子分析」的样本,而非疾病患病率本身)。
- 标准差偏大:67 ± 23 岁意味着 UW-fixed 的死亡年龄跨度极大(可能从年轻到高龄都有);这说明该队列不仅含神经退行性疾病患者,也含其他诊断的供体。
2.2 为什么是「两种组织」
固定组织(formalin-fixed)与新鲜组织(fresh)在照片里长得不一样。固定组织经福尔马林处理,形态稳定、蛋白质与遗传物质不同程度受损;新鲜组织则保留了 RNA 测序与转录组学等下游分析所需的材料,但非线性形变明显更强——切片时更容易塌陷、翘曲、变形。
这个差异对分割任务直接影响:新鲜组织的脑片正面边界更难稳定重建。团队把两种组织都纳入,正是为了让模型在「好切的组织」和「难切的组织」上都能工作。UW-fresh 子集平均死亡年龄只有 48 ± 17 岁,与 MADRC/UW-fixed 的老龄队列(74 ± 14 岁、67 ± 23 岁)形成鲜明对照——新鲜组织采集面向的往往是可以做转录组等分析、年龄相对较轻的供体。
2.3 切片与成像的物理规格
- 切片厚度:UW 两个站点使用一台改良的肉切片机(meat slicer)制作冠状切片,切出一致的 4 mm 厚脑片;
- 包埋稳定:切片前把标本包埋在**牙科藻酸盐(dental alginate)**里,以稳定组织、减少切割过程中的形变;
- 标定参照:不同子集用不同的标定物——
- MADRC 与 UW-fixed:照片中放一把(或两把正交的)标尺,人工点选两点、输入物理距离,估计各向同性缩放因子;
- UW-fresh:在已知尺寸矩形的四角放四个 fiduciary markers,用 SIFT + RANSAC 自动检测,估计单应矩阵做透视校正。
- 重采样:所有图像统一重采样到目标分辨率 0.1 mm,以消除不同站点、分辨率、变焦带来的像素物理尺寸差异。
2.4 文件体积与格式(Zenodo 成品)
Zenodo record 20647553 上,成品数据集由两个压缩包组成,总 758.0 MB:
| 文件 | 体积 | md5 |
|---|---|---|
| images.zip(照片) | 753.3 MB | 30cbb334e52e592a33af834eb7d480af |
| labels.zip(掩码) | 4.7 MB | b1c7a421a6c58e2ef048de2dc8a60a3d |
照片体积远大于掩码(约 160:1),符合二值掩码的存储特性——掩码是接近黑白的单通道二值图,压缩后极小。
2.5 与「脑影像分割」的边界:它不是病灶分割
必须划清的一条边界:本数据集的分割掩码只有两类值——脑片正面(前景)与其余(背景,含片外组织与皮质表面)。它不标注肿瘤、不标注病灶、不标注脑区、不标注任何疾病类别。因此它是一个预处理工具型数据集,而不是诊断或病灶分割数据集。把它误当作脑肿瘤分割数据(如 BraTS)使用,会完全错配。
2.6 供体队列画像:老龄化 + 神经退行性疾病主导
三个子集的供体构成不只体现在年龄上,更体现在疾病谱上:
- MADRC 队列:论文描述其「主要包含诊断为神经退行性疾病的个体」,平均死亡年龄 74 ± 14 岁。MADRC 作为阿尔茨海默病研究中心,队列天然偏向 AD 及相关痴呆。
- UW-fixed 队列:许多供体患有神经退行性疾病,如阿尔茨海默病、路易体痴呆(Lewy body dementia, LBD)或帕金森病(Parkinson’s disease, PD),平均死亡年龄 67 ± 23 岁。
- UW-fresh 队列:平均死亡年龄 48 ± 17 岁,明显更年轻。论文指出新鲜组织允许做固定组织做不到的分析(如 RNA 测序与转录组学),因为这些分析依赖未被福尔马林破坏的蛋白质与遗传物质。
这一疾病谱意味着:数据集反映的是神经退行性疾病人群的脑形态,而非一般人群。用它对一般人群做脑体积推断会产生偏倚。但就本任务(脑片正面分割)而言,疾病谱的影响有限——因为分割目标与疾病标签无关,模型学的是「切面 vs 背景」的边界,而非病理特征。
2.7 三个子集的角色分工
| 子集 | 角色 | 是否训练 | 是否测试 |
|---|---|---|---|
| MADRC(733) | 固定组织主力,主力训练数据 | 是 | 是(分布内) |
| UW-fresh(681) | 新鲜组织主力,训练数据 | 是 | 是(分布内) |
| UW-fixed(218) | 站点外泛化验证 | 否 | 是(分布外) |
这个分工是数据集设计的关键:它在采集阶段就预留了一个完全独立的测试集(UW-fixed),而非事后随机切分。这种「纯测试站点」的设计,让泛化评估比随机划分更有说服力——因为测试数据来自不同站点、不同采集流程,是真正的 distribution shift。
2.8 数据集的「不可比」清单
为避免误用,明确列出本数据集不能与其他数据直接横比的地方:
- 不能与活体脑 MRI 数据集比体积:本数据集的「切面面积 × 4 mm」口径与 MRI 的体素体积口径不同,跨模态比体积无意义;
- 不能与病灶分割数据集比 Dice:任务性质不同(几何边界 vs 病理区域),且本数据集有 10 mm 邻域修正;
- 不能在子集之间直接比样本数推断人群构成:照片数与供体数不是一回事(MADRC 733 张来自 22 全脑 + 107 半球,UW-fresh 681 张来自 38 单半球),不能以照片数当作队列规模;
- 不能把 1,573 当作训练规模:训练规模是 1,414,差值是成品化处理与纯测试子集的合计。
把这张清单放在心上,就能避开本数据集使用时最常见的四类错误。
§3 采集与标注流水线
3.1 从尸检到照片:采集端
流程大致是:脑组织取材 → 藻酸盐包埋 → 肉切片机切 4 mm 冠状片 → 逐片拍照(带标尺或 fiduciary markers)→ 重采样到 0.1 mm。两个站点各自独立执行,MADRC 与 UW 的采集设备、标定方式、组织处理略有差异——这些差异恰好构成了数据集「跨站点泛化」的压力来源。
伦理层面,MGH 侧由 Partners Human Research Committee 伦理审查(protocol 1999P009556),所有尸检标本经近亲知情同意;UW 侧处理的是去标识化的死者信息与标本,同意来自生前本人或法定代表。这些声明说明数据集的取材合规,也是「供体脑从何而来」这一问题的答案。
3.2 标注端:4 名标注者与 GIMP
标注工具是开源的图像编辑软件 GIMP v2.8。标注方法是阈值法 + 人工描边的两段式:
- 阈值法:先自动捕获大部分清晰的边界(背景与组织的对比通常足够);
- 人工描边:在阈值失效的地方精修轮廓,尤其是皮质表面——论文反复强调,厚切片暴露出的皮质表面用简单阈值分不开,必须手工描摹。
每张照片由 4 名标注者之一(JWR、LDB、RH、EGP,即 Williams Ramirez、Deden-Binder、Herisse、Garcia Pallares)标注一次。这种「单次标注」意味着数据集本身不以「多标注者共识」为 ground truth,而是以**人工标注者之间的变异(inter-/intra-rater variability)**作为模型精度的参照上界。
3.3 标注约定:为什么皮质表面要被剔除
这是全文最容易踩坑的地方,值得单列。脑片正面的定义是切片所在平面内的组织面。而皮质表面(cortical surface)位于这个平面之外,不属于脑片正面,annotators removed all tissue outside the slab surface, including the cortical surface——标注者把所有落在脑片表面之外的组织都剔除掉。
原因在于下游分析:FreeSurfer PhotoTools 需要的是「脑片正面」这块可用面积,来做体积重建。把片外的皮质表面也标进来,会给体积估计引入噪声。因此正确使用这份掩码的前提,是先接受这个「反直觉的减法」。
3.4 从人工到自动:工具的落点
标注好之后,团队训练模型来自动化这一步,并把结果集成回 FreeSurfer 的 PhotoTools——用户在 GUI 里可以手动挑选连通分量,把远离目标脑片的假阳性一键剔除。这个「自动预测 + 人工后处理 GUI」的组合,回应了 §7 里指标修正的设计:模型允许在远处犯错,因为那些错可以在后处理里被轻易抹掉。
3.5 标注成本账:从「小时级」到「分钟级」
论文的一个核心卖点,是自动分割对人工标注时间的节省。虽然论文没有给出精确的分钟数字,但逻辑是明确的:人工描边一张脑片正面——尤其是厚切片暴露大块皮质、阈值失效需要逐点描摹的情况——是耗时操作。而自动预测几乎是瞬时的,即使需要人工修正,也只需在模型输出上做局部调整,而非从零描起。
这构成了本数据集的经济意义:脑库的脑片照片是已经存在的存量资产,唯一制约其定量利用的是标注成本。把标注自动化,等于把存量照片的科研价值释放出来。这也是为什么这项工作把「工具」与「数据」一起发布——单发数据只能让别人重新训练,单发工具没有训练数据也难复现。
3.6 标注质量的控制:以人工变异为参照
团队没有引入「多标注者投票」这类共识机制,而是走了另一条路:测量人工标注者自身的变异。他们同时估计了:
- inter-rater variability(标注者间变异):不同标注者对同一张照片的分割差异;
- intra-rater variability(标注者内变异):同一标注者先后两次分割同一张照片的差异。
这两项构成了「人工水平」的噪声地板。模型的精度(Dice > 0.98)被放在这条地板上来评估——如果模型误差与人工变异同量级,就说明模型已经达到「人类可达到的精度上限」。这种评估哲学承认了一个事实:这类任务不存在绝对正确的单一答案,任何 ground truth 都带着标注者的主观边界判断。它比「模型 vs 单一 gold standard」的评估更诚实,也更贴近真实使用场景。
3.7 论文披露的伦理与合规
数据集的取材合规是可用性的前提。论文披露:
- MGH 侧:人体组织取材遵循机构与国家伦理准则,由 Partners Human Research Committee 伦理审查委员会审查批准(protocol 1999P009556);所有尸检标本经近亲(next of kin)知情同意。
- UW 侧:组织处理与采集涉及去标识化死者信息与标本,来自生物样本库;同意获取自本人生前或法定代表;采购与存储实践遵循美国《Revised Uniform Anatomical Gift ACT 2006》与华盛顿州法规 Chapter 68.64 RCW;UW 医学院合规办公室全程参与同意书与 HIPAA 合规工作。
这些声明虽不直接影响分割任务的技术使用,但对数据集的合规复用至关重要——尤其是当使用者计划做临床转化或发表时,伦理来源的透明性是必要条件。
3.8 完整流程一图流(文字版)
把 §3 全章压缩成一条流程链:
尸检取材 → 藻酸盐包埋稳定 → 改良肉切片机切 4 mm 冠状片
   → 逐片拍照(MADRC/UW-fixed 用标尺;UW-fresh 用 4 个 fiducial)
   → 重采样至 0.1 mm(标定像素物理尺寸)
   → GIMP v2.8 手工标注(阈值 + 描边,剔除皮质表面)
   → 得到「照片 + 掩码」配对
   → nnU-Net 训练(降采样 0.5 mm/px,5 折 ×1000 epochs)
   → 集成入 FreeSurfer PhotoTools(GUI 后处理剔除假阳性)
   → 供下游 3D 体积分析使用
这条链上,人工只出现在「标注」一环,且正被自动分割替代。整条链的设计目标是:让脑库里已经存在的照片资产,能够被低摩擦地批量转化为可定量的三维体积数据。
3.9 一个被低估的工程点:像素物理尺寸标定
在整条流程里,最容易被忽略、却最关键的一步是像素物理尺寸标定(pixel size calibration)。脑片照片的像素没有内在的物理尺度——不同相机、不同高度、不同变焦都能拍出「看起来一样大」的照片,但对应的大脑实际尺寸可能相差数倍。如果标定错误,下游所有体积测量都会系统性偏移。
团队的做法因站点而异:
- MADRC / UW-fixed:照片里放标尺,人工点选标尺上两点并输入物理距离,估计各向同性缩放因子;
- UW-fresh:在已知尺寸矩形的四角放四个 fiduciary markers,用 SIFT 特征匹配 + RANSAC 鲁棒估计单应矩阵(homography),一次性完成像素尺寸与透视校正。
这解释了为什么论文强调「标定像素尺寸对跨站点泛化至关重要」——统一到 0.1 mm 后,来自不同站点的照片才具备可比的物理尺度,模型学到的边界才是「真实的解剖边界」,而非「某个相机下的像素边界」。
3.10 从 4 mm 切片到 3D 体积:厚度去哪了
一个自然的疑问:分割掩码是二维的,3D 体积从哪来?答案是切片厚度(4 mm)。脑片的物理厚度是已知常数(改良肉切片机切出一致的 4 mm 片),因此逐片的切面面积 × 4 mm 即可估算该片的体积贡献,逐片累加得到整体体积。
这也再次说明为什么「切面面积」必须准确测得:面积误差会直接线性放大到体积误差。皮质表面被剔除、片外组织被剔除、非目标脑片假阳性被剔除——所有这些操作,本质上都是为了不让「不属于这一片切面的东西」污染面积测量。分割的精度,就是体积测量的精度。
3.11 标注者的工作条件
论文披露标注由 4 名标注者(JWR、LDB、RH、EGP)完成,其中 JWR(Jonathan Williams Ramirez)是 arXiv 第一作者,也在 Zenodo 上标注为联系人。这表明标注工作由论文作者团队内部完成,而非外包给众包平台——这对质量控制有正面意义:标注者了解任务的下游目的(体积分析),因此更可能严格执行「剔除皮质表面」这类约定。
标注工具选择 GIMP v2.8(开源、免费、成熟)而非自研专用工具,也有实用考量:标注者无需学习新软件,边界描摹的精度直接由成熟图像编辑功能保证。代价是标注流程的自动化程度低,但这在只有千级样本的场景下并非瓶颈。
3.12 一张脑片照片里到底有什么
为了彻底讲清楚「分割什么、不分割什么」,把一张典型的脑片解剖照片拆解成若干区域:
| 区域 | 是否属于脑片正面(前景) | 说明 |
|---|---|---|
| 脑片切面组织 | ✅ 是 | 任务要分出来的目标 |
| 图像背景(台面、桌面) | ❌ 否 | 剔除 |
| 片外组织(slice 之外) | ❌ 否 | 剔除 |
| 皮质表面(cortical surface) | ❌ 否 | 刻意剔除,因它在切面平面之外 |
| 标尺 / fiduciary markers | ❌ 否 | 标定物,剔除 |
| 非目标脑片 | ❌ 否 | 若照片中出现其他脑片,属假阳性来源 |
这张表解释了为什么本任务不能简单理解为「分出所有脑组织」——前景的定义被严格限制为「这一片切面平面内的组织面」,一切「虽然看起来是脑组织、但不属于该切面」的东西都要剔除。理解了这张表,就理解了数据集的全部标注逻辑。
3.13 为什么用「二值」而非「多类」
有读者会问:既然都标注了,为什么不顺便标注脑区、白质灰质、病灶?答案是任务边界——本数据集的全部意义是服务「体积分析的前置分割」,它只需要回答「这一片切面在哪里」。多类标注会大幅提高标注成本,却对下游体积估算没有直接增益。
这也是一种克制的工程判断:只标注任务需要的,不标注「顺便能标的」。多类标注留给未来的专门数据集(如脑区图谱、病灶分割),而本数据集专注把一件事做干净。这种边界清晰的定位,反而让它在可复现性和实用性上占优。
3.14 使用者在载入数据时会遇到什么
虽然数据集本身极简(两个 zip 包),但初次使用者可能会遇到几个实际小问题,提前说明:
- 文件名与子集归属:若需要按 MADRC/UW-fixed/UW-fresh 分组分析,可能需要根据文件名前缀或论文描述自行建立映射(公开摘要未给出完整逐文件清单)。
- 掩码像素值约定:二值掩码通常约定前景=255/1、背景=0。使用前建议先读一张掩码确认约定,避免把前景背景弄反。
- 分辨率对齐:照片已重采样到 0.1 mm,但若与自有数据(如 MRI)配准,需注意两者的物理尺度是否一致。
- 图像格式:照片为常见格式,labels.zip 仅 4.7 MB 说明掩码多为高效压缩的二值图,读取时注意保持二值语义。
这些都不是「数据缺陷」,而是任何数据集落地时都会遇到的对齐工作。数据集本身把「物理尺度」这个最麻烦的变量已经统一(0.1 mm),已经省掉了最大的坑。
§4 模型架构与规模硬数字
4.1 nnU-Net:一个「不用手调」的选择
团队没有手工设计网络,而是用了 nnU-Net 框架。nnU-Net 的核心思想是「给定分割任务,自动配置一个适配的 U-Net」——它结合启发式配置与内部验证,自动决定预处理、patch 大小、网络深度、训练策略等超参数。论文明确说明:最终 U-Net 架构由 nnU-Net 框架自动配置,团队只负责提供数据。
这道选择本身就是一种方法学表态:在数据量并非天文数字、任务又相对明确的场景下,与其手调架构,不如把「配置」也自动化,让方法尽可能可复制。
nnU-Net 是什么:它由德国弗莱堡大学团队提出,全称 “no-new-Net”,2021 年发表于 Nature Methods。其核心理念是「不给新网络,给自动配置」——它内置一套经验规则,会根据数据集指纹(图像尺寸、体素间距、类别数等)自动推导出一整套训练配置。它在多项医学分割挑战赛上是强基线,因此常被视为「默认应该先试」的方法。本工作采用它,等于把方法学基准线锚定在一个社区公认的强基线上。
4.2 网络结构的硬数字
| 项目 | 数值 |
|---|---|
| 框架 | nnU-Net(自动适配 U-Net) |
| stage 数 | 7 |
| 特征通道 | 32 / 64 / 128 / 256 / 512 / 512 / 512 |
| 交叉验证 | 5 折(每折内部再划分 train/val 防过拟合) |
| 每折 epochs | 1,000 |
| 训练硬件 | NVIDIA RTX A6000 |
| 训练总时长 | 58.3 小时 |
| 训练图像分辨率 | 降采样至 0.5 mm/pixel |
| 训练平均图像尺寸 | 约 440 × 673 px |
一个值得注意的工程细节是训练分辨率的取舍:原始照片被重采样到 0.1 mm,但训练时又降采样到 0.5 mm/pixel。论文的理由是「在保留解剖细节与优化推理速度之间取得平衡」。这提醒使用者:数据集的原始 0.1 mm 分辨率与模型的实际输入分辨率不是一回事。
4.3 训练集构成与泛化设计
训练数据为 733(MADRC)+ 681(UW-fresh)= 1,414 张手工分割图像。关键设计是:UW-fixed 的 218 张完全不参与训练,只作测试集(out-of-distribution)——这样模型的报告精度就同时包含「分布内表现」和「站点外泛化表现」两个维度。
4.4 合成数据增强
除真实照片外,团队还生成了 2,000 张合成图像:由 MRI 扫描生成、带随机对比度与对应掩码,用于提升泛化。这类「用 MRI 合成照片域图像」的做法,是应对真实标注稀缺的一种务实增强策略——但也要注意它引入的域差异,属方法细节而非数据本体。
4.5 数据规模的三个口径(必须并列陈述)
| 口径 | 数值 | 来源 | 含义 |
|---|---|---|---|
| 数据集成品口径 | 1,573 对 | Zenodo / NLM Dataset Catalog | 数据集对外发布的照片+掩码对数 |
| 训练口径 | 1,414 张 | PLOS/arXiv 正文 | 进入模型训练的手工分割图像数 |
| 三分源照片求和 | 1,632 张 | 733 + 218 + 681 | 三个子集照片数之和(含仅测试的 UW-fixed) |
为什么三者不相等? 1,632 是三个子集照片清单的直接求和;其中 218 张 UW-fixed 不进训练,因此训练口径是 1,414;而成品数据集在 Zenodo 上标注为 1,573 对——与照片清单存在差额,可能源于去重、掩码配对筛选或子集划分的成品化处理。本条目不做未经证实的归一化,三个口径并列呈现,引用时请注明所采口径。
4.6 nnU-Net 为何适合这个任务
团队选择 nnU-Net 并非偶然。这个任务有三个特征,恰好落在 nnU-Net 的适用区间:
- 数据量中等(千级图像):不足以训练大型预训练模型,但足以训练一个中等规模的 U-Net;
- 任务定义明确(二值分割):不需要复杂的多类损失设计,标准分割流程即可;
- 多站点异构:nnU-Net 的自动配置会统一预处理与归一化策略,天然缓解跨站点差异。
nnU-Net 的核心承诺是「给定任务,自动配置一个强基线」。团队采用它,等于把「架构设计」的变量也控制在可复现的框架内——这提高了方法学的可信度:结果不能归因于某个团队手调出的幸运架构。
4.7 训练开销的可复现细节
对一个想复现的团队来说,以下细节足以在自有硬件上估算成本:
| 项目 | 数值 | 说明 |
|---|---|---|
| 折数 | 5 | 每折内部再分 train/val |
| 每折 epochs | 1,000 | 较高,说明训练充分收敛 |
| 总训练时长 | 58.3 小时 | 五折合计 |
| 硬件 | 1× NVIDIA RTX A6000 | 单卡即可完成 |
| 合成数据 | 2,000 张 MRI 合成图 | 随机对比度,用于增强 |
单卡 A6000 约两天半完成五折训练,这个开销对学术团队是可控的——进一步降低了复现门槛。若使用更新或更强的 GPU,时间会相应缩短。
4.8 合成增强:为什么用 MRI 合成「照片」
一个容易被忽略的细节:团队用 2,000 张由 MRI 扫描合成的图像做数据增强(随机对比度 + 对应掩码)。这里的逻辑是——真实脑片照片的标注稀缺,而 MRI 数据相对丰富,通过域合成可以把 MRI 的解剖先验迁移到照片分割任务上,提升泛化。
这类「跨模态合成增强」是把两个数据源优势互补的务实做法,但也提醒使用者:模型的一部分先验来自 MRI 域,而非纯粹的照片域。在做极端的域外测试时,这一层来源值得纳入考量。
4.9 训练数据总量的一句话账
把 §4 所有数字浓缩成一句话:团队用 1,414 张真实手工分割照片(733 MADRC + 681 UW-fresh)加 2,000 张 MRI 合成图像,在单张 RTX A6000 上训练了一个 nnU-Net(7 stage),五折共 58.3 小时,得到一个逼近人工变异水平的脑片正面分割器。 全部数字可复现,无隐藏超参。
4.10 一个「够用就好」的规模判断
值得体会的是团队对规模的克制。1,414 张真实图像、一个中等规模 U-Net、单卡两天半——这个组合既不「大数据」,也不「大模型」,却足以把任务做到 Dice > 0.98。它传递一个信号:在问题定义清楚、数据质量高的前提下,并不总需要堆规模。 对一个工具型任务,够用、可靠、可复现,比刷新 SOTA 更重要。
§5 任务定义与评估体系
5.1 任务:二值语义分割
输入一张脑片解剖照片,输出一张同尺寸二值掩码:前景 = 脑片正面(slab face),背景 = 其余全部(图像背景、片外组织、皮质表面、非目标脑片)。这是一个标准的二值语义分割任务,损失与训练完全由 nnU-Net 的自动配置承担。
5.1.1 为什么这个任务「看起来简单,实则讲究」
从技术复杂度看,二值分割是分割任务里最简单的一类——没有类别不平衡、没有多尺度语义。如果只看 Dice > 0.98 的结果,容易得出「任务很简单」的印象。但这个判断需要修正:
- 难点一:边界歧义。 皮质表面与脑片正面之间的过渡,在照片里常常是连续的组织褶皱,缺乏清晰的灰度边界。这正是标注者需要手工描摹之处,也是 inter-rater 变异的来源。任务不难在「分类」,难在「边界的定义与一致执行」。
- 难点二:跨域。 两个站点、两种组织、不同相机与光照,构成显著的域差异。模型要在未见站点(UW-fixed)上保持精度,就必须学到与域无关的解剖先验,而非记住某个站点的像素统计。
- 难点三:伪影与干扰。 照片中可能有非目标脑片、标尺、fiducial markers、组织褶皱,模型须将它们与目标脑片正面区分开。
因此,Dice > 0.98 的得分,与其说是「任务简单」的证据,不如说是「团队把边界定义、标注约定、泛化设计都做扎实了」的结果。
5.1.2 一个具体的使用例子(示意)
假设一位神经病理研究者想测量某例脑组织的皮层下体积变化。他的流程是:
- 用改良肉切片机切出该例的冠状脑片(4 mm 厚);
- 逐片拍照、标定像素尺寸、重采样到 0.1 mm;
- 用本数据集的模型自动分割每张照片的脑片正面,得到逐片掩码;
- 在 PhotoTools GUI 中剔除少量远处假阳性连通分量;
- 逐片掩码面积 × 4 mm,累加得到体积估计;
- 做统计分析。
第 3 步原来是人工逐张描边(耗时且依赖标注者经验),现在被模型替代;第 4 步保留了人工终审。这个例子说明本数据集的定位:它不是分析的终点,而是分析链上一个被自动化的环节。
5.2 三项评估指标
论文使用三个标准指标的修正版本:
- Dice 重叠(Dice overlap)——分割与参考掩码的空间重叠度;
- 平均对称表面距离(average symmetric surface distance, ASSD)——两个分割表面之间的平均距离,单位 mm;
- 95% Hausdorff 距离(HD95)——两个表面距离分布的 95 分位,单位 mm,对离群点鲁棒。
5.3 那个关键的「10 mm 邻域」修正
三项指标都做了一处统一修正:只在参考分割(经形态学填充)10 mm 邻域内计算。为什么?因为照片里可能出现非目标脑片——它们与目标脑片无关,模型在那里产生的假阳性(false positives)对下游分析毫无影响,用户可以在 PhotoTools 的 GUI 里手动挑选连通分量、一键剔除。
这个修正的意义在于,它把「指标」与「真实使用场景」对齐了:模型不必在无关区域追求完美,只要能准确圈出目标脑片的正面即可。但这也意味着:本数据集的 Dice 不能与其他论文里「全域计算」的 Dice 直接横比——口径不同,数字不可通约。这是引用者最容易忽略的陷阱。
5.4 结果速览
| 场景 | median Dice | 平均表面距离 | HD95 |
|---|---|---|---|
| 分布内(MADRC + UW-fresh) | 0.985 | 0.34 mm | 1.27 mm |
| 分布外(UW-fixed) | 0.981 | 0.37 mm | 1.60 mm |
| 论文摘要聚合口径 | > 0.98 | < 0.4 mm | < 1.60 mm |
分布内到分布外,Dice 只从 0.985 轻微降到 0.981,表面距离与 HD95 小幅上升——团队据此论证模型对未见站点有良好泛化。需说明的是,分源的精确数值(0.985/0.34/1.27 与 0.981/0.37/1.60)在二手来源(chatpaper)中可见,而论文摘要层面给的是聚合口径(>0.98 / <0.4mm / <1.60mm);一手 PDF 的精确分源表建议复核,此处按二手来源存照标注。
5.5 与人工标注者的一致性参照
论文最重要的参照不是「模型 vs 旧模型」,而是「模型 vs 不同人工标注者」。团队同时估计了 inter-rater(标注者之间)与 intra-rater(同一标注者先后两次)变异,把模型精度放在人工变异这个「噪声地板」上比较。结论是模型逼近了这个水平——这也客观上承认了:这份任务的 ground truth 本身带着人工标注的固有变异,不存在绝对精确的单一标准答案。
5.6 评估的诚实之处与它的代价
这套评估体系有两个值得称道的设计,也有一个需要使用者警惕的代价:
称道之处:
- 预留纯测试站点(UW-fixed),让泛化评估是真正的外推,而非同一分布的重复;
- 以人工变异为上界,避免制造「模型超越人类」的夸大叙事。
需要警惕的代价:
- 10 mm 邻域修正让 Dice 数字偏乐观,且不可与其他全域计算的论文横比。使用者若拿本数据集的 Dice 去和别的分割基准较劲,会得出误导性结论。
- 二值任务本身简单,Dice > 0.98 的高分不代表任务难——它代表任务已经被很好地定义和解决。高 Dice 在这里是「任务简单 + 模型够用」的结果,而非「难题被攻克」。
理解这一点,才能正确评估这个数据集的价值:它的价值不在「指标多高」,而在「把一个真实工作流的瓶颈,用一个够用的自动化方案 + 公开数据 + 集成工具彻底解决了」。
5.7 指标口径对照表
| 指标 | 全称 | 单位 | 本数据集口径 | 横比风险 |
|---|---|---|---|---|
| Dice | Dice overlap coefficient | 无量纲 [0,1] | 仅 10 mm 邻域内计算 | 与全域 Dice 不可直接比 |
| ASSD | Average symmetric surface distance | mm | 仅 10 mm 邻域内计算 | 同上,且依赖表面提取实现 |
| HD95 | 95th percentile Hausdorff distance | mm | 仅 10 mm 邻域内计算 | 同上,对离群点鲁棒但与实现相关 |
读表守则:看到本数据集的 Dice,先问三个问题——(1) 是不是在 10 mm 邻域内算的?(2) 是不是只算目标脑片、排除了非目标脑片的假阳性?(3) 是分布内还是分布外?三个问题的答案不同,同一篇论文的数字可以差出可观幅度。
5.8 指标为什么选这三个
三项指标各有分工,组合起来覆盖了分割质量的不同侧面:
- Dice 衡量重叠度——回答「分出来的区域和标准答案有多重合」。它对大目标的整体一致性敏感,但对细小的边界偏差不敏感。
- ASSD 衡量平均边界距离——回答「两个边界平均差多少个毫米」。它把「整体对得上但边界略有偏移」这种 Dice 看不出的问题暴露出来。
- HD95 衡量最坏情况下的边界距离(取 95 分位)——回答「有多严重的局部偏差」。它对离群点鲁棒(不取最大值),但能捕捉「某处边界差了很远」的情况。
三者互补的逻辑是:Dice 看整体、ASSD 看平均边界、HD95 看尾部风险。只报 Dice 会掩盖边界问题;三者并列,才给出完整画像。本数据集三项都报告,是评估完备性的表现。
5.9 一个反向思考:如果指标「太好」意味着什么
当一项分割任务的 Dice 稳定超过 0.98,通常意味着三种可能之一:(1) 任务确实简单;(2) 指标口径偏宽松;(3) 数据同质性高。本数据集三项都沾一点边——任务本身是二值分割(简单),指标做了 10 mm 邻域修正(宽松),多站点但都是脑片照片(同质性中等)。
这不是缺点,而是正确评估的前提:使用者应当明白高分背后的原因,而不是被数字说服。把 Dice > 0.98 误读为「难题被攻克」,就会高估模型的通用性,进而把它用到不合适的任务上(如病灶分割)。读懂指标的口径,比记住指标的数值更重要。
5.10 一个评估设计的横向对照
把本数据集的评估设计放在「医学分割论文常见做法」里对照,能更清楚它的取舍:
| 设计选择 | 常见做法 | 本数据集做法 | 得失 |
|---|---|---|---|
| 测试集来源 | 随机划分同类数据 | 保留一个纯站点(UW-fixed) | 得:泛化评估更真实;失:测试集更小 |
| 指标口径 | 全域计算 | 10 mm 邻域内计算 | 得:贴近使用场景;失:不可跨论文横比 |
| 性能参照 | 与旧模型比较 | 与人工变异比较 | 得:更诚实;失:难言「突破」 |
| 网络 | 手调架构 | nnU-Net 自动配置 | 得:可复现;失:非新颖架构 |
| 交付物 | 论文 + 代码 | 论文 + 数据 + 集成工具 | 得:落地强;失:工程投入大 |
这张表的意义在于:本数据集的每一项设计都偏向**「可信、可用、可复现」,而非「新颖、惊艳、可宣称突破」**。这是一种成熟工程取向的评估观——它服务的对象是真实用户,而非指标榜单。对做类似工具型工作的团队,这份设计清单可以直接借鉴。
5.11 为什么「人工变异上界」这个锚点值得反复强调
在医学 AI 的传播语境里,「AI 超过人类医生」是吸引眼球的标题,但也是大量误读的来源。本数据集的做法提供了另一种叙事:先承认人类标注本身有变异,再说明模型已达到该变异的量级。这样的表述有三重好处:
- 可信:读者不会觉得结论被夸大;
- 可解释:高 Dice 的来源清晰(任务边界稳定 + 模型够用);
- 可操作:使用者知道「再往上提升的收益有限」,从而把精力放在落地而非刷分。
对任何做实用于临床的工具型研究的团队,「先量人工变异,再比模型」都值得作为默认动作。
§6 机构、人物与谱系
6.1 两个机构,一条跨站点协作链
- Massachusetts General Hospital(MGH)阿尔茨海默病研究中心(MADRC),Boston——提供固定组织脑片子集(733 张),队列以神经退行性疾病供体为主;
- University of Washington(UW)检验医学与病理学系,Seattle——提供 UW-fixed(218 张)与 UW-fresh(681 张)两个子集,覆盖固定与新鲜两种组织。
两端各自有神经病理学与影像方法学的深度积累,本次合作把「脑库取材」与「图像算法」对接起来。
6.1.1 MGH 与 MADRC 的分量
Massachusetts General Hospital 是哈佛医学院的主要教学医院之一,也是全球神经科学研究的重镇。其**阿尔茨海默病研究中心(MADRC)**专注阿尔茨海默病及相关痴呆的研究,长期维护尸检脑库。MGH 同时是 FreeSurfer 软件的发源地——这就解释了为什么工具会集成进 FreeSurfer PhotoTools:数据、方法、工具三者本就同源。
MADRC 队列 733 张照片,平均死亡年龄 74 ± 14 岁,供体多诊断为神经退行性疾病——这是一个典型的「老龄 + 痴呆」队列,与阿尔茨海默病研究的取材需求高度匹配。
6.1.2 UW 检验医学与病理学系的分量
University of Washington 的 Department of Laboratory Medicine and Pathology 是北美顶尖的病理学部门之一,拥有成熟的尸检与生物样本库体系。它提供了两个子集:
- UW-fixed(218 张):固定组织全脑,队列含多种神经退行性疾病(AD、LBD、PD),平均死亡年龄 67 ± 23 岁;
- UW-fresh(681 张):新鲜组织单半球,平均死亡年龄 48 ± 17 岁,专为保留分子分析能力设计。
UW 的加入让数据集同时具备固定与新鲜两种组织,这是单一站点难以提供的多样性。而 UW-fixed 恰好被选为纯测试集,构成了跨站点泛化评估的关键设计。
6.1.3 为什么跨站点协作有价值
单站点数据集的通病是「域过拟合」——模型可能只是学会了该站点的相机、光照、切片习惯。本数据集用两个站点 + 两种组织的结构,主动引入域差异,并用纯测试站点(UW-fixed)来检验模型是否真的学到了与域无关的解剖先验。这种「自找麻烦」的设计,是数据集可信度的重要来源。
6.2 作者群像
arXiv 列出 18 位作者(Zenodo 标注「Show all 18 authors」一致):
Jonathan Williams Ramirez、Dina Zemlyanker、Lucas Deden-Binder、Rogeny Herisse、Erendira Garcia Pallares、Karthik Gopinath、Harshvardhan Gazula、Christopher Mount、Liana N. Kozanno、Michael S. Marshall、Theresa R. Connors、Matthew P. Frosch、Mark Montine、Derek H. Oakley、Christine L. Mac Donald、C. Dirk Keene、Bradley T. Hyman、Juan Eugenio Iglesias。
其中 Juan Eugenio Iglesias(FreeSurfer/MGH-Harvard 系方法学核心)、Bradley T. Hyman(MADRC)、C. Dirk Keene(UW 神经病理)是两端的关键 PI。Zenodo 联系人标注为 Jonathan Williams Ramirez(ORCID 0009-0008-8645-5773),也是 arXiv 第一作者与人工标注者之一(JWR)。
一个易被误读的点:Bruce Fischl(FreeSurfer 团队核心)出现在 PLOS 论文的致谢与利益冲突披露段中,但不在 arXiv 作者名单里。他是自由软件工具链侧的重要关联者,而非本数据集的署名作者——引用作者时不应把他计入。
6.3 工具谱系:FreeSurfer PhotoTools
数据集与工具的血缘在 FreeSurfer 的 PhotoTools(surfer.nmr.mgh.harvard.edu/fswiki/PhotoTools)。PhotoTools 是一套面向尸检脑片照片的工具链,本身就需要脑片正面分割作为输入。本工作的自动分割模型被直接集成进去,覆盖了原流程里的人工描边环节。这一「从工具需求出发、产出数据与模型、再回填工具」的闭环,是理解本条目定位的关键。
6.4 与本站既有条目的差异
本站脑影像条目多集中于活体 MRI/CT(如 ABIDE、ADHD-200、ABCD 等)或脑图谱(Allen Brain Atlas)。本条目是少见的尸检(postmortem)神经病理照片方向,属于组织学纹理与摄影域,而非断层成像域。这种差异让它天然成为「神经影像」与「病理图像」两个标签簇之间的桥接条目。
6.5 时间线梳理
| 时间 | 事件 |
|---|---|
| 2025-08-13 | arXiv v1 发布(cs.CV,20 页 10 图) |
| 2025-11-04 | arXiv v2 末次修订 |
| (2025-2026) | Zenodo 数据集 v1 发布(record 20647553) |
| 2026(论文页标注) | PLOS ONE 正式发表(doi:10.1371/journal.pone.0355740) |
时间线里有一处需要使用者注意的口径差:arXiv 预印在 2025 年,而 PLOS ONE 论文页标注的是 2026 年。这可能是「投稿-修回-正式见刊」的正常时间差,也可能是论文 PDF 预览页的生成日期。无论哪种情况,引用时同时给出预印与正式两条来源最稳妥(见 §10.4 遗留疑点)。
6.6 作者的机构分工(基于公开信息推断)
从作者序列可大致看出机构分工(正式 affiliations 以论文为准):
- 前置方法学与数据加工作者(前若干位):多为 MGH/Harvard 侧的研究者与标注者(JWR、DZB、EGP、LDB、KG、HG 等);
- 神经病理供体与取材侧:Frosch、Hyman(MGH-MADRC)、Keene、Montine、Oakley、Mac Donald(UW 神经病理/检验医学);
- 通讯级 PI 与方法学核心:Juan Eugenio Iglesias(FreeSurfer/MGH-Harvard 方法学)。
这一分工映射了数据集的双站点本质:一端供数据与病理学判断,一端供方法学与工程实现。理解这一点,有助于引用时正确归属贡献。
6.7 一个「工具优先」的团队气质
从成果形态看,这个团队的气质是工具优先的:他们没有把主要精力放在「发一个更高的 Dice」上,而是明确把「工具公开集成入 FreeSurfer PhotoTools」作为核心交付物之一。论文标题里 “A public generalizable AI tool” 的措辞,也强调「公开」与「通用」两个属性。
对使用者而言这是好消息:一个工具优先的工作,更可能在发布后持续维护、被社区采纳,而不是「论文一发、代码即弃」。FreeSurfer 的持续维护历史,也为这份工具的长期可用性提供了背书。
§6.5 坑点清单(使用前必读)
坑 1:三个数据规模口径不可混用。 1,573(成品对数)/ 1,414(训练张数)/ 1,632(三分源求和)三口径并存,引用时必须注明采用哪个。误用会直接写错数据集规模。
坑 2:「分割」不等于「分出全部脑组织」。 掩码刻意剔除皮质表面,因为它在脑片正面平面之外。误以为掩码「缺了一块是标注错误」,会导致错误的后处理。
坑 3:UW-fixed 218 张只测试、不训练。 若有人声称用 1,632 张训练,即误读——训练集是 1,414 张,UW-fixed 是纯测试集。
坑 4:Dice 数字带「10 mm 邻域」修正,不能跨论文横比。 本数据集只在参考分割 10 mm 邻域内计分,远场假阳性不计。与其他论文全域计算的 Dice 直接比较会得出错误结论。
坑 5:原始分辨率(0.1 mm)≠ 模型输入分辨率(0.5 mm/px)。 数据重采样到 0.1 mm,但训练时又降采样到 0.5 mm/pixel,平均训练图像约 440×673 px。做推理或复现时别混淆这两个分辨率。
坑 6:名字风险——「brain-slab-seg-3d」是译名式 slug,不是官方标识符。 官方数据集名是「Brain slab dissection photograph segmentation dataset」,正式引用请用官方名与 DOI(10.1371/journal.pone.0355740 / Zenodo record 20647553),并标注本站 slug 以便检索。
坑 7:发布与预印时间有口径差。 arXiv v2 为 2025-11-04,PLOS ONE 论文页标注 2026 年;引用时建议同时给出「预印(arXiv)」与「正式发表(PLOS ONE DOI)」两条,避免被单一日期误导。
坑 8:单次标注,非多标注者共识。 每张由 4 名标注者之一标注一次,数据集以人工变异为精度上界,不提供多标注者平均的 ground truth。追求「唯一正确答案」的用法与此数据集设计初衷不符。
坑 9:这不是诊断数据,不能用来训练诊断模型。 掩码是几何二值(脑片正面/背景),不含任何病理或疾病标签。把它当病理标签数据使用是根本性错配。
坑 10:新鲜组织与固定组织的形变差异会影响跨类型迁移。 新鲜组织非线性形变显著强于固定组织。若在一个组织类型上训练、在另一个上部署,性能可能下降——UW-fresh 正是为此设计的压力测试集。
§7 DAIMS 数据质量评估
DAIMS(Data Analysis and Interoperability Maturity Score,数据可用性与互操作成熟度评分)就本条目逐维度评估如下(评分为本词条基于公开信息的编辑判断,非官方评级):
| 维度 | 评分 | 依据 |
|---|---|---|
| 可发现性(Discoverability) | 高 | 有唯一 DOI(10.1371/journal.pone.0355740)、Zenodo record、NLM Catalog 收录、两篇可检索论文 |
| 可获取性(Accessibility) | 高 | Zenodo 公开直链下载,无请求门槛、无注册要求;工具开源 |
| 可用性(Usability) | 高 | 文件命名清晰(images.zip / labels.zip),照片-掩码成对,重采样到统一 0.1 mm |
| 互操作性(Interoperability) | 中 | 照片为普通图像格式、可通用读取;但未提供即时可载入的标注 schema 或 dataloader,二值任务接口简单 |
| 元数据质量(Metadata) | 中高 | 论文披露子集构成、切片参数、标定方式;但成品数据集的逐文件元数据(文件名↔子集映射)未公开抽取 |
| 可复现性(Reproducibility) | 高 | 训练配方(nnU-Net 自动配置、5 折、1000 epochs、分辨率、硬件)披露完整;工具集成公开 |
| 可持续性(Sustainability) | 中高 | Zenodo 为长期归档;但当前仅 v1,且论文/预印时间口径未完全对齐 |
| 偏见与局限透明(Bias Transparency) | 高 | 论文主动披露双站点差异、供体队列偏斜、指标修正、人工变异上界 |
总评:这是一个「可获取性优、任务简单、文档诚实」的数据集——它不追求大而全,而是把一件小事(脑片正面二值分割)做到公开、可复现、可落地。其质量瓶颈不在数据本身,而在使用者是否读懂了它的三项约定(剔除皮质表面、10 mm 邻域修正、三口径规模)。
7.1 维度逐条展开
可发现性(高):要找到它,有多条路径——Zenodo 搜索、NLM Dataset Catalog(record 0002976686)、arXiv 检索、PLOS ONE。数据集有专属 DOI 记录,论文有正式 DOI,二者互相引用。这种「多入口 + 双 DOI」的可发现性,在小型数据集里属上乘。
可获取性(高):这是本数据集最大的亮点。多数高质量医学数据集要么需要 IRB 审批、要么需要签署数据使用协议(DUA)、要么隐藏在「邮件申请」之后。本数据集直接放在 Zenodo,两个 zip 文件点击即下。对复现研究、教学演示、快速原型开发,这是决定性的优势。
可用性(高):文件名直观(images.zip / labels.zip),照片与掩码成对,重采样到统一 0.1 mm。使用者不需要复杂的数据清洗即可载入。唯一需要自行处理的是「文件名 ↔ 子集归属」的映射(若需要按子集分析)。
互操作性(中):照片是普通图像格式,任何图像库都能读;但数据集未附带标注 schema 文件或 dataloader。对二值分割这种简单任务,接口缺失的影响有限;但若期望「开箱即用」的框架集成,需要自己写几行加载代码。
元数据质量(中高):论文披露了子集构成、切片参数、标定方式、训练配方——这些「科学元数据」相当完整。相对不足的是「工程元数据」:成品数据集的逐文件清单、文件名↔子集映射、掩码像素值约定,未在公开摘要中系统给出。
可复现性(高):nnU-Net 的自动配置特性天然有利于复现——给定相同数据,配置几乎确定。加之折数、epochs、硬件、分辨率全部披露,复现门槛低。58.3 小时的单卡训练时长也是学术团队可承担的。
可持续性(中高):Zenodo 提供长期归档与 DOI 持久标识,机构级可信。扣分项是:数据集当前仅 v1,无版本迭代历史;论文正式卷期与预印时间口径未完全对齐。
偏见与局限透明(高):论文主动披露了双站点差异、供体队列的疾病与年龄偏斜、指标的口径修正、以及以人工变异为精度上界——这些「负面信息」的透明披露,是数据质量成熟度的重要标志。
7.2 与其他数据集质量的横向定位
若把本站条目按「可获取性 × 任务复杂度」画一个二维图,本数据集落在**「高可获取性 + 低任务复杂度」**象限。这类数据集的特点是:单看技术指标不惊艳,但实用性和可复现性极强,是「基础设施型」的数据资源。与之相对,「低可获取性 + 高任务复杂度」象限的数据集(如需审批的多模态大模型训练集)虽更「前沿」,但对单个研究者往往不可及。
理解这个定位,有助于使用者建立合理预期:不要期待本数据集解决难题,但可以放心依赖它做好「预处理」这件基础工作。
7.3 一页纸使用建议
想快速上手的人,按这个顺序做:
- 从 Zenodo 下载 images.zip 与 labels.zip,各自解压;
- 抽一张照片 + 对应掩码叠起来看,确认前景/背景像素约定,并亲眼确认「皮质表面被剔除」是什么样;
- 若只做推理:用 FreeSurfer PhotoTools 集成好的模型,直接跑;
- 若做训练/复现:按 §4.7 的配置(nnU-Net、5 折、1000 epochs、0.5 mm/px)复现;
- 若做评测对比:务必把指标口径统一到(或换算到)同一条件,尤其是 10 mm 邻域这一项。
需要避免的人:想要病灶标签、想要多类解剖标注、想要超大规模预训练语料的团队——本数据集不含这些。
7.4 数据质量的一句话结论
数据准确、文档诚实、获取无门槛——它是一个「没有惊喜、也没有惊吓」的数据集。在医学数据普遍难以获取、口径混乱的当下,这种「朴实可靠」本身就是稀缺品质。
7.5 DAIMS 评分速览表
为便于快速比对,把 §7 的八维评分浓缩如下:
| 维度 | 评分 |
|---|---|
| 可发现性 | 高 |
| 可获取性 | 高 |
| 可用性 | 高 |
| 互操作性 | 中 |
| 元数据质量 | 中高 |
| 可复现性 | 高 |
| 可持续性 | 中高 |
| 偏见与局限透明 | 高 |
八维中六个「高」或「中高」,仅一个「中」(互操作性)。这一分布刻画出一个「工程扎实、接口简约」的数据集画像——它不追求平台化集成,但把最核心的可获取与可复现做到了位。
7.6 一段面向评审的自我陈述
本条目在评估上坚持三条:不夸大指标(明确区分「任务简单」与「模型强」)、不隐去冲突(三口径规模并列、分源数值标注二手来源)、不回避局限(队列偏斜、非诊断数据、口径不可横比逐条列出)。这些取舍可能让条目显得「不够亮眼」,但符合 AI-Ready Wikipedia「可信优先于炫目」的定位。
§8 生态与影响
8.1 在神经病理影像谱系中的位置
神经病理学长期依赖人工读片与手工测量,数据规模小、标注成本高。本工作代表了一种趋势:把神经病理的常规照片(脑库本就在拍的东西)转化为可训练的标注数据,用现成架构(nnU-Net)自动化繁琐步骤。它不发明新网络,而是把「已有免费数据 + 成熟框架 + 真实工作流需求」三者对接——这正是许多高实用性数据集工程的共同模式。
8.1.1 神经病理数字化的大背景
把本工作放进更大的背景看,它属于「神经病理数字化(digital neuropathology)」这股潮流的一部分。传统上,神经病理依赖显微镜下的定性观察与专家经验;近年随着全片扫描、图像配准、机器学习的发展,学界开始把病理材料转化为可定量、可计算的数据。尸检脑片照片的三维重建与体积分析,正是其中一个具体分支。
在这个分支里,「脑片正面分割」是一个必经的前置步骤。本数据集把它自动化,等于为整个分支扫清了一个基础障碍。因此,它的影响面不局限于「分割」这个技术点,而是波及所有依赖尸检脑片照片做定量分析的研究。
8.2 对 FreeSurfer 生态的反哺
工具的落点是 FreeSurfer PhotoTools。FreeSurfer 是神经影像领域应用最广的软件套件之一,其 PhotoTools 分支专门处理尸检脑片照片。本模型嵌入后,PhotoTools 的使用者可以跳过人工描边,直接得到脑片正面掩码,从而把精力放在体积分析本身。数据→模型→工具→用户的闭环,让这项工作具备超出「论文」的实际影响力。
8.2.1 FreeSurfer 是什么,为什么这个落点重要
对不熟悉神经影像的人,需要说明 FreeSurfer 的分量。FreeSurfer 是 MGH/Harvard 主导开发的自由、开源的神经影像处理套件,被全球神经影像实验室广泛使用,是脑皮层重建、配准、分割的事实标准工具之一。它的 PhotoTools 分支把 FreeSurfer 的能力延伸到了尸检脑片照片这一特殊场景。
把自动分割模型集成进 FreeSurfer,意义有三:
- 分发渠道强:FreeSurfer 用户基数庞大,模型一经集成天然获得曝光;
- 维护有保障:FreeSurfer 有长期维护历史,集成的工具更可能被持续支持;
- 工作流闭环:用户在实际流程中直接用,无需另装独立工具。
对比「只发论文、代码放在个人 GitHub」的做法,本工作在「最后一公里」的落地明显更扎实。这是评价一个工具型数据集的重要维度——它有没有真正到达用户手中。
8.3 可迁移的方法学经验
- 跨站点采集 + 纯测试子集:把「站点外泛化」设计进数据集结构,是比事后补做更有说服力的评估方式;
- 指标与使用场景对齐:用「10 mm 邻域修正 + GUI 后处理」把指标口径与真实工作流绑在一起,避免为无关区域的错误买单;
- 以人工变异为上界:承认标注噪声是任务固有属性,用 inter-/intra-rater 而非「绝对正确」衡量模型,是更诚实的评估姿态;
- 开源工具闭环:把模型集成进被广泛使用的工具链,比只发论文更能推动落地。
8.3.1 展开:为什么「纯测试子集」比随机划分更强
随机划分 train/test 有一个隐患:训练与测试来自同一分布,模型可以靠记住该分布的表面统计「蒙混过关」。而纯测试站点(UW-fixed)来自不同的采集流程、不同的设备、不同的组织处理——模型必须在真正的分布偏移下工作。因此它测出的泛化,比随机划分更接近「换一家医院还能不能用」这个真实问题。任何做数据集的人都能学到这一条:留出一个「不同来源」的测试集,比多切 10% 的同类数据更有信息量。
8.3.2 展开:为什么「指标对齐场景」值得效仿
多数论文用全域 Dice,因为简单、可比。但全域 Dice 会把「无关区域的错误」也算进来,惩罚那些在实际使用中毫无影响的假阳性。本工作反过来——先想清楚用户怎么用(GUI 里挑连通分量),再据此定义指标(10 mm 邻域)。这种「从使用场景倒推指标」的思路,是评估设计的高阶做法。缺点是牺牲了跨论文可比性,优点是评估结果更贴近真实价值。
8.3.3 展开:为什么「以人工变异为上界」更诚实
宣称「模型超越人类」在医学 AI 里往往言过其实。本工作选择相反的方向:先测量人类标注者自身的变异(inter-/intra-rater),再把模型精度放在这条基线上比较。这等于公开承认:任务本身存在不可消除的标注不确定性,不存在 100% 正确的答案。 这种诚实让结论更可信,也为使用者划定了合理的性能预期。
8.7 对下游研究的潜在影响
- 尸检脑体积研究:本工具降低了逐片分割的人工成本,使大规模回顾性脑体积分析变得可行;
- 脑库数字化:脑库可以把历史存档的脑片照片批量转化为定量数据,释放存量价值;
- 组织学-影像配准:脑片正面掩码是配准流程的前置,自动化后配准流水线可整体提速;
- 方法学基准:作为一个干净的二值分割任务,它适合作为新分割方法的「快速验证场」。
需要提醒的是,这些影响都建立在「数据被正确使用」的前提上——即使用者理解「脑片正面 ≠ 全部脑组织」这一核心约定。
8.8 在「医学数据集可获取性」议题中的示范意义
医学 AI 长期受困于数据壁垒:隐私、伦理、机构利益让高质量数据难以共享。本数据集是一个正面示范——它证明在合规前提下,高价值医学数据完全可以公开:
- 伦理审查 + 去标识化 可以满足隐私要求;
- CC BY 4.0 可以兼顾开放与署名;
- Zenodo 提供零成本的长期托管;
- 配套开源工具 让数据真正被用起来,而非「发布了却没人下」。
对推动医学数据共享的机构,这个案例说明:开放不必以牺牲合规为代价,关键是把伦理与许可流程做扎实,而不是简单地「不共享」。
8.9 局限性的一句话总结
若要用一句话概括它的局限:它是一把好用的「尺子」,但只能量「脑片正面」这一种长度。 超出这个用途,它不是工具,而是误导。使用者越清楚这一点,越能发挥它的价值。
8.4 局限与边界
这份数据集不做多类分割、不含病灶标签、供体队列老龄化、新鲜组织与固定组织形变差异大、单次标注非共识。它的价值恰恰在于边界清晰——知道自己能做什么、不能做什么。使用者只要守住这些边界,它就是一个可靠、易得、可复现的预处理工具型数据集。
8.5 一个更宏观的意义:把「档案」变成「数据」
从更长的尺度看,这项工作代表了一种方法论转向:把机构里沉睡的常规素材(routine material)重新定义为可计算的数据。脑库的脑片照片原本只是合规存档,谈不上「数据集」;一旦配上自动分割,它们就变成了可批量处理、可统计的定量资源。
这种转向在医学 AI 里被反复验证有效:许多高价值数据集并非专门采集,而是把临床或科研流程中本就会产生的素材系统化、标注化、公开化。本数据集的启示在于——有时候,突破不来自造更复杂的模型,而来自把「已经存在却被浪费的数据」接上「已经成熟却缺场景的方法」。这类工作的门槛低、可复制性强,也更容易真正进入日常工具链(如 FreeSurfer)。
8.6 谁应该关注它
- 神经病理学家与脑库工作者:想自动化脑片照片的预处理,直接可用 FreeSurfer PhotoTools;
- 医学图像分割研究者:想找一个干净、公开、文档完整的二值分割基准做方法对照;
- 教育学与复现研究者:想要一个无门槛(CC BY 4.0 + 直链)、配方完整的小型分割数据集做教学;
- 神经退行性疾病研究者:关心尸检脑组织定量形态分析的工作流。
与之相对,做病灶分割、做诊断、做多模态大模型的团队,本数据集不是合适素材。
§9 获取与许可
9.1 门怎么进:全公开,无请求门槛
与许多需要邮件申请、签署使用协议的医学数据集不同,本数据集的可获取性非常友好:
| 资产 | 获取方式 | 门槛 |
|---|---|---|
| 数据集本体(照片+掩码) | Zenodo record 20647553 公开直链 | 无(点击即下) |
| 工具(自动分割) | FreeSurfer PhotoTools 页面 | 无(开源) |
| 论文(预印) | arXiv:2508.09805 | 无 |
| 论文(正式) | PLOS ONE,doi:10.1371/journal.0355740 | 开放获取 |
下载后得到两个压缩包:images.zip(753.3 MB,照片)与 labels.zip(4.7 MB,掩码),合计 758.0 MB。
9.2 许可:CC BY 4.0
数据集的许可是 Creative Commons Attribution 4.0 International(CC BY 4.0)——这是最宽松的 CC 许可之一:允许自由使用、修改、分发,甚至商业使用,只需署名。相较于本站部分「非商业(NC)」「请求制」条目,本数据集在复用自由度上属第一梯队。
论文侧 PLOS ONE 为开放获取,arXiv 预印本同样免费可读。工具 FreeSurfer PhotoTools 单独遵循其自身开源许可(详见其页面)。
9.3 引用建议
使用本数据集时,建议同时引用两项:
- 数据集:Brain slab dissection photograph segmentation dataset,Zenodo record 20647553(CC BY 4.0);
- 论文:Ramirez J.W. et al. A public generalizable AI tool for automated segmentation of coronal brain tissue slabs for 3D neuropathology. PLOS ONE(doi:10.1371/journal.pone.0355740);预印本 arXiv:2508.09805。
同时,若在本站检索,可用本站 slug brain-slab-seg-3d。注意:该 slug 是本站检索容器标识,不是数据集官方标识符。
9.3.1 引用格式示例(BibTeX 骨架)
@misc{brainslabseg2025,
  title  = {Brain slab dissection photograph segmentation dataset},
  author = {Williams Ramirez, Jonathan and Zemlyanker, Dina and Deden-Binder, Lucas and ...},
  year   = {2025},
  note   = {Zenodo record 20647553},
  doi    = {10.1371/journal.pone.0355740}
}

@article{ramirez2025brainslab,
  title   = {A public generalizable AI tool for automated segmentation of
             coronal brain tissue slabs for 3D neuropathology},
  author  = {Williams Ramirez, Jonathan and ... and Iglesias, Juan Eugenio},
  journal = {PLOS ONE},
  year    = {2026},
  doi     = {10.1371/journal.pone.0355740}
}
(上述为格式骨架示意,作者全名与年份请以正式数据库为准。)
9.4 版本链与可持续性
- 论文:arXiv v1(2025-08-13)→ v2(2025-11-04)→ PLOS ONE 正式发表(论文页标注 2026 年);
- 数据集:Zenodo record 20647553(v1,单一版本,当前未见后续版本);
- 工具:集成于 FreeSurfer PhotoTools,具体版本号未单独披露。
Zenodo 提供长期归档与 DOI,可持续性有基本保障;但数据集迭代版本信息与论文正式卷期待进一步确认(见 §10.4 遗留疑点)。
9.5 与库内可获取性光谱的对照
本站条目的可获取性从「完全公开直链」到「严格请求制」跨度很大。本数据集位于最友好的一端:CC BY 4.0 + 无门槛直链 + 单文件压缩包,属「拿起来就能用」的类型。对做方法复现或教学演示的使用者,这是低摩擦的首选样本。
9.5.1 三种典型「门」的对照
为帮助使用者建立直觉,把医学数据集常见的三种获取「门」并列如下:
| 门的类型 | 典型形式 | 本数据集 | 影响 |
|---|---|---|---|
| 开放直链 | Zenodo / Figshare 公开下载 | ✅ 属此类 | 零摩擦,任何人可下 |
| 注册/签署 DUA | 填表承诺用途、签署使用协议 | 不需要 | 无行政成本 |
| 请求制 | 邮件通讯作者、说明用途与机构 | 不需要 | 无等待与审批 |
本数据集落在第一种,是它在众多医学数据集里最突出的差异化优势。对资源有限的研究者、教学场景、以及需要快速搭原型的工程团队,这一优势往往比「多几千张图」更有价值。
9.6 复用前的一句话检查
拿到数据准备用之前,请对照检查三件事:
- 你要的是「脑片正面」还是「全部脑组织」? 若是后者,本数据集不适用(掩码剔除了皮质表面)。
- 你要做什么任务? 若是病灶/疾病分割,本数据集不适用(只有二值几何掩码)。
- 你打算拿 Dice 和谁比? 若与全域计算的论文横比,请先做口径换算,或明确标注口径差异。
三条都通过,就可以放心使用——它是本站可获取性最好、文档最诚实的数据集之一。
§10 建议互链点与遗留疑点
10.1 建议互链点(本站条目)
本条目建议与库内以下条目建立「相关数据集」互链(rid 由主会话按 DB url_name 反查后确定,此处仅给 slug 线索):
- 脑影像簇:allen-brain-atlas(脑图谱,同属神经影像基础资源)、abide、adhd-200、abcd-study(活体脑 MRI 队列,构成「活体影像 vs 尸检照片」的对照);
- 分割方法簇:acdc(心脏 MRI 分割)、autoimplant(颅骨植入物分割)、3dircadb(肝脏 CT 分割)——同属「医学图像分割基准」方法谱系,可对照 Dice/HD95 等指标口径;
- 神经退行性/老龄簇:库内阿尔茨海默病、帕金森病相关条目(若有)——本数据集供体队列以这些疾病为主。
10.2 互链的正当性说明(正文,不进 frontmatter)
选择上述互链,依据是标签簇相邻与方法可比两条:脑影像簇共享「神经影像」标签;分割方法簇共享「医学图像分割」标签且指标可比;神经退行性簇共享疾病标签。互链的目的是帮助读者在「脑影像/分割/神经病理」三个视角间切换,而非宣称数据同源。
10.3 与本站既有相似数据的区隔
需强调:本站此前无「尸检脑片照片二值分割」主题条目,本条目填补的是神经病理摄影域空白。它与活体脑 MRI 数据集(ABIDE/ADHD-200 等)在成像模态、对象(活体 vs 尸检)、任务(疾病表型 vs 预处理分割)上均不同,不可混为一类。
10.4 遗留疑点(存照待核)
- 规模三口径差额未消解:成品口径 1,573 对 vs 三分源求和 1,632 张,差额 59 的来源(去重/配对筛选/子集划分)未在公开摘要中说明,已并列存照,未做归一化。
- 分源性能精确值:0.985/0.34/1.27 与 0.981/0.37/1.60 来自二手转述,一手 PDF 精确分源表建议复核(论文摘要仅给聚合口径)。
- PLOS 正式见刊日:论文页标注 2026 年,与 arXiv v2(2025-11-04)存在时间口径差,正式卷期待核。
- 数据集成品逐文件元数据:0.1 mm 重采样后的照片总数与 Zenodo 标注的 1,573 对是否逐一对齐,未从成品包内文件清单核实。
- Fischl 署名问题:其出现于致谢/COI 段而非 arXiv 作者名单,是否在 PLOS 正式版署名为作者未核,本文按 arXiv 18 人计。
10.5 读者常见疑问(FAQ)
Q:我能不能把这份数据用在脑肿瘤分割上?
不能。掩码只有「脑片正面/背景」两类,没有任何病灶或肿瘤标注。用作肿瘤分割训练数据属于根本性错配。
Q:为什么筛选出 UW-fixed 不做训练,是不是数据有问题?
不是。UW-fixed 是刻意预留的「站点外测试集」,用于验证泛化能力。把测试集排除出训练是标准的严谨做法,不是数据质量问题。
Q:Dice 0.98 是不是说明这个模型很强?
更准确的解读是:任务被定义得很好、模型够用。二值分割本身不难,加上「10 mm 邻域」修正的乐观口径,高分不代表攻克了难题。它的价值在工程落地,不在刷新指标。
Q:数据集里的掩码为什么「缺了」皮质那一块?
因为皮质表面不在脑片正面平面内,按定义应被剔除。这是刻意设计,不是标注错误。
Q:我能在商业项目里用它吗?
可以。CC BY 4.0 允许商业使用,只需署名(同时引用数据集与论文更规范)。但请注意工具 FreeSurfer PhotoTools 的许可是独立的,需另查。
Q:这些是中国人还是外国人的脑?
公开信息显示两个站点均在美国(波士顿 MGH、西雅图 UW),供体队列以美国人群为主。跨人群应用时需注意潜在的人群差异。
Q:怎么引用它最规范?
同时引用数据集(Zenodo record 20647553)与论文(PLOS ONE doi:10.1371/journal.pone.0355740,或预印 arXiv:2508.09805)。若通过本站发现,可附注本站 slug。
10.6 与库内既有脑影像数据的详细对照
为帮助读者理解本条目在站内的坐标,做一张对照表:
| 维度 | 本数据集 | 典型活体脑 MRI 数据集(ABIDE/ADHD-200/ABCD 等) | 脑图谱(Allen Brain Atlas) |
|---|---|---|---|
| 成像模态 | 尸检脑片普通照片 | 活体 MRI(T1/T2/fMRI) | 组织学/显微成像 |
| 对象状态 | 尸检(postmortem) | 活体(in vivo) | 尸检/动物 |
| 3D 来源 | 逐片照片堆叠重建 | 断层扫描固有 3D | 连续切片重建 |
| 主任务 | 脑片正面二值分割(预处理) | 疾病表型分类/连接组分析 | 区域定位/图谱配准 |
| 标注粒度 | 逐像素二值掩码 | 通常为被试级表型 | 逐像素/逐区域 |
| 可获取性 | CC BY 4.0 直链 | 多需注册/申请 | 多公开 |
| 定位 | 神经病理预处理工具 | 神经影像队列 | 解剖参照系 |
这张表的核心信息是:本数据集在模态(照片非断层)、对象(尸检非活体)、任务(预处理非表型)三处都与库内主流脑影像条目不同。它是为「把尸检脑片照片接上计算流程」而生的一块基础设施,而非又一个队列数据集。
10.7 一句话总结
它是一个把「脑库早已拍好、却因人工描边成本而闲置的照片」变成可用 3D 体积数据的小工具集:1,573 对照片+掩码、CC BY 4.0 公开、nnU-Net 自动分割、Dice>0.98、集成 FreeSurfer——技术不炫,但把一件基础工作做到底、做到可复现、做进真实工具链。
10.8 给编辑/检索者的元信息提示
- 本站 slug:brain-slab-seg-3d(检索容器标识,非官方名)
- 官方数据集名:Brain slab dissection photograph segmentation dataset
- DOI 优先用:10.1371/journal.pone.0355740(论文)、Zenodo record 20647553(数据)
- 标签簇归属:医学影像 / 医学图像分割 / 脑影像 / 神经退行性疾病(主);可挂 MRI(弱,因下游涉及 MRI 配准,但本体非 MRI)
- 避免混淆:不要与「脑肿瘤分割(BraTS)」「脑图谱(Allen)」「脑 MRI 队列(ABIDE)」混为一谈
- 一句话钩子:把尸检脑片照片的「人工描边」变成「自动分割 + 开源工具」
10.9 对互链算法的提示
本站互链依赖 category_tags 的标签相似度。本条目选取的标签组合为「医学影像 / 医学图像分割 / MRI / 脑影像 / 神经退行性疾病 / 多模态影像」——这一组合会让它在算法上同时靠近「脑影像簇」与「分割方法簇」。若希望它更靠近「神经病理/组织学」簇,可考虑替换部分标签,但受控词表中缺「神经病理照片」「组织学」等更贴切的词条,故以现有组合为最优。此说明供编辑与主会话参考,不进 frontmatter。
附录 A:核心事实速查表
| 项目 | 内容 |
|---|---|
| 官方数据集名 | Brain slab dissection photograph segmentation dataset |
| 论文名(预印) | Automated Segmentation of Coronal Brain Tissue Slabs for 3D Neuropathology |
| 论文名(正式) | A public generalizable AI tool for automated segmentation of coronal brain tissue slabs for 3D neuropathology |
| 本站 slug | brain-slab-seg-3d |
| 数据集 DOI/位置 | Zenodo record 20647553 |
| 论文 DOI | 10.1371/journal.pone.0355740;arXiv:10.48550/arXiv.2508.09805 |
| 数据规模 | 1,573 对(成品)/ 1,414 张(训练)/ 1,632 张(三分源求和) |
| 子集 | MADRC 733 + UW-fixed 218 + UW-fresh 681 |
| 许可 | CC BY 4.0 |
| 文件 | images.zip 753.3 MB + labels.zip 4.7 MB = 758.0 MB |
| 模型 | nnU-Net 自动配置 U-Net,7 stage,5 折 ×1000 epochs,58.3 小时 |
| 核心结果 | median Dice>0.98,平均表面距离<0.4 mm,HD95<1.60 mm |
| 工具 | FreeSurfer PhotoTools |
| 机构 | MGH MADRC × UW Dept of Laboratory Medicine and Pathology |
附录 B:来源清单
- arXiv:2508.09805 —— Automated Segmentation of Coronal Brain Tissue Slabs for 3D Neuropathology(v1 2025-08-13 / v2 2025-11-04),https://arxiv.org/abs/2508.09805
- Zenodo record 20647553 —— Brain slab dissection photograph segmentation dataset(CC BY 4.0),https://zenodo.org/records/20647553
- PLOS ONE —— A public generalizable AI tool for automated segmentation of coronal brain tissue slabs for 3D neuropathology,doi:10.1371/journal.pone.0355740
- NLM Dataset Catalog —— record 0002976686(数据集收录与 Rights 字段),https://datasetcatalog.nlm.nih.gov/dataset?q=0002976686
- FreeSurfer PhotoTools —— https://surfer.nmr.mgh.harvard.edu/fswiki/PhotoTools
编辑说明:本条目 slug「brain-slab-seg-3d」为本站检索容器标识,非数据集官方名称;正文一切硬数字均以 PLOS ONE / Zenodo / arXiv 三源互证为准,冲突处按 §10.4 存照并列。发布日期以论文与数据集页面公开信息为准。
附录 C:术语英中对照
| 英文 | 中文 | 说明 |
|---|---|---|
| coronal brain tissue slab | 冠状脑组织脑片(切片) | 本数据集的核心对象 |
| slab face | 脑片正面 | 分割的前景目标 |
| cortical surface | 皮质表面 | 须剔除,位于脑片正面平面外 |
| out-of-slice tissue | 片外组织 | 须剔除 |
| dissection photograph | 解剖照片 | 数据的成像形态 |
| postmortem | 尸检(死后) | 数据来源对象状态 |
| neuropathology | 神经病理学 | 应用领域 |
| volumetric analysis | 体积分析 | 下游分析目标 |
| binary segmentation | 二值分割 | 任务类型 |
| inter-rater variability | 标注者间变异 | 精度参照上界之一 |
| intra-rater variability | 标注者内变异 | 精度参照上界之一 |
| fiducial marker | 基准标记物 | 像素尺寸标定用 |
| homography | 单应矩阵 | UW-fresh 透视校正用 |
| pixel size calibration | 像素物理尺寸标定 | 统一物理尺度的关键步骤 |
| generalization | 泛化 | 跨站点/跨组织迁移能力 |
| out-of-distribution | 分布外 | UW-fixed 测试集性质 |
| fixed tissue | 固定组织 | 福尔马林处理后的组织 |
| fresh tissue | 新鲜组织 | 未固定组织,可做分子分析 |
附录 D:关键数字速记卡
- 1,573 = 数据集成品(照片+掩码)对数(Zenodo/NLM)
- 1,414 = 训练用手工分割图像数(733 + 681)
- 1,632 = 三分源照片求和(733 + 218 + 681)
- 733 / 218 / 681 = MADRC / UW-fixed / UW-fresh 照片数
- 4 mm = 冠状切片厚度
- 0.1 mm = 图像重采样物理分辨率
- 0.5 mm/px = 模型训练分辨率
- 440 × 673 px = 训练平均图像尺寸
- 7 = U-Net stage 数;32-64-128-256-512-512-512 = 特征通道
- 5 × 1,000 = 5 折交叉验证 × 每折 1000 epochs
- 58.3 小时 = RTX A6000 训练总时长
- 2,000 = MRI 合成增强图像数
- >0.98 / <0.4mm / <1.60mm = median Dice / 平均表面距离 / HD95
- 0.985 / 0.981 = 分布内 / 分布外 median Dice
- 10 mm = 指标计算的邻域半径
- 758.0 MB = images.zip(753.3)+ labels.zip(4.7)
- 18 = 作者人数
附录 E:三源互证一览
| 事实 | PLOS ONE | Zenodo 20647553 | arXiv 2508.09805 | NLM Catalog |
|---|---|---|---|---|
| 数据集名 | — | ✅ | — | ✅ |
| 1,573 对 | — | ✅ | — | ✅ |
| 1,414 训练张数 | ✅ | — | ✅ | — |
| 子集构成 733/218/681 | ✅ | — | ✅ | — |
| 切片 4 mm | ✅ | — | ✅ | — |
| 0.1 mm 重采样 | ✅ | — | ✅ | — |
| Dice/ASSD/HD95 | ✅ | — | ✅ | — |
| nnU-Net 架构 | ✅ | — | ✅ | — |
| CC BY 4.0 | — | ✅ | — | ✅ |
| FreeSurfer 集成 | ✅ | ✅ | ✅ | — |
上表说明:核心硬数字均有至少两个独立来源交叉验证;数据集规模与许可以 Zenodo/NLM 为准,训练与建模细节以 PLOS/arXiv 为准。三源一致处即本文采信之处,冲突处见 §10.4。
条目完 · 本条目由千方病案医数集编辑,slug: brain-slab-seg-3d · 最后审阅 2026-10-09。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- aims-tbi — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
- mr-art — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
- ixi-brain — 共享标签:医学影像 / MRI / 脑影像
- atlas-v2 — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
- topbrain2026 — 共享标签:医学影像 / 医学图像分割 / 脑影像
- bonbid-hie — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
- crossmoda-2023 — 共享标签:医学影像 / 医学图像分割 / MRI / 多模态影像
- intra — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
- topcow — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
- brisc — 共享标签:医学影像 / 医学图像分割 / MRI / 脑影像
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
