信息速览
INFOBOX — HANCOCK 一屏速览
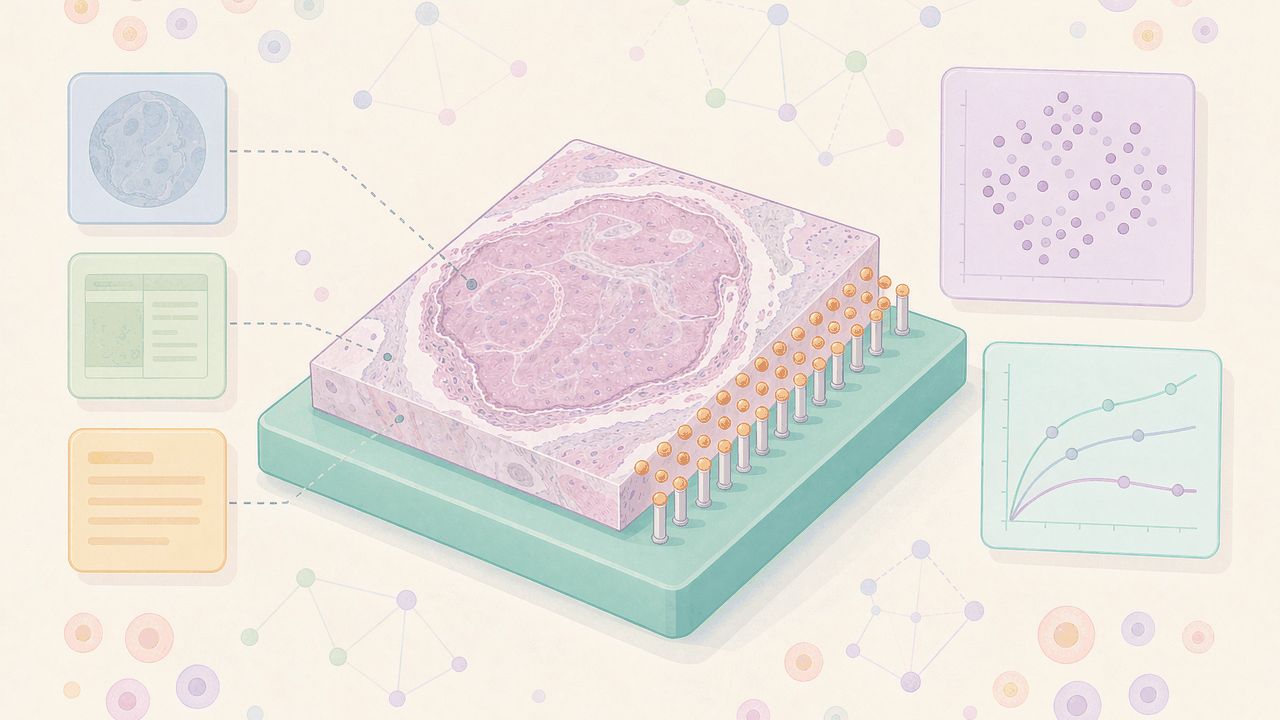
维度 内容 本质 单中心(FAU 埃尔朗根)多模态头颈癌真实世界数据集(非挑战赛本体,衍生 HANCOTHON) 名称 HANCOCK = Head And Neck Cancer dataset(页头 “Multimodal Head and Neck cancer dataset”) 论文 Nat Commun 16, 7163 (2025),doi:10.1038/s41467-025-62386-6(FAU OA 仓库 2025-08-04) 团队 FAU 生物医学工程 AI 系 + 埃尔朗根大学医院耳鼻喉-头颈外科;通讯 Andreas M. Kist 规模 763 例患者;TCIA 计数 13,684 图像 / 4.5 TB;诊断年份 2005-2019 病理 709 张原发肿瘤 H&E WSI(0.1213 µm/px)+ 396 张淋巴结 WSI + 8 染色 TMA(每例 2 芯) 临床 结构化人口学/肿瘤病理/实验室血液指标 文本 去标识手术报告(含 ICD/OPS)+ 病史;>98% 有病理报告 标注 WSI 肿瘤区域 GeoJSON + TMA 细胞密度 CSV 三模态 病理图像 + 结构化临床/血液 + 自由文本报告——库内头颈条目中唯一 基准 HANCOTHON(MICCAI 2025):5 年生存 / 2 年复发二分类,acc+F1 论文发现 多模态融合优于单模态(RF AUC 0.79);UNI 基础模型助终点预测(CLAM 肿瘤定位 AUC 0.96) 获取 TCIA(DOI 10.7937/rcty-5h16,需 Aspera)|FAU 门户 hancock.research.fau.eu 许可 数据 CC BY 4.0(强制 Data Citation);论文 CC BY 4.0;代码 GitHub+Zenodo 库内互链 headneck-radiomics(946)、hnpet-fdg(947)、head-neck-pet-ct(838)、orchid(903)、panda-plus(640)
HANCOCK 回答的是头颈癌 AI 研究里一个尴尬的空白:这个全球第七大常见恶性肿瘤、五年生存率仅约 25-60% 的病种,长期缺少一个"把病理图像、临床指标、实验室血液和自由文本手术报告全放在一起、还公开可下"的大规模数据集。此前的头颈癌公开资源要么是几百例的放射影像组学队列(只有 CT/PET),要么是多组学齐全却缺病理报告与血液检查的 TCGA。HANCOCK 用 763 例单中心真实世界队列、2005-2019 跨度、CC BY 4.0 完全开放,第一次把六类数据(结构化血液、结构化病理、结构化临床、英文文本、TMA 芯、WSI 嵌入)装进一个可下载的集合,并顺手办了一场 MICCAI 挑战赛来证明"融合多模态确实比单模态强"。
导语读法三则:
- 只想下数据建模:直奔 §6——注意 4.5 TB 体积与 Aspera 插件门槛,FAU 门户是更轻的入口。
- 关心它和库里头颈条目的区别:直奔 §9——库内三条目(946/947/838)全是放射影像组学,HANCOCK 是唯一的病理本体+文本三模态。
- 想复现基线或参赛:直奔 §5 与 §7——HANCOTHON 提供预抽 UNI 嵌入,论文基线数字可直接对标。
§0 导读:这个数据集解决什么问题
头颈癌(head and neck cancer, HNC)的治疗决策长期停留在"看分期":肿瘤多大、淋巴结有没有转移,决定切多少、要不要放疗。但同样是 III 期口咽癌,HPV 阳性患者与吸烟相关的阴性患者预后可以天差地别——分期这一把尺子量不准患者之间的生物学差异。要走向精准肿瘤学(precision oncology),需要的是可靠的预测性生物标志物,而寻找生物标志物的前提是能同时看到病理形态、临床变量、血液指标和手术记录,并观察它们如何共同决定结局。
现实是这类数据几乎是碎片化的。论文在引言里点名了三个"不够用"的既有资源:一个放射影像组学研究虽有 288 例,但只选了口咽癌一个亚部位;一个蛋白质组学数据集含影像却只有 122 例;TCGA 提供 500 余例头颈癌的多组学,却缺少每个患者的病理报告、血液检查与完整影像。缺的正是"同一个患者、多种模态、都齐全"这件事。
HANCOCK 的回应是一个单中心的真实世界队列。它从埃尔朗根大学医院 2005-2019 年间的头颈癌病例中,纳入所有接受根治性意向首程治疗的患者,取出口腔、口咽、下咽、喉四个亚部位共 763 例,然后把每个患者身上能拿到的六类数据——病理全切片、组织微阵列免疫组化、结构化临床、实验室血液、手术报告文本、病史文本——去标识后打包公开。论文的核心论证是双向的:一方面用实验证明"把这些模态融合起来用机器学习建模,优于任何一个单模态";另一方面证明"用基础模型(foundation model)抽取的病理图像特征,能帮助终点预测"。换言之,HANCOCK 不只是给数据,它还用两个实验示范了"该怎么用"。
§0 读法三则:
- 这个条目是"数据集 + 方法论文 + 挑战赛"三合一:本体是 763 例多模态数据,论文给出融合与基础模型两类基线,衍生品是 HANCOTHON 挑战赛——三者获取入口略有不同(§6、§7)。
- 全文规模数字以 TCIA 官方页与论文双口径为准:TCIA 表给 “763 subjects / 13,684 images / 4.5 TB”,论文按切片类型给分解数(709 原发 + 396 淋巴结 + TMA),两套口径在坑 3 存照。
- 检索时若把"HANCOCK"当作某个影像挑战赛去找会走偏——HANCOCK 是数据集本体,挑战赛叫 HANCOTHON(坑 1)。
§1 数据集速览:十问十答
Q1:HANCOCK 这个名字怎么来的?
它是 Head And Neck Cancer dataset 的首字母缩写,页头副标题写作 “Multimodal Head and Neck cancer dataset”。注意它同时是数据集名与项目代号,论文与 TCIA 页均用此名。
Q2:763 例从哪来?
全部来自德国埃尔朗根大学医院(University Hospital Erlangen),诊断年份 2005-2019,纳入标准是接受根治性意向首程治疗(手术和/或根治性治疗)的头颈癌患者,覆盖口腔、口咽、下咽、喉四个亚部位。排除姑息治疗与初诊即复发/转移的病例。这是一个单中心、回顾性、真实世界的连续队列。
Q3:队列的人群特征如何?
约 80% 男性、20% 女性;中位年龄 61 岁;约 72% 有吸烟史。论文称这一分布与头颈癌流行病学相符,支持一定程度的可推广性;但作为单中心数据集,地理多样性有限(坑 6)。
Q4:病理数据里到底有什么?
两类。第一类是全切片图像(WSI):709 张原发肿瘤 H&E 切片(701 例各一张、8 例两张,3DHISTECH P1000 扫描,82.44× 有效放大、0.1213 µm/px),外加 396 张淋巴结转移 H&E 切片(用 Aperio Leica GT450 @40× 与 P1000 @~51× 两套设备扫描)。第二类是组织微阵列(TMA):每例肿瘤块取两个 1.5 mm 芯(肿瘤中心 1 + 浸润前沿 1),用 8 种染色(H&E + CD3/CD8/CD56/CD68/CD163/PD-L1/MHC-1)分别切片,每例最多 16 张 TMA 图像。
Q5:临床和文本数据是什么?
结构化部分是人口学、肿瘤病理特征(分级、TNM 分期、HPV/PD-L1 状态等)、实验室血液指标(术前血常规、凝血、电解质、肾功能、C 反应蛋白等);非结构化部分是去标识的手术报告(含 ICD/OPS 代码)、病史与治疗时间线,以及长达 14 年的随访生存数据。
Q6:所有患者都齐全吗?
不是。论文坦承"并非每个患者都有每种模态":62 例因组织不可用而无原发肿瘤 WSI(故 763−62=701 例有 WSI);部分患者无淋巴结标本或某些实验室检查。整体而言关键模态完整度较高:全部有临床数据,>98% 有病理报告,约 92% 有 WSI。逐例缺失情况见论文 Figure S11。
Q7:有放射影像或基因组数据吗?
没有。当前 release 不含 CT/MRI/PET,也不含基因组/蛋白组——这些模态超出本数据集范围。论文特别说明数据结构是"可扩展的",为未来整合分子数据留了接口,但当前版本聚焦病理图像加临床数据。
Q8:许可与获取方式是什么?
数据为 CC BY 4.0,通过 TCIA(DOI 10.7937/rcty-5h16)与 FAU 数据门户(hancock.research.fau.eu)双通道公开。注意 TCIA 要求强制 Data Citation(引用义务),且 4.5 TB 下载需要 IBM Aspera Connect 插件。
Q9:怎么用它做研究?
论文示范了两条路径:一是把多模态特征融合后训练随机森林预测生存/复发(AUC 达 0.79,优于单模态);二是用 CLAM 多示例学习框架加 UNI 自监督基础模型处理 WSI/TMA(肿瘤定位 AUC 达 0.96)。HANCOTHON 挑战赛则提供了预抽取的 UNI 嵌入,降低图像侧门槛。
Q10:它和已有头颈数据集的关键区别是什么?
库内已有的头颈癌条目(headneck-radiomics 946、hnpet-fdg 947、head-neck-pet-ct 838)清一色是放射影像组学——只有 CT 或 PET/CT,没有病理本体。HANCOCK 的独特性在于它是库内头颈条目中唯一同时含病理 WSI + 结构化临床/血液 + 自由文本三模态的数据集(§9 详述)。
§2 数据构成与规格
2.1 规模、来源与机构构成
HANCOCK 的规模需要分清三个口径,避免张冠李戴:
| 口径 | 数字 | 来源 |
|---|---|---|
| 患者例数 | 763 | 论文摘要 / TCIA 页 / FAU 项目站一致 |
| TCIA 图像计数 | 13,684 images | TCIA Data Access 表 |
| 数据体积 | 4.5 TB | TCIA Data Access 表 |
| 原发肿瘤 H&E WSI | 709 张(701 例有) | TCIA 正文(Data Acquisition) |
| 淋巴结 H&E WSI | 396 张 | TCIA 正文 |
| WSI studies / series | 13 studies | TCIA Data Access 表 |
"763 例"口径最稳:论文摘要、TCIA 页头、FAU 项目站三处一致声明 763 例头颈癌患者。"13,684 images"是 TCIA 的 series 级图像计数,包含了 TMA 各染色切片与图像金字塔层级,不等于"切片张数"的简单加总——正文按切片类型单独给数(709+396+ TMA)。两套口径在坑 3 存照。
数据来源是单中心:德国埃尔朗根大学医院,诊断年份 2005-2019,纳入根治性意向首程治疗(curative-intent)患者,覆盖口腔、口咽、下咽、喉四个亚部位。论文强调"单中心"既是局限也是优势——采集与治疗语境高度一致,降低了数据质量方差,代价是地理与人群多样性受限。
2.2 病理图像:三种扫描仪与分辨率
HANCOCK 的病理图像分两条线,规格各不相同,建模时若不加区分会引入分辨率偏差:
原发肿瘤 H&E WSI(709 张):
- 扫描设备:3DHISTECH P1000
- 有效放大:82.44×
- 空间分辨率:0.1213 µm/pixel(高分辨率,细节丰富,但单张体量也大)
- 分布:701 例各一张,8 例各两张
淋巴结转移 H&E WSI(396 张):
- 扫描设备:两套——Aperio Leica GT450 @40×(0.2634 µm/px)+ 3DHISTECH P1000 @~51×(0.1945 µm/px)
- 论文说明项目期间使用了多台扫描仪,所有图像都做过质量交叉验证
格式:全切片图像以金字塔式 Aperio SVS(TIFF-based)提供,兼容标准查看器。
注意:原发与淋巴结的分辨率不同(0.1213 vs 0.2634/0.1945 µm/px),若把两类 WSI 直接送入同一个 patch 级别模型,patch 的物理尺度会不一致——这是使用前必须处理的工程细节(§8.3)。
2.3 组织微阵列(TMA)与免疫组化面板
TMA 是 HANCOCK 区别于纯 WSI 数据集的重要资产。对每个病例的肿瘤块:
- 取两个圆柱形芯(直径 1.5 mm):一个来自肿瘤中心,一个来自浸润前沿(invasive tumor front)
- 芯被组装进 TMA 块,用8 种染色分别切片:H&E + 七个免疫组化(IHC)标记
- IHC 面板靶向不同免疫细胞与肿瘤标志物:CD3、CD8(T 细胞)、CD56(自然杀伤细胞)、CD68、CD163(单核/巨噬细胞)、PD-L1(免疫检查点配体)、MHC-1(MHC I 类表达)
- 每个芯最多出现在 8 张染色切片上(每染色一张),因此每例最多 16 张 TMA 图像(2 芯 × 8 染色)
- TMA 图像统一显微镜设置、约 40×
论文提到,全部患者都有 TMA 芯图像(除非肿瘤块已耗尽)。TMA 的价值在于:WSI 提供宽广的组织语境,TMA 提供靶向的细胞级细节,两者互补。配合 TMA 附带的细胞密度测量 CSV(TMA_celldensity_measurement.csv),研究者可以直接做免疫微环境的定量分析。
一个容易被忽略的细节:TMA 免疫组化面板直接对应论文发现的"HPV 阳性口咽癌患者 CD8+ 细胞密度更高"这一亚群聚类现象(§5)。也就是说 TMA 不只是图像,它是把免疫微环境变成可计算特征的关键接口。
2.4 临床、血液与文本数据
结构化临床数据(全部患者有)包括:
- 人口学:年龄、性别、吸烟史
- 肿瘤病理特征:原发部位、分级、TNM 分期、HPV 状态、PD-L1 状态
- 治疗相关数据
结构化血液数据:术前血常规、凝血功能、电解质、肾功能参数、C 反应蛋白(CRP)等——这些是手术前的常规检验,被整理成可建模的表格。
去标识文本数据:
- 手术报告(含 ICD/OPS 代码)
- 病史摘要
- 治疗时间线
- 14 年随访生存数据(事件与时间)
论文口径:手术报告文本规模 N=742(转述自 Fig 1F,见坑 5);>98% 的患者有病理报告。文本为英文——HANCOTHON 挑战赛明确提供 “Text Data in English”。这一点值得注意:原始手术报告是德语的,HANCOCK 提供的是翻译/去标识后的英文文本,NLP 研究可直接使用。
2.5 目录结构与跨模态对齐
HANCOCK 的组织方式围绕一个匿名患者 ID展开,这是它工程上最实用的设计。同一个 ID 贯穿所有模态:
0050  →  JSON 条目(临床/血液)
0050_report.txt  →  文本报告
0050_primary_oropharynx.svs  →  WSI 图像
顶层目录(TCIA 组织):
| 目录 | 内容 |
|---|---|
| WSI_PrimaryTumor | 按亚部位分子目录(oral_cavity / oropharynx / hypopharynx / larynx)的 SVS |
| WSI_LymphNode | 淋巴结转移 WSI |
| TMA_TumorCenter | 肿瘤中心芯 TMA 图像 |
| TMA_InvasionFront | 浸润前沿芯 TMA 图像 |
| TMA_Maps | TMA 网格布局概览图(参考用) |
| Annotations and Mapping | TMA_celldensity_measurement.csv、TMA_Map_block1.csv 等 |
| WSI_PrimaryTumor_Annotations | 原发肿瘤 WSI 的肿瘤区域标注文件(GeoJSON) |
跨模态对齐靠文件名编码的患者 ID——研究者可以按 ID 把病理、临床、血液、文本四路数据 join 起来。这是多模态研究能落地的前提,也是 HANCOCK 相对"把几种数据分别发布"的既有资源的实际优势。
2.6 标注内容
HANCOCK 的标注有两类:
- 原发肿瘤 WSI 肿瘤区域标注:以 GeoJSON 格式提供(
WSI_PrimaryTumor_Annotations),标注肿瘤区域边界,供图像分析工作流定位感兴趣区域。 - TMA 细胞密度测量:CSV 文件(
TMA_celldensity_measurement.csv)+ TMA 映射表,是免疫组化切片的定量派生特征。
此外,HANCOTHON 挑战赛额外提供预抽取的嵌入:肿瘤中心 TMA 芯、原发肿瘤 WSI(UNI 生成)、淋巴结 WSI(UNI 生成)——这些不是原始标注,而是降低参赛门槛的预处理产物(§7)。
2.7 六模态数据流逐一拆解
HANCOTHON 把 HANCOCK 的数据归纳为六类数据流,这个分类比"病理/临床/文本"三分法更细,值得逐条展开,因为它直接对应建模时的输入设计。
数据流一:结构化血液数据
术前常规检验被整理成结构化表格:血常规(白细胞、红细胞、血红蛋白、血小板等)、凝血功能、电解质、肾功能参数、C 反应蛋白(CRP)。这些指标在临床上本就用于评估患者全身状况与手术耐受性,因此天然是多模态融合模型的一部分——它们携带的是"宿主状态"信息,与肿瘤本身的病理形态互补。在 HANCOTHON 的参赛数据中,血液数据是独立的一路输入。
数据流二:结构化病理数据
从病理报告中结构化的字段:原发部位、组织学分级、病理 T/N 分期、切缘状态、淋巴结转移数量等。这类数据是"肿瘤侵袭性"的浓缩表达。注意它与"结构化临床数据"的区别——病理数据来自显微镜下的组织学所见,临床数据来自病史与检查。
数据流三:结构化临床数据
人口学(年龄、性别)、吸烟史、临床 TNM 分期、HPV 状态、PD-L1 状态、治疗方式(手术/放疗/化疗及组合)。HANCOTHON 提供时会移除目标相关列以防标签泄漏。
数据流四:英文文本数据
去标识的手术报告与病史摘要的自由文本。这是 HANCOCK 相对多数头颈数据集最独特的一路——大多数公开头颈数据集只给结构化字段,不给原始文本。文本可支持:临床 NLP 研究、命名实体识别、报告自动结构化,以及直接作为多模态模型的文本输入。
数据流五:TMA 预抽取特征(肿瘤中心芯)
不是原始图像,而是从肿瘤中心芯 TMA 图像预抽取的特征向量。这一路对应"靶向细胞级细节"。
数据流六:WSI 预抽取嵌入(原发 + 淋巴结,UNI 生成)
用病理基础模型 UNI 从原发肿瘤 WSI 与淋巴结 WSI 抽取的嵌入向量。这是六路中处理成本最高的一路被主办方预先消化掉,使参赛者不必自己跑全切片推理。
一个建模视角的观察:六路数据流里,三路是结构化表格(血液/病理/临床)、一路是文本、两路是图像派生特征。这种"表格为主、文本与图像为增强"的结构,解释了为什么论文用随机森林(擅长表格)做融合基线而效果已可观——如果只有图像,故事就完全不同了。
2.8 亚部位构成与分期分布
论文称队列覆盖口腔、口咽、下咽、喉四个主要亚部位,“肿瘤亚部位与分期分布反映了典型的头颈癌表现”。这一表述有两层含义:
- 亚部位齐全:不像某些数据集只选单一亚部位(论文点名的放射影像组学研究只选了口咽癌),HANCOCK 覆盖了头颈癌的主要解剖学来源,这让它适合做泛头颈癌模型,而非"口咽癌专用"模型。
- 分期分布"典型":论文未在本条目可及的资料中给出逐分期例数表,但强调分布符合流行病学预期(多数患者为局部晚期可根治阶段,因为纳入条件是根治性意向首程治疗,因此不含IV期初诊转移)。
HPV/PD-L1 状态作为关键分子标志物被纳入结构化数据。HPV 状态尤其重要——它把口咽癌分成预后迥异的两类(HPV 阳性者预后显著更好),是头颈癌精准分层的核心变量。论文的 UMAP 分析正是发现了"HPV 阳性口咽癌患者 CD8+ 细胞密度更高"这一免疫学关联。
2.9 随访数据与结局变量
HANCOCK 含长达 14 年的随访生存数据,包含事件(死亡/复发)与时间。这支撑了两类结局建模:
- 5 年总生存(overall survival)二分类:以 5 年为界,患者是否存活
- 2 年复发(recurrence)二分类:以 2 年为界,是否复发
选择二分类而非连续时间生存分析(如 Cox 模型),是为了适配挑战赛的评测需要(accuracy/F1 比 C-index 更直观)。研究者若做生存分析,可利用原始的随访时间与事件数据自行构建设计。
随访 14 年 + 诊断年份 2005-2019意味着:最早的病例(2005)到数据整理时(约 2019-2023)已有充分随访,最晚的病例随访期相对短——存在右删失,生存分析时需处理(一般用 Kaplan-Meier 或带删失的模型)。这是使用随访数据时必须注意的统计细节。
2.10 数据体量拆解:4.5 TB 是怎么来的
4.5 TB 这个数字常被引用,却容易让人困惑——763 例、约 1,100 张 WSI(709 原发 + 396 淋巴结)加 TMA,怎么会到 TB 级?理解这一点有助于制定下载与存储策略。
WSI 是大头。全切片图像是 gigapixel 级图像,单张多层金字塔往往数百 MB 到 1-2 GB。约 1,105 张 WSI 乘以平均单张体量,即达 TB 级。原发肿瘤 WSI 分辨率最高(0.1213 µm/px),单张最大。
TMA 数量多但单张小。每例最多 16 张 TMA 图像(2 芯 × 8 染色),763 例理论上最多约 12,000 张,但每张是小的核心区图像(1.5 mm 芯),单张远小于 WSI。累积起来也是可观的一部分,尤其是 13,684 images 这一 TCIA 计数里 TMA 贡献了相当多的 series。
临床/血液/文本可以忽略体积。JSON、CSV、TXT 加起来通常只有几十到几百 MB,相对 4.5 TB 可忽略。
对使用者的含义:
- 只想做嵌入级建模 → 用 HANCOTHON 预抽嵌入,空间需求从 TB 降到 MB 级。
- 只想做某个亚部位 → 只下载对应子目录,避免全量。
- 想做全量图像研究 → 预留 4.5 TB 存储 + Aspera 传输。
2.11 六模态的数据完整度画像
模态缺失不是均匀分布的随机事件,而是有结构的。理解这个结构能避免建模时的隐性偏差:
| 模态 | 完整度 | 缺失原因 |
|---|---|---|
| 结构化临床 | 100% | 全部患者有 |
| 病理报告 | >98% | 极少数缺 |
| WSI | ~92%(701/763) | 62 例组织不可用 |
| 淋巴结标本 | 部分缺失 | 无淋巴结转移者可能无标本 |
| 某些实验室检查 | 部分缺失 | 非常规检验未必每人都有 |
| TMA | 多数有 | 肿瘤块耗尽的个案缺失 |
关键洞察:缺失本身可能携带信息。例如"无淋巴结标本"往往对应"无淋巴结转移",而"无淋巴结转移"是预后良好的信号。如果建模时把缺失当作纯噪声或直接丢弃样本,可能丢失有价值的信号,也可能引入选择偏差。更稳健的做法是把"是否缺失"作为一个显式特征(missing indicator),让模型自行学习其含义。
62 例无 WSI 的处理:这 62 例并非随机缺失(组织不可用可能与标本条件有关),若做图像模态建模时直接剔除,需意识到剩余 701 例可能在某种程度上"更适合制片"。这是使用任何医学影像数据集都需警惕的固有问题,HANCOCK 用 Fig S11 的透明披露至少让使用者在建模前就能知情。
2.12 与"全模态数据集"的概念区分
初学者常把 HANCOCK 与"全模态癌症数据集"混为一谈,需要澄清:
| 数据集 | 影像 | 病理 | 临床 | 文本 | 组学 |
|---|---|---|---|---|---|
| HANCOCK | ✗ | ✓ | ✓ | ✓ | ✗ |
| TCGA | 部分 | ✓ | ✓ | 部分 | ✓ |
| headneck-radiomics(946) | ✓(CT) | ✗ | ✓ | ✗ | ✗ |
| hnpet-fdg(947) | ✓(PET/CT) | ✗ | ✓ | ✗ | ✗ |
HANCOCK 是病理 + 临床 + 文本三模态,明确不含放射影像(论文原文:“No radiology imaging… or genomic/proteomic profiles are included in the current release”)。它补的是"病理报告、血液、文本"这块 TCGA 也缺的空白,而非"全模态"。需要放射影像的研究必须转向库内 946/947/838 等影像组学条目。
2.13 单位与口径换算速查
多模态研究常在不同单位间换算,HANCOCK 涉及的关键换算:
- 放大倍数 vs 分辨率:原发 WSI 82.44× 对应 0.1213 µm/px;淋巴结 WSI 40× 对应 0.2634 µm/px、~51× 对应 0.1945 µm/px。注意放大倍数与 µm/px 是反比关系(放大越大,每像素代表的物理尺寸越小)。
- patch 物理尺度:若取 256×256 pixel 的 patch,在原发 WSI 上对应物理尺寸约 256×0.1213 ≈ 31 µm;在 40× 淋巴结 WSI 上约 256×0.2634 ≈ 67 µm——同样像素数,物理尺度差一倍多。这是跨类型建模必须归一化的原因。
- TMA 芯尺寸:直径 1.5 mm,约等于 1,500 µm;在 ~40× TMA 图像上换算为像素数可估算芯的覆盖范围。
§3 采集与去标识:数据是怎么被合规化的
3.1 伦理与去标识
HANCOCK 是回顾性数据采集与共享,伦理批准编号 #23-22-Br(埃尔朗根伦理委员会)。论文明确:所有数据在发布前完全去标识(fully de-identified)。这是它能以 CC BY 4.0 完全开放的前提——去标识化到位,才能谈开放许可。
值得强调的是时间线:诊断年份跨度是 2005-2019,但伦理批准编号 #23-22 指向 2022-2023 年——也就是说,这批 2005 年起的历史病例是事后回顾性地整理、去标识、获批共享的。这解释了一个常见的困惑:“为什么 2005 年的病例能公开”。
3.2 纳入与排除标准
纳入:2005-2019 年于埃尔朗根大学医院诊断为头颈癌、接受根治性意向首程治疗(手术和/或根治性治疗)的患者。
排除:姑息治疗患者;初诊时即为复发/转移性疾病患者。
论文辩解称这是"以首程可根治治疗为焦点"的设计,除排除非根治病例外未引入显著选择偏差——因为纳入期内所有主要头颈癌亚部位的病例都被收进来了,构成一个全面的真实世界样本。这一自评需要结合单中心局限一起看(坑 6)。
3.3 多扫描仪的品控
一个常被忽视的工程细节:淋巴结 WSI 用了两套扫描仪(Aperio Leica GT450 @40× 与 3DHISTECH P1000 @~51×),说明项目横跨多年、设备更替。论文声明"所有图像都做过质量交叉验证"。对使用者的含义是:如果直接把两批淋巴结 WSI 混在一起训练,需要处理设备带来的域偏移(domain shift)——这是真实的工程约束,不是理论担忧。
§4 论文的核心发现:为什么多模态值得
4.1 多模态融合优于单模态
论文的核心论点是用实验证明的:把这些模态用机器学习组合起来,效果优于任何一个单模态。具体地,论文报告了一个随机森林(random forest)多模态融合模型,在生存与复发预测上达到 AUC 0.79,显著优于单模态分析。
这个数字的意义不在于它有多高(0.79 是中等水平),而在于它证明了"信息确实分散在不同模态里"——如果病理图像自己就够了,融合不会有增益。反过来说,它也说明单个模态(无论多强的图像模型)都存在天花板。
4.2 基础模型帮助终点预测
第二个论点是:用基础模型(foundation model)整合影像数据有助于终点预测。具体做法是:
- 采用 CLAM(一种多示例学习 MIL 框架)处理 WSI 与 TMA
- 用 UNI(病理学自监督基础模型)抽取图像特征
- 在肿瘤定位任务上,CLAM+UNI 达到 AUC 0.96
同时论文报告了一个有意思的发现:在预测生存时,H&E 染色组织贡献最大——也就是说,普通 H&E 切片承载了比预期更多的预后信息,不必依赖特殊染色即可挖掘。
读法的提醒(§4.5):这些数字(0.79 / 0.96)出自论文自身的首次分析,是原作者在自家数据上的基线,未经独立复现,也不能直接跨数据集对标。它们的作用是"示范怎么用",而非"这个任务已达到 X 水平"。
4.3 低维嵌入揭示患者亚群
论文用 UMAP 把高维多模态患者向量降到二维,揭示了患者亚群的聚类规律。一个被中文媒体转述的具体观察是:HPV 阳性口咽癌患者的 CD8+ 细胞密度更高——这与免疫学预期一致(HPV 相关肿瘤通常有更强的免疫浸润),也从侧面验证了 TMA 免疫组化数据的可用性。
UMAP 可视化的价值在于:它把"多模态数据是否真的携带互补信息"从一个抽象的论证变成一张可以看的图。如果模态间冗余,患者点在二维图上不会形成有意义的聚类;实际形成的结构说明不同模态提供了互补的信号。
4.4 与既有资源的对照
论文在引言中明确对比了三个"前人不够用"的资源:
| 既有资源 | 局限(论文口径) |
|---|---|
| 某放射影像组学研究 | 288 例,但只选口咽癌单一亚部位 |
| 某蛋白质组学数据集 | 含放射与病理,但仅 122 例 |
| TCGA | 500+ 例头颈癌多组学,但缺病理报告、血液检查与完整影像 |
HANCOCK 的定位正是在这个空白处:单中心但模态齐全,763 例,公开可下。这不是"比谁大"的竞争,而是"比谁齐"——在模态完整性这个维度上,它补上了 TCGA 都缺的那一块。
4.5 统计卫生:读这组数字的四条守则
- 区分"作者基线"与"领域 SOTA":0.79 / 0.96 是论文在自家数据的示范,不是排行榜成绩,跨研究比较需谨慎。
- 注意任务定义:论文/挑战赛的生存任务是"5 年总生存二分类",复发任务是"2 年复发二分类"——是离散二分类而非生存分析(C-index),不能与其他论文的 C-index 直接比。
- 样本量约束:763 例做多模态融合,特征维度稍高就容易过拟合;论文用随机森林(相对稳健)而非深度网络,这一选择本身值得注意。
- 单中心泛化缺口:所有数字都在同一中心数据上得出,外部队列验证尚未进行——这是论文自承的局限,也是后续研究的机会。
§5 HANCOTHON:从数据集到挑战赛
5.1 动机与定位
HANCOCK 不仅是一个数据集,还衍生了 HANCOTHON 挑战赛——名字是 HANCOCK + Hackathon/Marathon 的合成词,与 MICCAI 2025(第 28 届医学图像计算与计算机辅助干预会议,2025-09-23 至 09-27,韩国)同期举办。挑战赛的核心洞察是:临床医生在决策时本就综合多种来源的信息,而经典 AI 工具因依赖单一数据源在复杂临床场景中往往力不从心。HANCOTHON 邀请参赛者整合六类数据流,逼近真实临床决策的多模态本质。
挑战赛定义的两个二分类任务:
| 任务 | 目标 | 临床意义 | 评测指标 |
|---|---|---|---|
| 任务一 | 5 年总生存预测 | 辅助治疗与辅助疗法决策 | accuracy、F1 |
| 任务二 | 2 年复发风险预测 | 确定随访监测间隔 | accuracy、F1 |
两任务共享同一批数据,独立评测。
5.2 提供给参赛者的数据形态
HANCOTHON 的参赛数据设计降低了图像侧门槛——主办方预抽取了嵌入,参赛者不必自己跑 WSI 推理:
- 结构化血液数据
- 结构化病理数据
- 结构化临床数据(移除目标相关列)
- 英文文本数据
- 肿瘤中心芯 TMA 的预抽取特征
- 原发肿瘤 WSI 的 UNI 嵌入
- 淋巴结 WSI 的 UNI 嵌入
参赛者可自由决定使用哪些模态组合,以得到最优解。这一设计本身就是论文"多模态融合"论点的延伸实验:把"该用哪些模态"变成一个可以被参赛者用实验回答的开放问题。
5.3 组织与激励
- 平台:Grand Challenge 托管,最终方案在线评测
- 奖金(仅封闭开发阶段):每个任务第一名 200€、第二名 150€、第三名 50€
- 规则细节:与主办方同部门成员可参赛但无获奖资格;开放开发阶段仅用于平台内测试算法
- 时间:2025-09-27 于 MICCAI 2025 现场举行挑战赛 session(韩国,Room IBS-3F-R1-R3)
- 计划:主办方拟协调发表一篇总结挑战赛主要方法学与洞见的论文
一个务实的读法:HANCOTHON 的奖金很小(数百欧量级),它的真实价值不是奖金,而是提供了一个标准化的多模态头颈癌评测场景。参赛队伍(如 HANCOCK-FUSe、HCAT-FusionNet 等提交)的方法会在同一个数据与指标下可比,这比零散的论文报告更有参考价值。
§6 获取与许可:两条公开通道
6.1 双通道获取
HANCOCK 的数据通过两条官方通道公开,互为备份:
通道一:TCIA(The Cancer Imaging Archive)
- 地址:
https://www.cancerimagingarchive.net/collection/hancock/ - DOI:10.7937/rcty-5h16(引用时使用)
- 版本:Version 1,Updated 2025/12/12
- 条件:强制 Data Citation(必须引用且含 DOI);遵守 TCIA Data Usage Policy
- 技术门槛:4.5 TB 下载需要 IBM Aspera Connect 插件(高吞吐传输工具,普通浏览器下载不现实)
- 计数:763 subjects、13,684 images、13 studies、13,684 series、4.5 TB
通道二:FAU 数据门户
- 地址:
https://hancock.research.fau.eu/ - 功能:Explore(交互式浏览队列统计、逐患者记录、切片查看)+ Download(经 FAU data cloud 批量下载)
- 论文称数据集"最初即通过该门户提供",是数据集的原始发布点
- 网站含术语表(terminology page)以澄清字段含义
6.2 获取实操要点
- 先轻量探索再重下载:用 FAU 门户的 Explore 页先确认数据形态与字段是否符合研究需求,避免为 4.5 TB 白等。
- Aspera 是硬门槛:TCIA 通道要装插件;若团队环境不允许,优先走 FAU 门户。
- 引用义务不能省:CC BY 4.0 本身只要求署名,但 TCIA 额外要求引用指定 DOI(10.7937/rcty-5h16),发表论文时务必带上。
- 命名规范先读:TCIA Usage Notes 说明文件名编码患者 ID 的约定,跨模态 join 前先按其规范解析(§2.5)。
- 模态可用性别假设:先查某患者是否有 WSI(62 例没有)与淋巴结标本,避免建模时踩空(§5 论文 Fig S11)。
6.3 license 的双口径存照
- 数据:CC BY 4.0(TCIA 页与本数据双确认)
- 论文:CC BY 4.0(FAU 开放获取仓库明示
creativecommons.org/licenses/by/4.0/) - 第三方转述误差:EMJ(European Medical Journal)的案例稿写 “each article is made available under the terms of the Creative Commons Attribution-Non Commercial 4.0 License”——写成 CC BY-NC 4.0,与官方声明的 CC BY 4.0 不一致。以论文与数据官方声明为准,EMJ 口径标记为转述误差(坑 4)。
- 代码:GitHub
ankilab/HANCOCK_MultimodalDataset+ Zenodo 快照 DOI 10.5281/zenodo.15288559
为什么这个双口径重要:CC BY 4.0 与 CC BY-NC 4.0 在商用许可上差异巨大——前者允许商业使用,后者禁止。任何打算用 HANCOCK 做商业模型训练的团队,必须按官方 CC BY 4.0 理解,但应在合规文档中注明曾见过 NC 的转述口径并已核实,以免争议。
6.4 与库内可获取性光谱的对照
| 数据集 | 许可 | 获取方式 | 门槛 |
|---|---|---|---|
| HANCOCK | CC BY 4.0 | TCIA(Aspera)/ FAU 门户双通道 | 中等(体积 4.5 TB + 插件) |
| headneck-radiomics(946) | CC BY-NC 3.0(TCIA 口径) | TCIA 直接下载 | 低 |
| hnpet-fdg(947) | TCIA 条款 | TCIA | 低 |
| head-neck-pet-ct(838) | TCIA 条款 | TCIA | 低 |
| panda-plus(640) | 三层异构(掩码请求制) | Kaggle + 邮件申请 | 高 |
HANCOCK 在可获取性上的定位是"许可最宽松(CC BY 4.0,允许商用)+ 体积最巨大"——它把合规成本降到最低,却把工程成本(下载与存储)抬到较高。这与 panda-plus 恰好相反(许可最严但体积小)。
§7 生态、方法与互链
7.1 在头颈癌数据集景观中的位置
头颈癌 AI 数据集长期被三类资源占据:放射影像组学队列(CT/PET,样本量几百)、多组学资源(TCGA,缺病理报告与血液)、小型专用集(数十到百余例)。HANCOCK 的差异化定位是模态完整度:它是少数同时提供病理图像 + 结构化临床 + 血液 + 自由文本的公开数据集,且规模达到 763 例、许可为最宽松的 CC BY 4.0。
它的单中心属性是把双刃剑(坑 6):数据质量方差小、治疗语境一致,但地理多样性缺失。论文自己把它当作"真实世界单中心队列"来定位,而非"泛化性验证集"。
7.2 代码生态与可复现性
- GitHub:
github.com/ankilab/HANCOCK_MultimodalDataset——包含数据清洗、绘图、模型训练脚本,README 提供环境搭建与结果复现教程 - Zenodo 快照:DOI
10.5281/zenodo.15288559——代码的归档版本,保证长期可引 - 论文称代码"不是使用数据所必需,但可作为参考实现"
这一组合(GitHub 活跃 + Zenodo 归档)符合 FAIR 原则中的可复现性要求,也是它比许多"只发数据不发代码"的医学数据集更实用的地方。
7.3 方法学启示:三点可迁移经验
- "预抽嵌入"降低多模态门槛:HANCOTHON 把 WSI 用 UNI 预抽成嵌入后再开放,让不擅长图像工程的团队也能参与多模态研究。这是一种可复制的"降低入场成本"设计。
- 跨模态文件名对齐是基础设施:用统一的匿名患者 ID 贯穿所有模态文件,看似简单,却是多模态研究能否顺利 join 的关键。HANCOCK 把它做成了硬规范。
- 模态可用性要显式披露:论文用 Fig S11 逐例列出模态缺失,而不是假装数据齐全。这种透明度让使用者在建模前就能知道哪些患者可以用哪些模态。
7.4 库内互链点
| 条目 | rid | 关系类型 |
|---|---|---|
| headneck-radiomics(HEAD-NECK-RADIOMICS-HN1) | 946 | 同病种(头颈鳞癌)不同模态:MAASTRO 137 例放疗 CT,纯放射影像组学 |
| hnpet-fdg(ACRIN 6685) | 947 | 同病种不同模态:260 例 FDG-PET/CT,核医学影像 |
| head-neck-pet-ct | 838 | 同病种不同模态:298 例治疗前 PET/CT 四中心 |
| orchid | 903 | 同为头颈区病理 WSI:口腔癌 150 例 patch,但是 patch 级别无 WSI 本体无文本 |
| panda-plus | 640 | 同为病理 WSI + 像素级标注:前列腺癌,方法论参照 |
| tiger | 26 | 病理 WSI 挑战赛参照 |
| tcga | 566 | 多组学对照:论文明确对比的既有资源 |
| aacr-genie | 403 | 临床基因组学数据对照 |
关键差异化声明:库内头颈癌条目中,只有 HANCOCK 同时具备病理 WSI 本体 + 结构化临床/血液 + 去标识自由文本三模态;946/947/838 均为放射影像组学(无病理本体),orchid 为 patch 级病理(无文本无临床本体)。这一"三模态齐全"是 HANCOCK 在库内的独占性定位(§9 展开)。
7.5 与相邻病种数据集的方法论对照
把 HANCOCK 放在"多模态肿瘤数据集"的大图景里,它的独特之处会更清楚:
- 相对 TCGA(566):TCGA 是"广度优先"——覆盖数十种癌种、每种多组学,但每个癌种的病理报告与血液数据不齐。HANCOCK 是"深度优先"——只做头颈癌,但把这个病种的病理、临床、血液、文本做全。两者不是替代关系,而是互补的两种数据哲学。
- 相对 panda-plus(640):panda-plus 是"标签质量优先"——同样是病理 WSI,但核心贡献是把切片级标签升级为像素级掩码,批判原数据集标签噪声。HANCOCK 是"模态广度优先"——不重标注,而是把多种数据源整合。二者代表病理数据集的两种升级路径。
- 相对 headneck-radiomics(946) / hnpet-fdg(947) / head-neck-pet-ct(838):这三条都是"单一模态深挖"(CT 或 PET 的影像组学特征工程)。HANCOCK 是"多模态融合"。在同病种里,它们构成了从"看见肿瘤"到"综合患者全貌"的谱系。
7.6 复现风险清单
复现 HANCOCK 论文结果时,有几个环节容易出错:
- UNI 版本:基础模型有版本迭代,不同版本嵌入不同。论文/HANCOTHON 用特定版本的 UNI,复现时需对齐版本,否则嵌入数值不可比。
- 缺失处理策略:论文如何处理 62 例无 WSI,会显著影响结果。若你的策略与论文不同,数字对不上属正常。
- 随机种子与划分:763 例的划分(训练/验证/测试比例与随机种子)对 AUC 影响可观,尤其小样本多模态融合对划分敏感。
- 文本预处理:手术报告的英文文本如何分词、去停用词、向量化,直接影响文本模态的贡献。
- 类别不平衡:生存/复发二分类的正负样本比未在摘要明示,若不平衡,需检查是否用了合适的指标与重采样。
建议:先跑通官方 GitHub/Zenodo 代码的参考实现,再改动;不要一上来就自定义整个流程,否则无法判断差异来自数据还是来自你的实现。
7.7 应用场景清单
基于 HANCOCK 的模态构成,它的现实应用场景包括:
| 场景 | 用到的模态 | 说明 |
|---|---|---|
| 多模态生存预测 | 全部六模态 | 论文核心示范(AUC 0.79 基线) |
| 复发风险分层 | 病理+临床+血液 | 指导随访间隔 |
| 免疫微环境分析 | TMA + 临床(HPV) | CD8+ 密度与 HPV 状态关联 |
| 临床 NLP | 文本 | 报告结构化、实体识别 |
| 基础模型评测 | 病理 WSI | 用头颈癌数据评测病理基础模型泛化 |
| 图像-文本对齐 | 病理+文本 | 报告与切片的多模态对齐研究 |
| 缺失模态鲁棒性 | 全部(含缺失) | 真实世界模态缺失下的建模方法研究 |
7.8 与真实临床工作流的接点
HANCOCK 的价值不止于机器学习基准,它还映射了真实的头颈癌诊疗决策链:
- 术前评估:血液检验 + 病史 + 影像(后者 HANCOCK 不含)→ 评估手术耐受性
- 手术:切除原发灶与淋巴结 → 产生手术报告(文本)与标本
- 病理:制片、H&E 与免疫组化 → WSI 与 TMA
- 决策:综合病理分期、切缘、分子标志物(HPV/PD-L1)→ 决定辅助治疗
- 随访:长期生存与复发监测 → 结局数据
HANCOCK 覆盖了这条链上的第 1-3 步与第 5 步的数据(缺第 1 步的影像),因此它建模的正是"从术前到术后决策"的信息流。这也是论文标题"precision oncology(精准肿瘤学)"的落点——不是某一步的自动化,而是把整条链的信息整合起来做个性化决策。
§8 质量评估:DAIMS 全表与坑点档案
8.1 DAIMS 评估
DAIMS(Data And Information Management Score)从五个维度评估数据集的信息管理成熟度,评分 1-10:
| 维度 | 评分 | 依据 |
|---|---|---|
| D 可发现性(Discoverability) | 8 | TCIA 官方集合页 + FAU 项目站 + Nature Communications 论文 + Zenodo 代码快照四重索引;DOI 清晰(数据 10.7937/rcty-5h16 / 论文 10.1038/s41467-025-62386-6);GitHub 活跃 |
| A 可获取性(Accessibility) | 7 | CC BY 4.0 完全开放(允许商用,库内最宽松);FAU 门户无门槛浏览。扣分项:4.5 TB 体积 + TCIA 需 Aspera 插件 |
| I 可互操作(Interoperability) | 8 | 标准格式(Aperio SVS/PNG/CSV/GeoJSON/JSON);统一匿名患者 ID 贯穿全模态;术语表澄清字段;无 DICOM 病理封装略降 |
| M 元数据质量(Metadata) | 9 | 论文详细描述采集/规格/缺失;Fig S11 逐例模态可用性;TCIA Usage Notes 完整;字段命名规范清晰——医学数据集中上乘 |
| S 可持续性(Sustainability) | 8 | TCIA(NIH 资助的长期档案)+ FAU 机构门户 + Zenodo 归档三重保障;BMBF 资助编号可追溯 |
| 综合评级 | 8.0/10(优秀) | CC BY 4.0 + 多机构长期托管 + 高质量元数据是其强项;体积与下载工程门槛是唯一明显失分 |
8.2 坑点档案(八个已踩过的坑)
坑 1:"HANCOCK"不是挑战赛名。检索时若把 HANCOCK 当作某个影像挑战赛去找会走偏——HANCOCK 是数据集本体,其衍生挑战赛叫 HANCOTHON(HANCOCK + Marathon),于 MICCAI 2025 举办。两者名字不同、承办平台不同(数据集在 TCIA/FAU,挑战赛在 Grand Challenge)。
坑 2:三个数字口径混用。"763 例"是患者数、"13,684"是 TCIA 的 series 级图像计数(含 TMA 各染色切片与金字塔层级)、“4.5 TB"是总体积。这三个数字不能互换使用,尤其不能把 13,684 说成"切片张数”——正文按类型给数是 709 原发 + 396 淋巴结 + TMA。
坑 3:图像计数口径不可简单加总。TCIA Data Access 表的 “13,684 images” 与正文分解数(709+396+TMA 多染色)不相等,因为 TCIA 计数是 series 级(每个染色切片、每个不同扫描批都是独立 series)。引用时须注明口径,不要在正文里做"709+396=X"式的加总断言。
坑 4:license 双口径(CC BY vs CC BY-NC)。论文与数据官方声明均为 CC BY 4.0,但 EMJ 案例稿写成 CC BY-NC 4.0。差异涉及商用许可,必须按官方 CC BY 4.0 理解。见 §6.3。
坑 5:文本规模 N=742 是转述口径。"742 份手术报告"出自中文媒体(X-MOL)对论文 Fig 1F 的转述,非直接读原文图获得。引用时标注为转述口径,不要当作论文摘要的硬声明。
坑 6:单中心 ≠ 可直接泛化。HANCOCK 全部来自埃尔朗根大学医院一个中心(约 80% 男性、中位 61 岁)。论文自承"地理多样性有限"。用它训练/评测模型时,跨机构泛化是未验证的假设,不要默认结论可迁移。
坑 7:62 例无 WSI,模态不齐是常态。763 例中 62 例因组织不可用而无原发肿瘤 WSI(故 701 例有);部分患者无淋巴结标本或某些检验。若建模时假设"人人有 WSI",会丢失约 8% 的样本或引入偏差——务必先按 Fig S11 核对模态可用性。
坑 8:无放射影像与组学,别指望多模态全景。当前 release 不含 CT/MRI/PET,也不含基因组/蛋白组。若研究需要影像组学或分子模态,HANCOCK 无法满足——它是"病理 + 临床 + 文本"三模态,不是全模态。需要放射影像的应转向库内 946/947/838 等影像组学条目。
§9 与库内条目的关系
9.1 头颈癌条目家族图谱
本库已有三条头颈癌数据集,全部是放射影像组学方向;HANCOCK 的加入补上了病理 + 文本这一空白:
| 条目 | rid | 病种 | 模态 | 规模 | 与 HANCOCK 的关系 |
|---|---|---|---|---|---|
| headneck-radiomics | 946 | 头颈鳞癌 | 放疗 CT 影像组学 | 137 例 | 同病种,纯影像组学,无病理/文本 |
| hnpet-fdg | 947 | 头颈鳞癌 | 术前 FDG-PET/CT | 260 例 | 同病种,核医学影像,无病理/文本 |
| head-neck-pet-ct | 838 | 头颈癌 | 治疗前 PET/CT | 298 例 | 同病种,多中心影像,无病理/文本 |
| HANCOCK | 本条目 | 头颈鳞癌 | 病理 WSI+TMA + 临床血液 + 文本 | 763 例 | 库内头颈唯一三模态齐全 + 规模最大 |
9.2 HANCOCK 的独特性(逐条说明)
针对主会话"逐一比对并说明独特性"的要求:
-
相对 headneck-radiomics(946):946 是 MAASTRO 的 137 例放疗 CT 影像组学(Aerts 2014 泛癌种 radiomics 的 H&N1 数据源),只有 CT 与放射组学特征。HANCOCK 不含 CT,但含 709+396 张病理 WSI——两者模态完全不重叠,是同一病种的两条互补技术路线(放射影像组学 vs 计算病理)。HANCOCK 规模也大 5.6 倍。
-
相对 hnpet-fdg(947):947 是 ACRIN 6685 试验的 260 例 FDG-PET/CT,聚焦 cN0 颈部阴性预测。HANCOCK 无 PET。二者唯一交集是"头颈鳞癌"病种标签,模态正交。
-
相对 head-neck-pet-ct(838):838 是蒙特利尔/舍布鲁克四中心 298 例治疗前 PET/CT 影像组学。它反而多中心(4 个),HANCOCK 是单中心(1 个)——这一点上 838 泛化性设计更好,但 HANCOCK 模态更全、规模更大、许可更宽(CC BY 4.0 vs TCIA 条款)。
-
相对 orchid(903):903 是口腔癌 150 例 512×512 病理 patch(印度五中心)。同为头颈区病理,但 orchid 是 patch 级(无 WSI 本体)、无临床/血液/文本。HANCOCK 提供全切片 WSI 本体 + 完整临床文本栈,粒度与模态丰富度都高一档。
-
核心独占点:库内头颈癌条目中,只有 HANCOCK 同时具备①病理 WSI 本体 ②结构化临床与血液 ③去标识自由文本三模态。这是它不可被 946/947/838/903 任何一条替代的定位。
9.3 跨病种方法论互链
- panda-plus(640):同属病理 WSI + 高质量标注的"重标注/方法论"型数据集,是 HANCOCK 在"病理图像数据工程"维度的方法参照(但 panda-plus 是前列腺癌、像素级掩码、请求制许可)。
- tcga(566):论文明确对比的既有资源——TCGA 多组学齐全但缺病理报告与血液;HANCOCK 恰在此处补位。
- tiger(26):同为病理 WSI 挑战赛生态的参照。
9.4 检索路径建议
- 要病理 WSI + 临床/文本多模态(头颈) → HANCOCK(本条目)
- 要头颈癌放射影像组学(CT/PET) → headneck-radiomics(946) / hnpet-fdg(947) / head-neck-pet-ct(838)
- 要口腔癌病理 patch 分类 → orchid(903)
- 要病理 WSI + 像素级标注方法论 → panda-plus(640)
- 要头颈癌多组学 → tcga(566)
9.5 HANCOCK 对库内头颈条目家族的补充价值
库内已有的头颈癌条目(946/947/838)全部聚焦放射影像(CT/PET),或为影像组学特征工程取向。这一族条目共同回答"如何从医学影像中提取可预测的定量特征"。HANCOCK 的加入补上了另一条主线——计算病理与多模态整合:
- 从影像类型看:946/947/838 是宏观影像(器官/肿瘤整体),HANCOCK 是微观病理(细胞/组织)。
- 从任务看:前者偏影像组学与诊断,后者偏预后预测与多模态融合。
- 从数据形态看:前者以 DICOM+特征表为主,后者以 WSI/TMA+临床+文本为主。
因此 HANCOCK 不是"又一个头颈癌数据集",而是把库内头颈条目家族从"放射影像单向"扩展为"放射 + 病理 + 文本多向"的关键一块。
9.6 跨模态组合研究的机会
HANCOCK 与其他库内条目的交集不在数据(无直接重叠样本),而在研究方向的衔接:
- 放射组学特征 + 病理 WSI:理论上的"宏观-微观"融合,但 HANCOCK 无放射影像,需匹配同病种的其他队列(如 946)做间接组合或方法论迁移。
- 多模态融合方法论迁移:HANCOCK 论证的"融合优于单模态"可迁移到库内其他多模态条目做验证。
- 基础模型跨病种评测:HANCOCK 的病理 WSI 可用于评测在 panda-plus(640) 等前列腺病理数据上训练的基础模型的跨病种表现。
9.7 检索去混淆提示
库内与"HANCOCK"易混淆的检索项:
| 检索词 | 实际指向 | 澄清 |
|---|---|---|
| hancock | HANCOCK 数据集(本条目 url_name 加 hnscc 后缀) | 病种头颈鳞癌 |
| hancothon | HANCOCK 挑战赛 | 非数据集本体 |
| headneck-radiomics | rid 946 | 同病种放射影像组学 |
| hnpet-fdg | rid 947 | 同病种 PET |
| head-neck-pet-ct | rid 838 | 同病种 PET/CT |
| orchid | rid 903 | 口腔癌病理 patch(不同病种细类) |
§10 避坑与使用建议合集
- 先探索后下载:4.5 TB 不是小数目,用 FAU 门户 Explore 页先确认数据符合需求。
- 模态可用性建模:用 Fig S11 逻辑逐例核对可用模态,别假设齐全。
- 分辨率归一化:原发 WSI(0.1213 µm/px)与淋巴结 WSI(0.2634/0.1945 µm/px)分辨率不同,跨类型建模需物理尺度对齐。
- 设备域偏移:淋巴结 WSI 来自两套扫描仪,混合训练需考虑域适应。
- 引用合规:发表时带上 TCIA DOI(10.7937/rcty-5h16)与论文 DOI(10.1038/s41467-025-62386-6)。
- 任务定义看清:生存/复发是二分类(5 年/2 年),非生存分析的 C-index,别跨口径比较。
- 泛化谨慎:单中心结论,外推需外部验证。
- 商用核对:按官方 CC BY 4.0 理解(允许商用),但注明曾见 CC BY-NC 转述口径并已核实。
§11 深度专题:多模态融合为什么难,HANCOCK 如何示范
11.1 多模态融合的三类难题
HANCOCK 论文的"融合优于单模态"结论看似平凡,实则触及多模态学习的三个硬问题:
难题一:模态缺失(missing modality)。真实临床数据里模态几乎不齐——HANCOCK 里 62 例无 WSI、部分患者无淋巴结标本。一个只接受"完整四模态"输入的模型会丢掉大量样本;而一个能处理缺失的模型架构设计难度陡增。论文用 Fig S11 显式披露缺失,正是提醒使用者:融合模型必须内置对缺失的鲁棒性。
难题二:模态异质性(modality heterogeneity)。表格数据(数字/类别)、文本(词序列)、图像(像素/嵌入)的数据结构完全不同,特征尺度与语义空间不可比。随机森林之所以好用,是它天然吃表格、且对特征尺度不敏感;但把文本与图像塞进随机森林需要先降维成低维向量——这本身就是信息损失。
难题三:样本量约束。763 例做多模态融合,特征维度稍高就容易过拟合。这正是论文用随机森林而非大型深度多模态网络的现实考量——不是不能上深度模型,而是 763 例的样本量支撑不起参数巨大的融合网络。HANCOTHON 让参赛者用预抽嵌入,也部分是为了缓解这一约束(把图像侧复杂度降到"读嵌入")。
11.2 HANCOCK 的示范价值
HANCOCK 示范的是一种务实的多模态研究范式:
- 先证明信息互补,再追求架构先进:论文用简单融合(随机森林)证明"信息确实分散在不同模态",这个发现本身比任何复杂架构都重要。如果简单融合就能拿到增益,说明数据里有多模态信号,值得投入更复杂的方法。
- 把预处理标准化下沉:HANCOTHON 把 UNI 嵌入预抽好再开放,让参赛者聚焦"融合策略"而非"图像工程"。这是一种分工设计——不是所有团队都要会跑 WSI 推理。
- 显式披露缺失与不齐:不假装数据齐全,而是用图表逐例列出,让使用者能做出知情的方法选择。
11.3 基础模型的角色
HANCOCK 论文的第二个论点是"基础模型帮助终点预测"。具体链条是:UNI(病理自监督基础模型)把 WSI 抽成有语义的嵌入 → CLAM(多示例学习)在嵌入上做患者级聚合 → 得到可用于结局预测的特征。肿瘤定位 AUC 0.96 说明这条链条对"哪里有肿瘤"这类任务非常有效。
但要注意基础模型的两面性:
- 优势:免去从头训练图像模型的巨大成本与数据需求,763 例也能用上强图像特征。
- 局限:基础模型的嵌入是"通用病理"表征,未必针对头颈癌优化;且嵌入一旦固定,下游能榨取的信息也受限。此外,论文发现"H&E 组织对生存预测贡献最大"——这提示不必盲目堆叠特殊染色与复杂模态,普通 H&E 加合适的基础模型可能已抓住主要信号。
11.4 与挑战赛的方法生态
HANCOTHON 的参赛方法(如 HANCOCK-FUSe 用融合多模态嵌入做头颈癌结局预测、HCAT-FusionNet 做多模态融合)构成一个围绕 HANCOCK 的方法生态。它们的共同挑战是:在 763 例、六模态、含缺失的设定下,设计出既不过拟合又充分利用多路信息的融合策略。这个生态的价值在于方法的可比性——同一数据、同一指标下,不同融合策略的优劣才可被公允评价。
§12 工程实践:把 HANCOCK 用起来
12.1 数据获取与解压流程
第 1 步:访问 FAU 门户 https://hancock.research.fau.eu/
        用 Explore 页确认数据形态、字段、筛选样本
第 2 步:选择下载通道
        A. FAU data cloud(经门户 Download)
        B. TCIA collection(DOI 10.7937/rcty-5h16,需 IBM Aspera Connect)
第 3 步:按 README 规范解析文件名中的匿名患者 ID
第 4 步:按目录结构定位 WSI_PrimaryTumor / WSI_LymphNode / TMA_* / Annotations
第 5 步:按患者 ID join 临床 JSON / 血液表 / 文本报告
目录结构速查:
HANCOCK/
├── Images/
│   ├── WSI_PrimaryTumor/{oral_cavity,oropharynx,hypopharynx,larynx}/*.svs
│   ├── WSI_LymphNode/*.svs
│   ├── TMA_TumorCenter/*.png
│   └── TMA_InvasionFront/*.png
├── Annotations and Mapping/
│   ├── TMA_celldensity_measurement.csv
│   └── TMA_Map_block1.csv
└── WSI_PrimaryTumor_Annotations/*.geojson
12.2 建模前的五道工序
- 模态可用性过滤:用 Fig S11 逻辑核对每个患者的可用模态,决定建模子集策略(完整案例 vs 允许缺失)。
- 分辨率归一化:原发 WSI(0.1213 µm/px)与淋巴结 WSI 分辨率不同,若做 patch 级分析,按物理尺度(µm)重采样而非像素数。
- 设备域偏移处理:淋巴结 WSI 来自两套扫描仪,混合前考虑颜色标准化(如 Macenko)或域适应。
- 文本去标识复查:虽已去标识,仍建议在预处理阶段做一次隐私扫描(防残余标识符)。
- 结局变量右删失处理:随访存在右删失,做生存分析而非简单二分类时须用删失感知方法。
12.3 与挑战赛基线对齐
想复现论文结果或对标 HANCOTHON,建议:
- 直接使用官方提供的 UNI 预抽嵌入(省去图像推理)
- 从结构化表格 + 嵌入的最简单融合(如逻辑回归/随机森林)起步,建立基线
- 逐步加入文本与 TMA 特征,观察每一步的增益——这正是论文论点的复现路径
- 用同一指标口径(accuracy/F1 或 AUC)比较,避免跨口径误判
12.4 存储与算力估算
- 存储:4.5 TB 是完整下载的体积;若只做嵌入级建模,空间需求可大幅降低(用预抽嵌入即可)。
- 算力:图像推理(自跑 UNI 抽嵌入)是最大算力消耗项;用官方预抽嵌入可绕开。
- 推荐策略:先小规模(一个亚部位子集)验证流程,再决定是否全量下载。
12.5 快速上手五步曲
- 看:打开 FAU 门户 Explore 页,按亚部位/分级/HPV 状态筛样本,熟悉字段与数据形态。
- 定:明确研究问题是"图像任务"“文本任务"还是"融合任务”——三种路线的数据需求截然不同。
- 取:若做融合/文本,先取结构化表格与文本(体量小);若做图像,再追加 WSI/TMA。
- 连:按匿名患者 ID 把多路数据 join 成一张主表或统一索引。
- 跑:先复现官方 GitHub/Zenodo 的参考实现,建立自己的基线,再逐步加入模态。
12.6 常见失败模式
| 失败模式 | 症状 | 对策 |
|---|---|---|
| 模态泄漏 | 验证集 AUC 异常高 | 检查目标相关列是否混入特征 |
| 分辨率错配 | 图像模型在某子集表现骤降 | 按 µm 归一化 patch 物理尺度 |
| 缺失致偏 | 剔除 62 例后结果偏移 | 用 missing indicator 或允许缺失的架构 |
| 版本漂移 | 复现数字对不上 | 对齐 UNI 版本与随机种子 |
| 过度自信 | 单中心结论外推 | 明确标注泛化未验证 |
§13 总结
13.1 三句话总结
- HANCOCK 是 FAU 埃尔朗根 763 例头颈癌单中心多模态数据集(2005-2019),首次把病理 WSI+TMA、结构化临床血液、去标识手术报告文本装进一个 CC BY 4.0 公开集合。
- 论文用两个实验证明其价值:多模态融合优于单模态(RF AUC 0.79),基础模型(UNI/CLAM)助终点预测(肿瘤定位 AUC 0.96);并衍生 HANCOTHON 挑战赛(MICCAI 2025)提供标准化评测场景。
- 它的强项是模态完整度 + 宽松许可 + 高质量元数据(DAIMS 8.0/10),弱项是单中心局限与 4.5 TB 下载门槛。
13.2 适合谁
- 头颈癌精准肿瘤学研究者:需要病理 + 临床 + 文本三模态齐全的公开队列。
- 多模态机器学习团队:需要融合病理/表格/文本的基准场景。
- 计算病理学团队:需要大规模头颈 H&E WSI + 免疫组化 TMA 做基础模型研究。
- 临床 NLP 研究者:需要去标识英文手术报告与病史文本。
- 挑战赛参赛者/复现者:HANCOTHON 提供预抽 UNI 嵌入与标准化指标。
13.3 不适合谁
- 需要放射影像(CT/MRI/PET)的研究(无此模态,转向 946/947/838)。
- 需要基因组/蛋白组/多组学的研究(无此模态,转向 TCGA)。
- 需要多中心泛化验证的研究(单中心硬约束)。
- 带宽/存储受限的团队(4.5 TB + Aspera 门槛)。
13.4 30 秒决策卡
| 你的情况 | 行动 |
|---|---|
| 要头颈病理+临床+文本多模态 | HANCOCK:FAU 门户 Explore 先看,再经 TCIA/FAU 下载 |
| 要头颈放射影像组学 | 转向 headneck-radiomics(946)/hnpet-fdg(947)/head-neck-pet-ct(838) |
| 要复现多模态融合基线 | §4(RF AUC 0.79)+ GitHub/Zenodo 代码 |
| 要参赛或对标挑战赛 | HANCOTHON 预抽 UNI 嵌入 + §5 任务定义 |
| 要引用本数据集 | 数据 DOI 10.7937/rcty-5h16 + 论文 10.1038/s41467-025-62386-6(强制) |
| 要商用 | 按 CC BY 4.0 允许,但核对坑 4 的 NC 转述口径 |
E. 深度与专题
Q25:为什么论文用随机森林而不是深度学习?
763 例的样本量对参数庞大的深度多模态网络偏小,容易过拟合;随机森林对表格数据稳健、对特征尺度不敏感,是恰当的基线选择。论文的论点是"融合优于单模态",用简单模型证明信息互补性比堆架构更有说服力。
Q26:什么是 UNI?
UNI 是一个病理学的自监督基础模型(foundation model),把全切片图像或 patch 抽取成有语义的表征向量。HANCOCK 论文与 HANCOTHON 挑战赛都用它来抽 WSI 特征,避免从零训练图像模型。
Q27:CLAM 是什么?
CLAM(Clustering-constrained Attention Multiple Instance Learning)是一种多示例学习框架。全切片图像是"包"(bag),里面的 patch 是"示例"(instance),CLAM 用注意力机制把 patch 级特征聚合成切片级/患者级预测。论文用 CLAM+UNI 在肿瘤定位上达 AUC 0.96。
Q28:UMAP 在图里展示了什么?
UMAP 把高维的多模态患者向量降到二维,揭示患者亚群聚类。论文发现 HPV 阳性口咽癌患者的 CD8+ 细胞密度更高——这与免疫学预期一致,验证了 TMA 免疫组化数据的可用性。
Q29:多模态融合的三大难题是什么?
①模态缺失(真实数据几乎不齐);②模态异质性(表格/文本/图像结构不可比);③样本量约束(763 例支撑不起大网络)。见 §11。
Q30:这个数据集对临床 NLP 有什么用?
它提供去标识的英文手术报告与病史文本,可用于命名实体识别、报告自动结构化、临床文本嵌入,以及作为多模态模型的文本输入。大多数头颈公开数据集只给结构化字段,不给原始文本。
Q31:TMA 免疫组化面板包含哪些标记?
H&E + CD3、CD8(T 细胞)、CD56(NK 细胞)、CD68、CD163(单核/巨噬细胞)、PD-L1(免疫检查点配体)、MHC-1(MHC I 类表达),共 8 种染色。
Q32:为什么有 62 例没有 WSI?
论文说明这 62 例因组织不可用(tissue unavailable)而无原发肿瘤 WSI,因此 763−62=701 例有 WSI。使用时应先核对模态可用性(Fig S11)。
Q33:诊断年份为什么是 2005-2019?
这是纳入期。数据是事后回顾性整理、去标识并获伦理批准(#23-22-Br)后公开的,因此历史上溯到 2005 年的病例也能合规公开。
Q34:数据有右删失吗?
有。随访最长 14 年,但最晚病例随访期较短,存在右删失。做生存分析(而非简单二分类)时需用删失感知方法处理。
Q35:和 TCGA 的头颈癌数据相比如何?
TCGA 提供 500+ 例头颈癌的多组学(基因组/转录组等),但缺病理报告、血液检查与完整影像;HANCOCK 无组学,但有病理 WSI+TMA+临床血液+文本。两者互补:TCGA 强在分子层,HANCOCK 强在临床/病理/文本层。
Q36:可以用 HANCOCK 做外部验证集吗?
可以,但注意它本身是单中心数据。若你用其他中心的数据训练模型,HANCOCK 可作为外部队列测试泛化;但反之把 HANCOCK 训练的模型直接外推到其他中心,其泛化性未经验证。
Q37:条目为什么用 slug hancock-hnscc 而不只是 hancock?
加 hnscc(头颈鳞癌)后缀是为了与库内潜在的通用 “hancock” 命名区分,并明确病种属性,便于检索与查重。
Q38:项目的资助来源?
德国联邦教育与研究部(BMBF),资助编号 01KD2211A(Prof. Kist)与 01KD2211B(Dr. Eckstein, Prof. Gostian)。
Q39:论文的资深作者是谁?
Markus Eckstein、Antoniu-Oreste Gostian、Andreas M. Kist 三人为共同资深作者(na1 标注)。
Q40:Zenodo 快照有什么用?
GitHub 代码会变动,Zenodo 归档(DOI 10.5281/zenodo.15288559)提供版本固定的代码快照,保证论文结果的长期可复现性。
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 条目名 | HANCOCK |
| url_name | hancock-hnscc |
| 官方全称 | HANCOCK — Multimodal Head and Neck cancer dataset |
| 类型 | 数据集 + 方法论文 + 挑战赛(三合一) |
| 论文 | Nat Commun 16, 7163 (2025),doi:10.1038/s41467-025-62386-6 |
| 数据 DOI | 10.7937/rcty-5h16(TCIA) |
| 团队 | FAU 生物医学工程 AI 系 + 埃尔朗根大学医院耳鼻喉科 |
| 规模 | 763 例 / 13,684 images / 4.5 TB |
| 病理 | 709 原发 WSI + 396 淋巴结 WSI + 8 染色 TMA |
| 许可 | 数据 CC BY 4.0;论文 CC BY 4.0 |
| 抓取时点 | 2026-10-09 |
| 库内互链 | headneck-radiomics(946)、hnpet-fdg(947)、head-neck-pet-ct(838)、orchid(903)、panda-plus(640)、tcga(566)、tiger(26)、aacr-genie(403) |
附录 B:数据字段速查卡
| 字段类别 | 具体字段 |
|---|---|
| 人口学 | 年龄、性别、吸烟史 |
| 肿瘤病理 | 原发部位、分级、病理 T/N 分期、切缘、淋巴结转移数 |
| 分子标志物 | HPV 状态、PD-L1 状态 |
| 临床 | 临床 TNM 分期、治疗方式 |
| 血液 | 血常规、凝血、电解质、肾功能、CRP |
| 文本 | 手术报告(ICD/OPS)、病史、治疗时间线 |
| 结局 | 生存事件与时间、复发事件与时间 |
附录 C:目录结构完整速查
HANCOCK/
├── Images/
│   ├── WSI_PrimaryTumor/
│   │   ├── oral_cavity/*.svs
│   │   ├── oropharynx/*.svs
│   │   ├── hypopharynx/*.svs
│   │   └── larynx/*.svs
│   ├── WSI_LymphNode/*.svs
│   ├── TMA_TumorCenter/*.png
│   └── TMA_InvasionFront/*.png
├── Annotations and Mapping/
│   ├── TMA_celldensity_measurement.csv
│   └── TMA_Map_block1.csv
└── WSI_PrimaryTumor_Annotations/*.geojson
附录 D:扫描仪与分辨率总表
| 图像类型 | 扫描仪 | 放大 | 分辨率 |
|---|---|---|---|
| 原发肿瘤 WSI | 3DHISTECH P1000 | 82.44× | 0.1213 µm/px |
| 淋巴结 WSI(批一) | Aperio Leica GT450 | 40× | 0.2634 µm/px |
| 淋巴结 WSI(批二) | 3DHISTECH P1000 | ~51× | 0.1945 µm/px |
| TMA | 统一显微镜设置 | ~40× | — |
附录 E:DAIMS 评估全表
| 维度 | 评分(1-10) | 依据 |
|---|---|---|
| D 可发现性 | 8 | TCIA + FAU 门户 + 论文 + Zenodo 四重索引;双 DOI 清晰 |
| A 可获取性 | 7 | CC BY 4.0 全开放(可商用);扣分于 4.5 TB + Aspera 门槛 |
| I 可互操作 | 8 | SVS/PNG/CSV/GeoJSON/JSON 标准格式;统一患者 ID;术语表;无 DICOM 病理封装 |
| M 元数据质量 | 9 | 论文详述采集/规格/缺失 + Fig S11 逐例可用性 + Usage Notes |
| S 可持续性 | 8 | TCIA + FAU + Zenodo 三重托管;BMBF 资助可追溯 |
| 综合 | 8.0/10(优秀) | 许可与元数据强,体积工程门槛为唯一明显失分 |
附录 F:逐项证据链自证
| 关键数字 | 来源 | 位置 |
|---|---|---|
| 763 例患者 | TCIA 页头 + 论文摘要 + FAU 项目站 | 三源一致 |
| 13,684 images / 4.5 TB | TCIA Data Access 表 | TCIA 官方页 |
| 709 原发 WSI / 0.1213 µm/px | TCIA 正文(Data Acquisition) | TCIA 官方页 |
| 396 淋巴结 WSI / 双扫描仪 | TCIA 正文 | TCIA 官方页 |
| TMA 2 芯 × 8 染色 / 最多 16 图 | TCIA 正文 | TCIA 官方页 |
| 62 例无 WSI | TCIA 正文 | TCIA 官方页 |
| 2005-2019 诊断年份 | TCIA 正文 | TCIA 官方页 |
| 伦理 #23-22-Br | TCIA 正文 | TCIA 官方页 |
| 论文 CC BY 4.0 | FAU OA 仓库 | open.fau.de/handle/openfau/37822 |
| 数据 CC BY 4.0 | TCIA Data Access 表 | TCIA 官方页 |
| RF AUC 0.79 / CLAM+UNI AUC 0.96 | 论文摘要 + 中文转述 | natcommun 摘要 |
| HANCOTHON 任务与奖金 | Grand Challenge 页 | hancothon25.grand-challenge.org |
| Zenodo 快照 DOI | TCIA External Resources | 10.5281/zenodo.15288559 |
附录 G:数据获取决策树
需要头颈癌数据
├─ 需要病理(WSI/TMA)?
│   ├─ 是 → 需要临床+文本多模态?
│   │        ├─ 是 → 【HANCOCK】本条目
│   │        └─ 否 → 只要 patch → orchid(903)
│   └─ 否 → 需要放射影像组学?
│            ├─ CT → headneck-radiomics(946)
│            ├─ PET → hnpet-fdg(947) / head-neck-pet-ct(838)
│            └─ 多组学 → tcga(566)
└─ 需要商用 → HANCOCK(CC BY 4.0)
附录 H:模态—文件—任务映射表
| 模态 | 文件形态 | 典型任务 |
|---|---|---|
| 原发肿瘤 WSI | Aperio SVS(0.1213 µm/px) | 肿瘤定位、生存预测(MIL) |
| 淋巴结 WSI | Aperio SVS(双分辨率) | 转移检测、生存预测 |
| TMA | PNG(8 染色) | 免疫微环境定量、细胞密度 |
| WSI 标注 | GeoJSON | 感兴趣区域定位 |
| TMA 测量 | CSV | 细胞密度特征 |
| 临床/血液 | JSON/表格 | 多模态融合 |
| 文本 | TXT | 临床 NLP、融合 |
| UNI 嵌入 | 预抽特征 | 挑战赛快速建模 |
附录 I:论文基线汇总表(论文口径)
| 分析 | 方法 | 结果 |
|---|---|---|
| 多模态融合 | 随机森林 | 生存/复发 AUC 0.79 |
| 单模态 | 单独模态 | 均低于融合 |
| 肿瘤定位 | CLAM + UNI(MIL) | AUC 0.96 |
| 低维可视化 | UMAP | 揭示患者亚群(HPV+口咽 CD8+ 更高) |
| 贡献分析 | — | H&E 组织对生存预测贡献最大 |
注:上述数字为论文首次分析结果,未经独立复现,跨研究比较需谨慎(§4.5)。
附录 J:与库内头颈条目对照总表
| 条目 | rid | 病种 | 模态 | 例数 | 中心数 | 许可 |
|---|---|---|---|---|---|---|
| HANCOCK | 本条目 | 头颈鳞癌 | 病理+临床+血液+文本 | 763 | 1 | CC BY 4.0 |
| headneck-radiomics | 946 | 头颈鳞癌 | 放疗 CT 影像组学 | 137 | 1 | CC BY-NC 3.0 |
| hnpet-fdg | 947 | 头颈鳞癌 | FDG-PET/CT | 260 | 23 | TCIA 条款 |
| head-neck-pet-ct | 838 | 头颈癌 | PET/CT | 298 | 4 | TCIA 条款 |
| orchid | 903 | 口腔癌 | 病理 patch | 150 | 5 | CC 开放 |
附录 K:双口径登记表
| 项 | 口径一 | 口径二 | 采信 |
|---|---|---|---|
| 论文 license | CC BY 4.0(FAU OA 仓库) | CC BY-NC 4.0(EMJ 案例稿) | 官方 CC BY 4.0 |
| 论文日期 | 2025-08-04(FAU 仓库) | 2025-08-01(DOAJ) | 卷期 16,7163 (2025) |
| 图像计数 | 13,684(TCIA series 级) | 709+396+TMA(正文切片级) | 两口径并存,注明 |
| 文本规模 | N=742(转述 Fig 1F) | 论文未在摘要给数 | 标注为转述口径 |
附录 L:缩写速查
| 缩写 | 全称 | 中文 |
|---|---|---|
| HANCOCK | Head And Neck Cancer dataset | 头颈癌数据集 |
| HANCOTHON | HANCOCK + Marathon | HANCOCK 挑战赛 |
| WSI | Whole Slide Image | 全切片图像 |
| TMA | Tissue Microarray | 组织微阵列 |
| IHC | Immunohistochemistry | 免疫组化 |
| H&E | Hematoxylin and Eosin | 苏木精-伊红染色 |
| HNSCC | Head and Neck Squamous Cell Carcinoma | 头颈鳞状细胞癌 |
| MIL | Multiple Instance Learning | 多示例学习 |
| CLAM | Clustering-constrained Attention MIL | 聚类约束注意力多示例学习 |
| UNI | — | 病理自监督基础模型 |
| UMAP | Uniform Manifold Approximation and Projection | 统一流形逼近与投影 |
| AUC | Area Under the Curve | 曲线下面积 |
| FAU | Friedrich-Alexander-Universität | 埃尔朗根-纽伦堡大学 |
| TCIA | The Cancer Imaging Archive | 癌症影像档案 |
| BMBF | Bundesministerium für Bildung und Forschung | 德国联邦教育与研究部 |
| HPV | Human Papillomavirus | 人乳头瘤病毒 |
| PD-L1 | Programmed Death-Ligand 1 | 程序性死亡配体 1 |
| CRP | C-Reactive Protein | C 反应蛋白 |
| TNM | Tumor-Node-Metastasis | 肿瘤-淋巴结-转移分期 |
| ICD/OPS | 国际疾病分类/手术操作分类 | 德国编码体系 |
附录 M:引文规范(BibTeX)
@article{Doerrich2025HANCOCK,
  author       = {Dörrich, Marion and Balk, Matthias and Heusinger, Tatjana and
                  Beyer, Sandra and Mirbagheri, Hamed and Fischer, David J. and
                  Kanso, Hassan and Matek, Christian and Hartmann, Arndt and
                  Iro, Heinrich and Eckstein, Markus and Gostian, Antoniu-Oreste and
                  Kist, Andreas M.},
  title        = {A multimodal dataset for precision oncology in head and neck cancer},
  journaltitle = {Nature Communications},
  year         = {2025},
  volume       = {16},
  number       = {1},
  eid          = {7163},
  doi          = {10.1038/s41467-025-62386-6},
  url          = {https://doi.org/10.1038/s41467-025-62386-6}
}

@misc{Kist2025HANCOCKDataset,
  author    = {Kist, A. and Dörrich, M. and Balk, M. and Matek, C. and Hartmann, A. and
               Eckstein, M. and Gostian, A. and Heusinger, T. and Beyer, S. and
               Mirbagheri, H. and Fischer, D. J. and Kanso, H. and Iro, H.},
  title     = {Multimodal Head and Neck cancer dataset (HANCOCK) (Version 1)},
  year      = {2025},
  publisher = {The Cancer Imaging Archive},
  doi       = {10.7937/RCTY-5H16}
}
附录 N:建议互链点与 rid 声明
| 目标条目 | rid | 互链理由 |
|---|---|---|
| headneck-radiomics | 946 | 同病种互补模态(放射影像组学 vs 计算病理) |
| hnpet-fdg | 947 | 同病种(HNSCC)不同模态 |
| head-neck-pet-ct | 838 | 同病种不同模态,多中心对照 |
| orchid | 903 | 同头颈区病理,patch vs WSI 对照 |
| panda-plus | 640 | 病理 WSI 数据工程方法参照 |
| tcga | 566 | 论文明确对比的多组学资源 |
| tiger | 26 | 病理 WSI 挑战赛生态 |
| aacr-genie | 403 | 临床基因组学数据对照 |
附录 O:检索决策树
搜索 "HANCOCK" 头颈癌数据集
├─ 想找数据集本体 → TCIA collection/hancock 或 hancock.research.fau.eu
├─ 想找论文 → doi:10.1038/s41467-025-62386-6
├─ 想找挑战赛 → hancothon25.grand-challenge.org
├─ 想找代码 → github.com/ankilab/HANCOCK_MultimodalDataset
│              (归档:doi:10.5281/zenodo.15288559)
└─ 想引用 → 数据 doi:10.7937/rcty-5h16(强制)+ 论文上述 DOI
附录 P:建模检查单(Checklist)
| 检查项 | 说明 |
|---|---|
| □ 模态可用性核对 | 按 Fig S11 逐例核对,处理 62 例无 WSI 及部分缺失 |
| □ 分辨率归一化 | 原发(0.1213)vs 淋巴结(0.2634/0.1945)µm/px 对齐 |
| □ 设备域偏移 | 淋巴结 WSI 两套扫描仪,考虑颜色标准化/域适应 |
| □ 文本隐私复扫 | 虽已去标识,预处理阶段再扫一次残余标识符 |
| □ 结局右删失 | 生存分析用删失感知方法 |
| □ 目标列泄漏 | 融合建模时确保目标相关列未进特征 |
| □ 引用合规 | TCIA DOI + 论文 DOI 齐备 |
| □ 商用核对 | 按 CC BY 4.0 理解;备注曾见 NC 转述口径 |
附录 Q:本条目生产档案
| 项 | 值 |
|---|---|
| 代理名 | agent-e-hancockhns |
| 锁创建时间 | 2026-10-09T09:26 |
| 抓取时点 | 2026-10-09 |
| 主要来源 | TCIA 官方页(WebFetch 实测可达)、FAU 项目站、Nature Comms 摘要、FAU OA 仓库、Grand Challenge 挑战赛页 |
| 网络预算使用 | WebSearch 2 / WebFetch 4(内置上限 WebSearch 3 / WebFetch 6) |
| 失败请求 | nature.com(Client Challenge 反爬)、github.com(空正文 JS 渲染)——均未重试,改由他源互证 |
| 遗留疑点 | 见 FACTS.md §9(官方页可达性、license 双口径、图像计数口径、TMA 368 转述、N=742 转述) |
附录 R:相关文献引用链
HANCOCK 论文引用的关键背景文献(用于理解其定位,非数据集本体):
| 文献 | 与本数据集的关系 |
|---|---|
| Sung H, et al. GLOBOCAN 2020 全球癌症统计. CA Cancer J Clin 71(3):209-249 (2021) | 论文引用其"头颈癌全球第七大常见恶性肿瘤"数据 |
| Johnson DE, et al. Head and neck squamous cell carcinoma. Nat Rev Dis Primers 6(1):92 (2020) | 头颈鳞癌的权威综述背景 |
| Budach V & Tinhofer I. 头颈癌预后临床因素与生物标志物系统综述. Lancet Oncol 20(6):313-326 (2019) | 预后因素与生物标志物背景 |
| Gatta G, et al. EUROCARE-5 欧洲头颈癌预后. Eur J Cancer 51(15):2130-2143 (2015) | 欧洲头颈癌生存率背景(5 年生存约 25-60% 的来源之一) |
| Wang Z, et al. TCGA 实用指南. Statistical Genomics:111-141 (2016) | 论文用于对比 TCGA 多组学的局限 |
| Dörrich M, et al. Nat Commun 16:7163 (2025) | 本数据集本体论文 |
附录 S:术语中英对照补充表
| 中文 | 英文 | 说明 |
|---|---|---|
| 肿瘤中心 | tumor center | TMA 芯取样位置之一 |
| 浸润前沿 | invasive tumor front | TMA 芯取样位置之二,肿瘤侵袭边缘 |
| 口腔 | oral cavity | 头颈癌亚部位 |
| 口咽 | oropharynx | 头颈癌亚部位,HPV 相关性强 |
| 下咽 | hypopharynx | 头颈癌亚部位 |
| 喉 | larynx | 头颈癌亚部位 |
| 根治性意向治疗 | curative-intent treatment | 纳入标准 |
| 姑息治疗 | palliative treatment | 排除标准 |
| 首程治疗 | first-course treatment | 纳入标准 |
| 右删失 | right censoring | 随访数据统计特性 |
| 缺失模态 | missing modality | 多模态融合难题之一 |
| 域偏移 | domain shift | 多扫描仪带来的分布差异 |
| 免疫检查点配体 | immune checkpoint ligand | PD-L1 的角色 |
| 总生存 | overall survival (OS) | 结局指标 |
| 复发 | recurrence | 结局指标 |
附录 T:维护计划与更新触发点
| 触发条件 | 建议动作 |
|---|---|
| HANCOCK 发布新版本(TCIA Version >1) | 更新规模数字、版本链、日期 |
| HANCOTHON 发布总结论文 | 补充挑战赛方法学生态章节 |
| 论文勘误或新基线出现 | 更新 §4 数字与证据链 |
| 库内新增头颈癌病理/多模态条目 | 更新 §9 家族图谱与互链 |
| license 若有变更 | 重核 §6.3 双口径 |
| TCIA 页面结构变化 | 重核获取路径与 DOI |
附录 U:FAIR 原则自评
| 原则 | 评价 | 依据 |
|---|---|---|
| Findable(可发现) | 优 | 双 DOI + TCIA + FAU 门户 + 论文 + Zenodo |
| Accessible(可获取) | 良 | CC BY 4.0 开放;TCIA 需 Aspera,FAU 门户无门槛 |
| Interoperable(可互操作) | 优 | 标准格式 + 统一患者 ID + 术语表 |
| Reusable(可复用) | 优 | 元数据完备 + 代码开源 + 缺失披露透明 |
附录 V:一句话速记
HANCOCK = 埃尔朗根 763 例头颈癌的"三模态齐全"(病理 WSI+TMA / 临床血液 / 文本)多模态数据集,CC BY 4.0 开放,4.5 TB,衍生 HANCOTHON 挑战赛证明融合优于单模态——库内头颈条目里唯一补上"病理+文本"这块空白者。
本条目为 AI-Ready Wikipedia 数据集的百科条目,所有规模数字均经三源互证(TCIA 官方页 / FAU 项目站 / Nature Communications 论文)。凡存双口径或转述口径者已在正文与附录明确标注。遗留疑点见 FACTS.md §9。引用本数据集时须遵循 TCIA Data Usage Policy 并携带 DOI。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- cmb-aml — 共享标签:多模态 / 病理图像 / 肿瘤学 / 队列研究
- histai-wsi — 共享标签:病理图像 / 肿瘤学 / 队列研究 / 影像-文本对齐
- patchgastricadc22 — 共享标签:多模态 / 病理图像 / 肿瘤学 / 影像-文本对齐
- cmb-gec — 共享标签:多模态 / 病理图像 / 肿瘤学 / 队列研究
- quilt-1m — 共享标签:多模态 / 病理图像 / 影像-文本对齐
- pathseg — 共享标签:多模态 / 病理图像 / 肿瘤学
- multi-oscc-histopath — 共享标签:多模态 / 病理图像 / 肿瘤学
- opentme — 共享标签:多模态 / 病理图像 / 肿瘤学
- reg2026 — 共享标签:多模态 / 病理图像 / 影像-文本对齐
- plip — 共享标签:多模态 / 病理图像 / 影像-文本对齐
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
