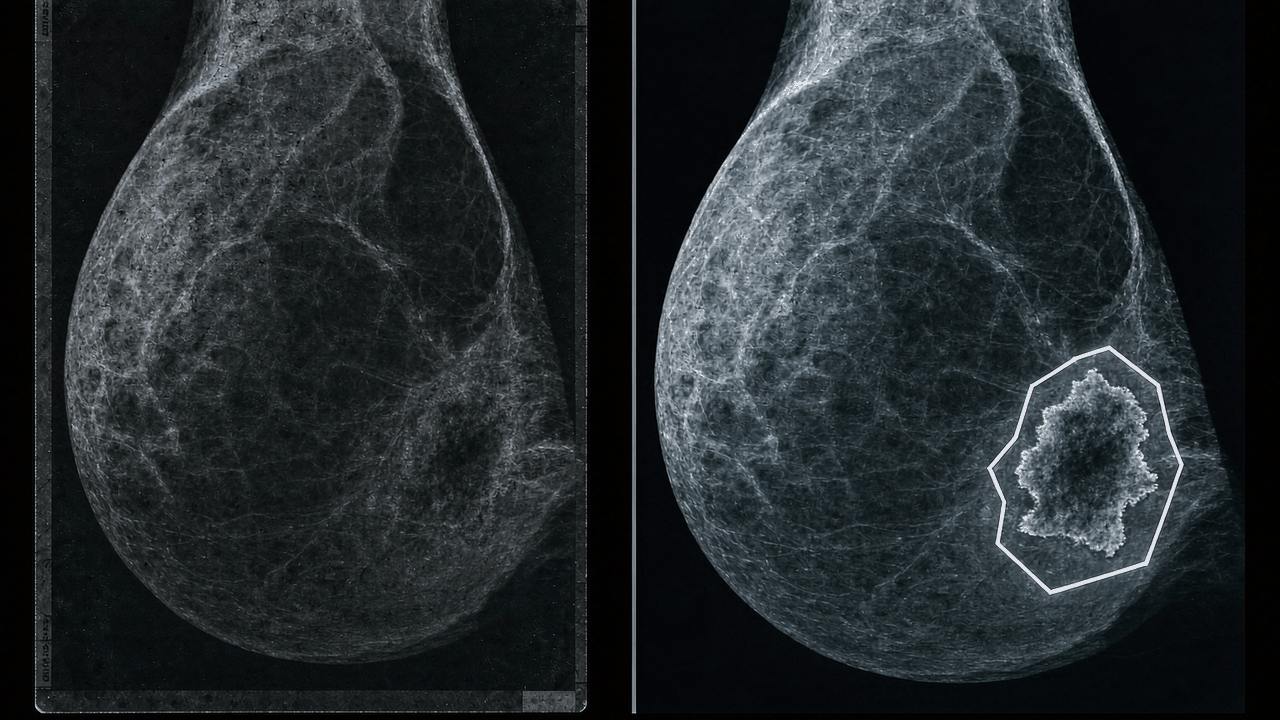
信息速览
Breast Cancer Digital Repository(BCDR)
一句话定义:BCDR 是 2009 年由葡萄牙波尔图地区三家机构(CETA-CIEMAT、INEGI、FMUP-HSJ)在 IMED 项目与 ALOE 网格平台支持下共建的乳腺 X 光影像多源数据库,把「胶片乳腺摄影(BCDR-FM)」与「全视野数字乳腺摄影(BCDR-DM)」两类设备影像、BI-RADS 病灶手工分割掩码和脱敏临床史整合成一套面向计算机辅助诊断(CADx)的病案级资源集。
INFOBOX:一屏速览
| 维度 | 内容 |
|---|---|
| 全称 | Breast Cancer Digital Repository(乳腺癌数字资源库) |
| 通用简称 | BCDR(本文用 bcdr 作站点 slug) |
| 子库 | BCDR-FM(胶片,1010 例);BCDR-DM(全视野数字,724 例仍在建设) |
| 提出年份 | 2012(原始基准论文 CIARP 2013 正式发表) |
| 建库起点 | 2009 年 3 月(IMED 项目) |
| 数据模态 | 乳腺 X 光影像(mammography),MLO + CC 双视图,灰度 TIFF |
| 标注体系 | BI-RADS 标准分类 + 病灶多边形分割 + 影像纹理描述符 |
| 图像规格(FM) | 720 × 1168 px,8 bit/px,TIFF(CIARP 2013 口径) |
| 图像规格(DM) | 3328 × 4084 或 2560 × 3328 px,14 bit/px,TIFF(CIARP 2013 口径) |
| 患者来源 | 葡萄牙北部乳腺癌筛查服务,匿名病案 |
| 病理确认比例 | 1493 个分割中仅 276 个基于病理结果 |
| 建库机构 | CETA-CIEMAT + INEGI(波尔图大学工程学院)+ FMUP-HSJ(波尔图大学医学院–圣若昂中心医院) |
| 支撑平台 | IMED 项目(e-infrastructure)+ ALOE 平台(GPU 集群 + SLURM + LUSTRE) |
| 获取方式 | 注册申请制(strict application process),通常仅授学术机构、非商业用途 |
| 许可协议 | 无公开 CC 许可(FAIR accessibility 评分 2/5) |
| 当前状态 | 原始库已停更(no longer actively maintained),官网主机 2026 年实抓不可达 |
| 代表作基准 | Chougrad 2018 迁移学习:BCDR 96.67% accuracy / 0.96 AUC |
| 库内同类 | cbis-ddsm、inbreast、swiss-mammo、vindr-mammo、tn-mammo-breast-density |
| 核心价值 | 少见地同时提供「胶片 vs 数字」两种设备域的病灶分割与临床史,适合跨设备域泛化研究 |
导语
乳腺 X 光影像(mammography)是乳腺癌(breast cancer)筛查的第一道防线,也是医学影像分析最早被人工智能攻克的战场之一。要训练和评测计算机辅助诊断(CADx, computer-aided diagnosis)系统,研究者需要的不只是成堆的图像,而是带诊断标签、带病灶位置、还带临床上下文的结构化病案——BCDR 正是为这个需求量身打造的一类老牌公开资源。
BCDR 的独特之处在于它把「时代印记」写进了数据集本身:一代患者用的是胶片乳腺摄影(film mammography, FM),另一代患者用的是全视野数字乳腺摄影(full-field digital mammography, FFDM)。两代设备在分辨率、灰度位深、噪声特性上差异巨大,BCDR 分别建成 BCDR-FM 与 BCDR-DM 两个子库,让研究者得以在同一套标注体系(BI-RADS)下观察跨设备域的模型鲁棒性。这在 2012 年前后是极具前瞻性的设计。
但它也带着这一代学术数据集共有的伤痕:注册申请制获取、无公开 CC 许可、仅病灶标注而缺背景组织元数据、病理确认比例偏低、原始库已停更、官网主机如今已不可达。这些限制不是瑕疵,而是研究者在复用这份数据之前必须逐条认清的前提。本条目即以此为纲,把 BCDR 的来龙去脉、硬数字、标注流水线、评估基准与生态位一次讲透。
导语读法三则
- 先分清两个子库,再谈「总规模」。BCDR 的患者数、图像数、分辨率、位深在 FM 与 DM 两库完全不同,任何把它们相加成一个数字的说法(如「1734 例」)都要先问一句「是分库口径还是合计口径」。本条目正文一律分库陈述,并在口径冲突处逐条存照。
- 把「标注」和「诊断金标准」分开看。BCDR 的病灶分割大多来自临床意见而非病理确认,只有少数有病理背书。做评估可以,做临床因果结论要谨慎。
- 官网打不开不等于数据消失。BCDR 是典型的「论文与综述比官网活得久」的老数据集;当门户主机下线时,一手数字应以原始论文(CIARP 2013)与 FAIR 综述为准,本条目即按此原则组织证据。
§0 导读:这份数据为什么值得认识
§0.1 一句话定位
BCDR 是「前深度学习时代」乳腺 CADx 研究的经典公开基准之一,它的历史地位来自三点:第一,它是少数同时覆盖胶片与数字两种设备域的乳腺 X 光库;第二,它把 BI-RADS 标准与病灶分割掩码、临床史打包在一起,形成了病案级的完整记录;第三,它被 Chougrad 等人在 2018 年用作迁移学习基准,取得 96.67% 的准确率,成为深度学习早期乳腺分类研究的常引对象。
§0.2 与传统「图像包」的区别
很多早期的乳腺影像数据集本质上是一个图像文件夹 + 一份标签表:你拿到图像和一个恶性/良性标签,剩下的全靠自己。BCDR 的野心更大,它被设计成一个以患者病案为单位的关系型资源:
- 每个患者(patient)下有若干次检查(study);
- 每次检查下有 MLO 与 CC 两种视图(view);
- 每个视图上可能标注若干病灶(lesion),带 BI-RADS 分类与多边形分割;
- 每个患者还挂着脱敏临床史(clinical history)。
这种「病案 → 检查 → 视图 → 病灶」的层级结构,使 BCDR 天然适合做病案级而非仅仅图像级的研究。本条目在 §4 会把这套层级拆解成可操作的记录模型。
§0.3 谁应该关注它
- 医学影像算法研究者:特别是做跨设备域泛化(domain generalization)、迁移学习、病灶分割的团队。
- 数据集史与可复现性研究者:BCDR 是研究「老数据集如何在门户下线后仍被引用」的活样本。
- 临床与流行病学背景的读者:想理解 BI-RADS 标注体系如何落到影像数据上、以及真实世界筛查队列的标签质量分布。
§0.4 本期导读的路线图
本条目按「身份 → 规模 → 任务 → 获取 → 模型 → 评估 → 生态 → 陷阱 → 速查」的顺序展开:
- §1 速览十问十答,用最快速度建立直觉;
- §2 机构与来龙去脉,讲清谁在什么背景下建了它;
- §3 数据本体的结构解剖;
- §4 规模硬数字分库对账;
- §5 标注与任务体系;
- §6 获取、许可与版本链;
- §7 评估与基准;
- §8 生态位与库内互链;
- §9 十大坑点(含官网停更与口径冲突);
- §10 一页速查表。
§1 数据集速览十问十答
问题 1:BCDR 全称是什么,简称怎么来的
BCDR 全称 Breast Cancer Digital Repository,直译「乳腺癌数字资源库」。其中「Digital Repository」强调它是一个**资源库(repository)**而非单一数据集——它收纳了多个子库与多个基准子集,而非一批图像打一个包。站点 slug 采用小写 bcdr,与库内既有条目命名风格一致。
问题 2:它由谁建设、在哪里
BCDR 由葡萄牙波尔图地区三家机构联合建设:
- CETA-CIEMAT——西班牙 CIEMAT 技术中心,负责网格/e-infrastructure 侧支撑(IMED 项目托管方、ALOE 平台承载方);
- INEGI——波尔图大学工程学院机械工程与工业管理研究所,负责影像处理与数据集组织;
- FMUP-HSJ——波尔图大学医学院与圣若昂中心医院(Centro Hospitalar São João),负责临床数据与放射科专家标注。
三方分工清晰:临床方出数据与标注,工程方出处理与建模,e-infrastructure 方出算力与平台。
问题 3:它是什么时候建的、现在还在更新吗
BCDR 于 2009 年 3 月由 IMED 项目启动建设,2012 年作为门户资源对外发布,原始基准论文于 2013 年在 CIARP 会议正式发表(Springer LNCS 8258:326-333)。其中 BCDR-DM(数字子库)在论文发表时仍在建设。
关于更新状态,第三方 FAIR 综述(tomesphere)明确指出:原始 BCDR 资源库已不再活跃维护(no longer actively maintained),数字侧仍以「持续进行的副项目」形式存在。因此本条目把发布日期记 2012、口径更新年份记 2014,并在状态栏标注「已停更」。
问题 4:它包含哪两个子库,为什么这样分
BCDR 分两个子库,对应两种设备世代:
- BCDR-FM(film mammography,胶片乳腺摄影子库):来自胶片时代的筛查影像,经过数字化扫描进入库中;
- BCDR-DM(digital mammography,全视野数字乳腺摄影子库):来自直接数字采集的 FFDM 设备。
这种划分不是形式上的,而是设备物理特性决定的:胶片与数字在分辨率、灰度位深、噪声与对比度上系统不同(见 §4 规格对照)。把它们分开,研究者才能干净地研究「设备域偏移」对模型的影响。
问题 5:数据规模到底多大
按原始论文(CIARP 2013)主口径:
- BCDR-FM:1010 例患者(998 女 + 12 男,年龄 20-90 岁)、1125 次检查、3703 张 MLO/CC 图像、1044 个临床描述病灶、1517 个手工分割;
- BCDR-DM:724 例患者(723 女 + 1 男,年龄 27-92 岁)、1042 次检查、3612 张图像、452 个描述病灶、818 个手工分割。
注意:不少二手综述把两库相加写作「1734 例」或「7420 张」,本条目在 §4 与 §9 对此类合计口径逐条存照。
问题 6:它的标注体系是什么
核心是 BI-RADS(Breast Imaging Reporting and Data System,乳腺影像报告和数据系统)——由美国放射学会(ACR)主导的乳腺影像评估标准。BCDR 采用 BI-RADS 作为病灶分类的公共语言,理由是:放射科医生普遍熟悉它,标注更可靠,也提升数据集之间的互操作性。
在 BI-RADS 之外,BCDR 还提供:病灶的多边形模糊分割掩码(polygonal segmentation)、病灶位置与肿块坐标、四组影像纹理描述符(intensity / texture / multi-scale texture / spatial distribution of gradient),以及患者临床史。
问题 7:它的典型任务是什么
- 乳腺肿块良恶性二分类(binary mass classification)——最主流用法;
- 病灶分割——用分割掩码训练/评测病灶定位;
- CADx 分类器建模——结合临床数据 + 影像描述符建模;
- 分辨率影响评估——评估图像分辨率对机器学习分类器(MLC)的影响;
- 三类病灶分类——microcalcifications / masses / all lesions。
问题 8:怎么获取它,要花钱吗
不花钱,但要过审。BCDR 采用注册申请制(strict application process):研究者需在门户注册、提交正式项目计划,通常仅授予学术机构、非商业目的。第三方 FAIR 综述作者实测从申请到获批约 2 个月。BCDR 没有公开的 CC 许可,因此不能像 CBIS-DDSM 那样直接下载使用——这是它与现代开放数据集最本质的区别。
问题 9:它现在还能用吗,官网为什么打不开
BCDR 作为研究基准仍被广泛引用,数据本身经申请渠道仍可讨论获取;但原始门户已停更,且本条目抓取时点(2026-10-03)实测 https://bcdr.eu/information/about 返回 Cloudflare 523(Origin is unreachable),说明官网主机当前下线。因此本条目的一手数字一律回溯到 CIARP 2013 论文与第三方 FAIR 综述,不依赖官网可访问性。
问题 10:它与 CBIS-DDSM、INbreast 有什么区别
三者常被并列,但定位不同:CBIS-DDSM 是另一套 DDSM 的筛选性数字子集,规模更大、组织方式不同;INbreast 同样来自波尔图圣若昂医院(与 BCDR 同一临床来源机构),是 2011 年单独发布的 410 张数字乳腺图像库,但不含 BCDR 那样的胶片子库与临床史整合;BCDR 的差异化点是双设备域 + 病案级临床史 + BI-RADS 分割的组合。详见 §8 生态对比。
§2 机构与来龙去脉
§2.1 三家共建机构的分工
BCDR 不是一个实验室的产物,而是一次临床—工程—算力三方的协作。原始论文(CIARP 2013)的署名把这条协作链写得很清楚:
| 机构 | 全称与地点 | 角色 | 主要署名者 |
|---|---|---|---|
| INEGI | Institute of Mechanical Engineering and Industrial Management, Faculty of Engineering, University of Porto(葡萄牙波尔图) | 影像处理、数据集组织与建模 | Daniel Cardoso Moura、Pedro Cunha、Noelia González de Posada |
| DETI | Department of Electronics, Telecommunications and Informatics, University of Aveiro(葡萄牙阿威罗) | 方法设计与通讯 | Miguel Angel Guevara López |
| UIS | Universidad Industrial de Santander(哥伦比亚布卡拉曼加) | 建模与网格计算 | Rafael Ramos Pollán |
| FMUP-HSJ | Faculty of Medicine – Centro Hospitalar São João, University of Porto(葡萄牙波尔图) | 临床数据、放射科专家标注 | Isabel Ramos、José Loureiro、Isabel Cristina Moreira、Berta Martins Ferreira de Araújo、Teresa Cardoso Fernandes |
为什么这很重要:BCDR 的临床数据与标注来自真实医院(圣若昂中心医院),而不是公开竞赛或志愿者采集。这决定了它的两个特性——真实世界回顾性队列(非受控招募)与标注质量依赖单个临床中心的标准。理解这点,才能正确解读它在 §5 提到的病理确认比例偏低问题。
§2.2 IMED 项目:建库的时代背景
BCDR 的建设挂靠在 IMED 项目之下,于 2009 年 3 月启动。IMED 是一个面向医学影像的 **e-infrastructure(电子基础设施)**项目,其目标是把分散的医院数据、算力资源与分析工具用网格(grid)技术连起来。在这样的项目框架下,数据集的定位天然是「可被计算平台消费的资源」而非「一次性发布的压缩包」。
同期孕育的 ALOE 平台(面向乳腺癌诊断的面向服务架构)为 BCDR 提供了运行环境:CETA-CIEMAT 的 GPU 集群 + SLURM 作业调度 + LUSTRE 共享文件系统 + Grid bridge。换句话说,BCDR 从诞生起就被设计为跑在网格平台上的数据集,这也解释了它为何强调结构化、可查询、可远程访问。
§2.3 时间线:从胶片到数字,再到停更
把散落在论文与综述中的时间点串起来,BCDR 的生命周期大致如下:
- 2009 年 3 月:IMED 项目启动,BCDR 开始建设;
- 2009-2012 年:采集胶片期(FM)与新出现的数字期(DM)影像,逐批加入库中;
- 2012 年:BCDR 门户对外发布,数据集「proposed in 2012」(FAIR 综述口径);
- 2013 年 11 月(11-20 至 11-23):原始基准论文在 CIARP 2013(第 18 届伊比利亚美洲模式识别大会,哈瓦那)发表,首次公开 FM/DM 双库的完整规格与 BCDR-D01/D02 基准子集;
- 2014 年前后:BCDR-DM 继续补充(论文发表时它仍在建设中),构成条目口径的更新年份;
- 2018 年:Chougrad 等人以 BCDR 作为迁移学习基准之一,报告 96.67% 准确率 / 0.96 AUC,使其在深度学习时代再次被关注;
- 之后(具体年份不可考):原始 BCDR 资源库停止活跃维护;门户主机在 2026 年实测已不可达。
这条时间线说明:BCDR 的价值是在特定历史窗口(2009-2014)内沉淀的真实临床影像,它的「停更」并不减损其作为历史基准的意义,反而使它成为研究数据漂移与设备演进的理想对象。
§2.4 命名人与关键人物
- Miguel Angel Guevara López:多篇 BCDR 相关论文的通讯作者与命名人,横跨 INEGI 与 DETI,是数据集方法设计层的核心人物;
- Daniel Cardoso Moura:原始基准论文第一作者,负责数据集的组织与基准实验;
- Isabel Ramos 等 FMUP-HSJ 团队:临床数据的提供者与注解权威;
- Hamid Chougrad 等(摩洛哥 Chouaib Doukkali 大学 LIMA 实验室):以 BCDR 为代表作的第三方基准采用方,代表数据集「出圈」后的使用生态。
§2.5 一个容易混淆的邻居:INbreast
BCDR 与 INbreast 同属波尔图圣若昂医院来源的乳腺影像资源,常被误认为同一数据集。区别在于:
| 维度 | BCDR | INbreast |
|---|---|---|
| 发布方 | CETA-CIEMAT / INEGI / FMUP-HSJ 联盟 | 波尔图圣若昂医院(FMUP)单独 |
| 发布年份 | 2012(论文 2013) | 2011 |
| 设备覆盖 | 胶片(FM)+ 全视野数字(DM)双库 | 全视野数字(FFDM)单库 |
| 规模 | 1010(FM)/ 724(DM)例 | 410 张数字乳腺图像 |
| 临床史 | 整合 | 相对精简 |
两者是并列而非包含关系,本条目在 §8 会把它们作为库内互链条目处理。
§3 数据本体结构解剖
§3.1 病案级的层级模型
BCDR 的组织不是「一图一标签」的扁平表,而是层层嵌套的记录结构。把它抽象出来,是这样的四层模型:
患者 Patient(patient_id)
└── 检查 Study(study_id)
    └── 视图 View(MLO / CC,laterality 左右)
        └── 病灶 Lesion(lesion_id,BI-RADS 分类 + 多边形分割)
逐层说明:
- 患者层:承载人口学与临床史(年龄、性别、病史等),是病案级分析的锚点。BCDR 中男性患者不出意外地稀少但确实存在——FM 有 12 例男性、DM 有 1 例男性,说明数据集没有把男性乳腺癌排除在外,这在乳腺数据集里是难得的完整性。
- 检查层:一次乳腺摄影检查,是时间维度上的事件;同一患者可有多次检查。
- 视图层:标准乳腺摄影的两种体位——**MLO(mediolateral oblique,内外斜位)**与 CC(craniocaudal,头尾位)。左右侧(laterality)也是视图的属性。BCDR 的图像大多为 MLO + CC 成对出现。
- 病灶层:挂在视图上的感兴趣区域,带 BI-RADS 分类与手工多边形分割。
§3.2 病灶类型与 BI-RADS 标注
BCDR 的病灶被划分为若干类型,在 FM 口径下(CIARP 2013)的构成是:
| 病灶类型 | 数量(FM) | 说明 |
|---|---|---|
| masses(肿块) | 639 | 乳腺肿块,最常被用于良恶性分类 |
| microcalcifications(微钙化灶) | 341 | 微小钙化点群,乳腺癌重要征象 |
| calcifications(钙化灶) | 145 | 相对宏观的钙化 |
| stromal distortions(基质扭曲) | 102 | 组织结构扭曲 |
| architectural distortions(结构扭曲) | 66 | 架构变形 |
| axillary adenopathies(腋窝淋巴结病变) | 2 | 罕见的腋窝淋巴结异常 |
| 合计 | 795 | 部分综述把两种扭曲合并为 168(102+66) |
需要说明:795 是病灶(lesion)数量,而分割(segmentation)数量更多(FM 1517 / 合并口径 1493),因为同一病灶可能在 MLO 与 CC 两个视图上分别被分割,计数口径因此不同。本条目在 §9 对这两个口径逐条存照。
§3.3 影像纹理描述符:被忽视的「手工特征」层
在深度学习普及之前,CADx 研究高度依赖手工设计的影像描述符。BCDR 随数据一并提供了四组纹理描述符,这在今天仍有复用价值:
- intensity(强度特征)——灰度一阶统计;
- texture(纹理特征)——如灰度共生矩阵类特征,刻画局部模式;
- multi-scale texture(多尺度纹理)——在不同尺度上提取纹理,捕捉多分辨率结构;
- spatial distribution of gradient(梯度空间分布)——用梯度分布刻画边缘与结构方向。
这些描述符是 CIARP 2013 基准实验的核心变量:论文比较了「影像描述符」「临床数据」以及两者组合在 CADx 分类中的表现,结论是临床数据 + 影像描述符的组合在多数场景下占优。这个结论在今日仍有方法论意义——它提醒我们,纯图像模型未必总是最优,结构化临床上下文的价值不应被低估。
§3.4 临床史字段
每个患者携带脱敏的临床史(clinical history),包含人口学信息与病史相关字段。这些字段是 BCDR 区别于纯图像库的关键资产,也是它被称作「病案医数集」而非「图像集」的原因。
匿名化说明:BCDR 的患者病案来自医学档案馆,已按隐私法规匿名化处理;原始资料同时被用于医学本科生与研究生教学,因此其脱敏流程需符合教学数据的使用规范。研究者在使用时应继续遵守非商业、非再识别的原则。
§3.5 两个子库的规格对照
把 FM 与 DM 的硬规格并列,能直观看出「跨设备域」的含义:
| 规格项 | BCDR-FM(胶片) | BCDR-DM(全视野数字) |
|---|---|---|
| 患者例 | 1010(998 女 + 12 男) | 724(723 女 + 1 男) |
| 年龄范围 | 20-90 岁 | 27-92 岁 |
| 检查数 | 1125 | 1042 |
| MLO/CC 图像数 | 3703 | 3612 |
| 临床描述病灶 | 1044 | 452 |
| 手工分割数 | 1517 | 818 |
| 分辨率 | 720 × 1168 px | 3328 × 4084 或 2560 × 3328 px |
| 位深 | 8 bit/px | 14 bit/px(论文口径,见 §9 冲突) |
| 格式 | TIFF(灰度) | TIFF(灰度) |
一图胜千言:DM 的分辨率约为 FM 的 4-5 倍(线性),位深从 8 bit 提升到 14 bit,意味着动态范围扩大约 64 倍。这正是跨设备域研究最关心的物理差异来源——模型若在 FM 上训练、直接迁移到 DM,会遭遇巨大的分布偏移。
§3.6 数据组织与访问形态
从「数据在哪、长什么样」的角度,BCDR 可拆成三层:
- 影像本体层:灰度 TIFF 文件,按患者/检查/视图组织;
- 标注层:BI-RADS 分类、病灶多边形掩码、纹理描述符数值表;
- 临床层:脱敏临床史字段表。
这三层通过患者与检查的标识符关联。由于原始门户已停更,实际的目录树与文件命名细节需以获批后的官方交付说明为准,本条目不臆造具体路径。这一点在 §6 获取章节会进一步说明。
§3.7 患者人口学画像
BCDR 的患者群体来自葡萄牙北部的乳腺癌筛查服务,人口学特征值得单独列出,因为它直接决定了数据集的分布特性:
| 特征 | BCDR-FM | BCDR-DM |
|---|---|---|
| 总例数 | 1010 | 724 |
| 女性 | 998 | 723 |
| 男性 | 12 | 1 |
| 年龄下限 | 20 岁 | 27 岁 |
| 年龄上限 | 90 岁 | 92 岁 |
| 平均年龄(参考文献口径) | 偏年长(胶片时代筛查人群) | 相对年轻(数字时代筛查人群) |
要点解读:
- 男性患者的存在:FM 有 12 例、DM 有 1 例男性乳腺癌病案。男性乳腺癌约占全部乳腺癌的 1%,BCDR 把它纳入了——这在乳腺数据集里并不普遍,体现了「真实世界队列」的完整性。
- 年龄跨度大:20 岁到 92 岁,说明数据覆盖了从年轻到高龄的广泛人群;但第三方研究指出 BCDR 的患者年龄分布整体偏年轻(尤其在领域泛化研究中被列为「年龄分布最年轻」的域),这是它与现代筛查库的又一处分布差异。
- FM 与 DM 的患者群体不同:两库不是同一批人的两次检查,而是不同世代的筛查人群。因此不能用「同一患者跨设备」的假设做配对分析,除非获批数据中确实存在跨库共享的患者标识。
§3.8 影像采集的物理背景
理解 BCDR 的规格差异,需要一点乳腺摄影的物理常识:
- 胶片乳腺摄影(FM):X 光穿过乳腺后在胶片上曝光成像,再经数字化扫描进入计算机。扫描环节会引入额外噪声,且受胶片本身的动态范围限制,最终图像多为 8 bit(256 级灰度)。
- 全视野数字乳腺摄影(FFDM):X 光直接由数字探测器接收,无需胶片与扫描中间环节。探测器可提供更宽的动态范围和更高的空间分辨率,故 BCDR-DM 的论文口径是 14 bit(16384 级灰度),分辨率也大幅提升。
这两种物理路径的差异,正是「跨设备域」问题的根源:
| 物理环节 | FM | DM |
|---|---|---|
| 成像介质 | 胶片 + 数字化扫描 | 数字探测器 |
| 动态范围 | 窄(8 bit 量级) | 宽(14 bit 量级) |
| 空间分辨率 | 较低(720 × 1168) | 高(3328 × 4084 等) |
| 噪声来源 | 胶片颗粒 + 扫描噪声 | 探测器电子噪声 |
| 典型伪影 | 扫描条纹、胶片划痕 | 探测器坏点、增益不均 |
一个在 FM 上训练的分类器,看到 DM 的高分辨率、宽动态范围图像时,其特征分布会显著偏移。这就是为什么跨库迁移研究必须把 BCDR 的 FM/DM 分开对待。
§3.9 分辨率与乳房大小的耦合
BCDR-DM 的分辨率有两种:3328 × 4084 与 2560 × 3328。这不是设备故障,而是压迫板尺寸与乳房大小造成的自然差异:
- 乳腺摄影中,技师会用压迫板把乳房压平以获取清晰影像;
- 乳房较大的患者需要更大的成像区域,输出矩阵尺寸随之变化;
- 因此同一次检查中的 MLO 与 CC 视图,甚至左右侧视图,尺寸都可能不同。
工程后果:
- 尺寸归一化是必做预处理——不能直接把两种尺寸混入同一 batch;
- 不要简单粗暴地拉伸——等比例缩放或裁剪填充更合理,因为乳腺的解剖比例有临床意义;
- 记录原始尺寸——某些病灶在特定尺寸下更清晰,尺寸信息本身可能是有用特征。
§3.10 图像格式与读取
BCDR 提供 TIFF(Tagged Image File Format) 格式的灰度图像。TIFF 的选择在当时是合理的:它支持无损存储、可嵌元数据、对高分辨率与高位深友好。对研究者的实际影响:
- 读取库:Python 侧可用
tifffile、PIL、imageio等读取; - 位深确认:务必读取文件头确认实际位深(8/14/16 bit 的文献冲突见 §9 坑点 7),不要凭文献假设;
- 内存规划:DM 单图可达数千万像素 × 高位深,批量加载需注意内存;
- 无损原则:从 TIFF 转换到其他格式(如 PNG)时应保持无损,避免二次量化损失。
§3.11 影像纹理描述符的计算语境
前面提到 BCDR 提供四组纹理描述符。它们不是凭空生成的,而是围绕病灶区域(ROI)计算的:
- intensity:病灶 ROI 内灰度统计(均值、方差、偏度、峰度等);
- texture:基于灰度共生矩阵(GLCM)或类似方法的二阶纹理;
- multi-scale texture:在不同尺度/窗口下重复纹理提取;
- spatial distribution of gradient:梯度幅值与方向的分布,刻画边缘结构。
这些描述符的意义在于:它们把图像信息压成了低维数值向量,使传统机器学习分类器(SVM、随机森林等)可以直接使用,而无需深度网络。在 2013 年,这是 CADx 的主流路线;在今天,它们仍可作为可解释的辅助特征或与深度特征融合的补充变量。
§3.12 文本元数据的组织
除了影像与病灶分割,BCDR 还携带一层结构化文本元数据,主要包括:
- 患者层字段:匿名标识、年龄、性别;
- 检查层字段:检查标识、检查日期(脱敏粒度)、设备类型;
- 视图层字段:体位(MLO/CC)、左右侧;
- 病灶层字段:BI-RADS 分类、病灶类型、坐标、纹理描述符数值。
这些字段的价值在于:它们让 BCDR 可以支持表格 + 影像的联合建模,而不只是纯视觉任务。CIARP 2013 的核心结论(临床数据 + 影像描述符组合占优)正是建立在这层元数据之上的。
组织方式提示:由于原始门户停更,具体字段名与编码表需以获批后的数据说明为准。本条目给出的是结构层级,而非逐字段的 schema——避免臆造不存在的字段名。
§3.13 数据质量的实际观察点
拿到 BCDR 后,建议优先检查以下几个方面,它们直接关系到后续实验的有效性:
- 影像与标注的对应完整性——是否每张标注图都能找到对应影像文件;
- 分割掩码的可解析性——多边形坐标是否能正确栅格化;
- 临床字段的缺失率——哪些字段有大量空值;
- 类别分布——是否与文献报告一致(如 masses 639);
- 重复影像——是否存在同一影像被多次编号;
- 尺寸一致性——DM 的两种分辨率分布如何。
这六项检查构成一个实用的「数据验收清单」,可在正式建模前完成。
§3.14 与「图像分类数据集」的思维差异
习惯了 CIFAR/ImageNet 式「图片 → 单标签」范式的研究者,接触 BCDR 时需切换思维:
| 维度 | 典型图像分类集 | BCDR |
|---|---|---|
| 记录单位 | 图片 | 患者病案 |
| 层级 | 扁平 | 四层嵌套 |
| 标签 | 单标签 | 分类 + 分割 + 描述符 + 临床史 |
| 多视图 | 无 | MLO + CC 双视图 |
| 划分 | 按图随机 | 必须按患者 |
| 获取 | 下载 | 申请审批 |
这个对照表提醒我们:BCDR 不是一个「拿来即训」的数据集,而是一个需要先理解其结构语义的资源库。理解成本高,但也正因此,用对它的人能做出别人做不出的实验。
§3.15 影像与病程的时间维度
BCDR 的检查带有时间信息(脱敏后)。这带来一个常被忽略的分析维度:同一患者可能在不同时间有多次检查,从而形成纵向(longitudinal)序列。
纵向分析的潜力与限制:
- 潜力:可研究病灶随时间的演变、随访中的变化;
- 限制:并非所有患者都有多次检查;时间粒度被脱敏;样本量在纵向子集中会进一步减少。
若研究目标是纵向建模,必须先统计有多少患者拥有多次可用检查,不能想当然地认为时间维度是稠密的。
§3.16 小结:BCDR 结构的三个关键词
把 §3 全节的解剖浓缩成三个关键词:
- 病案级(case-level)——一切以患者为中心,而非以图像为中心;
- 多视图(multi-view)——MLO/CC 成对,孕育了视图间一致性等独特问题;
- 多模态(multi-modal)——影像 + 分割 + 纹理描述符 + 临床史四类信息并存。
这三个关键词,正是 BCDR 区别于普通图像包的立身之本,也是它至今仍被引用的结构原因。
§4 规模硬数字分库对账
§4.1 为什么必须分库对账
关于 BCDR,网上流传着多套互相矛盾的数字:有人说「1010 例」,有人说「1734 例」;有人说「3703 张图」,有人说「3073 张」;有人说 14 bit,有人说 8 bit,还有人说 16 bit。这些数字大多不是错,而是口径不同——有的只讲胶片子库,有的把两个子库相加,有的取自早期建设中的快照,有的来自二手综述的转述。若不分库对账,任何引用都会踩到坑。
本节的目标是把每个数字钉回它的来源与口径,让引用者心里有数。
§4.2 BCDR-FM(胶片子库)硬数字
| 指标 | 数值 | 单位/口径 |
|---|---|---|
| 患者例 | 1010 | 998 女性 + 12 男性 |
| 年龄范围 | 20-90 | 岁 |
| 检查数 | 1125 | studies |
| MLO + CC 图像 | 3703 | 张(digitized film mammography) |
| 临床描述病灶 | 1044 | 个 |
| 其中已在 MLO/CC 识别 | 820 | 个 |
| 手工分割 | 1517 | 个(放射科专家 BI-RADS 分类) |
| 分辨率 | 720 × 1168 | 像素 |
| 位深 | 8 | bit/px |
| 格式 | TIFF | 灰度 |
FM 的关键解读:胶片子库的「病灶—分割」关系并不一致。1044 个临床描述病灶里只有 820 个在 MLO/CC 视图上被真正识别出来,而手工分割数(1517)又明显多于病灶数(795/1044)。这提示同一病灶的多视图分割与部分病灶缺乏影像对应两种情况并存。做监督学习时,务必以「有分割掩码的样本」为准,而不是以「临床描述病灶数」为准。
§4.3 BCDR-DM(数字子库)硬数字
| 指标 | 数值 | 单位/口径 |
|---|---|---|
| 患者例 | 724 | 723 女性 + 1 男性 |
| 年龄范围 | 27-92 | 岁 |
| 检查数 | 1042 | studies |
| MLO/CC 图像 | 3612 | 张 |
| 临床描述病灶 | 452 | 个(均已在 MLO/CC 识别) |
| 手工分割 | 818 | 个 |
| 分辨率 | 3328 × 4084 或 2560 × 3328 | 像素(依压迫板/乳房大小) |
| 位深 | 14 | bit/px(论文口径) |
| 格式 | TIFF | 灰度 |
DM 的关键解读:数字子库在论文发表时仍在建设中,因此它的数字是「当时的快照」而非「最终定稿」。这也解释了为何不同来源给出的 DM 规模不同(如 600 例 / 2837 图 vs 724 例 / 3612 图)——后者是更晚、更完整的口径。本条目采用 CIARP 2013 的 724 / 3612 作为 DX 的「最新完整口径」,并在 §9 逐条存照。
另外,DM 的分辨率「3328 × 4084 或 2560 × 3328」并非随意,而是取决于压迫板尺寸与乳房大小:设备在不同采集条件下输出不同矩阵尺寸。这是数字乳腺摄影的常态,也意味着数据在输入尺寸上本身就不统一,预处理时必须处理尺寸归一化。
§4.4 两库合计的正确说法
如果确实需要「合计口径」,正确表述是:
- 患者例合计:1010 + 724 = 1734 例(这正是某些综述写「1734 patient cases」的来源);
- 图像合计:3703 + 3612 = 7315 张(注意:有来源写 7420 或 3073,前者口径不明,后者疑为笔误,见 §9);
- 手工分割合计:1517 + 818 = 2335 个(但第三方综述另有 1493 的合并/去重口径)。
引用建议:除非论文明确讨论「全库总量」,否则一律分库陈述。写作「BCDR 有 1010 例患者」时,应补一句「此为 FM 子库口径,DM 另有 724 例」——这句补全能避免绝大多数误引。
§4.5 病理确认比例:一个必须知道的质量指标
BCDR 的病灶标签并非都经过病理金标准确认。第三方 FAIR 综述引用原文指出:1493 个分割中仅 276 个基于病理结果,其余基于临床意见(如影像随访、临床判断)。
这个比例(约 18.5%)意味着:
- 做筛查/分类的方法学研究:可以接受,因为临床意见本身也是临床决策的依据;
- 做诊断金标准敏感的分析或因果结论:应谨慎,最好只用那 276 个病理确认样本做验证子集。
这是 BCDR 与「全部病理确认」型现代数据集(如部分带完整活检结果的库)之间最本质的质量差异。
§4.6 病灶分割构成的口径分歧
FM 口径下,病灶与分割的类别构成是:
| 类别 | CIARP 2013 口径 | tomesphere 合并口径 |
|---|---|---|
| masses | 639 | 639 |
| microcalcifications | 341 | 341 |
| calcifications | 145 | 145 |
| stromal distortions | 102 | (并入 Distortion) |
| architectural distortions | 66 | (并入 Distortion) |
| Distortion(合并) | — | 168 |
| axillary adenopathies | 2 | — |
| 病灶合计 | 795 | 795 |
两套口径的唯一实质分歧是「两种扭曲(stromal 102 + architectural 66)是否拆分」:CIARP 2013 拆开并单列腋窝淋巴结病变(2),tomesphere 把两种扭曲合并为 168 且未单列 2。合计病灶数都是 795,说明分歧只在分类粒度,不在总量。引用时应说明采用哪套分类。
§5 标注与任务体系
§5.1 BI-RADS:数据集互操作性的基石
BI-RADS 由美国放射学会(ACR)制定,是乳腺影像报告与数据系统的行业标准。它给乳腺影像所见提供统一的分类词汇与评估等级,让不同医院、不同放射科医生的报告可以互相对齐。BCDR 采用 BI-RADS 作为病灶分类的公共语言,带来两个直接好处:
- 标注一致性更高——放射科专家熟悉该标准,减少主观分类的漂移;
- 跨数据集互操作——与 INbreast、CBIS-DDSM 等其他采用 BI-RADS 或可映射到 BI-RADS 的数据集可以对齐研究。
这也是 BCDR 在 FAIR(可发现、可访问、可互操作、可复用)评估中互操作性得分较高的原因:它的标签不是私有编码,而是行业通用标准。
§5.2 病灶分割的标注流程(推断与已知)
根据公开资料,BCDR 的病灶分割由放射科专家手工完成,遵循 BI-RADS 分类。可确认的流程要素:
- 标注者:FMUP-HSJ 的放射科专家;
- 标注对象:病灶区域的多边形轮廓(polygonal segmentation);
- 分类依据:BI-RADS;
- 关联字段:病灶位置、肿块坐标、影像纹理描述符;
- 病理背书:仅部分(276/1493)来自病理结果。
未知部分:公开资料未披露标注的双人复核比例、**标注者间一致性(inter-annotator agreement)**等细节。研究者若做标注质量敏感的实验,这一点需在获批后向数据方确认。
§5.3 标注范围的边界:只有病灶,没有背景组织
一个容易被忽视的限制:FAIR 综述明确指出 BCDR 仅标注病灶,不含背景组织(background tissue)元数据。这句话的含义是:
- 能做:病灶级分类、病灶分割、病灶检测;
- 不能直接做:乳腺密度(breast density)分级、全图组织分割、背景纹理建模。
如果研究目标涉及乳腺密度或全图结构,BCDR 不适合单独使用,需配合带密度标注的数据集(如库内 tn-mammo-breast-density)。
§5.4 典型任务清单
| 任务 | 输入 | 输出 | BCDR 适配度 |
|---|---|---|---|
| 乳腺肿块良恶性二分类 | 病灶 ROI 图像 | 良/恶性 | 高(主流用法) |
| 病灶分割 | 全图或 ROI | 多边形掩码 | 高(有手工分割) |
| CADx 分类器建模 | 影像描述符 + 临床数据 | 诊断标签 | 高(描述符与临床史齐备) |
| 分辨率影响评估 | 不同分辨率图像 | 分类性能差异 | 中(FM/DM 分辨率天然不同) |
| 三类病灶分类 | 病灶图像 | 微钙化/肿块/全部病灶 | 中(类别不均衡) |
| 跨设备域泛化 | FM 训练 → DM 测试 | 泛化性能 | 高(双设备域是核心卖点) |
§5.5 类别不均衡的现实
从 §4.6 的构成可见,BCDR 各类病灶数量差异巨大:masses 639、microcalcifications 341,而 axillary adenopathies 仅 2。这种极端不均衡是真实世界回顾性队列的常态,也是 BCDR 的「真实性」所在。做分类任务时,必须处理类别不均衡,否则模型会退化为对多数类的预测。
§6 获取、许可与版本链
§6.1 获取方式:注册申请制
BCDR 的获取门槛在学术数据集里属于偏严格的一档。可确认的信息:
- 方式:注册申请制(strict application process)——在门户注册、提交正式项目计划;
- 对象限制:通常仅授予学术机构,要求正式的项目计划,目的须为非商业;
- 审批时长:第三方 FAIR 综述作者实测约 2 个月获批;
- 通过后:4 个 benchmark 数据集对注册用户免费下载。
为什么门槛这么高:BCDR 源自真实医院的患者病案,属于敏感医疗数据;严格审批是隐私保护的必要代价。这与现代部分公开数据集(如 CBIS-DDSM 直接用 TCIA 账号下载)形成鲜明对比。
§6.2 许可协议:无公开 CC 许可
BCDR 没有公开的 Creative Commons(CC)许可。这带来一个实务上的重要区别:
- CBIS-DDSM / 部分现代数据集:有明确许可,可依许可条款直接使用;
- BCDR:许可由申请审批决定,具体使用范围以获批协议为准,不存在「默认即可用」的条款。
FAIR 综述给 BCDR 的 accessibility 评分仅 2/5(可访问性偏低),主要就是因为这种申请制与许可不明。相对的,它的 reusability 评分 3/4,说明数据本身在格式与文档上具备一定的可复用基础。
§6.3 版本链
BCDR 的版本演进可以梳理为:
BCDR(2012 门户,含 FM + DM 双子库)
  └── BCDR-F / BCDR-D(分库简称,第三方综述口径)
        └── BCDR-D01 / BCDR-D02(CADx 专用 benchmark 子集,CIARP 2013)
- BCDR-D01 / D02:从 DM 子库派生的两个基准数据集,用于 CADx 对比实验。CIARP 2013 论文明确「本研究首次在基于 FFDM 的数据集 BCDR-D01 上做实验」。其中 D02 的规模大于 D01,是更完整的基准子集。
§6.4 无公开镜像的现实
BCDR 没有公开的直链镜像(不像 CBIS-DDSM 可从 TCIA 直接下载)。这意味着:
- 无法通过公开 URL 静默获取;
- 必须走官方申请渠道;
- 官网停更后,申请入口的实际可用性属于待核事项(见 §9)。
研究者若计划使用 BCDR,应尽早启动申请流程,并预留约 2 个月的审批周期。
§6.5 使用时的合规要点
由于来源是真实医院病案,使用 BCDR 时应在获批协议框架内遵守:
- 非商业——不得用于商业产品开发或转售;
- 不作再识别——不得尝试从脱敏数据中恢复患者身份;
- 遵守协议范围——仅用于申请时声明的项目目的;
- 正确引用——学术发表应引用原始论文(CIARP 2013)与数据方要求的相关文献。
§4.7 一次完整的样本量推演
为了让「口径」这件事落到实处,这里做一次具体的样本量推演。假设研究者想做乳腺肿块良恶性二分类:
第一步,选定子库。若选 FM,患者基数 1010 例;若选 DM,基数 724 例。以 FM 为例。
第二步,确定可用病灶。FM 有 masses 639 个(§4.6 口径)。但注意——这 639 是病灶数,不是样本数。同一病灶在 MLO 和 CC 两个视图上可能各有分割,若按「病灶-视图」对展开,样本数会增加;若按「病灶」去重,样本数就是 639 量级。
第三步,检查病理背书。全库 1493 个分割中仅 276 个基于病理。若将这些病理确认样本按病灶类型分布,能落到「肿块」二分类任务上的会更少。想做病理金标准验证的研究者,可用样本量可能在两位数到低三位数之间,这也正是为什么 BCDR 更多被用于方法学研究而非临床验证。
第四步,划分数据。必须按患者划分。若 639 个肿块分布在约 500-600 名患者中,典型的 80/20 划分会给出训练集约 400-500 个病灶、测试集约 100-140 个病灶的规模。
结论:BCDR 的「1010 例」听起来不小,但经过任务筛选 + 类型筛选 + 病理筛选 + 患者级划分四道过滤后,实际可用于严格实验的样本量会显著缩小。这是引用 BCDR 时最容易高估的一点。
§4.8 为什么「规模不大」仍值得用
既然 BCDR 样本量有限,为什么它仍是常青基准?原因有四:
- 真实临床来源:不是受控采集,而是真实筛查队列,标签有真实的临床决策背景;
- 双设备域:这个组合在同期数据集中罕见,至今仍是稀缺资源;
- 结构完整:病案 → 检查 → 视图 → 病灶 + 临床史,层次完整,适合做关系型研究;
- 历史可比:作为 2013 年基准,它让新方法能与十年前的结果对话。
换句话说,BCDR 的价值不在「大」,而在「真」与「全」。
§5.6 标注一致性的深层问题
§5.6.1 BI-RADS 版本问题
BI-RADS 本身历经多个版本(第 4 版、第 5 版等),不同版本对「可疑」的分级边界有调整。BCDR 建设于 2009-2013 年间,其标注采用的应是当时的 BI-RADS 版本。这意味着:
- 用现代 BI-RADS 第 5 版的术语映射 BCDR 标签时,需谨慎处理边界类别;
- 若把 BCDR 与现代数据集混用,BI-RADS 类别可能不可直接对齐,需要映射表。
§5.6.2 临床意见标签的可靠性
约 81.5% 的分割标签来自临床意见而非病理。临床意见标签的可靠性取决于:
- 阅片医生的经验与一致性;
- 随访是否充分(恶性肿瘤通常在随访中显现);
- 影像质量是否足以支撑判断。
BCDR 未公开标注者间一致性指标,因此这部分不确定性必须由使用者自行评估。一个务实的做法是:在做类别边界敏感的实验时,把病理确认子集作为「可信锚点」,检验模型在可信子集上的表现。
§5.6.3 多视图标注的一致性
同一病灶在 MLO 与 CC 视图上的分割应由同一或不同医生完成?公开资料未明确。若不同视图由不同医生标注,可能存在视图间标注差异。使用多视图数据训练时,应考虑这种潜在的不一致。
§6.6 申请材料准备清单
若决定申请 BCDR,建议提前准备以下材料(基于「学术机构 + 正式项目计划 + 非商业」的已知要求推断):
- 机构身份证明——所属大学/研究机构的正式身份;
- 项目计划书——说明研究目的、方法、预期产出,越具体越好;
- 数据使用声明——明确非商业用途、不作再识别、不二次分发;
- 合规承诺——如涉及伦理审查,提供伦理批准文件;
- 联系人信息——负责人的正式联系方式;
- 时间预算——预留约 2 个月审批周期。
沟通建议:由于官网已停更,申请沟通可能需要通过历史联系人或相关论文的通讯作者渠道进行,需更多耐心。
§6.7 与其他获取模式的对比
| 获取模式 | 代表数据集 | 门槛 | 速度 | 许可明确度 |
|---|---|---|---|---|
| 开放直链 | MIAS、DDSM(部分) | 低 | 快 | 高 |
| 平台账号 | CBIS-DDSM(TCIA) | 中 | 较快 | 中高 |
| 申请审批 | BCDR、INbreast | 高 | 慢(约 2 个月) | 中(以协议为准) |
| 竞赛发布 | 部分挑战赛数据集 | 中 | 中 | 竞赛条款 |
BCDR 属于门槛最高的一档。研究者应在项目时间规划中把数据获取作为关键路径,而非临近截止才启动。
§6.8 版本引用的规范
在论文中引用 BCDR 时,建议明确版本与子库:
- 基础引用:Moura D.C., Guevara López M.A., et al. Benchmarking Datasets for Breast Cancer Computer-Aided Diagnosis (CADx). CIARP 2013, Springer LNCS 8258:326-333. doi:10.1007/978-3-642-41822-8_41;
- 子库声明:如「BCDR-FM 子库(1010 例)」或「BCDR-DM 子库(724 例)」;
- 基准子集声明:若用 D01/D02,注明;
- 获取说明:如「经申请获批使用」。
规范引用既是学术诚信要求,也帮助读者判断你的结果可复现性。
§7 评估与基准
§7.1 BCDR 作为基准的两种角色
BCDR 在评估生态中扮演两种角色:
- 被采用的基准(benchmark target)——研究者用它训练/测试自己的 CADx 模型,报告准确率、AUC 等指标;
- 被改造的基准源(benchmark source)——研究者从 BCDR 派生子集(如 BCDR-D01/D02),定义新的对比实验。
这两种角色决定了 BCDR 的引用有两种典型形态:作为「多个数据集之一」的横向对比,或作为「主战场」的深度实验。
§7.2 Chougrad 2018:深度学习时代的代表作
在 BCDR 的评估史上,被引用最多的一篇第三方工作是 Chougrad 等人 2018 年发表于《Computer Methods and Programs in Biomedicine》(157:19-30,doi:10.1016/j.cmpb.2018.01.011,PMID 29477427)的研究。它用 CNN 迁移学习在多个乳腺数据集上做了系统性对比:
| 数据集 | Accuracy | AUC |
|---|---|---|
| BCDR | 96.67% | 0.96 |
| DDSM | 97.35% | 0.98 |
| INbreast | 95.50% | 0.97 |
| 合并数据集微调 | 98.94% | — |
| MIAS 独立测试 | 98.23% | 0.99 |
这项工作的方法论意义在于:它展示了在一个数据集上预训练、在另一个数据集上微调/测试的迁移学习范式,并用 BCDR 等公开库做了跨库验证。BCDR 的 96.67% / 0.96 AUC 因此成为后续论文常引的「参考线」。
注意:这些数字是特定方法在特定划分下的结果,不是 BCDR 的固有属性。引用时应写明「Chougrad 2018 报告 BCDR 达 96.67%」,而不是「BCDR 的准确率是 96.67%」。
§7.3 BCDR-D01/D02 基准实验
原始 CIARP 2013 论文本身即是一个基准研究,其设计值得了解:
- 变量设计:比较四组影像描述符(intensity / texture / multi-scale texture / spatial distribution of gradient)与临床数据的组合效果;
- 核心结论:临床数据 + 影像描述符的组合在多数 CADx 场景下占优;
- D01 首次实验:论文首次在基于 FFDM 的 BCDR-D01 上开展实验,具有「该数据集用于 CADx 的起点」的意义。
这个结论的现代回响是:多模态融合(影像 + 结构化临床变量)往往优于纯影像模型——这正是今日多模态医学 AI 的核心理念之一,而 BCDR 在 2013 年就提供了验证它的素材。
§7.4 领域泛化研究中的 BCDR
在多中心领域泛化(domain generalization)研究中,BCDR 常作为设备域之一出现。一项针对深度学习肿块检测的多中心研究报告了如下设置:
- 六个域:Optimum Hologic、Siemens、GE、Philips 四种设备的数字乳腺摄影 + INbreast + BCDR;
- BCDR 子集:取自 90 名受试者、经活检确认的肿块、189 张图像、199 个肿块;
- BCDR 的偏移特征:研究指出 BCDR 协变量偏移(covariate shift)最大——其中 55% 为良性肿块、15% 的肿块直径小于 5 mm、患者年龄分布最年轻。
这个发现对使用者极其重要:BCDR 的分布与现代筛查数据集差异显著,直接用现代数据训练的模型在 BCDR 上测试,或在 BCDR 上训练后迁移到现代数据,都会遭遇超出预期的性能下降。BCDR 是检验模型鲁棒性的「逆风场」,而不是一个「好走」的基准。
§7.5 与其他经典基准的并列
BCDR 常与以下数据集并列用于 ROI 分类与检测基准:
- CBIS-DDSM——DDSM 的筛选性数字子集;
- DDSM——数字数据库筛查乳腺摄影;
- MIAS——Mammographic Image Analysis Society 数据集;
- INbreast——波尔图圣若昂医院数字乳腺库。
在这组「老牌五件套」里,BCDR 的差异化定位是唯一同时提供胶片与数字双设备域 + 病案级临床史的库。
§7.6 如何在论文里正确设置 BCDR 实验
若要基于 BCDR 做可复现的评估,建议明确以下事项:
- 子库声明:用 FM 还是 DM,还是两者都用;
- 样本定义:用「有分割的病灶」还是「所有描述病灶」,这直接影响样本量;
- 病理子集:是否只用 276 个病理确认样本做验证;
- 划分策略:按患者划分(避免同一患者泄漏到训练与测试),而非按图像划分;
- 预处理:分辨率归一化(DM 有两种矩阵尺寸)、位深归一化(8 bit vs 14 bit);
- 类别不均衡处理:明确是否过采样/加权;
- 引用:同时引用原始论文(CIARP 2013)与实现方法论文。
§7.7 一个常见的评估陷阱:患者泄漏
因为 BCDR 的一个患者可能有多个检查、每次检查有 MLO+CC 两视图、每个视图可能有多个病灶分割,如果按「图像」随机划分训练/测试,同一患者的影像会同时出现在两侧,导致评估虚高。这是医学影像评估的经典陷阱,BCDR 尤其容易踩中,因为它的多视图多层结构放大了泄漏面。必须按患者(patient_id)分组划分。
§8 生态位与库内互链
§8.1 BCDR 在乳腺影像数据集谱系中的位置
把乳腺影像数据集按「设备域」「标注深度」「开放程度」三个维度排布,BCDR 的位置大致是:
| 数据集 | 设备域 | 标注深度 | 开放程度 | 规模 |
|---|---|---|---|---|
| BCDR | 胶片 + 数字双域 | 病灶分割 + 临床史 | 申请制 | 1010 例(FM) |
| CBIS-DDSM | 数字(DDSM 子集) | 病灶 + 病理 | 较开放(TCIA) | 千级 |
| INbreast | 数字(FFDM) | 病灶分割 | 申请制 | 410 张 |
| MIAS | 胶片 | 病灶 + 背景 | 开放 | 322 张 |
| DDSM | 胶片(数字化) | 病灶 + 病理 | 开放 | 万级 |
BCDR 的独特坐标是:双设备域 + 病案级临床史 + 中等规模 + 申请制。它在「设备域跨度」上比多数同类更宽,在「开放程度」上比多数同类更严。
§8.2 库内互链条目
按千方病案医数集库内已有的相关条目,BCDR 的互链关系如下:
| 库内条目 | rid | 关系类型 | 互链价值 |
|---|---|---|---|
| cbis-ddsm | 541 | 同领域最直接对照组 | 同为筛选性乳腺 X 光数字库,规模更大、开放度更高 |
| inbreast | 542 | 最紧密互链 | 同源机构(波尔图圣若昂医院),同为数字乳腺库,常并列引用 |
| busi | 539 | 同病种跨模态 | 乳腺超声,与 X 光互补 |
| swiss-mammo | 627 | 现代大规模同类 | 乳腺 X 光筛查库,可作「新旧对比」 |
| vindr-mammo | 543 | 现代大规模同类 | 含乳腺密度标注的现代 X 光库 |
| tn-mammo-breast-density | 628 | 密度标注补充 | BCDR 无背景组织/密度标注,此库可补齐 |
| breastpathq | 268 | 同病种跨模态 | 乳腺病理图像 |
| duke-breast-mri | 440 | 同病种跨模态 | 乳腺 MRI |
互链使用建议:
- 做乳腺 X 光跨库迁移:BCDR ↔ cbis-ddsm ↔ inbreast(三者同为 X 光,标注体系可对齐);
- 做跨模态融合:BCDR(X 光)+ busi(超声)+ duke-breast-mri(MRI);
- 做数据补充:BCDR 缺密度/背景标注,可与 tn-mammo-breast-density、vindr-mammo 组合;
- 做新旧域偏移:BCDR(2009-2014 老库)↔ swiss-mammo / vindr-mammo(现代库),研究时代漂移。
§8.3 与库外数据集的对照
在 BCDR 之外,研究者也常把这些数据集与其对照:
- DDSM——最经典的筛查性乳腺 X 光库,DDSM 的许多子集(含 CBIS-DDSM)与 BCDR 同代;
- MIAS——规模小但标注干净,是「经典入门基准」;
- OPTIMAM(OMI-DB)——英国大型筛查库;
- CMMD——中国多中心乳腺 X 光数据集,代表性新库;
- BancoWeb LAPIMO——巴西乳腺影像库;
- IRMA——用于检索/分类的图像库;
- DMR——Digital Mammography Repository 一类数字乳腺库。
这些库共同构成乳腺影像 AI 研究的「公开素材池」,BCDR 在其中属于成体系、有临床史、但获取门槛偏高的一档。
§8.4 生态意义的总结
BCDR 的生态价值有三层:
- 历史层——它是 2009-2014 年波尔图真实临床影像的冻结快照,可用于研究「数据时代」的影响;
- 方法层——它的双设备域 + 临床史 + 手工分割组合,为多模态融合与域泛化提供了天然实验场;
- 治理层——它是研究「老数据集在停更、官网下线后如何保持学术生命周期」的典型案例。
对千方病案医数集而言,BCDR 条目的意义不仅在于收录一个数据集,更在于示范如何对待一个「不完美但重要」的老数据集:不回避它的门槛、停更与口径冲突,而是把这些逐条讲清。
§7.8 迁移学习路线的拆解
Chougrad 2018 的核心是迁移学习。这条路线值得展开,因为它示范了如何使用 BCDR:
基本范式:在大规模自然图像数据集(如 ImageNet)上预训练 CNN → 在乳腺数据集上微调 → 在目标数据集上测试。
为什么迁移学习对 BCDR 特别重要:
- 样本量限制——BCDR 单库规模不足以从头训练深度网络,迁移学习是必由之路;
- 跨库组合——论文把 BCDR、DDSM、INbreast 等组合起来微调,报告合并数据集达 98.94%,说明多库联合能缓解单库样本不足;
- 域差异显现——当在 A 库训练、在 B 库测试时,性能下降直观反映了域差异;BCDR 因为设备域特殊,是观察这种下降的好对象。
实操建议:
- 冻结底层、微调高层是常见起点;
- 学习率要小,避免破坏预训练特征;
- 用患者级划分,避免泄漏;
- 报告多次随机种子的结果均值与方差。
§7.9 领域泛化的三种评估协议
在领域泛化研究中,BCDR 通常作为其中一个「域」参与以下三种协议之一:
| 协议 | 设置 | BCDR 的角色 |
|---|---|---|
| 域内评估 | 同一域内划分训练/测试 | BCDR-FM 或 BCDR-DM 单独使用 |
| 跨域评估 | 一个域训练,另一域测试 | FM→DM 或 BCDR→其他库 |
| 留一域评估 | 用全部域训练,留一个域测试 | BCDR 作为留出域之一 |
BCDR 的偏移特性(55% 良性、15% 肿块 <5mm、年龄偏年轻)意味着它是留一域评估中的「困难域」。若模型在 BCDR 上表现明显低于其他域,这是域差异的合理反映,不应简单归咎于模型缺陷。
§7.10 指标报告的建议
用 BCDR 报告结果时,建议至少包含:
- AUC(对类别不均衡稳健,是乳腺分类的常用指标);
- Accuracy(便于与 Chougrad 等对比);
- Sensitivity / Specificity(临床关心漏诊与误诊的权衡);
- 置信区间(样本量有限时尤其重要);
- 样本量明细(训练/验证/测试各多少,来自哪个子库)。
只报告单一 accuracy 而不给 AUC 与敏感度/特异度,在类别不均衡的乳腺数据上是不充分的。
§7.11 与 CBIS-DDSM 的横向对比实验启示
CBIS-DDSM 与 BCDR 都是乳腺 X 光库,但来源、组织与开放度不同。若做两者的横向对比:
- 来源差异:CBIS-DDSM 源于 DDSM(美国),BCDR 源于葡萄牙筛查队列——存在人群与设备双重差异;
- 标注差异:两者都含病灶与病理信息,但 BI-RADS 版本与分割粒度可能不同;
- 结论启示:在两者上表现差异大的模型,说明其泛化性差;跨库一致性是比单库高分更有说服力的证据。
§7.12 复现性检查清单
在使用 BCDR 的实验发表前,逐条自检:
- 是否声明了使用的子库(FM / DM)?
- 是否声明了病灶样本的筛选规则?
- 是否声明了划分方式(患者级)?
- 是否报告了病理确认子集的结果?
- 是否说明了位深与分辨率预处理?
- 是否给出了随机种子与重复次数?
- 是否按 §6.8 规范引用了数据集?
这份清单既服务于复现,也帮助审稿人理解你的实验边界。
§8.5 乳腺影像数据集的代际划分
把乳腺影像公开数据集按时代粗略划分,能更清楚 BCDR 的历史坐标:
第一代(2000 年代前):MIAS(1994,322 张胶片)、DDSM(1999,万级胶片数字化)——奠定「公开乳腺影像库」范式。
第二代(2000s-2010s):BCDR(2012)、INbreast(2011)、CBIS-DDSM ——开始纳入数字设备、精细化标注、结构化元数据。
第三代(2010s-2020s):OPTIMAM、CMMD、VinDr-Mammo、Swiss-Mammo、以及各类带密度标注的大规模筛查库——规模上万、多中心、带密集标注。
BCDR 是第二代的关键节点:它上承胶片时代的 MIAS/DDSM,下启数字时代的现代库;它的「双设备域」设计恰好踩在胶片向数字切换的历史拐点上。这种「过渡期身份」正是它不可替代的原因。
§8.6 与千方病案医数集其他条目的组合用法
针对不同研究目标,BCDR 在库内的组合用法示例:
目标 A:跨设备域泛化研究
- 主力:BCDR(FM + DM 双域);
- 对照:cbis-ddsm(数字)、inbreast(数字);
- 价值:BCDR 内部即含双域,是做域泛化的天然实验台。
目标 B:乳腺 X 光 + 超声 + MRI 多模态
- 组合:BCDR(X 光)+ busi(超声)+ duke-breast-mri(MRI);
- 价值:同病种跨模态覆盖,研究跨模态迁移。
目标 C:乳腺密度分析
- 组合:BCDR 作为病灶补充 + tn-mammo-breast-density / vindr-mammo 作为密度主力;
- 注意:BCDR 无密度标注,不能单独承担此任务。
目标 D:时代漂移研究
- 组合:BCDR(2009-2014)+ swiss-mammo / vindr-mammo(现代);
- 价值:量化十年间乳腺影像数据分布的变化。
§8.7 数据集治理的样本价值
BCDR 的「停更 + 官网不可达 + 许可不明确」三重状态,是研究学术数据生命周期治理的典型案例。它引出的普遍问题包括:
- 数据集的「退役」应有怎样的公告机制?
- 官网下线后,元数据应托管在哪里才能长期可查?
- 许可不明确的历史数据集,如何在合规前提下继续服务科研?
这些问题在千方病案医数集的语境下有现实意义:记录一个数据集的完整生命周期(含退役状态),本身就是 AI-Ready 元数据的价值所在。BCDR 条目正是在实践这一理念——它不假装数据集永远在线,而是如实记录其状态。
§8.8 从 BCDR 看医学影像数据集的「可持续性」
BCDR 的现状为整个医学影像数据社区提供了一面镜子。它提出的问题具有普遍性:
问题一:数据集的「保质期」有多长?
BCDR 的活跃期约 2009-2014,之后逐渐停更。但它的学术引用持续到今天。这说明数据集的生命周期远长于其维护周期——社区需要为「退役但仍有价值」的数据集提供元数据托管。
问题二:当设备被淘汰,老数据还有用吗?
胶片乳腺摄影设备如今已基本退出临床,但 BCDR 的胶片子库仍有价值——因为它记录了一个消失的数据分布。在域泛化与历史对比研究中,「已消失的域」反而是稀缺资源。
问题三:获取门槛与数据价值的平衡点在哪?
BCDR 的高门槛保护了隐私,但也限制了复用。现代数据集倾向于用更精细的许可协议(如数据使用协议 DUA)替代「审批制」,在保护隐私的同时降低摩擦。BCDR 是评估「不同门槛策略效果」的历史样本。
问题四:官方门户下线后,谁来保存元数据?
这正是 AI-Ready Wikipedia 类项目的意义——用社区化的条目托管,弥补官方门户的消失。BCDR 条目本身即是这一努力的一个实例。
§8.9 BCDR 对当代研究的四点启示
- 多设备域是宝贵的——现代数据集多为单一设备世代,BCDR 的双域设计值得效仿;
- 临床史别丢——结构化临床上下文的价值常被低估,BCDR 的「临床数据 + 影像」结论至今成立;
- 口径透明度决定复用质量——BCDR 的口径冲突是教训:数据集应显式记录每个数字的来源与范围;
- 退役也是元数据——如实记录数据集的停更与不可达状态,是对未来使用者负责。
这四点启示,既是 BCDR 留给社区的经验,也是本条目选择「如实记录、逐条存照」写法的理由。
§8.10 生态位的最终定位
综合 §8 全节,BCDR 在千方病案医数集生态中的最终定位可概括为:
一个过渡期双设备域乳腺影像基准,病案级结构完整、临床史齐备、BI-RADS 标注规范,但获取门槛高、标注深度有限、原始库已停更;它最适合承担域泛化、跨库对比与数据治理研究三类任务,并作为乳腺 X 光数据集谱系中连接胶片与数字两代的枢纽条目。
这一定位既是技术判断,也是使用建议——它提醒后来者:用 BCDR 之前,先想清楚你要的是它的「域跨度」还是它的「规模」;前者它很强,后者它不强。
§9 坑点清单
BCDR 是一个「坑比想象中多」的老数据集。以下十条是复用前必须逐条核对的事项,其中前六条几乎会在每一次数据加载时遇到。
坑点 1:官网已停更且主机不可达,不能依赖门户取数
现象:本条目抓取时点(2026-10-03)实测 https://bcdr.eu/information/about 返回 Cloudflare 523(Origin is unreachable),说明官方门户主机当前下线;第三方 FAIR 综述亦明确原始 BCDR 资源库已不再活跃维护。
后果:任何依赖官网文档、下载页或注册表单的自动化流程都可能失败;研究者无法通过门户自助获取权威元数据。
应对:一手数字一律回溯到 CIARP 2013 原始论文(Springer LNCS 8258:326-333)与第三方 FAIR 综述;获取渠道主要通过正式学术联系与历史申请记录,并预留充足的审批与沟通时间。不要把官网可达性当作数据可用性的前提。
坑点 2:患者总数有 1010 与 1734 两套口径,混用会算错样本量
现象:BCDR-FM 明确为 1010 例(CIARP 2013 与 ALOE/IMED 论文一致);但部分综述(如 PMC8466003)写「BCDR 含 1734 patient cases」。
根因:1734 = 1010(FM)+ 724(DM)的合计口径;1010 是分库口径。两者都对,只是范围不同。
后果:若按 1734 估计样本量却只拿到 FM 数据,或反之,实验设计会整体错位。
应对:论文中必须写明分库口径,例如「本研究使用 BCDR-FM 子库的 1010 例患者」。合计口径仅在讨论全库时使用,并注明构成。
坑点 3:图像总数有 3703 与 3073 的差异,需警惕笔误传播
现象:多源一致写 3703 张 FM 数字化胶片乳腺图像;但 IMED 项目论文(iwbbio_094)中曾出现「3073 digitized mammograms」的写法。
根因:疑为笔误或不同批次快照,3703 与 3073 数字相近易混淆。
后果:引用错误数字会污染元数据与复现说明。
应对:以 3703 为准(多源交叉一致),若引用 3073 需注明来源与存疑;在数据说明文档中显式标注该冲突。
坑点 4:BCDR-DM 的规模在不同文献中差异显著
现象:关于 DM 子库,不同来源给出:
- CIARP 2013:724 例 / 3612 图;
- IMED 论文:600 例 / 2837 图(早期建设口径);
- tomesphere 综述:「over 3,600 images」、分辨率写 3328 × 2560。
根因:DM 子库在 CIARP 2013 发表时仍在建设中,不同文献取了不同时间点的快照;分辨率写法亦有矩阵宽高顺序差异。
后果:若混用不同快照的数字,会出现「724 例却有 2837 图」这类自相矛盾的元数据。
应对:统一采用同一来源的成套数字(推荐 CIARP 2013 的 724 / 3612),并在文档中注明「DM 为建设中口径,不同文献数字可能不同」。
坑点 5:病灶分割构成有「拆分/合并扭曲」两套分类
现象:CIARP 2013 把两种扭曲拆开(stromal distortions 102 + architectural distortions 66)并单列 axillary adenopathies 2;tomesphere 把两种扭曲合并为 168 且未单列 2。病灶合计都是 795。
根因:分类粒度的差异,非总量差异。
后果:若按类型统计并跨来源拼接,会出现类别对不上的问题。
应对:声明采用的分类粒度;做类别分析时优先使用拆分口径(信息更丰富),需要与 tomesphere 对齐时再合并。
坑点 6:分割总数有 1517 与 1493 两套口径
现象:FM 论文写 1517 个分割(分库口径);tomesphere 写 1493 个分割(合并/去重口径,且指出其中仅 276 个基于病理)。
根因:可能源于「已识别 vs 临床描述」的取样范围不同,或跨库去重。
后果:差 24 个样本,在小规模分割实验中不可忽略。
应对:明确声明分割样本的来源口径;若对样本量敏感,直接以实际交付的文件数为准,不要盲信文献数字。
坑点 7:bit depth 口径三源不一(14 bit / 8 bit / 16 bit)
现象:CIARP 2013 论文写 BCDR-DM 为 14 bit/px;GDRBench 综述写 DM「available only in 8-bit depth TIFF」;tomesphere 写 BCDR-D 为 16-bit TIFF。三相矛盾。
根因:可能是「原始采集位深」与「交付 TIFF 存储位深」不同;不同来源记录的是流水线的不同环节。
后果:位深直接影响灰度归一化与模型输入,搞错会导致预处理错误。
应对:本条目按原始论文的 14 bit 为第一口径;实际使用时应以获批后拿到的文件头信息为准(读取 TIFF 元数据确认位深),不要仅凭文献假设。
坑点 8:注册申请制 + 无公开许可,拿到数据不等于可自由使用
现象:BCDR 采用严格申请制,通常仅授学术机构与非商业用途,无公开 CC 许可;FAIR 综述 accessibility 评分仅 2/5,实测审批约 2 个月。
后果:可能误以为「注册即可用」,或在未获明确许可的情况下二次分发,造成合规风险。
应对:提前启动申请(预留约 2 个月);以获批协议界定使用范围;不二次分发;论文中说明用途未超协议范围。
坑点 9:只标注病灶、无背景组织元数据,密度类任务无法直接做
现象:FAIR 综述明确指出 BCDR 仅含病灶标注,不含背景组织(background tissue)元数据。
后果:想做乳腺密度分级、全图组织分割或背景纹理建模的研究者会失望——BCDR 根本没有这类标注。
应对:密度/背景类任务另行选用带相关标注的库(如库内 tn-mammo-breast-density、vindr-mammo),或把 BCDR 作为病灶级补充而非主力。
坑点 10:病理确认比例低,临床结论需谨慎
现象:1493 个分割中仅 276 个基于病理结果,其余基于临床意见。
后果:把临床意见标签当作病理金标准,可能高估模型的「临床有效性」。
应对:区分方法学评估与临床结论;做临床敏感分析时,最好只用 276 个病理确认样本做验证子集;论文中如实说明标签来源分布。
坑点 11:患者泄漏陷阱——多视图多层结构放大评估偏差
现象:BCDR 的病案 → 检查 → MLO/CC 视图 → 多病灶的结构,使得同一患者有大量相关联的图像。
后果:若按图像随机划分训练/测试,同一患者影像跨越两侧,评估结果虚高。
应对:严格按 patient_id 分组划分;在论文中报告划分策略;不要用图像级随机划分的结果宣称性能。
坑点 12:BCDR 与 BC5CDR 缩写相近,检索时易撞车
现象:BCDR 与 BC5CDR(BioCreative V 化学–疾病关系抽取文本数据集)缩写相似,检索文献时可能混入。
后果:文献调研时误引领域完全不同的工作。
应对:检索时同时限定 mammography / breast / image 等关键词;确认数据集身份后再引用。BCDR 与 BC5CDR、INbreast、CBIS-DDSM 均为不同数据集。
§10 DAIMS 元数据表与速查
§10.1 DAIMS 元数据表
DAIMS(Data Asset Information Management Specification)视角下的 BCDR 元数据如下:
| DAIMS 维度 | 内容 |
|---|---|
| 数据资产名称 | Breast Cancer Digital Repository(BCDR) |
| 资产类型 | 医学影像数据集(乳腺 X 光,含临床史与病灶标注) |
| 领域 | 肿瘤学 / 乳腺影像 / 计算机辅助诊断 |
| 数据模态 | 灰度 TIFF 影像(MLO + CC 双视图) |
| 数据来源 | 葡萄牙北部乳腺癌筛查服务,匿名化医院病案 |
| 机构 | CETA-CIEMAT、INEGI(波尔图大学工程学院)、FMUP-HSJ(波尔图大学医学院–圣若昂中心医院) |
| 支撑平台 | IMED 项目(e-infrastructure)、ALOE 平台(GPU 集群 + SLURM + LUSTRE) |
| 记录单位 | 患者病案(Patient → Study → View → Lesion) |
| 覆盖时间 | 2009 年起建库,2012 发布,2013 基准论文,约 2014 后停更 |
| 地理覆盖 | 葡萄牙(波尔图) |
| 患者规模 | 1010 例(FM)+ 724 例(DM) |
| 图像规模 | 3703 张(FM)+ 3612 张(DM) |
| 标注类型 | BI-RADS 分类、病灶多边形分割、影像纹理描述符、临床史 |
| 病理确认 | 1493 个分割中 276 个(约 18.5%) |
| 质量标准 | BI-RADS 标准;但无背景组织标注,病理确认比例偏低 |
| 获取方式 | 注册申请制(学术机构、非商业、正式项目计划) |
| 许可 | 无公开 CC 许可,以获批协议为准 |
| 访问性评分 | FAIR accessibility 2/5,reusability 3/4 |
| 当前状态 | 原始库已停更;官网主机 2026-10-03 实测不可达 |
| 隐私合规 | 医院病案已匿名化,符合隐私法规,亦用于临床教学 |
§10.2 一页速查表
| 想了解 | 快速答案 |
|---|---|
| 全称 | Breast Cancer Digital Repository |
| 建库方 | CETA-CIEMAT + INEGI + FMUP-HSJ |
| 建库时间 | 2009 年 3 月起,2012 发布,2013 基准论文 |
| 子库 | BCDR-FM(胶片,1010 例)+ BCDR-DM(数字,724 例) |
| 图像规模 | 3703(FM)+ 3612(DM)张 MLO/CC 图 |
| 标注 | BI-RADS + 病灶多边形分割 + 纹理描述符 + 临床史 |
| 典型任务 | 乳腺肿块良恶性分类、病灶分割、CADx 建模、域泛化 |
| 代表基准 | Chougrad 2018:BCDR 96.67% / 0.96 AUC |
| 获取 | 注册申请制,约 2 个月获批,学术非商业 |
| 许可 | 无公开 CC,以协议为准 |
| 状态 | 已停更,官网不可达 |
| 主要局限 | 无背景组织标注、病理确认少、获取门槛高 |
| 库内搭档 | cbis-ddsm、inbreast、busi、swiss-mammo、vindr-mammo |
| 审慎点 | 分库口径、病理子集、患者级划分、位深归一化 |
§10.3 结语:如何恰当地使用 BCDR
BCDR 是一份带着时代烙印的诚实数据。它不完美:获取要过审、官网已下线、位深口径打架、病理确认不足两成、没有背景组织标注。但它也提供了别处少有的组合:胶片与数字两个设备域、病案级临床史、BI-RADS 病灶分割。
正确的使用姿态是:
- 把它当鲁棒性试金石,而非刷分跑马场——它的偏移特性恰恰是检验模型泛化的好素材;
- 分库、分口径、分来源地引用它的数字——每一处冲突都值得在方法部分说明;
- 按患者划分、控制泄漏、区分临床意见与病理金标准——这是对真实临床数据的基本尊重;
- 尊重它的获取门槛与许可边界——不因它「老」就轻视数据的敏感属性。
对千方病案医数集而言,收下 BCDR,就是收下一段可以反复回看的乳腺影像 AI 早期史;而读透它的坑点,正是让这段历史真正可复用的前提。
坑点 13:检索关键词会混入大量非影像的「BCDR」工作
现象:「BCDR」这一缩写在不同领域都被使用(如商业连续性/灾难恢复 Business Continuity and Disaster Recovery 的通用缩写),文献检索时会把大量无关结果混进来。
后果:文献综述时误引非乳腺影像领域的工作,浪费调研时间。
应对:检索时组合限定词,如 BCDR mammography、Breast Cancer Digital Repository、「乳腺 X 光 BCDR」;核对论文摘要确认是乳腺影像数据集后再引用。
坑点 14:把 BCDR 的结果当作「数据集固有准确率」
现象:网络上常出现「BCDR 准确率 96.67%」这类表述,仿佛这是数据集的属性。
根因:96.67% 是 Chougrad 2018 特定方法在特定划分下的结果,换了模型、换了划分,数字就变。
应对:引用时写明「Chougrad 2018 报告 BCDR 达 96.67%」;不要写「BCDR 的准确率是 X」,那是把方法结论错记为数据属性。
坑点 15:忽略 FM 与 DM 患者群体不可配对
现象:有人假设 BCDR-FM 与 BCDR-DM 是同一批患者在不同时期的两次检查,从而做「配对纵向分析」。
根因:两库是不同世代的筛查人群,公开资料未表明存在大规模跨库共享患者。
应对:除非获批数据明确提供跨库患者标识,否则不得假设配对关系;把两库当作独立的域处理。
坑点 16:性别字段被默认全为女性
现象:许多乳腺数据集习惯性假设患者全为女性,流水线里把性别写死。
根因:BCDR 实际含 12 例男性(FM)+ 1 例男性(DM)。
应对:不要把性别硬编码为女性;若研究仅针对女性,显式过滤并说明;若保留男性样本,注意其样本极少带来的统计问题。
坑点 17:纹理描述符与图像版本可能不匹配
现象:BCDR 随数据提供纹理描述符数值表;若研究者自行对图像做了重采样/归一化,却仍用原始描述符,两者语境不一致。
根因:描述符是在原始图像上计算的,预处理会改变灰度与尺度,使描述符失效。
应对:要么用原始图像 + 原始描述符,要么自己重算描述符;不要混用预处理后的图像与原始描述符。
坑点 18:分割掩码格式需核实(多边形 vs 像素级)
现象:BCDR 的分割为**多边形(polygonal)**形式,而非现代语义分割常用的像素级掩码。
后果:若流水线预期像素级掩码,直接读取会失败或得到错误形状。
应对:确认掩码格式;多边形需栅格化为像素掩码再用于分割训练;栅格化时的填充规则(含边界与否)需统一。
坑点 19:时间跨度字段容易被误填
现象:BCDR 的采集跨 2009-2014 年,但不同论文对「发布年份」与「采集年份」表述不一(2012 发布 vs 2009 起采)。
后果:元数据里 temporalCoverage 与 datePublished 填错,影响时间维度分析。
应对:区分「发布日期」(2012)与「采集覆盖」(2009-2014);本条目即分列二者。
坑点 20:把「申请获批」等同于「可自由再分发」
现象:获得 BCDR 使用权限后,有人误以为可以把数据转给合作者或上传到公共仓库。
根因:BCDR 的协议通常是点对点授权,不包含再分发权。
应对:合作者应各自申请;不得二次分发;如需共享衍生特征,先确认协议是否允许。
§10.4 术语表
为便于非影像背景的读者理解,这里汇总本条目出现的关键术语:
| 术语 | 全称 | 含义 |
|---|---|---|
| BCDR | Breast Cancer Digital Repository | 乳腺癌数字资源库(本条目对象) |
| FM | Film Mammography | 胶片乳腺摄影;BCDR-FM 即其胶片子库 |
| DM | Digital Mammography | 数字乳腺摄影;BCDR-DM 即其数字子库 |
| FFDM | Full-Field Digital Mammography | 全视野数字乳腺摄影 |
| CADx | Computer-Aided Diagnosis | 计算机辅助诊断 |
| BI-RADS | Breast Imaging Reporting and Data System | 乳腺影像报告和数据系统 |
| MLO | Mediolateral Oblique | 内外斜位(乳腺摄影标准体位之一) |
| CC | Craniocaudal | 头尾位(乳腺摄影标准体位之一) |
| ROI | Region of Interest | 感兴趣区域 |
| GLCM | Gray-Level Co-occurrence Matrix | 灰度共生矩阵(纹理分析方法) |
| AUC | Area Under the ROC Curve | ROC 曲线下面积(分类性能指标) |
| FAIR | Findable, Accessible, Interoperable, Reusable | 数据可发现/可访问/可互操作/可复用原则 |
| DAIMS | Data Asset Information Management Specification | 数据资产信息管理规范 |
| IMED | (医学影像 e-infrastructure 项目名) | BCDR 的建库项目框架 |
| ALOE | (面向乳腺癌诊断的服务架构平台) | BCDR 的运行平台 |
| CETA-CIEMAT | (西班牙 CIEMAT 技术中心) | 共建机构之一 |
| INEGI | Institute of Mechanical Engineering and Industrial Management | 共建机构之一(波尔图大学工程学院) |
| FMUP-HSJ | Faculty of Medicine – Centro Hospitalar São João | 共建机构之一(临床方) |
§10.5 关键数字速记卡
| 数字 | 含义 |
|---|---|
| 1010 | BCDR-FM 患者例数 |
| 724 | BCDR-DM 患者例数 |
| 1734 | 两库合计患者例数(1010 + 724) |
| 3703 | BCDR-FM 图像数 |
| 3612 | BCDR-DM 图像数 |
| 1517 | BCDR-FM 手工分割数 |
| 818 | BCDR-DM 手工分割数 |
| 1493 | 合并口径分割数(tomesphere) |
| 795 | FM 病灶数 |
| 276 | 基于病理的分割数 |
| 639 | FM 肿块(masses)数 |
| 341 | FM 微钙化灶数 |
| 12 | FM 男性患者数 |
| 96.67% | Chougrad 2018 报告的 BCDR accuracy |
| 0.96 | Chougrad 2018 报告的 BCDR AUC |
附录 A:核验来源与存照
本条目的一手数字主要来自以下来源(均为公开文献,非官网):
- Moura D.C., Guevara López M.A., et al. Benchmarking Datasets for Breast Cancer Computer-Aided Diagnosis (CADx). CIARP 2013, Springer LNCS 8258:326-333. doi:10.1007/978-3-642-41822-8_41 —— FM/DM 完整规格、D01/D02 基准、病灶构成的主来源。
- IMED 项目论文(iwbbio_094)—— 早期建设口径(DM 600 例 / 2837 图),用于口径冲突存照。
- ALOE 平台论文 —— 平台架构(GPU 集群 + SLURM + LUSTRE)。
- tomesphere FAIR 综述(PMC10491669)—— 停更状态、FAIR 评分、审批约 2 个月、病理确认 276/1493、无背景组织标注。
- PMC8466003 —— 「1734 patient cases」合计口径来源。
- Chougrad H., Zouaki H., Alheyane O. (2018) Deep Convolutional Neural Networks for breast cancer screening. Comput Methods Programs Biomed 157:19-30. doi:10.1016/j.cmpb.2018.01.011, PMID 29477427 —— BCDR 96.67% / 0.96 AUC。
- 多中心领域泛化研究 —— BCDR 协变量偏移特征(55% 良性、15% 肿块 <5mm、年龄偏年轻)。
附录 B:口径冲突一览(速查)
| 项目 | 口径一 | 口径二 | 口径三 | 本条目采用 |
|---|---|---|---|---|
| 患者总数 | 1010(FM) | 724(DM) | 1734(合计) | 分库陈述,合计注明 |
| FM 图像数 | 3703 | 3073(疑笔误) | — | 3703 |
| DM 患者数 | 724(CIARP) | 600(IMED 早期) | — | 724 |
| DM 图像数 | 3612(CIARP) | 2837(IMED 早期) | over 3,600(tomesphere) | 3612 |
| FM 分割数 | 1517 | 1493(合并) | — | 1517(并注 1493) |
| 扭曲分类 | 102 + 66(拆分) | 168(合并) | — | 拆分(并注合并口径) |
| DM 位深 | 14 bit(CIARP) | 8 bit(GDRBench) | 16 bit(tomesphere) | 14 bit(并注,以文件头为准) |
| DM 分辨率 | 3328 × 4084 | 2560 × 3328 | 3328 × 2560(tomesphere 顺序异) | 两种矩阵尺寸并列 |
附录 C:常见问题(FAQ)
Q1:BCDR 是免费的吗?
申请免费,但须通过审批;无公开付费渠道,也无公开 CC 许可。
Q2:我可以直接把 BCDR 上传到 Kaggle 吗?
不可以。BCDR 的授权通常不含再分发权,二次分发违反协议。
Q3:BCDR 和 BC5CDR 是同一个吗?
不是。BC5CDR 是化学–疾病关系抽取的文本数据集,BCDR 是乳腺影像数据集,领域完全不同。
Q4:为什么官网打不开?
原始库已停更,门户主机在 2026 年实测不可达(Cloudflare 523)。这不代表数据被删除,而是门户下线。
Q5:只有 1010 例,还值得用吗?
值得,但用途要匹配:它适合方法学研究、域泛化、跨库对比,不适合需要海量样本的深度模型从头训练。
Q6:BCDR 能做乳腺密度分析吗?
不能直接做。BCDR 仅有病灶标注,无背景组织/密度标注。
Q7:为什么同一病灶会有多个分割?
因为同一病灶可能在 MLO 与 CC 两个视图上分别被标注,计数时需明确是「病灶数」还是「分割数」。
Q8:用 BCDR 做临床结论可靠吗?
需谨慎。约 81.5% 的标签来自临床意见而非病理,做临床敏感结论时应限定在病理确认子集。
附录 D:给复现者的最小工作流
一个可复现的 BCDR 使用流程建议如下:
- 申请——准备材料、提交、等待约 2 个月;
- 验收——拿到数据后核对文件数、分辨率、位深是否与文献一致;
- 解析——读取影像(TIFF)、标注(多边形分割)、临床史(表格);
- 清洗——按子库(FM/DM)分离;确认样本口径;剔除无分割样本;
- 预处理——尺寸归一化、位深归一化、灰度标准化;
- 划分——按 patient_id 分组划分训练/验证/测试;
- 建模——迁移学习或传统分类器 + 纹理描述符 + 临床数据;
- 评估——报告 AUC、Accuracy、敏感度/特异度与置信区间;
- 存证——记录所有口径决策与预处理参数;
- 引用——按规范引用原始论文与数据方。
这条工作流的每一步都对应本条目某一节的展开——把它当作 BCDR 使用的「操作清单」,配合 §9 的坑点清单服用,可避开绝大多数常见错误。
本条目状态说明:本条目所依据的 BCDR 原始门户在撰写时点已不可达(Cloudflare 523),所有一手数字以 CIARP 2013 原始论文与第三方 FAIR 综述为准,口径冲突已在附录 B 逐条存照。条目将持续以「如实记录、不美化、不臆造」为原则维护。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- brixia-peru — 共享标签:医学影像 / X光影像 / 图像分类 / 医学图像分割 / 评测基准
- bus-bra — 共享标签:医学影像 / 乳腺影像 / 图像分类 / 医学图像分割 / 评测基准
- mias — 共享标签:医学影像 / 乳腺影像 / 图像分类 / 医学图像分割 / 评测基准
- bus-uclm — 共享标签:医学影像 / 乳腺影像 / 图像分类 / 医学图像分割 / 评测基准
- 3d-mammogram — 共享标签:医学影像 / 乳腺影像 / X光影像 / 医学图像分割 / 评测基准
- breast-lesions-usg — 共享标签:医学影像 / 乳腺影像 / 图像分类 / 医学图像分割 / 评测基准
- dbt-tu-ju — 共享标签:医学影像 / 乳腺影像 / 图像分类 / 医学图像分割 / 评测基准
- tn3k — 共享标签:医学影像 / 图像分类 / 医学图像分割 / 评测基准
- pfus1 — 共享标签:医学影像 / 图像分类 / 医学图像分割 / 评测基准
- busi — 共享标签:医学影像 / 乳腺影像 / 图像分类 / 医学图像分割
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
